在机器学习中,您一定遇到过过拟合这个词。过拟合是指机器学习模型在训练数据上拟合得过于“好”,却无法在测试数据上表现良好的现象。在机器学习中,能在测试数据上有足够好的表现被视为一种“硬性要求”。
有相当多的方法可以帮助防止过拟合。正则化便是其中之一。而本文将专注于此。本文将尽量用更少的数学公式、更多的直观解释来说明正则化。与我其他教程不同,本文不包含任何案例研究。在深入案例之前,我希望您先理解正则化的重要性与其一些“微妙之处”。因为正则化确实不太好掌握,但对数据科学家而言却非常重要。
本文结构如下:
- 什么是机器学习中的过拟合?
- 什么是正则化,它如何帮助防止过拟合现象?
- 结论
什么是机器学习中的过拟合?
在解释过拟合之前,先简单谈谈机器学习中的泛化。
泛化指模型在学习过程中未见过的具体样本(简称测试集)上,所学概念适用得有多好。
一个优秀的机器学习模型的目标,是能将从训练数据中学到的规律,良好地泛化到该问题域中的任意数据上。这样,您便能对模型从未见过的未来数据做出预测。
引用开头部分的描述:“过拟合是指机器学习模型在训练数据上拟合得过于‘好’,却无法在测试数据上表现良好的现象。”
当模型把训练数据中的细节与噪声都学到,以至于对未见数据的表现受到负面影响,就会发生过拟合。这意味着训练数据中的噪声或随机波动被模型当作概念加以学习。问题在于,这些概念并不适用于新数据,从而损害了模型的泛化能力。
非参数和非线性模型在学习目标函数时更灵活,因此更容易过拟合。因此,许多非参数机器学习算法都会包含一些参数或技术,用来限制并约束模型所学习的细节程度。
例如,决策树是一种非常灵活的非参数算法,容易对训练数据过拟合。这个问题可以通过在树学习完成后进行剪枝来缓解,从而去除其学到的一些细枝末节。另一方面,欠拟合则指模型既无法很好地拟合训练数据,也无法泛化到新数据。
什么是正则化?
如果您只听到“正则化”这个词,而未与机器学习联系起来,您大概会理解为“使之规则化的过程”。问题是:究竟“什么”被规则化?在机器学习中,我们谈论学习算法或模型,而算法或模型内部究竟是什么?是参数集合。简言之,机器学习中的正则化,就是对参数进行约束、规范,或将系数估计收缩至接近零的过程。换言之,这一技术会抑制学习到更复杂或更灵活的模型,从而避免过拟合风险。
现在,您正逐步理解正则化究竟如何帮助防止过拟合。让我们直接展开。
既然知道正则化是在规范参数,您可能会问:为什么约束参数能帮助防止过拟合?请看下图:
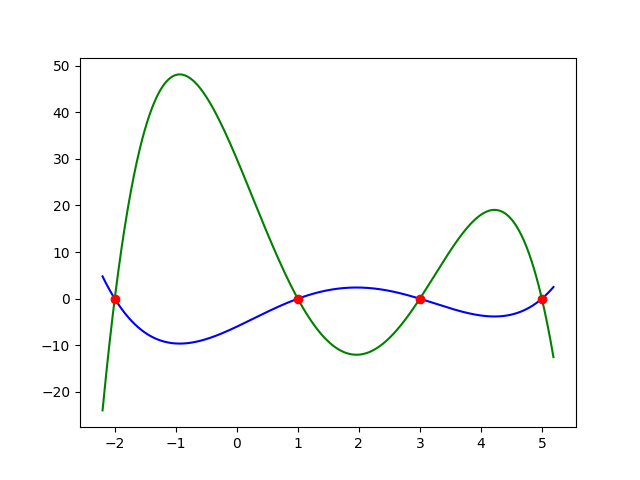
如图所示,绿色曲线与蓝色曲线分别代表两个函数。两条曲线都非常好地拟合了那些红点,几乎可以认为它们的损失为零。根据对过拟合的直觉,您也许已经猜到绿色曲线是过拟合的那条。没错!但您是否想过,为什么绿色曲线(或与其相似的曲线)会对数据过拟合?
为了稍微从数学角度理解这一点,假设用于作图的两个函数如下:
绿色曲线:

红色曲线:

如果您查看每个函数的方程,会发现绿色曲线的系数更大,而这正是过拟合的主因。前文提到,过拟合可以理解为模型把数据集拟合得过于“完美”,更像是在记忆我们给出的数据,而不是从中真正学习。直观来看,较大的系数可以被视为“记忆数据”的证据。举个例子,如果训练数据中存在噪声,其数值量级明显偏离其他样本,这些噪声会促使模型在高阶项的系数上赋予更大的权重,结果就是一个对训练数据过拟合的模型!
在数据科学问题中,随着特征数量的增加,模型往往能更好地拟合数据。但凡事有度,特征太多就会遭遇过拟合。有些人可能会想:既然加太多特征会导致过拟合,那我们在模型尚可时就别再加特征不就好了吗?但请换个角度思考:如果客户或老板希望模型达到 95% 的准确率,而您不增加一些特征就达不到目标,可一旦增加又导致过拟合,接下来该怎么办?
再换一种情况:您面临一个大规模数据集,每条记录都包含许多特征。您不知道该删哪些特征,更糟的是可能每个特征都相当有信息量,也就是说,一旦删除一些特征,很可能会破坏算法的表现。接下来又该如何?
答案就是正则化。
正则化项:
因此,删特征并不总是防止过拟合的好主意。而且如上例所示,是否能删除一些信息量较低的特征,往往需要进一步分析。所以,一个良好的实践是:在一开始用全部特征来构建您的首个模型。然后,正则化作为解决方案登场。为更清晰起见,先看一下 MSE 损失函数(MSE:均方误差):

其中:
- hθ(X(i)) 是对第 i 个输入参数 Xi 的预测
- y(i) 是真实值
- m 为输入样本总数
在如逻辑回归等模型中,学习的目标是最小化该 MSE 函数。这意味着参数可以以任何方式更新,只要能降低 MSE 值即可。而如前所述,参数越大,模型越容易过拟合。那么问题来了:是否能在最小化损失函数的同时,限制参数不要变得过大?答案是:可以。方法是添加如下的正则化项:

其中:
看看加入正则化项后的新损失函数。正则化项会对较大的参数进行惩罚。显然,最小化该损失函数需要同时降低右侧的两部分:MSE 项与正则化项。因此,每当某个参数更新得过大时,正则化项就会使损失函数的值上升,从而对其进行惩罚并将其更新为较小的值。
结论
本文就在这里收尾。我认为篇幅不长,但足以供您自行复习与消化。当您对文中直觉解释感到自如时,下一步可以:
- 学习不同类型的正则化,如 L1 与 L2 变体。
- 在任何参数化的机器学习模型中实现正则化。
如果您想进一步学习机器学习,请查看这些 DataCamp 课程:


在机器学习中,您一定遇到过过拟合这个词。过拟合是指机器学习模型在训练数据上拟合得过于“好”,却无法在测试数据上表现良好的现象。在机器学习中,能在测试数据上有足够好的表现被视为一种“硬性要求”。
有相当多的方法可以帮助防止过拟合。正则化便是其中之一。而本文将专注于此。本文将尽量用更少的数学公式、更多的直观解释来说明正则化。与我其他教程不同,本文不包含任何案例研究。在深入案例之前,我希望您先理解正则化的重要性与其一些“微妙之处”。因为正则化确实不太好掌握,但对数据科学家而言却非常重要。
本文结构如下:
什么是机器学习中的过拟合?
在解释过拟合之前,先简单谈谈机器学习中的泛化。
泛化指模型在学习过程中未见过的具体样本(简称测试集)上,所学概念适用得有多好。
一个优秀的机器学习模型的目标,是能将从训练数据中学到的规律,良好地泛化到该问题域中的任意数据上。这样,您便能对模型从未见过的未来数据做出预测。
引用开头部分的描述:“过拟合是指机器学习模型在训练数据上拟合得过于‘好’,却无法在测试数据上表现良好的现象。”
当模型把训练数据中的细节与噪声都学到,以至于对未见数据的表现受到负面影响,就会发生过拟合。这意味着训练数据中的噪声或随机波动被模型当作概念加以学习。问题在于,这些概念并不适用于新数据,从而损害了模型的泛化能力。
非参数和非线性模型在学习目标函数时更灵活,因此更容易过拟合。因此,许多非参数机器学习算法都会包含一些参数或技术,用来限制并约束模型所学习的细节程度。
例如,决策树是一种非常灵活的非参数算法,容易对训练数据过拟合。这个问题可以通过在树学习完成后进行剪枝来缓解,从而去除其学到的一些细枝末节。另一方面,欠拟合则指模型既无法很好地拟合训练数据,也无法泛化到新数据。
什么是正则化?
如果您只听到“正则化”这个词,而未与机器学习联系起来,您大概会理解为“使之规则化的过程”。问题是:究竟“什么”被规则化?在机器学习中,我们谈论学习算法或模型,而算法或模型内部究竟是什么?是参数集合。简言之,机器学习中的正则化,就是对参数进行约束、规范,或将系数估计收缩至接近零的过程。换言之,这一技术会抑制学习到更复杂或更灵活的模型,从而避免过拟合风险。
现在,您正逐步理解正则化究竟如何帮助防止过拟合。让我们直接展开。
既然知道正则化是在规范参数,您可能会问:为什么约束参数能帮助防止过拟合?请看下图:
如图所示,绿色曲线与蓝色曲线分别代表两个函数。两条曲线都非常好地拟合了那些红点,几乎可以认为它们的损失为零。根据对过拟合的直觉,您也许已经猜到绿色曲线是过拟合的那条。没错!但您是否想过,为什么绿色曲线(或与其相似的曲线)会对数据过拟合?
为了稍微从数学角度理解这一点,假设用于作图的两个函数如下:
绿色曲线:
红色曲线:
如果您查看每个函数的方程,会发现绿色曲线的系数更大,而这正是过拟合的主因。前文提到,过拟合可以理解为模型把数据集拟合得过于“完美”,更像是在记忆我们给出的数据,而不是从中真正学习。直观来看,较大的系数可以被视为“记忆数据”的证据。举个例子,如果训练数据中存在噪声,其数值量级明显偏离其他样本,这些噪声会促使模型在高阶项的系数上赋予更大的权重,结果就是一个对训练数据过拟合的模型!
在数据科学问题中,随着特征数量的增加,模型往往能更好地拟合数据。但凡事有度,特征太多就会遭遇过拟合。有些人可能会想:既然加太多特征会导致过拟合,那我们在模型尚可时就别再加特征不就好了吗?但请换个角度思考:如果客户或老板希望模型达到 95% 的准确率,而您不增加一些特征就达不到目标,可一旦增加又导致过拟合,接下来该怎么办?
再换一种情况:您面临一个大规模数据集,每条记录都包含许多特征。您不知道该删哪些特征,更糟的是可能每个特征都相当有信息量,也就是说,一旦删除一些特征,很可能会破坏算法的表现。接下来又该如何?
答案就是正则化。
正则化项:
因此,删特征并不总是防止过拟合的好主意。而且如上例所示,是否能删除一些信息量较低的特征,往往需要进一步分析。所以,一个良好的实践是:在一开始用全部特征来构建您的首个模型。然后,正则化作为解决方案登场。为更清晰起见,先看一下 MSE 损失函数(MSE:均方误差):
其中:
在如逻辑回归等模型中,学习的目标是最小化该 MSE 函数。这意味着参数可以以任何方式更新,只要能降低 MSE 值即可。而如前所述,参数越大,模型越容易过拟合。那么问题来了:是否能在最小化损失函数的同时,限制参数不要变得过大?答案是:可以。方法是添加如下的正则化项:
其中:
看看加入正则化项后的新损失函数。正则化项会对较大的参数进行惩罚。显然,最小化该损失函数需要同时降低右侧的两部分:MSE 项与正则化项。因此,每当某个参数更新得过大时,正则化项就会使损失函数的值上升,从而对其进行惩罚并将其更新为较小的值。
结论
本文就在这里收尾。我认为篇幅不长,但足以供您自行复习与消化。当您对文中直觉解释感到自如时,下一步可以:
如果您想进一步学习机器学习,请查看这些 DataCamp 课程: