

रेग्युलराइज़ेशन
मॉडल ट्रेनिंग के दौरान दो बड़े समस्याएँ सामने आ सकती हैं: ओवरफिटिंग और अंडरफिटिंग।
- ओवरफिटिंग तब होता है जब मॉडल ट्रेनिंग सेट पर अच्छा प्रदर्शन करता है, लेकिन अनदेखे (टेस्ट) डेटा पर उतना अच्छा नहीं।
- अंडरफिटिंग तब होता है जब वह न तो ट्रेन सेट पर अच्छा करता है, न ही टेस्ट सेट पर।
विशेष रूप से, रेग्युलराइज़ेशन का उपयोग डेटा के ओवरफिटिंग से बचने के लिए किया जाता है, खासकर जब ट्रेन और टेस्ट सेट के प्रदर्शन में बड़ा वैरिएंस हो। रेग्युलराइज़ेशन में, ट्रेनिंग में उपयोग किए गए फीचर्स की संख्या स्थिर रहती है, परंतु समीकरण 1.1 में दिखे गुणांकों (w) का परिमाण घटा दिया जाता है।
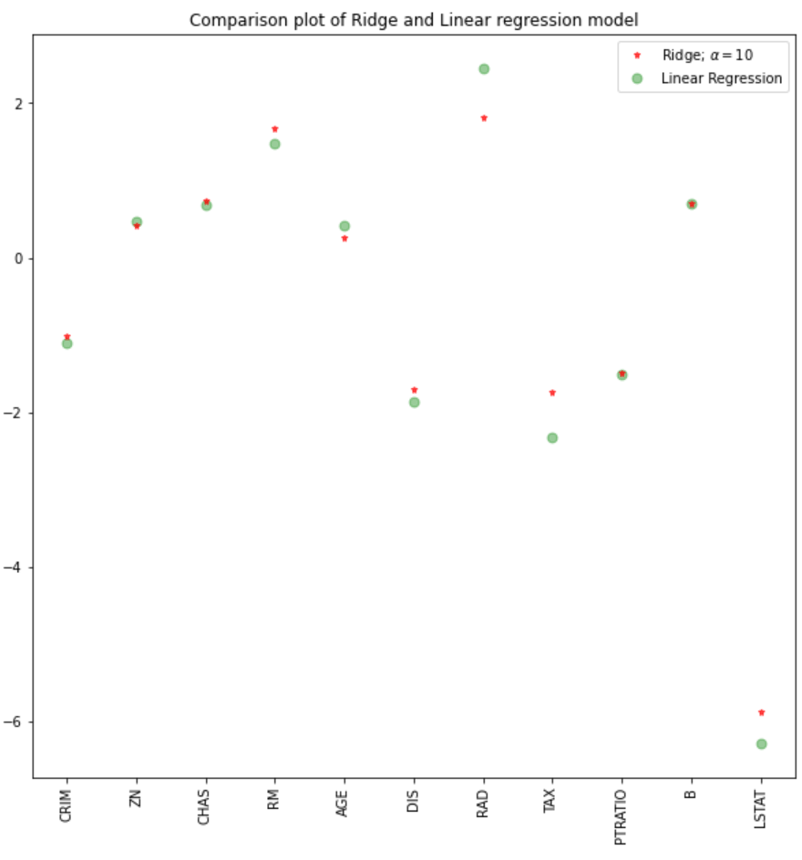
नीचे हाउस प्राइस की भविष्यवाणी के लिए गुणांकों की छवि पर विचार करें। भले ही भविष्यवक्ताओं की संख्या अधिक है, RM और RAD के गुणांक सबसे बड़े हैं। इसका मतलब होगा कि हाउसिंग कीमतें मुख्यतः इन दो फीचर्स द्वारा संचालित होंगी, जिससे ओवरफिटिंग हो सकती है, जहाँ सामान्यीकृत पैटर्न नहीं सीखे जाते।
रैखिक मॉडलों में मॉडल की जटिलता घटाने और ओवरफिटिंग रोकने के कई तरीके हैं। इनमें ridge और lasso रिग्रेशन मॉडल शामिल हैं।
Lasso Regression का परिचय
यह एक रेग्युलराइज़ेशन तकनीक है जिसका उपयोग फीचर चयन में Shrinkage विधि से किया जाता है, जिसे दंडित (penalized) रिग्रेशन विधि भी कहा जाता है। Lasso का पूर्ण रूप है Least Absolute Shrinkage and Selection Operator, जिसका उपयोग रेग्युलराइज़ेशन और मॉडल चयन, दोनों के लिए होता है। यदि कोई मॉडल L1 रेग्युलराइज़ेशन तकनीक का उपयोग करता है, तो उसे lasso रिग्रेशन कहा जाता है।
रेग्युलराइज़ेशन के लिए Lasso Regression
इस श्रिंकेंज तकनीक में, ऊपर समीकरण 1.1 से रैखिक मॉडल में निर्धारित गुणांक एक केंद्रीय बिंदु, अर्थात माध्य, की ओर सिकोड़े जाते हैं, जिसके लिए एक दंड कारक, alpha α (कभी-कभी lambda) प्रस्तुत किया जाता है।
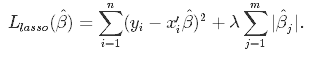
Alpha (α) वह दंड पद है जो यह दर्शाता है कि समीकरण में कितना श्रिंकेंज (या बाधा) लागू किया जाएगा। जब alpha शून्य होता है, तो यह समीकरण 1.2 वाले रैखिक रिग्रेशन मॉडल के समतुल्य होता है, और बड़े मान ऑप्टिमाइज़ेशन फ़ंक्शन पर अधिक दंड लगाते हैं। अतः, lasso रिग्रेशन गुणांकों को सिकोड़ता है और मॉडल जटिलता व मल्टी-कोलीनियरिटी को घटाने में मदद करता है।
Alpha (α) शून्य से अनंत तक कोई भी वास्तविक मान हो सकता है; मान जितना बड़ा, दंड उतना आक्रामक।
मॉडल चयन के लिए Lasso Regression
क्योंकि गुणांक शून्य के माध्य की ओर सिकोड़े जाते हैं, दंड लागू होने पर डेटासेट के कम महत्वपूर्ण फीचर्स हट जाते हैं। प्रदान किए गए alpha मान के आधार पर इन गुणांकों का श्रिंकेंज किसी हद तक स्वचालित फीचर चयन कर देता है, क्योंकि इनपुट चर प्रभावी रूप से हटाए जाते हैं।
Ridge Regression
Lasso रिग्रेशन के समान ही, ridge रिग्रेशन भी दंड कारक प्रस्तुत करके गुणांकों पर बाधा लगाता है। हालाँकि, जहाँ lasso रिग्रेशन गुणांकों के परिमाण को लेता है, वहीं ridge रिग्रेशन उनके वर्ग को लेता है।
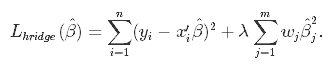
Ridge रिग्रेशन को L2 रेग्युलराइज़ेशन भी कहा जाता है।
Lasso मॉडल चयन के लिए क्यों उपयुक्त है, जबकि Ridge Regression नहीं
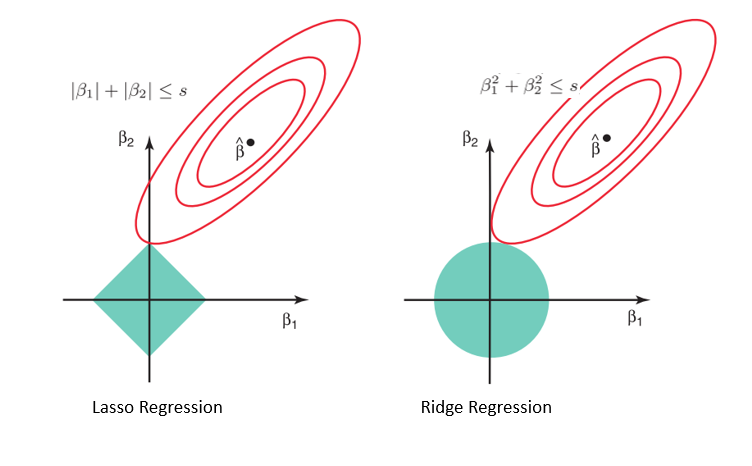
Lasso (बाएँ) और ridge (दाएँ) दोनों मॉडलों की ज्यामिति पर विचार करें। दीर्घवृत्ताकार कंटूर (लाल वृत्त) प्रत्येक के कॉस्ट फ़ंक्शन हैं। दंड कारक द्वारा प्रस्तुत बाधाओं को ढीला करने से बाधित क्षेत्र (डायमंड, सर्कल) बढ़ता है। ऐसा लगातार करते हुए हम दीर्घवृत्त के केंद्र तक पहुँचेंगे, जहाँ दोनों lasso और ridge मॉडल के परिणाम रैखिक रिग्रेशन मॉडल जैसे हो जाते हैं।
हालाँकि, दोनों विधियाँ उन पहले बिंदुओं को खोजकर गुणांक निर्धारित करती हैं जहाँ दीर्घवृत्ताकार कंटूर बाधा क्षेत्र को छूते हैं। क्योंकि lasso रिग्रेशन में बाधित क्षेत्र प्लॉट में हीरे (डायमंड) के आकार का होता है, हर बार जब दीर्घवृत्तीय क्षेत्र इन कोनों से प्रतिच्छेद करते हैं, तो कम से कम एक गुणांक शून्य हो जाता है। यह ridge रिग्रेशन मॉडल में संभव नहीं है क्योंकि यह वृत्ताकार आकार बनाता है और मान शून्य के क़रीब तो सिकोड़े जा सकते हैं, पर बिल्कुल शून्य नहीं होते।
Python में कार्यान्वयन
इस कार्यान्वयन के लिए, हम Sklearn में उपलब्ध Boston हाउसिंग डेटासेट का उपयोग करेंगे। हम यह देखना चाहते हैं:
- Python में ridge और lasso रिग्रेशन कैसे करें
- परिणामों की तुलना रैखिक रिग्रेशन मॉडल से करें
डेटा आयात और EDA
#libraries
import pandas as pd
import numpy as np
import seaborn as sns
import matplotlib.pyplot as plt
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression
from sklearn.linear_model import Ridge, RidgeCV, Lasso
from sklearn.preprocessing import StandardScaler
from sklearn.datasets import load_boston
#data
boston = load_boston()
boston_df=pd.DataFrame(boston.data,columns=boston.feature_names)
#target variable
boston_df['Price']=boston.target
#preview
boston_df.head()
#Exploration
plt.figure(figsize = (10, 10))
sns.heatmap(boston_df.corr(), annot = True)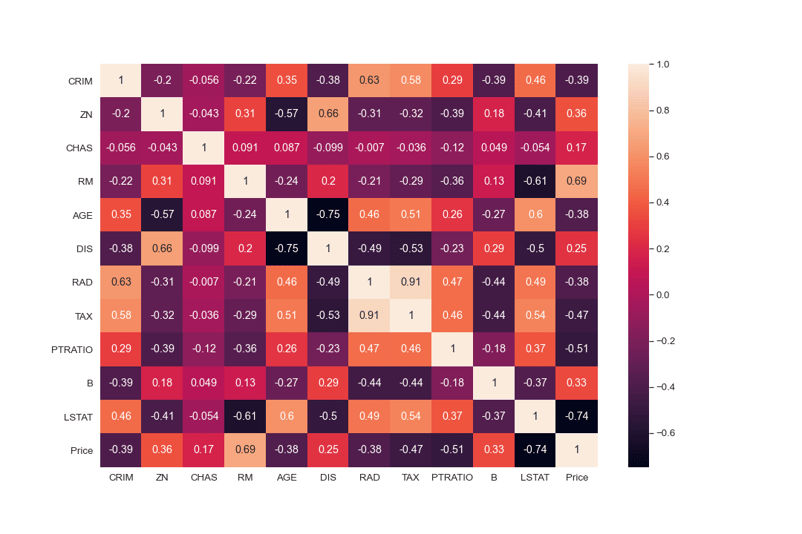
#There are cases of multicolinearity, we will drop a few columns
boston_df.drop(columns = ["INDUS", "NOX"], inplace = True)
#pairplot
sns.pairplot(boston_df)
#we will log the LSTAT Column
boston_df.LSTAT = np.log(boston_df.LSTAT)
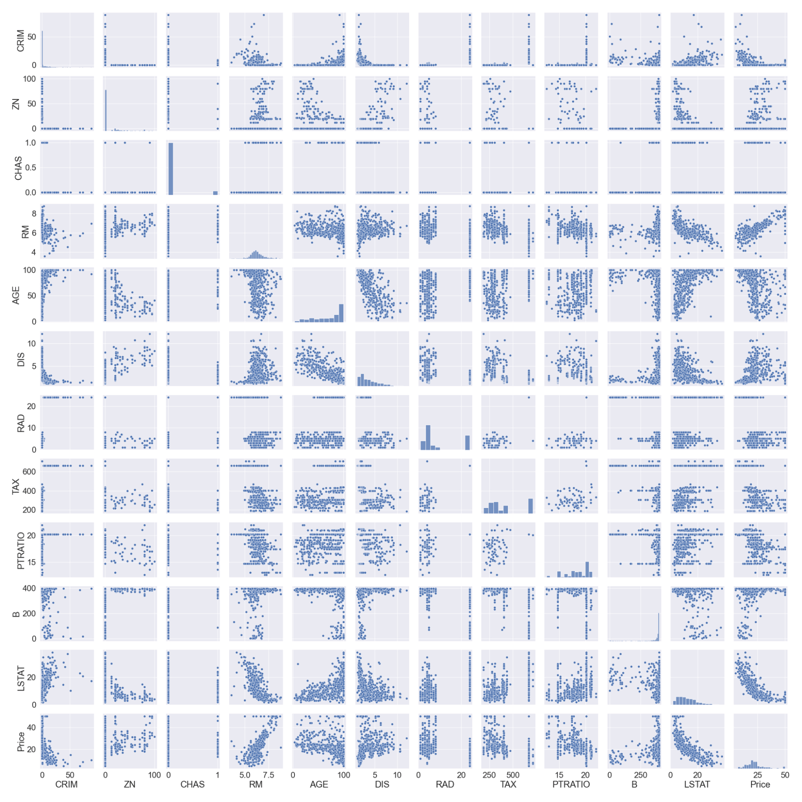
ध्यान दें कि हमने LSTAT कॉलम को लॉग-परिवर्तित किया है क्योंकि इसका प्राइस कॉलम के साथ रैखिक संबंध नहीं है। रैखिक मॉडल x और y चर के बीच रैखिक संबंध मानते हैं।
डेटा विभाजन और स्केलिंग
#preview
features = boston_df.columns[0:11]
target = boston_df.columns[-1]
#X and y values
X = boston_df[features].values
y = boston_df[target].values
#splot
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=17)
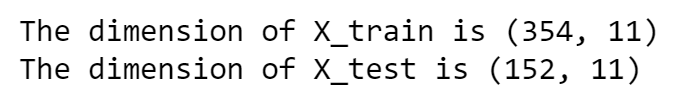
print("The dimension of X_train is {}".format(X_train.shape))
print("The dimension of X_test is {}".format(X_test.shape))
#Scale features
scaler = StandardScaler()
X_train = scaler.fit_transform(X_train)
X_test = scaler.transform(X_test)
आउटपुट:
लिनियर और Ridge रिग्रेशन मॉडल
हम एक रैखिक और एक ridge रिग्रेशन मॉडल बनाएँगे और फिर प्लॉट में गुणांकों की तुलना करेंगे। ट्रेन और टेस्ट सेट का स्कोर भी हमें बताएगा कि मॉडल कितना अच्छा प्रदर्शन करता है।
#Model
lr = LinearRegression()
#Fit model
lr.fit(X_train, y_train)
#predict
#prediction = lr.predict(X_test)
#actual
actual = y_test
train_score_lr = lr.score(X_train, y_train)
test_score_lr = lr.score(X_test, y_test)
print("The train score for lr model is {}".format(train_score_lr))
print("The test score for lr model is {}".format(test_score_lr))
#Ridge Regression Model
ridgeReg = Ridge(alpha=10)
ridgeReg.fit(X_train,y_train)
#train and test scorefor ridge regression
train_score_ridge = ridgeReg.score(X_train, y_train)
test_score_ridge = ridgeReg.score(X_test, y_test)
print("\nRidge Model............................................\n")
print("The train score for ridge model is {}".format(train_score_ridge))
print("The test score for ridge model is {}".format(test_score_ridge))
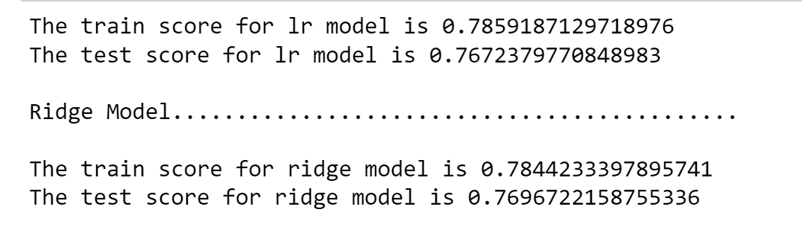
Alpha मान 10 का उपयोग करते हुए, मॉडल, ट्रेन और टेस्ट डेटा का मूल्यांकन यह इंगित करता है कि ridge मॉडल का प्रदर्शन रैखिक रिग्रेशन मॉडल से बेहतर है।
हम दोनों, रैखिक और ridge मॉडलों, के गुणांकों का प्लॉट भी बना सकते हैं।
plt.figure(figsize = (10, 10))
plt.plot(features,ridgeReg.coef_,alpha=0.7,linestyle='none',marker='*',markersize=5,color='red',label=r'Ridge; $\alpha = 10$',zorder=7)
#plt.plot(rr100.coef_,alpha=0.5,linestyle='none',marker='d',markersize=6,color='blue',label=r'Ridge; $\alpha = 100$')
plt.plot(features,lr.coef_,alpha=0.4,linestyle='none',marker='o',markersize=7,color='green',label='Linear Regression')
plt.xticks(rotation = 90)
plt.legend()
plt.show()
Lasso Regression
#Lasso regression model
print("\nLasso Model............................................\n")
lasso = Lasso(alpha = 10)
lasso.fit(X_train,y_train)
train_score_ls =lasso.score(X_train,y_train)
test_score_ls =lasso.score(X_test,y_test)
print("The train score for ls model is {}".format(train_score_ls))
print("The test score for ls model is {}".format(test_score_ls))
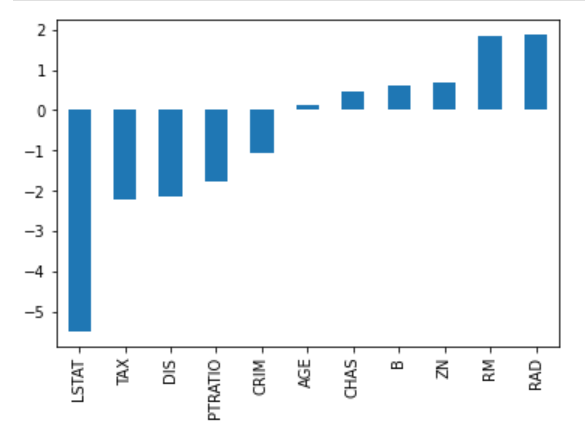
हम गुणांकों का विज़ुअलाइज़ेशन भी कर सकते हैं।
pd.Series(lasso.coef_, features).sort_values(ascending = True).plot(kind = "bar")
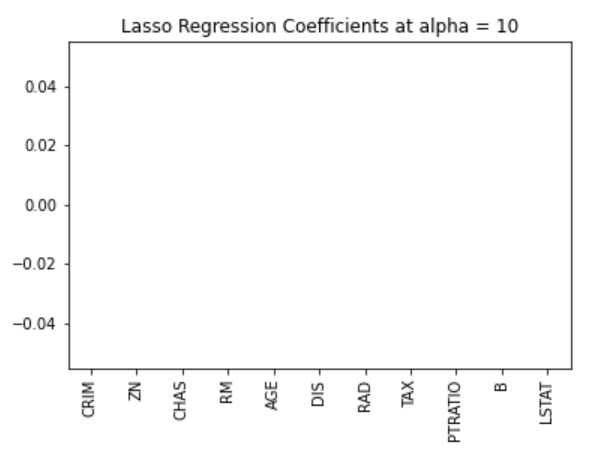
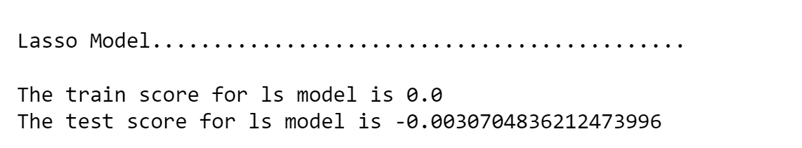
पहले हमने स्थापित किया था कि बाधा क्षेत्र के डायमंड आकार के कारण lasso मॉडल गुणांकों को शून्य तक ले जा सकता है। इस स्थिति में, alpha मान 10 का उपयोग मॉडल को अत्यधिक दंडित कर देता है और सभी मानों को शून्य तक सिकोड़ देता है। हम यह बात ऊपर दिए गए चित्र में मॉडल के गुणांकों का विज़ुअलाइज़ेशन करके साफ़ देख सकते हैं।
Sklearn में क्रॉस-वैलिडेशन से इष्टतम Alpha मान चुनना
हमें इष्टतम बाधा मान खोजने के लिए अलग-अलग alpha मान आज़माने पड़ सकते हैं। इस मामले में, हम sklearn पैकेज में उपलब्ध क्रॉस-वैलिडेशन मॉडल का उपयोग कर सकते हैं। यह अलग-अलग alpha संयोजनों को आज़माएगा और सर्वश्रेष्ठ मॉडल चुनेगा।
#Using the linear CV model
from sklearn.linear_model import LassoCV
#Lasso Cross validation
lasso_cv = LassoCV(alphas = [0.0001, 0.001,0.01, 0.1, 1, 10], random_state=0).fit(X_train, y_train)
#score
print(lasso_cv.score(X_train, y_train))
print(lasso_cv.score(X_test, y_test))
आउटपुट:
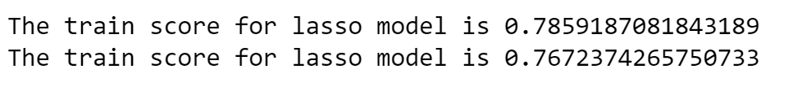
मॉडल LassoCV फ़ंक्शन में दिए गए अलग-अलग alpha मानों पर ट्रेन होगा। हम मॉडल के बेहतर प्रदर्शन का अवलोकन कर सकते हैं, जिससे alpha मानों को मैन्युअली बदलने का थकाऊ काम नहीं करना पड़ता।
हम lasso मॉडल के गुणांकों की तुलना बाकी मॉडलों (रैखिक और ridge) से कर सकते हैं।
#plot size
plt.figure(figsize = (10, 10))
#add plot for ridge regression
plt.plot(features,ridgeReg.coef_,alpha=0.7,linestyle='none',marker='*',markersize=5,color='red',label=r'Ridge; $\alpha = 10$',zorder=7)
#add plot for lasso regression
plt.plot(lasso_cv.coef_,alpha=0.5,linestyle='none',marker='d',markersize=6,color='blue',label=r'lasso; $\alpha = grid$')
#add plot for linear model
plt.plot(features,lr.coef_,alpha=0.4,linestyle='none',marker='o',markersize=7,color='green',label='Linear Regression')
#rotate axis
plt.xticks(rotation = 90)
plt.legend()
plt.title("Ridge, Lasso और Linear रिग्रेशन मॉडलों का तुलनात्मक प्लॉट")
plt.show()
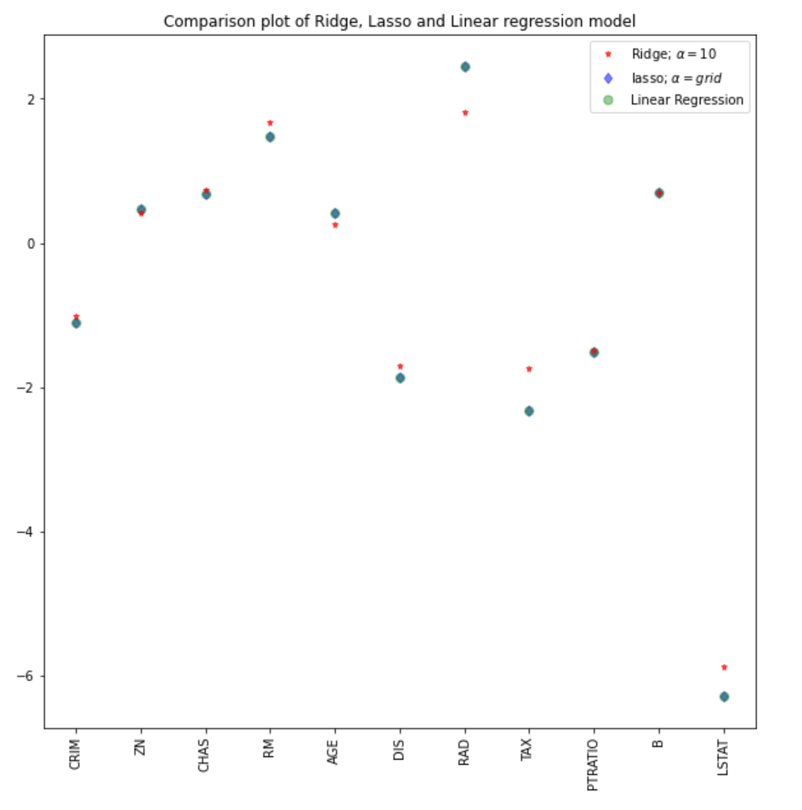
नोट: इसी तरह का तरीका ridge रिग्रेशन मॉडल पर भी लागू किया जा सकता है, जो बेहतर परिणाम दे सकता है। sklearn पैकेज में RidgeCV फ़ंक्शन इसी तरह कार्य करता है।
#Using the linear CV model from sklearn.linear_model import RidgeCV #Lasso Cross validation ridge_cv = RidgeCV(alphas = [0.0001, 0.001,0.01, 0.1, 1, 10]).fit(X_train, y_train) #score print("The train score for ridge model is {}".format(ridge_cv.score(X_train, y_train))) print("The train score for ridge model is {}".format(ridge_cv.score(X_test, y_test)))
अन्य प्रकार के रिग्रेशन के बारे में जानें हमारे Python में लॉजिस्टिक रिग्रेशन और Python में लिनियर रिग्रेशन ट्यूटोरियल्स के साथ।
निष्कर्ष
हमने ridge और lasso रिग्रेशन मॉडलों का कार्यान्वयन तथा इनके पीछे के सैद्धांतिक और गणितीय सिद्धांत देखे। इस ट्यूटोरियल के प्रमुख बिंदु शामिल हैं:
- Ridge और lasso रिग्रेशन के कॉस्ट फ़ंक्शन समान होते हैं। हालाँकि, ridge रिग्रेशन गुणांकों का वर्ग लेता है और lasso उनका परिमाण।
- Lasso रिग्रेशन स्वचालित फीचर चयन के लिए उपयोग किया जा सकता है, क्योंकि इसके बाधित क्षेत्र की ज्यामिति गुणांकों को शून्य तक ले जाने देती है।
- Ridge या lasso मॉडल में alpha का शून्य मान रिग्रेशन मॉडल जैसे परिणाम देता है।
- Alpha मान जितना बड़ा, दंड उतना आक्रामक।
Python कार्यान्वयन के लिए एक अधिक सुदृढ़ और पूर्ण नोटबुक आप यहाँ पा सकते हैं, या हमारे Introduction to Regression in Python कोर्स के साथ रिग्रेशन्स में गहराई से जाएँ।
रैखिक मॉडलों का परिचय
इस प्रायोगिक अभ्यास के साथ Python में Lasso और Ridge Regression का अभ्यास करें।
लिनियर रिग्रेशन रैखिक मॉडलों का एक प्रकार है, जिसे सबसे बुनियादी और आमतौर पर इस्तेमाल किया जाने वाला प्रेडिक्टिव एल्गोरिदम माना जाता है। यह इसकी सरल, फिर भी प्रभावी संरचना से जुड़ा है। एक रैखिक मॉडल इनपुट चर 𝑥 और आउटपुट चर y के बीच रैखिक संबंध मानता है। रैखिक मॉडल का समीकरण इस प्रकार दिखता है:
इस समीकरण 1.1 में, हम n फीचर्स वाले रैखिक मॉडल को दिखाते हैं। w प्रत्येक फीचर को सौंपे गए गुणांक (या वज़न) हैं — जो परिणाम y के लिए उनकी महत्ता का संकेत देते हैं। उदाहरण के लिए, हम मानते हैं कि आइसक्रीम बिक्री का बड़ा कारक तापमान है, न कि यह कि कोई सार्वजनिक अवकाश है या नहीं। हमारे रैखिक मॉडल में तापमान को दिया गया वज़न सार्वजनिक अवकाश वाले चर से अधिक होगा।
इसके बाद रैखिक मॉडल का लक्ष्य समीकरण 1.2 में दिए गए कॉस्ट फ़ंक्शन के माध्यम से वज़नों (b) को अनुकूलित करना हो जाता है। कॉस्ट फ़ंक्शन भविष्यवाणियों और वास्तविक मानों के बीच त्रुटि की गणना करता है, जिसे एक एकल वास्तविक-संख्या के रूप में दर्शाया जाता है। कॉस्ट फ़ंक्शन डेटासेट में n सैंपलों के पार औसत त्रुटि है, जिसे नीचे इस प्रकार दर्शाया गया है:
ऊपर दिए गए समीकरण में, yi वास्तविक मान है और हमारा रैखिक समीकरण से भविष्यवाणी किया गया मान है, जहाँ M पंक्तियों की संख्या और P फीचर्स की संख्या है।