自美国著名数学家 Samuel S. Wilks 借用 HG Wells 的著作 Mankind in the Making 之意,著名地提出“统计思维终有一天会像读写能力一样,对高效公民身份同样必不可少”以来,已过去七十多年。尽管这一表述或许略显夸张,但其关于统计学重要性的核心观点在当今信息时代依然切中要害。
图片来源:美国统计协会(The American Statistical Association)
随着技术的飞速发展与前所未有的创新,机器学习与生成式 AI 已走到舞台中央。这些进步深刻影响着我们的日常生活,并在大规模上促进了数据驱动的决策。
在围绕这些前沿技术的热议中,统计学始终是机器学习众多突破的基石。它与数据的本质密不可分,而数据正是所有令人兴奋的新技术的根基。
什么是统计机器学习?
顾名思义,统计机器学习指的是使用统计技术来开发能够从数据中学习并进行预测或决策的模型。
本质上,统计机器学习将机器学习算法的计算效率与适应性,与统计推断与建模能力相融合。您可能听过监督学习、无监督学习与半监督学习等技术术语——它们都建立在扎实的统计基础之上。
通过运用统计方法,我们能够从复杂数据集中提取重要的模式、关系与洞见,从而提升机器学习算法的有效性。
统计学在机器学习中的作用
我刚刚说过,统计学从根本上为机器学习算法提供了理论框架。现在,我们不妨更深入地看看二者的差异与融合方式。
统计学是一门使我们能够收集、分析、解释、展示与组织数据的科学。它为理解模式与趋势提供工具,并为基于数据进行推断与预测提供方法。在处理大型数据集时,统计学帮助我们理解并概括数据,让我们能够厘清复杂的模式。
另一方面,机器学习是一种强大的工具,使计算机能够从数据中学习并基于数据做出决策或预测。其最终目标是创建能够随时间自适应、不断改进,并能从具体样本泛化到更广泛情形的模型。
这正是统计学与机器学习融合之美所在。统计学原理构成了支撑机器学习结构的中流砥柱。
- 构建机器学习模型:统计学为机器学习中的模型创建提供方法与原则。例如,线性回归模型采用最小二乘这一统计方法来估计系数。
- 解释结果:统计概念使我们能够解释机器学习模型生成的结果。诸如 p 值、置信区间、R 平方等度量,为我们从统计视角评估机器学习模型的表现提供了依据。
- 验证模型:统计技术对于验证与改进机器学习模型至关重要。例如,假设检验、交叉验证与自助法(bootstrapping)等技术可帮助我们量化模型表现并避免过拟合等问题。
- 支撑高级技术:即便是一些更复杂的机器学习算法,如神经网络,其核心也蕴含统计原理。用于训练这些模型的优化技术(如梯度下降)基于统计理论。
因此,扎实的统计学理解不仅有助于我们更好地构建与验证机器学习模型,还能让我们以有意义、可用的方式解读其输出。
接下来看看与机器学习密切相关的一些关键统计概念。您可以在我们的 Statistics Fundamentals with Python 技能路径中进一步学习这些概念并获得动手实践。
概率
概率论在机器学习中至关重要,因为它为不确定性建模与概率性预测提供了基础。我们如何量化不同结果、事件或数值出现的可能性?概率正是解决之道!此外,概率分布在机器学习中特别重要,是许多“魔法”的来源。
常用分布包括 高斯(正态)、伯努利、泊松与指数分布。我们提供了便捷的概率速查表,可作为概率规则的快速参考。
描述性统计
描述性统计帮助我们理解数据集的特征与性质。它们用于汇总与可视化数据、识别模式、检测异常值,并获得指导后续建模与分析的初步洞见。

我们的描述性统计速查表可帮助您学习这些概念
集中趋势度量
均值、中位数与众数可为数据集的中心或代表性取值提供有益洞见。在机器学习中,它们通过辅助填补缺失值与识别潜在异常值来协助数据预处理。
在特征工程中,它们也有助于捕捉影响模型性能的典型或最常见取值。
方差与标准差
方差与标准差量化数据点围绕集中趋势的离散程度。它们可作为机器学习中数据一致性与变异性的指标。
这些度量有助于特征选择或降维,识别预测能力有限的特征。
此外,通过分析预测或残差的变异性,它们有助于评估模型表现,便于比较不同算法。
离散程度度量
极差、四分位距与百分位数等离散度量可揭示数据取值的分布特征。它们在异常值检测中特别有用,帮助识别并处理可能对模型训练与预测产生巨大影响的异常值。在需要对数据进行变换或归一化以提升算法表现的情况下,这些度量亦可提供指导。
抽样
机器学习模型是基于样本数据进行训练的。如果样本选择不当,我们的模型可靠性就会变得不确定。理想情况下,我们希望从更大的总体中选择具有代表性的数据子集。
采用恰当的抽样技术还能确保机器学习模型在多样且无偏的数据上训练,促进技术的伦理且负责任使用。
查看我们的 Sampling in Python 课程,进一步学习这一强大技能。
估计
估计技术对于基于样本数据确定未知总体参数至关重要。它们使我们能够估计模型参数、评估模型表现,并对未见数据进行预测。
机器学习中最常见的估计方法是极大似然(ML)估计,通过最大化似然函数来寻找未知参数的估计量。
假设检验
假设检验为评估机器学习任务中关系或差异的显著性提供了系统方法。它使我们能够检验假设有效性、比较模型,并基于现有证据做出具有统计学意义的决策。
交叉验证
交叉验证(CV)是机器学习中用于评估算法性能与泛化误差的统计技术。其主要目的是防止过拟合,即模型在训练数据上表现良好却无法泛化至未见数据的现象。
通过将数据集划分为多个子集,并在不同组合上迭代训练与评估模型,交叉验证能够更可靠地估计算法在未见数据上的表现。
流行的统计机器学习技术
这些复杂的统计概念是通往高效机器学习算法的第一步。现在让我们探索一些最受欢迎的机器学习模型,看看统计学如何助力它们实现卓越能力。
线性回归
线性回归是统计学文献中常见的术语,但它远不止于此。它也被视为一种监督学习算法,用于刻画因变量与一个或多个自变量之间的关系。
统计学帮助估计系数、开展假设检验并评估关系的显著性,从而提供有价值的洞见与对数据的更深理解。通过我们的 Python 线性回归要点教程或 R 回归入门课程深入学习该主题。
逻辑回归
与线性回归类似,逻辑回归是一种统计分类算法,基于自变量来估计类别结果的概率。通过应用逻辑函数,它可预测特定类别发生的可能性。
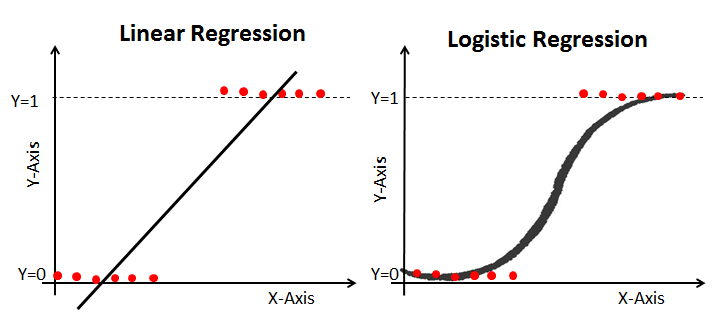
逻辑回归与线性回归
决策树
决策树是利用统计方法按特征对数据进行划分、构建用于分类或回归的树状结构的多功能算法。它直观、可解释,且可处理分类与数值数据。
基于统计的度量(如基尼不纯度或信息增益)常用于指导整棵树的划分过程。
您可以在单独的教程中学习 Python 决策树分类,或探索使用 R 进行机器学习中的决策树。
随机森林
随机森林是一种集成学习方法,通过组合多棵决策树来提升预测准确率。它通过抽样随机选择特征与数据子集来构建树,然后将各棵树的预测进行汇总以产生最终预测。
该算法之所以强大,是因为它引入了多样性并降低了过拟合。多样性的引入使模型更加稳健与全面,能够捕捉更广泛的数据模式;而过拟合的降低则确保模型对未见数据具有良好的泛化能力,使其成为可靠、精准的预测分析工具。
我们有单独的随机森林分类教程,介绍这种统计技术在机器学习中的使用方法与适用场景。
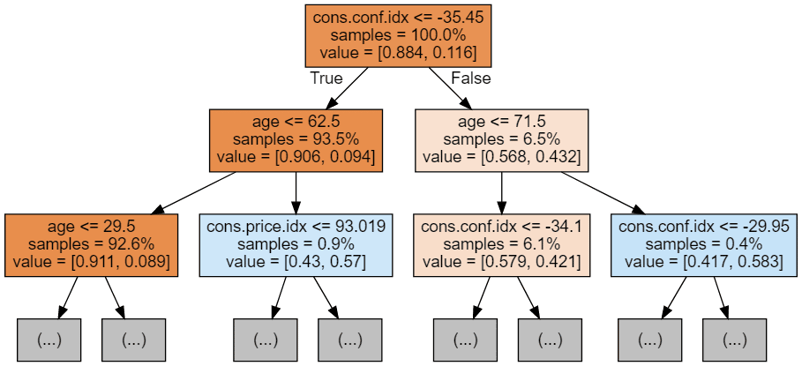
随机森林分类示例
支持向量机(SVM)
SVM 是一种功能强大的算法,可用于分类与回归任务。它运用统计原理在不同数据点群之间创建边界,从而更易区分。通过优化这一边界,SVM 可降低出错概率并提升整体准确率。
我们提供了探索 使用 Python 的 scikit-learn 实现支持向量机以及R 中的 SVM的教程。
K 近邻(KNN)
KNN 是一种简单而高效的算法,通过最近邻的多数投票来为数据点分类。它既适用于分类问题也适用于回归问题,并且不需要训练过程。
在 KNN 中,会使用统计度量来确定数据点之间的接近程度,以识别最近的邻居。随后通过最近邻的多数投票来对目标变量进行分类或预测。
同样,您可以通过我们的使用 scikit-learn 的 K 近邻分类教程更详细地了解 KNN 的概念。
结语
在这个技术不断进步、数据驱动决策蓬勃发展的令人振奋的时代,扎实掌握统计学对于提升我们的机器学习技能至关重要。通过深入学习统计学基础,我们就能开启释放机器学习真正潜力的大门。
无论您是新手还是资深从业者,都可立即开启学习之旅,访问 Statistics Fundamentals with Python 与 Machine Learning Fundamentals with Python 学习路径,深入了解精彩的统计机器学习领域!
参考资料
- All of Statistics (A Concise Course in Statistical Inference),作者 Larry Wasserman
- The Elements of Statistical Learning,作者 Jerome H. Friedman、Robert Tibshirani 与 Trevor Hastie


自美国著名数学家 Samuel S. Wilks 借用 HG Wells 的著作 Mankind in the Making 之意,著名地提出“统计思维终有一天会像读写能力一样,对高效公民身份同样必不可少”以来,已过去七十多年。尽管这一表述或许略显夸张,但其关于统计学重要性的核心观点在当今信息时代依然切中要害。
图片来源:美国统计协会(The American Statistical Association)
随着技术的飞速发展与前所未有的创新,机器学习与生成式 AI 已走到舞台中央。这些进步深刻影响着我们的日常生活,并在大规模上促进了数据驱动的决策。
在围绕这些前沿技术的热议中,统计学始终是机器学习众多突破的基石。它与数据的本质密不可分,而数据正是所有令人兴奋的新技术的根基。
什么是统计机器学习?
顾名思义,统计机器学习指的是使用统计技术来开发能够从数据中学习并进行预测或决策的模型。
本质上,统计机器学习将机器学习算法的计算效率与适应性,与统计推断与建模能力相融合。您可能听过监督学习、无监督学习与半监督学习等技术术语——它们都建立在扎实的统计基础之上。
通过运用统计方法,我们能够从复杂数据集中提取重要的模式、关系与洞见,从而提升机器学习算法的有效性。
统计学在机器学习中的作用
我刚刚说过,统计学从根本上为机器学习算法提供了理论框架。现在,我们不妨更深入地看看二者的差异与融合方式。
统计学是一门使我们能够收集、分析、解释、展示与组织数据的科学。它为理解模式与趋势提供工具,并为基于数据进行推断与预测提供方法。在处理大型数据集时,统计学帮助我们理解并概括数据,让我们能够厘清复杂的模式。
另一方面,机器学习是一种强大的工具,使计算机能够从数据中学习并基于数据做出决策或预测。其最终目标是创建能够随时间自适应、不断改进,并能从具体样本泛化到更广泛情形的模型。
这正是统计学与机器学习融合之美所在。统计学原理构成了支撑机器学习结构的中流砥柱。
因此,扎实的统计学理解不仅有助于我们更好地构建与验证机器学习模型,还能让我们以有意义、可用的方式解读其输出。
接下来看看与机器学习密切相关的一些关键统计概念。您可以在我们的 Statistics Fundamentals with Python 技能路径中进一步学习这些概念并获得动手实践。
概率
概率论在机器学习中至关重要,因为它为不确定性建模与概率性预测提供了基础。我们如何量化不同结果、事件或数值出现的可能性?概率正是解决之道!此外,概率分布在机器学习中特别重要,是许多“魔法”的来源。
常用分布包括 高斯(正态)、伯努利、泊松与指数分布。我们提供了便捷的概率速查表,可作为概率规则的快速参考。
描述性统计
描述性统计帮助我们理解数据集的特征与性质。它们用于汇总与可视化数据、识别模式、检测异常值,并获得指导后续建模与分析的初步洞见。
我们的描述性统计速查表可帮助您学习这些概念
集中趋势度量
均值、中位数与众数可为数据集的中心或代表性取值提供有益洞见。在机器学习中,它们通过辅助填补缺失值与识别潜在异常值来协助数据预处理。
在特征工程中,它们也有助于捕捉影响模型性能的典型或最常见取值。
方差与标准差
方差与标准差量化数据点围绕集中趋势的离散程度。它们可作为机器学习中数据一致性与变异性的指标。
这些度量有助于特征选择或降维,识别预测能力有限的特征。
此外,通过分析预测或残差的变异性,它们有助于评估模型表现,便于比较不同算法。
离散程度度量
极差、四分位距与百分位数等离散度量可揭示数据取值的分布特征。它们在异常值检测中特别有用,帮助识别并处理可能对模型训练与预测产生巨大影响的异常值。在需要对数据进行变换或归一化以提升算法表现的情况下,这些度量亦可提供指导。
抽样
机器学习模型是基于样本数据进行训练的。如果样本选择不当,我们的模型可靠性就会变得不确定。理想情况下,我们希望从更大的总体中选择具有代表性的数据子集。
采用恰当的抽样技术还能确保机器学习模型在多样且无偏的数据上训练,促进技术的伦理且负责任使用。
查看我们的 Sampling in Python 课程,进一步学习这一强大技能。
估计
估计技术对于基于样本数据确定未知总体参数至关重要。它们使我们能够估计模型参数、评估模型表现,并对未见数据进行预测。
机器学习中最常见的估计方法是极大似然(ML)估计,通过最大化似然函数来寻找未知参数的估计量。
假设检验
假设检验为评估机器学习任务中关系或差异的显著性提供了系统方法。它使我们能够检验假设有效性、比较模型,并基于现有证据做出具有统计学意义的决策。
交叉验证
交叉验证(CV)是机器学习中用于评估算法性能与泛化误差的统计技术。其主要目的是防止过拟合,即模型在训练数据上表现良好却无法泛化至未见数据的现象。
通过将数据集划分为多个子集,并在不同组合上迭代训练与评估模型,交叉验证能够更可靠地估计算法在未见数据上的表现。
流行的统计机器学习技术
这些复杂的统计概念是通往高效机器学习算法的第一步。现在让我们探索一些最受欢迎的机器学习模型,看看统计学如何助力它们实现卓越能力。
线性回归
线性回归是统计学文献中常见的术语,但它远不止于此。它也被视为一种监督学习算法,用于刻画因变量与一个或多个自变量之间的关系。
统计学帮助估计系数、开展假设检验并评估关系的显著性,从而提供有价值的洞见与对数据的更深理解。通过我们的 Python 线性回归要点教程或 R 回归入门课程深入学习该主题。
逻辑回归
与线性回归类似,逻辑回归是一种统计分类算法,基于自变量来估计类别结果的概率。通过应用逻辑函数,它可预测特定类别发生的可能性。
逻辑回归与线性回归
决策树
决策树是利用统计方法按特征对数据进行划分、构建用于分类或回归的树状结构的多功能算法。它直观、可解释,且可处理分类与数值数据。
基于统计的度量(如基尼不纯度或信息增益)常用于指导整棵树的划分过程。
您可以在单独的教程中学习 Python 决策树分类,或探索使用 R 进行机器学习中的决策树。
随机森林
随机森林是一种集成学习方法,通过组合多棵决策树来提升预测准确率。它通过抽样随机选择特征与数据子集来构建树,然后将各棵树的预测进行汇总以产生最终预测。
该算法之所以强大,是因为它引入了多样性并降低了过拟合。多样性的引入使模型更加稳健与全面,能够捕捉更广泛的数据模式;而过拟合的降低则确保模型对未见数据具有良好的泛化能力,使其成为可靠、精准的预测分析工具。
我们有单独的随机森林分类教程,介绍这种统计技术在机器学习中的使用方法与适用场景。
随机森林分类示例
支持向量机(SVM)
SVM 是一种功能强大的算法,可用于分类与回归任务。它运用统计原理在不同数据点群之间创建边界,从而更易区分。通过优化这一边界,SVM 可降低出错概率并提升整体准确率。
我们提供了探索 使用 Python 的 scikit-learn 实现支持向量机以及R 中的 SVM的教程。
K 近邻(KNN)
KNN 是一种简单而高效的算法,通过最近邻的多数投票来为数据点分类。它既适用于分类问题也适用于回归问题,并且不需要训练过程。
在 KNN 中,会使用统计度量来确定数据点之间的接近程度,以识别最近的邻居。随后通过最近邻的多数投票来对目标变量进行分类或预测。
同样,您可以通过我们的使用 scikit-learn 的 K 近邻分类教程更详细地了解 KNN 的概念。
结语
在这个技术不断进步、数据驱动决策蓬勃发展的令人振奋的时代,扎实掌握统计学对于提升我们的机器学习技能至关重要。通过深入学习统计学基础,我们就能开启释放机器学习真正潜力的大门。
无论您是新手还是资深从业者,都可立即开启学习之旅,访问 Statistics Fundamentals with Python 与 Machine Learning Fundamentals with Python 学习路径,深入了解精彩的统计机器学习领域!
参考资料