无监督学习是机器学习的一种基础类型,仍在不断发展。这种方法专注于没有对应目标值的输入向量,能够基于相似性、模式和差异来分组并解释信息,近年来取得了显著进展。最新的深度无监督学习模型进一步增强了这种能力,使其能更细致地理解复杂数据集。
到 2024 年,无监督学习算法(传统上不依赖输入到输出的映射)在发现未标注数据潜在结构方面变得更加自主且高效。借助复杂的自监督学习技术,这种摆脱“教师”的独立性得到强化,显著降低了对标注数据的依赖。
此外,该领域在将无监督学习与其他人工智能分支(如强化学习)融合方面也取得了进展,推动系统更加自适应和智能。这类系统擅长识别数据中的模式与异常,为各行业的创新应用铺平道路。本文将更详细地探讨无监督学习的多种类型及其用途。
监督学习 vs 无监督学习
下表比较了无监督学习与监督学习的一些关键差异:
| |
监督学习
|
无监督学习
|
|
目标
|
根据示例的输入-输出对,逼近一个将输入映射到输出的函数。
|
构建数据的精炼表示,并由此生成具有想象力的内容。
|
|
准确性
|
准确度与可靠性高。
|
准确度与可靠性较低。
|
|
复杂度
|
方法较为简单。
|
计算复杂度高。
|
|
类别数量
|
类别数量已知。
|
类别数量未知。
|
|
输出
|
存在期望输出值(也称监督信号)。
|
不存在对应的输出值。
|
无监督学习的类型
在开头我们提到,无监督学习是在没有标签的情况下对数据分组的方法。由于没有标签,无监督学习方法通常用于构建数据的精炼表示,以便从中衍生出具有想象力的内容。
例如,如果我们要发布一款新产品,可以使用无监督学习方法来识别该产品的目标市场:这是因为没有关于目标客户及其人口统计特征的历史信息。
无监督学习可细分为三项主要任务:
让我们分别深入了解:
聚类
从理论上讲,同一组内的实例往往具有相似属性。您可以在元素周期表中观察到这一现象。相隔十八列的同一族元素,其原子最外层具有相同数量的电子,并形成相同类型的化学键。
这正是聚类算法的思路;聚类方法根据未标注数据之间的相似与差异进行分组。当两个实例处于不同组时,我们可以推断它们的属性存在差异。
聚类是无监督学习中非常常见的一类方法,也可以进一步细分为不同类型,例如:
- 互斥聚类:对数据进行分组,使单个数据点只属于一个簇。
- 重叠聚类:软聚类,单个数据点可以不同的隶属度同时属于多个簇。
- 层次聚类:一种聚类方式,使相似实例位于同一组,不同对象分属其他组。
- 概率聚类:使用概率分布来形成簇。
关联规则挖掘
这类无监督学习以基于规则的方式来发现数据集中各特征之间的有趣关系。其工作原理是利用兴趣度量来识别数据集中的强规则。
关联规则挖掘常用于购物篮分析:这是一种数据挖掘技术,零售商据此基于不同产品之间的关系,深入理解顾客的购买模式。
最常用的关联规则学习算法是 Apriori 算法。此外,Eclat 和 FP-growth 等算法也用于此类无监督学习。
降维
常用的降维算法包括主成分分析(PCA)和奇异值分解(SVD)。这些算法旨在在不损失原始数据中有意义属性的前提下,将数据从高维空间映射到低维空间。这些技术通常用于探索性数据分析(EDA)或数据处理阶段,以便为建模做好准备。
在 EDA 中降低数据维度有助于可视化:这是因为可视化三维以上的数据非常困难。从数据处理角度看,降低数据维度可以简化建模问题。
当向模型输入的特征越多,模型就必须学习更复杂的逼近函数。这种现象可概括为“维度诅咒”。
无监督学习的应用
多数管理者对监督学习的应用场景并不陌生;但对无监督学习则未必。
原因之一在于风险的本质。无监督学习比监督学习引入更多风险,因为缺乏在离线环境中与真实标签对照评估结果的明确方式,而在在线环境中评估又可能风险过高。
尽管如此,在企业层面仍有多种有价值的无监督学习用例。除了用于数据探索之外,常见的实际应用包括:
- 自然语言处理(NLP)。Google 新闻据称利用无监督学习,将不同媒体关于同一事件的文章归类。例如,足球转会窗的报道都可归为“足球”。
- 图像与视频分析。如目标识别等视觉感知任务会用到无监督学习。
- 异常检测。用于识别偏离数据集正常行为的数据点、事件和/或观测。
- 客户细分。可通过无监督学习构建有意义的买家画像,帮助企业了解客户的共性特征与购买习惯,从而更好地调整产品。
- 推荐引擎。将过往购买行为与无监督学习结合,可帮助企业发现数据趋势,用于制定有效的交叉销售策略。
Python 中的无监督学习示例
主成分分析(PCA)是先计算主成分,再用其对数据进行基变换的过程。换言之,PCA 是一种无监督学习的降维技术。
对数据集降维主要有两个用途:
- 当数据集维度过多,难以可视化时
- 在构建预测模型时用于特征选择,识别最具预测性的 n 个维度。
本节我们将在鸢尾花数据集上实现Python 版 PCA 算法,并用matplotlib进行可视化。您可查看这个DataLab 工作簿,跟进本教程所用代码。
先导入必要的库和数据。
from sklearn.datasets import load_iris
from sklearn.decomposition import PCA
import matplotlib.pyplot as plt
iris_data = load_iris(as_frame=True)
iris_data.data.head()技术支持
| |
sepal length (cm)
|
sepal width (cm)
|
petal length (cm)
|
petal width (cm)
|
|
0
|
5.1
|
3.5
|
1.4
|
0.2
|
|
1
|
4.9
|
3
|
1.4
|
0.2
|
|
2
|
4.7
|
3.2
|
1.3
|
0.2
|
|
3
|
4.6
|
3.1
|
1.5
|
0.2
|
|
4
|
5
|
3.6
|
1.4
|
0.2
|
鸢尾花数据集包含四个特征。尝试在四维或更高维度中可视化数据是不可能的,因为我们无法直观感知如此高维的形态。退一步来说,可以在三维中呈现,但依然具有挑战。
例如:
"""
Credit: Rishikesh Kumar Rishi
Link: https://www.tutorialspoint.com/how-to-make-a-4d-plot-with-matplotlib-using-arbitrary-data
"""
plt.rcParams["figure.figsize"] = [7.00, 3.50]
plt.rcParams["figure.autolayout"] = True

fig = plt.figure()
ax = fig.add_subplot(111, projection='3d')
sepal_length = iris_data.data["sepal length (cm)"]
sepal_width = iris_data.data["sepal width (cm)"]
petal_length = iris_data.data["petal length (cm)"]
petal_width = iris_data.data["petal width (cm)"]

ax.scatter(sepal_length, sepal_width, petal_length, c=petal_width)
plt.show()技术支持
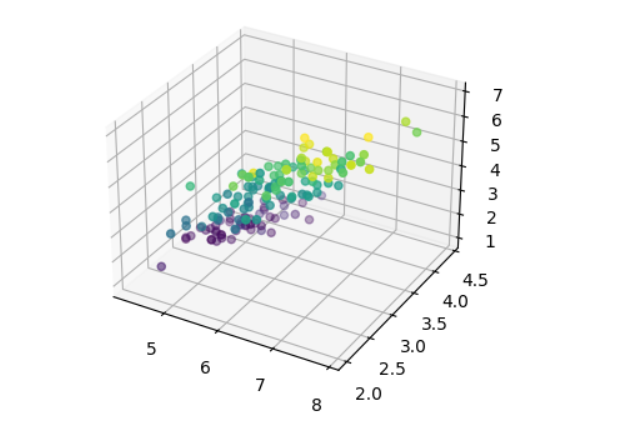
从该可视化中很难获得洞见,因为在三维场景下我们只能从一个视角观察,所有实例都挤在一起。
通过 PCA,我们可以将维度降到二维,从而更容易可视化数据并区分各类。
注意:在“R 语言主成分分析教程”中了解如何在 R 中实现 PCA。
pca = PCA(n_components=2)
pca.fit(iris_data.data)
iris_data_reduced = pca.fit_transform(iris_data.data)
plt.scatter(
iris_data_reduced[:,0],
iris_data_reduced[:,1],
c=iris_data.target
)
plt.show()技术支持
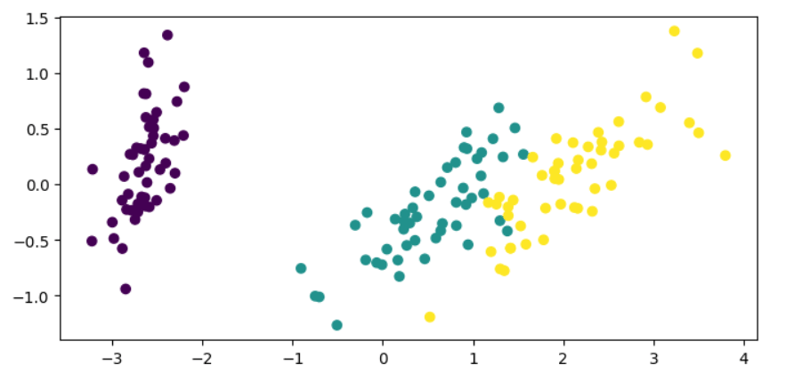
在上述代码中,我们对鸢尾花数据集的特征进行变换,仅保留两个主成分,然后在二维平面上绘制降维后的数据。
现在,我们更容易获取关于数据及类别分离情况的信息。如果要在数据上拟合机器学习模型,这些洞见有助于决定下一步操作。
总结
无监督学习指一类机器学习问题,模型用于表征或提取数据中的关系。
与监督学习不同,无监督学习算法仅利用输入特征来发现数据集的潜在结构。这意味着无监督学习模型不需要像监督学习那样由“教师”进行纠正。
本文介绍了无监督学习的三种主要类型:关联规则挖掘、聚类和降维。您还了解了无监督学习的若干应用,以及如何在 Python 中使用 PCA 算法进行降维。
不妨继续学习以下资源:

无监督学习是机器学习的一种基础类型,仍在不断发展。这种方法专注于没有对应目标值的输入向量,能够基于相似性、模式和差异来分组并解释信息,近年来取得了显著进展。最新的深度无监督学习模型进一步增强了这种能力,使其能更细致地理解复杂数据集。
到 2024 年,无监督学习算法(传统上不依赖输入到输出的映射)在发现未标注数据潜在结构方面变得更加自主且高效。借助复杂的自监督学习技术,这种摆脱“教师”的独立性得到强化,显著降低了对标注数据的依赖。
此外,该领域在将无监督学习与其他人工智能分支(如强化学习)融合方面也取得了进展,推动系统更加自适应和智能。这类系统擅长识别数据中的模式与异常,为各行业的创新应用铺平道路。本文将更详细地探讨无监督学习的多种类型及其用途。
监督学习 vs 无监督学习
下表比较了无监督学习与监督学习的一些关键差异:
监督学习
无监督学习
目标
根据示例的输入-输出对,逼近一个将输入映射到输出的函数。
构建数据的精炼表示,并由此生成具有想象力的内容。
准确性
准确度与可靠性高。
准确度与可靠性较低。
复杂度
方法较为简单。
计算复杂度高。
类别数量
类别数量已知。
类别数量未知。
输出
存在期望输出值(也称监督信号)。
不存在对应的输出值。
无监督学习的类型
在开头我们提到,无监督学习是在没有标签的情况下对数据分组的方法。由于没有标签,无监督学习方法通常用于构建数据的精炼表示,以便从中衍生出具有想象力的内容。
例如,如果我们要发布一款新产品,可以使用无监督学习方法来识别该产品的目标市场:这是因为没有关于目标客户及其人口统计特征的历史信息。
无监督学习可细分为三项主要任务:
让我们分别深入了解:
聚类
从理论上讲,同一组内的实例往往具有相似属性。您可以在元素周期表中观察到这一现象。相隔十八列的同一族元素,其原子最外层具有相同数量的电子,并形成相同类型的化学键。
这正是聚类算法的思路;聚类方法根据未标注数据之间的相似与差异进行分组。当两个实例处于不同组时,我们可以推断它们的属性存在差异。
聚类是无监督学习中非常常见的一类方法,也可以进一步细分为不同类型,例如:
关联规则挖掘
这类无监督学习以基于规则的方式来发现数据集中各特征之间的有趣关系。其工作原理是利用兴趣度量来识别数据集中的强规则。
关联规则挖掘常用于购物篮分析:这是一种数据挖掘技术,零售商据此基于不同产品之间的关系,深入理解顾客的购买模式。
最常用的关联规则学习算法是 Apriori 算法。此外,Eclat 和 FP-growth 等算法也用于此类无监督学习。
降维
常用的降维算法包括主成分分析(PCA)和奇异值分解(SVD)。这些算法旨在在不损失原始数据中有意义属性的前提下,将数据从高维空间映射到低维空间。这些技术通常用于探索性数据分析(EDA)或数据处理阶段,以便为建模做好准备。
在 EDA 中降低数据维度有助于可视化:这是因为可视化三维以上的数据非常困难。从数据处理角度看,降低数据维度可以简化建模问题。
当向模型输入的特征越多,模型就必须学习更复杂的逼近函数。这种现象可概括为“维度诅咒”。
无监督学习的应用
多数管理者对监督学习的应用场景并不陌生;但对无监督学习则未必。
原因之一在于风险的本质。无监督学习比监督学习引入更多风险,因为缺乏在离线环境中与真实标签对照评估结果的明确方式,而在在线环境中评估又可能风险过高。
尽管如此,在企业层面仍有多种有价值的无监督学习用例。除了用于数据探索之外,常见的实际应用包括:
Python 中的无监督学习示例
主成分分析(PCA)是先计算主成分,再用其对数据进行基变换的过程。换言之,PCA 是一种无监督学习的降维技术。
对数据集降维主要有两个用途:
本节我们将在鸢尾花数据集上实现Python 版 PCA 算法,并用matplotlib进行可视化。您可查看这个DataLab 工作簿,跟进本教程所用代码。
先导入必要的库和数据。
sepal length (cm)
sepal width (cm)
petal length (cm)
petal width (cm)
0
5.1
3.5
1.4
0.2
1
4.9
3
1.4
0.2
2
4.7
3.2
1.3
0.2
3
4.6
3.1
1.5
0.2
4
5
3.6
1.4
0.2
鸢尾花数据集包含四个特征。尝试在四维或更高维度中可视化数据是不可能的,因为我们无法直观感知如此高维的形态。退一步来说,可以在三维中呈现,但依然具有挑战。
例如:
从该可视化中很难获得洞见,因为在三维场景下我们只能从一个视角观察,所有实例都挤在一起。
通过 PCA,我们可以将维度降到二维,从而更容易可视化数据并区分各类。
注意:在“R 语言主成分分析教程”中了解如何在 R 中实现 PCA。
在上述代码中,我们对鸢尾花数据集的特征进行变换,仅保留两个主成分,然后在二维平面上绘制降维后的数据。
现在,我们更容易获取关于数据及类别分离情况的信息。如果要在数据上拟合机器学习模型,这些洞见有助于决定下一步操作。
总结
无监督学习指一类机器学习问题,模型用于表征或提取数据中的关系。
与监督学习不同,无监督学习算法仅利用输入特征来发现数据集的潜在结构。这意味着无监督学习模型不需要像监督学习那样由“教师”进行纠正。
本文介绍了无监督学习的三种主要类型:关联规则挖掘、聚类和降维。您还了解了无监督学习的若干应用,以及如何在 Python 中使用 PCA 算法进行降维。
不妨继续学习以下资源: