

SVM 是一个令人兴奋的算法,其概念相对简单。分类器使用具有最大间隔的超平面来分隔数据点。这也是为什么 SVM 分类器被称为判别式分类器。SVM 会找到一个最优超平面,帮助对新的数据点进行分类。
在本教程中,您将学习以下主题:
观看我们课程中的视频,用 Scikit-learn 了解更多支持向量机。
支持向量机
一般来说,支持向量机被视为一种分类方法,但它既可用于分类问题,也可用于回归问题。它可以轻松处理多个连续型和分类型变量。SVM 在多维空间中构造一个超平面来分隔不同的类别。SVM 以迭代方式生成最优超平面,用于最小化误差。SVM 的核心思想是找到能最佳划分数据集到不同类别的最大间隔超平面(MMH)。
支持向量
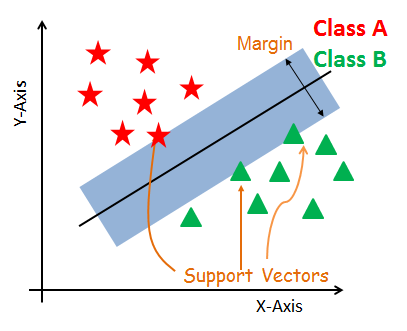
支持向量是距离超平面最近的数据点。通过计算间隔,这些点能更好地定义分隔线。这些点对分类器的构建最为关键。
超平面
超平面是一个决策平面,用于分隔具有不同类别归属的一组对象。
间隔
间隔是指在最接近的类别点上两条线之间的空隙。它被计算为从分隔线到支持向量或最近点的垂直距离。类别之间的间隔越大,通常被认为越好;间隔较小则较差。
SVM 的工作原理是什么?
主要目标是在尽可能好的方式下分隔给定数据集。最近点之间的距离称为间隔。目标是在给定数据集中选择一个在支持向量之间具有最大可能间隔的超平面。SVM 通过以下步骤搜索最大间隔超平面:
-
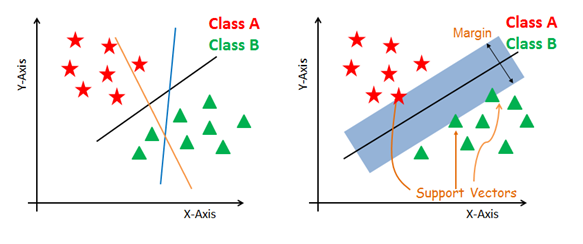
生成能以最佳方式分隔类别的超平面。左图显示了三条超平面:黑色、蓝色和橙色。其中蓝色和橙色的分类错误更高,而黑色能正确分隔两类。
-
选择与最近数据点分隔最大、也就是右图所示的正确超平面。
处理非线性与不可分平面
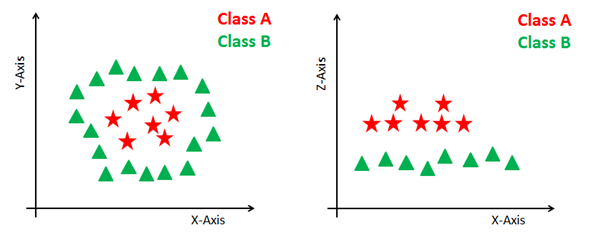
有些问题无法使用线性超平面来解决,如下图(左)所示。
在这种情况下,SVM 使用核技巧将输入空间映射到更高维空间,如右图所示。数据点被绘制在 x 轴和 z 轴上(Z 为 x 和 y 的平方和:z=x^2=y^2)。现在您可以通过线性分隔轻松分开这些点。
SVM 核函数
在实践中,SVM 算法通过核函数来实现。核函数会将输入数据空间转换为所需的形式。SVM 使用一种称为核技巧的技术。核会将低维输入空间转换为更高维空间。换句话说,通过增加维度,它能把不可分问题转换为可分问题。这在非线性分隔问题中最有用。核技巧有助于构建更准确的分类器。
- 线性核 线性核可以像普通点积一样用于任意两条观测的计算。两个向量的乘积是每对输入值相乘后求和。
K(x, xi) = sum(x * xi)
- 多项式核 多项式核是线性核的更一般形式。多项式核可以区分弯曲或非线性的输入空间。
K(x,xi) = 1 + sum(x * xi)^d
其中 d 为多项式的阶。d=1 与线性变换相似。该阶数需要在学习算法中手动指定。
- 径向基函数核 径向基函数(RBF)核是支持向量机分类中常用的一种核函数。RBF 可以将输入空间映射到无限维空间。
K(x,xi) = exp(-gamma * sum((x – xi^2))
其中 gamma 是一个参数,范围为 0 到 1。gamma 值越大,越能完美拟合训练数据集,但会导致过拟合。一般认为 Gamma=0.1 是一个不错的默认值。gamma 的取值需要在学习算法中手动指定。
在 Scikit-learn 中构建分类器
到目前为止,您已经了解了 SVM 的理论背景。现在将学习如何使用 scikit-learn 在 Python 中实现它。
在建模部分,您可以使用乳腺癌数据集,这是一个非常著名的多分类问题。该数据集由对乳腺肿块的细针抽吸(FNA)图像进行数字化后计算得到,描述了图像中细胞核的特征。
该数据集包含 30 个特征(平均半径、平均纹理、平均周长、平均面积、平均平滑度、平均致密度、平均凹度、平均凹点数、平均对称性、平均分形维数、半径误差、纹理误差、周长误差、面积误差、平滑度误差、致密度误差、凹度误差、凹点误差、对称性误差、分形维数误差、最差半径、最差纹理、最差周长、最差面积、最差平滑度、最差致密度、最差凹度、最差凹点数、最差对称性和最差分形维数)以及一个目标变量(癌症类型)。
该数据包含两类癌症:恶性(有害)和良性(无害)。在这里,您可以构建一个模型来对癌症类型进行分类。该数据集可在 scikit-learn 库中获取,您也可以从 UCI 机器学习库下载。
在线运行和编辑此教程中的代码
运行代码加载数据
首先加载您将使用的数据集。
#Import scikit-learn dataset library
from sklearn import datasets
#Load dataset
cancer = datasets.load_breast_cancer()
探索数据
加载数据集后,您可能希望进一步了解它。您可以查看特征名和目标名。
# print the names of the 13 features
print("Features: ", cancer.feature_names)
# print the label type of cancer('malignant' 'benign')
print("Labels: ", cancer.target_names)
Features: ['mean radius' 'mean texture' 'mean perimeter' 'mean area'
'mean smoothness' 'mean compactness' 'mean concavity'
'mean concave points' 'mean symmetry' 'mean fractal dimension'
'radius error' 'texture error' 'perimeter error' 'area error'
'smoothness error' 'compactness error' 'concavity error'
'concave points error' 'symmetry error' 'fractal dimension error'
'worst radius' 'worst texture' 'worst perimeter' 'worst area'
'worst smoothness' 'worst compactness' 'worst concavity'
'worst concave points' 'worst symmetry' 'worst fractal dimension']
Labels: ['malignant' 'benign']
再多探索一下。您还可以使用 shape 查看数据集的形状。
# print data(feature)shape
cancer.data.shape
(569, 30)
查看特征集的前 5 条记录。
# print the cancer data features (top 5 records)
print(cancer.data[0:5])
[[1.799e+01 1.038e+01 1.228e+02 1.001e+03 1.184e-01 2.776e-01 3.001e-01
1.471e-01 2.419e-01 7.871e-02 1.095e+00 9.053e-01 8.589e+00 1.534e+02
6.399e-03 4.904e-02 5.373e-02 1.587e-02 3.003e-02 6.193e-03 2.538e+01
1.733e+01 1.846e+02 2.019e+03 1.622e-01 6.656e-01 7.119e-01 2.654e-01
4.601e-01 1.189e-01]
[2.057e+01 1.777e+01 1.329e+02 1.326e+03 8.474e-02 7.864e-02 8.690e-02
7.017e-02 1.812e-01 5.667e-02 5.435e-01 7.339e-01 3.398e+00 7.408e+01
5.225e-03 1.308e-02 1.860e-02 1.340e-02 1.389e-02 3.532e-03 2.499e+01
2.341e+01 1.588e+02 1.956e+03 1.238e-01 1.866e-01 2.416e-01 1.860e-01
2.750e-01 8.902e-02]
[1.969e+01 2.125e+01 1.300e+02 1.203e+03 1.096e-01 1.599e-01 1.974e-01
1.279e-01 2.069e-01 5.999e-02 7.456e-01 7.869e-01 4.585e+00 9.403e+01
6.150e-03 4.006e-02 3.832e-02 2.058e-02 2.250e-02 4.571e-03 2.357e+01
2.553e+01 1.525e+02 1.709e+03 1.444e-01 4.245e-01 4.504e-01 2.430e-01
3.613e-01 8.758e-02]
[1.142e+01 2.038e+01 7.758e+01 3.861e+02 1.425e-01 2.839e-01 2.414e-01
1.052e-01 2.597e-01 9.744e-02 4.956e-01 1.156e+00 3.445e+00 2.723e+01
9.110e-03 7.458e-02 5.661e-02 1.867e-02 5.963e-02 9.208e-03 1.491e+01
2.650e+01 9.887e+01 5.677e+02 2.098e-01 8.663e-01 6.869e-01 2.575e-01
6.638e-01 1.730e-01]
[2.029e+01 1.434e+01 1.351e+02 1.297e+03 1.003e-01 1.328e-01 1.980e-01
1.043e-01 1.809e-01 5.883e-02 7.572e-01 7.813e-01 5.438e+00 9.444e+01
1.149e-02 2.461e-02 5.688e-02 1.885e-02 1.756e-02 5.115e-03 2.254e+01
1.667e+01 1.522e+02 1.575e+03 1.374e-01 2.050e-01 4.000e-01 1.625e-01
2.364e-01 7.678e-02]]
再看看目标集。
# print the cancer labels (0:malignant, 1:benign)
print(cancer.target)
[0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0 1 1 1 0 0 0 0 0 0 0 0 0 0 0 0 0 0 0
1 0 0 0 0 0 0 0 0 1 0 1 1 1 1 1 0 0 1 0 0 1 1 1 1 0 1 0 0 1 1 1 1 0 1 0 0
1 0 1 0 0 1 1 1 0 0 1 0 0 0 1 1 1 0 1 1 0 0 1 1 1 0 0 1 1 1 1 0 1 1 0 1 1
1 1 1 1 1 1 0 0 0 1 0 0 1 1 1 0 0 1 0 1 0 0 1 0 0 1 1 0 1 1 0 1 1 1 1 0 1
1 1 1 1 1 1 1 1 0 1 1 1 1 0 0 1 0 1 1 0 0 1 1 0 0 1 1 1 1 0 1 1 0 0 0 1 0
1 0 1 1 1 0 1 1 0 0 1 0 0 0 0 1 0 0 0 1 0 1 0 1 1 0 1 0 0 0 0 1 1 0 0 1 1
1 0 1 1 1 1 1 0 0 1 1 0 1 1 0 0 1 0 1 1 1 1 0 1 1 1 1 1 0 1 0 0 0 0 0 0 0
0 0 0 0 0 0 0 1 1 1 1 1 1 0 1 0 1 1 0 1 1 0 1 0 0 1 1 1 1 1 1 1 1 1 1 1 1
1 0 1 1 0 1 0 1 1 1 1 1 1 1 1 1 1 1 1 1 1 0 1 1 1 0 1 0 1 1 1 1 0 0 0 1 1
1 1 0 1 0 1 0 1 1 1 0 1 1 1 1 1 1 1 0 0 0 1 1 1 1 1 1 1 1 1 1 1 0 0 1 0 0
0 1 0 0 1 1 1 1 1 0 1 1 1 1 1 0 1 1 1 0 1 1 0 0 1 1 1 1 1 1 0 1 1 1 1 1 1
1 0 1 1 1 1 1 0 1 1 0 1 1 1 1 1 1 1 1 1 1 1 1 0 1 0 0 1 0 1 1 1 1 1 0 1 1
0 1 0 1 1 0 1 0 1 1 1 1 1 1 1 1 0 0 1 1 1 1 1 1 0 1 1 1 1 1 1 1 1 1 1 0 1
1 1 1 1 1 1 0 1 0 1 1 0 1 1 1 1 1 0 0 1 0 1 0 1 1 1 1 1 0 1 1 0 1 0 1 0 0
1 1 1 0 1 1 1 1 1 1 1 1 1 1 1 0 1 0 0 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1 1
1 1 1 1 1 1 1 0 0 0 0 0 0 1]
拆分数据
为了理解模型表现,将数据集划分为训练集和测试集是一个好策略。
使用函数 train_test_split() 拆分数据集。您需要传入 3 个参数:特征、目标和测试集大小。此外,您可以使用 random_state 来随机选择记录。
# Import train_test_split function
from sklearn.model_selection import train_test_split
# Split dataset into training set and test set
X_train, X_test, y_train, y_test = train_test_split(cancer.data, cancer.target, test_size=0.3,random_state=109) # 70% training and 30% test
生成模型
我们来构建支持向量机模型。首先导入 SVM 模块,并在 SVC() 函数中通过参数 kernel 指定线性核来创建支持向量分类器对象。
然后,使用 fit() 在训练集上拟合模型,并使用 predict() 对测试集进行预测。
#Import svm model
from sklearn import svm
#Create a svm Classifier
clf = svm.SVC(kernel='linear') # Linear Kernel
#Train the model using the training sets
clf.fit(X_train, y_train)
#Predict the response for test dataset
y_pred = clf.predict(X_test)
评估模型
我们来估计分类器或模型对患者乳腺癌的预测准确度。
可通过比较测试集的真实值与预测值来计算准确率。
#Import scikit-learn metrics module for accuracy calculation
from sklearn import metrics
# Model Accuracy: how often is the classifier correct?
print("Accuracy:",metrics.accuracy_score(y_test, y_pred))
Accuracy: 0.9649122807017544
结果显示分类准确率为 96.49%,可认为非常好。
为进一步评估,您还可以查看模型的精确率和召回率。
# Model Precision: what percentage of positive tuples are labeled as such?
print("Precision:",metrics.precision_score(y_test, y_pred))
# Model Recall: what percentage of positive tuples are labelled as such?
print("Recall:",metrics.recall_score(y_test, y_pred))
Precision: 0.9811320754716981
Recall: 0.9629629629629629
精确率为 98%、召回率为 96%,同样是非常不错的结果。
超参数调优
- 核函数:核函数的主要作用是将给定的数据集输入转换为所需形式。常见类型包括线性、多项式和径向基函数(RBF)。多项式核和 RBF 适用于非线性超平面。多项式与 RBF 核在更高维空间中计算分隔线。在某些应用中,建议使用更复杂的核来分隔弯曲或非线性的类别。这种变换可以带来更准确的分类器。
- 正则化:在 Python 的 Scikit-learn 中,参数 C 用于控制正则化。这里的 C 是惩罚参数,表示误分类或误差项。误分类或误差项告诉 SVM 优化可容忍多少误差。由此您可以在决策边界与误分类项之间进行权衡。较小的 C 会产生小间隔超平面,而较大的 C 会产生大间隔超平面。
- Gamma:较低的 Gamma 值会对训练数据拟合较松,而较高的 Gamma 值会严格拟合训练数据,导致过拟合。换言之,较低的 gamma 值在计算分隔线时只考虑邻近点,而较高的 gamma 值会在计算分隔线时考虑所有数据点。
优点
与朴素贝叶斯算法相比,SVM 分类器具有较好的准确率且预测更快。由于在决策阶段只使用训练点的一个子集,它们也更省内存。SVM 在分隔边界清晰且维度较高的空间中表现良好。
缺点
由于训练时间较长,SVM 不适用于大型数据集;与朴素贝叶斯相比,其训练也更耗时。对于类别重叠的情况表现不佳,并且对所使用的核类型较为敏感。
总结
恭喜您读完本教程!
在本教程中,您学习了支持向量机算法、其工作原理、核函数、超参数调优,以及使用 Scikit-learn 包在乳腺癌数据集上的建模与评估。您还了解了它的优缺点。希望这些内容对您有所帮助!
若想进一步学习这类分类器,欢迎查看我们的课程Python 中的线性分类器。该课程介绍了其他类型的回归与损失函数,以及支持向量机。
期待您的反馈或问题。您可以留言提问,我会尽力解答。
与逻辑回归、决策树等其他分类器相比,SVM 具有很高的准确率。它以“核技巧”闻名,可用于处理非线性输入空间。SVM 广泛应用于人脸检测、入侵检测、电子邮件、新闻文章和网页分类、基因分类以及手写识别等场景。
在本教程中,您将使用Python 中的 scikit-learn。如果您想进一步了解这个 Python 包,建议查看我们的课程使用 scikit-learn 进行监督学习。