

假设检验
伯努利分布在假设检验中至关重要,尤其是在处理比例或成功率时。常见应用包括:
- 市场营销中的 A/B 测试:比较两种不同营销策略的成功率。通过我们的Python 中的客户分析与 A/B 测试课程以及R 中的 A/B 测试跟练获取更多内容。
- 质量控制:检验制造过程中的缺陷率是否超过某一阈值。
- 临床试验:评估新疗法相较安慰剂的疗效。
在这些情境中,原假设通常假定成功概率p为某一特定值,而备择假设则基于观测数据对该假定提出质疑。
仿真与建模
伯努利分布在仿真与概率建模中十分便利,尤其适用于具有二元结果的情景。它们用于:
- 蒙特卡罗仿真:对包含众多二元决策点的复杂系统进行建模。参阅我们的蒙特卡罗方法入门教程了解更多。
- 风险分析:评估商业场景中的成功或失败概率。
- 群体遗传学:在遗传研究中对性状遗传进行建模。
通过从伯努利分布中生成随机样本,研究者与数据科学家可以创建对复杂系统和过程的逼真仿真。
性能考量
在数据分析和机器学习中使用伯努利分布时,需要注意以下性能方面的考量:
处理类别不平衡
在许多真实场景中,伯努利分布的成功概率p并不等于 0.5,从而导致数据集类别不平衡。这种不平衡会给机器学习算法带来挑战,可能使其偏向多数类。应对策略包括:
- 少数类过采样:使用 SMOTE(合成少数类过采样技术)等方法生成少数类的合成样本。
- 多数类欠采样:随机移除多数类样本以平衡数据集。
- 调整类别权重:在模型训练中给予少数类更高的重要性。
- 使用集成方法:如随机森林或梯度提升等技术通常比单一模型更能处理不平衡数据。阅读我们的什么是提升法教程,系统了解提升法和更广泛的集成方法。
- 选择合适的评估指标:对于不平衡数据集,仅用准确率可能具有误导性。可考虑 F1 分数、精确率、召回率或 ROC 曲线下面积等指标。
计算效率
伯努利分布在二元分类等大规模数据任务中具有良好的计算效率。但仍需注意以下方面:
- 向量化:实现基于伯努利的算法时,使用向量化运算(如 Python 中的 NumPy)以提升性能。
- 稀疏性:在使用伯努利朴素贝叶斯进行文本分类时,利用稀疏矩阵表示可显著降低内存使用并缩短计算时间。
- 模型复杂度的权衡:更复杂的模型可能带来略微的性能提升,但计算成本未必总是值得。需要在模型精度与处理时间之间取得平衡。
常见误解
要全面理解伯努利分布,需澄清一些常见误解:
误解成功概率
一个常见误解是认为伯努利分布的成功概率p总是 0.5。实际上,p可以取 0 到 1(含端点)之间的任何值。p的取值取决于所建模的具体情境或过程。
例如:
- 在公平的抛硬币中,p = 0.5。
- 在一枚做过手脚的骰子中,将掷出 6 视为成功,p可能为 1/4。
- 在缺陷率为 1% 的质量控制过程中,将“缺陷”视为成功事件,则p为 0.01。
从数据中准确估计p对正确的统计推断与建模至关重要,这通常涉及采集具有代表性的样本并计算成功比例。
伯努利分布 vs. 二项分布
伯努利分布有时会与二项分布混淆。二者有关联,但并不相同:
- 伯努利分布刻画一次试验,只有两种可能结果。
- 二项分布刻画在固定次数、相互独立的伯努利试验中成功的次数。
换言之,二项分布是多个独立伯努利分布的和。比如,您将硬币抛掷 10 次并统计正面次数,这就是二项分布。而每一次单独的抛掷都服从伯努利分布。我们来进行可视化比较:
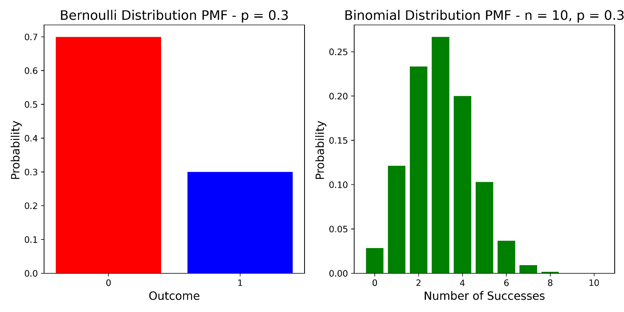
伯努利分布与二项分布对比。图片作者自制。
该比较清楚地展示了两者的根本差异:
- 伯努利分布(左)表示一次试验,只有两种可能结果:0(失败)或 1(成功)。在本例中,p = 0.3,失败概率为 70%,成功概率为 30%。
- 二项分布(右)表示多次试验中的成功次数(此处为 10 次试验)。它给出了获得每个可能成功次数(从 0 到 10)的概率。该分布的形状由n(试验次数)与p(每次试验的成功概率)共同决定。
伯努利分布的可能结果始终只有两种,而二项分布可以有n+1种可能结果,其中n为试验次数。
伯努利分布的替代方案
尽管伯努利分布应用广泛,但在某些情境下其他分布可能更合适。我们来看看两个常见替代:
二项分布
当您面对的是多次试验而非单次事件时,二项分布更为合适。当您关注的是多次尝试中的成功次数而非单次结果时,通常会考虑这种替代方案。
几何分布
当您关心实现首次成功所需的尝试次数时,几何分布便派上用场。它通常应用于关注等待时间或成功前尝试次数的场景。
结论
伯努利分布是众多统计概念的基础,也是数据科学中的关键组成部分。其简单的二元特性,加之在机器学习、假设检验与仿真中的广泛应用,使其成为分析与建模二元结果的重要框架。
要点如下:
- 伯努利分布刻画具有两种可能结果的单次试验。
- 成功概率p是定义分布的关键参数。
- 它在二元分类、假设检验与仿真中有广泛应用。
- 理解其性质与常见误解有助于有效应用。
- 尽管强大,但在特定情境中,二项分布和几何分布等替代方案可能更为适用。
如果您希望在特定编程环境中应用这些概念,我们的Python 统计学入门课程与R 统计学入门课程提供实用的动手学习体验。若您已准备好探索更高级主题,R 中的混合模型课程将在这些基础之上,带您深入更复杂的统计建模技术。最后,查看我们的Python 生产环境中的机器学习技能路径,将您的机器学习技能提升至生产级并开始部署高级模型。

Vinod Chugani 的职业生涯始于东京,曾任摩根大通最年轻的对冲基金销售台负责人,随后在雷曼兄弟创下个人销售纪录,之后又打造了覆盖 30 个国家的电子分销业务,营收突破 1 亿新元,随后转向数据领域。他毕业于杜克大学经济学专业,亦为 NYC Data Science Academy 校友,并在 100 多名申请者中成为Hugo Bowne-Anderson 在 Maven 开设的 “Building AI Applications” 课程的三位奖学金获得者之一。目前,他为 DataCamp、KDnuggets、Machine Learning Mastery 和 Statology 撰稿,内容涵盖从统计学到代理式 AI 等主题,并在 NYC Data Science Academy 指导数据从业者,已完成超过 1,000 场一对一辅导。
常见问题解答
什么是伯努利分布?
伯努利分布是一种离散概率分布,适用于只有两种可能结果的随机变量:成功(通常记为 1)或失败(通常记为 0)。它由单一参数p刻画,p表示成功的概率。
伯努利分布与二项分布有何区别?
伯努利分布刻画一次具有两种可能结果的试验;而二项分布刻画在固定次数、相互独立的伯努利试验中成功的次数。您可以将二项分布视为多个伯努利分布的和。
伯努利分布可以用于假设检验吗?
是的,伯努利分布常用于假设检验,尤其适用于涉及比例或成功率的情景。它们在 A/B 测试中尤为有用,可用于比较两种不同策略或处理方式的成功率。
伯努利分布与赔率和对数赔率有何关系?
伯努利试验中的成功赔率为p/(1-p),其中p为成功概率。对数赔率(亦称 logit 函数)是赔率的自然对数。这些概念常用于逻辑回归和其他统计分析。
如何从数据中估计伯努利分布的参数 p?
估计p的最常见方法是极大似然估计(MLE)。对于伯努利分布,p的极大似然估计就是样本中的成功比例。例如,如果在 10 次试验中观察到 7 次成功,则对p的估计为 0.7。
伯努利分布是统计学和数据科学中的基础概念。它以瑞士数学家雅各布·伯努利命名,在概率论中占据重要地位,并作为更复杂统计模型的基石——从预测客户行为到开发机器学习算法,无所不包。
开始之前,您可以参考我们的统计学入门课程,回顾概率分布的基础。还可以学习Python 概率基础课程,专注于两种可能结果的问题并实践使用
scipy库。我们的Python 的统计思维(第一部分)课程同样是不错的选择,可教您编写自己的 Python 函数来执行伯努利试验。什么是伯努利分布?
伯努利分布是一种离散概率分布,用于刻画只有两种可能结果的随机变量。这两种结果通常标记为“成功”和“失败”,或用数字 1 和 0 表示。
伯努利试验
先从伯努利试验说起。伯努利试验是一种恰有两种可能结果的随机实验。经典示例包括:
每次伯努利试验彼此独立,意味着某一次试验的结果不会影响后续试验的成功概率。
伯努利分布
伯努利分布描述一次伯努利试验中成功的概率。它由单一参数p刻画,该参数表示成功的概率。相应地,失败的概率为1 - p。 从数学上,我们可以如下表示伯努利分布,其中X是表示伯努利试验结果的随机变量。
为展示成功概率不同时时伯努利分布的变化,我们比较三个示例。
不同 p 值下伯努利分布的比较。图片作者自制。
这里,每个图对应一种不同的伯努利分布。
可以看到,伯努利分布的概率质量函数总是包含两根柱:一根对应失败的概率(X = 0),另一根对应成功的概率(X = 1)。柱高随 p 的取值而变,但总和始终为 1。
伯努利分布的性质
我们来探讨界定伯努利分布的关键特征。
二元结果
伯努利分布最鲜明的特征是其二元性。每次试验只能产生两种可能结果之一:
这种二元特性使伯努利分布在我们关心“是/否”“真/假”或“成功/失败”结果时尤为有用。以下是伯努利分布在数据科学和机器学习中的一些关键优势:
均值与方差
伯努利分布的均值(μ)和方差(σ²)与成功概率p直接相关。
均值
均值等于成功概率。这意味着如果重复进行大量伯努利试验,平均结果将收敛于p。
方差
方差为:σ² = p(1 - p)。当 p = 0.5 时方差最大,且当p趋近 0 或 1 时方差减小。该关系揭示了数据的离散程度及结果所伴随的不确定性。就数据离散而言,伯努利分布的方差意味着:
对称性与非对称性
伯努利分布的形状取决于p的取值:
分布的对称性或非对称性会在多方面影响解读:
伯努利分布的实际应用
伯努利分布在多个领域广泛应用,尤其是在数据科学和统计学中。以下是一些最常见的应用:
机器学习中的二元分类
在机器学习中,伯努利分布在二元分类问题中发挥核心作用。这类问题需要将数据划分为两个类别之一。示例包括:
利用伯努利分布进行二元分类的算法包括: