प्रसिद्ध अमेरिकी गणितज्ञ सैमुअल एस. विल्क्स ने लगभग सत्तर वर्ष पहले एच. जी. वेल्स की पुस्तक Mankind in the Making को परिभाषित करते हुए यह प्रसिद्ध वाक्य कहा था, "सांख्यिकीय सोच एक दिन कुशल नागरिकता के लिए पढ़ने-लिखने जितनी ही आवश्यक होगी।" यह कथन भले कुछ अतिशयोक्तिपूर्ण रहा हो, पर आज की सूचना-प्रधान दुनिया में सांख्यिकी के महत्व के बारे में इसका मूल संदेश अब भी उतना ही प्रासंगिक है।
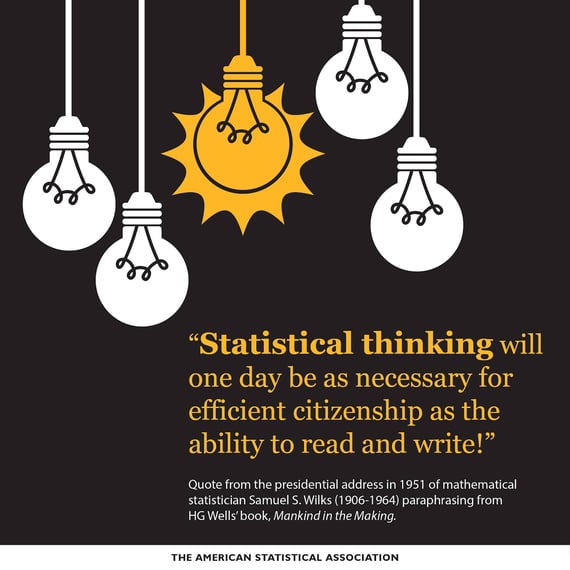
छवि स्रोत: The American Statistical Association
प्रौद्योगिकी की तीव्र प्रगति और अद्वितीय नवाचार के बीच, मशीन लर्निंग और जनरेटिव AI केंद्र में आ गए हैं। इन प्रगतियों ने हमारे निजी जीवन को गहराई से प्रभावित किया है और बड़े पैमाने पर डेटा-आधारित निर्णय लेने को संभव बनाया है।
इन अत्याधुनिक तकनीकों की सारी हलचल के बीच, सांख्यिकी मशीन लर्निंग में हुई अनेक प्रगति की आधारशिला बनी हुई है। यह डेटा के सार से अभिन्न रूप से जुड़ी है, जो हमारे आसपास की सभी रोमांचक नई तकनीकों की नींव है।
सांख्यिकीय मशीन लर्निंग क्या है?
इसके नाम से ही स्पष्ट है कि सांख्यिकीय मशीन लर्निंग में डेटा से सीखने और पूर्वानुमान या निर्णय लेने में सक्षम मॉडल विकसित करने के लिए सांख्यिकीय तकनीकों का उपयोग किया जाता है।
मूल रूप से, सांख्यिकीय मशीन लर्निंग मशीन लर्निंग एल्गोरिद्म की संगणनात्मक दक्षता और अनुकूलनशीलता को सांख्यिकीय अनुमान और मॉडलिंग की क्षमताओं के साथ समेटती है। आप ने supervised, unsupervised और semi-supervised learning जैसे तकनीकी शब्द सुने होंगे—ये सभी ठोस सांख्यिकीय आधार पर टिकी हैं।
सांख्यिकीय विधियों को अपनाकर, हम जटिल डेटासेट्स से महत्वपूर्ण पैटर्न, संबंध और अंतर्दृष्टियाँ निकाल सकते हैं, जिससे मशीन लर्निंग एल्गोरिद्म अधिक प्रभावी बनते हैं।
मशीन लर्निंग में सांख्यिकी की भूमिका
मैंने कहा था कि मूलतः सांख्यिकी वह सैद्धांतिक ढांचा देती है जिस पर मशीन लर्निंग एल्गोरिद्म निर्मित होते हैं। अब, मैं उनके अंतरों और एक साथ आने के तरीकों पर थोड़ा और विस्तार से देखना चाहता हूँ।
सांख्यिकी वह विज्ञान है जो हमें डेटा एकत्रित करने, विश्लेषण करने, व्याख्या करने, प्रस्तुत करने और व्यवस्थित करने में सक्षम बनाता है। यह पैटर्न और प्रवृत्तियों को समझने के लिए औज़ार प्रदान करता है, साथ ही डेटा के आधार पर निष्कर्ष और पूर्वानुमान लगाने के औज़ार भी देता है। जब हम बड़े डेटासेट्स से निपटते हैं, तो सांख्यिकी हमें डेटा को समझने और संक्षेपित करने में मदद करती है, जिससे जटिल पैटर्नों का अर्थ लगाया जा सके।
वहीं दूसरी ओर, मशीन लर्निंग एक शक्तिशाली औज़ार है जो कंप्यूटरों को डेटा से सीखने और उसी के आधार पर निर्णय या पूर्वानुमान लगाने में सक्षम बनाता है। मशीन लर्निंग का अंतिम लक्ष्य ऐसे मॉडल बनाना है जो समय के साथ अनुकूलित हों और बेहतर होते जाएँ, तथा विशिष्ट उदाहरणों से व्यापक मामलों तक सामान्यीकरण कर सकें।
यही वह जगह है जहाँ सांख्यिकी और मशीन लर्निंग के मेल की खूबसूरती सामने आती है। सांख्यिकी के सिद्धांत ही मशीन लर्निंग की संरचना को सहारा देने वाले स्तंभ हैं।
- मशीन लर्निंग मॉडल बनाना: सांख्यिकी मशीन लर्निंग में मॉडल बनाने की कार्यविधियाँ और सिद्धांत देती है। उदाहरण के लिए, रैखिक प्रतिगमन मॉडल गुणांकों के अनुमान के लिए least squares जैसी सांख्यिकीय विधि का उपयोग करता है।
- परिणामों की व्याख्या: सांख्यिकीय अवधारणाएँ हमें मशीन लर्निंग मॉडलों द्वारा उत्पन्न परिणामों की व्याख्या करने में मदद करती हैं। p-value, confidence intervals, R-squared आदि जैसी मापें मॉडल के प्रदर्शन पर सांख्यिकीय दृष्टिकोण प्रदान करती हैं।
- मॉडलों का प्रमाणीकरण: मशीन लर्निंग मॉडलों के सत्यापन और परिष्करण के लिए सांख्यिकीय तकनीकें आवश्यक हैं। उदाहरण के लिए, hypothesis testing, cross-validation और bootstrapping जैसी तकनीकें मॉडल के प्रदर्शन को मात्रात्मक बनाती हैं और overfitting जैसी समस्याओं से बचने में मदद करती हैं।
- उन्नत तकनीकों की आधारशिला: यहाँ तक कि कुछ जटिल एल्गोरिद्म, जैसे Neural Networks, के मूल में भी सांख्यिकीय सिद्धांत निहित होते हैं। इन मॉडलों को प्रशिक्षित करने के लिए प्रयुक्त optimization तकनीकें, जैसे gradient descent, सांख्यिकीय सिद्धांतों पर आधारित हैं।
नतीजतन, सांख्यिकी की ठोस समझ न केवल हमें मशीन लर्निंग मॉडल बेहतर तरीके से बनाने और मान्य करने में सक्षम बनाती है, बल्कि उनके आउटपुट की अर्थपूर्ण और उपयोगी व्याख्या करने में भी सहायक होती है।
आइए अब कुछ प्रमुख सांख्यिकीय अवधारणाओं पर नज़र डालते हैं जो मशीन लर्निंग से गहरे तौर पर जुड़ी हैं। इन अवधारणाओं के बारे में और जानने के लिए आप हमारे Statistics Fundamentals with Python स्किल ट्रैक से व्यावहारिक अनुभव प्राप्त कर सकते हैं।
प्रायिकता
प्रायिकता सिद्धांत मशीन लर्निंग में इसलिए अत्यंत महत्वपूर्ण है क्योंकि यह अनिश्चितता का मॉडलिंग करने और प्रायिक पूर्वानुमान लगाने का आधार देता है। विभिन्न परिणामों, घटनाओं, या केवल संख्यात्मक मानों की संभावना को हम कैसे परिमाणित करें? यही काम प्रायिकता करती है! साथ ही, प्रायिकता वितरण मशीन लर्निंग में विशेष रूप से महत्वपूर्ण हैं और यहीं से सारा जादू होता है।
कुछ प्रचलित वितरणों में Gaussian (Normal), Bernoulli, Poisson और Exponential वितरण शामिल हैं। हमारे पास एक उपयोगी प्रायिकता चीट शीट भी है जो प्रायिकता के नियमों के त्वरित संदर्भ के रूप में काम आती है।
वर्णनात्मक सांख्यिकी
वर्णनात्मक सांख्यिकी हमें डेटासेट्स की विशेषताओं और गुणों को समझने में सक्षम बनाती है। यह डेटा को संक्षेपित और दृश्यात्मक बनाने, पैटर्न पहचानने, अपवादों का पता लगाने और ऐसे प्रारंभिक संकेत पाने में मदद करती है जो आगे की मॉडलिंग और विश्लेषण को दिशा देते हैं।

हमारी वर्णनात्मक सांख्यिकी चीट शीट इन अवधारणाओं को सीखने में आपकी मदद कर सकती है
केन्द्रीय प्रवृत्ति के माप
औसत (mean), माध्य (median) और बहुलक (mode) किसी डेटासेट के केन्द्रीय या प्रतिनिधि मानों के बारे में महत्वपूर्ण जानकारी देते हैं। मशीन लर्निंग में, वे डेटा प्रीप्रोसेसिंग के दौरान गुम मानों के प्रत्यारोपण (imputation) और संभावित अपवादों की पहचान में मदद करते हैं।
फीचर इंजीनियरिंग के दौरान भी, ये मान मॉडल के प्रदर्शन को प्रभावित करने वाले सामान्य या सर्वाधिक आवृत्ति वाले मानों को पकड़ने में सहायक होते हैं।
वैरिएंस और मानक विचलन
वैरिएंस और मानक विचलन डेटा बिंदुओं के केन्द्रीय प्रवृत्ति के आसपास फैलाव को परिमाणित करते हैं। ये मशीन लर्निंग में डेटा की सुसंगतता और परिवर्तनशीलता के संकेतक होते हैं।
ये माप फीचर चयन या आयामीयता में कमी के लिए उपयोगी होते हैं, ताकि सीमित भविष्यवाणी-क्षमता वाली विशेषताओं की पहचान की जा सके।
साथ ही, ये पूर्वानुमानों या अवशेषों (residuals) की परिवर्तनशीलता का विश्लेषण करके मॉडल के प्रदर्शन के आकलन में मदद करते हैं, जिससे विभिन्न एल्गोरिद्म का मूल्यांकन और तुलना सुगम होती है।
फैलाव के माप
परास (range), इंटरक्वार्टाइल रेंज और पर्सेंटाइल्स फैलाव के ऐसे माप हैं जो डेटा मानों के वितरण के बारे में अंतर्दृष्टि देते हैं। ये विशेषतः अपवादों का पता लगाने में मूल्यवान हैं, क्योंकि ये ऐसे अपवादों की पहचान और समाधान में मदद करते हैं जो मॉडल प्रशिक्षण और पूर्वानुमान पर अत्यधिक प्रभाव डाल सकते हैं। जहाँ बेहतर एल्गोरिद्मिक प्रदर्शन के लिए डेटा का रूपांतरण या सामान्यीकरण आवश्यक हो, वहाँ ये माप मार्गदर्शन प्रदान करते हैं।
सैंपलिंग
मशीन लर्निंग मॉडल सैंपल किए गए डेटा पर प्रशिक्षित होते हैं। यदि सैंपल सावधानी से न चुने जाएँ, तो हमारे मॉडलों की विश्वसनीयता संदिग्ध हो जाती है। आदर्श रूप से, हम बड़ी आबादी से प्रतिनिधि उपसमुच्चय चुनना चाहते हैं।
उचित सैंपलिंग तकनीकों का उपयोग यह भी सुनिश्चित करता है कि मशीन लर्निंग मॉडल विविध और निष्पक्ष डेटा पर प्रशिक्षित हों, जिससे तकनीक का नैतिक और जिम्मेदार उपयोग संभव हो।
इस शक्तिशाली कौशल के बारे में अधिक जानने के लिए हमारा Sampling in Python कोर्स देखें।
अनुमान
अनुमान तकनीकें मशीन लर्निंग में नमूना डेटा के आधार पर अज्ञात आबादी मापदंडों का निर्धारण करने के लिए अत्यंत महत्वपूर्ण हैं। ये हमें मॉडल पैरामीटर का अनुमान लगाने, मॉडल प्रदर्शन का मूल्यांकन करने और अनदेखे डेटा पर पूर्वानुमान लगाने में सक्षम बनाती हैं।
मशीन लर्निंग में प्रयुक्त सबसे सामान्य अनुमान विधि Maximum Likelihood (ML) estimation है, जो likelihood फ़ंक्शन को अधिकतम करके अज्ञात पैरामीटर का अनुमापक खोजती है।
परिकल्पना परीक्षण
परिकल्पना परीक्षण मशीन लर्निंग कार्यों में संबंधों या अंतरों के महत्व का आकलन करने के लिए एक व्यवस्थित दृष्टिकोण देता है। यह हमें मान्यताओं की वैधता परखने, मॉडलों की तुलना करने और उपलब्ध साक्ष्यों के आधार पर सांख्यिकीय रूप से महत्वपूर्ण निर्णय लेने में सक्षम बनाता है।
क्रॉस-वैलिडेशन
क्रॉस-वैलिडेशन (CV) मशीन लर्निंग में किसी एल्गोरिद्म के प्रदर्शन और सामान्यीकरण त्रुटि का आकलन करने के लिए प्रयुक्त एक सांख्यिकीय तकनीक है। इसका मुख्य उद्देश्य overfitting को रोकना है, जब मॉडल प्रशिक्षण डेटा पर अच्छा प्रदर्शन करता है पर अनदेखे डेटा पर सामान्यीकरण करने में विफल रहता है।
डेटासेट को अनेक उपसमुच्चयों में बाँटकर और विभिन्न संयोजनों पर मॉडल का आवृत्तिमूलक प्रशिक्षण व मूल्यांकन करके, CV अनदेखे डेटा पर एल्गोरिद्म के प्रदर्शन का अधिक विश्वसनीय अनुमान प्रदान करता है।
लोकप्रिय सांख्यिकीय मशीन लर्निंग तकनीकें
ये जटिल सांख्यिकीय अवधारणाएँ प्रभावी मशीन लर्निंग एल्गोरिद्म की ओर शुरुआती कदम हैं। अब आइए कुछ सबसे लोकप्रिय मशीन लर्निंग मॉडलों का अन्वेषण करें और देखें कि सांख्यिकी ने उनकी उल्लेखनीय क्षमताएँ हासिल करने में कैसे मदद की।
रैखिक प्रतिगमन
रैखिक प्रतिगमन सांख्यिकीय साहित्य में अक्सर मिलने वाला शब्द है, पर यह सिर्फ इतना ही नहीं; इसे एक supervised learning एल्गोरिद्म के रूप में भी देखा जाता है जो एक आश्रित चर और एक या एक से अधिक स्वतंत्र चरों के बीच संबंध को पकड़ता है।
सांख्यिकी गुणांकों का अनुमान लगाने, परिकल्पना परीक्षण करने और संबंधों के महत्व का आकलन करने में सहायता करती है, जिससे मूल्यवान अंतर्दृष्टियाँ और डेटा की गहन समझ मिलती है। इस विषय को और विस्तार से जानें हमारे essentials of linear regression in Python ट्यूटोरियल या Introduction to Regression in R कोर्स से।
लॉजिस्टिक प्रतिगमन
रैखिक प्रतिगमन की तरह ही, लॉजिस्टिक प्रतिगमन एक सांख्यिकीय वर्गीकरण एल्गोरिद्म है जो स्वतंत्र चरों के आधार पर श्रेणीबद्ध परिणामों की प्रायिकता का अनुमान लगाता है। लॉजिस्टिक फ़ंक्शन लागू करके, यह किसी विशेष वर्ग की घटना का पूर्वानुमान करता है।
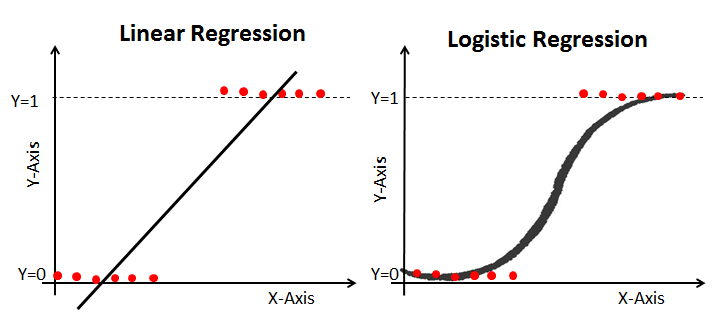
लॉजिस्टिक और रैखिक प्रतिगमन
डिसीजन ट्रीज़
डिसीजन ट्रीज़ बहुउद्देशीय एल्गोरिद्म हैं जो विशेषताओं के आधार पर डेटा को विभाजित करने के लिए सांख्यिकी का उपयोग करते हैं और वर्गीकरण या प्रतिगमन के लिए वृक्ष-सदृश संरचना बनाते हैं। ये सहज, व्याख्यायोग्य होते हैं और श्रेणीबद्ध तथा संख्यात्मक डेटा दोनों को संभालते हैं।
Gini impurity या information gain जैसी सांख्यिकी-आधारित मापें अक्सर ट्री के निर्माण के दौरान विभाजनों का मार्गदर्शन करने के लिए शामिल की जाती हैं।
आप Decision Tree Classification in Python पर एक अलग ट्यूटोरियल देख सकते हैं, या Decision Trees in Machine Learning Using R का अन्वेषण कर सकते हैं।
रैंडम फॉरेस्ट
रैंडम फॉरेस्ट एक एन्सेम्बल लर्निंग विधि है जो अनेक डिसीजन ट्रीज़ को मिलाकर पूर्वानुमान की सटीकता बढ़ाती है। यह ट्री बनाने के लिए विशेषताओं और डेटा के उपसमुच्चयों का यादृच्छ चयन करने हेतु सैंपलिंग का उपयोग करती है। फिर इन व्यक्तिगत ट्रीज़ के पूर्वानुमानों को समेकित करके अंतिम पूर्वानुमान किया जाता है।
यह एल्गोरिद्म शक्तिशाली विकल्प है क्योंकि यह विविधता लाता है और overfitting को घटाता है। विविधता का समावेश मॉडल को अधिक मजबूत और व्यापक बनाता है जो डेटा पैटर्न की विस्तृत श्रृंखला को पकड़ सके, और overfitting में कमी यह सुनिश्चित करती है कि मॉडल अनदेखे डेटा पर भी अच्छी तरह सामान्यीकृत हो—जिससे यह predictive analytics के लिए विश्वसनीय और सटीक औज़ार बनता है।
हमारे पास random forest classification पर एक अलग ट्यूटोरियल है, जिसमें बताया गया है कि मशीन लर्निंग में इस सांख्यिकीय तकनीक का उपयोग कैसे और कब किया जाए।
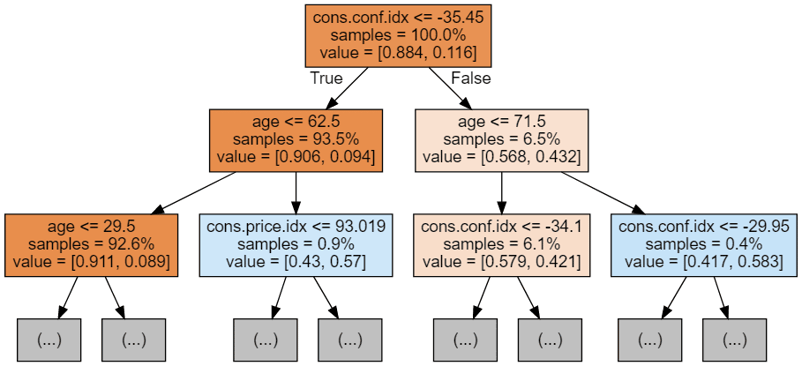
रैंडम फॉरेस्ट वर्गीकरण का एक उदाहरण
सपोर्ट वेक्टर मशीनें (SVM)
SVM एक शक्तिशाली एल्गोरिद्म है जिसका उपयोग वर्गीकरण और प्रतिगमन दोनों कार्यों के लिए किया जा सकता है। यह विभिन्न समूहों के डेटा बिंदुओं के बीच एक सीमा बनाने के लिए सांख्यिकीय सिद्धांतों का उपयोग करता है, जिससे उन्हें अलग-अलग पहचानना आसान हो जाता है। इस सीमा का अनुकूलन करके, SVM त्रुटियों की संभावना घटाता है और समग्र सटीकता में सुधार करता है।
हमारे पास support vector machines with SciKit learn in Python और R में SVMs पर ट्यूटोरियल उपलब्ध हैं।
K-nearest neighbors (KNN)
KNN एक सरल पर प्रभावी एल्गोरिद्म है जो अपने निकटतम पड़ोसियों के बहुमत मत के आधार पर डेटा बिंदुओं का वर्गीकरण करता है। यह वर्गीकरण और प्रतिगमन दोनों समस्याओं के लिए उपयुक्त है और किसी प्रशिक्षण की आवश्यकता नहीं होती।
KNN में, डेटा बिंदुओं के बीच निकटता निर्धारित करने के लिए सांख्यिकीय मापों का उपयोग किया जाता है, जो निकटतम पड़ोसियों की पहचान में मदद करते हैं। इसके बाद निकटतम पड़ोसियों के बहुमत मत से लक्षित चर का वर्गीकरण या पूर्वानुमान किया जाता है।
फिर से, आप हमारे K-Nearst Neighbors Classification with scikit-learn ट्यूटोरियल के साथ KNN की अवधारणा को और विस्तार से समझ सकते हैं।
अंतिम विचार
जैसे-जैसे हम प्रौद्योगिकी के उन्नत होते युग और डेटा-आधारित निर्णय लेने की दुनिया में आगे बढ़ रहे हैं, सांख्यिकी की ठोस समझ हमारी मशीन लर्निंग क्षमताओं को निखारने में अनमोल सिद्ध होती है। सांख्यिकी की बुनियाद में उतरकर, हम मशीन लर्निंग की वास्तविक संभावनाओं को साकार करने का मार्ग खोलते हैं।
चाहे आप नए हों या अनुभवी, अपनी सीखने की यात्रा आज ही Statistics Fundamentals with Python और Machine Learning Fundamentals with Python ट्रैक्स के साथ शुरू करें और सांख्यिकीय मशीन लर्निंग के इस रोचक क्षेत्र के बारे में अधिक जानें!
स्रोत
- All of Statistics (A Concise Course in Statistical Inference) — Larry Wasserman
- The Elements of Statistical Learning — Jerome H. Friedman, Robert Tibshirani, और Trevor Hastie


प्रसिद्ध अमेरिकी गणितज्ञ सैमुअल एस. विल्क्स ने लगभग सत्तर वर्ष पहले एच. जी. वेल्स की पुस्तक Mankind in the Making को परिभाषित करते हुए यह प्रसिद्ध वाक्य कहा था, "सांख्यिकीय सोच एक दिन कुशल नागरिकता के लिए पढ़ने-लिखने जितनी ही आवश्यक होगी।" यह कथन भले कुछ अतिशयोक्तिपूर्ण रहा हो, पर आज की सूचना-प्रधान दुनिया में सांख्यिकी के महत्व के बारे में इसका मूल संदेश अब भी उतना ही प्रासंगिक है।
छवि स्रोत: The American Statistical Association
प्रौद्योगिकी की तीव्र प्रगति और अद्वितीय नवाचार के बीच, मशीन लर्निंग और जनरेटिव AI केंद्र में आ गए हैं। इन प्रगतियों ने हमारे निजी जीवन को गहराई से प्रभावित किया है और बड़े पैमाने पर डेटा-आधारित निर्णय लेने को संभव बनाया है।
इन अत्याधुनिक तकनीकों की सारी हलचल के बीच, सांख्यिकी मशीन लर्निंग में हुई अनेक प्रगति की आधारशिला बनी हुई है। यह डेटा के सार से अभिन्न रूप से जुड़ी है, जो हमारे आसपास की सभी रोमांचक नई तकनीकों की नींव है।
सांख्यिकीय मशीन लर्निंग क्या है?
इसके नाम से ही स्पष्ट है कि सांख्यिकीय मशीन लर्निंग में डेटा से सीखने और पूर्वानुमान या निर्णय लेने में सक्षम मॉडल विकसित करने के लिए सांख्यिकीय तकनीकों का उपयोग किया जाता है।
मूल रूप से, सांख्यिकीय मशीन लर्निंग मशीन लर्निंग एल्गोरिद्म की संगणनात्मक दक्षता और अनुकूलनशीलता को सांख्यिकीय अनुमान और मॉडलिंग की क्षमताओं के साथ समेटती है। आप ने supervised, unsupervised और semi-supervised learning जैसे तकनीकी शब्द सुने होंगे—ये सभी ठोस सांख्यिकीय आधार पर टिकी हैं।
सांख्यिकीय विधियों को अपनाकर, हम जटिल डेटासेट्स से महत्वपूर्ण पैटर्न, संबंध और अंतर्दृष्टियाँ निकाल सकते हैं, जिससे मशीन लर्निंग एल्गोरिद्म अधिक प्रभावी बनते हैं।
मशीन लर्निंग में सांख्यिकी की भूमिका
मैंने कहा था कि मूलतः सांख्यिकी वह सैद्धांतिक ढांचा देती है जिस पर मशीन लर्निंग एल्गोरिद्म निर्मित होते हैं। अब, मैं उनके अंतरों और एक साथ आने के तरीकों पर थोड़ा और विस्तार से देखना चाहता हूँ।
सांख्यिकी वह विज्ञान है जो हमें डेटा एकत्रित करने, विश्लेषण करने, व्याख्या करने, प्रस्तुत करने और व्यवस्थित करने में सक्षम बनाता है। यह पैटर्न और प्रवृत्तियों को समझने के लिए औज़ार प्रदान करता है, साथ ही डेटा के आधार पर निष्कर्ष और पूर्वानुमान लगाने के औज़ार भी देता है। जब हम बड़े डेटासेट्स से निपटते हैं, तो सांख्यिकी हमें डेटा को समझने और संक्षेपित करने में मदद करती है, जिससे जटिल पैटर्नों का अर्थ लगाया जा सके।
वहीं दूसरी ओर, मशीन लर्निंग एक शक्तिशाली औज़ार है जो कंप्यूटरों को डेटा से सीखने और उसी के आधार पर निर्णय या पूर्वानुमान लगाने में सक्षम बनाता है। मशीन लर्निंग का अंतिम लक्ष्य ऐसे मॉडल बनाना है जो समय के साथ अनुकूलित हों और बेहतर होते जाएँ, तथा विशिष्ट उदाहरणों से व्यापक मामलों तक सामान्यीकरण कर सकें।
यही वह जगह है जहाँ सांख्यिकी और मशीन लर्निंग के मेल की खूबसूरती सामने आती है। सांख्यिकी के सिद्धांत ही मशीन लर्निंग की संरचना को सहारा देने वाले स्तंभ हैं।
नतीजतन, सांख्यिकी की ठोस समझ न केवल हमें मशीन लर्निंग मॉडल बेहतर तरीके से बनाने और मान्य करने में सक्षम बनाती है, बल्कि उनके आउटपुट की अर्थपूर्ण और उपयोगी व्याख्या करने में भी सहायक होती है।
आइए अब कुछ प्रमुख सांख्यिकीय अवधारणाओं पर नज़र डालते हैं जो मशीन लर्निंग से गहरे तौर पर जुड़ी हैं। इन अवधारणाओं के बारे में और जानने के लिए आप हमारे Statistics Fundamentals with Python स्किल ट्रैक से व्यावहारिक अनुभव प्राप्त कर सकते हैं।
प्रायिकता
प्रायिकता सिद्धांत मशीन लर्निंग में इसलिए अत्यंत महत्वपूर्ण है क्योंकि यह अनिश्चितता का मॉडलिंग करने और प्रायिक पूर्वानुमान लगाने का आधार देता है। विभिन्न परिणामों, घटनाओं, या केवल संख्यात्मक मानों की संभावना को हम कैसे परिमाणित करें? यही काम प्रायिकता करती है! साथ ही, प्रायिकता वितरण मशीन लर्निंग में विशेष रूप से महत्वपूर्ण हैं और यहीं से सारा जादू होता है।
कुछ प्रचलित वितरणों में Gaussian (Normal), Bernoulli, Poisson और Exponential वितरण शामिल हैं। हमारे पास एक उपयोगी प्रायिकता चीट शीट भी है जो प्रायिकता के नियमों के त्वरित संदर्भ के रूप में काम आती है।
वर्णनात्मक सांख्यिकी
वर्णनात्मक सांख्यिकी हमें डेटासेट्स की विशेषताओं और गुणों को समझने में सक्षम बनाती है। यह डेटा को संक्षेपित और दृश्यात्मक बनाने, पैटर्न पहचानने, अपवादों का पता लगाने और ऐसे प्रारंभिक संकेत पाने में मदद करती है जो आगे की मॉडलिंग और विश्लेषण को दिशा देते हैं।
हमारी वर्णनात्मक सांख्यिकी चीट शीट इन अवधारणाओं को सीखने में आपकी मदद कर सकती है
केन्द्रीय प्रवृत्ति के माप
औसत (mean), माध्य (median) और बहुलक (mode) किसी डेटासेट के केन्द्रीय या प्रतिनिधि मानों के बारे में महत्वपूर्ण जानकारी देते हैं। मशीन लर्निंग में, वे डेटा प्रीप्रोसेसिंग के दौरान गुम मानों के प्रत्यारोपण (imputation) और संभावित अपवादों की पहचान में मदद करते हैं।
फीचर इंजीनियरिंग के दौरान भी, ये मान मॉडल के प्रदर्शन को प्रभावित करने वाले सामान्य या सर्वाधिक आवृत्ति वाले मानों को पकड़ने में सहायक होते हैं।
वैरिएंस और मानक विचलन
वैरिएंस और मानक विचलन डेटा बिंदुओं के केन्द्रीय प्रवृत्ति के आसपास फैलाव को परिमाणित करते हैं। ये मशीन लर्निंग में डेटा की सुसंगतता और परिवर्तनशीलता के संकेतक होते हैं।
ये माप फीचर चयन या आयामीयता में कमी के लिए उपयोगी होते हैं, ताकि सीमित भविष्यवाणी-क्षमता वाली विशेषताओं की पहचान की जा सके।
साथ ही, ये पूर्वानुमानों या अवशेषों (residuals) की परिवर्तनशीलता का विश्लेषण करके मॉडल के प्रदर्शन के आकलन में मदद करते हैं, जिससे विभिन्न एल्गोरिद्म का मूल्यांकन और तुलना सुगम होती है।
फैलाव के माप
परास (range), इंटरक्वार्टाइल रेंज और पर्सेंटाइल्स फैलाव के ऐसे माप हैं जो डेटा मानों के वितरण के बारे में अंतर्दृष्टि देते हैं। ये विशेषतः अपवादों का पता लगाने में मूल्यवान हैं, क्योंकि ये ऐसे अपवादों की पहचान और समाधान में मदद करते हैं जो मॉडल प्रशिक्षण और पूर्वानुमान पर अत्यधिक प्रभाव डाल सकते हैं। जहाँ बेहतर एल्गोरिद्मिक प्रदर्शन के लिए डेटा का रूपांतरण या सामान्यीकरण आवश्यक हो, वहाँ ये माप मार्गदर्शन प्रदान करते हैं।
सैंपलिंग
मशीन लर्निंग मॉडल सैंपल किए गए डेटा पर प्रशिक्षित होते हैं। यदि सैंपल सावधानी से न चुने जाएँ, तो हमारे मॉडलों की विश्वसनीयता संदिग्ध हो जाती है। आदर्श रूप से, हम बड़ी आबादी से प्रतिनिधि उपसमुच्चय चुनना चाहते हैं।
उचित सैंपलिंग तकनीकों का उपयोग यह भी सुनिश्चित करता है कि मशीन लर्निंग मॉडल विविध और निष्पक्ष डेटा पर प्रशिक्षित हों, जिससे तकनीक का नैतिक और जिम्मेदार उपयोग संभव हो।
इस शक्तिशाली कौशल के बारे में अधिक जानने के लिए हमारा Sampling in Python कोर्स देखें।
अनुमान
अनुमान तकनीकें मशीन लर्निंग में नमूना डेटा के आधार पर अज्ञात आबादी मापदंडों का निर्धारण करने के लिए अत्यंत महत्वपूर्ण हैं। ये हमें मॉडल पैरामीटर का अनुमान लगाने, मॉडल प्रदर्शन का मूल्यांकन करने और अनदेखे डेटा पर पूर्वानुमान लगाने में सक्षम बनाती हैं।
मशीन लर्निंग में प्रयुक्त सबसे सामान्य अनुमान विधि Maximum Likelihood (ML) estimation है, जो likelihood फ़ंक्शन को अधिकतम करके अज्ञात पैरामीटर का अनुमापक खोजती है।
परिकल्पना परीक्षण
परिकल्पना परीक्षण मशीन लर्निंग कार्यों में संबंधों या अंतरों के महत्व का आकलन करने के लिए एक व्यवस्थित दृष्टिकोण देता है। यह हमें मान्यताओं की वैधता परखने, मॉडलों की तुलना करने और उपलब्ध साक्ष्यों के आधार पर सांख्यिकीय रूप से महत्वपूर्ण निर्णय लेने में सक्षम बनाता है।
क्रॉस-वैलिडेशन
क्रॉस-वैलिडेशन (CV) मशीन लर्निंग में किसी एल्गोरिद्म के प्रदर्शन और सामान्यीकरण त्रुटि का आकलन करने के लिए प्रयुक्त एक सांख्यिकीय तकनीक है। इसका मुख्य उद्देश्य overfitting को रोकना है, जब मॉडल प्रशिक्षण डेटा पर अच्छा प्रदर्शन करता है पर अनदेखे डेटा पर सामान्यीकरण करने में विफल रहता है।
डेटासेट को अनेक उपसमुच्चयों में बाँटकर और विभिन्न संयोजनों पर मॉडल का आवृत्तिमूलक प्रशिक्षण व मूल्यांकन करके, CV अनदेखे डेटा पर एल्गोरिद्म के प्रदर्शन का अधिक विश्वसनीय अनुमान प्रदान करता है।
लोकप्रिय सांख्यिकीय मशीन लर्निंग तकनीकें
ये जटिल सांख्यिकीय अवधारणाएँ प्रभावी मशीन लर्निंग एल्गोरिद्म की ओर शुरुआती कदम हैं। अब आइए कुछ सबसे लोकप्रिय मशीन लर्निंग मॉडलों का अन्वेषण करें और देखें कि सांख्यिकी ने उनकी उल्लेखनीय क्षमताएँ हासिल करने में कैसे मदद की।
रैखिक प्रतिगमन
रैखिक प्रतिगमन सांख्यिकीय साहित्य में अक्सर मिलने वाला शब्द है, पर यह सिर्फ इतना ही नहीं; इसे एक supervised learning एल्गोरिद्म के रूप में भी देखा जाता है जो एक आश्रित चर और एक या एक से अधिक स्वतंत्र चरों के बीच संबंध को पकड़ता है।
सांख्यिकी गुणांकों का अनुमान लगाने, परिकल्पना परीक्षण करने और संबंधों के महत्व का आकलन करने में सहायता करती है, जिससे मूल्यवान अंतर्दृष्टियाँ और डेटा की गहन समझ मिलती है। इस विषय को और विस्तार से जानें हमारे essentials of linear regression in Python ट्यूटोरियल या Introduction to Regression in R कोर्स से।
लॉजिस्टिक प्रतिगमन
रैखिक प्रतिगमन की तरह ही, लॉजिस्टिक प्रतिगमन एक सांख्यिकीय वर्गीकरण एल्गोरिद्म है जो स्वतंत्र चरों के आधार पर श्रेणीबद्ध परिणामों की प्रायिकता का अनुमान लगाता है। लॉजिस्टिक फ़ंक्शन लागू करके, यह किसी विशेष वर्ग की घटना का पूर्वानुमान करता है।
लॉजिस्टिक और रैखिक प्रतिगमन
डिसीजन ट्रीज़
डिसीजन ट्रीज़ बहुउद्देशीय एल्गोरिद्म हैं जो विशेषताओं के आधार पर डेटा को विभाजित करने के लिए सांख्यिकी का उपयोग करते हैं और वर्गीकरण या प्रतिगमन के लिए वृक्ष-सदृश संरचना बनाते हैं। ये सहज, व्याख्यायोग्य होते हैं और श्रेणीबद्ध तथा संख्यात्मक डेटा दोनों को संभालते हैं।
Gini impurity या information gain जैसी सांख्यिकी-आधारित मापें अक्सर ट्री के निर्माण के दौरान विभाजनों का मार्गदर्शन करने के लिए शामिल की जाती हैं।
आप Decision Tree Classification in Python पर एक अलग ट्यूटोरियल देख सकते हैं, या Decision Trees in Machine Learning Using R का अन्वेषण कर सकते हैं।
रैंडम फॉरेस्ट
रैंडम फॉरेस्ट एक एन्सेम्बल लर्निंग विधि है जो अनेक डिसीजन ट्रीज़ को मिलाकर पूर्वानुमान की सटीकता बढ़ाती है। यह ट्री बनाने के लिए विशेषताओं और डेटा के उपसमुच्चयों का यादृच्छ चयन करने हेतु सैंपलिंग का उपयोग करती है। फिर इन व्यक्तिगत ट्रीज़ के पूर्वानुमानों को समेकित करके अंतिम पूर्वानुमान किया जाता है।
यह एल्गोरिद्म शक्तिशाली विकल्प है क्योंकि यह विविधता लाता है और overfitting को घटाता है। विविधता का समावेश मॉडल को अधिक मजबूत और व्यापक बनाता है जो डेटा पैटर्न की विस्तृत श्रृंखला को पकड़ सके, और overfitting में कमी यह सुनिश्चित करती है कि मॉडल अनदेखे डेटा पर भी अच्छी तरह सामान्यीकृत हो—जिससे यह predictive analytics के लिए विश्वसनीय और सटीक औज़ार बनता है।
हमारे पास random forest classification पर एक अलग ट्यूटोरियल है, जिसमें बताया गया है कि मशीन लर्निंग में इस सांख्यिकीय तकनीक का उपयोग कैसे और कब किया जाए।
रैंडम फॉरेस्ट वर्गीकरण का एक उदाहरण
सपोर्ट वेक्टर मशीनें (SVM)
SVM एक शक्तिशाली एल्गोरिद्म है जिसका उपयोग वर्गीकरण और प्रतिगमन दोनों कार्यों के लिए किया जा सकता है। यह विभिन्न समूहों के डेटा बिंदुओं के बीच एक सीमा बनाने के लिए सांख्यिकीय सिद्धांतों का उपयोग करता है, जिससे उन्हें अलग-अलग पहचानना आसान हो जाता है। इस सीमा का अनुकूलन करके, SVM त्रुटियों की संभावना घटाता है और समग्र सटीकता में सुधार करता है।
हमारे पास support vector machines with SciKit learn in Python और R में SVMs पर ट्यूटोरियल उपलब्ध हैं।
K-nearest neighbors (KNN)
KNN एक सरल पर प्रभावी एल्गोरिद्म है जो अपने निकटतम पड़ोसियों के बहुमत मत के आधार पर डेटा बिंदुओं का वर्गीकरण करता है। यह वर्गीकरण और प्रतिगमन दोनों समस्याओं के लिए उपयुक्त है और किसी प्रशिक्षण की आवश्यकता नहीं होती।
KNN में, डेटा बिंदुओं के बीच निकटता निर्धारित करने के लिए सांख्यिकीय मापों का उपयोग किया जाता है, जो निकटतम पड़ोसियों की पहचान में मदद करते हैं। इसके बाद निकटतम पड़ोसियों के बहुमत मत से लक्षित चर का वर्गीकरण या पूर्वानुमान किया जाता है।
फिर से, आप हमारे K-Nearst Neighbors Classification with scikit-learn ट्यूटोरियल के साथ KNN की अवधारणा को और विस्तार से समझ सकते हैं।
अंतिम विचार
जैसे-जैसे हम प्रौद्योगिकी के उन्नत होते युग और डेटा-आधारित निर्णय लेने की दुनिया में आगे बढ़ रहे हैं, सांख्यिकी की ठोस समझ हमारी मशीन लर्निंग क्षमताओं को निखारने में अनमोल सिद्ध होती है। सांख्यिकी की बुनियाद में उतरकर, हम मशीन लर्निंग की वास्तविक संभावनाओं को साकार करने का मार्ग खोलते हैं।
चाहे आप नए हों या अनुभवी, अपनी सीखने की यात्रा आज ही Statistics Fundamentals with Python और Machine Learning Fundamentals with Python ट्रैक्स के साथ शुरू करें और सांख्यिकीय मशीन लर्निंग के इस रोचक क्षेत्र के बारे में अधिक जानें!
स्रोत