

想象一下,您正穿行在一个迷宫中。每走一步,您都要做出一个决定:是离出口更近,还是更深入迷宫。这很像决策树算法——一种强大而直观的机器学习方法,帮助我们理解复杂数据并选择最佳行动路径。
决策树算法会基于某些条件将数据集不断划分为更小的子集。就像带有叶子和节点的分叉树一样,它从一个根节点开始,向外扩展出多条分支,每条分支都代表基于某个特征取值所作出的决策。树的最终叶子节点即为可能的结果或预测。
本文将使用 R 编程语言带您走进决策树的世界。我们将介绍基础概念,深入讲解常见的决策树算法类型,探索树模型家族方法,并通过一个分步示例进行演练。读完之后,您就能运用决策树的力量,做出更优的数据驱动决策。
什么是机器学习中的决策树?
决策树之所以在机器学习中独树一帜,是因为它简单、可解释且用途广泛。
它是一种监督学习算法,可同时用于回归(预测连续值)和分类(预测类别值)问题。此外,它还是更高级技术(如装袋、提升和随机森林)的基础。
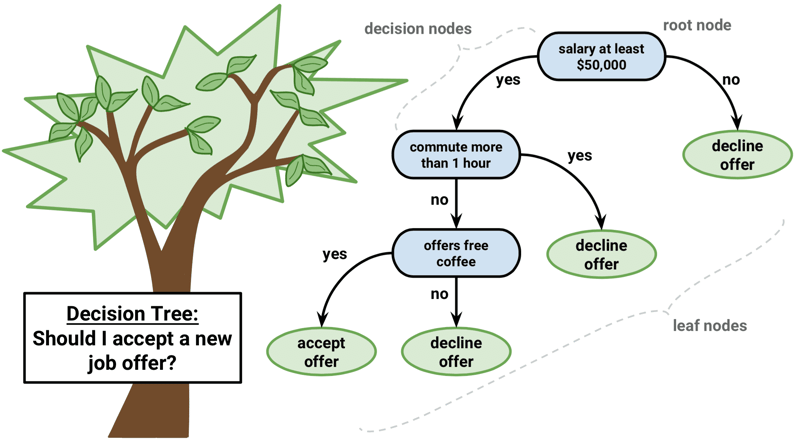
下面这张图将说明决策树背后的术语:
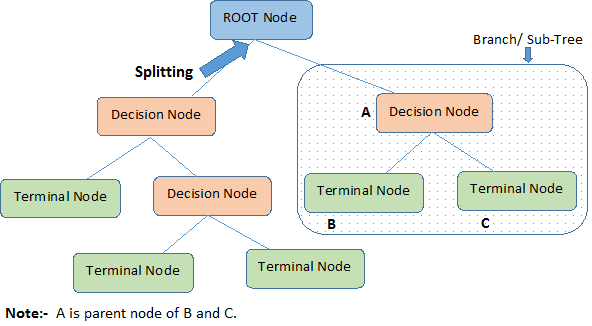
决策树从一个表示整体总体或样本的根节点开始,然后通过称为“分裂”的方法划分为两个或更多更均匀的组。子节点如果继续被划分,则称为决策节点;不再继续划分的节点称为终端节点或叶节点。完整树的一段被称为分支。
我们已经知道决策树可用于回归和分类任务;因此,接下来我们来理解这两类决策树背后的算法。
常见的决策树算法类型
我们直观地理解回归树与分类树:它们的相同点与差异,以及各自的误差函数。
回归树
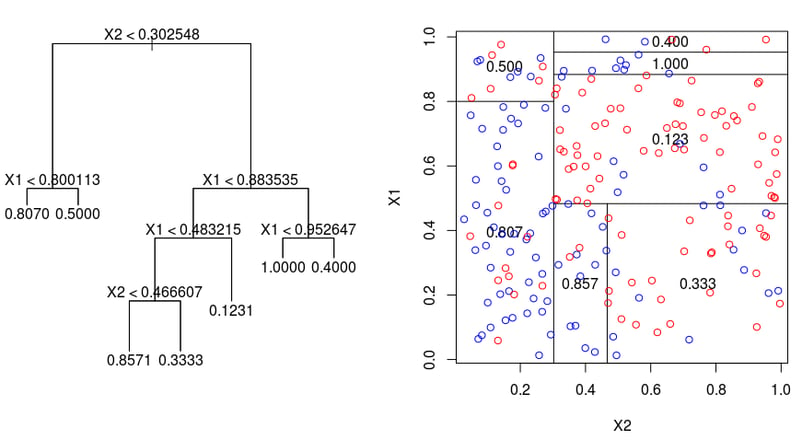
请看下图,它帮助我们可视化回归树进行划分的方式。图中展示了一个未剪枝的树以及拟合到随机数据集的回归树。两个可视化都显示了从树顶开始的一系列划分规则。请注意,域中的每一次划分都与某一特征轴对齐。轴平行划分的概念可以直接推广到高于二维的情形。对于大小为 $p$ 的特征空间($\mathbb{R}^p$ 的子集),空间被划分为 $M$ 个区域 $R_{m}$,每个区域都是一个 $p$ 维“超块”。
要构建回归树,首先使用递归二元划分在训练数据上生长一棵大树,仅当每个终端节点中的观测数少于某个最小阈值时才停止。递归二元划分是一种自顶向下的贪心算法,目标是最小化残差平方和(RSS),这也是线性回归中使用的误差度量。在被划分成 M 个区域的特征空间中,RSS 定义为:
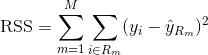
从树顶开始,将其划分为两条分支,形成两个子空间。然后多次尝试在树顶进行这种具体的划分,选择能使(当前)RSS 最小的特征划分。
接着,您对这棵大树应用代价复杂度剪枝,以获得关于 $\alpha$ 的一系列最优子树。其基本思想是引入一个额外的调参项 $\alpha$,在树的深度与其对训练数据的拟合优度之间取得平衡。
您可以使用K 折交叉验证来选择 $\alpha$。该技术将训练数据划分为 K 折,以估计各子树的测试误差率。目标是选择能带来最低误差率的那一棵。
分类树
分类树与回归树非常相似,但它用于预测定性响应而非定量响应。
回忆一下,在回归树中,某个观测的预测值等于落入同一终端节点的训练观测响应的均值。相比之下,在分类树中,您预测每个观测属于其所在区域中出现最频繁的训练类别。
在解读分类树结果时,您往往不仅关心某一终端节点区域对应的类别预测,还关心落入该区域的训练观测在各类别间的比例。
生长一棵分类树的任务与生长回归树非常相似。与回归设置一样,您使用递归二元划分来生长分类树。然而,在分类设置中,残差平方和不能作为二元划分的评判标准。取而代之,您可以使用以下三种方法之一:
- 分类错误率:不同于在回归中查看数值响应距离均值有多远,这里可以将“命中率”定义为某一区域中不属于出现最频繁类别的训练观测所占的比例。误差由如下公式给出:
E = 1 - argmaxc($\hat{\pi}_{mc}$)
其中 $\hat{\pi}_{mc}$ 表示在区域 Rm 内属于类别 c 的训练数据所占比例。
- 基尼指数:基尼指数是一种用于衡量区域“纯度”的替代误差度量。此处的“纯度”指某区域内的训练数据有多大比例来自同一类别。如果区域 Rm 中的数据大多来自单一类别 c,那么基尼指数就会很小:
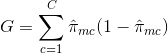
- 交叉熵:第三种与基尼指数相似的替代方法称为交叉熵或偏差:
当 $\hat{\pi}_{mc}$ 的取值都接近于 0 或 1 时,交叉熵会接近于零。因此,与基尼指数一样,如果第 m 个节点很纯,交叉熵将较小。事实上,基尼指数与交叉熵在数值上相当接近。
在构建分类树时,通常使用基尼指数或交叉熵评估某一划分的质量,因为与分类错误率相比,它们对节点纯度更为敏感。在剪枝阶段,这三种方法都可能被使用;但如果目标是最终剪枝树的预测准确率,则更倾向使用分类错误率。
决策树的优缺点
我们希望了解算法及其优势的同时,也必须认识其局限。事实上,决策树并不适合所有类型的机器学习问题——这对所有算法同样成立。
以下是其优缺点:
优点
- 易于理解与解释。决策树非常直观,且便于可视化。其层级结构类似于人类的决策过程,即使非专业人士也能理解。这种可解释性在需要理解决策过程本身与预测结果同等重要的场景中至关重要。
- 可同时处理连续与类别变量。决策树用途广泛,既能处理包含连续与类别特征混合的数据集,也能处理任一类型的目标变量。这种灵活性使其适用于广泛的问题。
- 所需数据预处理较少。决策树不需要特征缩放或归一化,因为它对单调变换不敏感。同时,它也能较好地处理缺失值与异常值,适合原始且噪声较多的数据。
- 可用于特征选择与识别重要变量。决策树会通过选择最具信息量的分裂特征来自然地进行特征选择。特征的重要性可通过其在树中出现的早晚及被使用的频率来衡量。
缺点
- 易过拟合。当树过深时,决策树可能过于复杂,从而对训练数据过拟合,导致对未见数据的泛化能力较差。可通过剪枝或设置最大深度等技术缓解。
- 对数据的小变化敏感。训练数据的轻微变化可能导致完全不同的树结构,使决策树不够稳定。通过集成方法(如装袋、提升或随机森林)构建多棵树并聚合结果,可降低这种敏感性。
- 模型精度往往不及其他方法。由于其简单性与构建过程的贪心特征,决策树并不总能产生最准确的模型。不过,它可作为一个良好的起点或基线,与更复杂的方法进行比较。
- 偏向占优类别。在类别不平衡的数据集中,决策树可能偏向多数类,导致次优划分与少数类误分类。可通过过采样、欠采样或代价敏感学习等方法应对。
尽管存在这些缺点,决策树仍因其简单、可解释与多功能性而在许多应用中备受青睐。
高级树模型集成算法
下面来探索能发挥决策树优势并弥补其部分不足的树模型集成方法:装袋、提升与随机森林。
装袋(Bagging)
上文讨论的决策树存在高方差问题,这意味着如果随机把训练数据分成两部分,并在两部分上各拟合一棵决策树,得到的结果可能大相径庭。相较之下,低方差的过程在不同数据集上重复应用会得到相似结果。
装袋(或称自助聚合)是一种通过集成多个在同一数据集的不同子样本上训练得到的分类器,从而降低预测方差的技术。装袋的公式如下:
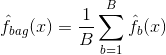
其中您生成 $B$ 个不同的自助法训练数据集;然后在第 $b$ 个自助训练集上训练方法得到 $\hat{f}_{b}(x)$,最后对预测取平均。
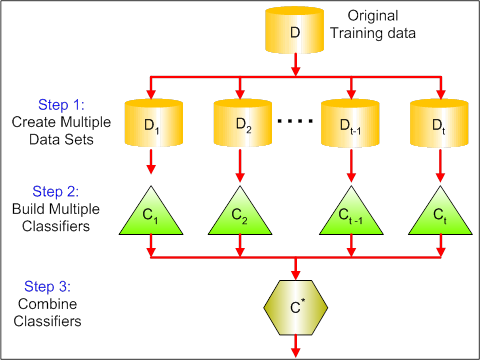
下图展示了装袋的三个步骤:
-
步骤 1:用新数据替换原始数据。新数据通常仅包含原始数据部分的列与行,这些比例可作为装袋模型的超参数。
-
步骤 2:在每个数据集上构建分类器。通常可以使用相同的分类器来建模与预测。
-
步骤 3:最后,根据问题需要,用平均值将所有分类器的预测进行组合。一般而言,这种组合结果比单一模型更稳健。
虽然装袋能提升许多回归与分类方法的预测性能,但它对决策树尤其有效。要将装袋用于回归/分类树,您只需用 $B$ 个自助训练集构建 $B$ 棵回归/分类树,并对所得预测取平均。这些树会被尽可能地生长而不剪枝,因此每棵树的方差高但偏差低。对这 $B$ 棵树求平均可降低方差。
总体而言,装袋已被证明能通过将数百甚至上千棵树组合成一个过程而显著提升准确率。
随机森林
随机森林是一种多才多艺的机器学习方法,既可用于回归也可用于分类。它还能进行降维、处理缺失值与异常值以及其他重要的数据探索步骤,并能取得相当不错的效果。
随机森林通过一个小改动来去相关化装袋树以改进它。与装袋一样,您在自助抽样得到的训练样本上构建多棵决策树。但在构建这些树时,每当考虑对某个节点进行划分,就会从完整的 $p$ 个预测变量中随机选择 m 个预测变量作为候选,仅允许使用这 $m$ 个变量中的一个进行划分。这是随机森林与装袋的主要区别;在装袋中取 $m = p$。
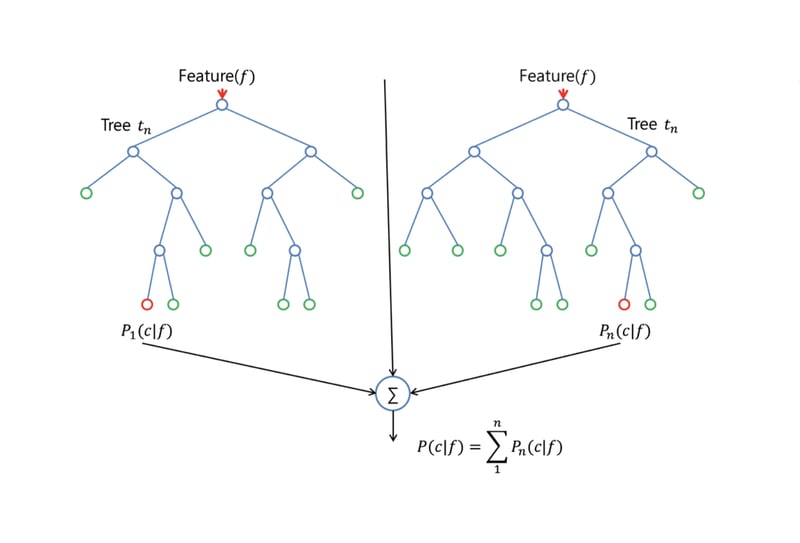
要生长一片随机森林,您应当:
-
首先假设训练集有 K 个样本。然后从这 K 个样本中随机抽样,并用该样本作为训练集来生长一棵树。
-
如果有 $p$ 个输入变量,指定一个 $m < p$ 的数,使得在每个节点,仅从这 $p$ 个变量中随机选出的 $m$ 个变量里选择最佳划分用于分裂该节点。
-
每棵树随后都尽可能地生长,无需剪枝。
-
最后,将这些目标树的预测进行聚合,以预测新数据。
随机森林在估计缺失数据并在大量数据缺失时仍保持准确性方面非常有效。它还能在类别不平衡的数据集中平衡错误。更重要的是,它能处理高维度的海量数据。但其一个劣势是:在回归问题上,面对噪声较大的数据集时较易过拟合。
提升(Boosting)
提升是改进决策树预测的另一种方法。与装袋和随机森林一样,它是一种通用方法,可用于回归或分类的多种统计学习方法。回顾装袋:它通过自助法创建原始训练集的多个副本,对每个副本拟合一棵单独的决策树,然后将所有树组合成一个预测模型。值得注意的是,每棵树都建立在各自的自助数据集上,彼此独立。
提升的工作方式类似,但树是序列式生长的:每棵树都利用先前已生长树的信息。提升不涉及自助采样;每棵树都拟合在原始数据的一个经修改版本上。
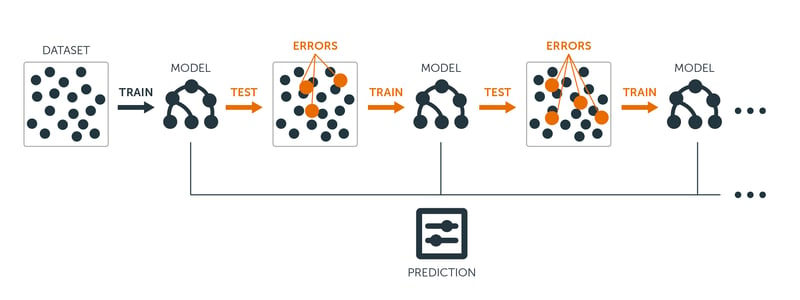
对于回归与分类树,提升的流程如下:
-
不同于一次性拟合一棵大树(这相当于对数据“硬拟合”,并可能过拟合),提升采取“慢学习”的方式。
-
给定当前模型,拟合一棵树来对当前模型的残差进行拟合。也就是说,用当前的残差而非结果变量 $Y$ 作为响应来拟合这棵树。
-
然后将这棵新树加入到已拟合的函数中,以更新残差。每棵树都可以很小,仅包含少量终端节点,其大小由算法中的参数 $d$ 决定。通过对残差拟合小树,您会在模型表现不佳的区域逐步改进 $\hat{f}$。
-
收缩参数 $\nu$ 进一步放慢这一过程,使更多不同形状的树可以“进攻”残差。
当您拥有大量数据并预期决策树会非常复杂时,提升非常有用。提升已被用于解决众多具有挑战性的分类与回归问题,包括风险分析、情感分析、预测性广告、定价建模、销量预估以及患者诊断等。
本质上,这些算法通过集成多棵决策树的预测,来提升整体性能与稳定性。理解了这些高级算法后,出于本教程的范围,我们将继续使用简单的决策树模型。
在 R 中一步步构建决策树模型
我们已经学习了大量理论与直觉,但没有什么比动手实践更有效。现在就来构建模型,并以循序渐进的方式评估模型表现。
为建模准备数据
接下来的示例将使用广受欢迎的 Boston Housing 数据集。
Boston Housing 数据集包含 1970 年代美国马萨诸塞州波士顿的房地产市场信息。它有 506 条观测、14 个变量,其中包含 13 个特征和 1 个目标变量。
Boston Housing 数据集中的特征包括:
- CRIM:各镇人均犯罪率
- ZN:划为超过 25,000 平方英尺住宅用地的比例
- INDUS:各镇非零售商业用地所占比例
- CHAS:查尔斯河虚拟变量(若地块临河 = 1,否则为 0)
- NOX:一氧化氮浓度(每千万份)
- RM:每套住宅的平均房间数
- AGE:1940 年前建成的自有住房比例
- DIS:到波士顿五个就业中心的加权距离
- RAD:径向公路可达性指数
- TAX:每 $10,000 的房产税税率
- PTRATIO:各镇师生比
- Black:各镇黑人群体所占比例
- LSTAT:低收入人群所占百分比
目标变量为 MEDV,表示自有住房的中位数价值(单位:$1000)。
目标是基于给定特征,预测自有住房的中位数价值(以千美元计)。
在 R 中,该数据由“MASS”包提供。您需要为本教程安装多个包并加载。为避免重复,我们以 MASS 包为例演示一次,后续遇到新包时同样处理。
# install the package
install.packages("MASS")
# Load the MASS package
library(MASS)
# Load the Boston Housing dataset
data(Boston)在建模前,通过可视化探索数据并进行预处理往往是必要的。我们先通过直方图查看各变量的分布。
创建直方图的代码如下:
# Load the library
library(tidymodels)
library(tidyr)
# Prepare the dataset for ggplot2
boston_data_long <- Boston %>%
pivot_longer(cols = everything(),
names_to = "variable",
values_to = "value")
# Create a histogram for all numeric variables in one plot
boston_histograms <- ggplot(boston_data_long, aes(x = value)) +
geom_histogram(bins = 30, color = "black", fill = "lightblue") +
facet_wrap(~variable, scales = "free", ncol = 4) +
labs(title = "Histograms of Numeric Variables in the Boston Housing Dataset",
x = "Value",
y = "Frequency") +
theme_minimal()
# Plot the histograms
print(boston_histograms)输出如下所示:
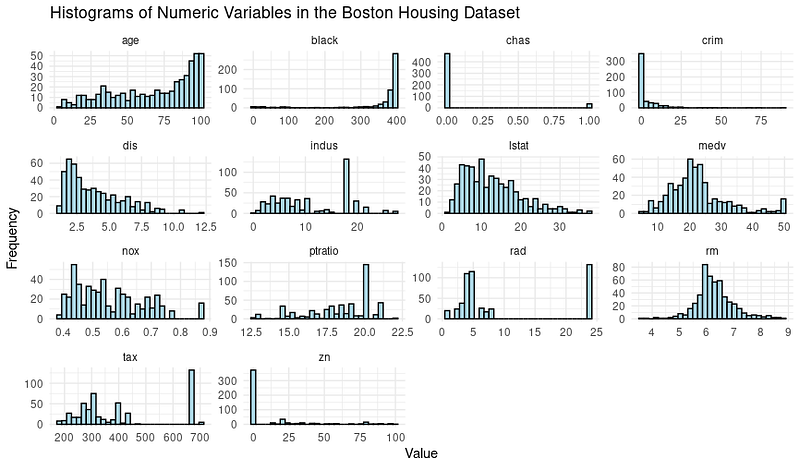
我们确实注意到一些离群值,尤其在 RAD、TAX 和 NOX 等列。本教程以决策树建模为重点;因此,先将数据集划分为训练集与测试集。
# Split the data into training and testing sets
set.seed(123)
data_split <- initial_split(Boston, prop = 0.75)
train_data <- training(data_split)
test_data <- testing(data_split)现在开始进入建模与模型评估阶段。
简单的决策树建模
使用 R 中 Tidymodels 包的 decision_tree() 函数,我们可以先创建一个决策树模型规格,然后在训练数据上进行拟合,过程相当直接。
# Create a decision tree model specification
tree_spec <- decision_tree() %>%
set_engine("rpart") %>%
set_mode("regression")
# Fit the model to the training data
tree_fit <- tree_spec %>%
fit(medv ~ ., data = train_data)这里我们使用“回归”模式;若是分类决策树,则需使用“classification”模式。
评估决策树建模表现
为评估模型性能,我们将使用 Tidymodels 包,在测试数据上计算决策树模型的均方根误差(RMSE)与 R 方(R²)。
# Make predictions on the testing data
predictions <- tree_fit %>%
predict(test_data) %>%
pull(.pred)
# Calculate RMSE and R-squared
metrics <- metric_set(rmse, rsq)
model_performance <- test_data %>%
mutate(predictions = predictions) %>%
metrics(truth = medv, estimate = predictions)
print(model_performance)您将看到两个性能指标:均方根误差(RMSE)与 R 方(R²)。
.metric .estimator .estimate
<chr> <chr> <dbl>
1 rmse standard 5.22
2 rsq standard 0.689分析模型结果
那么,我们的模型结果是否足够好?
- RMSE(均方根误差):衡量预测值与真实值的平均偏差。在此示例中,RMSE 为 5.22,意味着决策树模型的预测与真实值平均相差约 5.22 个单位。RMSE 越低越好,表示预测误差更小。
- R 方(R²):衡量模型对目标变量方差的解释程度,取值范围为 0 到 1,越高表示拟合越好。此处 R² 为 0.689,表示模型解释了目标变量(MEDV)约 68.9% 的方差。
我们还可以通过超参数优化进一步挖掘性能,或采用更复杂的模型,如随机森林与 XGBoost,但这会以模型可解释性为代价。
使用决策树模型进行预测
当您对模型满意后,就可以让模型进行预测了。
这与我们在测试数据上使用 predict() 的方式相同,但此处需提供一份模拟波士顿新房信息的新数据集。这也是模型上线到生产环境时的常见场景。
# Make predictions on new data
new_data <- tribble(
~crim, ~zn, ~indus, ~chas, ~nox, ~rm, ~age, ~dis, ~rad, ~tax, ~ptratio, ~black, ~lstat,
0.03237, 0, 2.18, 0, 0.458, 6.998, 45.8, 6.0622, 3, 222, 18.7, 394.63, 2.94
)
predictions <- predict(tree_fit, new_data)
print(predictions)您将获得该房屋的中位价值预测(单位:$1000):
# A tibble: 1 × 1
.pred
<dbl>
1 37.8至此,您已经掌握了构建决策树模型的步骤——接下来关注如何解释模型的内部机制,便于您自己和使用该解决方案的相关方理解。
解释决策树
正如我们先前所述,决策树模型最大的优势是其可解释性。让我们将决策树可视化,以更好地理解模型:
# Load the library
library(rpart.plot)
# Plot the decision tree
rpart.plot(tree_fit$fit, type = 4, extra = 101, under = TRUE, cex = 0.8, box.palette = "auto")您会看到类似这样的图:
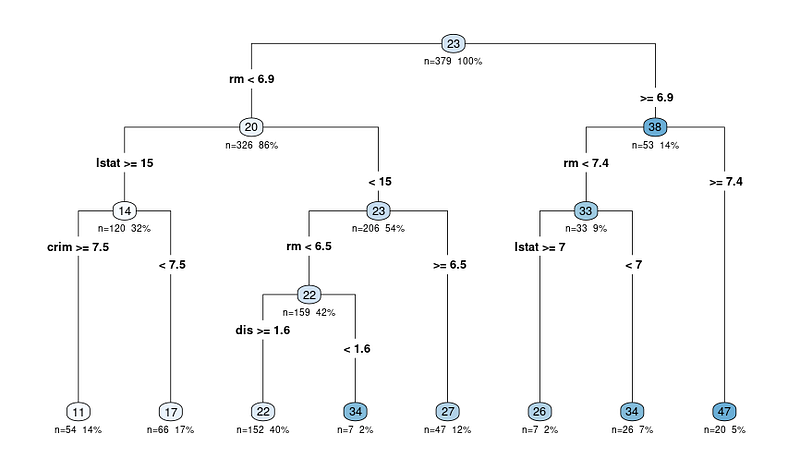
rpart.plot 的输出图展示了模型的决策树表示。图中,每个节点代表基于预测变量的一个分裂。该图包含多种有助于我们解读决策树的信息:
树图以根节点开始
节点以圆圈表示并由连线相连,展示了决策树的层级结构。树从顶部的根节点开始,向下分叉为内部节点,最终到达底部的终端节点或叶子。
各内部节点的分裂准则
每个内部节点都会显示分裂准则,即用于将数据分成两个子集的预测变量及阈值。
例如,某节点可能显示“RM < 6.8”,表示每户平均房间数(RM)小于 6.8 的观测将沿左分支,大于等于 6.8 的观测将沿右分支。
N:分裂后观测数量
每个节点中的 n 值表示落入该节点的数据集中观测的数量。例如,若节点显示“n = 100”,则表示有 100 个观测满足该节点所有父节点的条件。
X%:到达该节点的观测占整个数据集的比例
该百分比帮助您了解各节点相对于整个数据集的相对规模,展示数据如何在树中被划分与分布。百分比越高,说明沿该决策路径到达此节点的数据比例越大;反之则越小。
各节点的预测值
每个节点的预测值以彩色圆圈(节点)中的数字显示。对于回归树,这是该节点中所有观测的目标变量均值。
例如,最后一个叶节点显示 47,表示该节点中所有观测的目标变量均值(在本例中为自有住房中位价值)为 47。
从根节点出发,沿分支解读
因此,在解读任何结果时,从根节点出发,依据分裂准则沿分支前行,直到到达终端节点。终端节点中的预测值即为针对某一观测的模型预测,以及其背后的决策依据。
从决策树中提取规则
如果您更倾向于以文本形式提取规则(而非在图中逐层查看),也可以使用我们绘图时用到的同一库来实现。
代码如下:
rules <- rpart.rules(tree_fit$fit)
print(rules)您会看到如下输出,其中包含预测值及其对应的规则路径:
medv
11 when rm < 6.9 & lstat >= 15 & crim >= 7.5
17 when rm < 6.9 & lstat >= 15 & crim < 7.5
22 when rm < 6.5 & lstat < 15 & dis >= 1.6
26 when rm is 6.9 to 7.4 & lstat >= 7
27 when rm is 6.5 to 6.9 & lstat < 15
34 when rm < 6.5 & lstat < 15 & dis < 1.6
34 when rm is 6.9 to 7.4 & lstat < 7
47 when rm >= 7.4看到这些规则后,您可能会疑惑:当我们向决策树输入了更多变量时,为什么最终的决策只涉及 3–4 个变量?
事实证明,有些变量比其他变量更重要。我们来进一步理解这一点。
从决策树理解重要变量
我们已经了解了树图以及模型如何工作。解释性的最后一个方面,就是识别数据集中哪些变量更重要。
其重要性在于:
- 特征选择。识别重要变量可帮助您聚焦于关键特征,并可能剔除不重要特征,从而简化模型并降低噪声。
- 领域知识。了解哪些特征最重要,有助于在具体问题背景下更好地理解特征与目标变量之间的关系。
- 模型解释。理解驱动模型预测的关键特征,可为决策过程提供宝贵洞见。
在决策树中,变量重要性通常由用于节点分裂的特征来决定。那些在树的较高层进行分裂或被频繁使用的特征,通常被认为更重要。
变量重要性可量化为其在分裂时带来的不纯度度量(例如基尼指数或均方误差)的降低幅度。R 中的“VIP”包已封装了相关复杂性,可通过下面的代码得到可视化图:
# Load the necessary library
library(vip)
# Create a variable importance plot
var_importance <- vip::vip(tree_fit, num_features = 10)
print(var_importance)您将得到如下的变量重要性图:
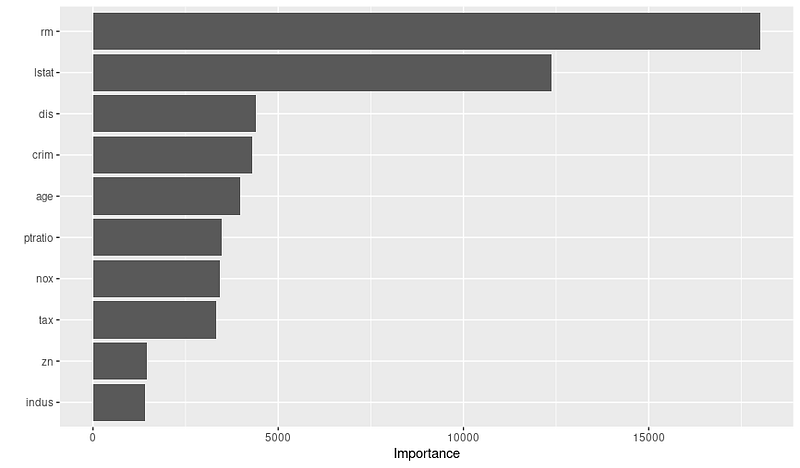
在看到该图后,您可以与领域专家合作,进一步研究这些变量为何重要。比如,基于上图,我们可以推断出前三个重要变量及其可能原因:
- RM:每户平均房间数是非常关键的特征,表明房间数越多的房屋,其价值中位数往往越高。
- LSTAT:低社会经济地位人群的占比同样重要,显示低地位社区的房价中位数可能更低。
- DIS:到就业中心的加权距离很关键,显示距离主要就业中心更近的房屋更可能拥有更高的中位价值。
因此,在最终确定模型前,请务必查看变量重要性图;它能帮助您构建与筛选更佳特征,从而优化性能。
结语
本教程介绍了决策树的基本概念,并不仅仅停留在建模,还涉及了对模型的解读。决策树既强大又可解释,适用于分类与回归任务,是数据科学家工具箱中的重要成员。
随着技能的提升,我们鼓励您进一步深入学习决策树,探索替代算法,并增强您的 R 编程能力。以下资源可作为下一步:
毫无疑问,持续扩展您的知识并尝试新工具与技术,将帮助您应对多样化挑战,为项目带来有价值的洞见。