课程
理解机器学习
2 小时
314K
本小节将简要介绍如何安装系统级依赖和用于可视化机器学习模型的 Python 库。
您需要安装的唯一系统级依赖是Graphviz。稍后我们将用它来可视化决策树,没有 Graphviz 代码将无法运行。
这是一款用于绘制图表、抽象图与网络的开源软件。您不会直接使用它,而是通过 scikit-learn 间接调用。
这是一款在 Python 中广泛用于机器学习任务的库。
在本文中,您将用它来训练机器学习模型、划分数据集、缩放数值特征,并可视化模型性能。它不可或缺,请根据您的 Python 环境用以下命令安装:
pip install scikit-learn
conda install scikit-learn
如果您完全不熟悉 scikit-learn,建议先观看我们的热门监督式机器学习课程。
Python 中的 SHAP 库是解释机器学习模型预测的热门工具。它借助博弈论概念(如Shapely 值)来度量各个属性对模型预测的贡献。
更棒的是,它内置了大量有用的可视化,帮助您理解模型的内部机制。
使用以下命令安装:
pip install shap
conda install -c conda-forge shap该 Python 库常用于需要解释单条模型预测的场景。它的工作方式不同于 SHAP:在局部用一个可解释的简单模型近似原始复杂模型,然后展示每个特征对该预测的贡献。
您马上就会看到 LIME 的工作方式,但先安装它:
pip install lime
conda install conda-forge::lime如果您用 TensorFlow 构建神经网络模型,那么 TensorBoard 毫无疑问是必备工具。
它是一款可视化工具,可帮助您跟踪机器学习实验并监控训练指标(如损失和准确率)。它能实时可视化并更新模型计算图,并展示训练过程中参数的变化。
TensorBoard 也可配合 PyTorch 等其他深度学习框架使用,但本文将以 TensorFlow 为主。
通过以下命令安装:
pip install tensorboard
conda install -c conda-forge tensorboard准备工作的最后一步是处理数据。
本文将使用两个数据集: MBA 录取(用于分类)和 保险(用于回归)。两者均可在 Kaggle 免费下载。
首先导入这些 Python 库:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import train_test_split针对分类数据集,我只做了最小化的预处理,主要包括:
这绝非完善的数据预处理流水线。如果有时间,欢迎进一步改进。
无论如何,复制以下函数以整理分类数据集:
def load_classification_dataset() -> pd.DataFrame:
    # https://www.kaggle.com/datasets/taweilo/mba-admission-dataset?resource=download
    df = pd.read_csv("MBA.csv")

    # Just an arbitrary ID
    df = df.drop(["application_id"], axis=1)

    # Fill unknown
    df["race"] = df["race"].fillna("Unknown")

    # Assume these are denied
    df["admission"] = df["admission"].fillna("Deny")

    # Convert boolean cols to 0/1
    df["gender"] = df["gender"].replace({"Male": 0, "Female": 1})
    df["international"] = df["international"].replace({False: 0, True: 1})

    # Create dummy columns for categorical features
    cols_for_dummy = ["major", "race", "work_industry"]
    for col in cols_for_dummy:
        dummies = pd.get_dummies(df[col], prefix=col)
        df = pd.concat([df, dummies], axis=1)

    # To drop
    cols_to_drop = ["major", "race", "work_industry", "major_Humanities", "race_Unknown", "work_industry_Other"]
    df = df.drop(cols_to_drop, axis=1)
    return df

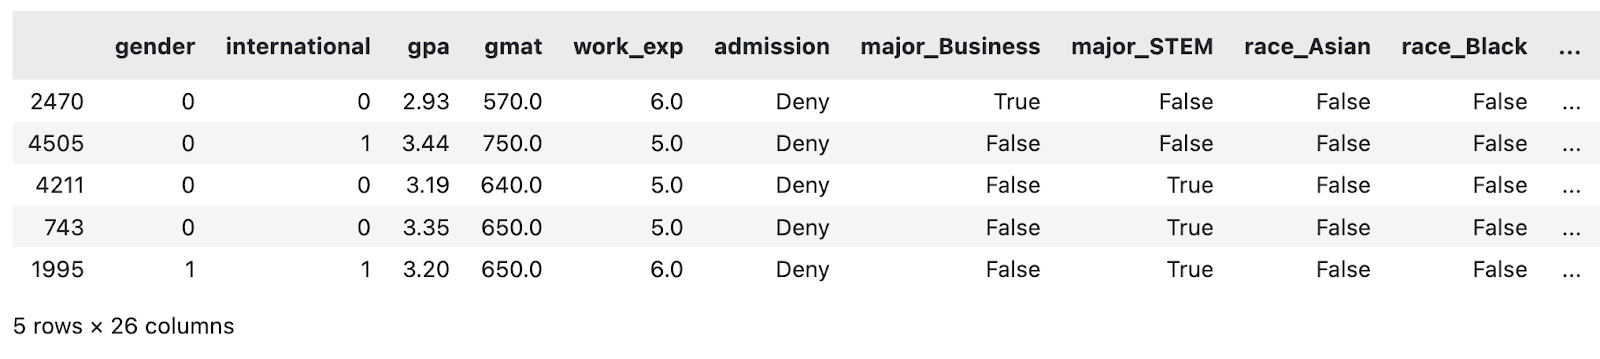
load_classification_dataset().sample(5)
修改后的 MBA 数据集样本。作者供图。
接下来对回归数据集做同样处理。
所选回归数据集包含一个连续特征——保险金额($),模型将基于其他属性来预测该金额。
我同样只做了较少预处理,主要包括:
如果有时间,不妨在此流水线上添加更多步骤。
复制以下函数以加载并预处理保险数据集:
def load_regression_dataset() -> pd.DataFrame:
    # https://www.kaggle.com/datasets/mirichoi0218/insurance
    df = pd.read_csv("MedicalCostPersonal.csv")

    # Scale numerical features
    cols_to_scale = ["age", "bmi", "children"]
    scaler = StandardScaler()
    df[cols_to_scale] = scaler.fit_transform(df[cols_to_scale])

    # Binary features
    df["sex"] = df["sex"].replace({"male": 0, "female": 1})
    df["smoker"] = df["smoker"].replace({"no": 0, "yes": 1})

    # Dummies
    dummies_region = pd.get_dummies(df["region"], prefix="region", drop_first=True)
    df = pd.concat([df, dummies_region], axis=1)
    df = df.drop("region", axis=1)
    return df

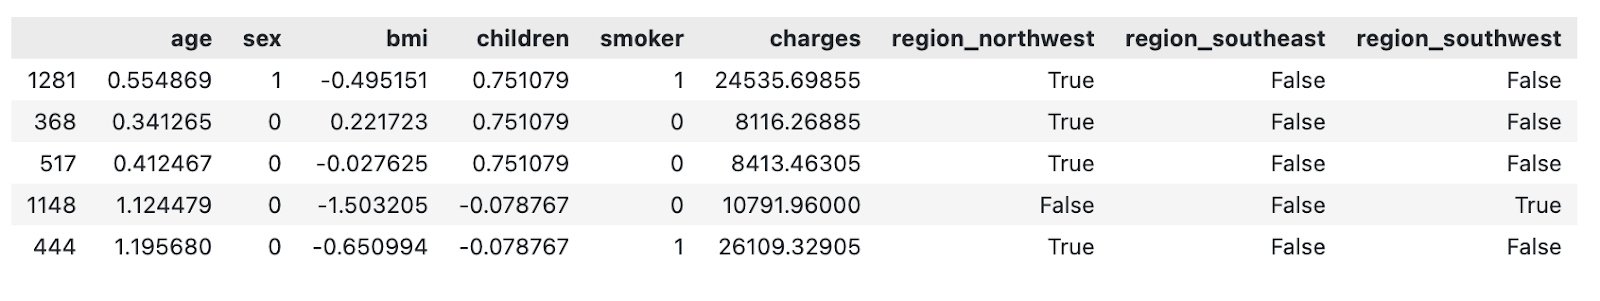
load_regression_dataset().sample(5)
修改后的保险数据集样本。作者供图。
就这些!
下一节我将展示如何开始对机器学习模型进行可视化。
基于树的模型常用于分类任务,但多数也能处理回归任务。
本节我将演示如何可视化决策树、随机森林模型的特征重要性,以及用 SHAP 和 LIME 进行预测解释。
请注意,决策树和随机森林模型并不总是容易理解。我们有一门完整课程涵盖mentals of Python 中基于树的机器学习模型。
首先,加载分类数据集并将其划分为训练集和测试集:
df = load_classification_dataset()
X = df.drop("admission", axis=1)
y = df["admission"]
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.25, random_state=42)
接下来,可视化一棵决策树!
可以把决策树看作一组嵌套的 if 语句,条件由机器学习模型决定。
还有更多细节,但用这个类比,您就会明白可视化这些决策应当很直观。确实如此:sklearn 的 plot_tree() 函数承担了大部分工作。
先训练一个决策树模型。max_depth 参数是可选的,仅用于可视化。否则,树会过深,尤其在大数据集上,您会迷失在大量决策之中。
下面这段代码在训练集上训练一个决策树分类模型:
from sklearn import tree

decision_tree = tree.DecisionTreeClassifier(random_state=42, max_depth=4)
decision_tree.fit(X_train, y_train)
用于可视化,只需复制下面的代码片段。可选参数 filled 与 feature_names 有助于提升可读性:
plt.figure(figsize=(12,8))
tree.plot_tree(decision_tree, filled=True, feature_names=X.columns, class_names=y.unique())
plt.title("Decision Tree Visualization", size=20, loc="left", y=1.04, weight="bold")
plt.show()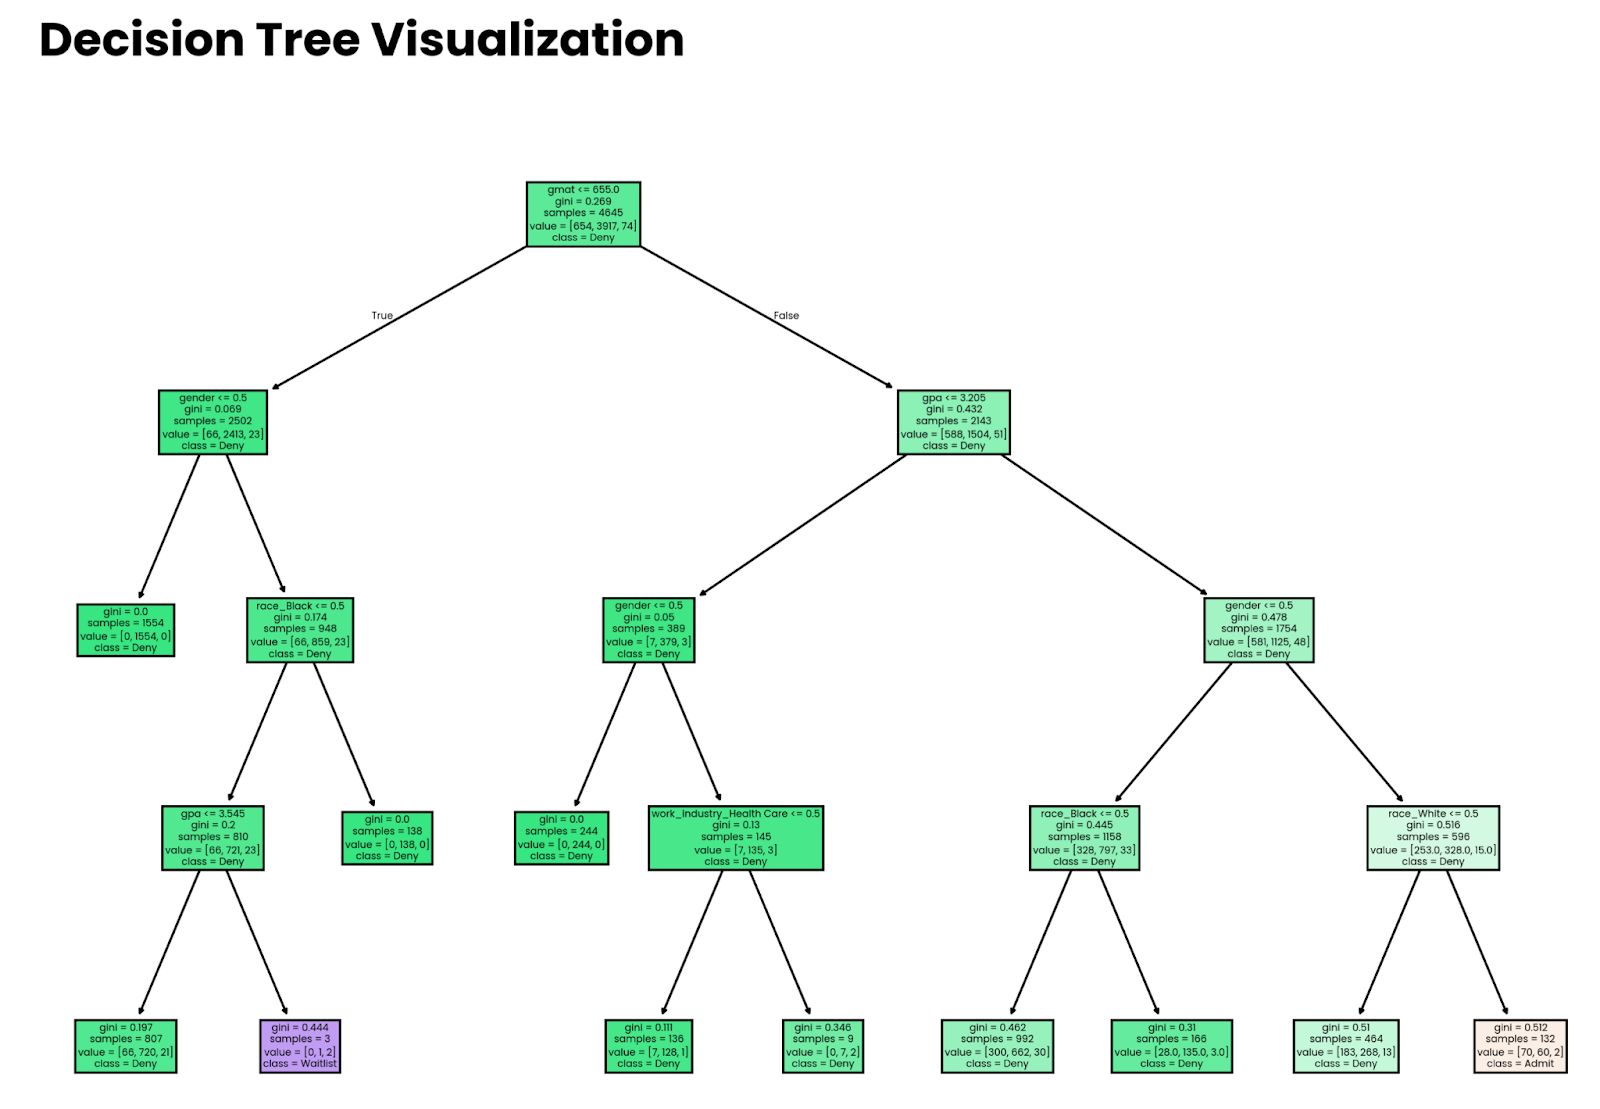
四层深的决策树。作者供图。
请注意,如果模型不够准确,其做出的决策都没有意义。本文稍后将展示如何评估准确率。
还记得前面的蛋糕类比吗?现在来实操一下。
每当您用 sklearn 训练树模型,都能访问 feature_importances_ 属性。把它与特征名配对,您就拥有了找出哪些属性对预测贡献最大的全部数据。
我们来看看实战!首先在训练集上训练一个随机森林分类器:
from sklearn.ensemble import RandomForestClassifier

random_forest = RandomForestClassifier(n_estimators=25, random_state=42)
random_forest.fit(X_train, y_train)可视化的核心是提取并排序特征重要性,同时用特征名替换索引:
importances = random_forest.feature_importances_
indices = np.argsort(importances)[::-1]
plt.figure(figsize=(10,6))
bars = plt.bar(range(X.shape[1]), importances[indices], edgecolor="#008031", linewidth=1)

for bar in bars:
    height = bar.get_height()
    plt.text(bar.get_x() + bar.get_width() / 2, height, f"{height:.2f}", ha="center", va="bottom", size=8)

plt.title("Feature Importances", size=20, loc="left", y=1.04, weight="bold")
plt.ylabel("Importance")
plt.xticks(range(X.shape[1]), np.array(X.columns)[indices], rotation=90, size=12)
plt.show()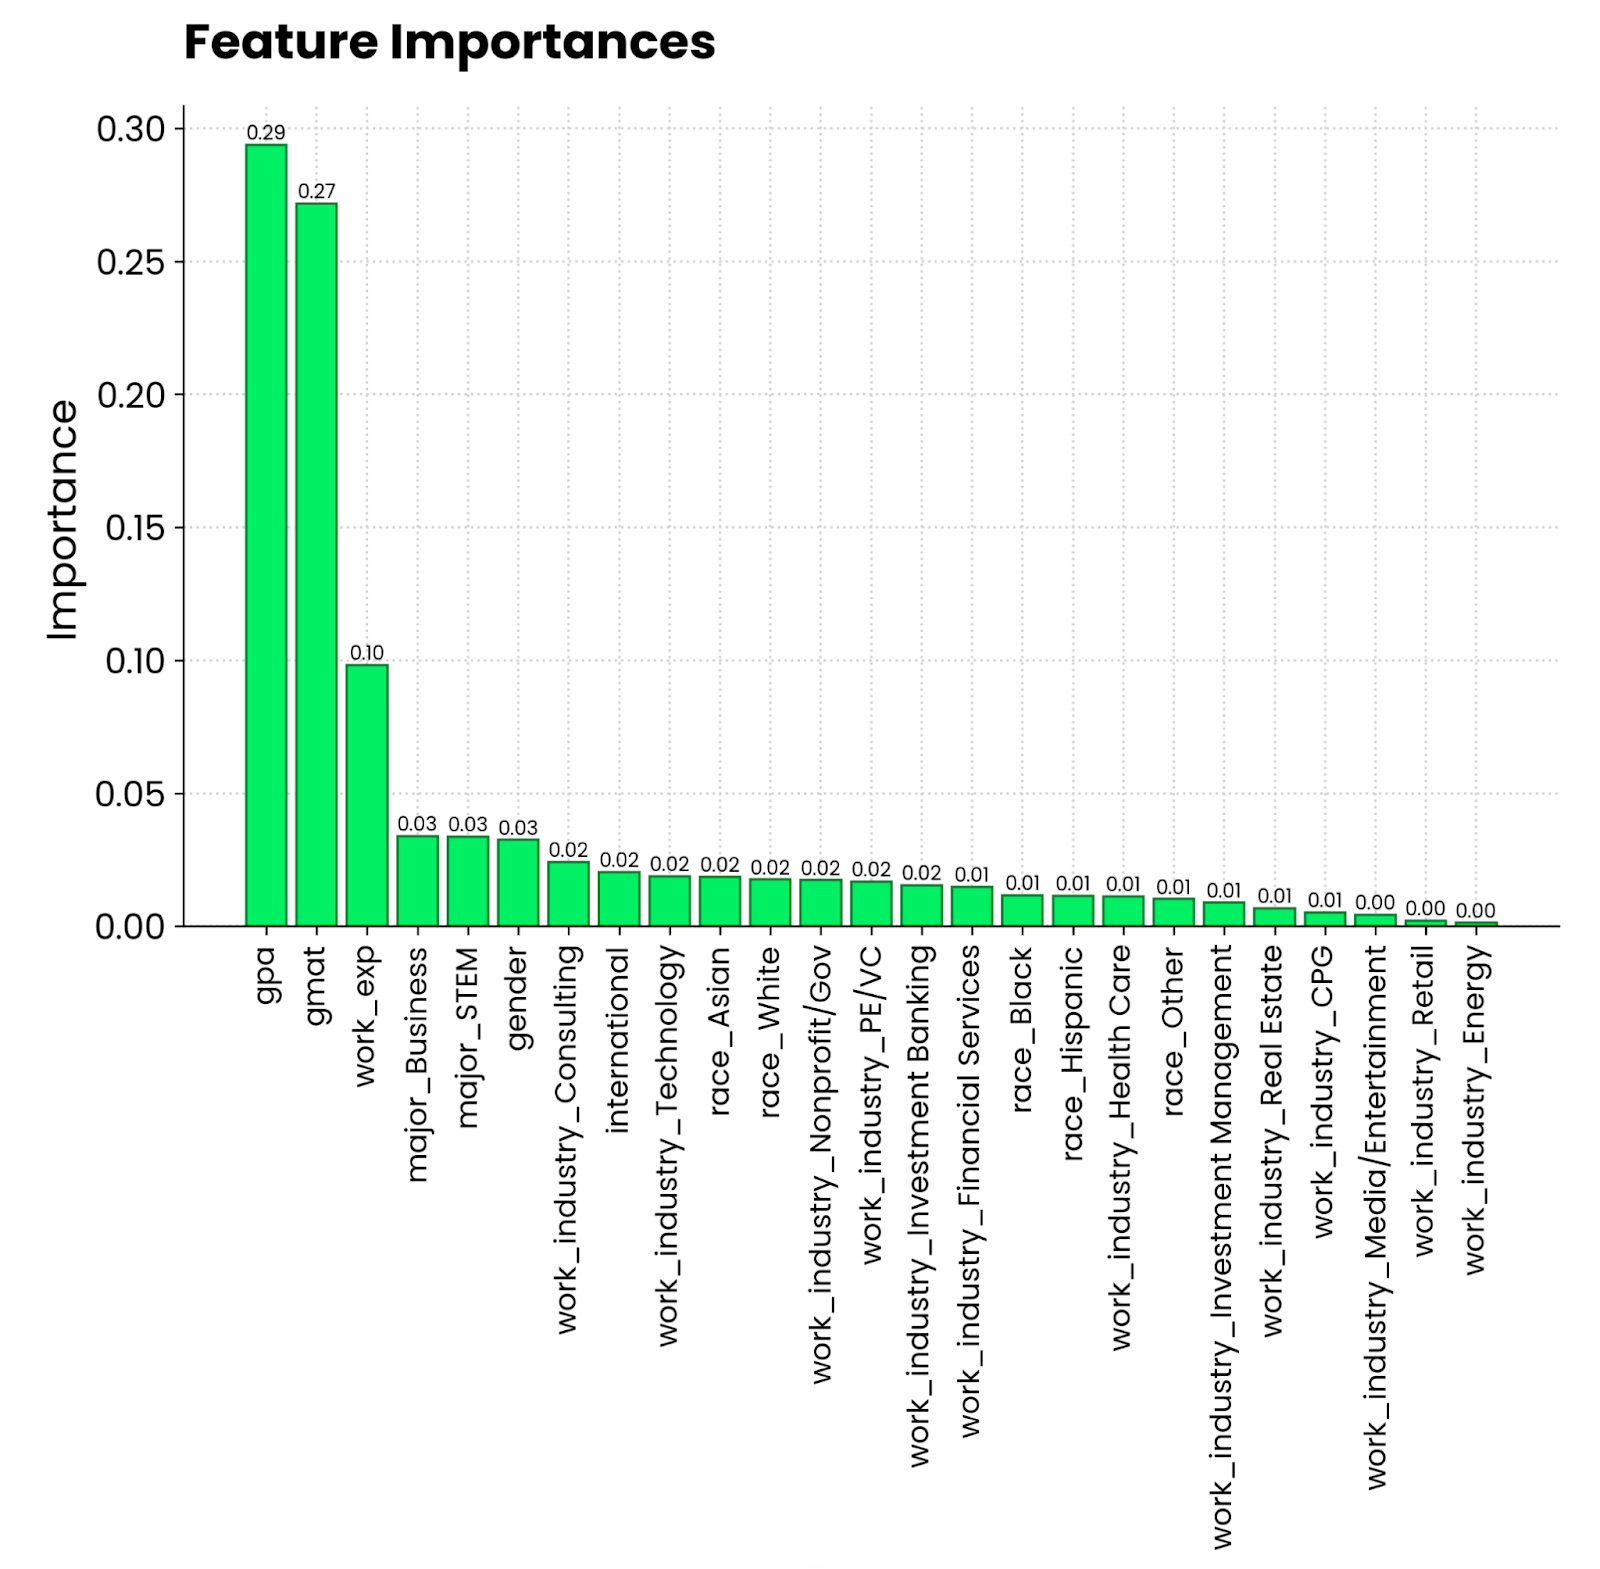
随机森林特征重要性图。作者供图。
看起来 4.0 量表的 GPA 和 GMAT 分数对 MBA 录取的贡献最大。其次是工作经验,这也是 MBA 学习的硬性要求。专业与所在行业的相关性则要小得多。
特征重要性描绘的是全局图景,但如果您想在个体预测层面可视化模型,该怎么办?
这正是 SHAP 和 LIME 的用武之地。我先讲 SHAP。您已了解它是什么,就不再赘述理论。
我将把梯度提升模型拟合到回归数据集上,看看各个特征对保险费用的影响。下面的代码演示如何拟合模型,并通过 shap.Explainer() 计算 SHAP 值:
import shap
from xgboost import XGBRegressor

df = load_regression_dataset()

# No need for train-test splits
X = df.drop("charges", axis=1)
y = df["charges"]
model = XGBRegressor().fit(X, y)

# Shap explainer
explainer = shap.Explainer(model)
shap_values = explainer(X)
使用 SHAP,可以绘制一整套图表。
我先用 waterfall() 查看首条预测的 SHAP 值:
shap.plots.waterfall(shap_values[0])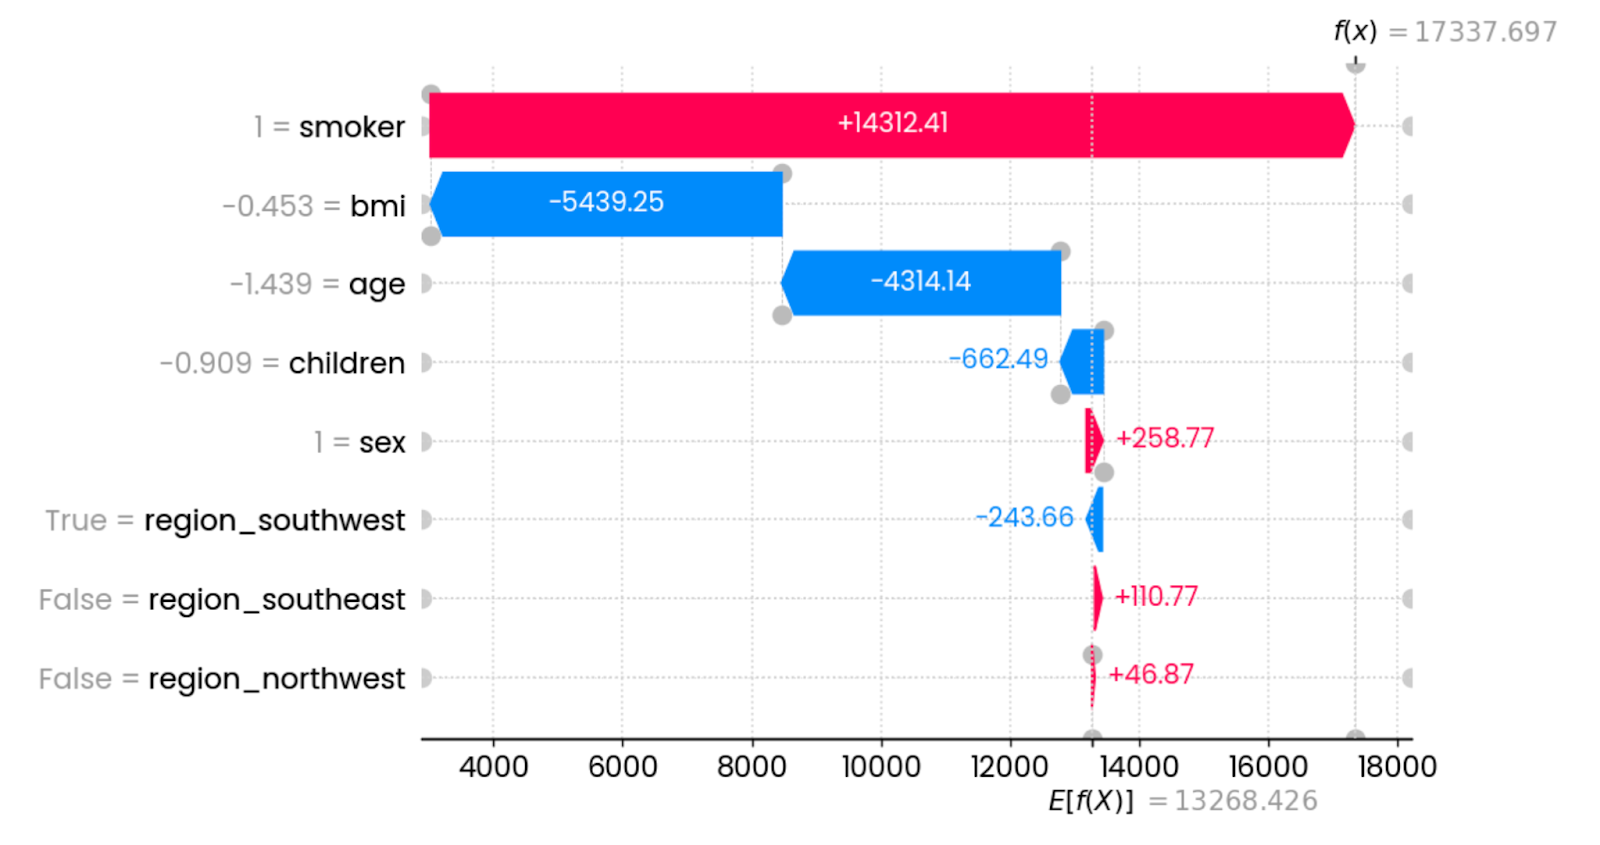
首条预测的解释。作者供图。
在这个具体样本中,吸烟会大幅提高保险费用。对费用降低影响最大的特征是 BMI(与体重相关)和年龄。其他特征的影响很小或几乎没有。
您还可以用更紧凑的形式呈现上述信息:
shap.plots.force(shap_values[0])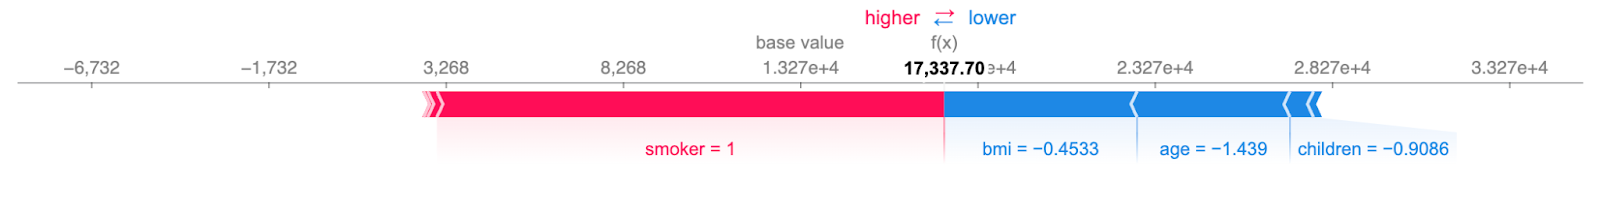
首条预测的精炼解释。作者供图。
信息仍然相同:红色特征会提高费用,蓝色特征会降低费用。二者相交处对应单个样本的保险费用。
接下来是蜂群图(beeswarm),通过绘制每个样本上每个特征的 SHAP 值来展示特征的重要性。特征按所有样本上 SHAP 值绝对值之和排序。颜色表示特征值(红为高、蓝为低):
shap.plots.beeswarm(shap_values)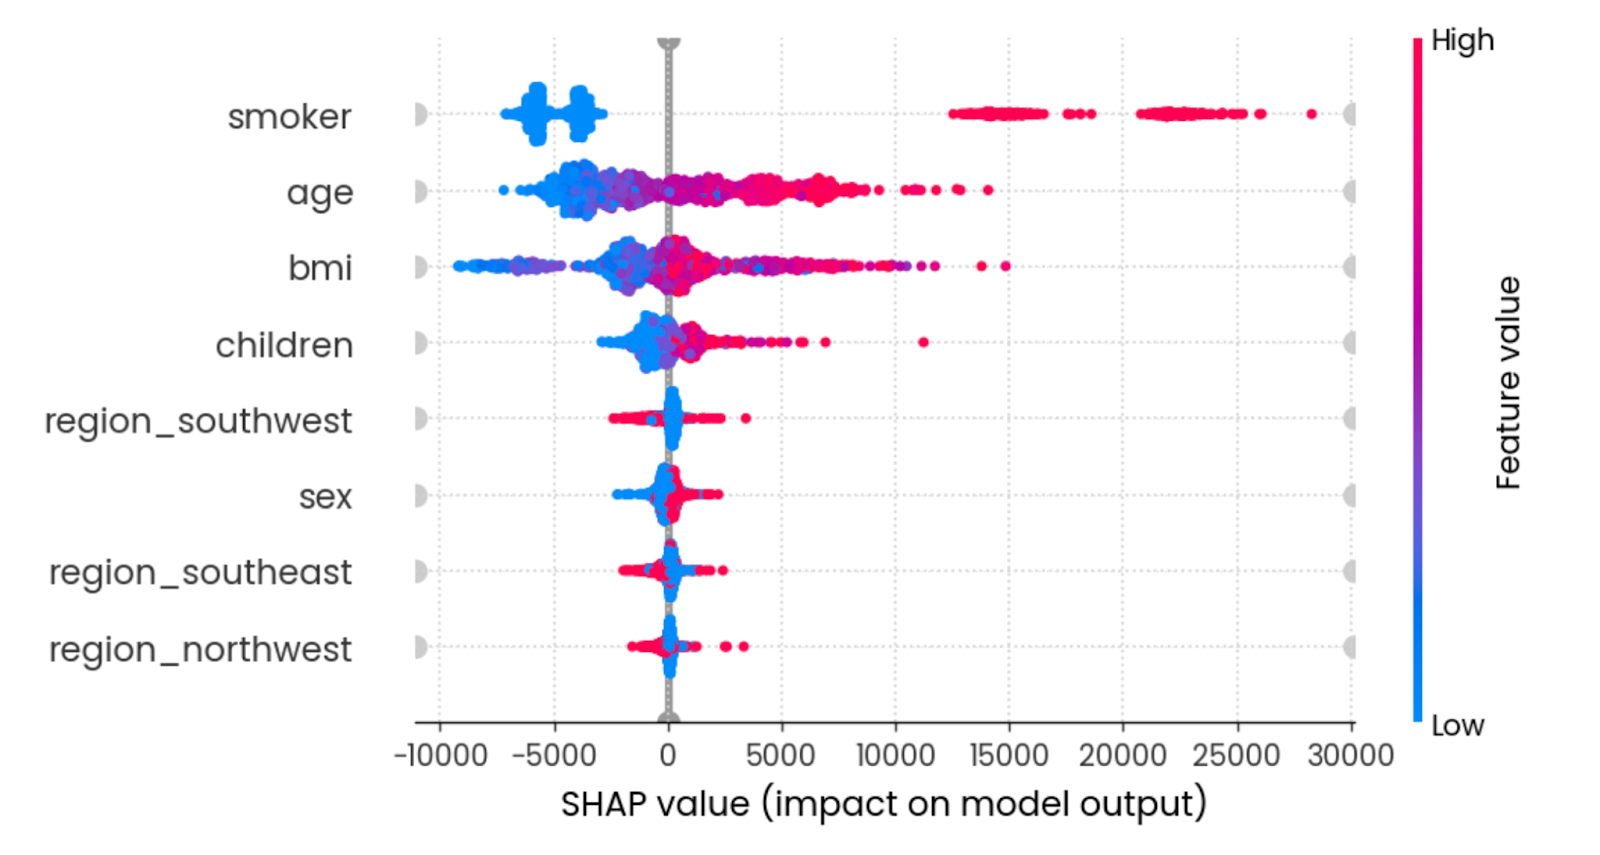
所有特征的汇总效应。作者供图。
解读:不吸烟、较年轻且 BMI 合理的个体,保险费用更低。
最后一个 SHAP 可视化是平均绝对值柱状图。它对每个特征的所有 SHAP 值取绝对值后再求平均:
shap.plots.bar(shap_values)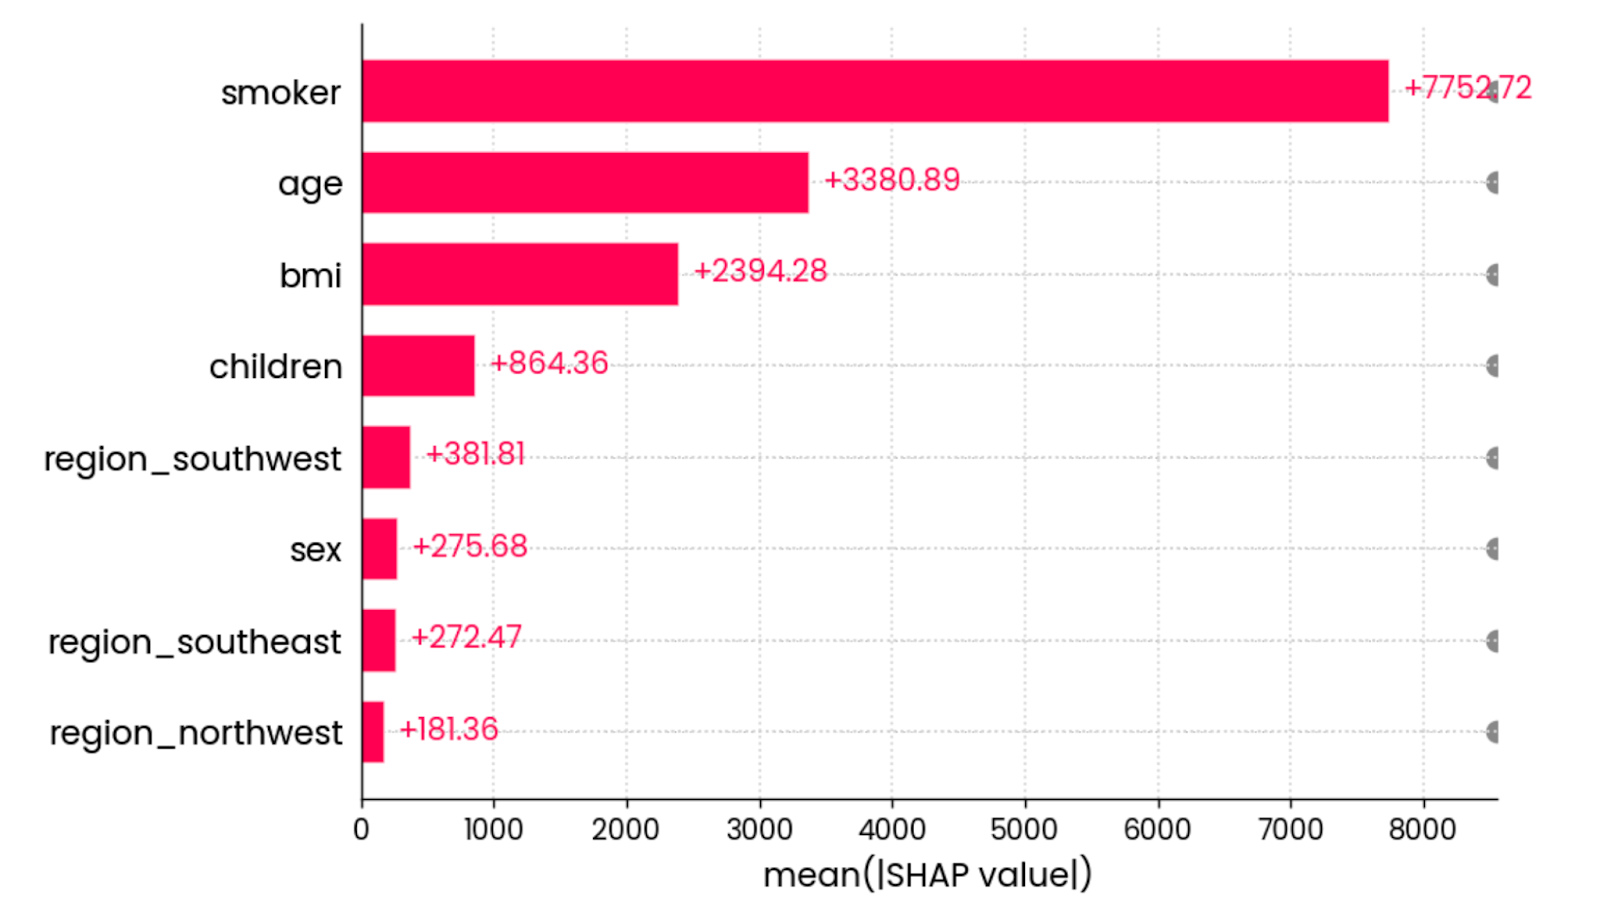
所有特征 SHAP 值的平均绝对值。作者供图。
换言之,这是计算全局特征重要性的“高阶玩法”——该图并不绑定某条具体预测。
SHAP 就讲到这里。接下来转向 LIME。
与 SHAP 一样,LIME 关注可解释的机器学习。
它的可视化类型不如 SHAP 丰富,但在表格数据上把核心事情做得很好。
作为演示,我将加载分类数据集,并将其进一步转换为二分类任务,将候补名单样本与拒绝样本合并。这样更便于理解 LIME 的输出:
from lime import lime_tabular

df = load_classification_dataset()

# Convert to binary
df["admission"] = df["admission"].replace({"Waitlist": "Deny"})
X = df.drop("admission", axis=1)
y = df["admission"]
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.25, random_state=42)
X_train.shape, y_test.shape
random_forest = RandomForestClassifier(n_estimators=25, random_state=42)
random_forest.fit(X_train, y_train)
LimeTabularExplainer() 类需要接收训练数据、列名、目标变量的类别名称,以及机器学习模式(分类或回归):
explainer = lime_tabular.LimeTabularExplainer(
    training_data=np.array(X_train),
    feature_names=X_train.columns,
    class_names=["Admit", "Deny"],
    mode="classification"
)
完成后,您可以调用 explain_instance() 方法,基于类别预测概率来解释单条预测:
exp = explainer.explain_instance(
    data_row=X_test.iloc[0],
    predict_fn=random_forest.predict_proba
)
exp.show_in_notebook(show_table=True)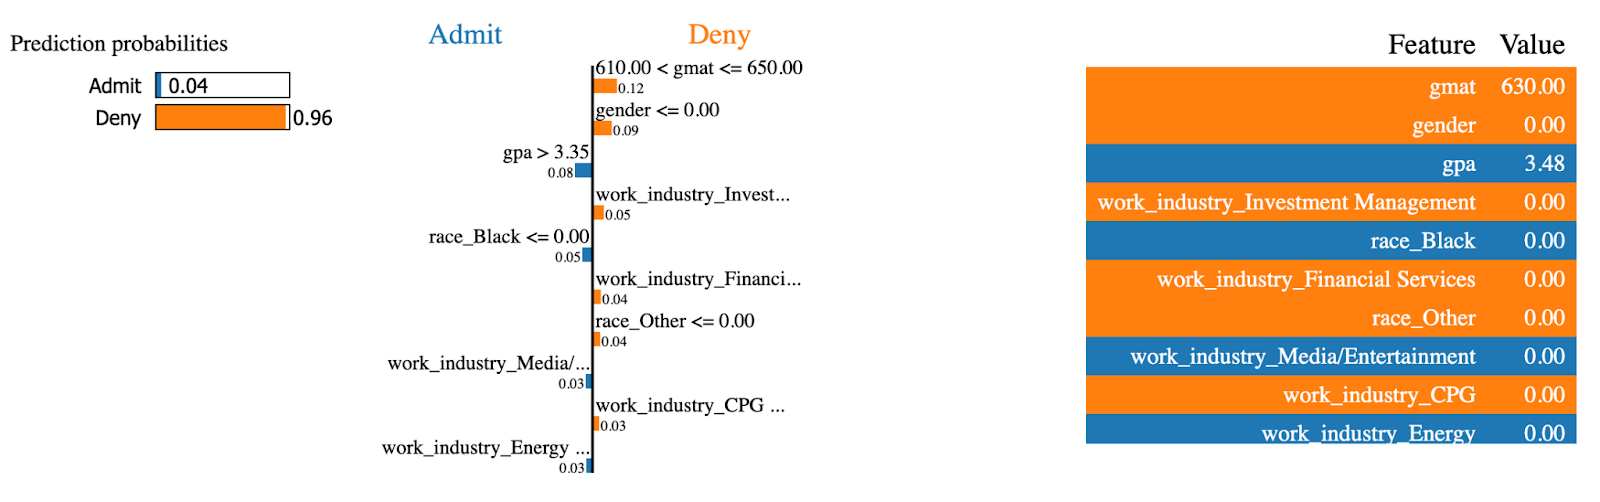
LIME 解释(1)。作者供图。
LIME 模型有 96% 的把握认为该 MBA 申请会被拒。gmat 与 gender 等特征对决策影响最大。
我们再对一条被录取的样本做同样的解释:
exp = explainer.explain_instance(
    data_row=X_test.iloc[234],
    predict_fn=random_forest.predict_proba
)
exp.show_in_notebook(show_table=True)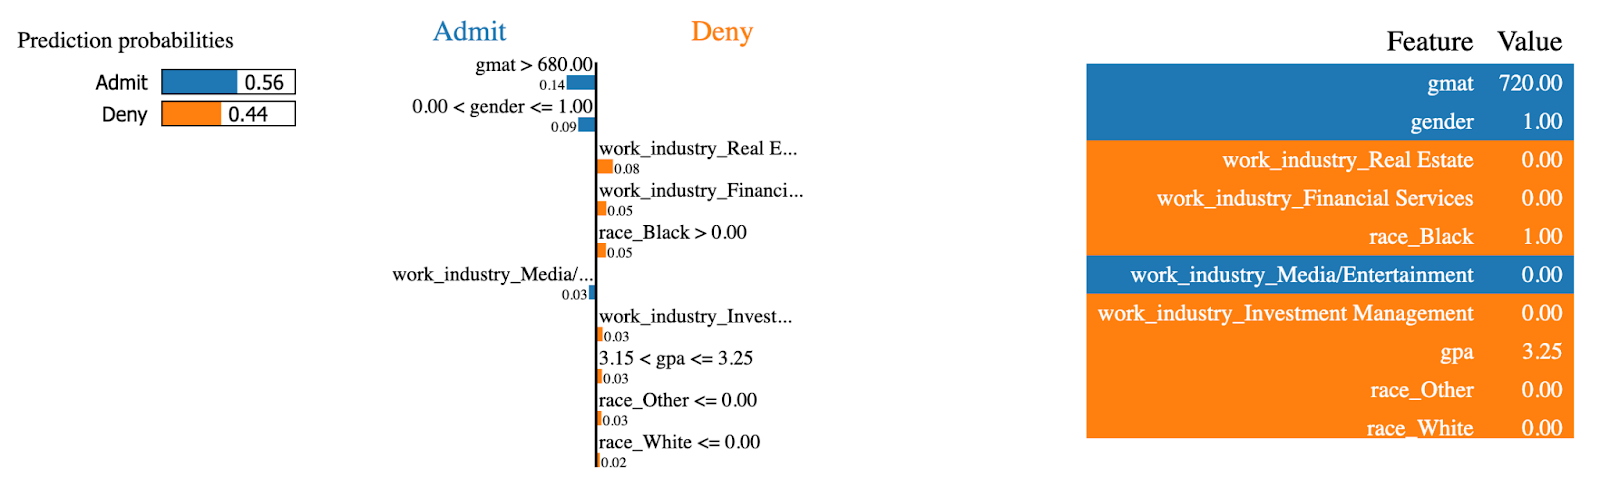
LIME 解释(2)。作者供图。
相同特征在这里产生了相反的作用!该样本拥有较高的 gmat 分数,是促成 MBA 录取的最大因素。
树模型部分就到这里!接下来您将学习如何可视化用于回归任务的线性模型。
如果您刚开始做预测建模,线性回归可能是最基础的模型。它简单、易懂,并且在数据关系近似线性时效果不错。
当然还有其他线性模型,但本节仅讨论线性回归。
先加载回归数据集,划分训练/测试集,并在训练集上拟合线性回归模型:
from sklearn.linear_model import LinearRegression

df = load_regression_dataset()
X = df.drop("charges", axis=1)
y = df["charges"]
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.25, random_state=42)
model = LinearRegression().fit(X_train, y_train)
第一个要看的可视化类型是模型系数。
通俗来说,线性回归模型归结为一个公式。您可能记得高中学过的 y = mx+b——思路相同。
回归方程扩展为 y = w0 + w1_x1 + w2_x2 + … + wn_xn 以容纳多个参数。模型的目标是给定输入特征集(x)找到权重(w)的最佳估计。
这为什么重要?
因为模型训练完成后,您可以访问系数(权重)并分析其贡献。系数越大,关联特征对目标变量预测的贡献越高。
您可以通过训练后模型的 coef_ 参数获取系数。
下面代码将系数绘制为水平柱状图:
features = X_train.columns
coefficients = model.coef_
plt.figure(figsize=(10, 4))
bars = plt.barh(y=features, width=coefficients, edgecolor="#008031", linewidth=1)

for bar in bars:
    width = bar.get_width()
    plt.text(width + 1, bar.get_y() + bar.get_height()/2, f"{width:.2f}",
             va="center", ha="left")

plt.xlabel("Coefficient value")
plt.title("Linear Regression Model Coefficients", y=1.05)
plt.show()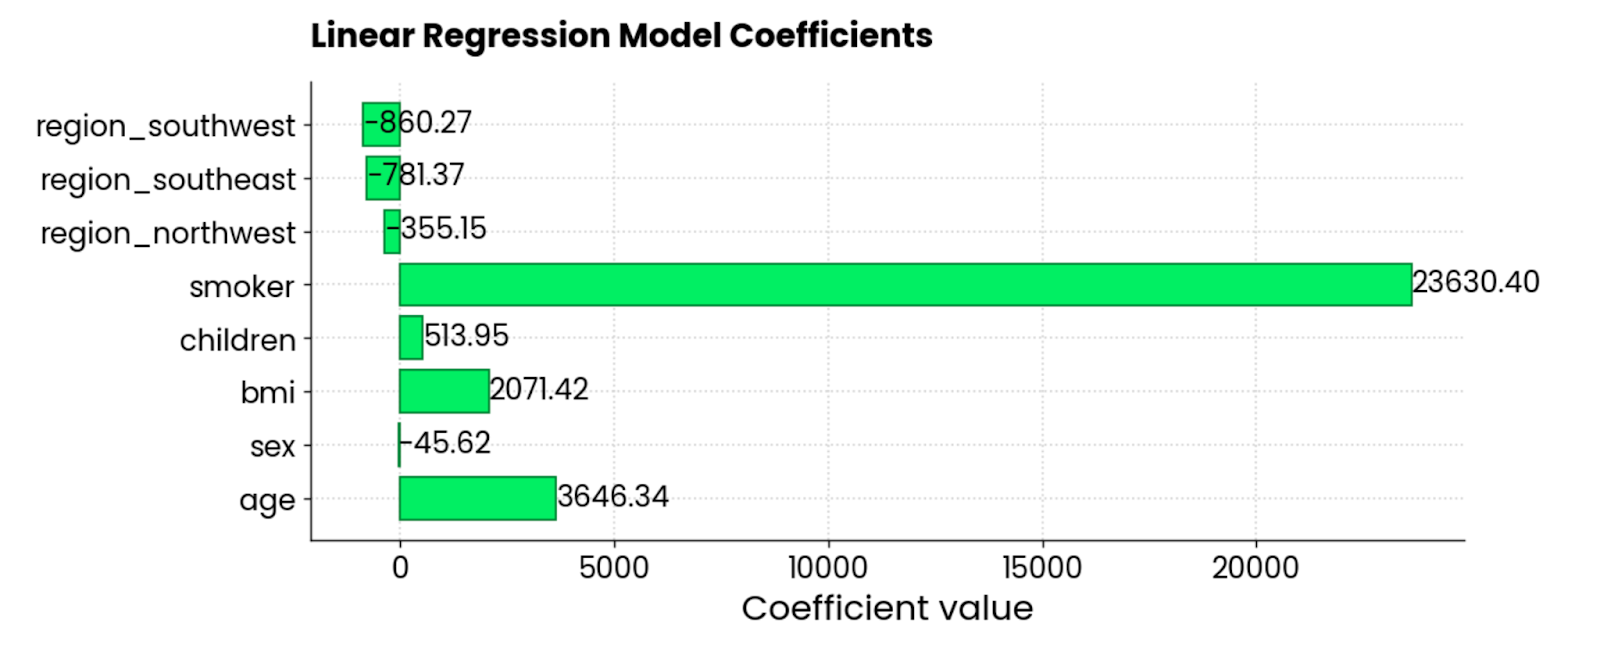
线性回归模型系数。作者供图。
smoker、BMI 与 age 是对保险费用贡献最大的正向特征——它们上升时,金额也会上升。也有一些负系数,意味着它们会降低总体金额。
另一种常见回归可视化是残差图。通俗来说,就是绘制一个散点图,X 轴为预测值,Y 轴为残差(真实值 - 预测值)。
理想情况下,残差中不应出现任何模式,且应围绕 0 居中。换言之,它们应当近似正态分布。
使用以下代码在保险数据集上可视化线性回归模型的残差:
y_pred = model.predict(X_test)
residuals = y_test - y_pred
plt.figure(figsize=(10, 6))
plt.scatter(y_pred, residuals, color="#03EF62", alpha=0.6, edgecolors="#008031")
plt.axhline(0, color="red", linestyle="--")
plt.xlabel("Predicted Values")
plt.ylabel("Residuals")
plt.title("Residuals vs Predicted Values", y=1.05)
plt.grid(True)
plt.show()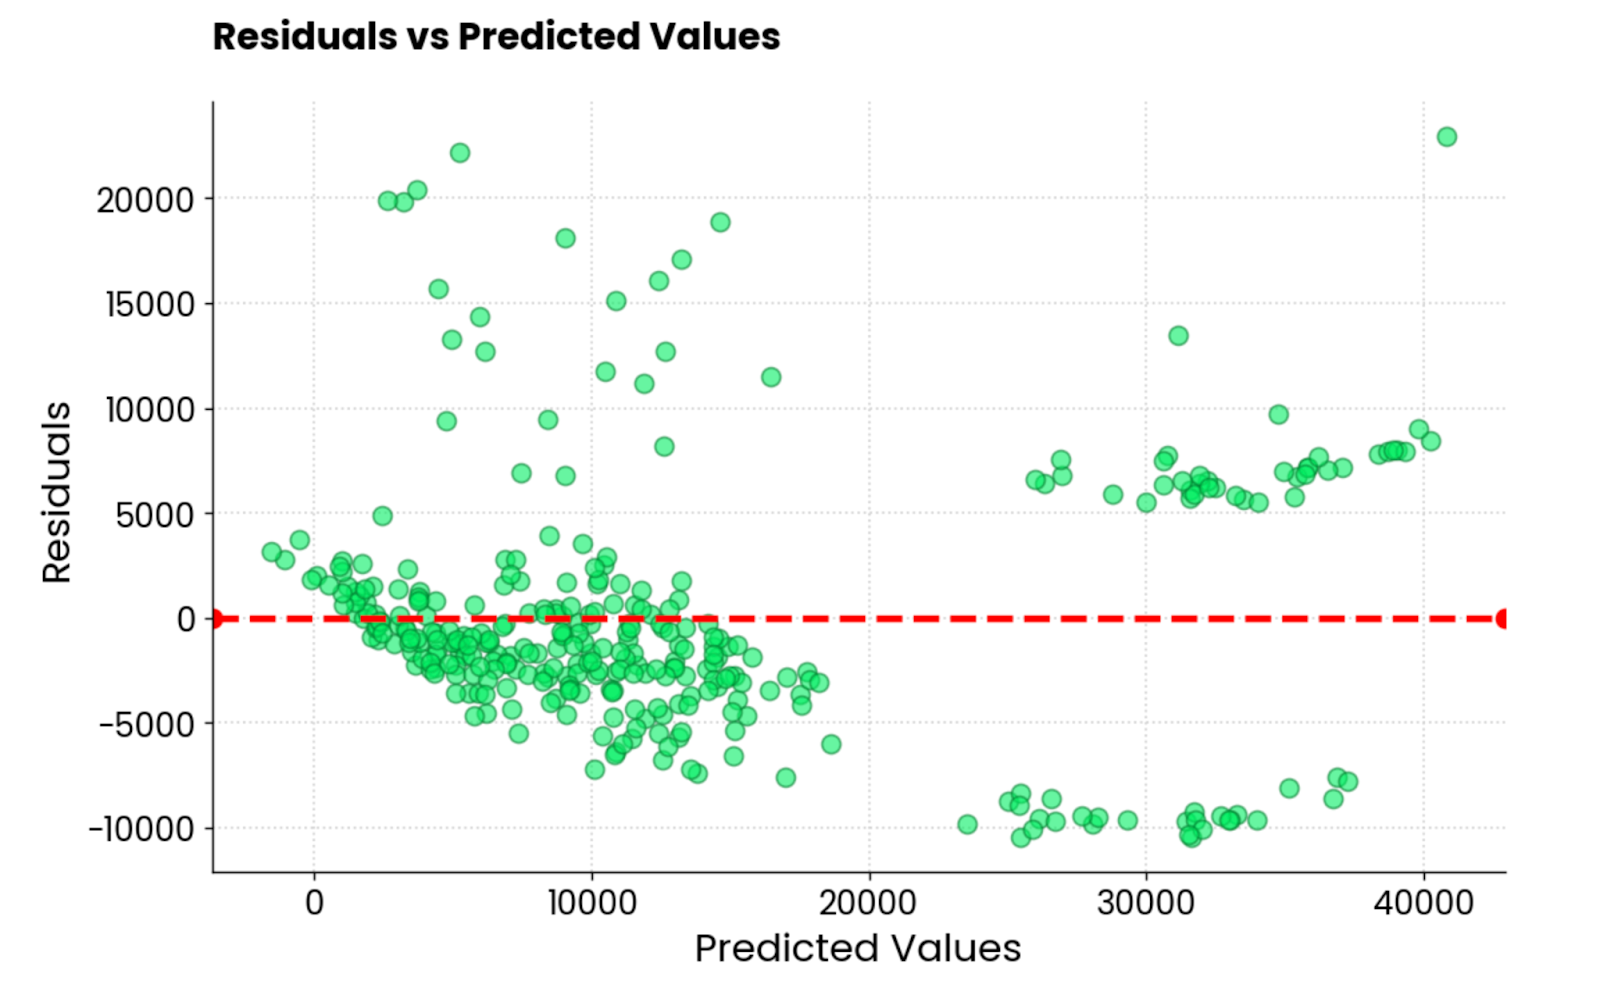
线性回归模型残差。作者供图。
这不是我见过的最佳残差图。看起来美观,但数值分布非常分散。如果您是从业者并得到类似残差图,说明还有大量工作要做。
接下来我将展示三种可视化神经网络模型的方法。
如果说机器学习中哪一块最需要可视化与解释,那必然是神经网络。
它们在最基本层面都不易理解:有不同的层类型、激活函数和反向传播,仅举几例。因此,神经网络常被视为黑盒模型的代名词。
不必如此。
本节我将展示三种可视化神经网络的方法:网络结构图、实时训练指标以及 Grad-CAM。
我偏好的库是 TensorFlow。如果您从未听说过,我们 have a TensorFlow 入门课程 可以助您快速起步!
当您可视化神经网络模型的结构时,有一件事将被解密——张量形状(shapes)。
换句话说,您会看到底层矩阵在经过各层时如何在尺寸上发生变化。对于新手而言,这可能是个难点,因此任何可视化都大有裨益。
作为演示,我将用 TensorFlow 创建一个用于手写数字分类的基础神经网络模型。接着用 plot_model() 函数把模型结构图保存为本地文件。
请看:
from tensorflow.keras import layers, models
from tensorflow.keras.utils import plot_model

model = models.Sequential()
model.add(layers.Input(shape=(28, 28, 1)))
model.add(layers.Conv2D(32, (3, 3), activation="relu"))
model.add(layers.MaxPooling2D((2, 2)))
model.add(layers.Conv2D(64, (3, 3), activation="relu"))
model.add(layers.MaxPooling2D((2, 2)))
model.add(layers.Flatten())
model.add(layers.Dense(64, activation="relu"))
model.add(layers.Dense(10, activation="softmax"))
plot_model(model, to_file="model_architecture.png", show_shapes=True, show_layer_names=True)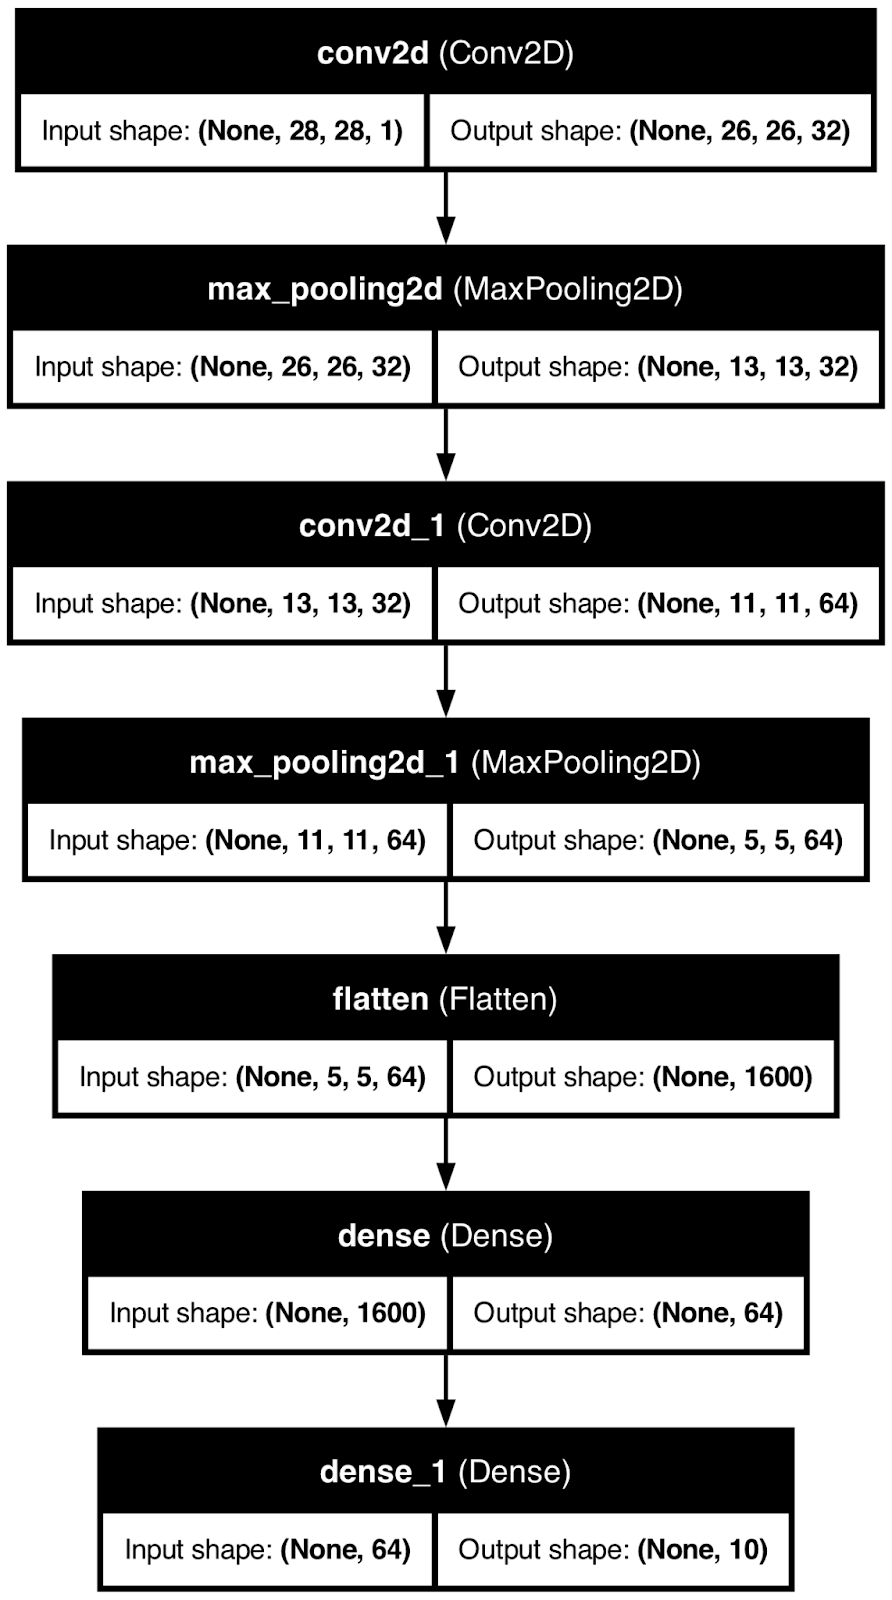
神经网络模型结构。作者供图。
虽然有帮助,但这种可视化的能力有限。
您知道数据是如何在各层间变换的,但并不了解神经网络模型如何得出结论。下一节就来解决这个问题。
Grad-CAM,全称Gradient Class Activation Mapping(梯度类激活映射),是一种用于可视化卷积神经网络模型的常用技术。
更准确地说,它帮助您理解输入图像的哪些区域对模型的预测贡献最大。可以把它看作决策树特征重要性的“加强版”。
这是一种高级可解释性技术,适用于所有卷积模型(不受架构限制),帮助您理解模型为何做出某个预测。
但问题在于——用 Python 实现它并不简单。以下是算法的高层概览:
这是一套相当繁琐的流程。为简化实现,我将使用一个预训练的 ResNet50 模型,它已能分类 1000 种图像类型。
但首先,加载必要的库和您想应用 Grad-CAM 的图像。我使用的是a 狗的素材图片:
import cv2
import tensorflow as tf
from tensorflow.keras.applications.resnet50 import ResNet50
from tensorflow.keras.preprocessing.image import load_img

image = np.array(load_img("dog.jpg", target_size=(224, 224, 3)))
plt.grid(False)
plt.imshow(image)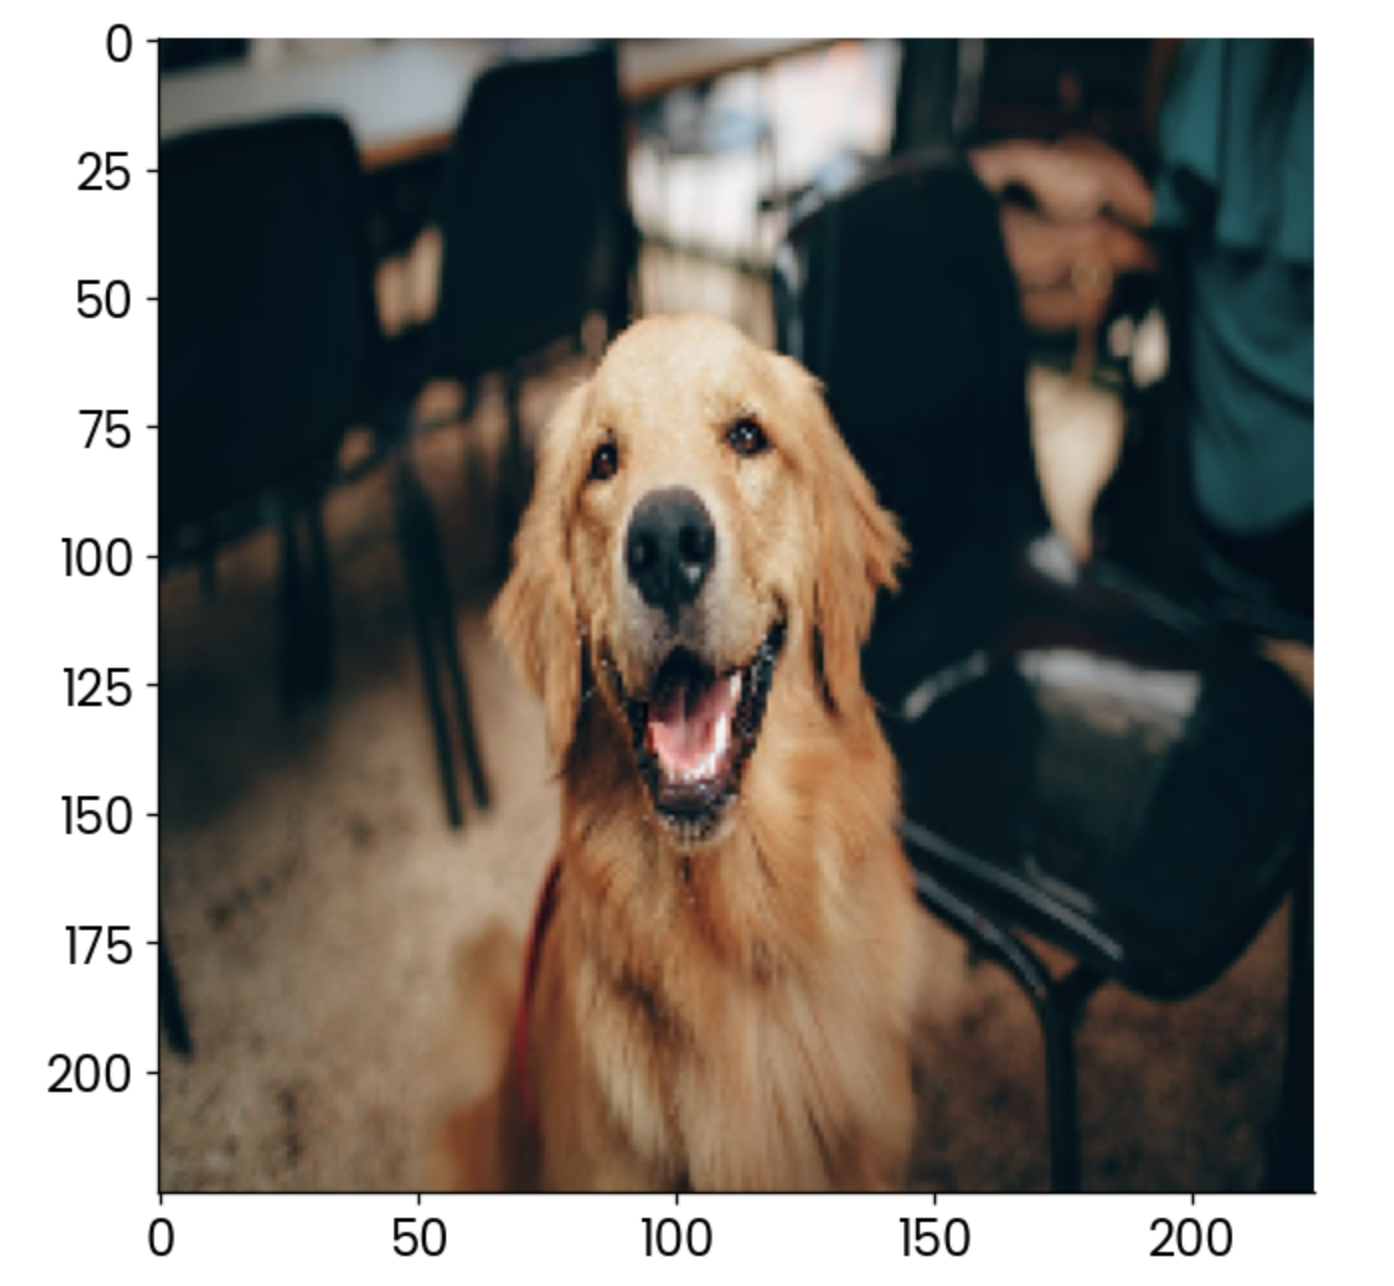
狗的示例图片。作者供图。
接下来进入有趣的部分。下面的代码实现了前述四个步骤。每行代码上方都有注释,便于理解:
# Load the pre-trained ResNet50 model
model = ResNet50()

# Extract the output of the last convolutional layer
last_conv_layer = model.get_layer("conv5_block3_out")

# Create a model that outputs the last convolutional layer’s activations
last_conv_layer_model = tf.keras.Model(model.inputs, last_conv_layer.output)

# Prepare the classifier model using the layers after the last convolutional layer
classifier_input = tf.keras.Input(shape=last_conv_layer.output.shape[1:])
x = classifier_input
for layer_name in ["avg_pool", "predictions"]:
    # Reuse the pooling and prediction layers from the ResNet50 model
    x = model.get_layer(layer_name)(x)

# Create a new model that takes in the last conv layer output and returns predictions
classifier_model = tf.keras.Model(classifier_input, x)

# Use a GradientTape to record operations for automatic differentiation
with tf.GradientTape() as tape:
    # Prepare the input image and get the activations from the last conv layer
    inputs = image[np.newaxis, ...]
    last_conv_layer_output = last_conv_layer_model(inputs)
    tape.watch(last_conv_layer_output)  # Watch the conv layer output
    # Get predictions from the classifier model
    preds = classifier_model(last_conv_layer_output)
    # Get the index of the highest predicted class
    top_pred_index = tf.argmax(preds[0])
    # Focus on the prediction of the top class
    top_class_channel = preds[:, top_pred_index]

# Compute the gradient of the top predicted class with respect to the conv layer output
grads = tape.gradient(top_class_channel, last_conv_layer_output)

# Average the gradients over the width and height dimensions
pooled_grads = tf.reduce_mean(grads, axis=(0, 1, 2))

# Multiply each channel in the conv layer output by its corresponding gradient
last_conv_layer_output = last_conv_layer_output.numpy()[0]
pooled_grads = pooled_grads.numpy()
for i in range(pooled_grads.shape[-1]):
    last_conv_layer_output[:, :, i] *= pooled_grads[I]

# Compute the Grad-CAM by averaging the channels and apply a ReLU activation
gradcam = np.mean(last_conv_layer_output, axis=-1)

# Normalize the Grad-CAM to be between 0 and 1
gradcam = np.clip(gradcam, 0, np.max(gradcam)) / np.max(gradcam)

# Resize the Grad-CAM heatmap to the size of the original image (224x224)
gradcam = cv2.resize(gradcam, (224, 224))
步骤很多没错,但现在终于可以绘制 Grad-CAM 算法生成的热力图了:
plt.grid(False)
plt.imshow(gradcam)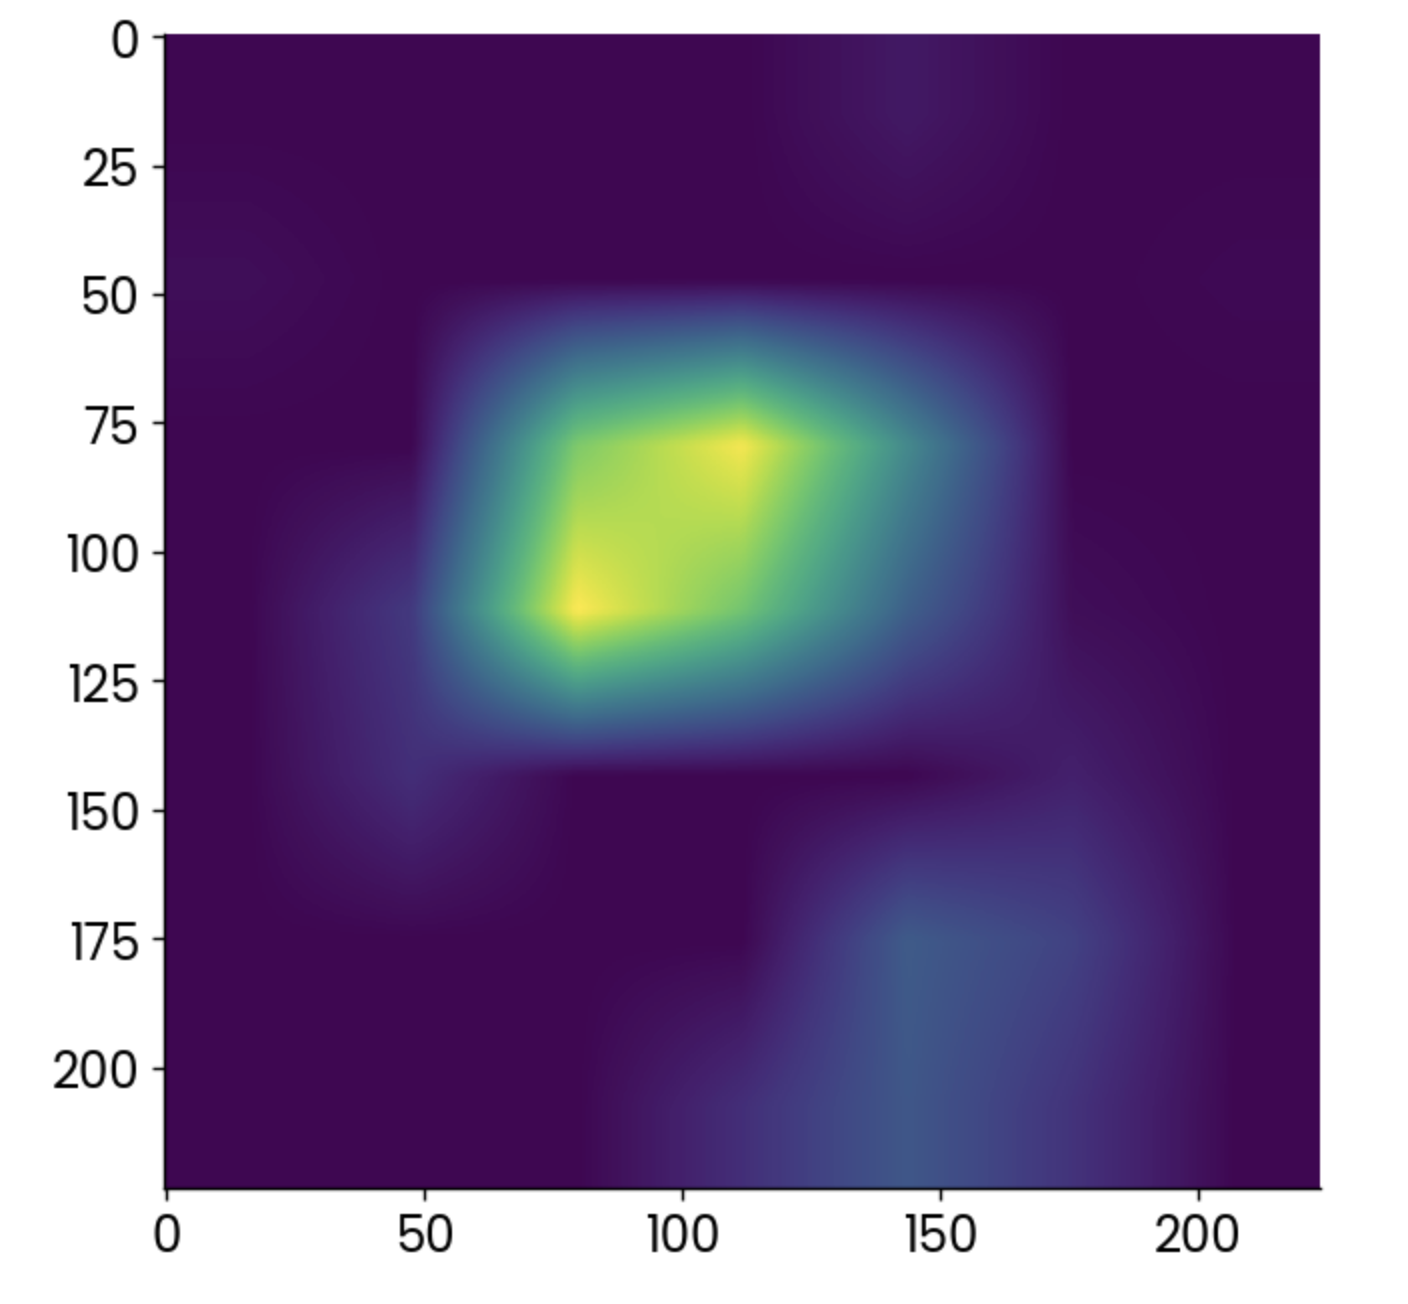
Grad-CAM 热力图。作者供图。
较亮的区域表示激活最高的部分,但单独看热力图信息有限。
把它叠加到原图上,并稍微降低不透明度,会更好:
plt.grid(False)
plt.imshow(image)
plt.imshow(gradcam, alpha=0.5)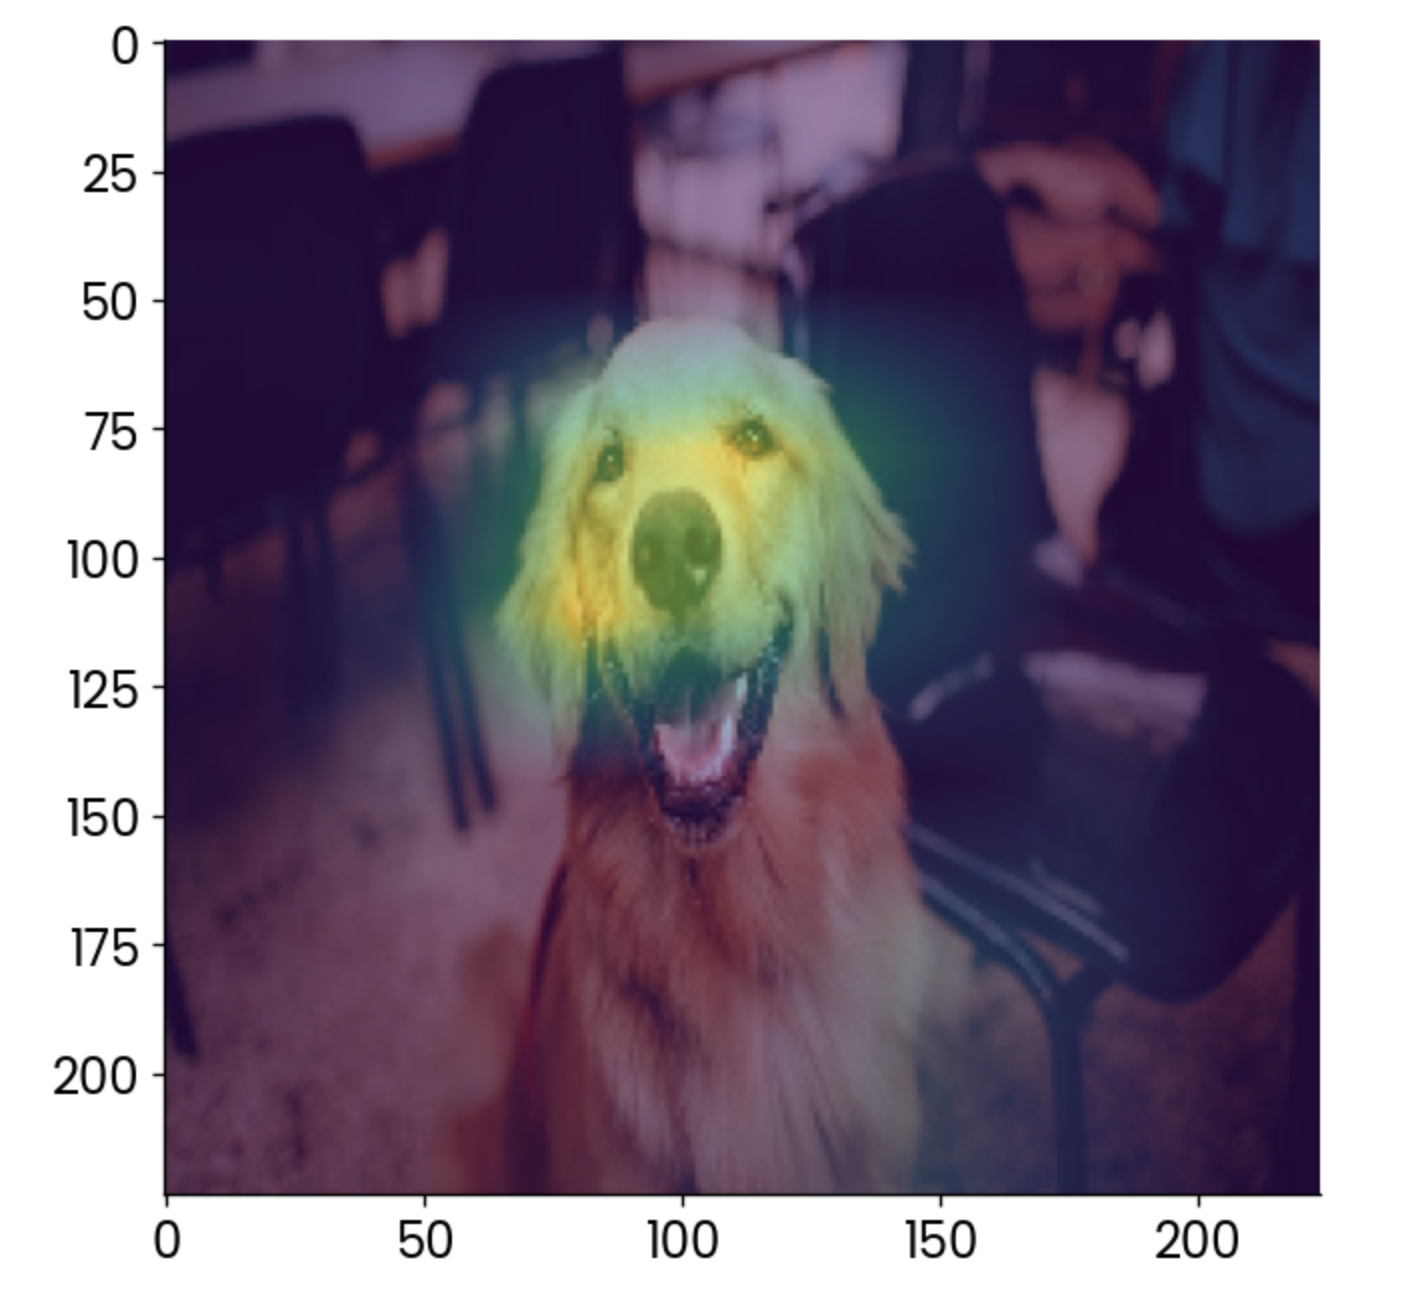
叠加 grad-CAM 的狗的图片。作者供图。
解读:将该图像归为“金毛寻回犬”的最大依据是面部,这很合理。
您可以用 Grad-CAM 来确保模型是在正确的方式进行预测。比如,如果热力图显示的是背景中的椅子而非狗脸是主要依据,您还会信任这个模型吗?
训练神经网络模型可能需要很长时间。好消息是,您无需等训练结束就能了解模型表现。TensorBoard 等库可以实时展示这些信息。
TensorBoard 随 TensorFlow 一同提供,因此无需额外安装即可跟进本文。
作为演示,我将训练一个基础的数字分类模型 25 个 epoch。关键部分在于回调(callback)——在其中指定训练日志的路径与格式,TensorBoard 稍后会使用。
以下是训练模型并存储训练日志的代码:
import tensorflow as tf
from tensorflow.keras import layers, models
from datetime import datetime

# Load MNIST dataset
mnist = tf.keras.datasets.mnist
(x_train, y_train), (x_test, y_test) = mnist.load_data()

# Normalize pixel values between 0 and 1
x_train, x_test = x_train / 255.0, x_test / 255.0

# Add a channels dimension (for the Convolutional layer)
x_train = np.expand_dims(x_train, -1)
x_test = np.expand_dims(x_test, -1)

# Build a simple CNN model
model = models.Sequential([
    layers.Conv2D(32, kernel_size=(3, 3), activation="relu", input_shape=(28, 28, 1)),
    layers.MaxPooling2D(pool_size=(2, 2)),
    layers.Flatten(),
    layers.Dense(128, activation="relu"),
    layers.Dense(10, activation="softmax")
])

# Compile the model
model.compile(
    optimizer="adam",
    loss="sparse_categorical_crossentropy",
    metrics=["accuracy"]
)

# Set up TensorBoard callback
log_dir = "logs/fit/" + datetime.now().strftime("%Y%m%d-%H%M%S")
tensorboard_callback = tf.keras.callbacks.TensorBoard(log_dir=log_dir, histogram_freq=1)

# Train the model with TensorBoard monitoring
model.fit(
    x_train,
    y_train,
    epochs=25,
    validation_data=(x_test, y_test),
    callbacks=[tensorboard_callback]
)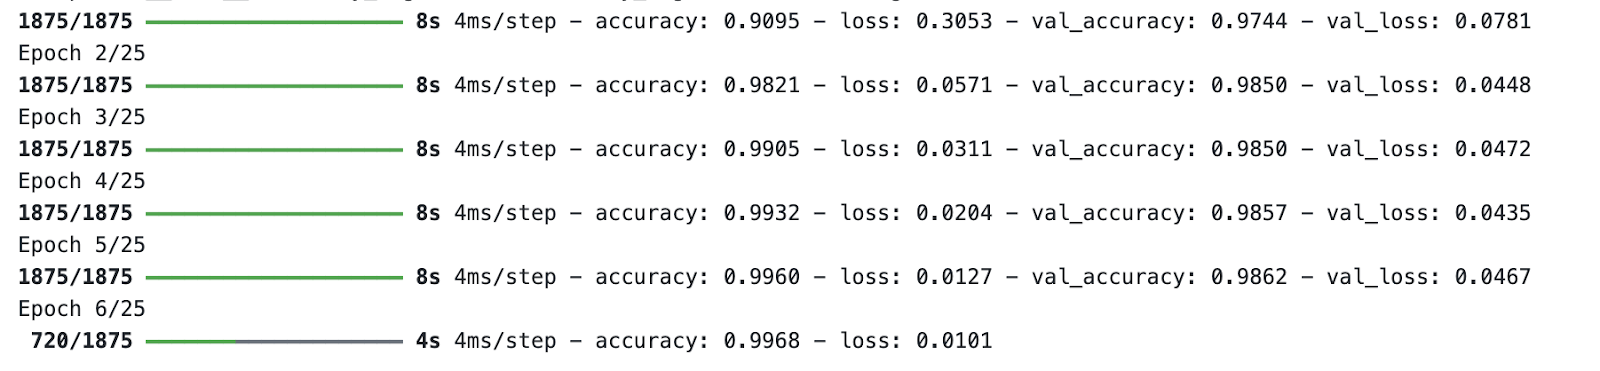
模型训练过程。作者供图。
在模型训练期间,从终端运行 TensorBoard,并指定训练日志目录:
tensorboard --logdir=logs/fit默认情况下,TensorBoard 运行在 6006 端口:
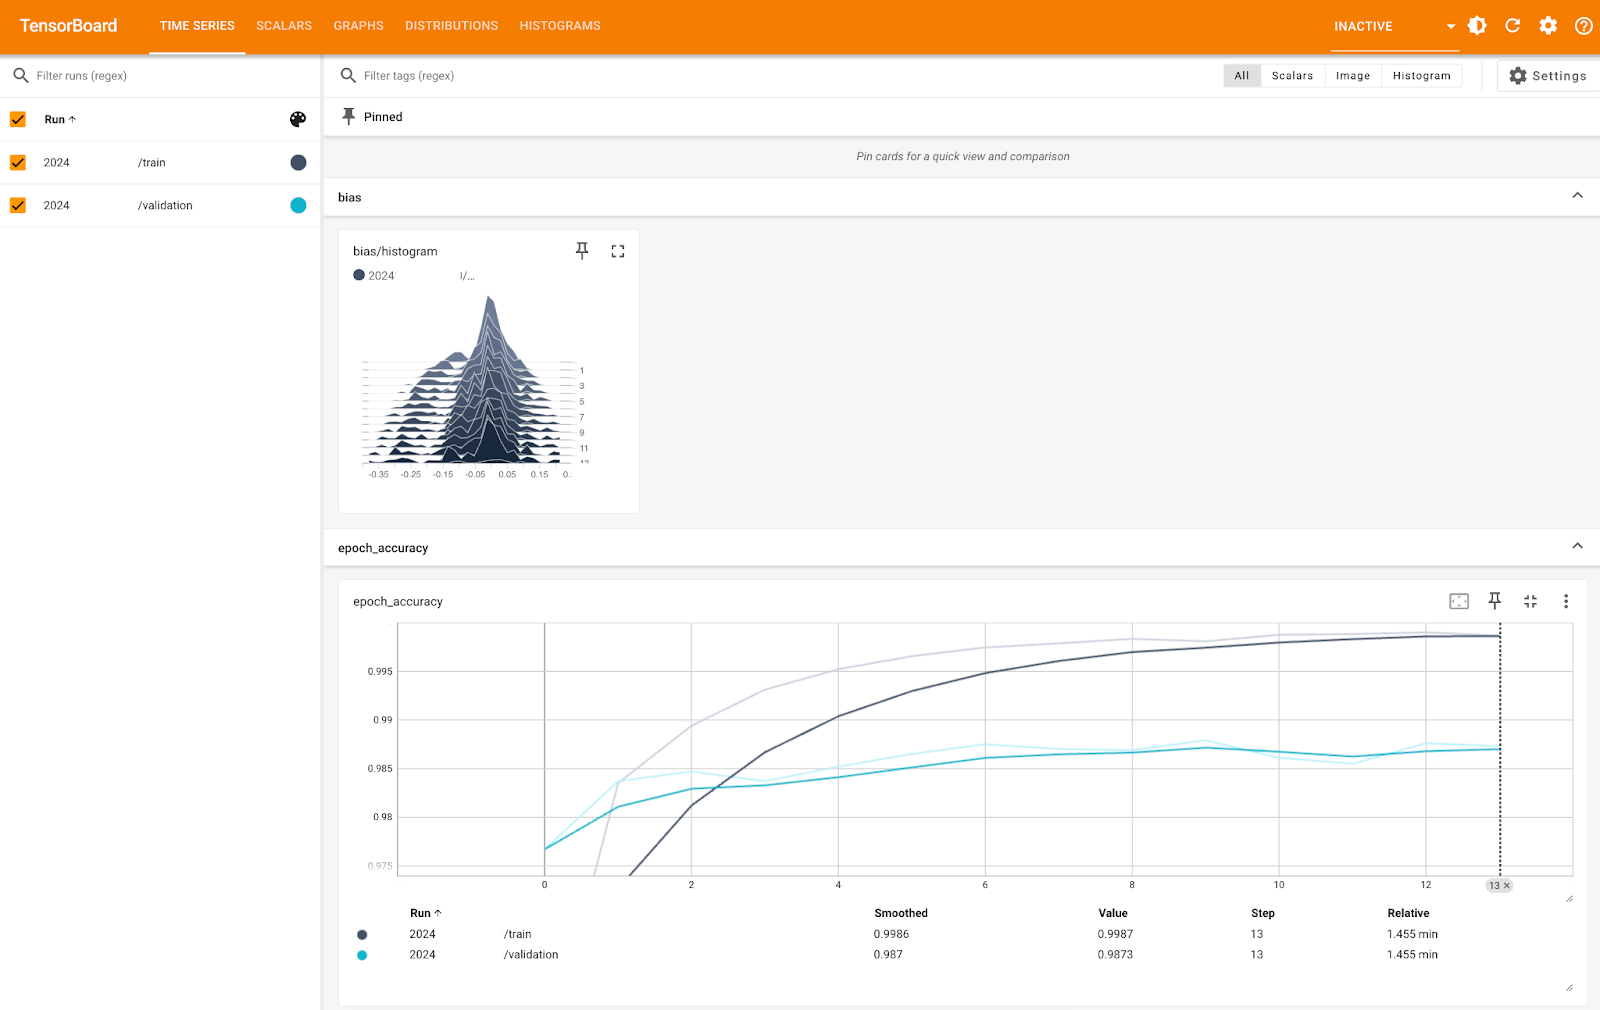
TensorBoard 指标(1)。作者供图。
上图展示了偏置直方图和每个 epoch 的准确率(训练与验证集)。您可以看到两者准确率都很高,接近 100%——只是 Y 轴刻度太小。
其他选项卡将深入更具体的指标,并允许您进行一些调整,如下图所示:
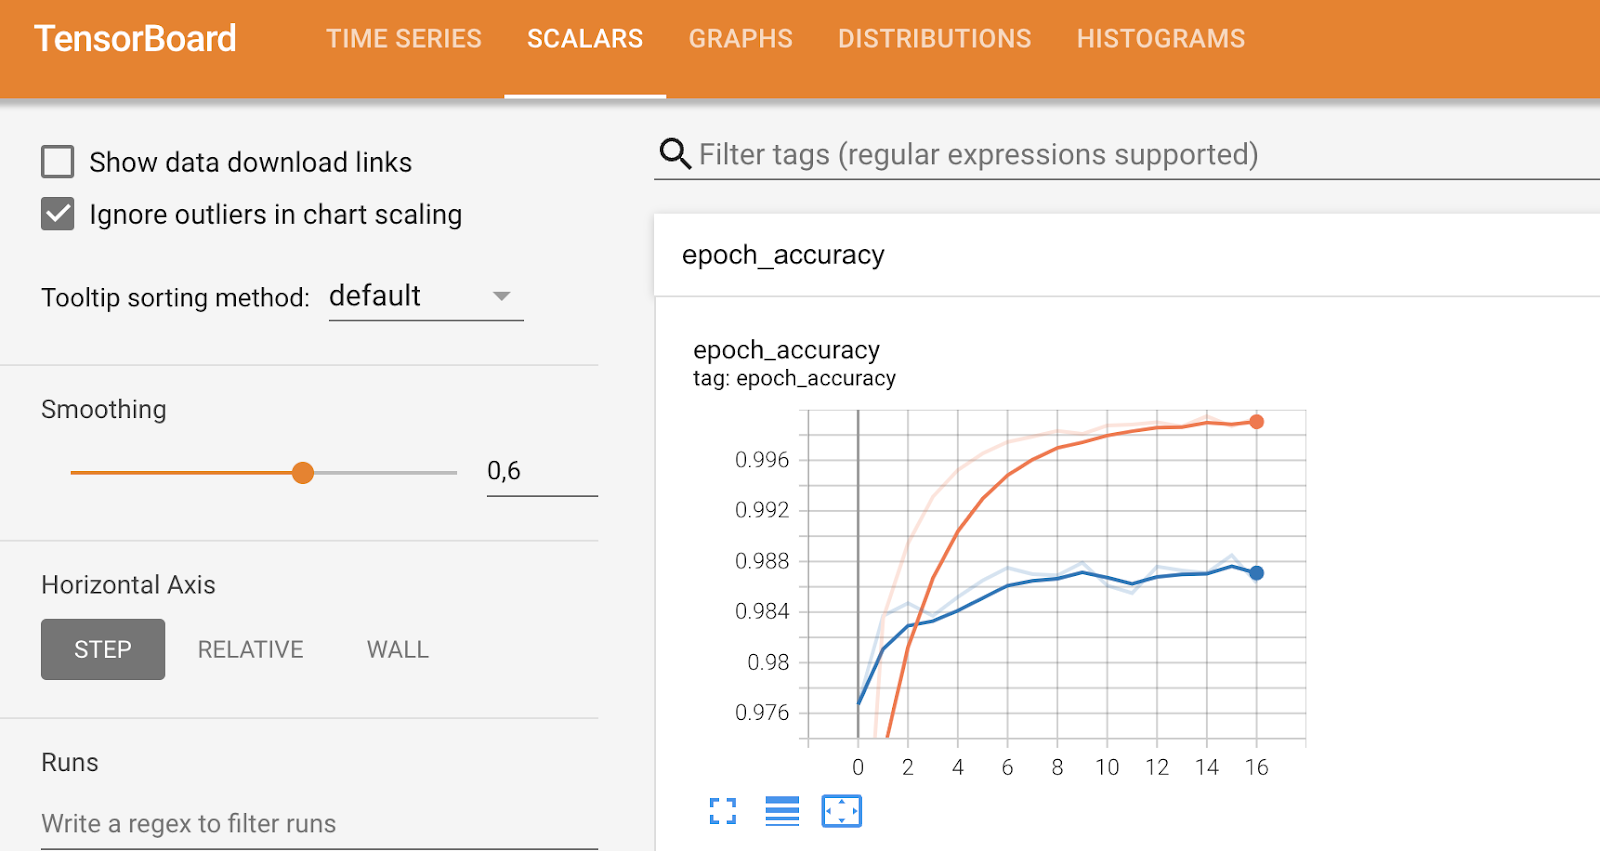
TensorBoard 指标(2)。作者供图。
总之,TensorBoard 是一款非常实用的模型性能可视化工具,可帮助您在训练过程中分析模型表现。
最后一部分,我们退一步,深入了解更通用的模型性能可视化指标。
您将看到三种:混淆矩阵、ROC 曲线图和精确率-召回率曲线图。
由于它们和分类问题相关,您需要加载分类MBA 数据集。为简化处理,我也把它转换为二分类问题(将候补名单设置为拒绝)。其余代码将数据划分为训练/测试集,并先拟合一个随机森林分类模型:
from sklearn.ensemble import RandomForestClassifier

df = load_classification_dataset()
df["admission"] = df["admission"].replace({"Waitlist": "Deny"})
df["admission"] = df["admission"].replace({"Deny": 0, "Admit": 1})
df.rename(columns={"admission": "is_admitted"}, inplace=True)
X = df.drop("is_admitted", axis=1)
y = df["is_admitted"]
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.25, random_state=42)
random_forest = RandomForestClassifier(n_estimators=25, random_state=42)
random_forest.fit(X_train, y_train)
我们先看第一个指标——混淆矩阵。
混淆矩阵能告诉您模型的表现如何。理想情况下,从左上到右下的对角线是唯一的非零元素,表示模型没有产生任何错误预测。
但现实世界中很少如此完美。
解释二分类混淆矩阵的要点如下:
没有通用规则规定应更关注假正还是假负。在 MBA 录取场景中,假正更“痛”,因为模型将学生判为录取,而现实却不是。另一些场景(如癌症预测)则必须尽量减少假负,因为您绝不希望把有癌症的人判为健康。
这就需要领域知识参与决策。
回到代码。下面的代码在测试集上计算随机森林模型的混淆矩阵,并使用 ConfusionMatrixDisplay 类进行可视化:
from sklearn.metrics import confusion_matrix
from sklearn.metrics import confusion_matrix, ConfusionMatrixDisplay

preds = random_forest.predict(X_test)
cm = confusion_matrix(y_true=y_test, y_pred=preds, labels=random_forest.classes_)
disp = ConfusionMatrixDisplay(confusion_matrix=cm, display_labels=random_forest.classes_)
disp.plot()
plt.grid(False)
plt.title("Confusion Matrix", y=1.04)
plt.show()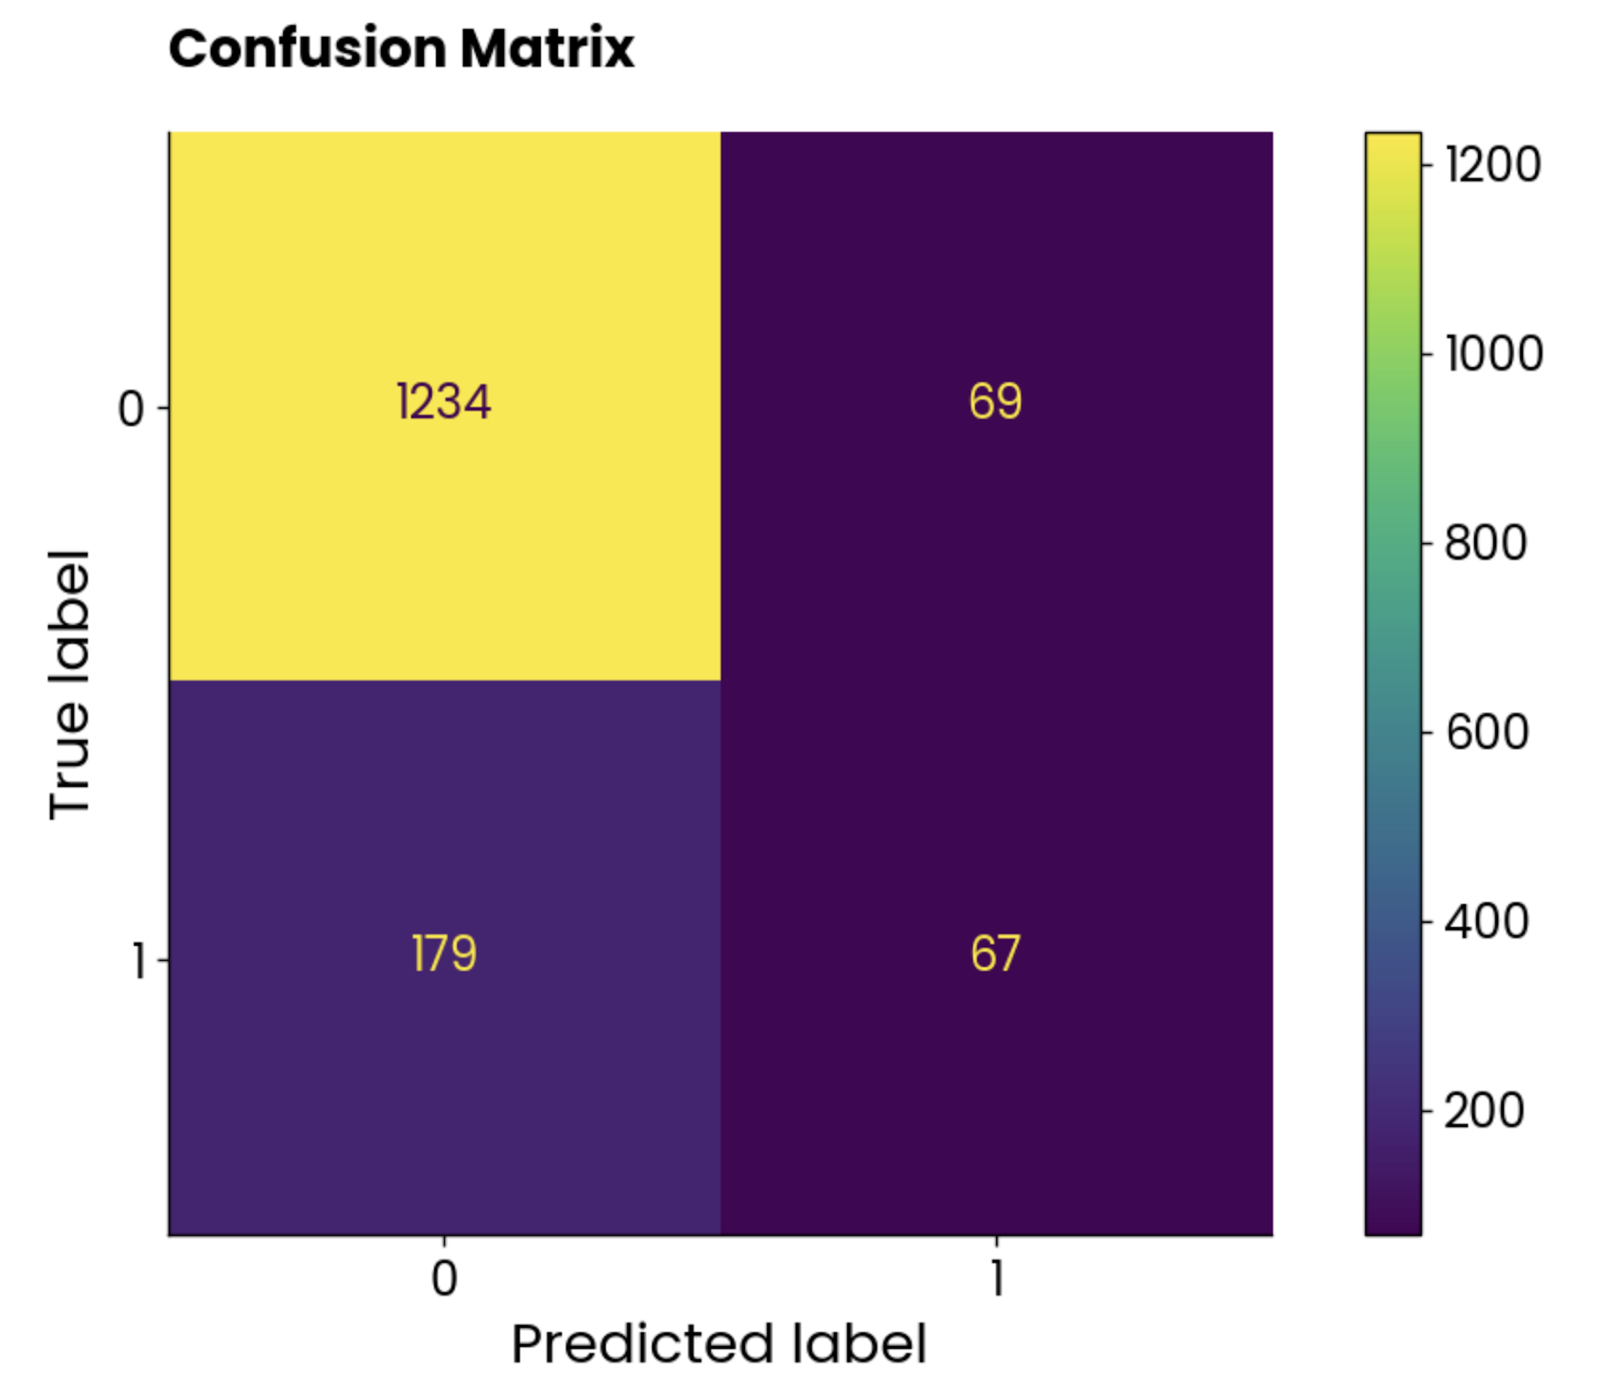
混淆矩阵图。作者供图。
类别并不平衡,且错误预测的数量惊人地高。
看看 ROC 曲线能告诉我们什么。
ROC 是Receiver Operating Characteristics 的缩写,是用于评估二分类模型性能的曲线。多分类时则需要两两比较类别。
ROC 曲线展示真正率(TPR,灵敏度、召回率)与假正率(FPR)在不同分类阈值下的权衡。TPR 作为 Y 轴,FPR 作为 X 轴。每个点代表用于正负分类判定的不同概率阈值。
通常会绘制一条从 (0, 0) 到 (1, 1) 的对角线,表示随机分类器。
如果曲线位于对角线上方,说明模型好于随机分类器。一个标量能总结这种表现,即AUC(曲线下面积),范围在 0 到 1 之间,越高越好,0.5 等同随机。
简言之,您希望曲线尽可能靠近左上角。
使用以下代码计算 ROC 与 AUC 并绘制曲线:
from sklearn.metrics import roc_curve, auc

# Get predicted probabilities for the positive class
y_probs = random_forest.predict_proba(X_test)[:, 1]
fpr, tpr, roc_thresholds = roc_curve(y_test, y_probs)
roc_auc = auc(fpr, tpr)
plt.plot(fpr, tpr, label=f"AUC = {roc_auc:.2f}")
plt.plot([0, 1], [0, 1], color="navy", linestyle="--")
plt.xlim([0.0, 1.0])
plt.ylim([0.0, 1.05])
plt.xlabel("False Positive Rate")
plt.ylabel("True Positive Rate")
plt.title("ROC Curve", y=1.04)
plt.legend(loc="lower right")
plt.show()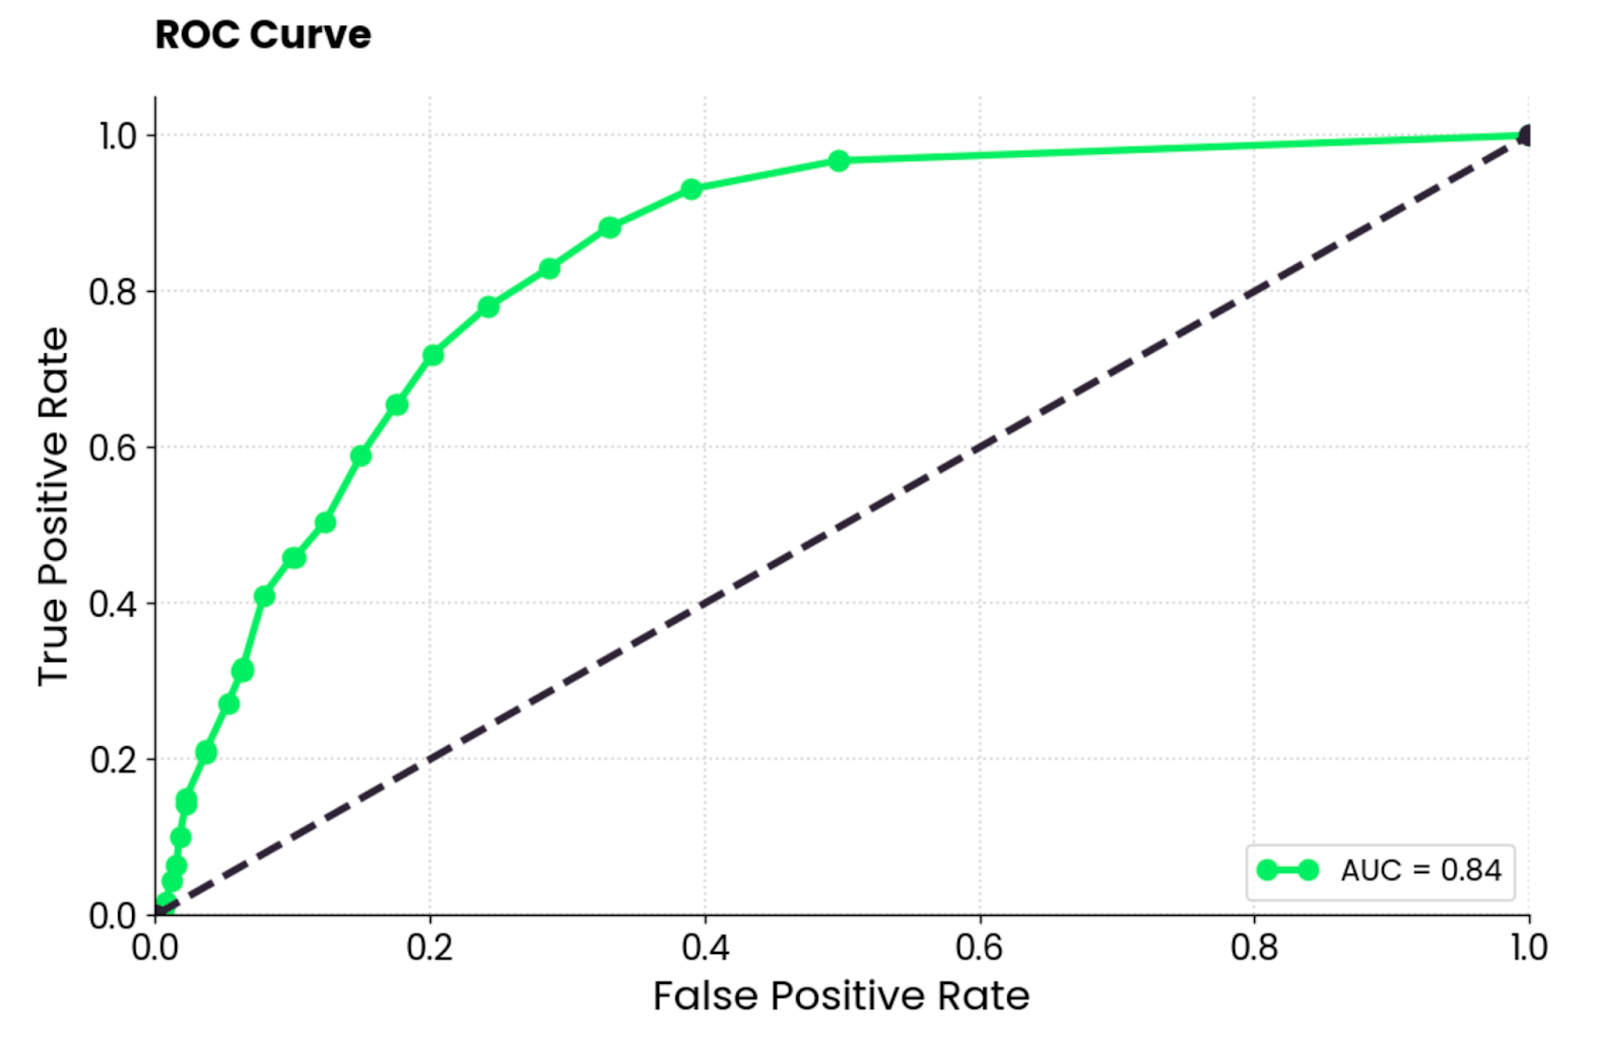
ROC 曲线图。作者供图。
解读:随机森林模型明显优于随机分类器,且在真正率与假正率之间取得了合理平衡。但仍存在一定程度的误分类,您应通过优化数据或选择不同模型,努力将曲线整体向左上角抬升。
该曲线与 ROC 类似,但展示的是精确率与召回率在不同分类阈值下的权衡。Y 轴为精确率、X 轴为召回率。在类别不平衡时,通常优先使用 PR 曲线。
MBA 录取数据集正是这种情况,因此 PR 曲线很合适!
需要注意的是,精确率-召回率曲线只关注少数类,更能反映模型识别最重要实例的能力(被录取学生、被检测出的癌症等)。
使用以下代码计算精确率与召回率,并绘制曲线:
from sklearn.metrics import precision_recall_curve

# Get predicted probabilities for the positive class
y_probs = random_forest.predict_proba(X_test)[:, 1]

# Precision-Recall curve
precision, recall, pr_thresholds = precision_recall_curve(y_test, y_probs)
pr_auc = auc(recall, precision)
plt.plot(recall, precision, label=f"(AUC = {pr_auc:.2f})")
plt.xlabel("Recall")
plt.ylabel("Precision")
plt.title("Precision-Recall Curve", y=1.04)
plt.legend(loc="lower left")
plt.show()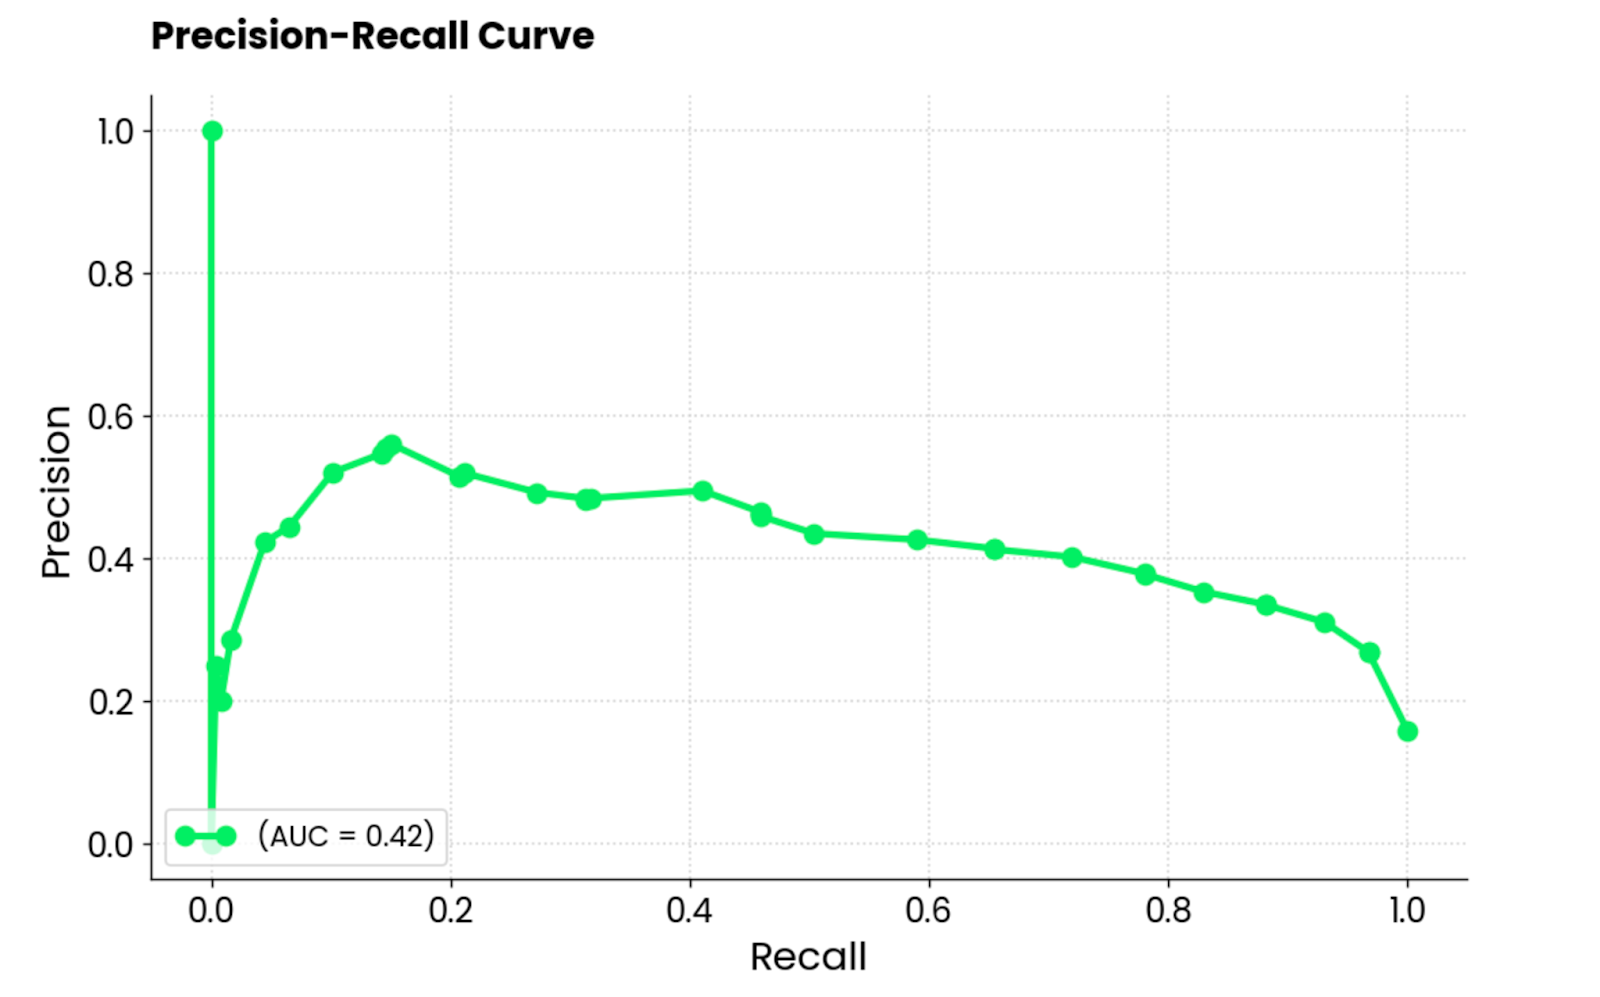
精确率-召回率曲线图。作者供图。
解读:AUC 得分为 0.42,模型表现不佳。模型尝试提升召回率时牺牲了过多精确率,导致大量假正类。简而言之,该模型不适合此数据集,或数据集本身的预处理尚不充分。
总的来说,机器学习领域复杂且常常不直观。作为初学者,理解其核心理念并不容易;与业务方合作时,对方也很可能听不懂技术术语。
数据可视化能在这两种情况下架起桥梁。
今天,您已经了解了可用于可视化回归与分类模型的多种图表,也看到了如何可视化神经网络的决策过程,以及通过 SHAP 与 LIME 解释单条预测。这信息量很大,欢迎多次回看!
如果您完全是新手,建议先观看我们的机器学习基础课程入门。之后,再学习更偏应用的 Python 课程会很合适。
如果您已有一定经验,但还不清楚全局是如何运作的,欢迎尝试我们的生产环境中的机器学习课程。
通过以下课程,深入学习机器学习!
课程
课程
课程