
Kurs
Machine Learning'i Anlamak
2 sa
311.3K
Bu kısa bölümde, makine öğrenimi modellerini görselleştirmek için gereken sistem genelindeki bağımlılıkları ve Python kütüphanelerini nasıl kuracağınızı göstereceğim.
Takip edebilmeniz için ihtiyaç duyacağınız tek sistem genelindeki bağımlılık Graphviz’dir. İleride bir karar ağacını görselleştirmek için kullanacaksınız ve Graphviz kurulmadan kod çalışmayacaktır.
Şemalar, soyut grafikler ve ağlar oluşturmak için kullanılan açık kaynaklı bir yazılımdır. Doğrudan değil; yalnızca scikit-learn üzerinden kullanacaksınız.
Bu Python kütüphanesi, Python’daki makine öğrenimi görevleri için yaygın olarak kullanılır.
Bu yazıda, makine öğrenimi modelleri eğitmek, veri kümelerini bölmek, sayısal özellikleri ölçeklemek ve model performansını görselleştirmek için kullanacaksınız. Vazgeçilmezdir, bu yüzden Python ortamınıza bağlı olarak aşağıdaki komutla kurun:
pip install scikit-learn
conda install scikit-learn
scikit-learn’e tamamen yeniyseniz, popüler denetimli makine öğrenimi kursumuzu izlemenizi öneririz.
Python’daki SHAP kütüphanesi, makine öğrenimi modellerinin tahminlerini açıklamak için popüler bir araçtır. Oyun teorisi kavramlarını (ör. Shapely değerleri) kullanarak her bir özniteliğin modelin tahminine katkısını ölçer.
Daha da iyisi, modellerinizin iç işleyişini anlamanıza yardımcı olan kullanışlı görselleştirmelerle doludur.
Aşağıdaki komutla kurun:
pip install shap
conda install -c conda-forge shapBu Python kütüphanesi, tek bir model tahminini açıklamanın kritik olduğu durumlarda birçok kişi tarafından kullanılır. SHAP’ten farklı çalışır. Orijinal modeli yerelde, yorumlanabilir ve daha basit bir modelle yaklaştırır. Ardından, veri kümesindeki her bir özelliğin tahmine katkısını gösterir.
LIME’ın nasıl çalıştığını birazdan göreceksiniz, ancak önce kurun:
pip install lime
conda install conda-forge::limeTensorFlow ile sinir ağı modelleri oluşturuyorsanız, TensorBoard kaçınılmazdır.
Makine öğrenimi deneylerini takip etmenize ve eğitim metriklerini (ör. kayıp ve doğruluk) izlemenize yardımcı olan bir görselleştirme aracıdır. Model grafiklerini gerçek zamanlı olarak görselleştirir ve günceller, ayrıca eğitim sırasında model parametrelerinin nasıl değiştiğini gösterir.
TensorBoard, PyTorch gibi diğer derin öğrenme çerçeveleriyle de kullanılabilir, ancak bu makalede TensorFlow’a odaklanacağım.
Aşağıdaki komutu çalıştırarak kurun:
pip install tensorboard
conda install -c conda-forge tensorboardBu hazırlık aşamasındaki son adım, veriyle ilgilenmektir.
Bugün iki veri kümesi kullanacağım: MBA başvuruları sınıflandırma için ve Sigorta regresyon için. Her ikisi de ücretsizdir ve Kaggle’dan indirilebilir.
Başlamak için şu Python kütüphanelerini içe aktarın:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import train_test_split
Sınıflandırma veri kümesine gelince, yaptığım veri ön işlemesi asgari düzeydedir. Şunlara indirgenir:
Bu kesinlikle kapsamlı bir veri ön işleme hattı değildir. Vaktiniz varsa, dilediğiniz gibi iyileştirebilirsiniz.
Yine de, sınıflandırma veri kümesini düzene sokmak için bu fonksiyonu kopyalayın:
def load_classification_dataset() -> pd.DataFrame:
    # https://www.kaggle.com/datasets/taweilo/mba-admission-dataset?resource=download
    df = pd.read_csv("MBA.csv")

    # Just an arbitrary ID
    df = df.drop(["application_id"], axis=1)

    # Fill unknown
    df["race"] = df["race"].fillna("Unknown")

    # Assume these are denied
    df["admission"] = df["admission"].fillna("Deny")

    # Convert boolean cols to 0/1
    df["gender"] = df["gender"].replace({"Male": 0, "Female": 1})
    df["international"] = df["international"].replace({False: 0, True: 1})

    # Create dummy columns for categorical features
    cols_for_dummy = ["major", "race", "work_industry"]
    for col in cols_for_dummy:
        dummies = pd.get_dummies(df[col], prefix=col)
        df = pd.concat([df, dummies], axis=1)

    # To drop
    cols_to_drop = ["major", "race", "work_industry", "major_Humanities", "race_Unknown", "work_industry_Other"]
    df = df.drop(cols_to_drop, axis=1)
    return df

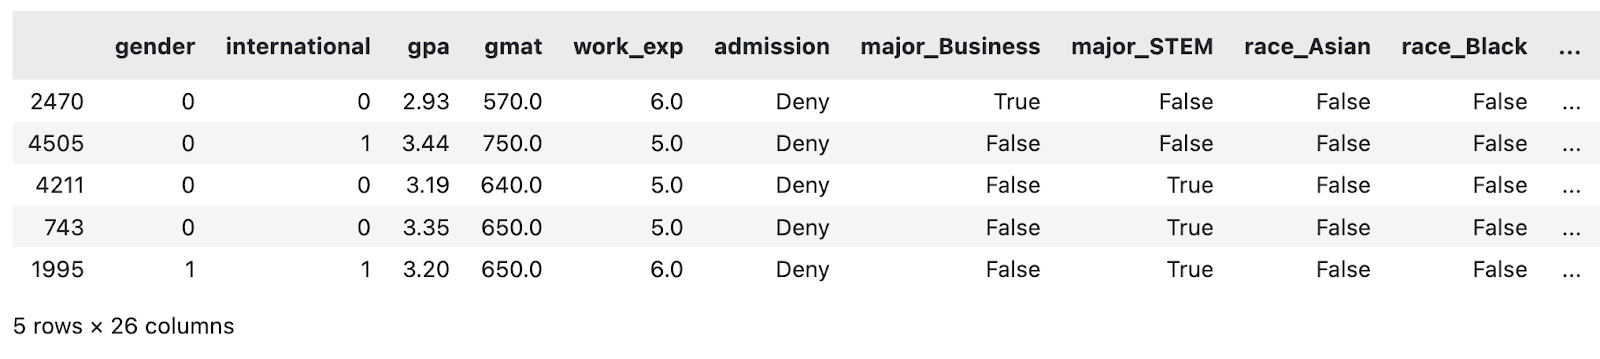
load_classification_dataset().sample(5)
Değiştirilmiş MBA veri kümesinden bir örnek. Görsel: Yazar.
Şimdi aynı işlemi regresyon veri kümesi için yapacağım.
Seçtiğim regresyon veri kümesi, makine öğrenimi modelinin diğer özniteliklere dayanarak tahmin etmeye çalışacağı sürekli bir özellik olarak sigorta tutarını ($) içerir.
Yaptığım veri ön işlemesi, yine epey minimaldir. Şunlara indirgenir:
Vaktiniz varsa, boru hattına daha fazla adım eklemekten çekinmeyin.
Sigorta veri kümesini yüklemek ve ön işlemek için aşağıdaki fonksiyonu kopyalayın:
def load_regression_dataset() -> pd.DataFrame:
    # https://www.kaggle.com/datasets/mirichoi0218/insurance
    df = pd.read_csv("MedicalCostPersonal.csv")

    # Scale numerical features
    cols_to_scale = ["age", "bmi", "children"]
    scaler = StandardScaler()
    df[cols_to_scale] = scaler.fit_transform(df[cols_to_scale])

    # Binary features
    df["sex"] = df["sex"].replace({"male": 0, "female": 1})
    df["smoker"] = df["smoker"].replace({"no": 0, "yes": 1})

    # Dummies
    dummies_region = pd.get_dummies(df["region"], prefix="region", drop_first=True)
    df = pd.concat([df, dummies_region], axis=1)
    df = df.drop("region", axis=1)
    return df

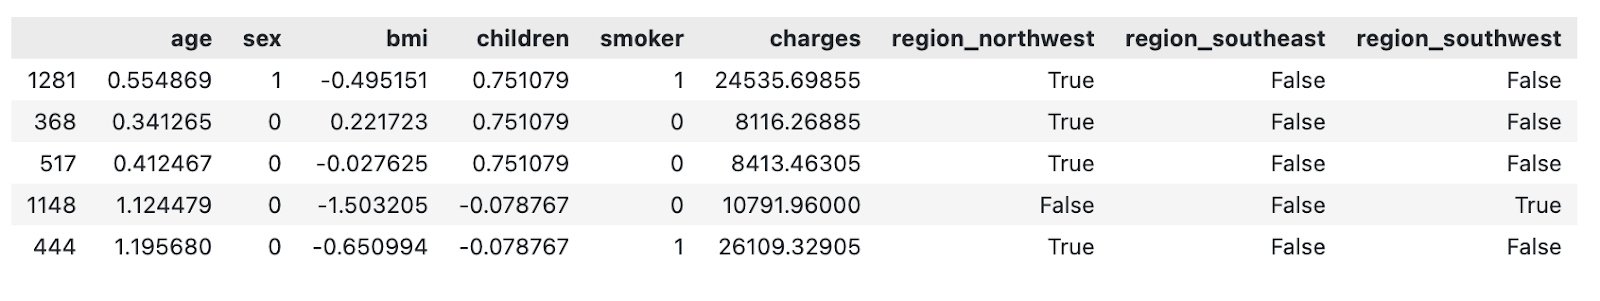
load_regression_dataset().sample(5)
Değiştirilmiş sigorta veri kümesinden bir örnek. Görsel: Yazar.
Ve hepsi bu!
Bir sonraki bölümde, makine öğrenimi modellerini görselleştirmeye nasıl başlayacağınızı göstereceğim.
Ağaç tabanlı modeller genellikle sınıflandırma için kullanılır, ancak çoğu regresyon görevlerini de ele alabilir.
Bu bölümde size bir karar ağacını görselleştirmeyi, bir rastgele orman modelinden özellik önemini ve tahmin açıklamalarını SHAP ve LIME ile nasıl yapacağınızı göstereceğim.
Karar ağacı ve rastgele orman modellerinin anlaşılmasının zor olabileceğini unutmayın. Python’da temellerini kapsayan ağaç tabanlı makine öğrenimi modelleri kursumuz var.
Başlamak için, sınıflandırma veri kümesini yükleyin ve eğitim ve test alt kümelerine ayırın:
df = load_classification_dataset()
X = df.drop("admission", axis=1)
y = df["admission"]
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.25, random_state=42)
Sırada bir karar ağacını görselleştirelim!
Bir karar ağacını, koşulları bir makine öğrenimi modelince belirlenen iç içe if ifadeleri kümesi olarak düşünün.
Daha fazlası da var, ancak bu benzetmeyle, kararları görselleştirmenin doğrudan bir süreç olması gerektiğini görebilirsiniz. Ve öyle: sklearn’den plot_tree() işlevi işin büyük kısmını halleder.
Bir karar ağacı modelini eğiterek başlayın. max_depth parametresi isteğe bağlıdır ve sadece görselleştirme amaçlı buradadır. Olmadan ağaç çok derinleşir ve özellikle büyük veri kümelerinde modelin verdiği kararların çokluğunda kaybolursunuz.
Aşağıdaki parça, eğitim alt kümesi üzerinde karar ağacı sınıflandırma modelini eğitir:
from sklearn import tree

decision_tree = tree.DecisionTreeClassifier(random_state=42, max_depth=4)
decision_tree.fit(X_train, y_train)
Ve görselleştirme için, aşağıdaki parçayı kopyalamanız yeterli. İsteğe bağlı filled ve feature_names parametreleri ağacı yorumlamayı kolaylaştırır:
plt.figure(figsize=(12,8))
tree.plot_tree(decision_tree, filled=True, feature_names=X.columns, class_names=y.unique())
plt.title("Decision Tree Visualization", size=20, loc="left", y=1.04, weight="bold")
plt.show()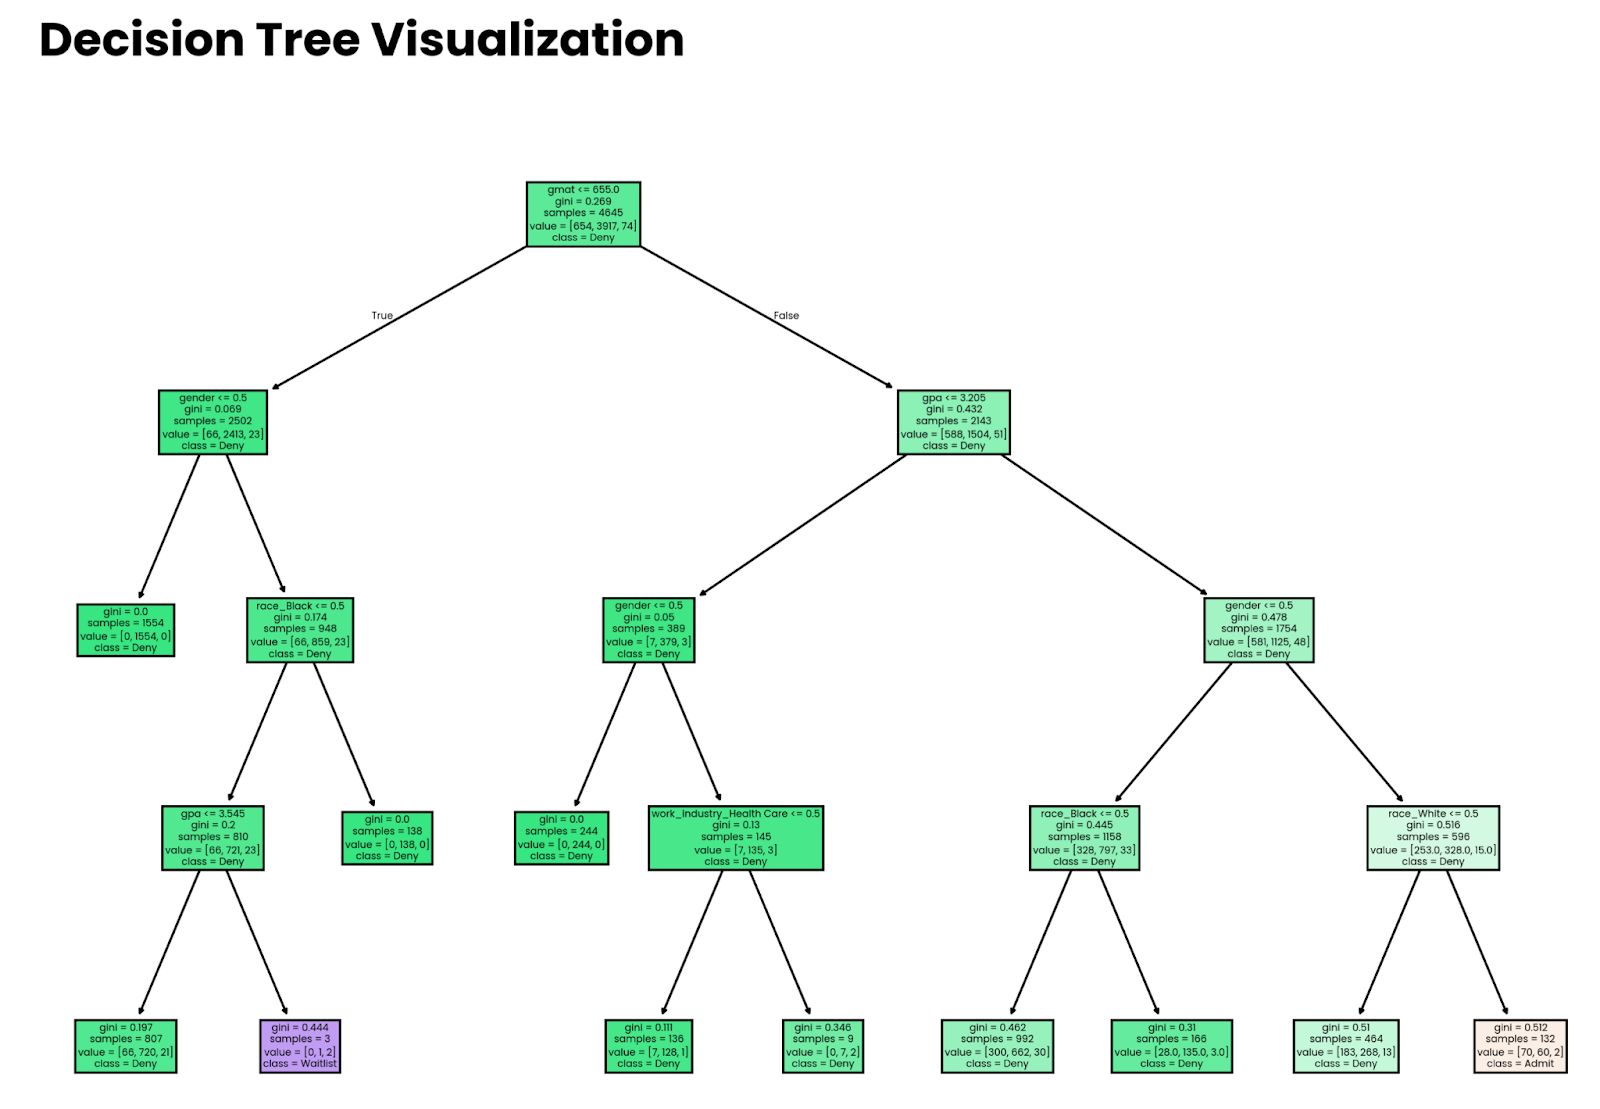
Dört seviyeli karar ağacı. Görsel: Yazar.
Modelin verdiği kararların, model doğru değilse bir anlam ifade etmediğini unutmayın. Yazının ilerleyen kısmında doğruluğu nasıl tahmin edeceğinizi göstereceğim.
Az önceki kek benzetmesini hatırladınız mı? Şimdi bunu uygulama zamanı.
sklearn ile her ağaç modeli eğittiğinizde, feature_importances_ özelliğine erişirsiniz. Bunu özellik adlarıyla eşleştirdiğinizde, tahmine en çok hangi özniteliklerin katkıda bulunduğunu görmek için gereken tüm verilere sahip olursunuz.
Hadi uygulayalım! Önce eğitim alt kümesi üzerinde bir rastgele orman sınıflandırıcısı eğitin:
from sklearn.ensemble import RandomForestClassifier

random_forest = RandomForestClassifier(n_estimators=25, random_state=42)
random_forest.fit(X_train, y_train)
Görselleştirme şimdi, özellik önemlerini çıkarmak ve sıralamak ve indeksleri özellik adlarıyla değiştirmeye kalıyor:
importances = random_forest.feature_importances_
indices = np.argsort(importances)[::-1]
plt.figure(figsize=(10,6))
bars = plt.bar(range(X.shape[1]), importances[indices], edgecolor="#008031", linewidth=1)

for bar in bars:
    height = bar.get_height()
    plt.text(bar.get_x() + bar.get_width() / 2, height, f"{height:.2f}", ha="center", va="bottom", size=8)

plt.title("Feature Importances", size=20, loc="left", y=1.04, weight="bold")
plt.ylabel("Importance")
plt.xticks(range(X.shape[1]), np.array(X.columns)[indices], rotation=90, size=12)
plt.show()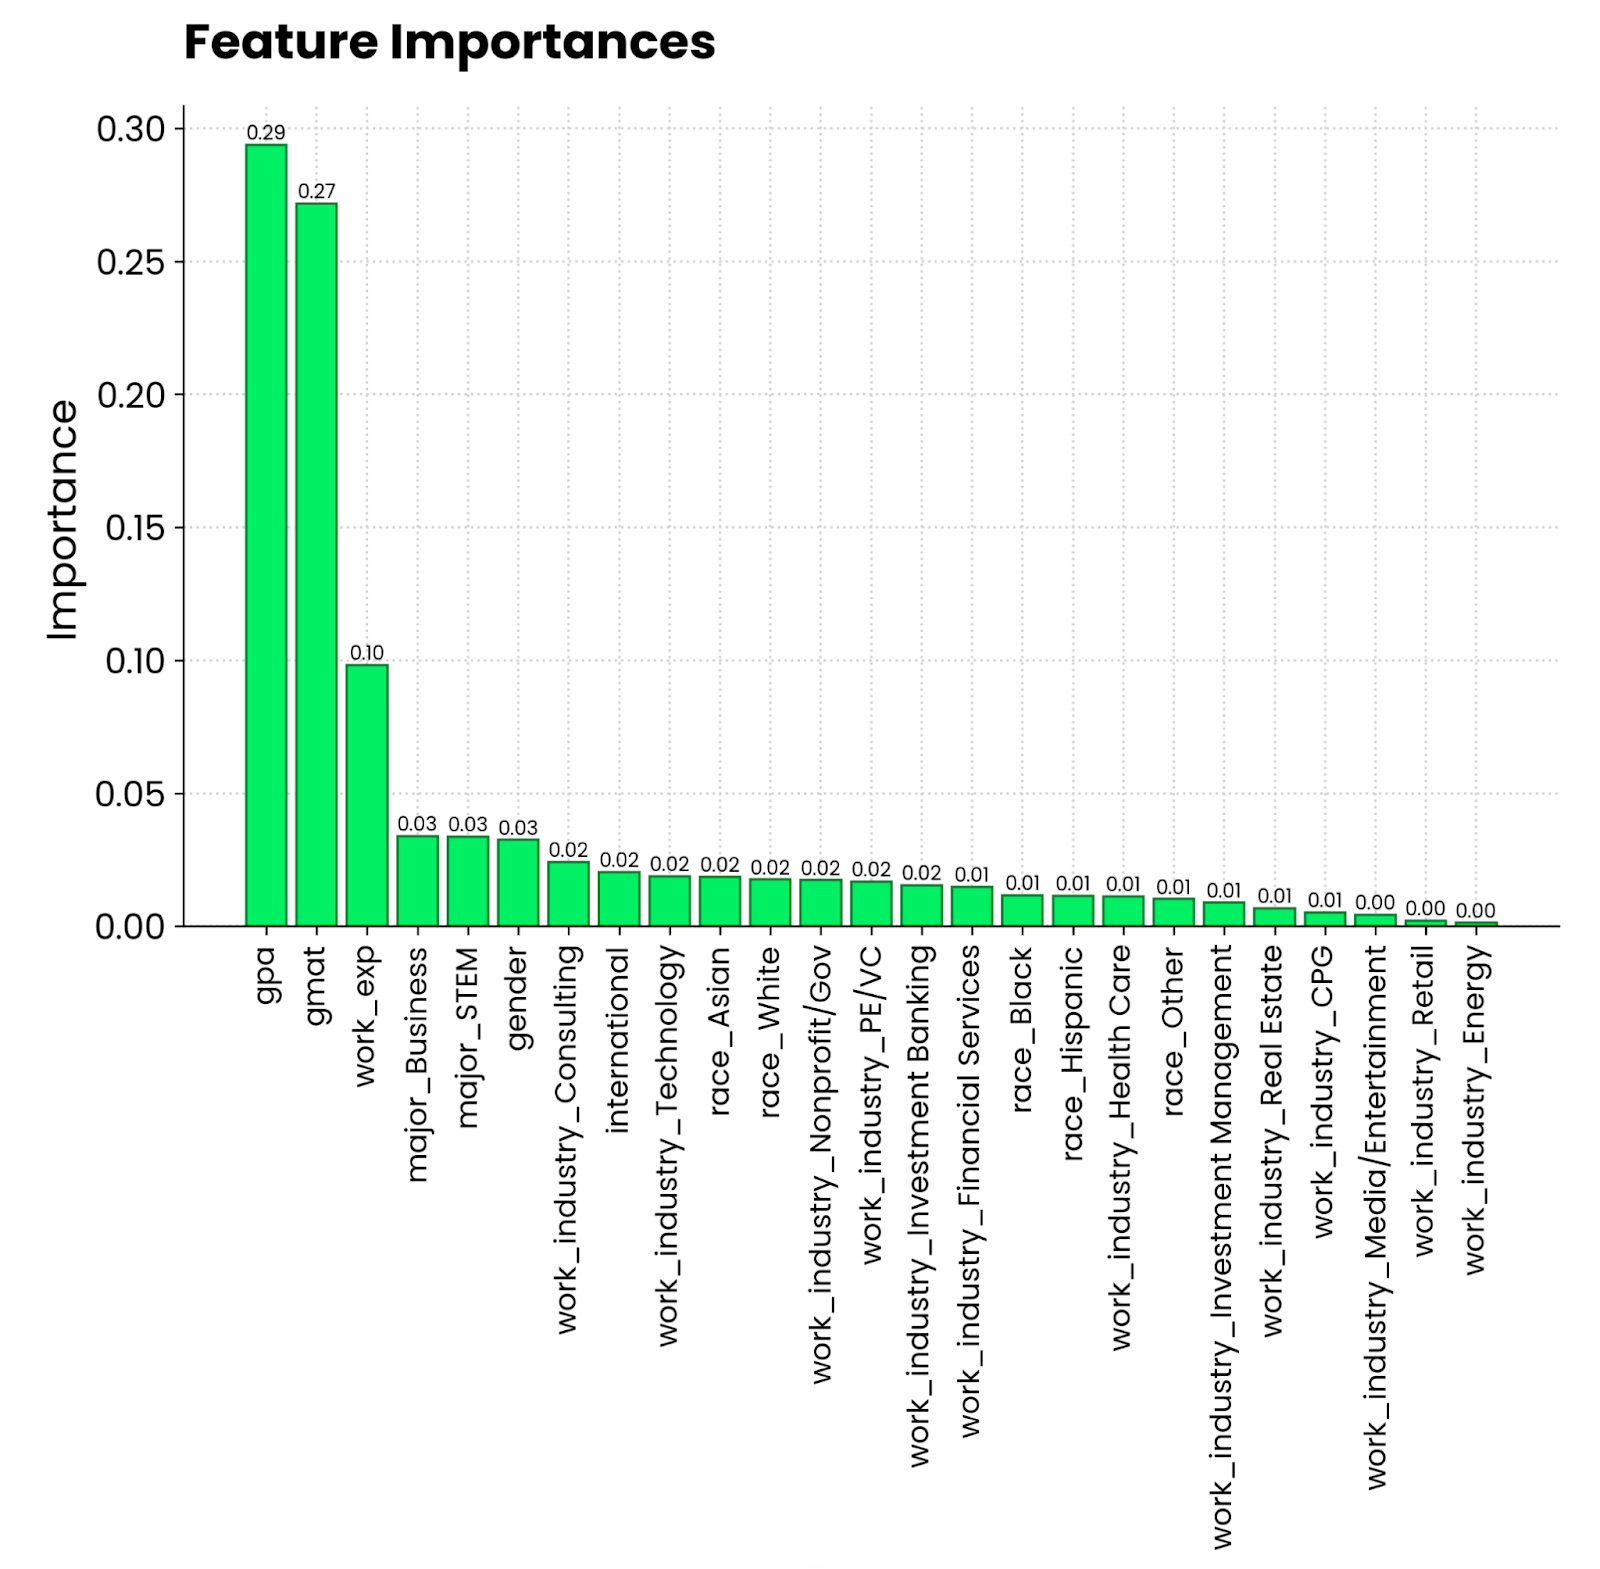
Rastgele orman özellik önemi grafiği. Görsel: Yazar.
4.0 ölçeğinde not ortalaması ve GMAT puanının, MBA programına kabul edilmede en çok katkıda bulunduğu görülüyor. Bunu, MBA için bir gereklilik olan iş deneyimi izliyor. Kişinin hangi bölümden mezun olduğu ve hangi sektörde çalıştığı çok daha az ilgili görünüyor.
Özellik önemi genel resmi çizer, peki ya makine öğrenimi modellerini tekil tahmin düzeyinde görselleştirmek isterseniz?
İşte burada SHAP ve LIME devreye girer. Önce SHAP’i ele alacağım. Ne olduğunu zaten biliyorsunuz, bu yüzden teoriyi atlayacağım.
Regresyon veri kümemiz üzerinde gradyan artırmalı bir model uydurup, tekil özelliklerin sigorta ücretlerine etkisini göreceğim. Aşağıdaki parça, modeli nasıl uyduracağınızı ve bir shap.Explainer() modelinden SHAP değerlerini nasıl hesaplayacağınızı gösterir:
import shap
from xgboost import XGBRegressor

df = load_regression_dataset()

# No need for train-test splits
X = df.drop("charges", axis=1)
y = df["charges"]
model = XGBRegressor().fit(X, y)

# Shap explainer
explainer = shap.Explainer(model)
shap_values = explainer(X)
SHAP ile yapabileceğiniz bir dizi grafik var.
waterfall() ile başlayıp ilk tahminin SHAP değerlerini inceleyeceğim:
shap.plots.waterfall(shap_values[0])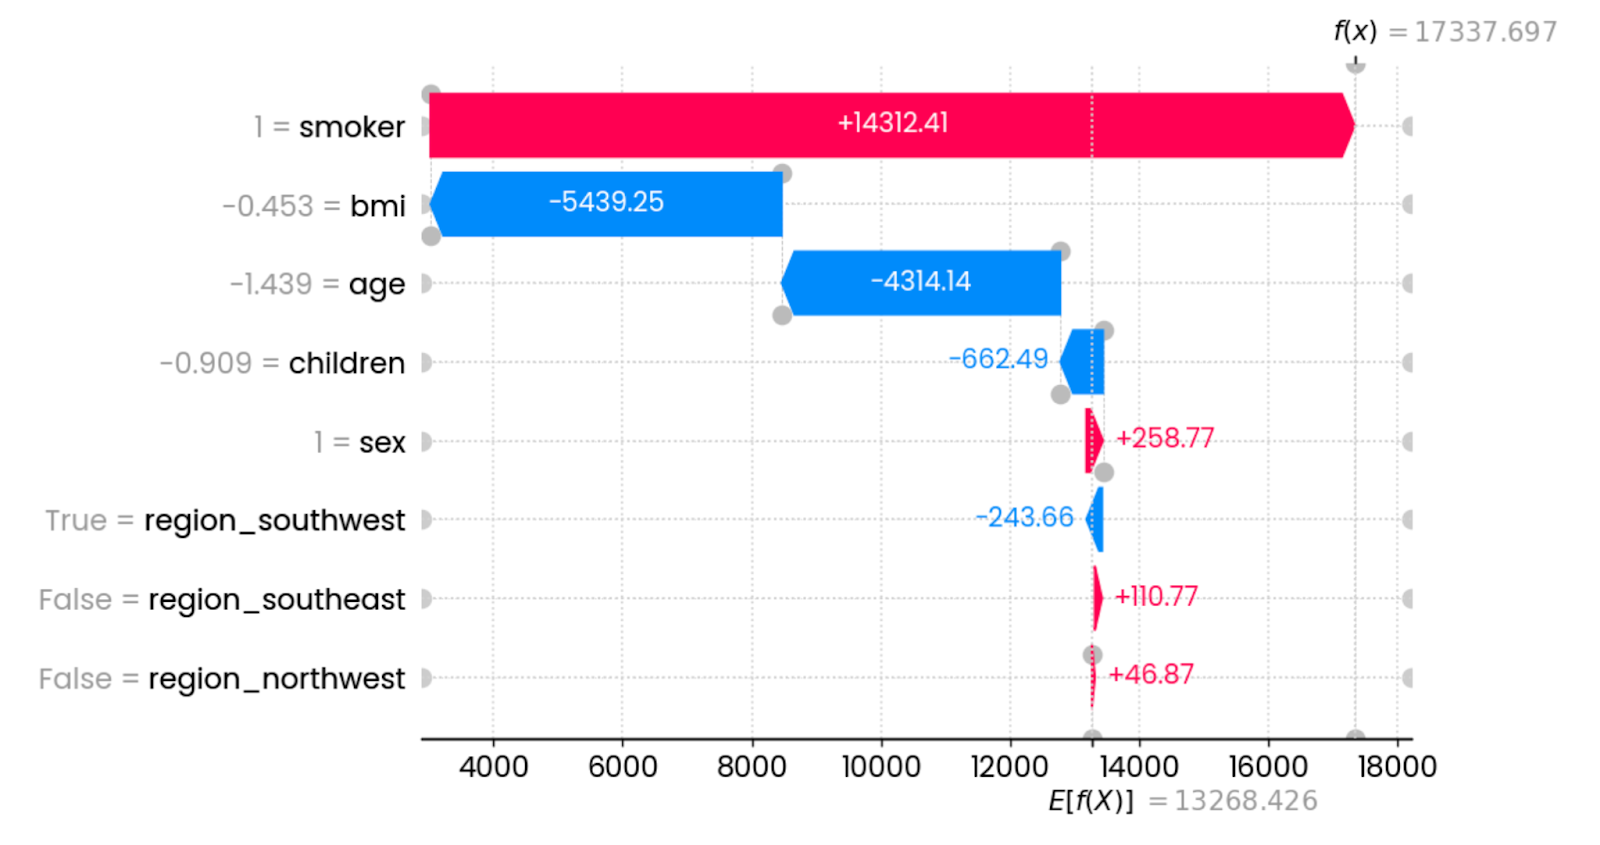
İlk tahmin açıklamaları. Görsel: Yazar.
Bu özel durumda, sigara içmek sigorta ücretlerini ciddi biçimde artırıyor. Ücretleri en çok düşüren özellikler ise BMI (kilo ile ilişkili) ve yaş. Diğer özelliklerin etkisi çok az ya da hiç yok.
Yukarıdaki grafiği daha kompakt bir formatta temsil edebilirsiniz:
shap.plots.force(shap_values[0])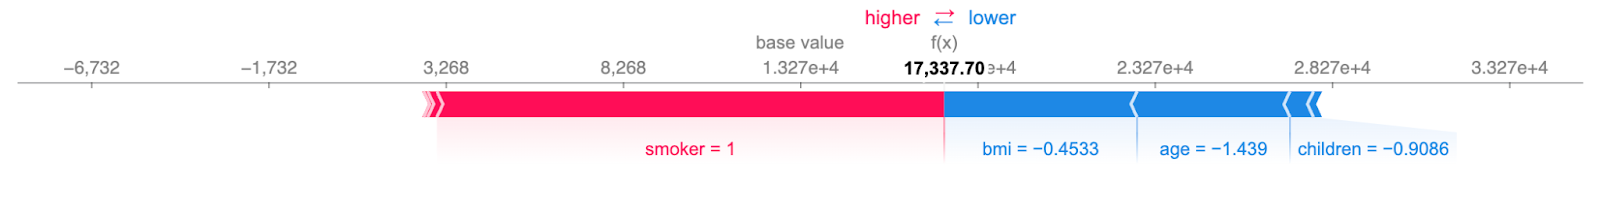
Özet ilk tahmin açıklamaları. Görsel: Yazar.
Bilgi aynı: kırmızı özellikler ücretleri artırır, mavi özellikler düşürür. Birleşim noktası tekil örnek için sigorta ücretini gösterir.
Arı kovanı (beeswarm) grafiği, her örnek için her özellik SHAP değerini çizerek hangi özelliklerin en önemli olduğunu gösterir. Özellikler tüm örnekler üzerindeki SHAP değer büyüklüklerinin toplamına göre sıralanır. Renk, özellik değerini temsil eder (kırmızı yüksek, mavi düşük):
shap.plots.beeswarm(shap_values)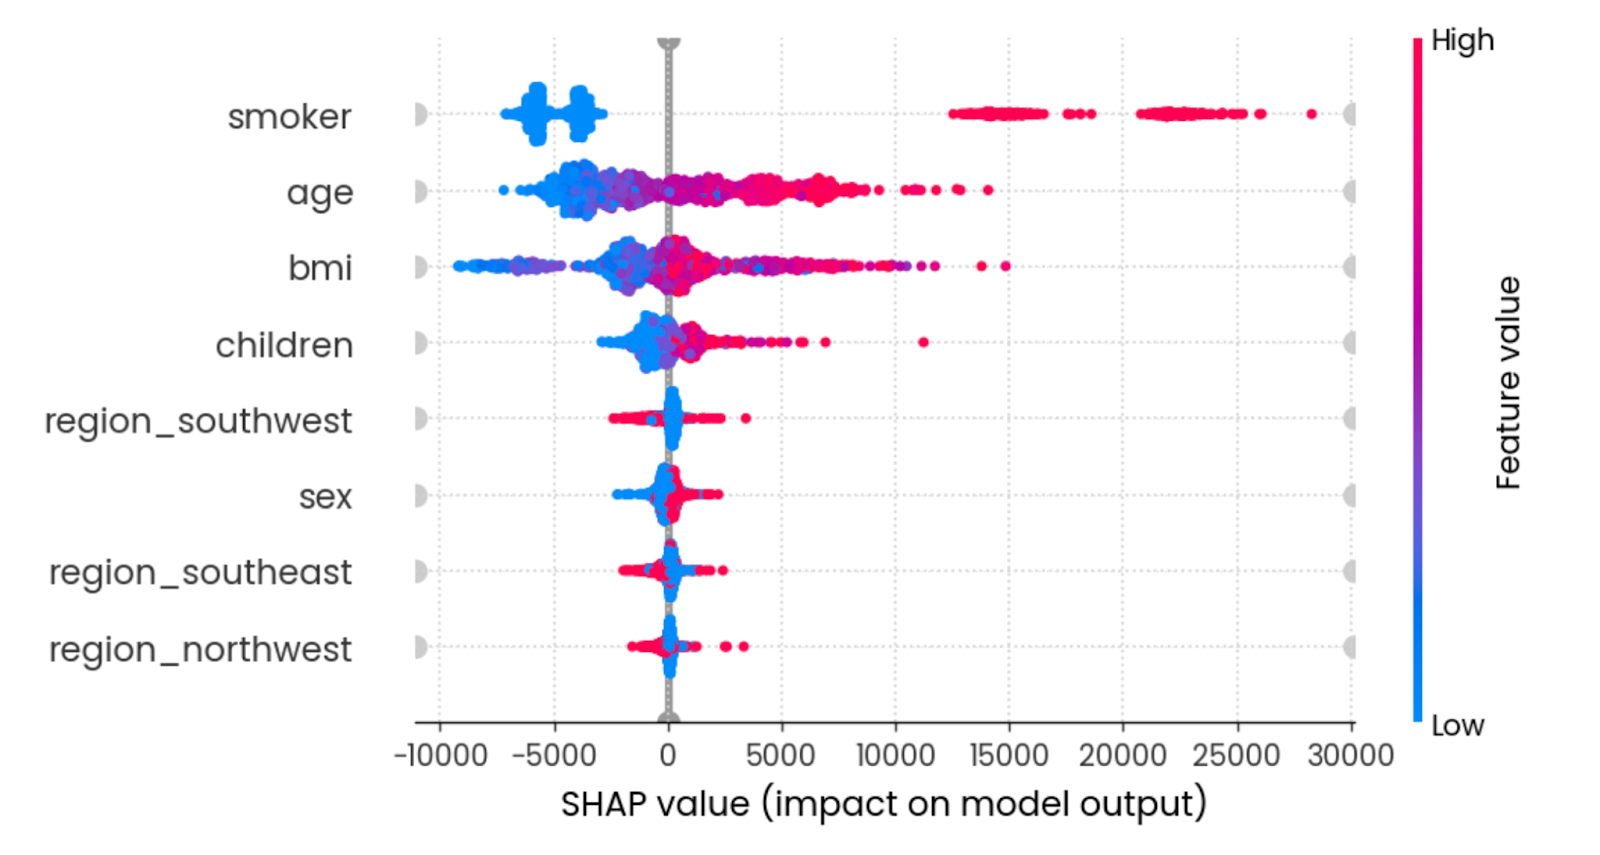
Tüm özelliklerin özet etkisi. Görsel: Yazar.
Yorumlarsak, genç, sigara içmeyen ve makul BMI değerine sahip olmak sigorta ücretlerini düşürür.
Göstermek istediğim son SHAP görselleştirmesi, ortalama mutlak değer çubuk grafiği. Her özellik için tüm SHAP değerlerinin ortalama mutlak değerini hesaplar:
shap.plots.bar(shap_values)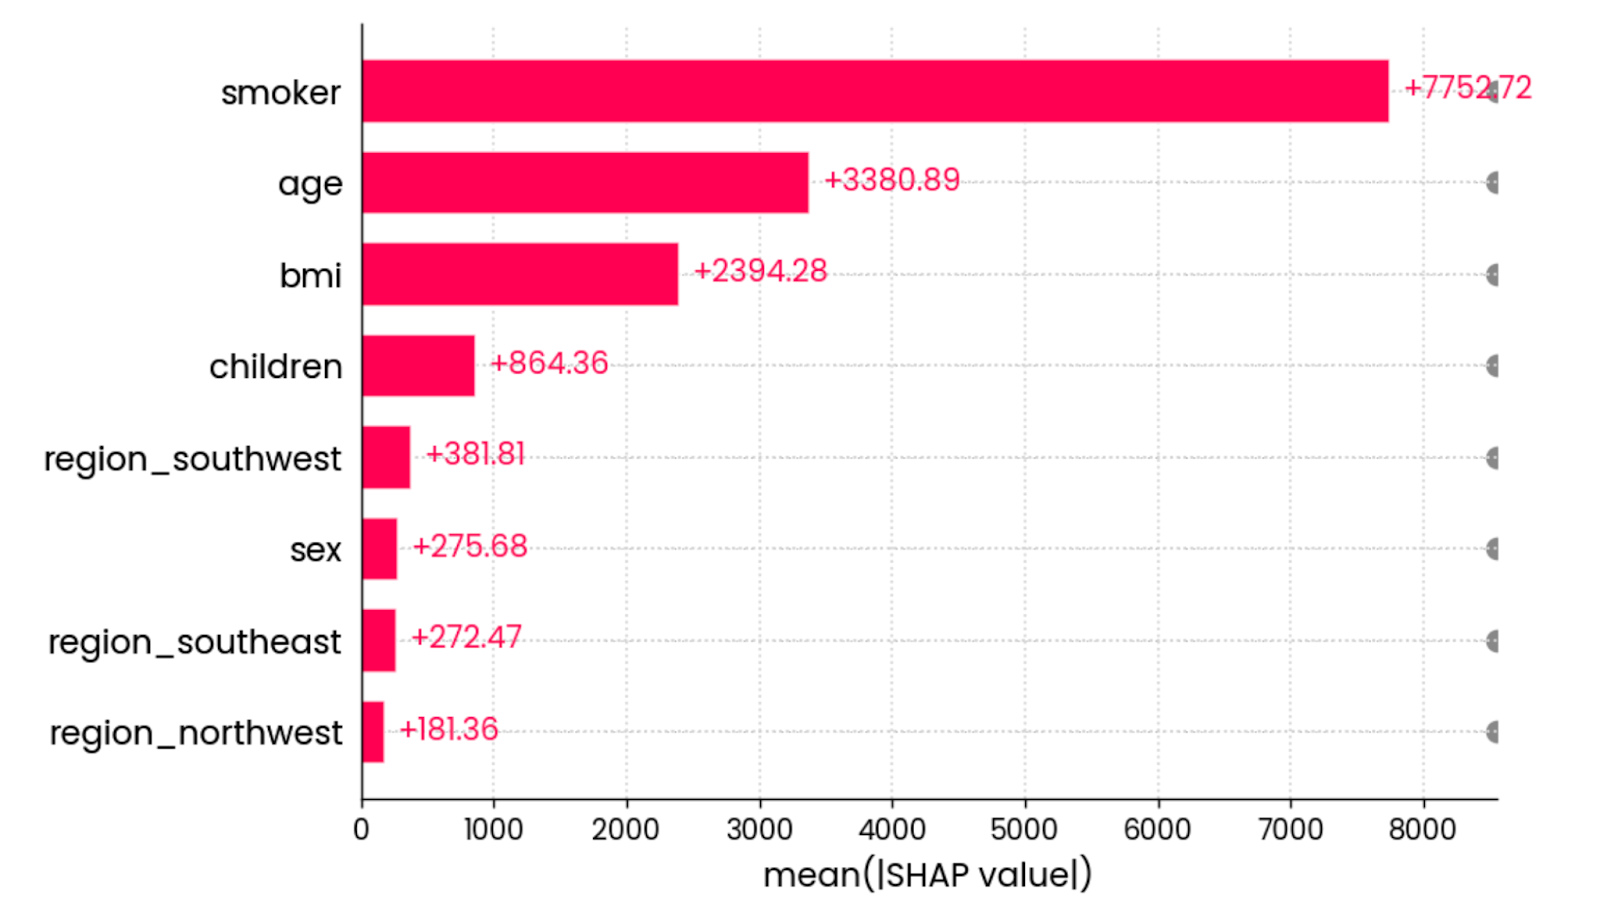
Tüm özellikler için SHAP değerlerinin ortalama mutlak değeri. Görsel: Yazar.
Başka bir deyişle, bu küresel özellik önemini hesaplamanın süslü bir yoludur - grafik tekil bir tahmine bağlı değildir.
Ve SHAP bu kadar. Şimdi odağı LIME’a kaydıracağım.
Tıpkı SHAP gibi, LIME da yorumlanabilir makine öğrenimi ile ilgilidir.
Araç çantasında SHAP kadar çok görselleştirme türü yoktur, ancak en azından tablosal veri kümelerinde tek bir işi iyi yapar.
Gösterim amacıyla, sınıflandırma veri kümesini yükleyip bekleme listesindeki kayıtları reddedilenlerle değiştirerek ikili sınıflandırma görevine dönüştüreceğim. Bu, LIME çıktısını anlamanızı kolaylaştıracaktır:
from lime import lime_tabular

df = load_classification_dataset()

# Convert to binary
df["admission"] = df["admission"].replace({"Waitlist": "Deny"})
X = df.drop("admission", axis=1)
y = df["admission"]
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.25, random_state=42)
X_train.shape, y_test.shape
random_forest = RandomForestClassifier(n_estimators=25, random_state=42)
random_forest.fit(X_train, y_train)
LimeTabularExplainer() sınıfı şimdi eğitim verilerini, sütun adlarını, hedef değişkendeki kategori adlarını ve makine öğrenimi modunu (sınıflandırma veya regresyon) alır:
explainer = lime_tabular.LimeTabularExplainer(
    training_data=np.array(X_train),
    feature_names=X_train.columns,
    class_names=["Admit", "Deny"],
    mode="classification"
)
Tamamlandığında, tekil bir tahmini yorumlamak için explain_instance() metodunu sınıf tahmin olasılıklarına dayalı olarak çağırabilirsiniz:
exp = explainer.explain_instance(
    data_row=X_test.iloc[0],
    predict_fn=random_forest.predict_proba
)
exp.show_in_notebook(show_table=True)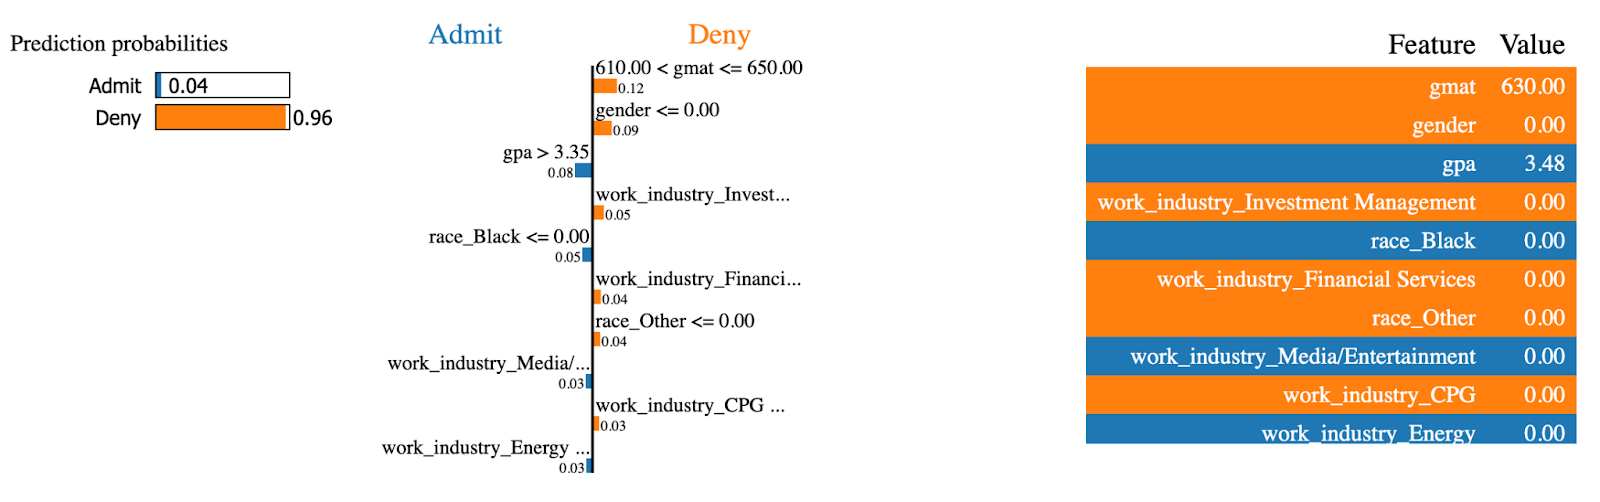
LIME açıklamaları (1). Görsel: Yazar.
LIME modeli bu MBA başvurusunun reddedileceğinden %96 emin. gmat ve gender gibi özellikler kararda en büyük etkiye sahipti.
Şimdi de MBA programına kabul edilen bir örnek için aynısını yapalım:
exp = explainer.explain_instance(
    data_row=X_test.iloc[234],
    predict_fn=random_forest.predict_proba
)
exp.show_in_notebook(show_table=True)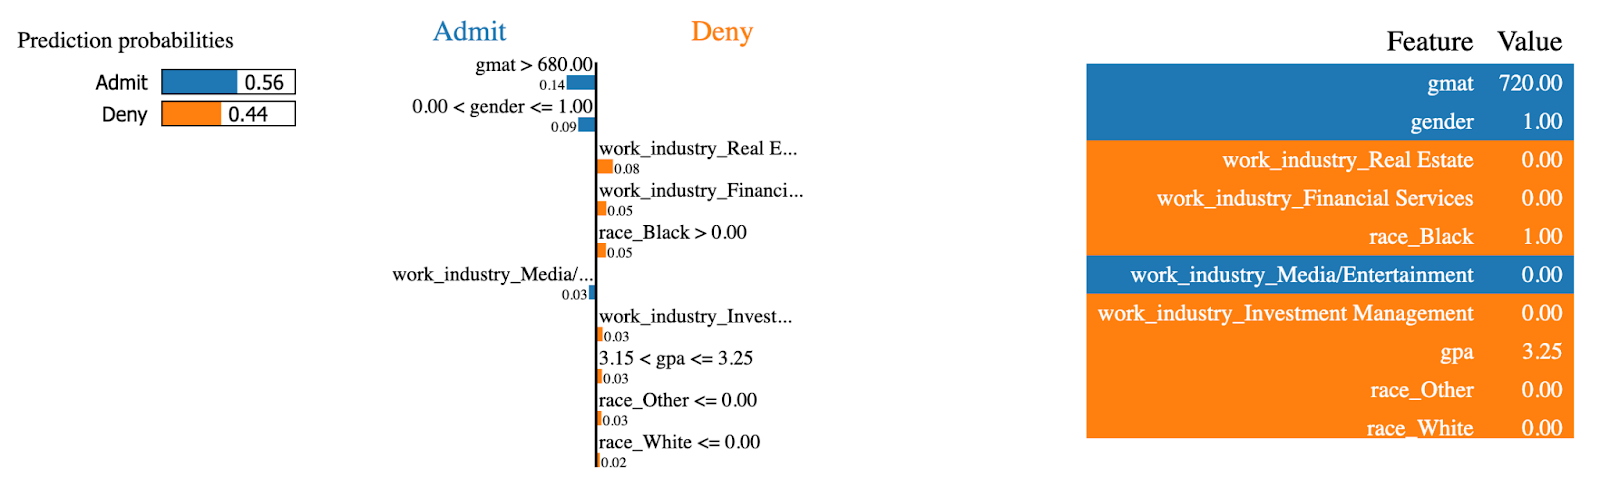
LIME açıklamaları (2). Görsel: Yazar.
Aynı özellikler şimdi zıt etki yaptı! Bu kişinin gmat puanı yüksekti ve bu, MBA programına kabul edilmenin en büyük belirleyicisiydi.
Ağaç modelleri için bu kadar! Sırada, regresyon görevleri için doğrusal modelleri nasıl görselleştireceğinizi öğreneceksiniz.
Öngörüsel modellemeye yeni başlıyorsanız, doğrusal regresyondan daha temel bir şey yoktur. Basit, anlaşılır bir modeldir ve veri kümenizdeki ilişkiler doğrusal olduğu sürece iyi çalışır.
Elbette başka doğrusal modeller de var, ancak bu bölümde yalnızca doğrusal regresyonla çalışacağım.
Regresyon veri kümesini yükleyip eğitim ve test alt kümelerine ayırarak ve eğitim kısmına bir doğrusal regresyon modeli uydurarak başlayın:
from sklearn.linear_model import LinearRegression

df = load_regression_dataset()
X = df.drop("charges", axis=1)
y = df["charges"]
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.25, random_state=42)
model = LinearRegression().fit(X_train, y_train)
İnceleyeceğim ilk görselleştirme türü model katsayılarıdır.
Basitçe söylemek gerekirse, doğrusal regresyon modeli tek bir denkleme indirgenir. Lisede gördüğünüz y = mx+b’yi hatırlıyor olabilirsiniz - aynı fikir geçerlidir.
Regresyon denklemi, birden çok parametreyi barındırmak için y = w0 + w1_x1 + w2_x2 + … + wn_xn şeklinde genişler. Modelin amacı, verilen girdi özellikleri kümesi (x) için ağırlıkların (w) en iyi tahminini bulmaktır.
Peki bu neden önemlidir?
Çünkü model eğitildikten sonra katsayılara (ağırlıklara) erişip katkılarını analiz edebilirsiniz; daha büyük katsayıya sahip özellikler, hedef değişkenin tahminine daha yüksek katkıda bulunur.
Katsayılara, eğitilmiş bir modeldeki coef_ parametresine erişerek ulaşabilirsiniz.
Aşağıdaki parça katsayıları alır ve yatay çubuk grafik olarak çizer:
features = X_train.columns
coefficients = model.coef_
plt.figure(figsize=(10, 4))
bars = plt.barh(y=features, width=coefficients, edgecolor="#008031", linewidth=1)

for bar in bars:
    width = bar.get_width()
    plt.text(width + 1, bar.get_y() + bar.get_height()/2, f"{width:.2f}",
             va="center", ha="left")

plt.xlabel("Coefficient value")
plt.title("Linear Regression Model Coefficients", y=1.05)
plt.show()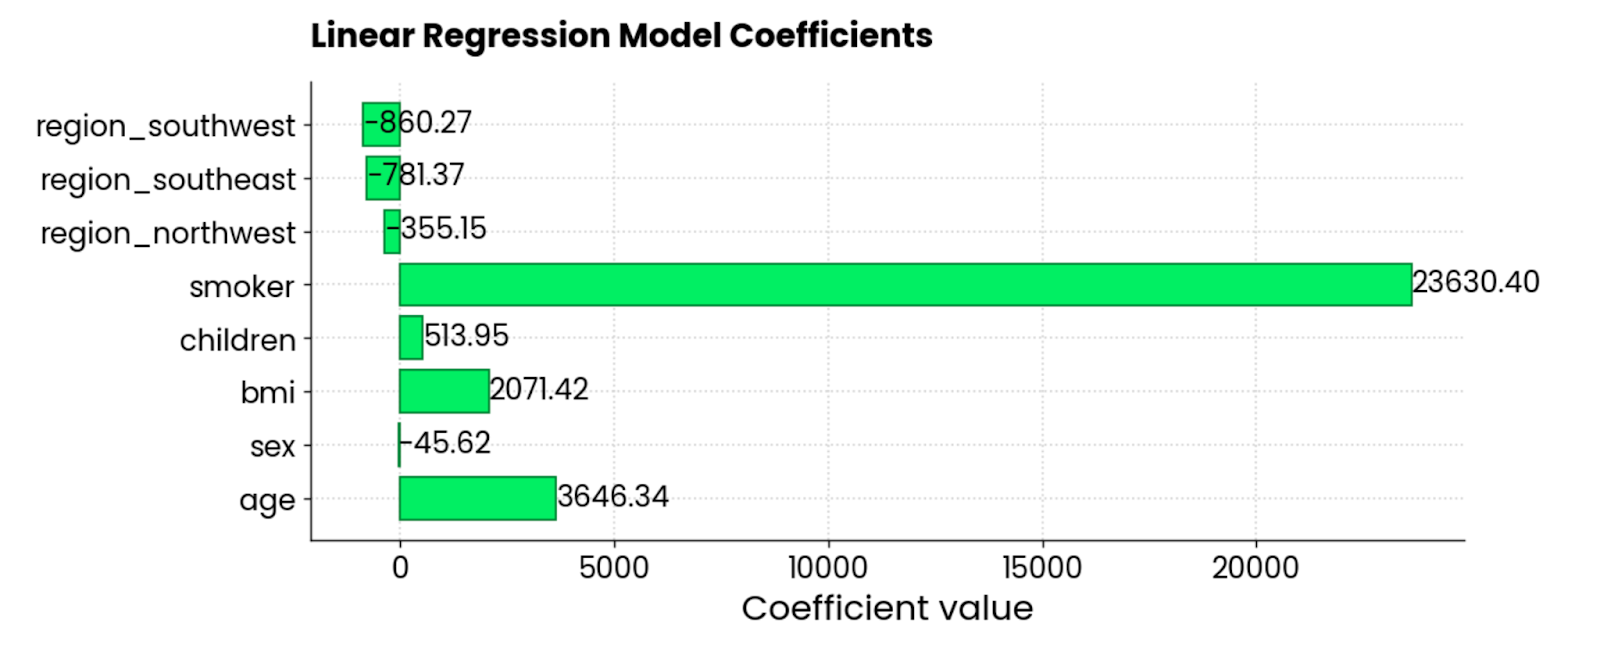
Doğrusal regresyon model katsayıları. Görsel: Yazar.
smoker, BMI ve age özellikleri sigorta ücretlerine en büyük pozitif katkıyı yapıyor — bunlar arttığında tutar da artıyor. Birkaç negatif katsayı da var; bunlar da toplam tutarı azaltıyor.
Regresyon görselleştirmenin bir diğer yaygın türü artık grafiğidir. Basitçe söylemek gerekirse, X ekseninde tahmin edilen değerlerin ve Y ekseninde artıkların (gerçek değerler - tahmin edilen değerler) saçılım grafiğini yaparsınız.
İdeal olarak, artıklar içinde görünür bir desen olmamalı ve 0 etrafında toplanmalıdır. Başka bir deyişle, normal dağılmış olmalıdırlar.
Sigorta veri kümesi üzerinde bir doğrusal regresyon modelinin artıklarını görselleştirmek için bu kod parçasını kullanın:
y_pred = model.predict(X_test)
residuals = y_test - y_pred
plt.figure(figsize=(10, 6))
plt.scatter(y_pred, residuals, color="#03EF62", alpha=0.6, edgecolors="#008031")
plt.axhline(0, color="red", linestyle="--")
plt.xlabel("Predicted Values")
plt.ylabel("Residuals")
plt.title("Residuals vs Predicted Values", y=1.05)
plt.grid(True)
plt.show()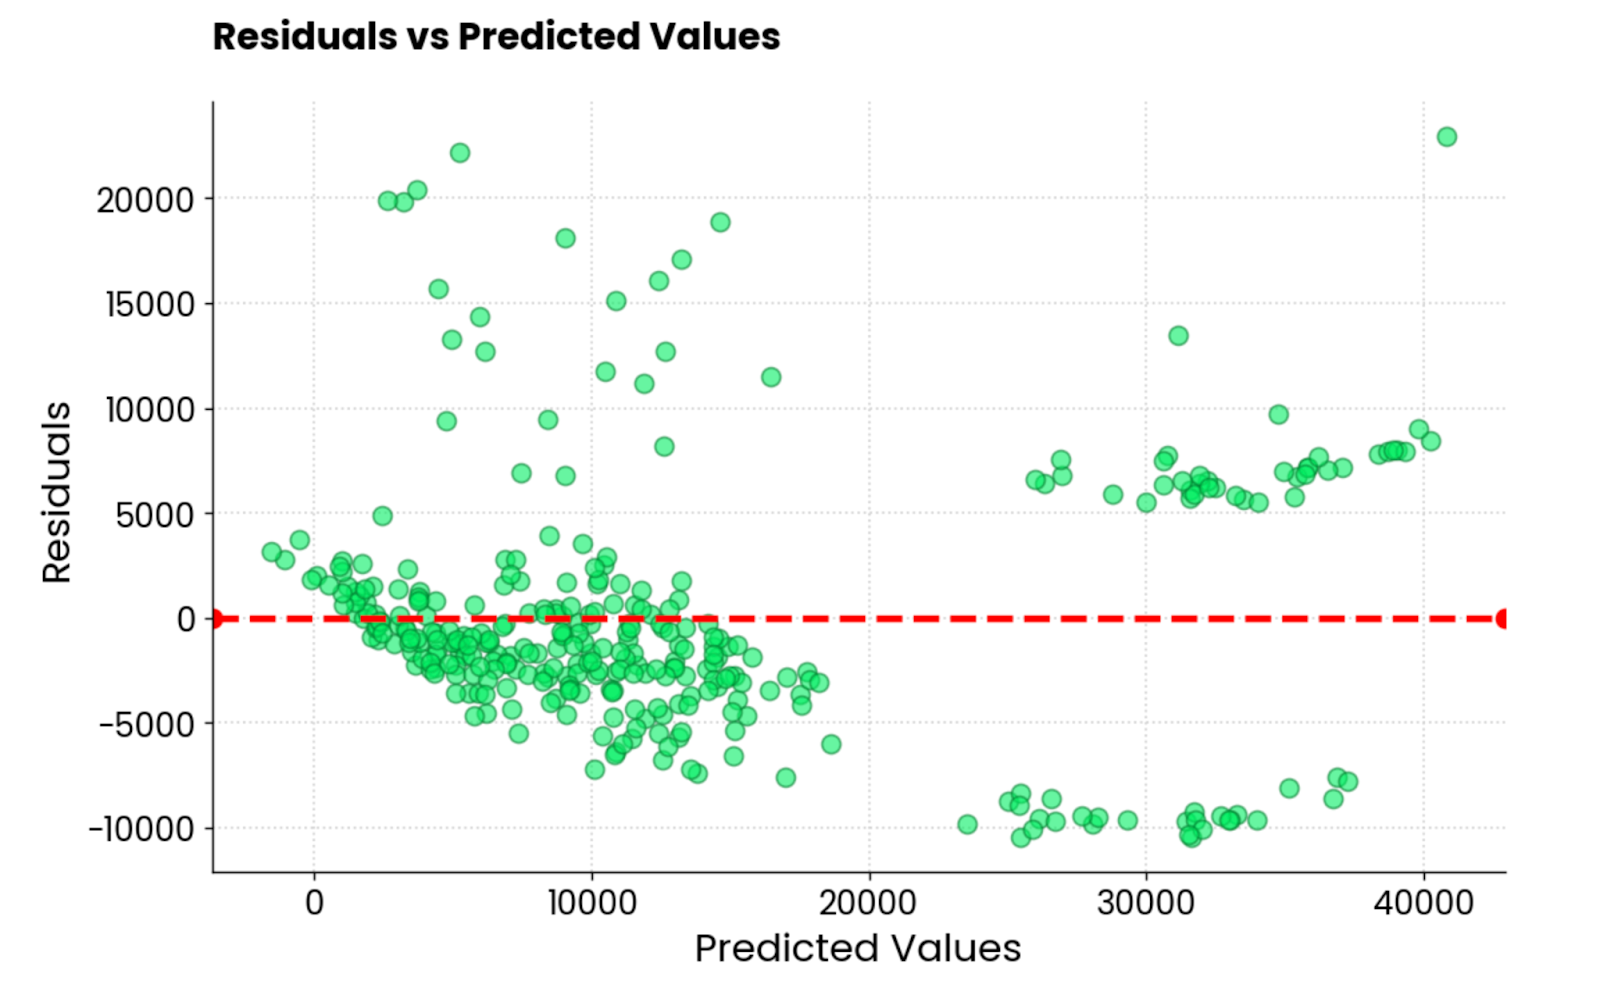
Doğrusal regresyon model artık (residual)ları. Görsel: Yazar.
Gördüğüm en iyi artık grafiği değil. Estetik olarak iyi görünüyor, ancak değerler her yana saçılmış. Bir makine öğrenimi uygulayıcısıysanız ve benzer bir artık grafiği elde ederseniz, önünüzde çok iş var demektir.
Sırada, sinir ağı modellerini görselleştirmenin 3 yolunu göstereceğim.
Makine öğreniminde görselleştirme ve yorumlamanın en çok önem taşıdığı alan varsa, o da sinir ağlarıdır.
Bunlar, en temel düzeyde bile kavraması zor yapılardır. Farklı katman türleri, aktivasyon fonksiyonları ve geri yayılım gibi konular var — sadece birkaçını saymak gerekirse. Bu nedenle sinir ağları sıklıkla kara kutu modeller ile eş anlamlıdır.
Böyle olmak zorunda değil.
Bu bölümde, sinir ağlarını üç şekilde görselleştirmeyi göstereceğim: mimari görseller, gerçek zamanlı eğitim metrikleri ve Grad-CAM.
Tercih ettiğim kütüphane TensorFlow. Daha önce duymadıysanız, hızlıca başlamanızı sağlayacak başlangıç seviyesi TensorFlow kursumuz var!
Sinir ağı modelinizin mimarisini görselleştirdiğinizde, bir şeyi gizemden arındırırsınız — şekiller.
Başka bir deyişle, alttaki matrisin katmanlar boyunca ilerledikçe boyut olarak nasıl dönüştüğünü görürsünüz. Yeni başlayanlar için zor bir konu olabilir, bu yüzden her türlü görselleştirme hoş karşılanır.
Göstermek için, el yazısı rakam sınıflandırması için temel bir sinir ağı modeli oluşturmak üzere TensorFlow kullanacağım. Ardından, plot_model() işlevini kullanarak model mimarisi görselini yerel bir dosyaya kaydedeceğim.
Kendiniz görün:
from tensorflow.keras import layers, models
from tensorflow.keras.utils import plot_model

model = models.Sequential()
model.add(layers.Input(shape=(28, 28, 1)))
model.add(layers.Conv2D(32, (3, 3), activation="relu"))
model.add(layers.MaxPooling2D((2, 2)))
model.add(layers.Conv2D(64, (3, 3), activation="relu"))
model.add(layers.MaxPooling2D((2, 2)))
model.add(layers.Flatten())
model.add(layers.Dense(64, activation="relu"))
model.add(layers.Dense(10, activation="softmax"))
plot_model(model, to_file="model_architecture.png", show_shapes=True, show_layer_names=True)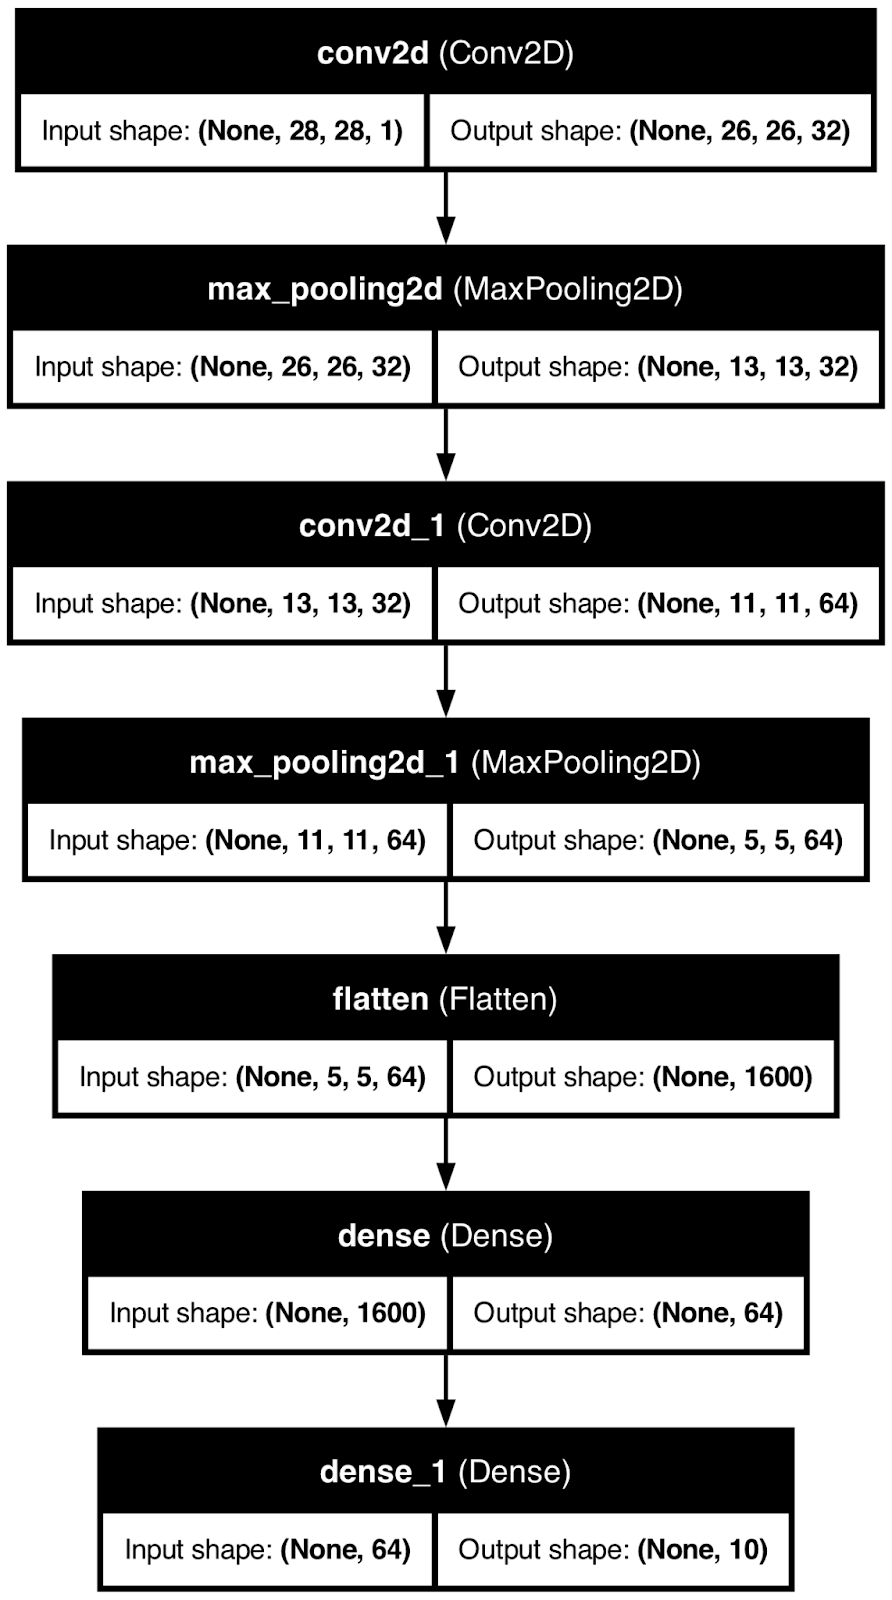
Sinir ağı model mimarisi. Görsel: Yazar.
Faydalı olsa da, bu tür bir görselleştirme ancak bir yere kadar götürür.
Verilerin yol boyunca nasıl dönüştüğünü biliyorsunuz, fakat bir sinir ağı modelinin sonuçlarına nasıl vardığına dair bir fikriniz yok. Bunu şimdi ele alacağım.
Grad-CAM, yani Gradyan Sınıf Aktivasyon Eşlemesi, evrişimsel sinir ağı modellerini görselleştirmek için kullanılan popüler bir tekniktir.
Daha net olmak gerekirse, girdi görselinin hangi kısımlarının modelin tahminlerine en çok katkıda bulunduğunu anlamanıza yardımcı olur. Bunu, karar ağacının özellik önemi grafiği gibi düşünün ama daha da güçlü.
Mimari fark etmeksizin tüm evrişimsel modeller için çalışan gelişmiş bir yorumlanabilirlik tekniğidir ve bir sinir ağı modelinin neden belirli bir tahmini yaptığını anlamanıza yardımcı olur.
Ama bir sorun var — Python’da uygulaması pek de kolay değildir. İşte algoritmanın üst düzey özeti:
Oldukça zahmetli bir süreçtir ve işi kolaylaştırmak için, halihazırda 1000 farklı görsel türünü sınıflandırabilen önceden eğitilmiş bir ResNet50 modeli kullanacağım.
Ama önce, gerekli kütüphaneleri ve Grad-CAM’ini görmek istediğiniz görseli yükleyin. Ben stok bir köpek görseli kullanıyorum:
import cv2
import tensorflow as tf
from tensorflow.keras.applications.resnet50 import ResNet50
from tensorflow.keras.preprocessing.image import load_img

image = np.array(load_img("dog.jpg", target_size=(224, 224, 3)))
plt.grid(False)
plt.imshow(image)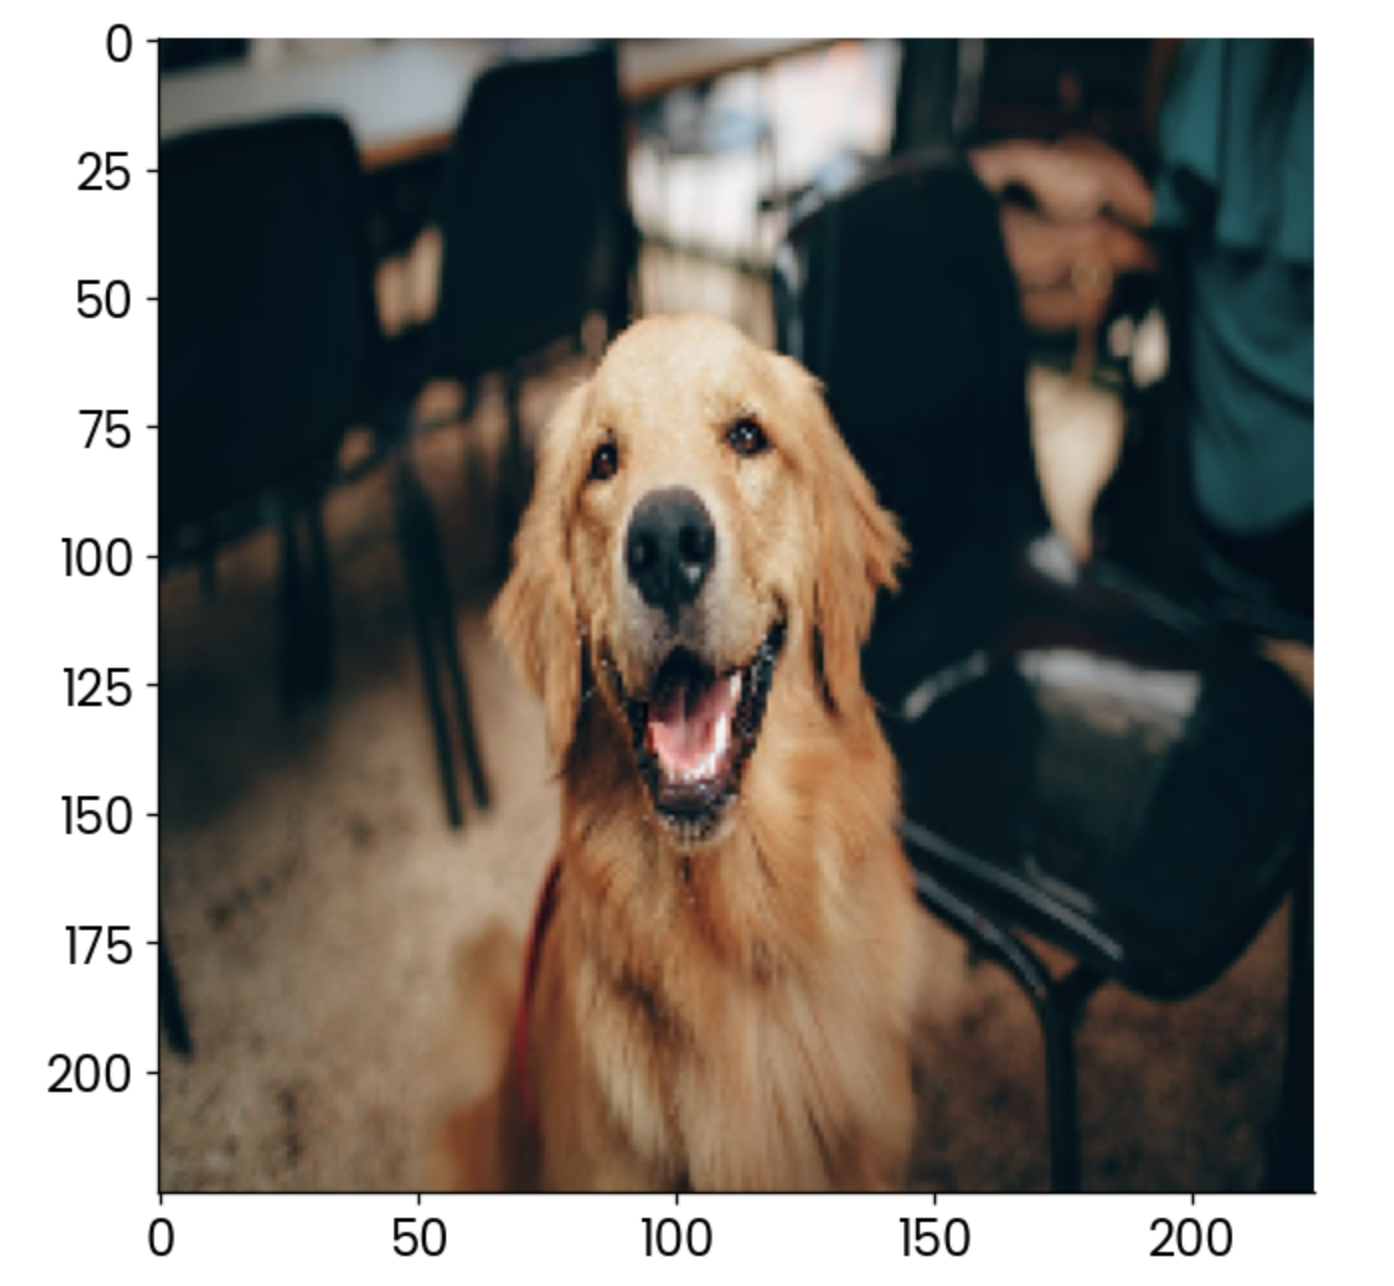
Örnek köpek görseli. Görsel: Yazar.
Şimdi eğlenceli kısım başlıyor. Aşağıdaki kod parçasında, daha önce açıklanan dört adımlı süreci uygularım. Anlamayı kolaylaştırmak için her kod satırının üzerinde yorumlar bulacaksınız:
# Load the pre-trained ResNet50 model
model = ResNet50()

# Extract the output of the last convolutional layer
last_conv_layer = model.get_layer("conv5_block3_out")

# Create a model that outputs the last convolutional layer’s activations
last_conv_layer_model = tf.keras.Model(model.inputs, last_conv_layer.output)

# Prepare the classifier model using the layers after the last convolutional layer
classifier_input = tf.keras.Input(shape=last_conv_layer.output.shape[1:])
x = classifier_input
for layer_name in ["avg_pool", "predictions"]:
    # Reuse the pooling and prediction layers from the ResNet50 model
    x = model.get_layer(layer_name)(x)

# Create a new model that takes in the last conv layer output and returns predictions
classifier_model = tf.keras.Model(classifier_input, x)

# Use a GradientTape to record operations for automatic differentiation
with tf.GradientTape() as tape:
    # Prepare the input image and get the activations from the last conv layer
    inputs = image[np.newaxis, ...]
    last_conv_layer_output = last_conv_layer_model(inputs)
    tape.watch(last_conv_layer_output)  # Watch the conv layer output
    # Get predictions from the classifier model
    preds = classifier_model(last_conv_layer_output)
    # Get the index of the highest predicted class
    top_pred_index = tf.argmax(preds[0])
    # Focus on the prediction of the top class
    top_class_channel = preds[:, top_pred_index]

# Compute the gradient of the top predicted class with respect to the conv layer output
grads = tape.gradient(top_class_channel, last_conv_layer_output)

# Average the gradients over the width and height dimensions
pooled_grads = tf.reduce_mean(grads, axis=(0, 1, 2))

# Multiply each channel in the conv layer output by its corresponding gradient
last_conv_layer_output = last_conv_layer_output.numpy()[0]
pooled_grads = pooled_grads.numpy()
for i in range(pooled_grads.shape[-1]):
    last_conv_layer_output[:, :, i] *= pooled_grads[I]

# Compute the Grad-CAM by averaging the channels and apply a ReLU activation
gradcam = np.mean(last_conv_layer_output, axis=-1)

# Normalize the Grad-CAM to be between 0 and 1
gradcam = np.clip(gradcam, 0, np.max(gradcam)) / np.max(gradcam)

# Resize the Grad-CAM heatmap to the size of the original image (224x224)
gradcam = cv2.resize(gradcam, (224, 224))
Epey fazlaydı, evet, ama artık Grad-CAM algoritmasının ürettiği ısı haritasını çizebilirsiniz:
plt.grid(False)
plt.imshow(gradcam)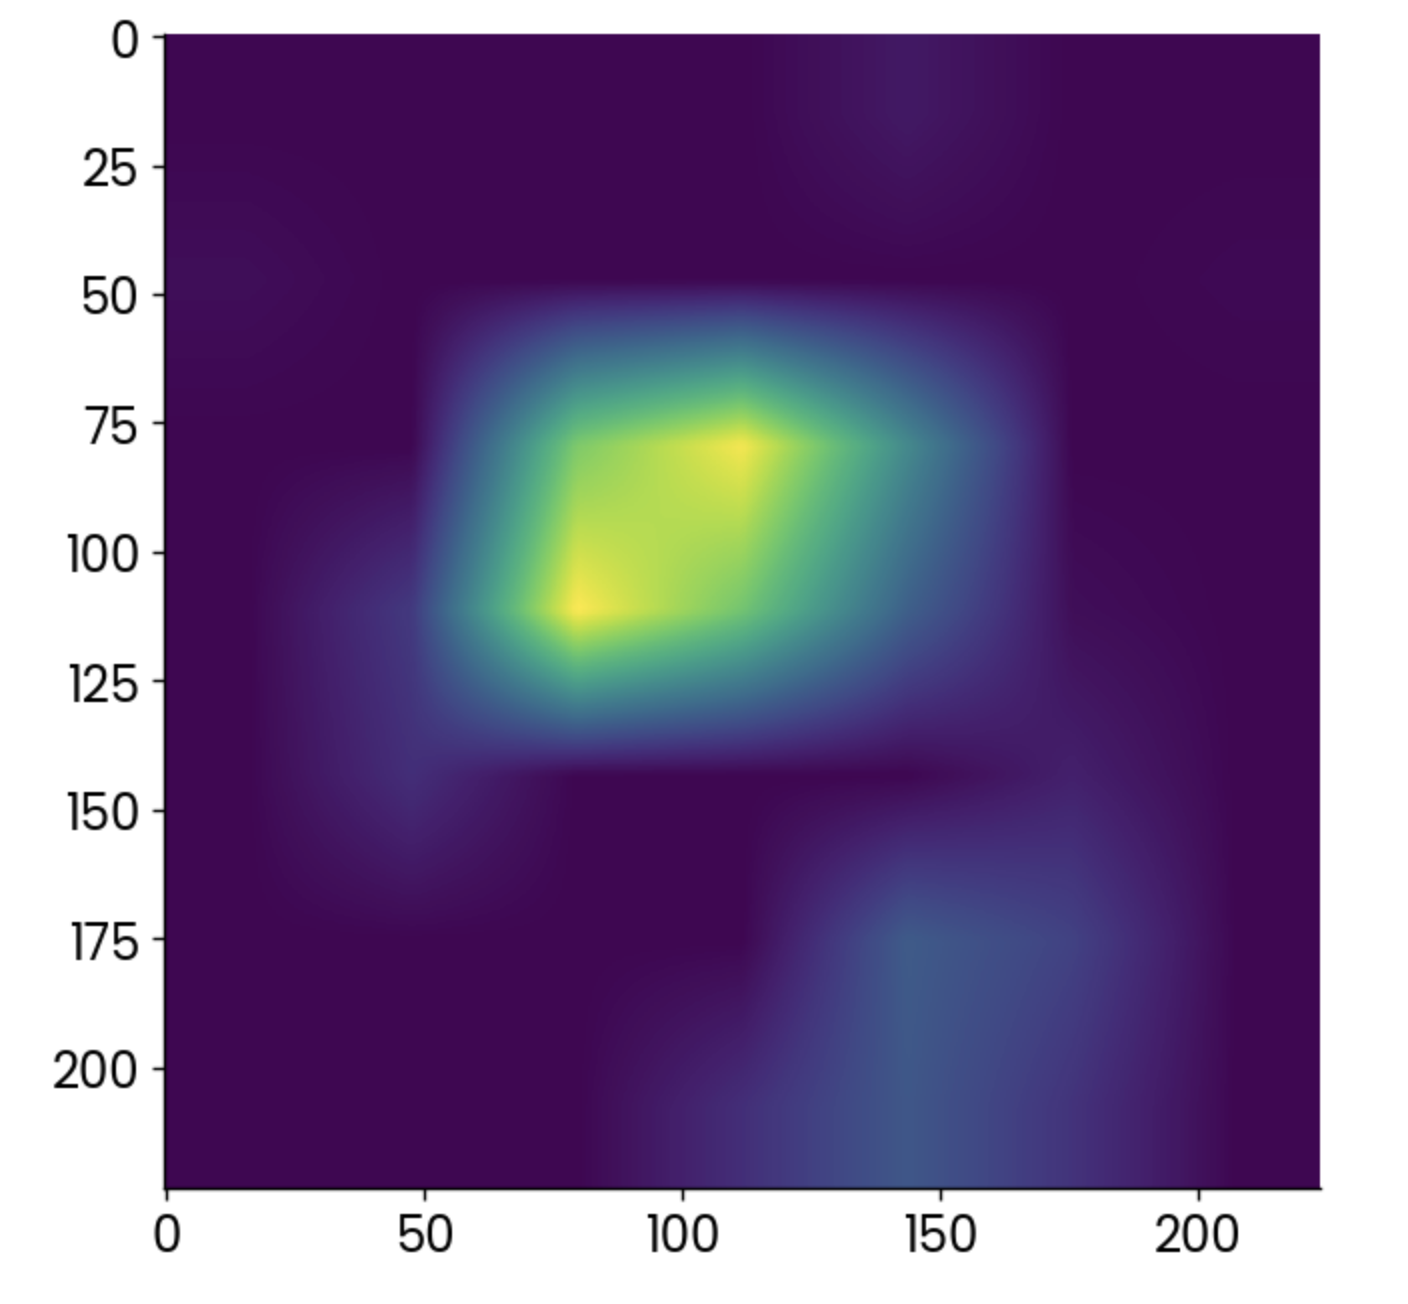
Grad-CAM ısı haritası. Görsel: Yazar.
Daha açık noktalar aktivasyonun en yüksek olduğu bölgeleri gösterir, ancak ısı haritası tek başına çok şey anlatmaz.
Bunu özgün görselin üzerine bindirip opaklığı biraz düşürmek çok daha faydalıdır:
plt.grid(False)
plt.imshow(image)
plt.imshow(gradcam, alpha=0.5)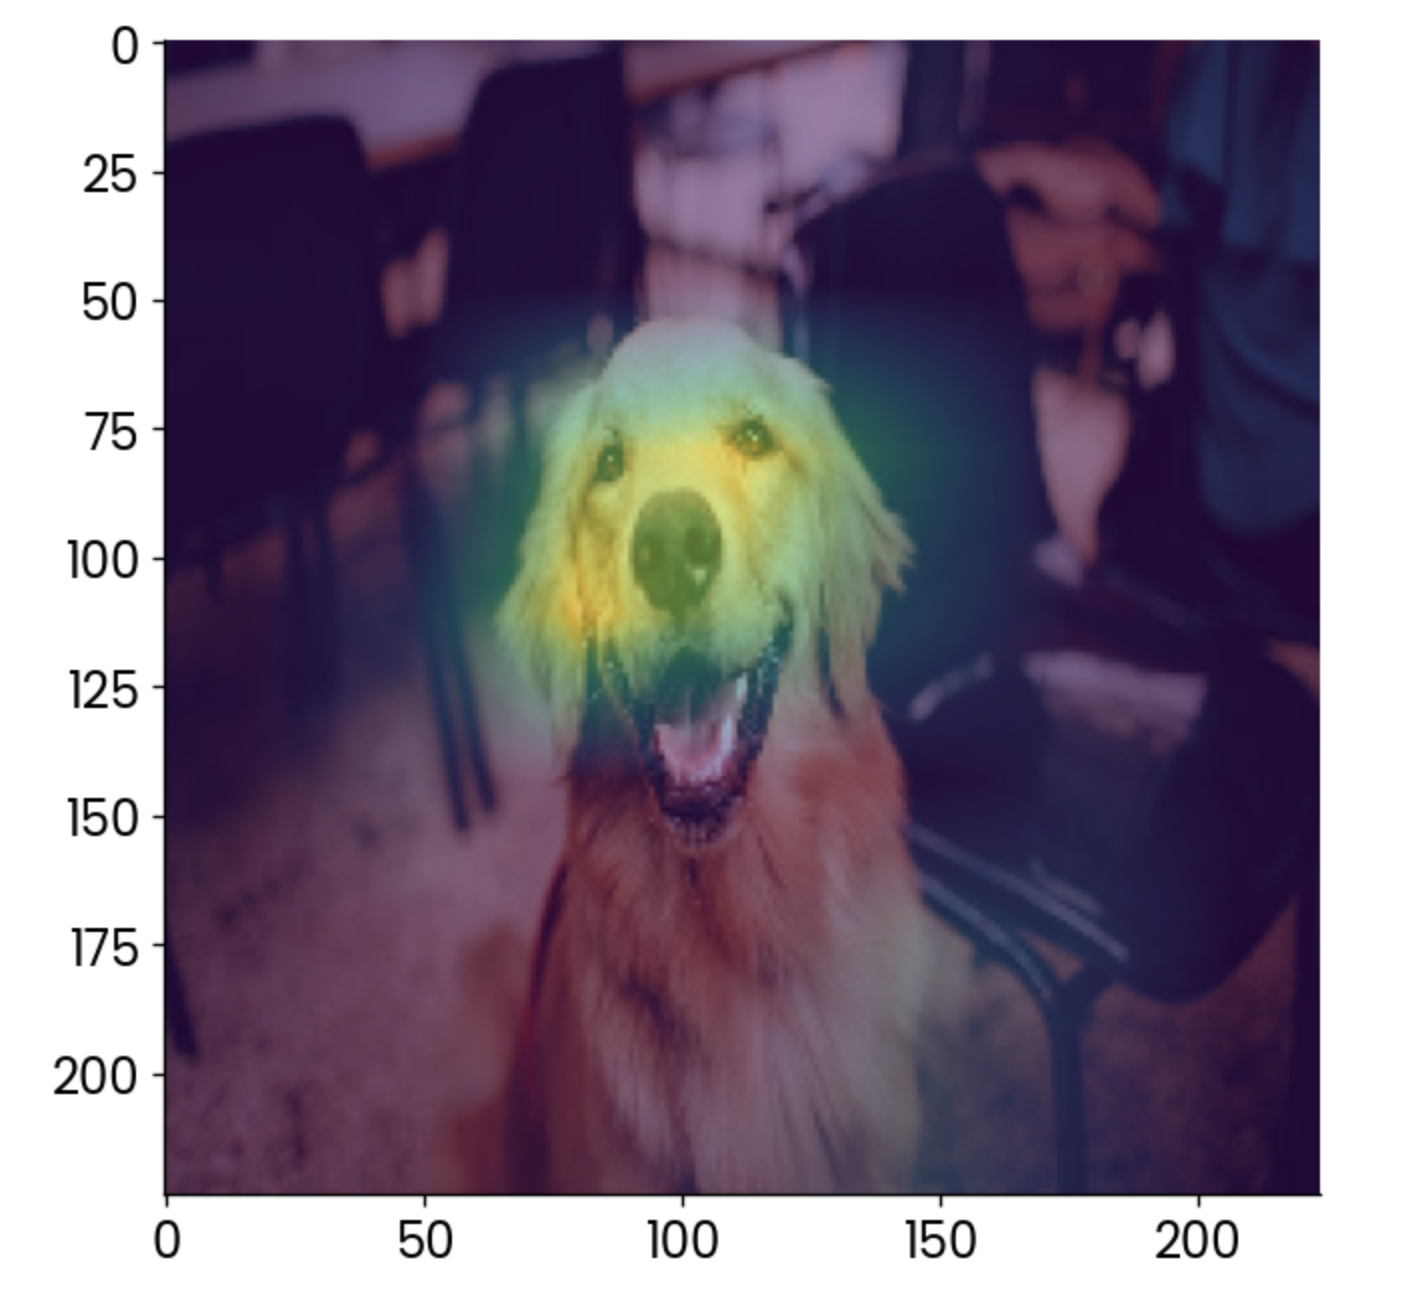
Grad-CAM bindirmeli köpek görseli. Görsel: Yazar.
Yorumlarsak, bu görselin “golden retriever” olarak sınıflandırılmasına en çok katkıda bulunan unsur yüzdür; bu da mantıklıdır.
Grad-CAM’i modelinizin tahminleri doğru şekilde yaptığından emin olmak için kullanabilirsiniz. Bu durumda, ısı haritasının arka plandaki sandalye gibi başka bir şeyi en çok katkıda bulunan unsur olarak gösterdiğini hayal edin. O modele güvenir miydiniz?
Bir sinir ağı modelini eğitmek uzun sürebilir. Güzel olan şu ki, modelin performansına göz atmak için eğitimin tamamlanmasını beklemek zorunda değilsiniz. TensorBoard gibi kütüphaneler bunu size gerçek zamanlı olarak gösterebilir.
TensorBoard, TensorFlow ile birlikte gelir, bu yüzden takip etmek için bir şey kurmanıza gerek yok.
Gösterim için, 25 dönem (epoch) boyunca temel bir rakam sınıflandırıcı eğiteceğim. Önemli kısım geri çağırma (callback) — burada eğitim günlüklerinin yolunu ve biçimini belirtirsiniz; TensorBoard bunu birazdan kullanacaktır.
Modeli eğitmek ve eğitim günlüklerini saklamak için ihtiyacınız olan kod şudur:
import tensorflow as tf
from tensorflow.keras import layers, models
from datetime import datetime

# Load MNIST dataset
mnist = tf.keras.datasets.mnist
(x_train, y_train), (x_test, y_test) = mnist.load_data()

# Normalize pixel values between 0 and 1
x_train, x_test = x_train / 255.0, x_test / 255.0

# Add a channels dimension (for the Convolutional layer)
x_train = np.expand_dims(x_train, -1)
x_test = np.expand_dims(x_test, -1)

# Build a simple CNN model
model = models.Sequential([
    layers.Conv2D(32, kernel_size=(3, 3), activation="relu", input_shape=(28, 28, 1)),
    layers.MaxPooling2D(pool_size=(2, 2)),
    layers.Flatten(),
    layers.Dense(128, activation="relu"),
    layers.Dense(10, activation="softmax")
])

# Compile the model
model.compile(
    optimizer="adam",
    loss="sparse_categorical_crossentropy",
    metrics=["accuracy"]
)

# Set up TensorBoard callback
log_dir = "logs/fit/" + datetime.now().strftime("%Y%m%d-%H%M%S")
tensorboard_callback = tf.keras.callbacks.TensorBoard(log_dir=log_dir, histogram_freq=1)

# Train the model with TensorBoard monitoring
model.fit(
    x_train,
    y_train,
    epochs=25,
    validation_data=(x_test, y_test),
    callbacks=[tensorboard_callback]
)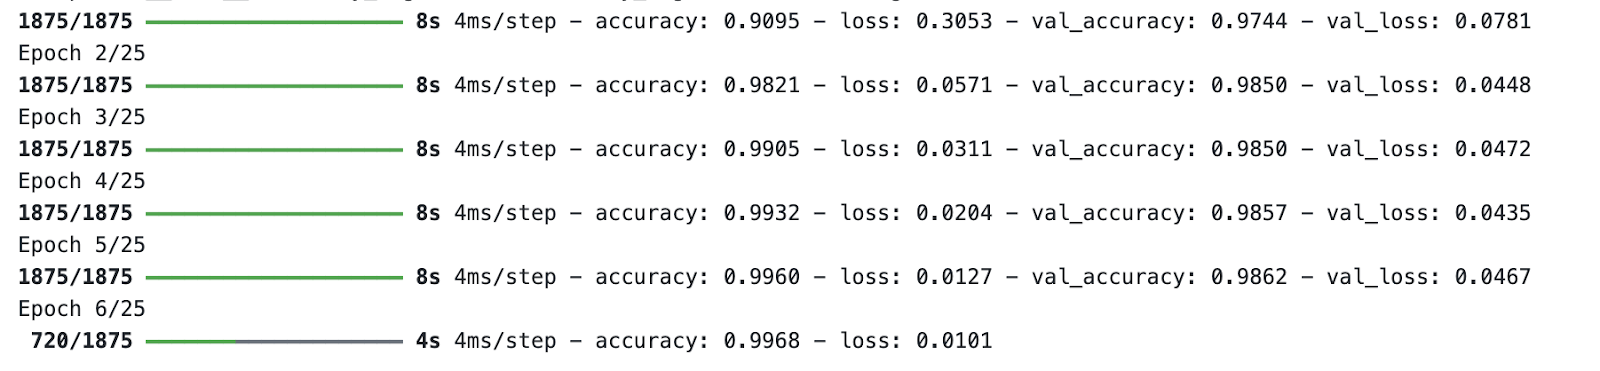
Model eğitim süreci. Görsel: Yazar.
Model eğitilirken, terminalden TensorBoard’u çalıştırın ve eğitim günlükleri klasörünün yolunu belirtin:
tensorboard --logdir=logs/fitTensorBoard varsayılan olarak 6006 portunda çalışır:
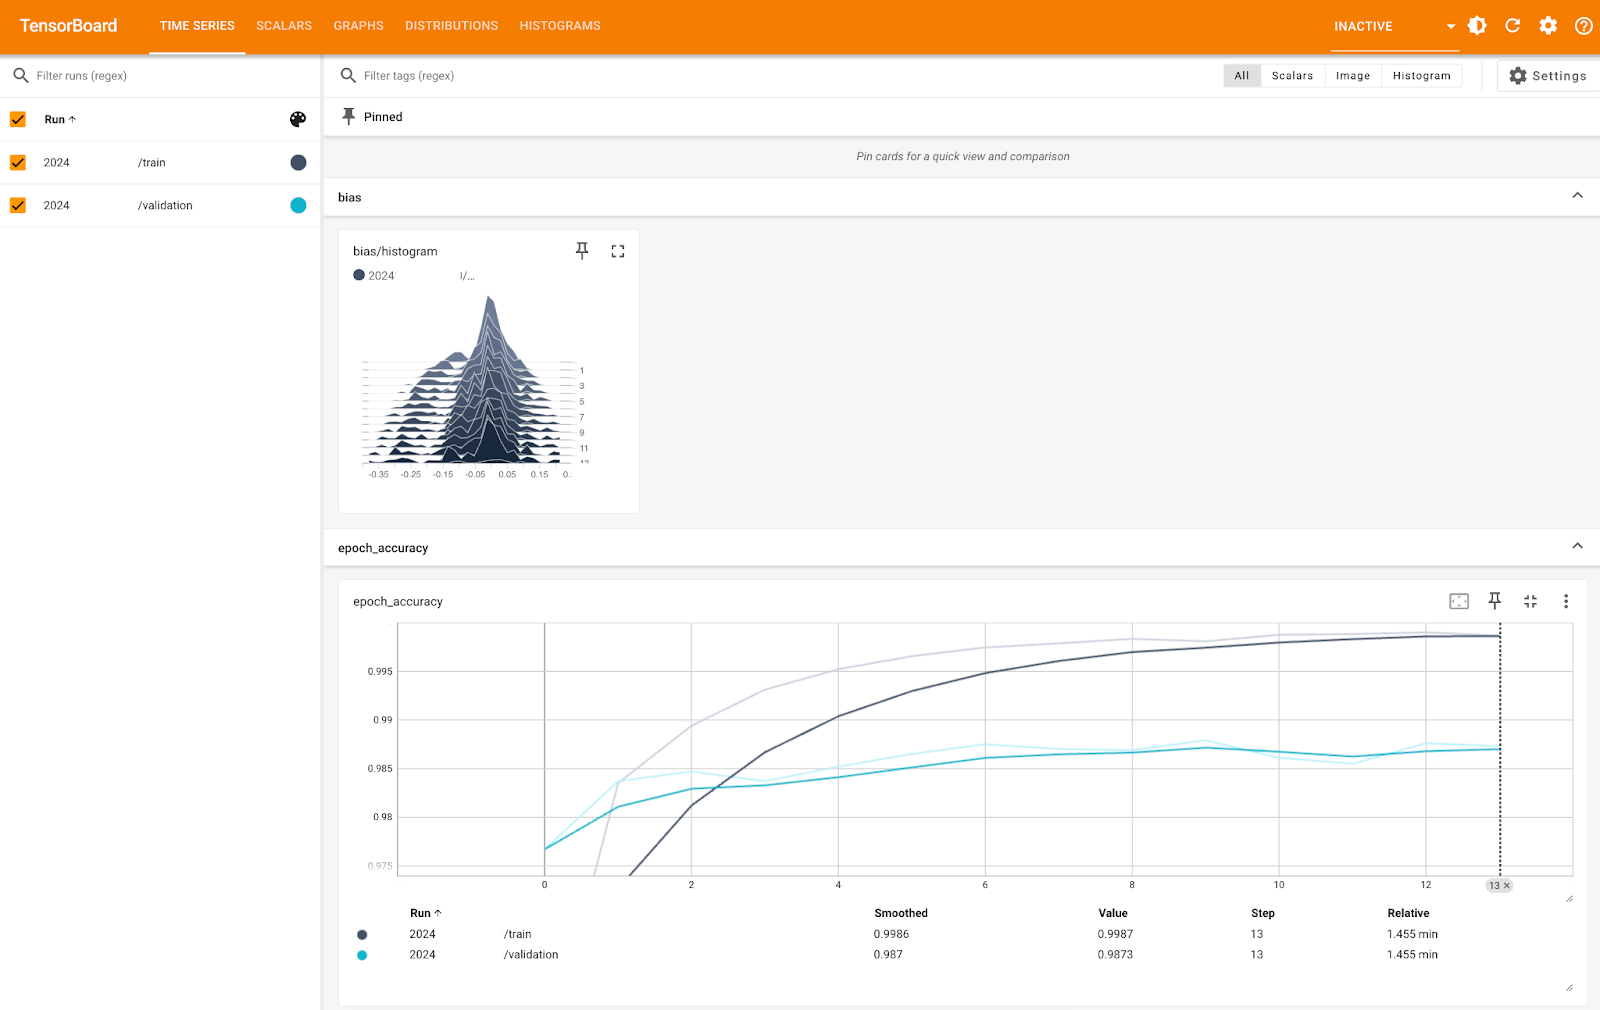
TensorBoard metrikleri (1). Görsel: Yazar.
Yukarıdaki görsel, önyargı histogramını ve dönem başına doğruluğu hem eğitim hem validasyon setleri için gösteriyor. Ölçek küçük olduğu için öyle görünse de, her ikisi için de doğruluğun %100’e çok yakın olduğunu görebilirsiniz.
Diğer sekmeler daha spesifik metriklere iner ve bazı şeyleri ayarlamanıza olanak tanır; aşağıda görebileceğiniz gibi:
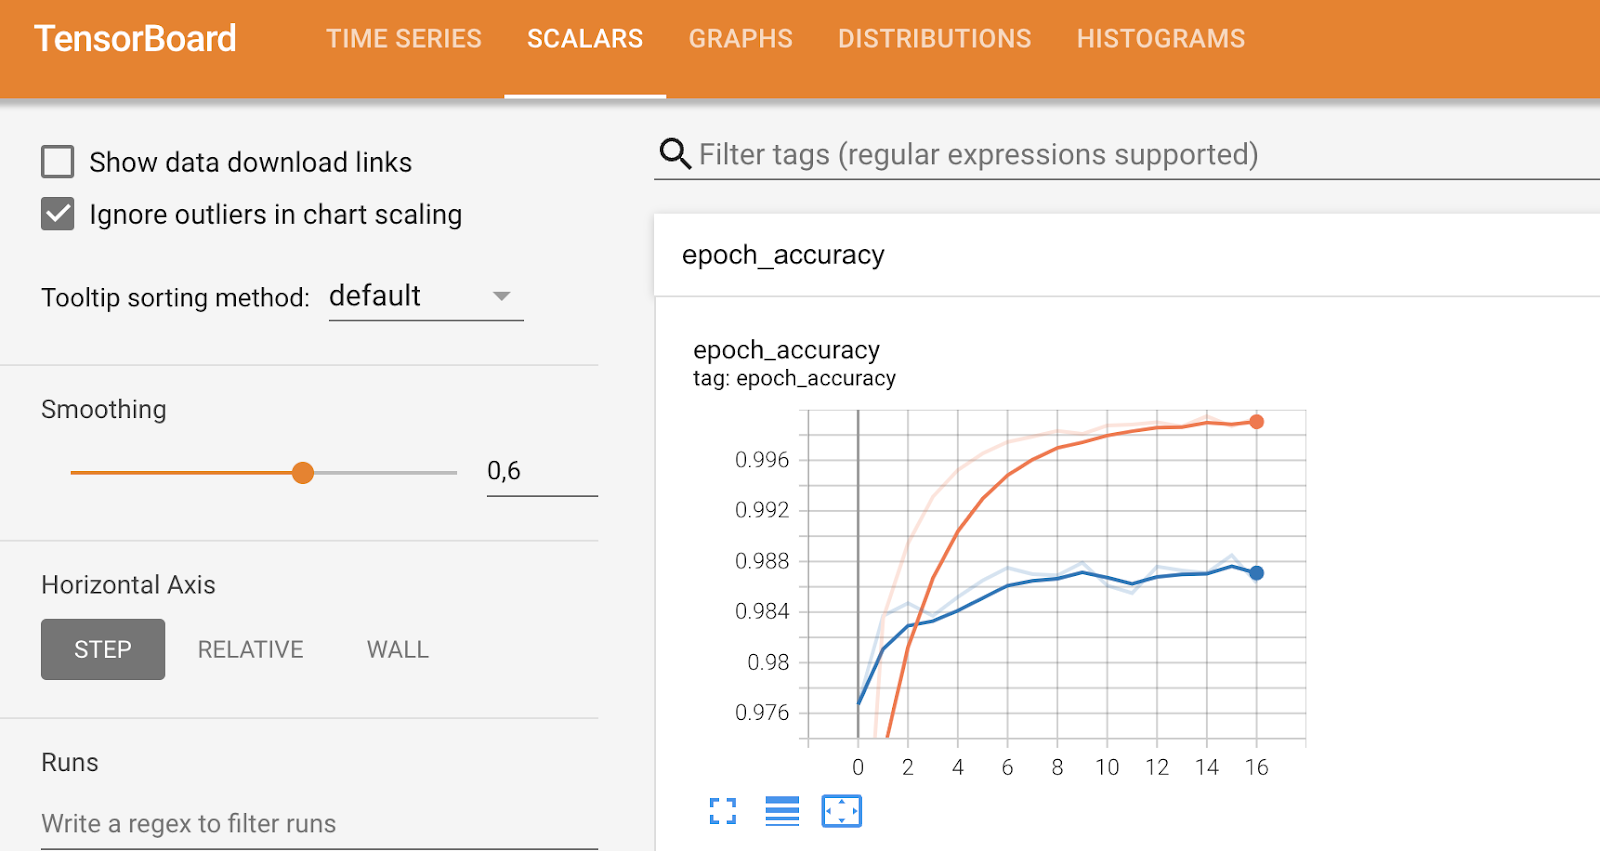
TensorBoard metrikleri (2). Görsel: Yazar.
Sonuç olarak, TensorBoard kullanışlı bir model performansı görselleştirme aracıdır ve model eğitilirken performansı analiz etmenize yardımcı olabilir.
Bu son bölümde, bir adım geri çekilip modelin performansını görselleştirmek için daha genel amaçlı metriklere dalmak istiyorum.
Üçünü göreceksiniz: karmaşıklık matrisi, ROC eğrisi grafiği ve Kesinlik-Duyarlılık eğrisi grafiği.
Bunlar sınıflandırma problemlerine bağlı olduğundan, sınıflandırma MBA veri kümesini yüklemeniz gerekir. İşleri kolaylaştırmak için, bekleme listesindeki kayıtları reddedilen olarak ayarlayarak bunu ikili sınıflandırma problemine dönüştürdüm. Kalan kod parçası verileri eğitim ve test alt kümelerine böler ve bir rastgele orman sınıflandırma modelini uydurur:
from sklearn.ensemble import RandomForestClassifier

df = load_classification_dataset()
df["admission"] = df["admission"].replace({"Waitlist": "Deny"})
df["admission"] = df["admission"].replace({"Deny": 0, "Admit": 1})
df.rename(columns={"admission": "is_admitted"}, inplace=True)
X = df.drop("is_admitted", axis=1)
y = df["is_admitted"]
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.25, random_state=42)
random_forest = RandomForestClassifier(n_estimators=25, random_state=42)
random_forest.fit(X_train, y_train)
İlk metrik olan karmaşıklık matrisine dalalım.
Karmaşıklık matrisi, modelinizin ne kadar iyi performans gösterdiğini söyler. İdeal senaryoda, sol üstten sağ alta diyagonaldeki değerler tek sıfır olmayan elemanlar olur ve modelin yanlış tahmin yapmadığını gösterir.
Ama gerçek dünyada bu pek sık olmaz.
Karmaşıklık matrisini (ikili sınıflandırma için) yorumlamak üzere şu yönergeleri kullanın:
Yanlış pozitiflere mi yoksa yanlış negatiflere mi daha çok önem vermeniz gerektiğine dair genel bir kural yoktur. MBA başvuruları bağlamında yanlış pozitifler daha can sıkıcıdır; çünkü model öğrencinin kabul edildiğini sınıflandırmış, ancak gerçekte öyle değildir. Kanser tahmini gibi diğer durumlarda, yanlış negatiflerin sayısını en aza indirmek hayati önem taşır; zira kanserliyken birini sağlıklı ilan etmek istemezsiniz.
İşte burada alan bilgisi devreye girer.
Her neyse, koda geri dönelim. Aşağıdaki parça, test setinde rastgele orman modelimizden karmaşıklık matrisini hesaplar ve görselleştirme için ConfusionMatrixDisplay sınıfını kullanır:
from sklearn.metrics import confusion_matrix
from sklearn.metrics import confusion_matrix, ConfusionMatrixDisplay

preds = random_forest.predict(X_test)
cm = confusion_matrix(y_true=y_test, y_pred=preds, labels=random_forest.classes_)
disp = ConfusionMatrixDisplay(confusion_matrix=cm, display_labels=random_forest.classes_)
disp.plot()
plt.grid(False)
plt.title("Confusion Matrix", y=1.04)
plt.show()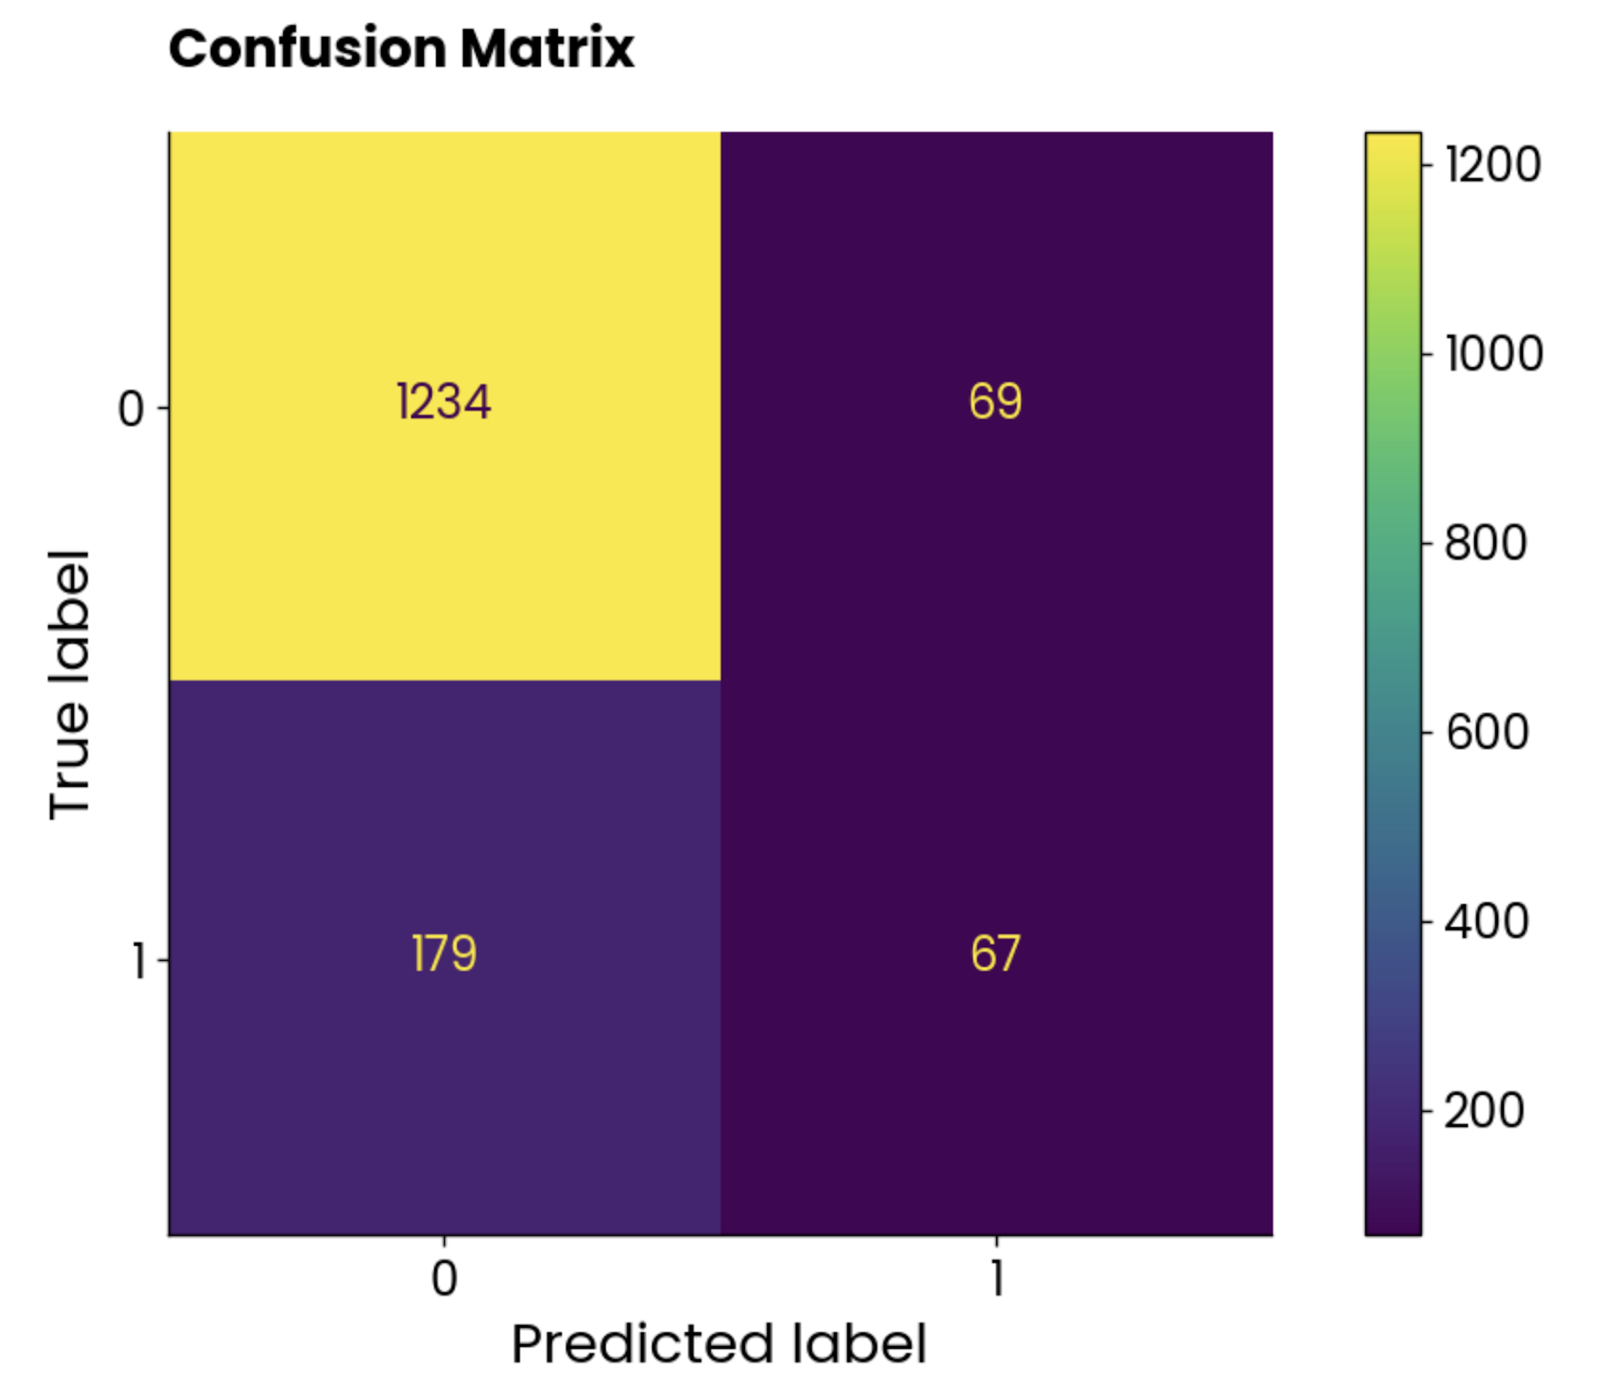
Karmaşıklık matrisi grafiği. Görsel: Yazar.
Sınıflar dengeli değil, ancak yanlış tahmin sayısı şaşırtıcı derecede yüksek.
ROC eğrisi ne diyor bir bakalım.
ROC, Alıcı İşletim Özellikleri’nin kısaltmasıdır ve ikili bir sınıflandırma modelinin performans değerlendirmesini gösteren bir eğridir. Çok sınıflı sınıflandırmada, aynı anda iki sınıfı karşılaştırmanız gerekir.
ROC eğrisi, farklı sınıflandırma eşikleri boyunca doğru pozitif oranı (TPR, duyarlılık, recall) ile yanlış pozitif oranı (FPR) arasındaki dengeyi gösterir. Y ekseninde TPR, X ekseninde FPR çizilir. Her nokta, bir örneği pozitif ya da negatif olarak sınıflandırmak için kullanılan farklı bir eşik değerini (olasılık skoru) gösterir.
Eğri genellikle (0, 0) ile (1, 1) arasındaki diyagonale karşı çizilir; bu da rastgele bir sınıflandırıcıyı temsil eder.
Eğri diyagonalin üzerindeyse, modelinizin rastgele bir sınıflandırıcıdan daha iyi performans gösterdiği anlamına gelir. Bunu özetleyen tek bir skaler değer vardır. Buna AUC (Eğri Altındaki Alan) denir ve 0 ile 1 arasında değişir; daha yüksek daha iyidir, 0,5 ise rastgeledir.
Kısaca, eğrinin sol üst köşeye mümkün olduğunca yakın olmasını istersiniz.
ROC ve AUC’yi hesaplamak ve eğriyi çizmek için aşağıdaki parçayı kullanın:
from sklearn.metrics import roc_curve, auc

# Get predicted probabilities for the positive class
y_probs = random_forest.predict_proba(X_test)[:, 1]
fpr, tpr, roc_thresholds = roc_curve(y_test, y_probs)
roc_auc = auc(fpr, tpr)
plt.plot(fpr, tpr, label=f"AUC = {roc_auc:.2f}")
plt.plot([0, 1], [0, 1], color="navy", linestyle="--")
plt.xlim([0.0, 1.0])
plt.ylim([0.0, 1.05])
plt.xlabel("False Positive Rate")
plt.ylabel("True Positive Rate")
plt.title("ROC Curve", y=1.04)
plt.legend(loc="lower right")
plt.show()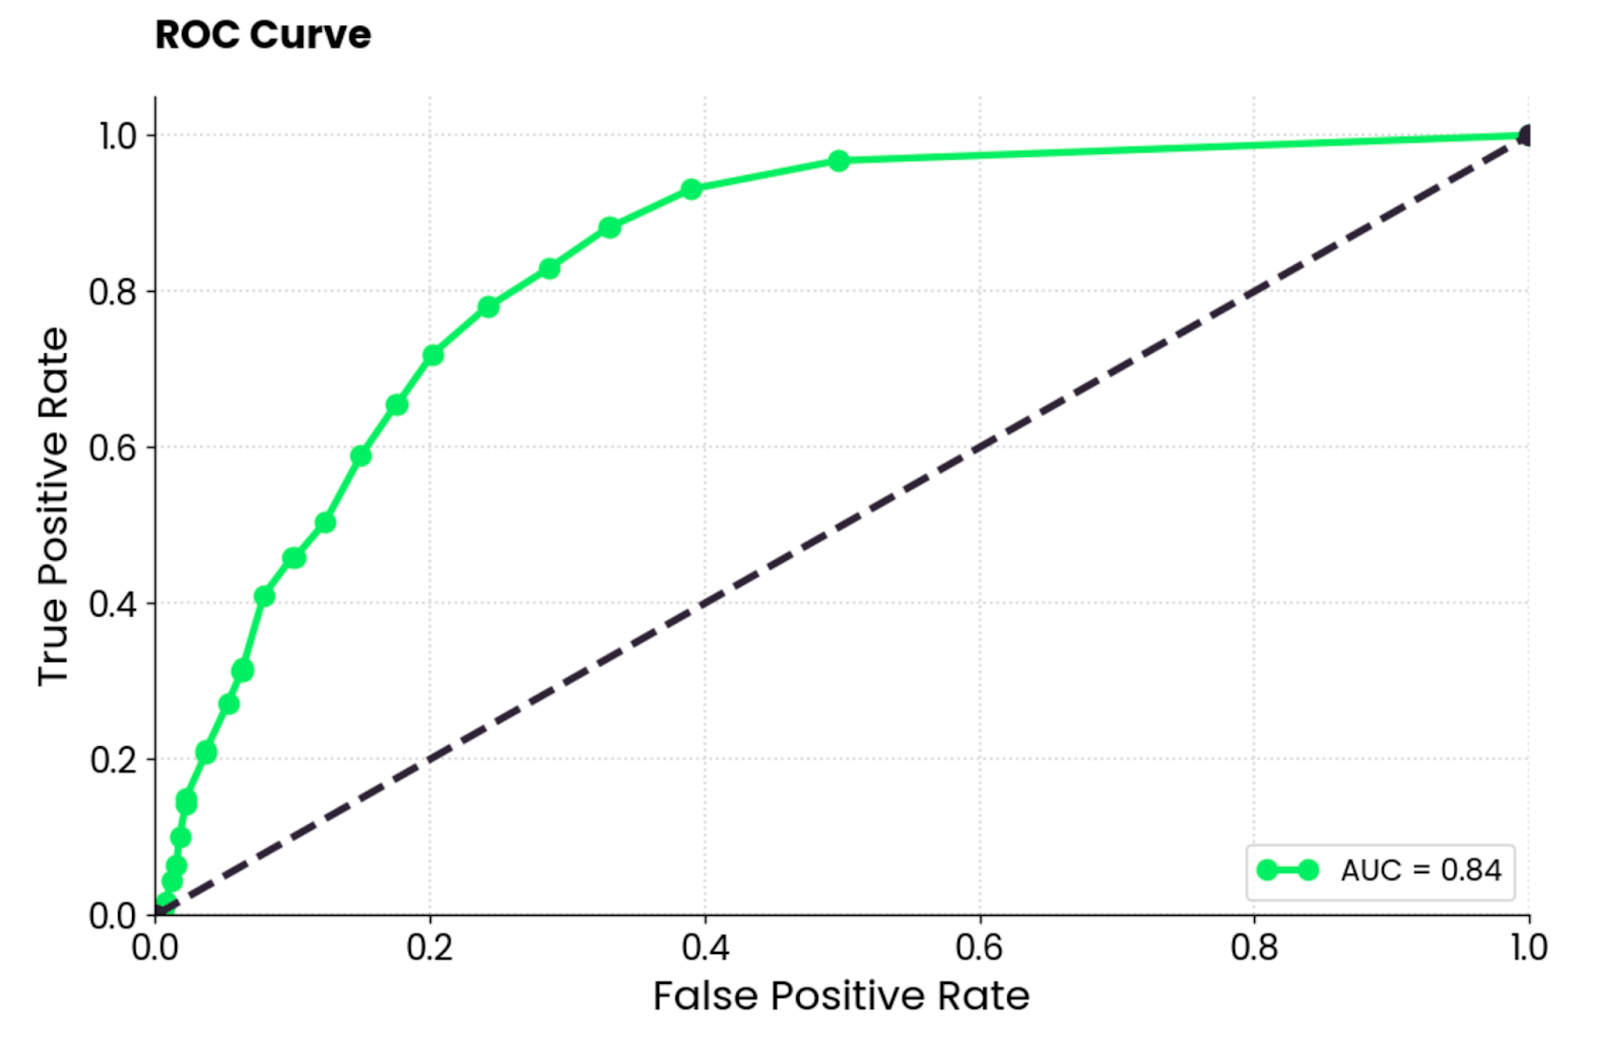
ROC eğrisi grafiği. Görsel: Yazar.
Yorumlarsak, rastgele orman modeli rastgele bir sınıflandırıcıdan oldukça iyi ve doğru pozitiflerle yanlış pozitifler arasında makul bir dengeye sahip. Yine de bir miktar yanlış sınıflandırma mevcut; veriyi iyileştirerek veya farklı bir makine öğrenimi modeli seçerek eğriyi yukarı ve sola taşımayı hedeflemelisiniz.
Bu eğri ROC’a benzer, ancak farklı sınıflandırma eşikleri için kesinlik ve duyarlılık arasındaki dengeyi gösterir. Y ekseninde kesinliği ve X ekseninde duyarlılığı gösterir ve sınıflar dengesiz olduğunda ROC’a kıyasla genellikle tercih edilir.
MBA başvuruları veri kümesinde de durum böyle, bu yüzden PR eğrisi harika bir seçim gibi görünüyor!
Kesinlik-duyarlılık eğrilerinin yalnızca azınlık sınıfına odaklandığını ve modelin en çok önem taşıyan örnekleri (kabul edilen öğrenciler, tespit edilen kanserler vb.) ne kadar iyi belirlediğine dair daha iyi bir resim sunduğunu belirtmek önemlidir.
Kesinlik ve duyarlılık değerlerini hesaplayıp grafiğe dökmek için aşağıdaki parçayı kullanın:
from sklearn.metrics import precision_recall_curve

# Get predicted probabilities for the positive class
y_probs = random_forest.predict_proba(X_test)[:, 1]

# Precision-Recall curve
precision, recall, pr_thresholds = precision_recall_curve(y_test, y_probs)
pr_auc = auc(recall, precision)
plt.plot(recall, precision, label=f"(AUC = {pr_auc:.2f})")
plt.xlabel("Recall")
plt.ylabel("Precision")
plt.title("Precision-Recall Curve", y=1.04)
plt.legend(loc="lower left")
plt.show()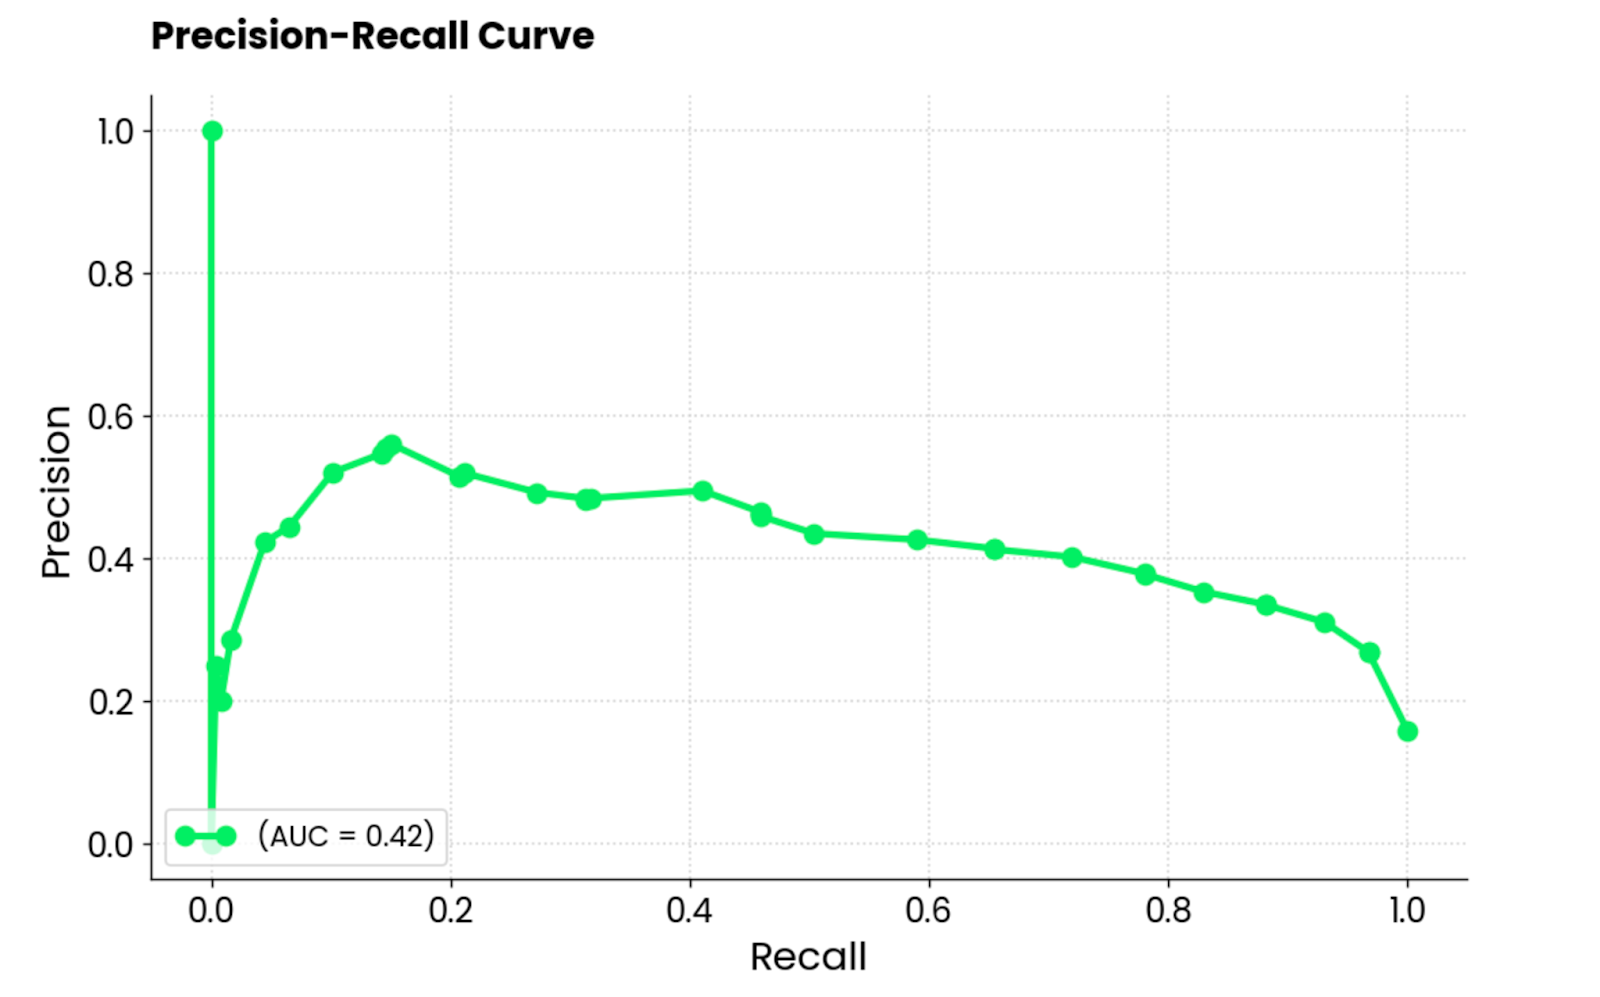
Kesinlik-duyarlılık eğrisi grafiği. Görsel: Yazar.
Yorumlarsak, AUC skorunun 0,42 olması modelin zayıf performansına işaret ediyor. Model duyarlılığı artırmaya çalıştığında, çok fazla kesinlikten ödün veriyor ve çok sayıda yanlış pozitife yol açıyor. Kısacası, bu model bu veri kümesi için pek uygun değil veya veri kümesinin ön işlemesi yeterli değil.
Sonuç olarak, makine öğrenimi alanı karmaşık ve çoğu zaman sezgisel değildir. Yeniyseniz, büyük fikirleri kavramakta zorlanırsınız. Bir iş müşterisiyle çalışıyorsanız, muhtemelen teknik jargonu anlamayacaklardır.
Veri görselleştirme her iki senaryoda da bu boşluğu kapatmaya yardımcı olur.
Bugün, regresyon ve sınıflandırma modellerini görselleştirmek için kullanabileceğiniz farklı grafik türlerini; ayrıca sinir ağlarının karar sürecini ve SHAP ile LIME üzerinden tekil tahminlerin yorumlanmasını gördünüz. Sindirmesi çok, bu yüzden bu yazıyı birden çok kez ziyaret etmekten çekinmeyin!
Konuya tamamen yeniyseniz, başlamak için makine öğrenimi temelleri kursumuzu izlemenizi öneririz. Ardından, daha uygulamalı bir Python kursu iyi bir seçimdir.
Biraz deneyiminiz var ama her şeyin daha büyük ölçekte nasıl çalıştığını anlamıyorsanız, üretim için makine öğrenimi kursumuza göz atmanızı öneririz.
Bu kurslarla makine öğrenimi hakkında daha fazlasını öğrenin!
Kurs
Kurs
Kurs
blog
Dario Radečić
15 dk.
blog
Abid Ali Awan
14 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




