
Kursus
Memahami Machine Learning
2 jam
311.4K
Di bagian singkat ini, saya akan menunjukkan cara memasang dependensi tingkat sistem dan pustaka Python yang diperlukan untuk memvisualisasikan model machine learning.
Satu-satunya dependensi tingkat sistem yang Anda perlukan untuk mengikuti adalah Graphviz. Anda akan menggunakannya nanti untuk memvisualisasikan decision tree, dan kodenya tidak akan berjalan tanpa Graphviz terpasang.
Ini adalah perangkat lunak sumber terbuka untuk membuat diagram, grafik abstrak, dan jaringan. Anda tidak akan menggunakannya secara langsung; hanya melalui scikit-Learn.
Pustaka Python ini banyak digunakan untuk tugas machine learning di Python.
Dalam artikel ini, Anda akan menggunakannya untuk melatih model, membagi dataset, menormalkan fitur numerik, dan memvisualisasikan kinerja model. Ini wajib ada, jadi pasang dengan perintah berikut (tergantung lingkungan Python Anda):
pip install scikit-learn
conda install scikit-learn
Jika Anda benar-benar baru dengan scikit-learn, kami sarankan menonton kursus pembelajaran terawasi kami yang populer.
Pustaka SHAP di Python adalah alat populer untuk menjelaskan prediksi model machine learning. Ia memanfaatkan konsep teori permainan (mis., nilai Shapely) untuk mengukur kontribusi tiap atribut terhadap prediksi model.
Lebih baik lagi, SHAP dilengkapi beragam visualisasi berguna yang membantu Anda memahami cara kerja internal model.
Pasang dengan perintah berikut:
pip install shap
conda install -c conda-forge shapPustaka Python ini banyak digunakan ketika penjelasan satu prediksi model sangat krusial. Cara kerjanya berbeda dari SHAP. LIME mendekati model asli secara lokal dengan model yang dapat ditafsirkan dan lebih sederhana. Lalu, LIME menunjukkan kontribusi tiap fitur dataset terhadap prediksi.
Sebentar lagi Anda akan melihat cara kerja LIME, tetapi pasang dulu:
pip install lime
conda install conda-forge::limeJika Anda membangun model neural network dengan TensorFlow, maka TensorBoard adalah pilihan jelas.
Ini adalah alat visualisasi yang membantu Anda melacak eksperimen machine learning dan memantau metrik pelatihan (mis., loss dan akurasi). TensorBoard memvisualisasikan dan memperbarui grafik model secara real-time dan menunjukkan bagaimana parameter model berubah selama pelatihan.
TensorBoard dapat digunakan dengan kerangka deep learning lain seperti PyTorch, tetapi untuk artikel ini saya akan berfokus pada TensorFlow.
Pasang dengan menjalankan perintah berikut:
pip install tensorboard
conda install -c conda-forge tensorboardLangkah terakhir pada fase persiapan ini adalah mengurus datanya.
Saya akan menggunakan dua dataset hari ini: MBA admissions untuk klasifikasi dan Insurance untuk regresi. Keduanya gratis digunakan dan tersedia untuk diunduh di Kaggle.
Untuk memulai, impor pustaka Python berikut:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import train_test_splitUntuk dataset klasifikasi, pra-pemrosesan data yang saya lakukan minimal. Intinya adalah:
Ini sama sekali bukan pipeline pra-pemrosesan yang komprehensif. Jika Anda punya waktu, silakan tingkatkan.
Namun demikian, salin fungsi ini untuk menyiapkan dataset klasifikasi:
def load_classification_dataset() -> pd.DataFrame:
    # https://www.kaggle.com/datasets/taweilo/mba-admission-dataset?resource=download
    df = pd.read_csv("MBA.csv")

    # Just an arbitrary ID
    df = df.drop(["application_id"], axis=1)

    # Fill unknown
    df["race"] = df["race"].fillna("Unknown")

    # Assume these are denied
    df["admission"] = df["admission"].fillna("Deny")

    # Convert boolean cols to 0/1
    df["gender"] = df["gender"].replace({"Male": 0, "Female": 1})
    df["international"] = df["international"].replace({False: 0, True: 1})

    # Create dummy columns for categorical features
    cols_for_dummy = ["major", "race", "work_industry"]
    for col in cols_for_dummy:
        dummies = pd.get_dummies(df[col], prefix=col)
        df = pd.concat([df, dummies], axis=1)

    # To drop
    cols_to_drop = ["major", "race", "work_industry", "major_Humanities", "race_Unknown", "work_industry_Other"]
    df = df.drop(cols_to_drop, axis=1)
    return df

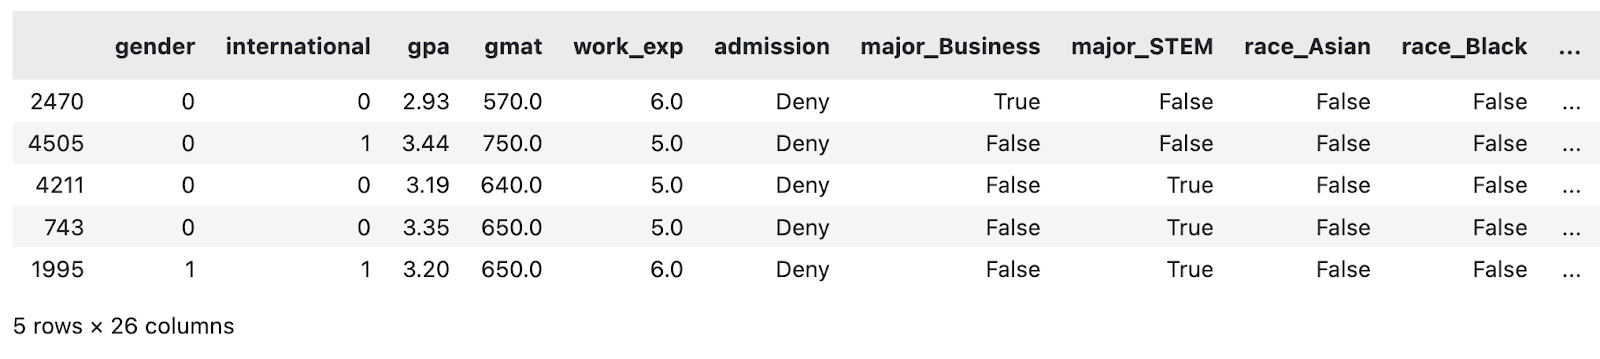
load_classification_dataset().sample(5)
Contoh sampel dataset MBA yang telah dimodifikasi. Gambar oleh Penulis.
Sekarang saya akan melakukan hal yang sama untuk dataset regresi.
Dataset regresi yang dipilih berisi jumlah biaya asuransi ($) sebagai fitur kontinu yang akan diprediksi model machine learning berdasarkan atribut lainnya.
Pra-pemrosesan data yang saya lakukan juga cukup minimal. Intinya adalah:
Jika Anda punya waktu, silakan tambahkan langkah lain ke pipeline.
Salin fungsi berikut untuk memuat dan memroses dataset asuransi:
def load_regression_dataset() -> pd.DataFrame:
    # https://www.kaggle.com/datasets/mirichoi0218/insurance
    df = pd.read_csv("MedicalCostPersonal.csv")

    # Scale numerical features
    cols_to_scale = ["age", "bmi", "children"]
    scaler = StandardScaler()
    df[cols_to_scale] = scaler.fit_transform(df[cols_to_scale])

    # Binary features
    df["sex"] = df["sex"].replace({"male": 0, "female": 1})
    df["smoker"] = df["smoker"].replace({"no": 0, "yes": 1})

    # Dummies
    dummies_region = pd.get_dummies(df["region"], prefix="region", drop_first=True)
    df = pd.concat([df, dummies_region], axis=1)
    df = df.drop("region", axis=1)
    return df

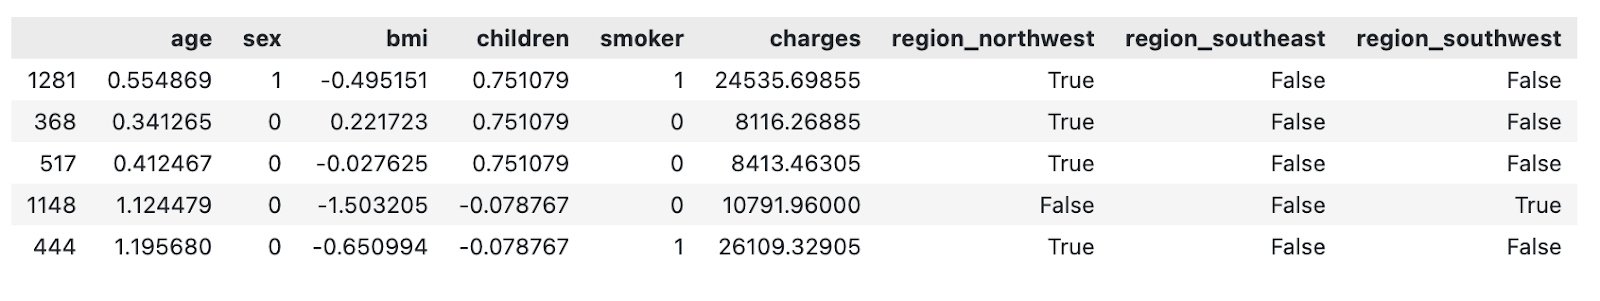
load_regression_dataset().sample(5)
Contoh sampel dataset asuransi yang telah dimodifikasi. Gambar oleh Penulis.
Dan itu saja!
Pada bagian berikutnya, saya akan menunjukkan cara mulai memvisualisasikan model machine learning.
Model berbasis pohon sering digunakan untuk klasifikasi, tetapi sebagian besar juga dapat menangani tugas regresi.
Di bagian ini, saya akan menunjukkan cara memvisualisasikan decision tree, feature importance dari model random forest, dan penjelasan prediksi dengan SHAP dan LIME.
Perlu diingat bahwa decision tree dan random forest bisa sulit dipahami. Kami memiliki kursus lengkap yang membahas dasar-dasar model machine learning berbasis pohon di Python.
Untuk memulai, muat dataset klasifikasi dan bagi menjadi subset pelatihan dan pengujian:
df = load_classification_dataset()
X = df.drop("admission", axis=1)
y = df["admission"]
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.25, random_state=42)
Berikutnya, mari memvisualisasikan decision tree!
Anggap decision tree sebagai sekumpulan pernyataan if bersarang di mana kondisinya ditentukan oleh model machine learning.
Masih ada cerita lain, tetapi dengan analogi ini, Anda bisa melihat bahwa memvisualisasikan keputusan seharusnya menjadi proses yang mudah. Dan memang begitu: fungsi plot_tree() dari sklearn menangani sebagian besar pekerjaan berat.
Mulailah dengan melatih model decision tree. Parameter max_depth bersifat opsional dan ada hanya untuk tujuan visualisasi. Tanpanya, pohon akan terlalu dalam, dan Anda akan tersesat dalam banyaknya keputusan yang dibuat model, terutama untuk dataset besar.
Cuplikan berikut melatih model klasifikasi decision tree pada subset pelatihan:
from sklearn import tree

decision_tree = tree.DecisionTreeClassifier(random_state=42, max_depth=4)
decision_tree.fit(X_train, y_train)
Untuk visualisasi, salin saja cuplikan berikut. Parameter opsional filled dan feature_names membuat pohon lebih mudah ditafsirkan:
plt.figure(figsize=(12,8))
tree.plot_tree(decision_tree, filled=True, feature_names=X.columns, class_names=y.unique())
plt.title("Decision Tree Visualization", size=20, loc="left", y=1.04, weight="bold")
plt.show()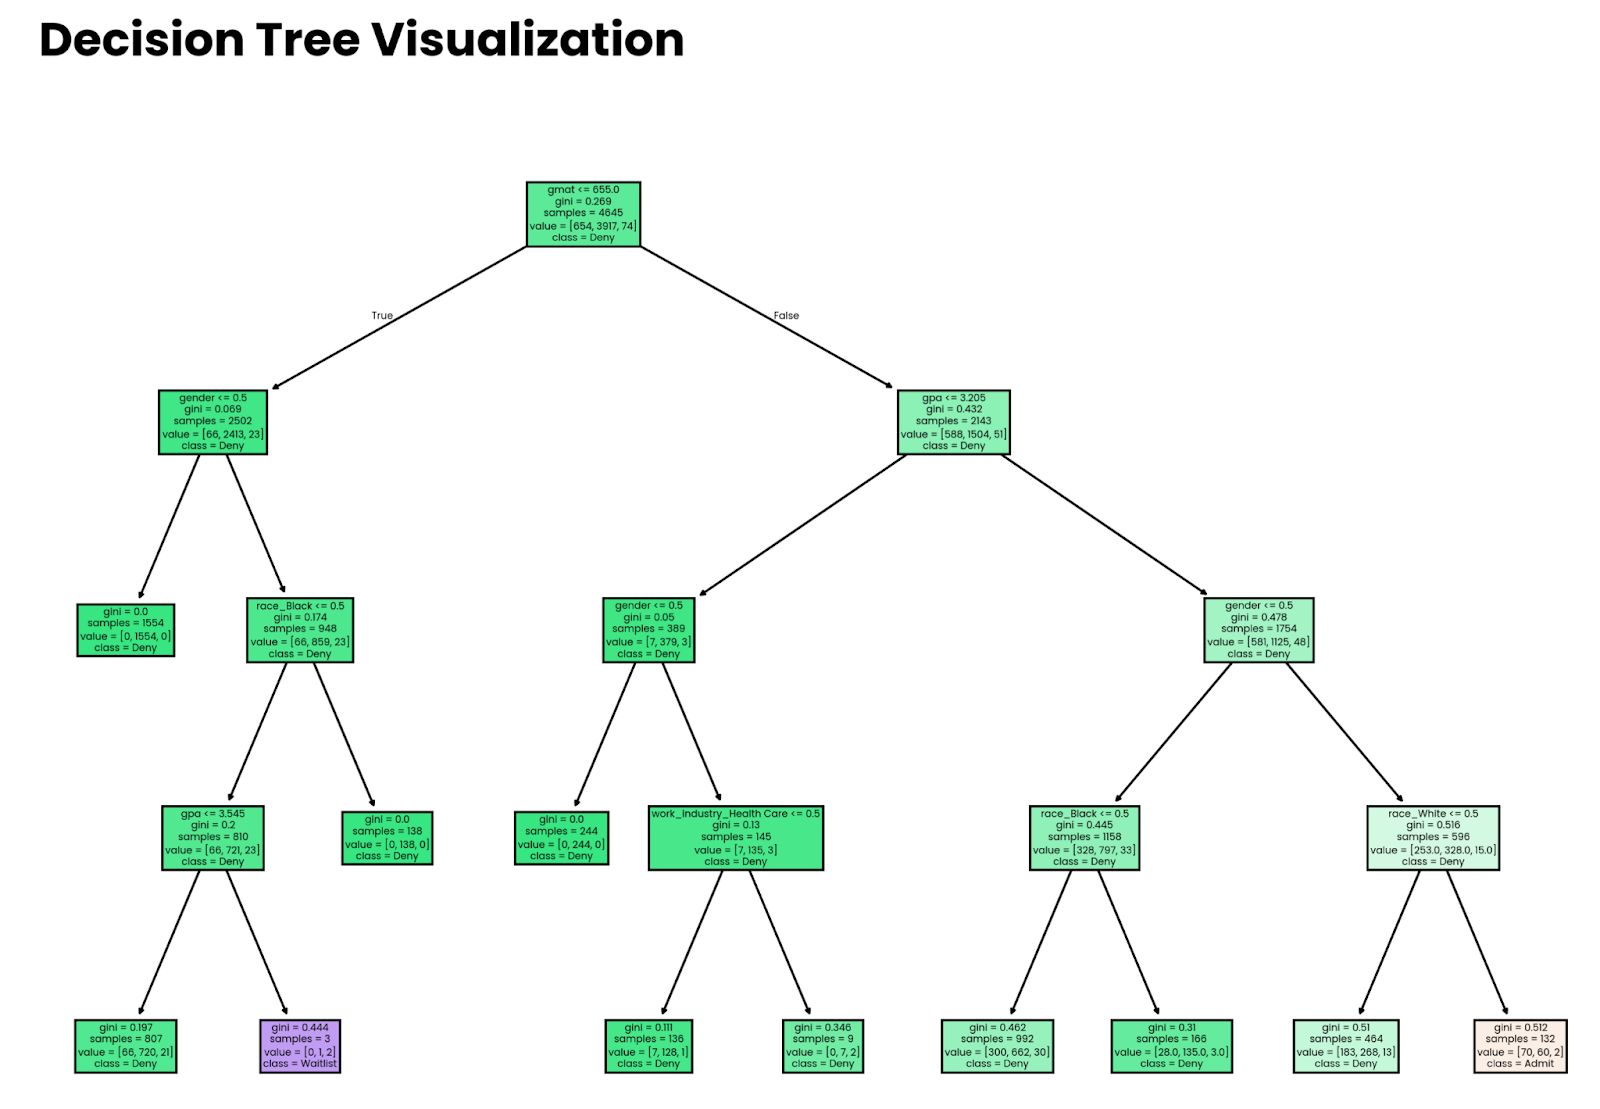
Decision tree sedalam empat level. Gambar oleh Penulis.
Perhatikan bahwa keputusan yang dibuat model tidak berarti apa-apa jika modelnya tidak akurat. Nanti di artikel ini, saya akan menunjukkan cara memperkirakan akurasi.
Ingat analogi kue sebelumnya? Saatnya mempraktikkannya.
Setiap kali Anda melatih model pohon dengan sklearn, Anda mendapat akses ke properti feature_importances_. Padukan dengan nama fitur, dan Anda memiliki semua data untuk melihat atribut mana yang paling berkontribusi terhadap prediksi.
Mari lihat aksinya! Pertama, latih classifier random forest pada subset pelatihan:
from sklearn.ensemble import RandomForestClassifier

random_forest = RandomForestClassifier(n_estimators=25, random_state=42)
random_forest.fit(X_train, y_train)
Visualisasi kini tinggal mengambil dan mengurutkan feature importance dan mengganti indeks dengan nama fitur:
importances = random_forest.feature_importances_
indices = np.argsort(importances)[::-1]
plt.figure(figsize=(10,6))
bars = plt.bar(range(X.shape[1]), importances[indices], edgecolor="#008031", linewidth=1)

for bar in bars:
    height = bar.get_height()
    plt.text(bar.get_x() + bar.get_width() / 2, height, f"{height:.2f}", ha="center", va="bottom", size=8)

plt.title("Feature Importances", size=20, loc="left", y=1.04, weight="bold")
plt.ylabel("Importance")
plt.xticks(range(X.shape[1]), np.array(X.columns)[indices], rotation=90, size=12)
plt.show()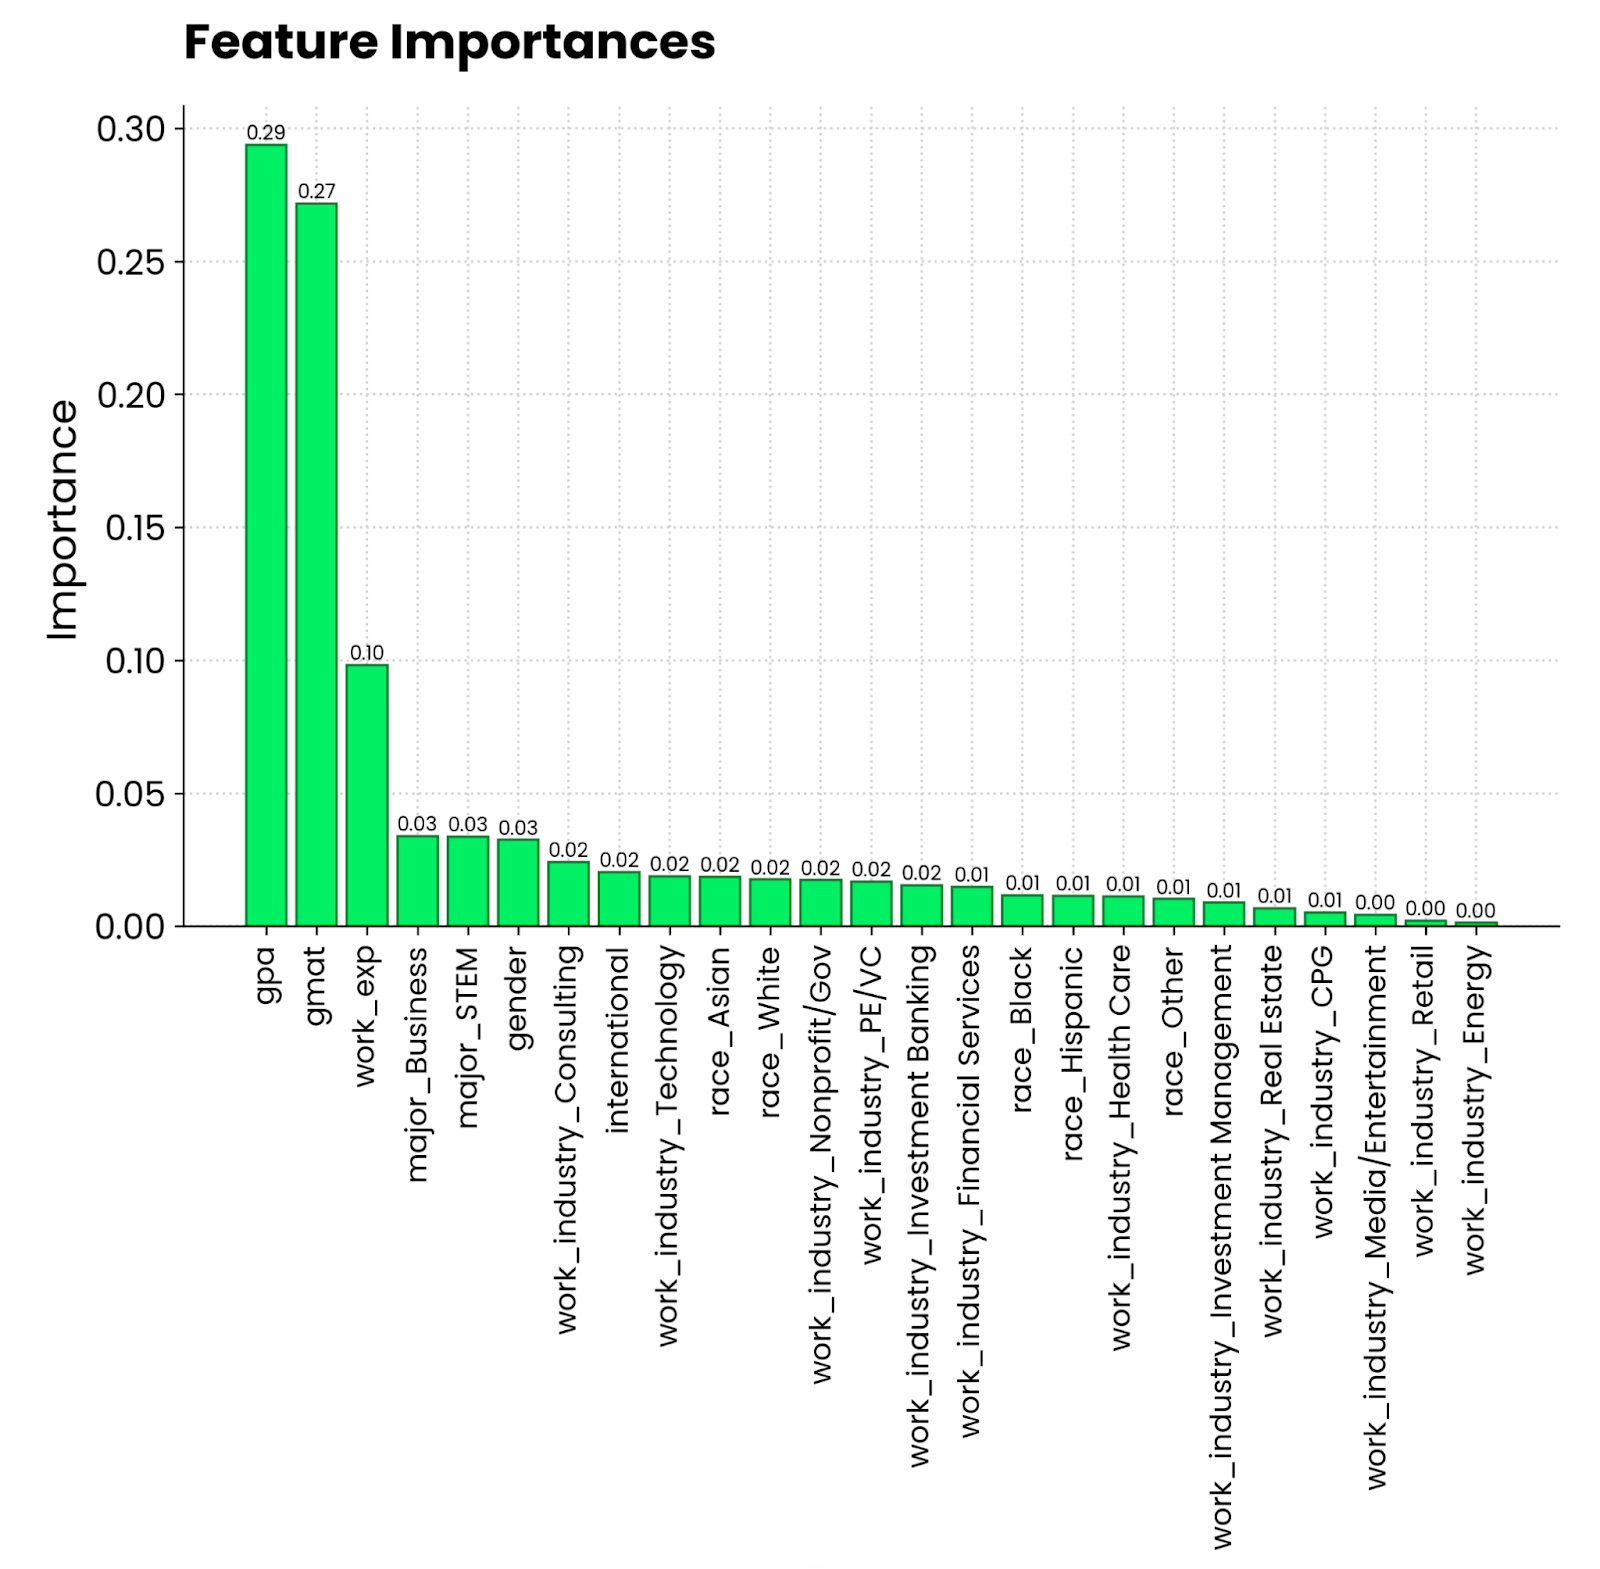
Plot feature importance random forest. Gambar oleh Penulis.
Tampaknya IPK pada skala 4.0 dan skor GMAT paling berkontribusi terhadap peluang diterima di program MBA. Setelahnya ada pengalaman kerja, yang memang menjadi persyaratan studi MBA. Jurusan yang diambil dan industri tempat bekerja jauh kurang relevan.
Feature importance memberikan gambaran umum, tetapi bagaimana jika Anda ingin memvisualisasikan model pada level prediksi individual?
Di sinilah SHAP dan LIME berperan. Saya akan membahas SHAP terlebih dahulu. Anda sudah tahu apa itu, jadi saya akan lewati teorinya.
Saya akan memasangkan model gradient boosting pada dataset regresi kita untuk melihat dampak fitur individual terhadap biaya asuransi. Cuplikan berikut menunjukkan cara memasang model dan menghitung nilai SHAP dari model shap.Explainer():
import shap
from xgboost import XGBRegressor

df = load_regression_dataset()

# No need for train-test splits
X = df.drop("charges", axis=1)
y = df["charges"]
model = XGBRegressor().fit(X, y)

# Shap explainer
explainer = shap.Explainer(model)
shap_values = explainer(X)
Dengan SHAP, ada serangkaian plot yang bisa Anda buat.
Saya akan mulai dengan waterfall() dan menelaah nilai SHAP untuk prediksi pertama:
shap.plots.waterfall(shap_values[0])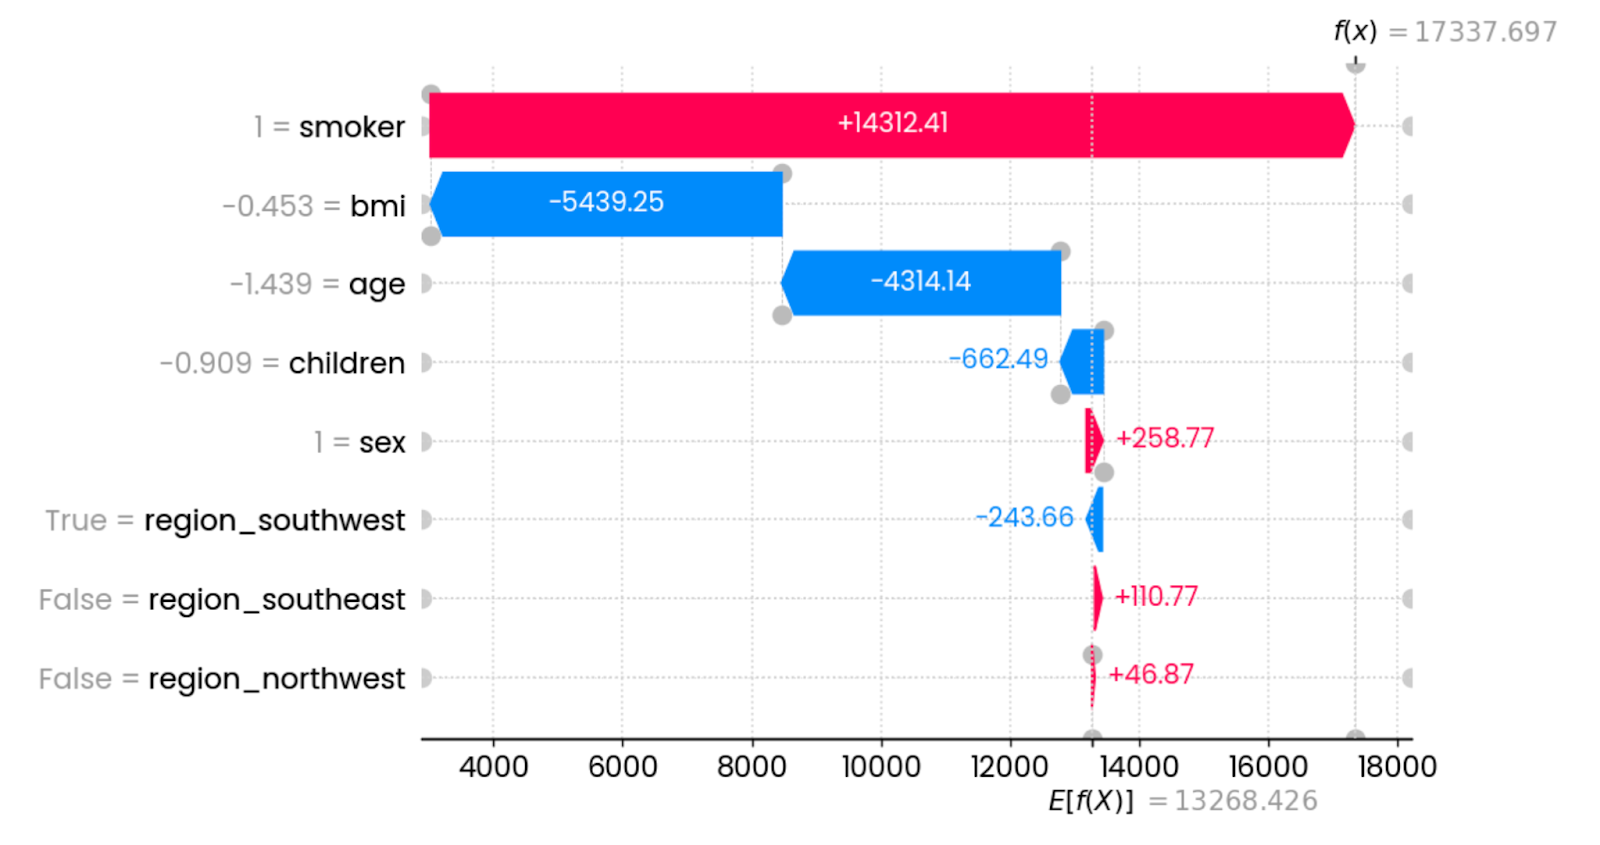
Penjelasan untuk prediksi pertama. Gambar oleh Penulis.
Dalam kasus ini, menjadi perokok secara drastis meningkatkan biaya asuransi. Fitur yang paling menurunkan biaya adalah BMI (terkait berat badan) dan usia. Fitur lain berdampak minimal atau bahkan tidak berdampak sama sekali.
Anda dapat merepresentasikan grafik di atas dalam format yang lebih ringkas:
shap.plots.force(shap_values[0])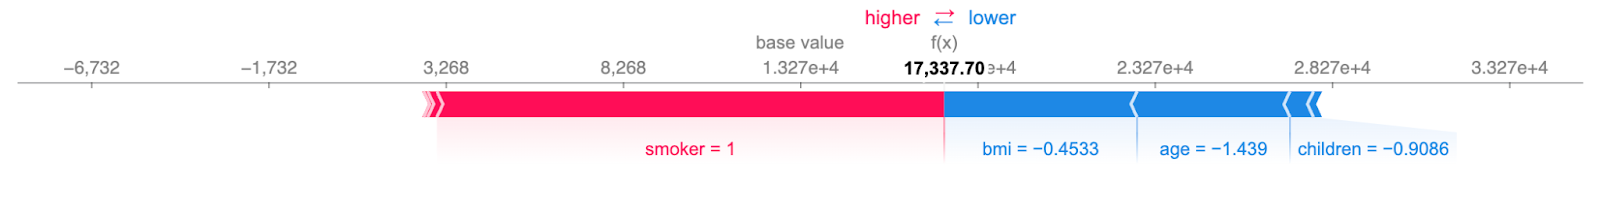
Penjelasan prediksi pertama yang ringkas. Gambar oleh Penulis.
Informasinya tetap sama: fitur berwarna merah menaikkan biaya, dan fitur biru menurunkannya. Titik temu menunjukkan biaya asuransi untuk satu instance.
Plot beeswarm menunjukkan fitur paling penting dengan memplot nilai SHAP setiap fitur untuk setiap sampel. Fitur diurutkan berdasarkan jumlah magnitudo nilai SHAP di semua sampel. Warna merepresentasikan nilai fitur (merah tinggi dan biru rendah):
shap.plots.beeswarm(shap_values)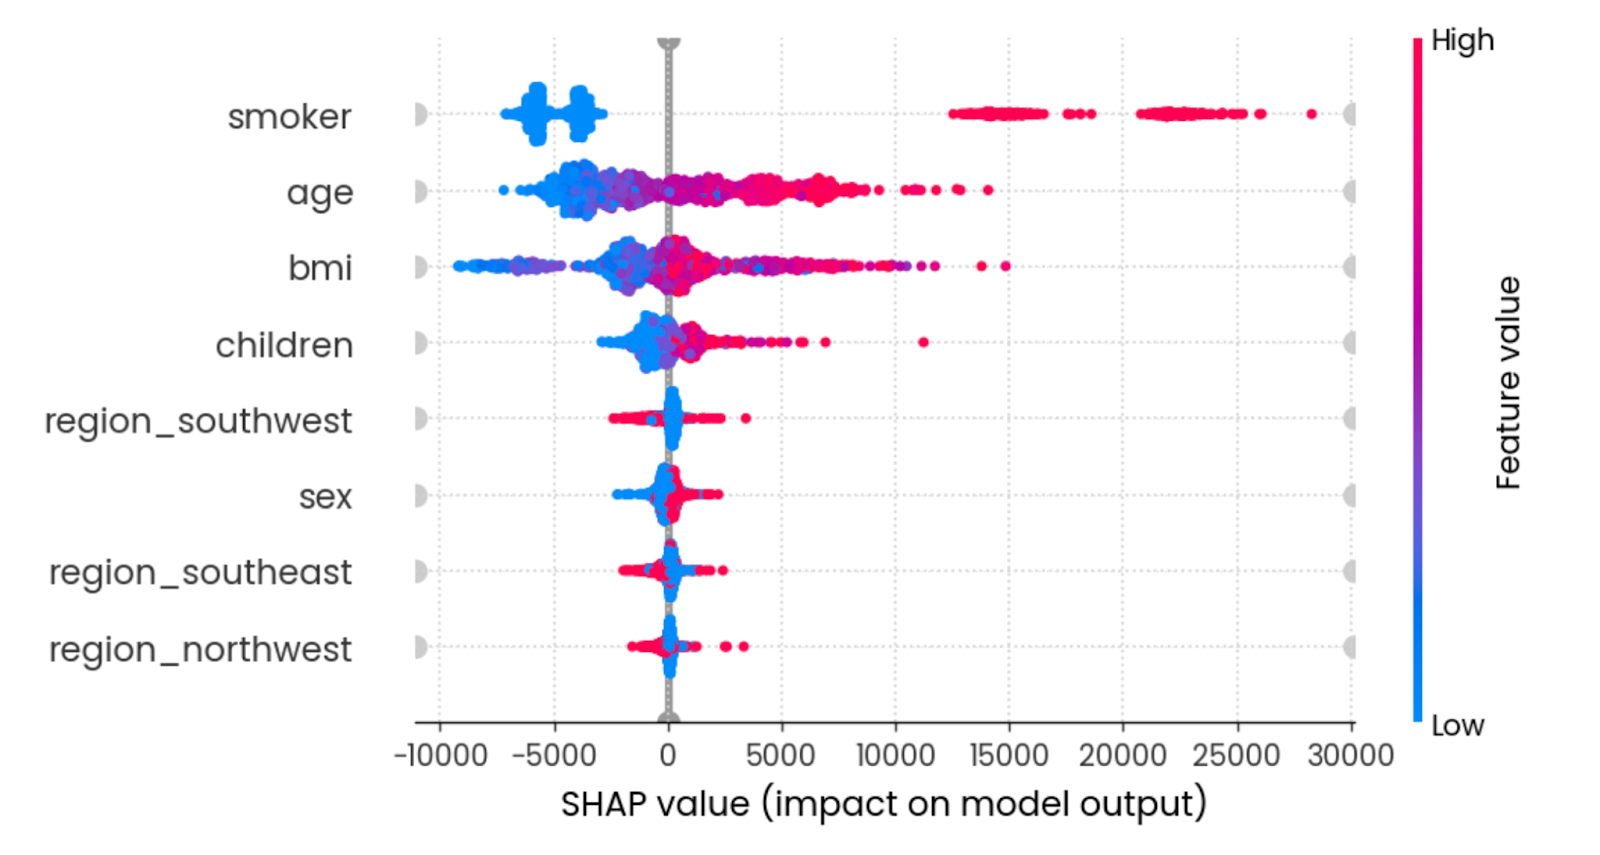
Dampak ringkasan semua fitur. Gambar oleh Penulis.
Untuk diinterpretasikan, menjadi non-perokok yang masih muda dengan BMI yang wajar menurunkan biaya asuransi.
Visualisasi SHAP terakhir yang ingin saya tunjukkan adalah diagram batang nilai absolut rata-rata. Ini menghitung nilai absolut rata-rata dari semua nilai SHAP untuk tiap fitur:
shap.plots.bar(shap_values)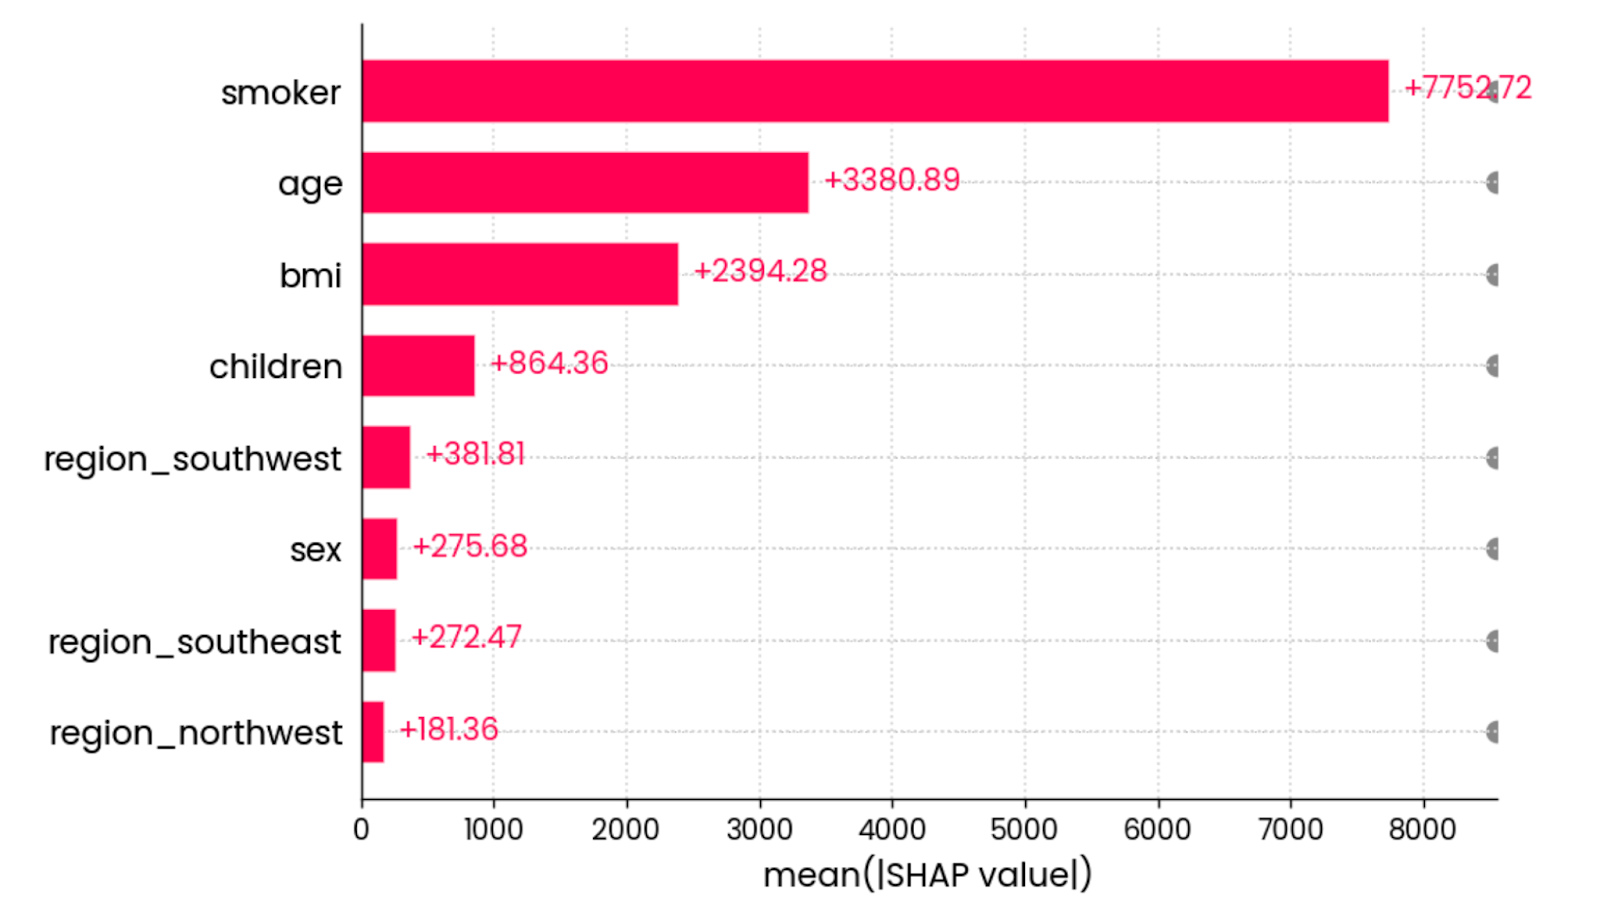
Nilai absolut rata-rata dari semua nilai SHAP untuk semua fitur. Gambar oleh Penulis.
Dengan kata lain, ini cara yang lebih rapi untuk menghitung feature importance global — grafik tidak terikat pada prediksi individual.
Selesai untuk SHAP. Selanjutnya saya akan beralih ke LIME.
Sama seperti SHAP, LIME berfokus pada machine learning yang dapat ditafsirkan.
LIME tidak memiliki banyak jenis visualisasi, tetapi melakukan satu hal dengan baik—setidaknya untuk dataset tabular.
Untuk demonstrasi, saya akan memuat dataset klasifikasi dan mengubahnya lebih lanjut menjadi tugas klasifikasi biner dengan mengganti entri daftar tunggu (waitlist) menjadi ditolak. Ini akan memudahkan Anda memahami keluaran LIME:
from lime import lime_tabular

df = load_classification_dataset()

# Convert to binary
df["admission"] = df["admission"].replace({"Waitlist": "Deny"})
X = df.drop("admission", axis=1)
y = df["admission"]
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.25, random_state=42)
X_train.shape, y_test.shape
random_forest = RandomForestClassifier(n_estimators=25, random_state=42)
random_forest.fit(X_train, y_train)
Kelas LimeTabularExplainer() kini menerima data pelatihan, nama kolom, nama kategori pada variabel target, dan mode machine learning (klasifikasi atau regresi):
explainer = lime_tabular.LimeTabularExplainer(
    training_data=np.array(X_train),
    feature_names=X_train.columns,
    class_names=["Admit", "Deny"],
    mode="classification"
)
Setelah selesai, Anda dapat memanggil metode explain_instance() untuk menafsirkan satu prediksi berdasarkan probabilitas prediksi kelas:
exp = explainer.explain_instance(
    data_row=X_test.iloc[0],
    predict_fn=random_forest.predict_proba
)
exp.show_in_notebook(show_table=True)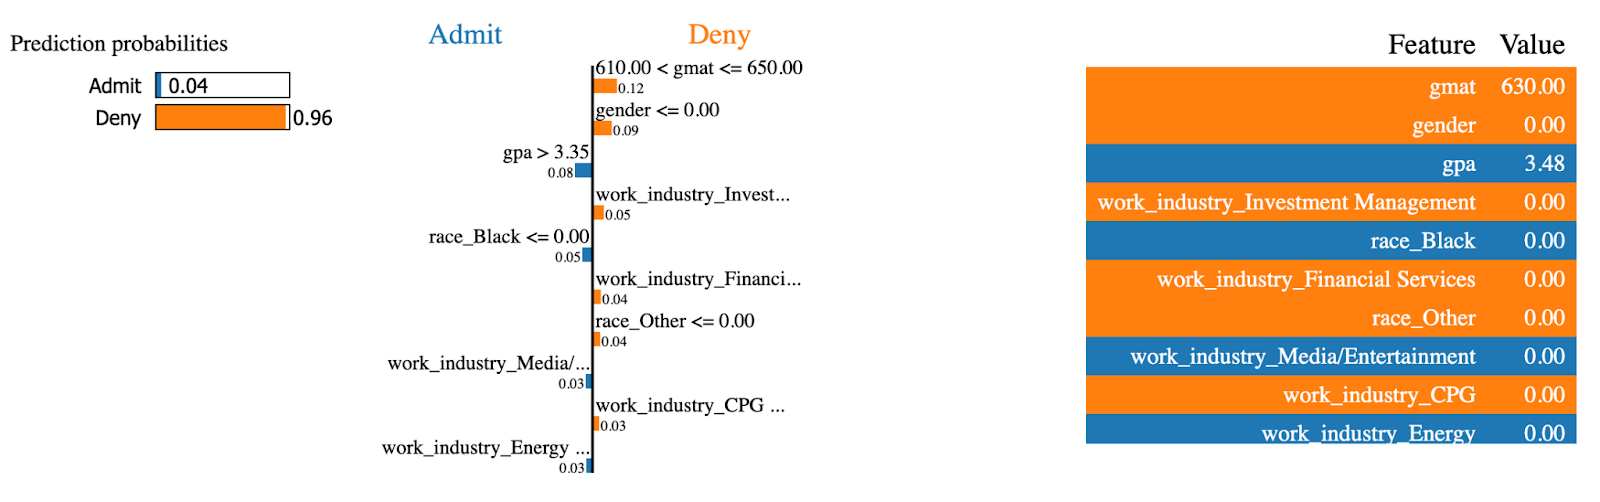
Penjelasan LIME (1). Gambar oleh Penulis.
Model LIME 96% yakin bahwa penerimaan MBA ini akan ditolak. Fitur seperti gmat dan gender paling berpengaruh pada keputusan.
Sekarang lakukan hal yang sama untuk instance yang diterima di program MBA:
exp = explainer.explain_instance(
    data_row=X_test.iloc[234],
    predict_fn=random_forest.predict_proba
)
exp.show_in_notebook(show_table=True)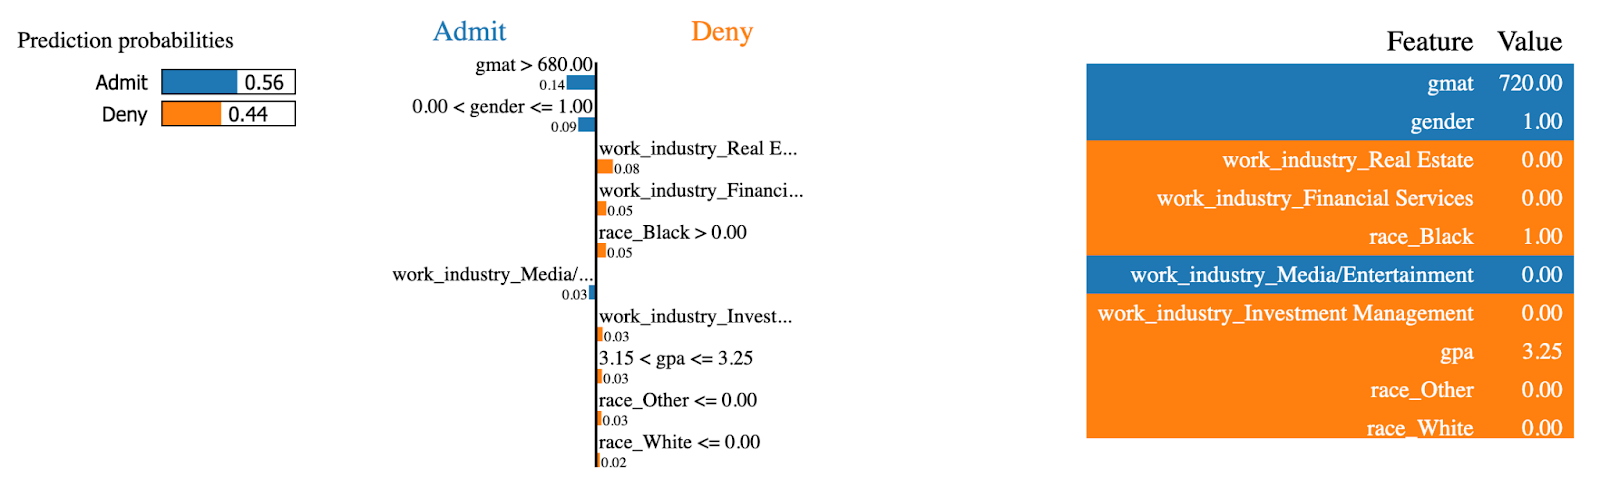
Penjelasan LIME (2). Gambar oleh Penulis.
Fitur yang sama kini berdampak sebaliknya! Orang ini memiliki skor gmat tinggi, yang menjadi kontributor terbesar untuk diterima di program MBA.
Selesai untuk model pohon! Berikutnya, Anda akan mempelajari cara memvisualisasikan model linear untuk tugas regresi.
Jika Anda baru memulai pemodelan prediktif, tidak ada yang lebih dasar dari regresi linear. Ini model sederhana yang mudah dipahami dan bekerja baik, selama hubungan dalam dataset Anda linear.
Ada model linear lain, tetapi di bagian ini, saya hanya akan menggunakan regresi linear.
Mulailah dengan memuat dataset regresi, membaginya menjadi subset pelatihan dan pengujian, lalu memasangkan model regresi linear ke bagian pelatihan:
from sklearn.linear_model import LinearRegression

df = load_regression_dataset()
X = df.drop("charges", axis=1)
y = df["charges"]
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.25, random_state=42)
model = LinearRegression().fit(X_train, y_train)
Jenis visualisasi pertama yang akan saya bahas adalah koefisien model.
Secara sederhana, model regresi linear bermuara pada satu persamaan. Anda mungkin ingat y = mx+b dari sekolah — idenya sama.
Persamaan regresi diperluas menjadi y = w0 + w1_x1 + w2_x2 + … + wn_xn untuk mengakomodasi banyak parameter. Tujuan model adalah menemukan estimasi bobot (w) terbaik untuk sekumpulan fitur input (x).
Jadi, mengapa ini penting?
Karena Anda bisa mengakses koefisien (bobot) setelah model dilatih dan menganalisis kontribusinya; fitur dengan koefisien lebih besar akan memiliki kontribusi lebih tinggi terhadap prediksi variabel target.
Anda bisa mendapatkan koefisien dengan mengakses parameter coef_ pada model yang telah dilatih.
Cuplikan berikut mengambil koefisien dan memplotnya sebagai diagram batang horizontal:
features = X_train.columns
coefficients = model.coef_
plt.figure(figsize=(10, 4))
bars = plt.barh(y=features, width=coefficients, edgecolor="#008031", linewidth=1)

for bar in bars:
    width = bar.get_width()
    plt.text(width + 1, bar.get_y() + bar.get_height()/2, f"{width:.2f}",
             va="center", ha="left")

plt.xlabel("Coefficient value")
plt.title("Linear Regression Model Coefficients", y=1.05)
plt.show()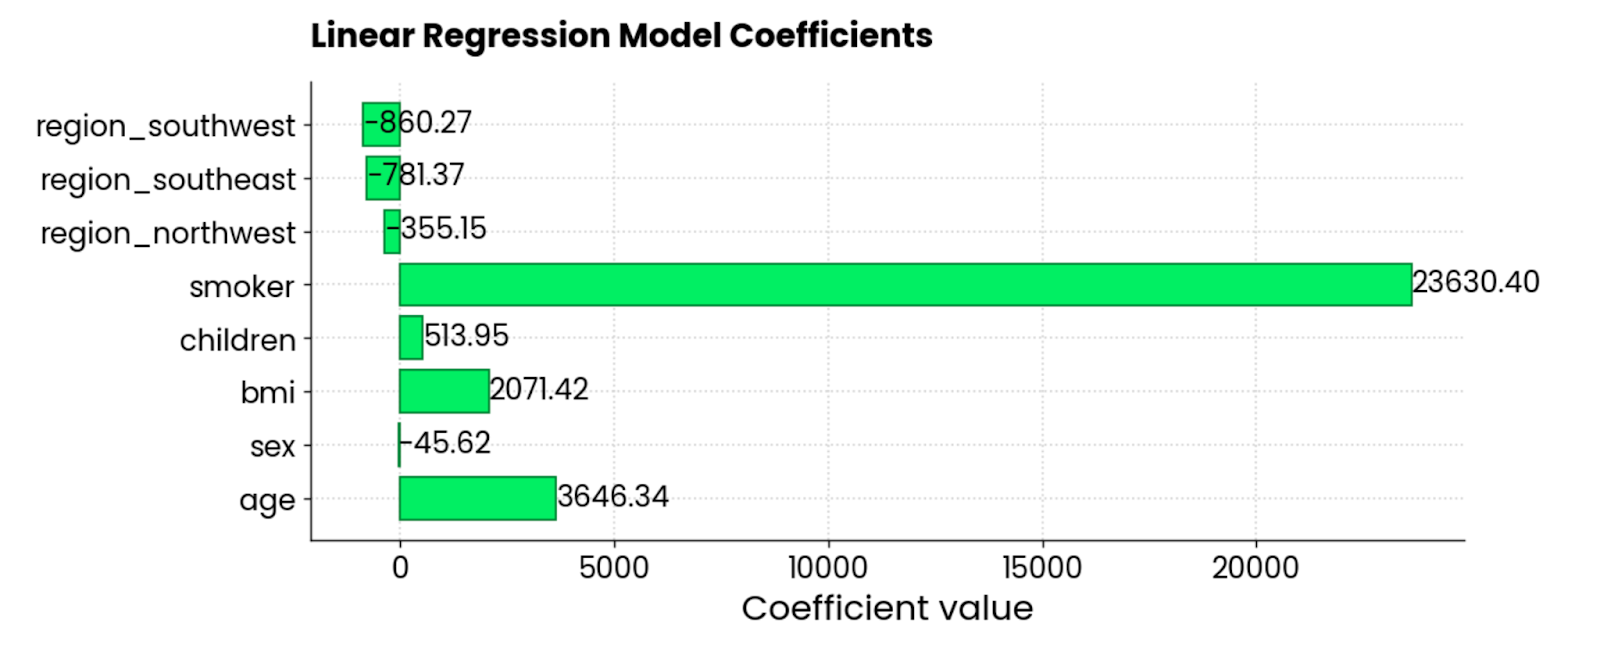
Koefisien model regresi linear. Gambar oleh Penulis.
Fitur smoker, BMI, dan age adalah kontributor positif terbesar terhadap biaya asuransi—ketika naik, jumlahnya juga naik. Ada beberapa koefisien negatif juga, yang berarti menurunkan jumlah keseluruhan.
Jenis visualisasi regresi lain yang umum adalah plot residual. Secara sederhana, Anda membuat scatter plot nilai prediksi pada sumbu X dan residual (nilai sebenarnya - nilai prediksi) pada sumbu Y.
Idealnya, tidak boleh ada pola yang terlihat pada residual, dan residual harus berpusat di sekitar 0. Dengan kata lain, residual harus terdistribusi normal.
Gunakan cuplikan kode ini untuk memvisualisasikan residual model regresi linear pada dataset asuransi:
y_pred = model.predict(X_test)
residuals = y_test - y_pred
plt.figure(figsize=(10, 6))
plt.scatter(y_pred, residuals, color="#03EF62", alpha=0.6, edgecolors="#008031")
plt.axhline(0, color="red", linestyle="--")
plt.xlabel("Predicted Values")
plt.ylabel("Residuals")
plt.title("Residuals vs Predicted Values", y=1.05)
plt.grid(True)
plt.show()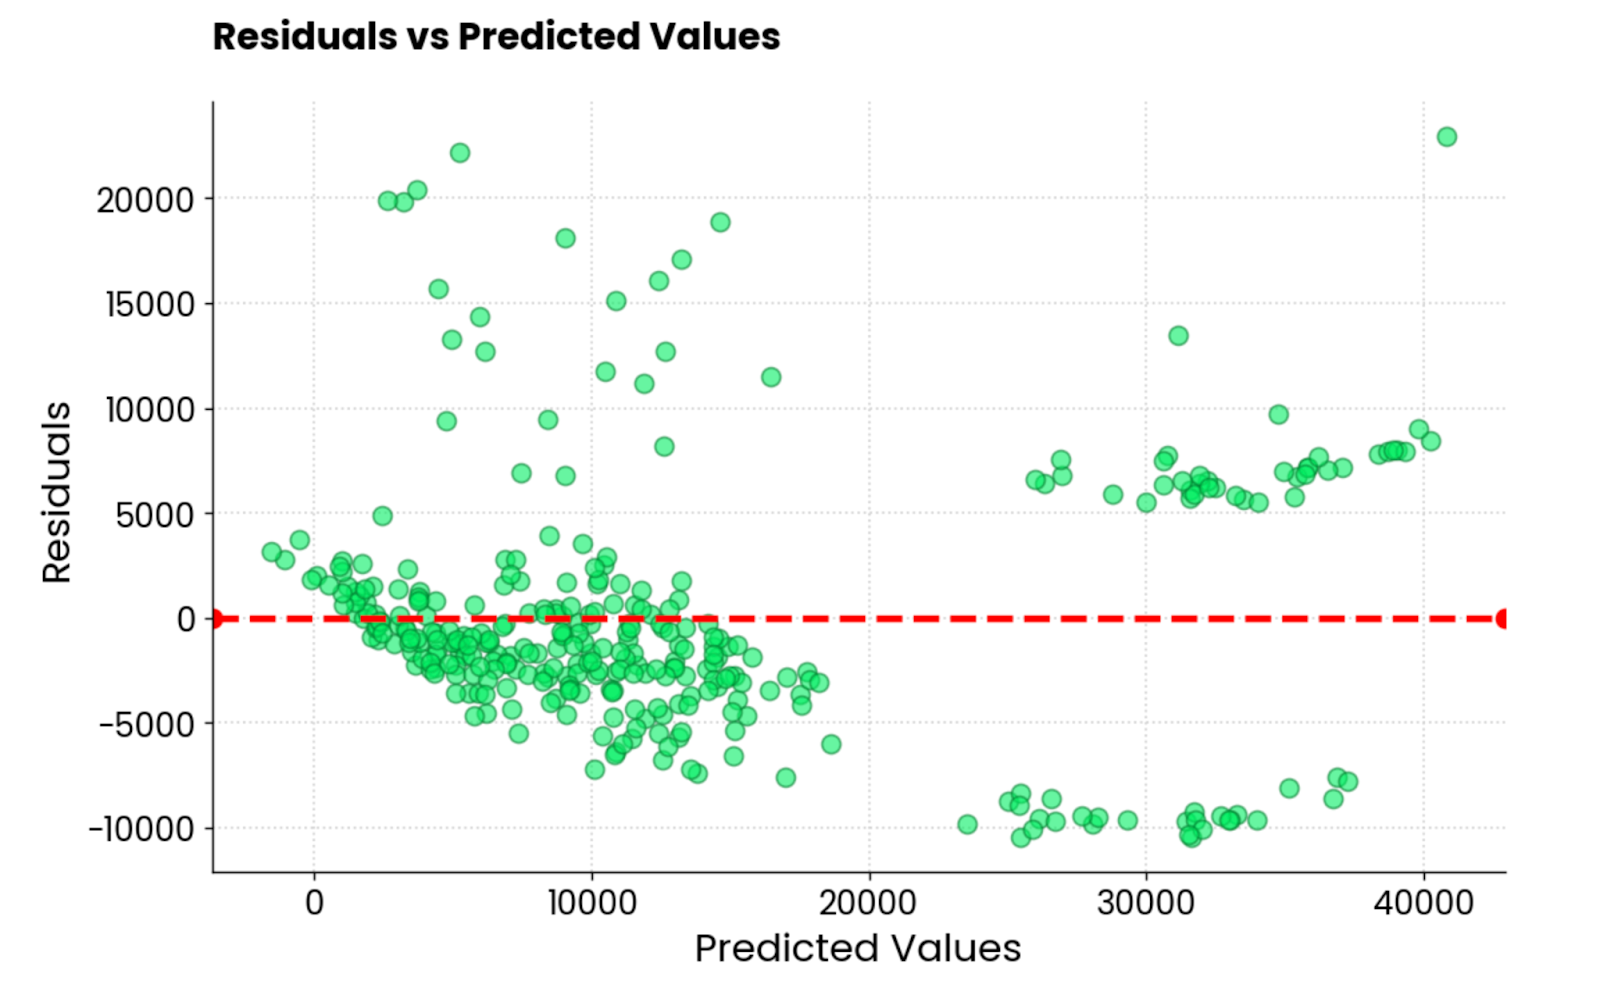
Residual model regresi linear. Gambar oleh Penulis.
Ini bukan plot residual terbaik yang pernah saya lihat. Secara estetika bagus, tetapi nilainya tersebar ke mana-mana. Jika Anda praktisi machine learning dan mendapatkan plot residual serupa, Anda masih punya banyak pekerjaan.
Berikutnya, saya akan menunjukkan 3 cara memvisualisasikan model neural network.
Jika ada satu area machine learning di mana visualisasi dan interpretasi paling penting, itu adalah neural network.
Model ini kompleks untuk dipahami, bahkan pada tingkat paling mendasar. Ada jenis layer yang berbeda, fungsi aktivasi, dan backpropagation — hanya beberapa di antaranya. Karena itu, neural network sering menjadi sinonim untuk model kotak hitam.
Tidak harus begitu.
Di bagian ini, saya akan menunjukkan tiga cara memvisualisasikan neural network: plot arsitektur, metrik pelatihan real-time, dan Grad-CAM.
Pustaka pilihan saya adalah TensorFlow. Jika Anda belum pernah mendengarnya, kami memiliki kursus TensorFlow untuk pemula yang akan membantu Anda mulai dengan cepat!
Saat Anda memvisualisasikan arsitektur model neural network, satu hal akan menjadi lebih jelas — bentuk (shapes).
Dengan kata lain, Anda akan melihat bagaimana matriks yang mendasarinya berubah ukuran saat melewati layer. Ini bisa menjadi topik sulit untuk pemula, jadi visualisasi apa pun sangat membantu.
Untuk demonstrasi, saya akan menggunakan TensorFlow untuk membuat model neural network dasar untuk klasifikasi digit tulisan tangan. Lalu, saya akan menggunakan fungsi plot_model() untuk menyimpan gambar arsitektur model ke file lokal.
Silakan lihat sendiri:
from tensorflow.keras import layers, models
from tensorflow.keras.utils import plot_model

model = models.Sequential()
model.add(layers.Input(shape=(28, 28, 1)))
model.add(layers.Conv2D(32, (3, 3), activation="relu"))
model.add(layers.MaxPooling2D((2, 2)))
model.add(layers.Conv2D(64, (3, 3), activation="relu"))
model.add(layers.MaxPooling2D((2, 2)))
model.add(layers.Flatten())
model.add(layers.Dense(64, activation="relu"))
model.add(layers.Dense(10, activation="softmax"))
plot_model(model, to_file="model_architecture.png", show_shapes=True, show_layer_names=True)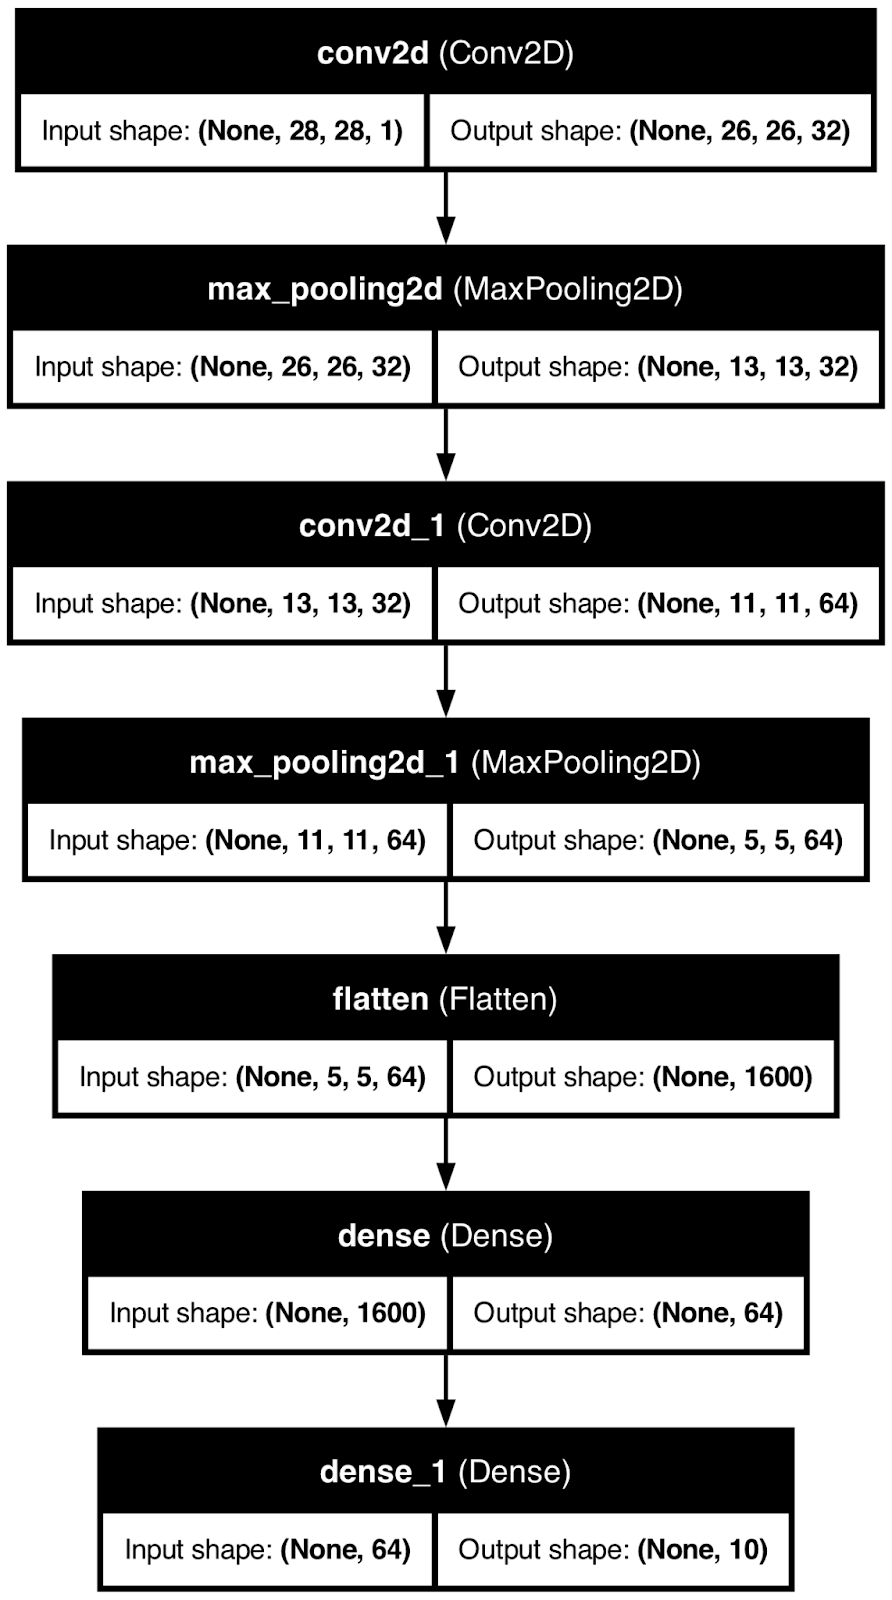
Arsitektur model neural network. Gambar oleh Penulis.
Meskipun membantu, jenis visualisasi ini hanya bisa sejauh itu.
Anda tahu bagaimana data bertransformasi, tetapi Anda belum tahu bagaimana model neural network sampai pada kesimpulannya. Itu yang akan saya bahas berikutnya.
Grad-CAM, atau Gradient Class Activation Mapping adalah teknik populer untuk memvisualisasikan model convolutional neural network.
Secara spesifik, teknik ini membantu Anda memahami bagian mana dari gambar input yang paling berkontribusi terhadap prediksi model. Anggap seperti plot feature importance pada decision tree, tetapi dinaikkan levelnya.
Ini teknik interpretabilitas lanjutan yang bekerja untuk semua model konvolusional apa pun arsitekturnya dan membantu Anda memahami mengapa model neural network membuat prediksi tertentu.
Namun ada masalah — implementasinya di Python tidak sepele. Berikut gambaran tingkat tinggi algoritmenya:
Prosesnya cukup rumit, dan untuk mempermudah, saya akan menggunakan model pra-latih ResNet50 yang sudah bisa mengklasifikasi 1000 jenis gambar berbeda.
Namun pertama-tama, muat pustaka yang diperlukan dan gambar yang ingin Anda lihat Grad-CAM-nya. Saya menggunakan sebuah gambar stok anjing:
import cv2
import tensorflow as tf
from tensorflow.keras.applications.resnet50 import ResNet50
from tensorflow.keras.preprocessing.image import load_img

image = np.array(load_img("dog.jpg", target_size=(224, 224, 3)))
plt.grid(False)
plt.imshow(image)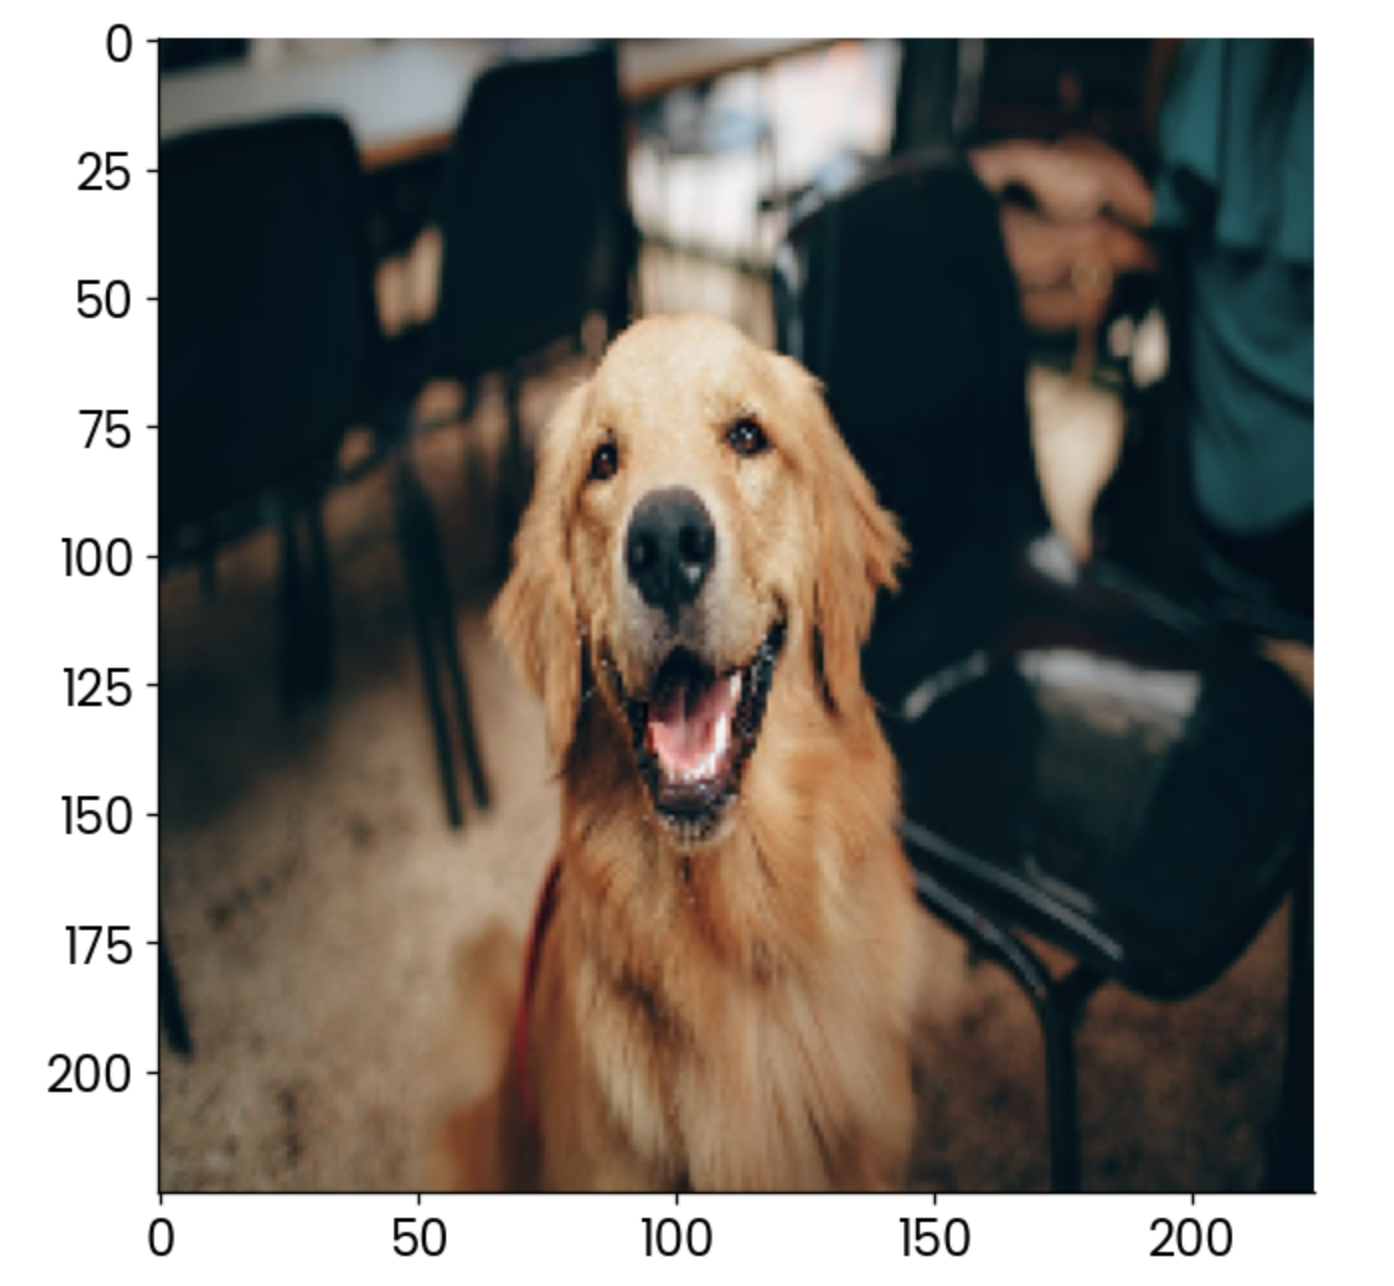
Contoh gambar anjing. Gambar oleh Penulis.
Sekarang bagian serunya dimulai. Pada cuplikan kode berikut, saya mengimplementasikan proses empat langkah yang dijelaskan sebelumnya. Anda akan menemukan komentar di atas setiap baris kode untuk memudahkan pemahaman:
# Load the pre-trained ResNet50 model
model = ResNet50()

# Extract the output of the last convolutional layer
last_conv_layer = model.get_layer("conv5_block3_out")

# Create a model that outputs the last convolutional layer’s activations
last_conv_layer_model = tf.keras.Model(model.inputs, last_conv_layer.output)

# Prepare the classifier model using the layers after the last convolutional layer
classifier_input = tf.keras.Input(shape=last_conv_layer.output.shape[1:])
x = classifier_input
for layer_name in ["avg_pool", "predictions"]:
    # Reuse the pooling and prediction layers from the ResNet50 model
    x = model.get_layer(layer_name)(x)

# Create a new model that takes in the last conv layer output and returns predictions
classifier_model = tf.keras.Model(classifier_input, x)

# Use a GradientTape to record operations for automatic differentiation
with tf.GradientTape() as tape:
    # Prepare the input image and get the activations from the last conv layer
    inputs = image[np.newaxis, ...]
    last_conv_layer_output = last_conv_layer_model(inputs)
    tape.watch(last_conv_layer_output)  # Watch the conv layer output
    # Get predictions from the classifier model
    preds = classifier_model(last_conv_layer_output)
    # Get the index of the highest predicted class
    top_pred_index = tf.argmax(preds[0])
    # Focus on the prediction of the top class
    top_class_channel = preds[:, top_pred_index]

# Compute the gradient of the top predicted class with respect to the conv layer output
grads = tape.gradient(top_class_channel, last_conv_layer_output)

# Average the gradients over the width and height dimensions
pooled_grads = tf.reduce_mean(grads, axis=(0, 1, 2))

# Multiply each channel in the conv layer output by its corresponding gradient
last_conv_layer_output = last_conv_layer_output.numpy()[0]
pooled_grads = pooled_grads.numpy()
for i in range(pooled_grads.shape[-1]):
    last_conv_layer_output[:, :, i] *= pooled_grads[I]

# Compute the Grad-CAM by averaging the channels and apply a ReLU activation
gradcam = np.mean(last_conv_layer_output, axis=-1)

# Normalize the Grad-CAM to be between 0 and 1
gradcam = np.clip(gradcam, 0, np.max(gradcam)) / np.max(gradcam)

# Resize the Grad-CAM heatmap to the size of the original image (224x224)
gradcam = cv2.resize(gradcam, (224, 224))
Memang banyak, tetapi kini Anda akhirnya dapat memplot heatmap yang dihasilkan algoritme Grad-CAM:
plt.grid(False)
plt.imshow(gradcam)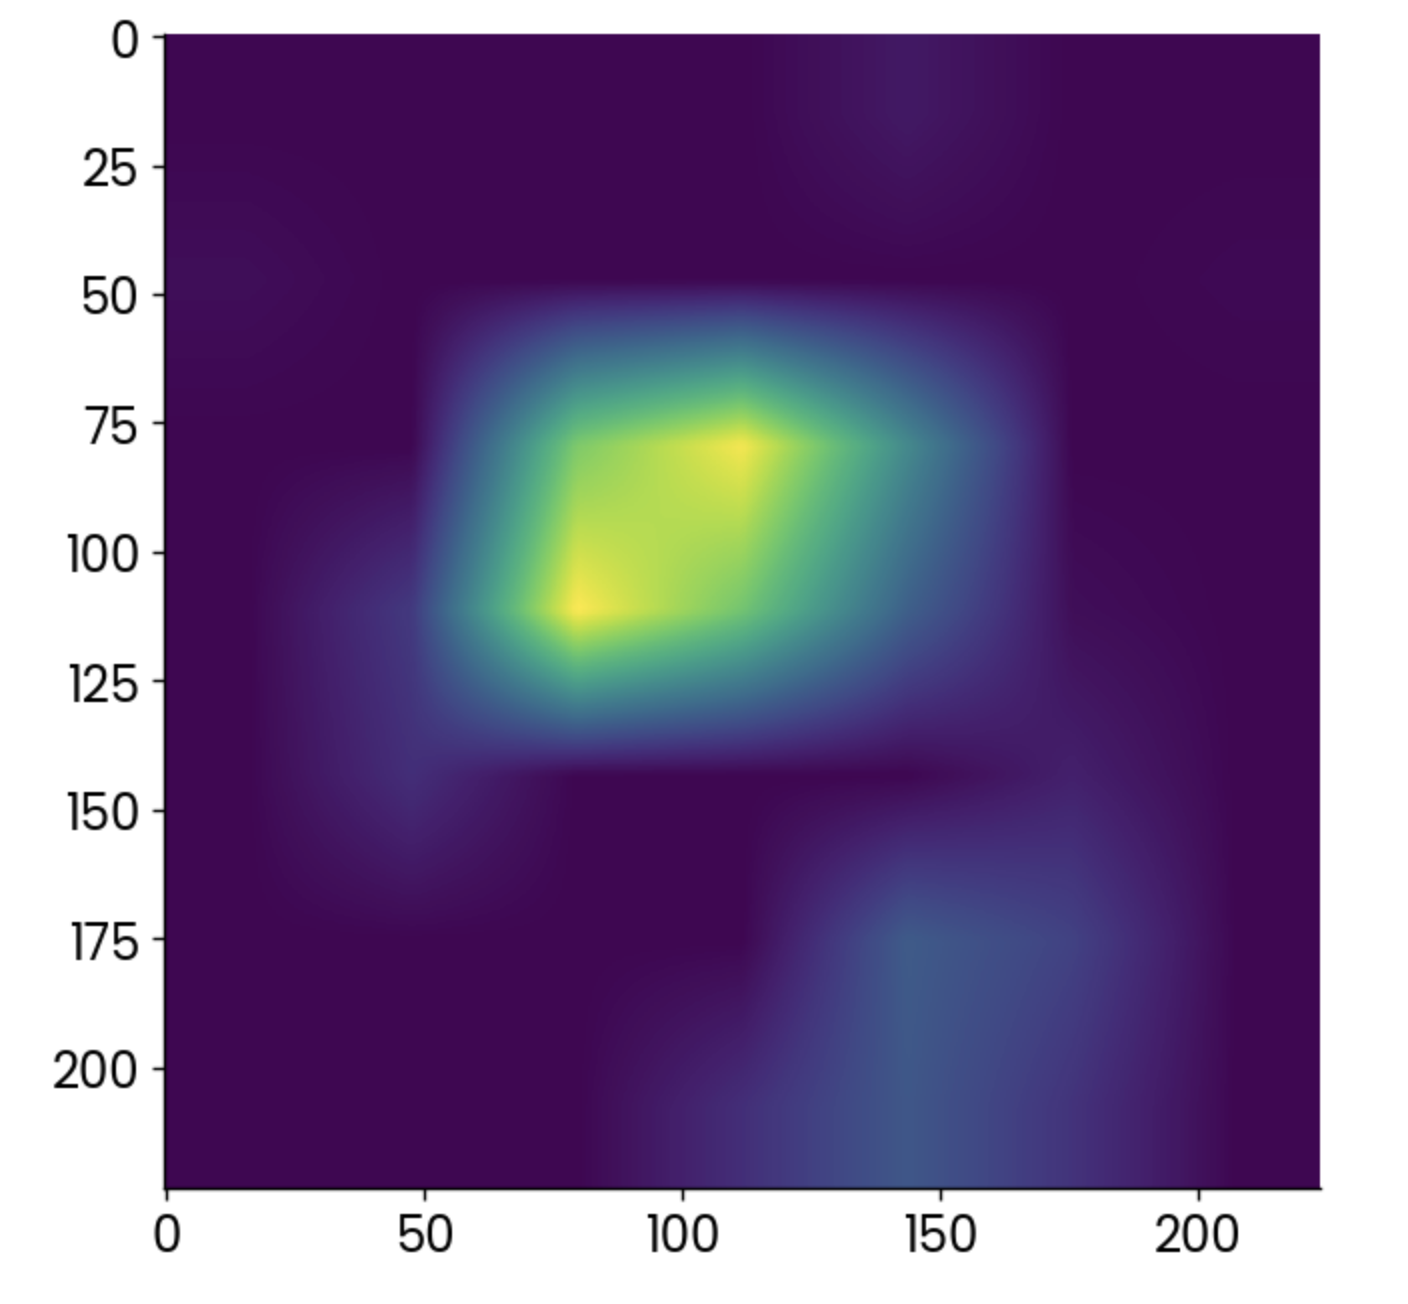
Heatmap Grad-CAM. Gambar oleh Penulis.
Titik yang lebih terang menunjukkan area dengan aktivasi tertinggi, tetapi heatmap saja tidak banyak bercerita.
Jauh lebih baik menindihkannya di atas gambar asli dan sedikit mengurangi opasitasnya:
plt.grid(False)
plt.imshow(image)
plt.imshow(gradcam, alpha=0.5)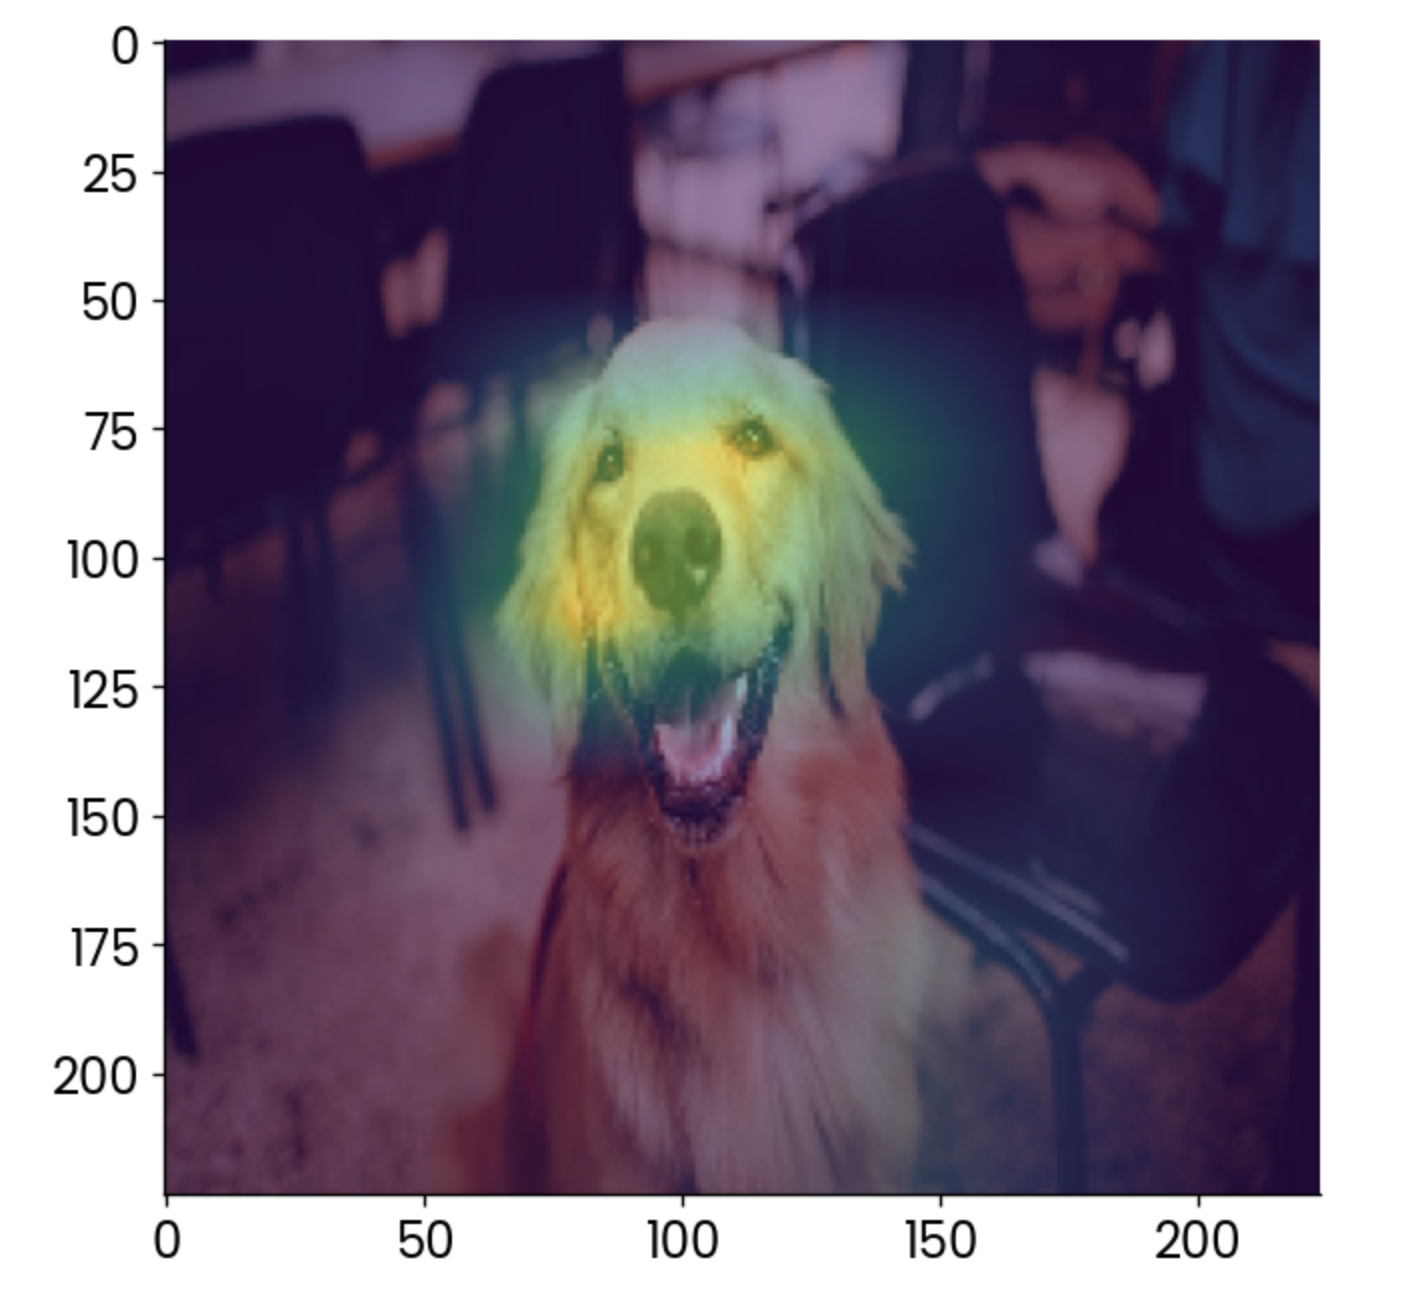
Gambar anjing dengan overlay grad-CAM. Gambar oleh Penulis.
Untuk diinterpretasikan, faktor paling berkontribusi sehingga gambar ini diklasifikasi sebagai “golden retriever” adalah area wajah, yang memang masuk akal.
Anda bisa menggunakan Grad-CAM untuk memastikan model membuat prediksi dengan cara yang tepat. Dalam kasus ini, bayangkan heatmap justru menyoroti objek lain, seperti kursi di latar belakang, sebagai faktor paling berkontribusi. Anda tentu tidak akan mempercayai model tersebut, bukan?
Melatih model neural network bisa memakan waktu lama. Kabar baiknya, Anda tidak perlu menunggu pelatihan selesai untuk melihat gambaran kinerja model. Pustaka seperti TensorBoard bisa menampilkannya secara real-time.
TensorBoard sudah disertakan dalam TensorFlow, jadi Anda tidak perlu memasang apa pun untuk mengikuti.
Untuk demonstrasi, saya akan melatih model pengklasifikasi digit dasar selama 25 epoch. Bagian pentingnya adalah callback—di sana Anda menentukan path dan format log pelatihan, yang akan digunakan TensorBoard sebentar lagi.
Ini kode yang Anda perlukan untuk melatih model dan menyimpan log pelatihan:
import tensorflow as tf
from tensorflow.keras import layers, models
from datetime import datetime

# Load MNIST dataset
mnist = tf.keras.datasets.mnist
(x_train, y_train), (x_test, y_test) = mnist.load_data()

# Normalize pixel values between 0 and 1
x_train, x_test = x_train / 255.0, x_test / 255.0

# Add a channels dimension (for the Convolutional layer)
x_train = np.expand_dims(x_train, -1)
x_test = np.expand_dims(x_test, -1)

# Build a simple CNN model
model = models.Sequential([
    layers.Conv2D(32, kernel_size=(3, 3), activation="relu", input_shape=(28, 28, 1)),
    layers.MaxPooling2D(pool_size=(2, 2)),
    layers.Flatten(),
    layers.Dense(128, activation="relu"),
    layers.Dense(10, activation="softmax")
])

# Compile the model
model.compile(
    optimizer="adam",
    loss="sparse_categorical_crossentropy",
    metrics=["accuracy"]
)

# Set up TensorBoard callback
log_dir = "logs/fit/" + datetime.now().strftime("%Y%m%d-%H%M%S")
tensorboard_callback = tf.keras.callbacks.TensorBoard(log_dir=log_dir, histogram_freq=1)

# Train the model with TensorBoard monitoring
model.fit(
    x_train,
    y_train,
    epochs=25,
    validation_data=(x_test, y_test),
    callbacks=[tensorboard_callback]
)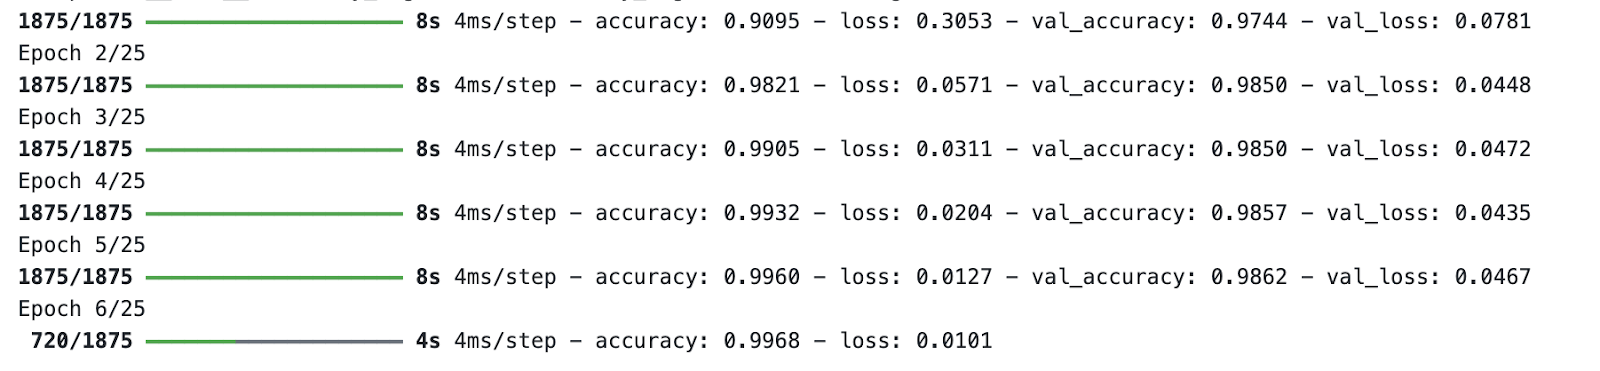
Proses pelatihan model. Gambar oleh Penulis.
Saat model sedang dilatih, jalankan TensorBoard dari terminal dan tentukan path ke folder log pelatihan:
tensorboard --logdir=logs/fitTensorBoard akan berjalan di port 6006 secara default:
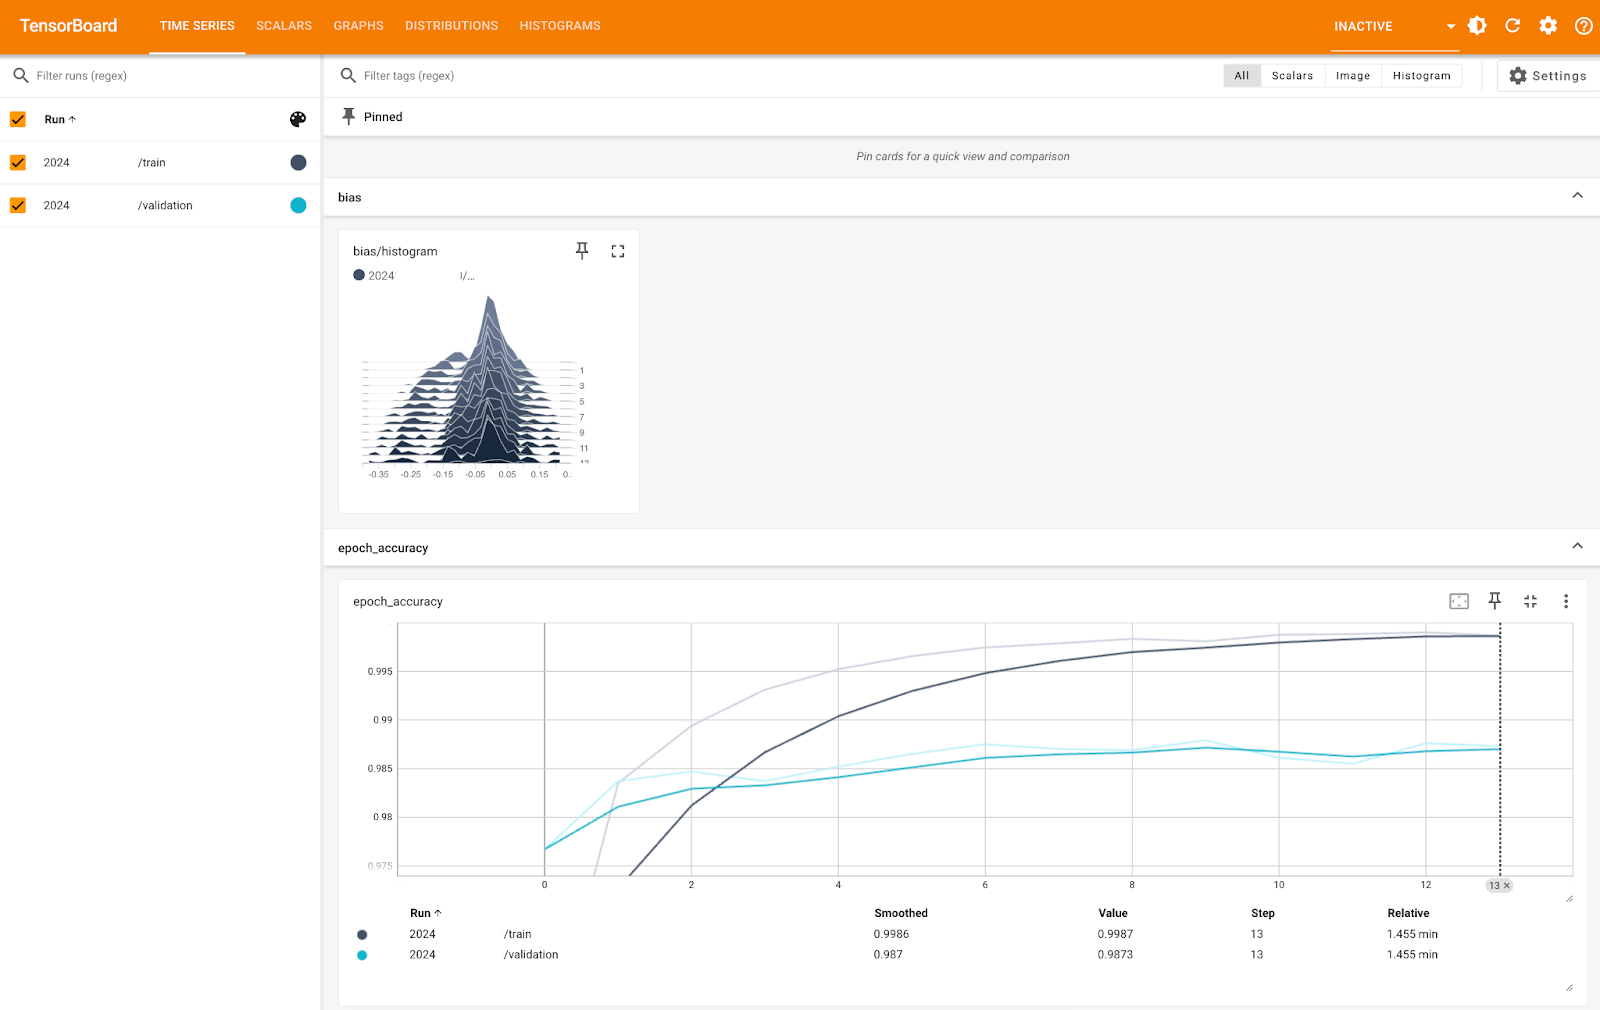
Metrik TensorBoard (1). Gambar oleh Penulis.
Gambar di atas menampilkan histogram bias dan akurasi per epoch, baik untuk set pelatihan maupun validasi. Anda dapat melihat akurasinya sangat tinggi untuk keduanya, mendekati 100% — hanya skala sumbu Y yang terlalu kecil.
Tab lain akan menampilkan metrik yang lebih spesifik dan memungkinkan Anda menyetel hal-hal tertentu, seperti terlihat di bawah:
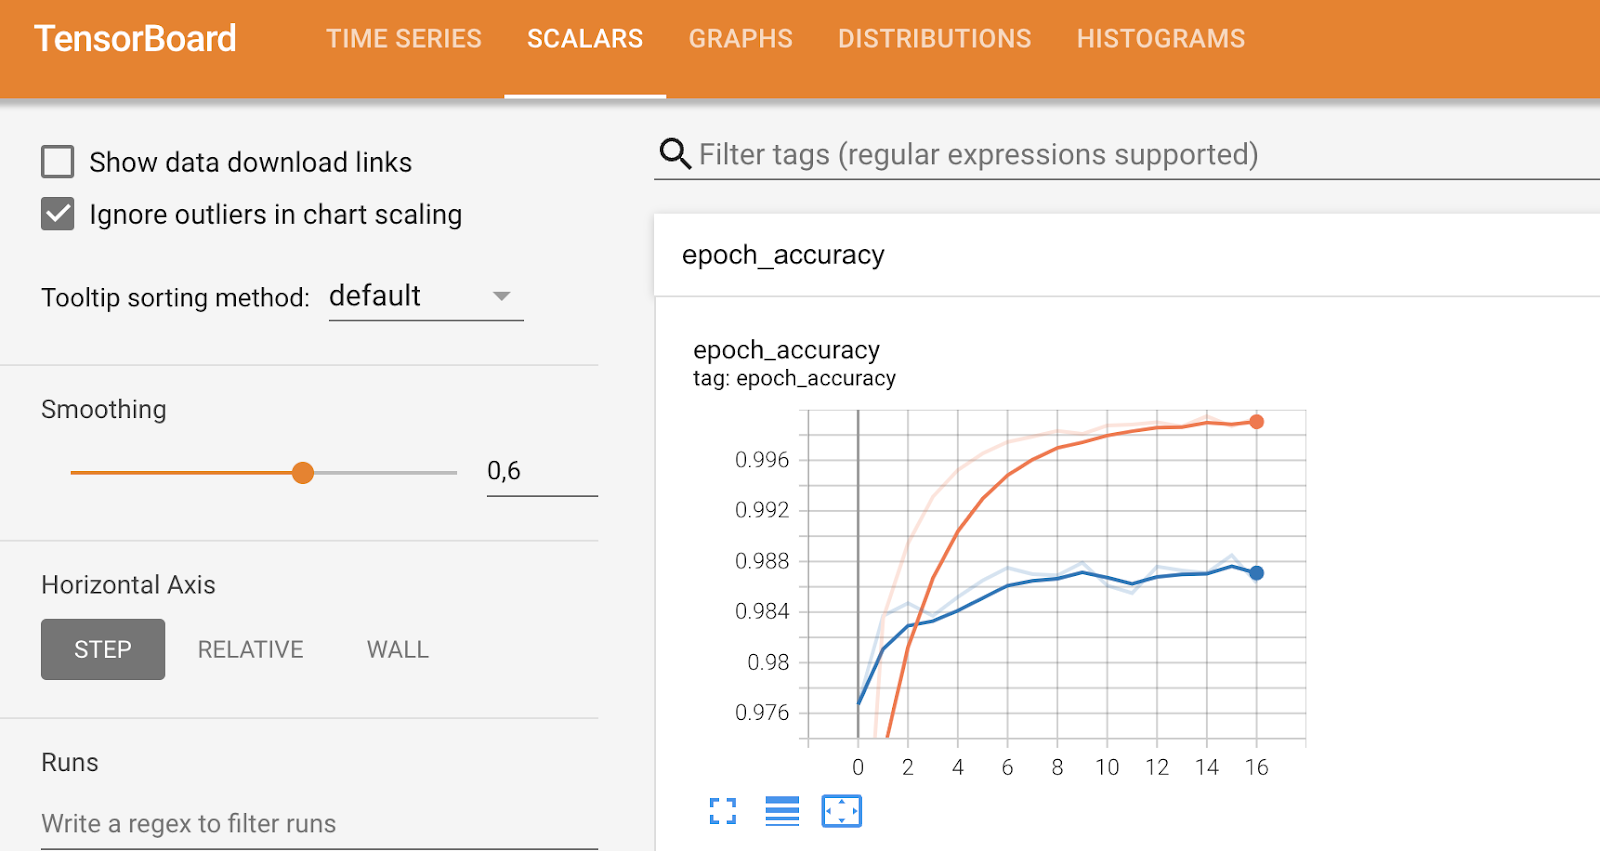
Metrik TensorBoard (2). Gambar oleh Penulis.
Sebagai penutup, TensorBoard adalah alat visualisasi kinerja model yang rapi dan dapat membantu Anda menganalisis performa saat model sedang dilatih.
Di bagian terakhir ini, saya ingin mundur selangkah dan membahas metrik yang lebih umum untuk memvisualisasikan kinerja model.
Anda akan melihat tiga di antaranya: confusion matrix, plot kurva ROC, dan plot kurva Precision-Recall.
Karena terkait dengan masalah klasifikasi, Anda harus memuat dataset MBA. Untuk memudahkan, saya juga mengubahnya menjadi masalah klasifikasi biner dengan mengatur entri daftar tunggu sebagai ditolak. Sisa cuplikan kode membagi data menjadi subset pelatihan dan pengujian dan memasangkan model klasifikasi random forest:
from sklearn.ensemble import RandomForestClassifier

df = load_classification_dataset()
df["admission"] = df["admission"].replace({"Waitlist": "Deny"})
df["admission"] = df["admission"].replace({"Deny": 0, "Admit": 1})
df.rename(columns={"admission": "is_admitted"}, inplace=True)
X = df.drop("is_admitted", axis=1)
y = df["is_admitted"]
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.25, random_state=42)
random_forest = RandomForestClassifier(n_estimators=25, random_state=42)
random_forest.fit(X_train, y_train)
Mari masuk ke metrik pertama — confusion matrix.
Confusion matrix memberi tahu Anda seberapa baik performa model. Dalam skenario ideal, nilai pada diagonal dari kiri atas ke kanan bawah adalah satu-satunya elemen non-nol, menunjukkan model tidak membuat prediksi salah.
Namun itu jarang terjadi di dunia nyata.
Gunakan pedoman berikut untuk menafsirkan confusion matrix (untuk klasifikasi biner):
Tidak ada aturan umum apakah Anda harus lebih peduli pada false positive atau false negative. Yang pertama lebih merugikan pada kasus penerimaan MBA karena model mengklasifikasikan mahasiswa sebagai diterima, padahal nyatanya tidak. Pada kasus lain, seperti deteksi kanker, sangat penting meminimalkan false negative, karena Anda tidak ingin menyatakan seseorang sehat padahal mengidap kanker.
Di sinilah pengetahuan domain berperan.
Kembali ke kode. Cuplikan berikut menghitung confusion matrix dari model random forest pada set uji dan menggunakan kelas ConfusionMatrixDisplay untuk membuat visualisasi:
from sklearn.metrics import confusion_matrix
from sklearn.metrics import confusion_matrix, ConfusionMatrixDisplay

preds = random_forest.predict(X_test)
cm = confusion_matrix(y_true=y_test, y_pred=preds, labels=random_forest.classes_)
disp = ConfusionMatrixDisplay(confusion_matrix=cm, display_labels=random_forest.classes_)
disp.plot()
plt.grid(False)
plt.title("Confusion Matrix", y=1.04)
plt.show()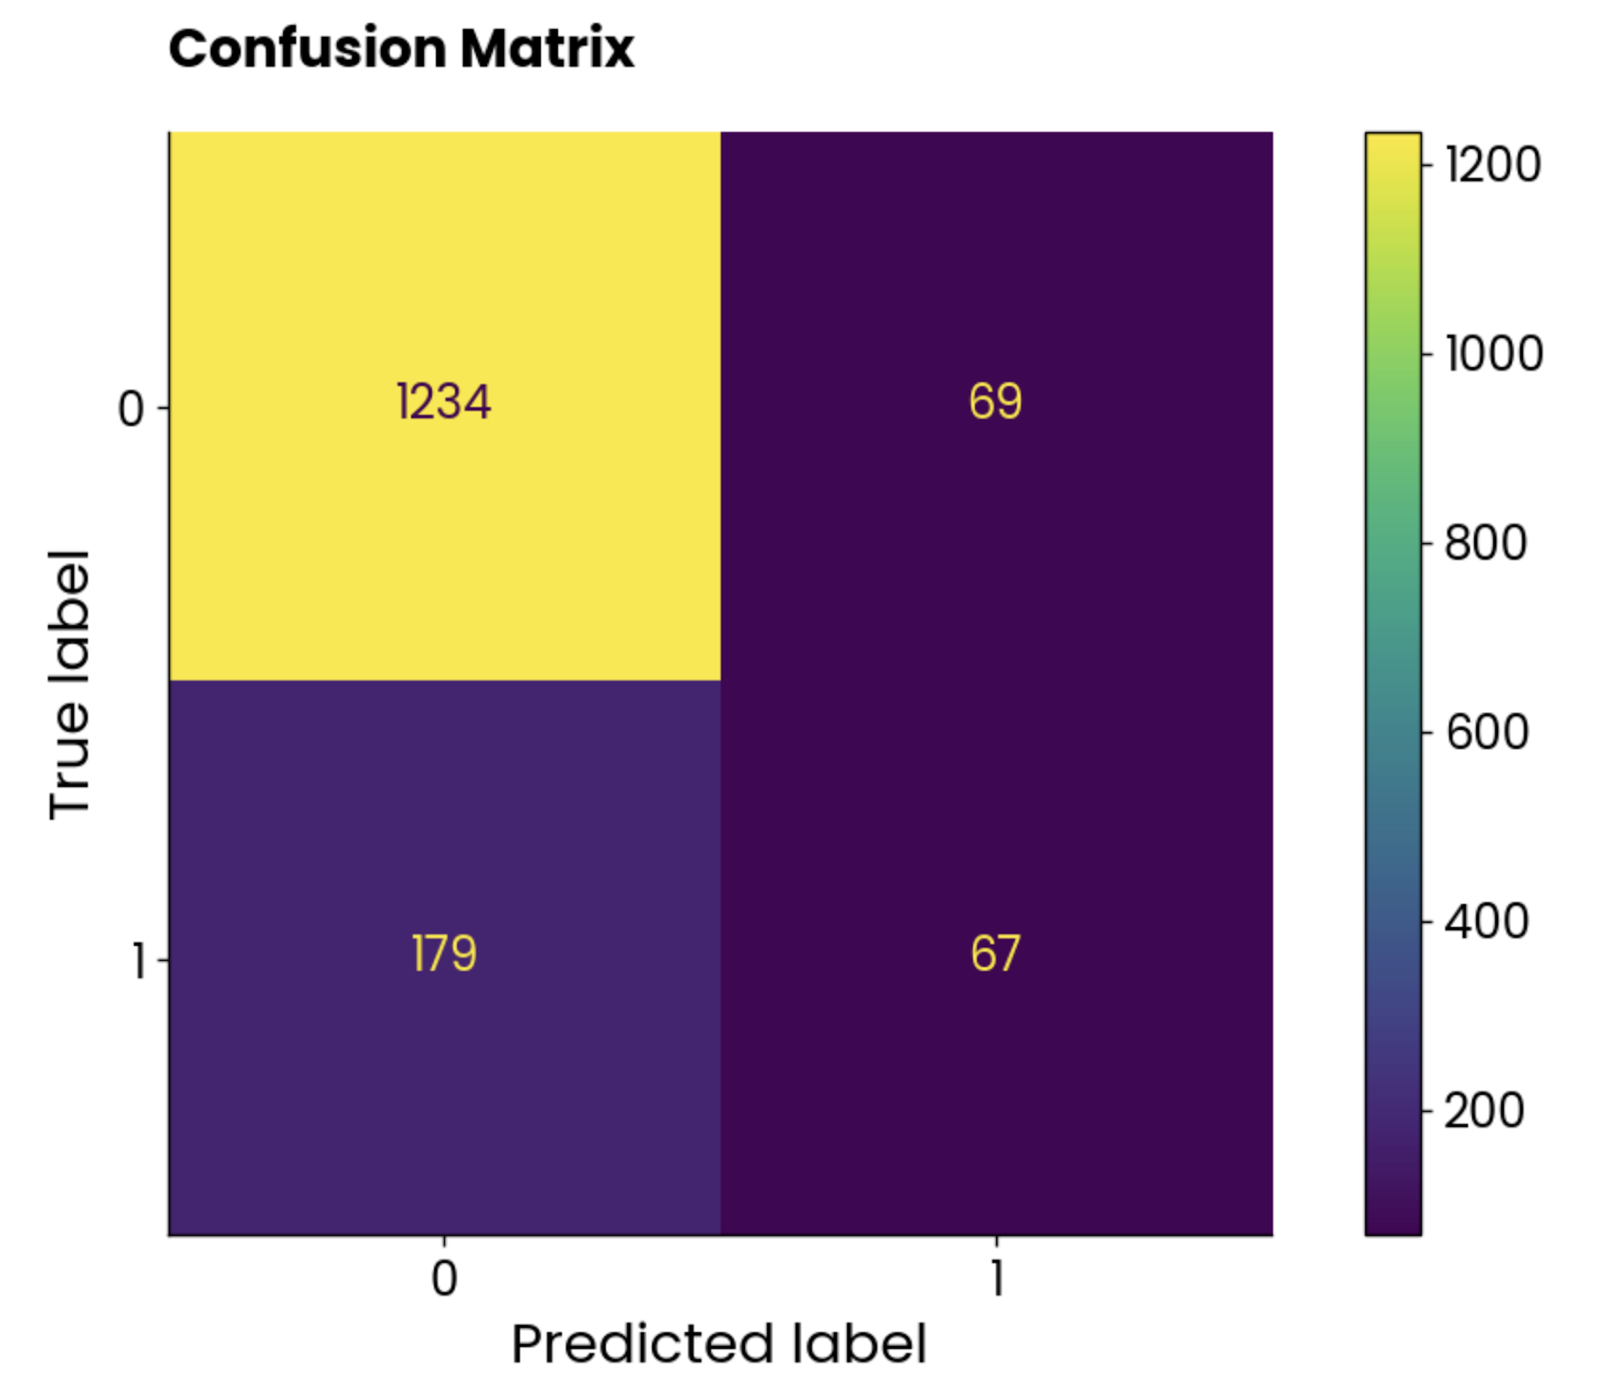
Plot confusion matrix. Gambar oleh Penulis.
Kelasnya tidak seimbang, tetapi jumlah prediksi yang salah sangat tinggi.
Mari lihat apa kata kurva ROC.
ROC adalah singkatan dari Receiver Operating Characteristics, dan merupakan kurva yang menampilkan evaluasi kinerja model klasifikasi biner. Untuk klasifikasi multi-kelas, Anda harus membandingkan dua kelas sekaligus.
Kurva ROC menunjukkan pertukaran antara true positive rate (TPR, sensitivitas, recall) dan false positive rate (FPR) pada berbagai ambang klasifikasi. TPR diplot pada sumbu Y dan FPR pada sumbu X. Setiap titik merepresentasikan ambang berbeda untuk keputusan klasifikasi (skor probabilitas yang digunakan untuk mengklasifikasikan sebuah instance sebagai positif atau negatif).
Kurva biasanya diplot terhadap diagonal dari (0, 0) ke (1, 1), yang merepresentasikan pengklasifikasi acak.
Jika kurva berada di atas diagonal, berarti model Anda lebih baik dari pengklasifikasi acak. Ada satu nilai skalar untuk meringkasnya, disebut AUC (Area Under the Curve) dengan rentang 0 hingga 1, semakin tinggi semakin baik dan 0,5 berarti acak.
Singkatnya, Anda ingin kurva sedekat mungkin dengan sudut kiri atas.
Gunakan cuplikan berikut untuk menghitung ROC dan AUC serta memplot kurvanya:
from sklearn.metrics import roc_curve, auc

# Get predicted probabilities for the positive class
y_probs = random_forest.predict_proba(X_test)[:, 1]
fpr, tpr, roc_thresholds = roc_curve(y_test, y_probs)
roc_auc = auc(fpr, tpr)
plt.plot(fpr, tpr, label=f"AUC = {roc_auc:.2f}")
plt.plot([0, 1], [0, 1], color="navy", linestyle="--")
plt.xlim([0.0, 1.0])
plt.ylim([0.0, 1.05])
plt.xlabel("False Positive Rate")
plt.ylabel("True Positive Rate")
plt.title("ROC Curve", y=1.04)
plt.legend(loc="lower right")
plt.show()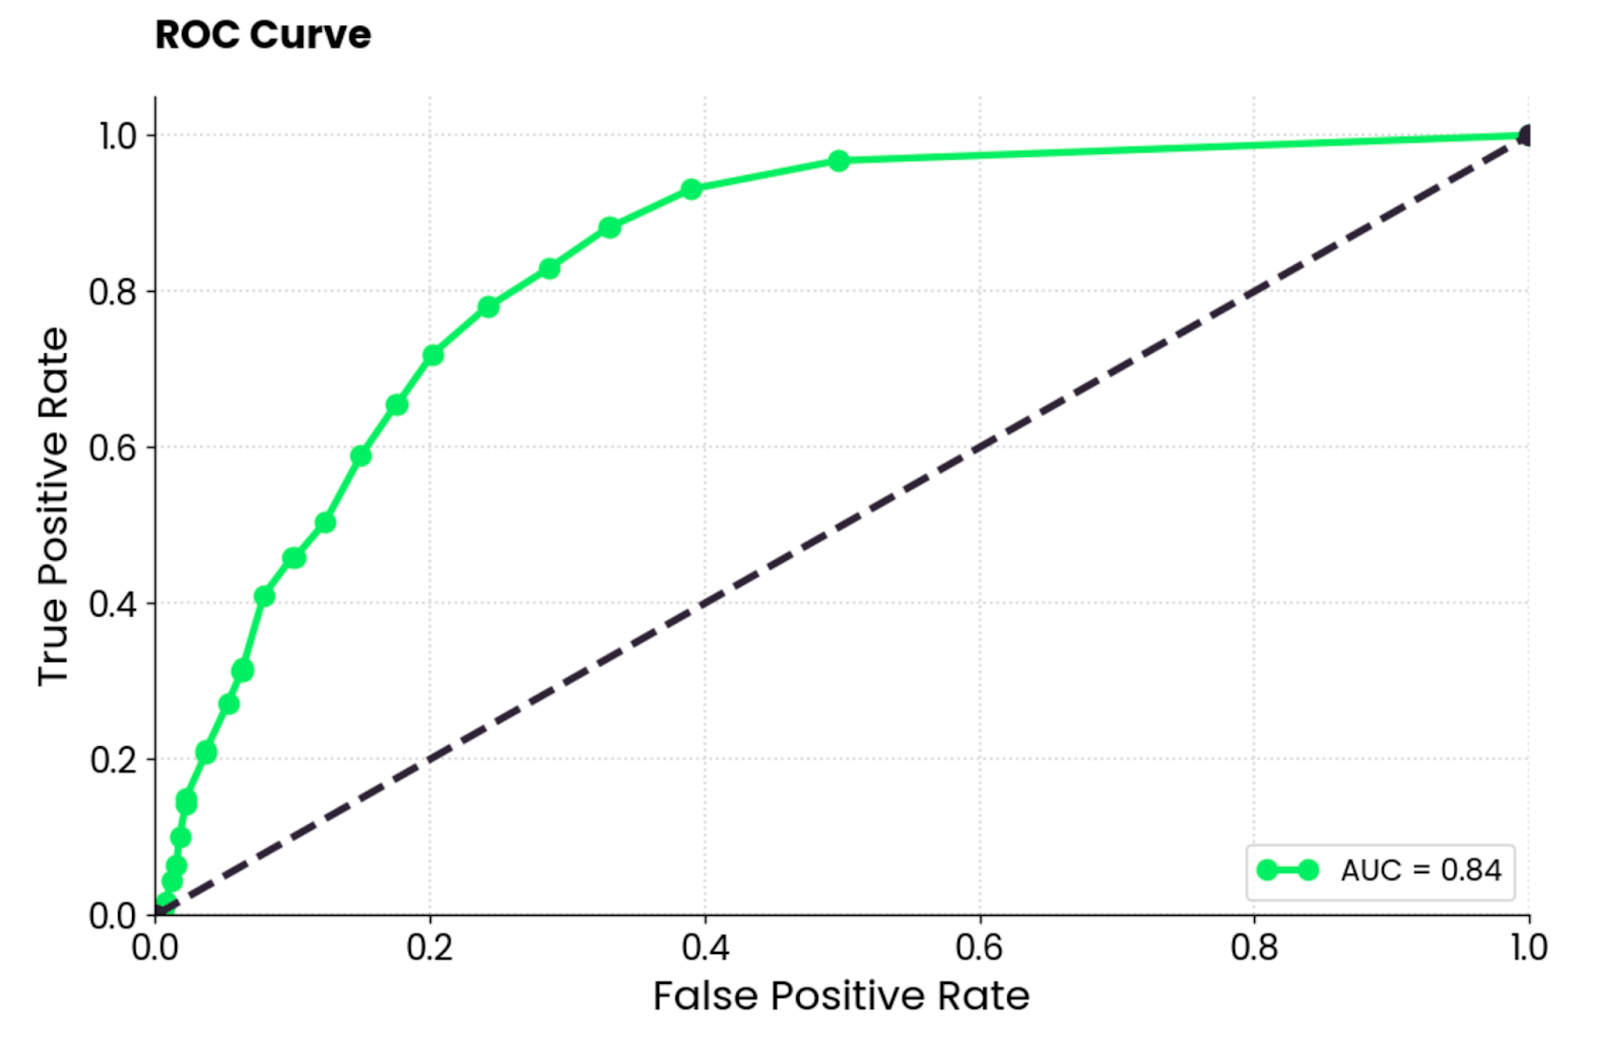
Plot kurva ROC. Gambar oleh Penulis.
Untuk diinterpretasikan, model random forest jauh lebih baik daripada pengklasifikasi acak dan memiliki keseimbangan yang wajar antara true positive dan false positive. Masih ada tingkat misklasifikasi, dan Anda harus berupaya mengangkat kurva ke atas dan ke kiri dengan mengoptimalkan data atau memilih model machine learning lain.
Kurva ini mirip dengan ROC tetapi menunjukkan pertukaran antara precision dan recall pada ambang klasifikasi yang berbeda. Kurva ini menampilkan precision pada sumbu Y dan recall pada sumbu X dan biasanya lebih disukai daripada ROC saat kelas tidak seimbang.
Itu terjadi pada dataset penerimaan MBA, jadi kurva PR terasa cocok!
Perlu dicatat bahwa kurva precision-recall hanya berfokus pada kelas minoritas dan memberikan gambaran yang lebih baik tentang seberapa baik model mengidentifikasi instance yang paling penting (mahasiswa yang diterima, kanker yang terdeteksi, dan seterusnya).
Gunakan cuplikan berikut untuk menghitung nilai precision dan recall serta memplotnya pada grafik:
from sklearn.metrics import precision_recall_curve

# Get predicted probabilities for the positive class
y_probs = random_forest.predict_proba(X_test)[:, 1]

# Precision-Recall curve
precision, recall, pr_thresholds = precision_recall_curve(y_test, y_probs)
pr_auc = auc(recall, precision)
plt.plot(recall, precision, label=f"(AUC = {pr_auc:.2f})")
plt.xlabel("Recall")
plt.ylabel("Precision")
plt.title("Precision-Recall Curve", y=1.04)
plt.legend(loc="lower left")
plt.show()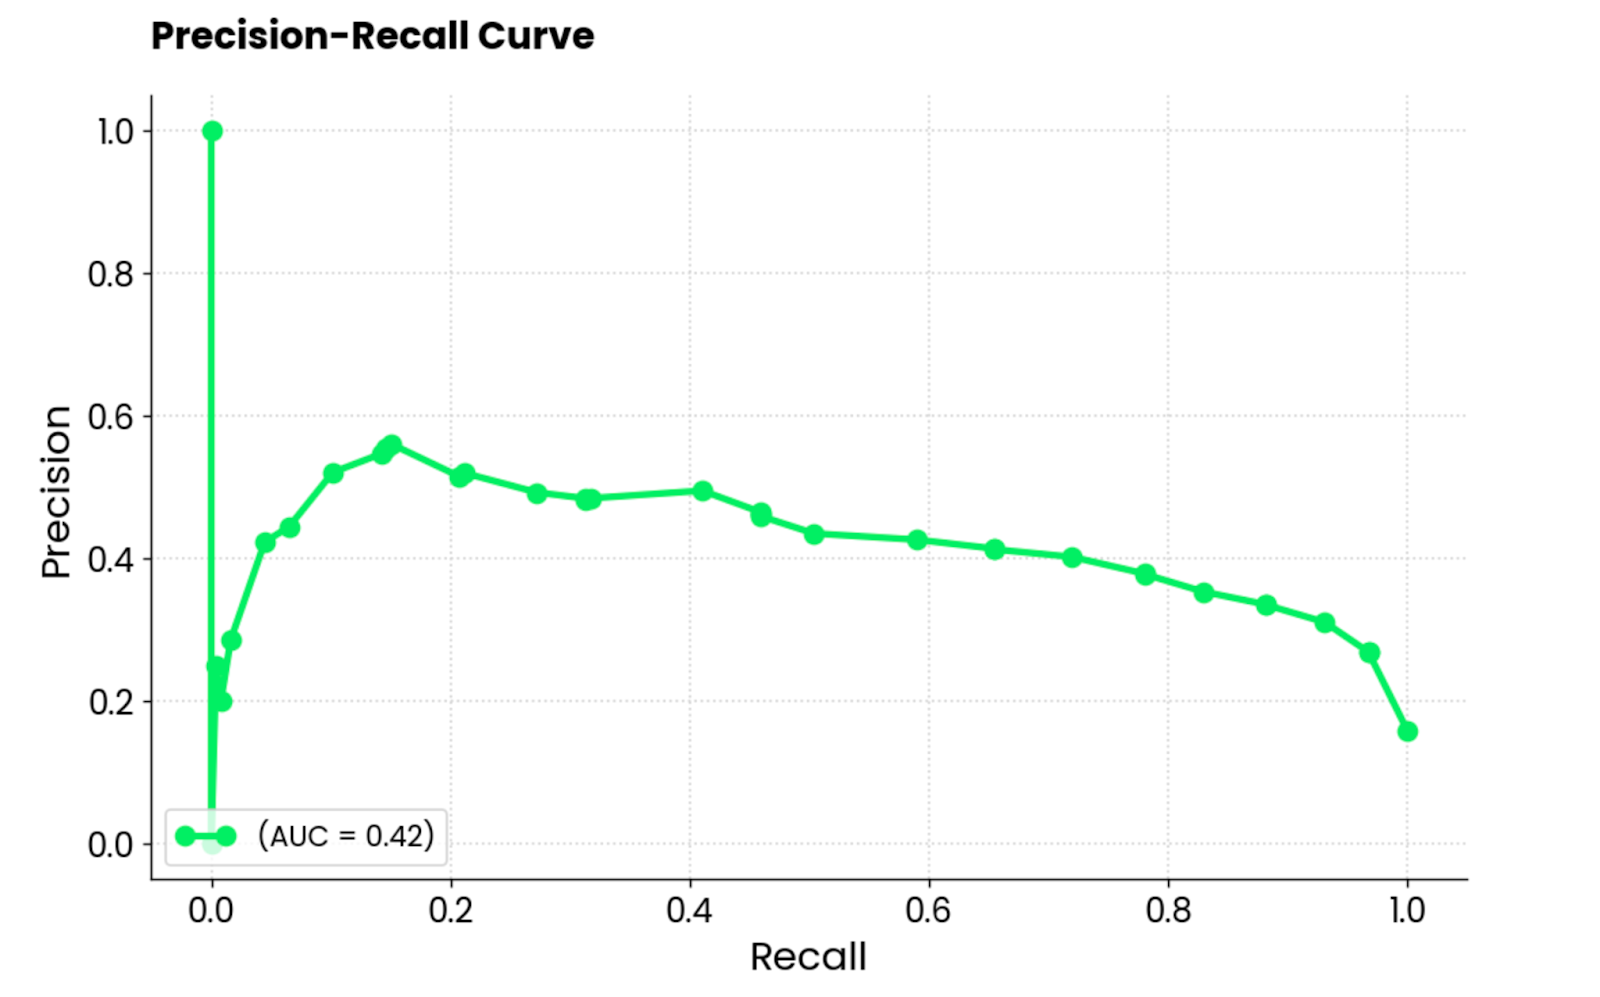
Plot kurva precision-recall. Gambar oleh Penulis.
Untuk diinterpretasikan, model berkinerja buruk, ditunjukkan oleh skor AUC 0,42. Saat model mencoba meningkatkan recall, ia mengorbankan terlalu banyak precision, sehingga banyak false positive. Singkatnya, model ini tidak cocok untuk dataset ini, atau datasetnya belum dipra-proses dengan baik.
Sebagai kesimpulan, bidang machine learning itu kompleks dan sering tidak intuitif. Jika Anda pemula, Anda akan kesulitan memahami gagasan besarnya. Jika Anda bekerja dengan klien bisnis, kemungkinan mereka tidak memahami jargon teknis.
Visualisasi data membantu menjembatani kesenjangan pada kedua skenario.
Hari ini, Anda telah melihat berbagai jenis grafik yang dapat digunakan untuk memvisualisasikan model regresi dan klasifikasi, serta proses pengambilan keputusan neural network dan interpretasi prediksi tunggal melalui SHAP dan LIME. Ini banyak untuk dicerna, jadi silakan kunjungi kembali artikel ini beberapa kali!
Jika Anda benar-benar baru dalam topik ini, kami sarankan menonton kursus fundamental machine learning kami untuk memulai. Setelah itu, kursus yang lebih terapan dengan Python adalah pilihan yang tepat.
Jika Anda sudah punya pengalaman tetapi belum memahami cara kerjanya dalam skala besar, kami mendorong Anda mencoba kursus machine learning untuk produksi kami.
Pelajari lebih lanjut tentang machine learning dengan kursus-kursus ini!
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



