

Các thư viện Python để trực quan hóa mô hình Machine Learning
Trong phần ngắn này, tôi sẽ hướng dẫn bạn cách cài đặt các phụ thuộc ở cấp hệ thống và các thư viện Python cần thiết để trực quan hóa mô hình machine learning.
Graphviz
Phụ thuộc duy nhất ở cấp hệ thống bạn cần để theo dõi là Graphviz. Bạn sẽ dùng nó sau để trực quan hóa cây quyết định, và mã sẽ không chạy nếu chưa cài đặt Graphviz.
Đây là phần mềm mã nguồn mở dùng để tạo sơ đồ, đồ thị trừu tượng và mạng. Bạn sẽ không dùng trực tiếp; mà thông qua scikit-Learn.
scikit-learn
Thư viện Python này được dùng rộng rãi cho các tác vụ machine learning trong Python.
Trong bài viết này, bạn sẽ dùng nó để huấn luyện mô hình machine learning, tách tập dữ liệu, chuẩn hóa đặc trưng số, và trực quan hóa hiệu năng mô hình. Đây là thư viện bắt buộc phải có, nên hãy cài bằng lệnh sau (tùy môi trường Python của bạn):
pip install scikit-learn
conda install scikit-learnNếu bạn hoàn toàn mới với scikit-learn, chúng tôi khuyến nghị xem khóa học về học có giám sát với scikit-learn đang rất được ưa chuộng của chúng tôi.
SHAP (SHapely Additive exPlanations)
Thư viện SHAP trong Python là công cụ phổ biến để giải thích dự đoán của các mô hình machine learning. Nó tận dụng các khái niệm lý thuyết trò chơi (ví dụ, giá trị Shapley) để đo lường mức đóng góp của từng thuộc tính vào dự đoán của mô hình.
Thậm chí hay hơn, nó đi kèm nhiều trực quan hóa hữu ích giúp bạn hiểu cách mô hình vận hành bên trong.
Cài đặt bằng lệnh sau:
pip install shap
conda install -c conda-forge shapLIME (Local Interpretable Model-agnostic Explanations)
Thư viện Python này được nhiều người dùng khi việc giải thích một dự đoán đơn lẻ của mô hình là quan trọng. Cách hoạt động của nó khác SHAP. Nó xấp xỉ mô hình gốc một cách cục bộ bằng một mô hình đơn giản, dễ diễn giải. Sau đó, nó hiển thị mức đóng góp của từng đặc trưng dữ liệu vào dự đoán.
Bạn sẽ thấy LIME hoạt động thế nào ngay sau đây, nhưng trước hết, hãy cài đặt nó:
pip install lime
conda install conda-forge::limeTensorBoard
Nếu bạn xây dựng các mô hình mạng nơ-ron với TensorFlow, thì TensorBoard là lựa chọn không cần đắn đo.
Đây là công cụ trực quan hóa giúp bạn theo dõi các thí nghiệm machine learning và giám sát các chỉ số huấn luyện (ví dụ, loss và accuracy). Nó trực quan hóa và cập nhật đồ thị mô hình theo thời gian thực và cho thấy tham số mô hình thay đổi ra sao trong quá trình huấn luyện.
TensorBoard có thể dùng với các framework học sâu khác như PyTorch, nhưng trong bài này tôi sẽ tập trung vào TensorFlow.
Cài đặt bằng cách chạy lệnh sau:
pip install tensorboard
conda install -c conda-forge tensorboardTập dữ liệu và Tiền xử lý dữ liệu
Bước cuối cùng trong giai đoạn chuẩn bị là xử lý dữ liệu.
Hôm nay tôi sẽ dùng hai tập dữ liệu: MBA admissions cho phân loại và Insurance cho hồi quy. Cả hai đều miễn phí và có sẵn để tải về trên Kaggle.
Để bắt đầu, hãy import các thư viện Python này:
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.preprocessing import StandardScaler
from sklearn.model_selection import train_test_splitTập dữ liệu phân loại
Với tập dữ liệu phân loại, tiền xử lý tôi thực hiện là tối thiểu. Tóm gọn lại gồm:
- Loại bỏ cột thứ tự
- Điền giá trị thiếu
- Chuyển các cột có hai hạng mục thành kiểu boolean
- Tạo cột giả (dummy) cho các đặc trưng có nhiều hạng mục
Đây không phải là một pipeline tiền xử lý dữ liệu toàn diện. Nếu có thời gian, bạn cứ thoải mái cải thiện thêm.
Dẫu vậy, hãy sao chép hàm này để chuẩn bị tập dữ liệu phân loại:
def load_classification_dataset() -> pd.DataFrame:
# https://www.kaggle.com/datasets/taweilo/mba-admission-dataset?resource=download
df = pd.read_csv("MBA.csv")
# Just an arbitrary ID
df = df.drop(["application_id"], axis=1)
# Fill unknown
df["race"] = df["race"].fillna("Unknown")
# Assume these are denied
df["admission"] = df["admission"].fillna("Deny")
# Convert boolean cols to 0/1
df["gender"] = df["gender"].replace({"Male": 0, "Female": 1})
df["international"] = df["international"].replace({False: 0, True: 1})
# Create dummy columns for categorical features
cols_for_dummy = ["major", "race", "work_industry"]
for col in cols_for_dummy:
dummies = pd.get_dummies(df[col], prefix=col)
df = pd.concat([df, dummies], axis=1)
# To drop
cols_to_drop = ["major", "race", "work_industry", "major_Humanities", "race_Unknown", "work_industry_Other"]
df = df.drop(cols_to_drop, axis=1)
return df
load_classification_dataset().sample(5)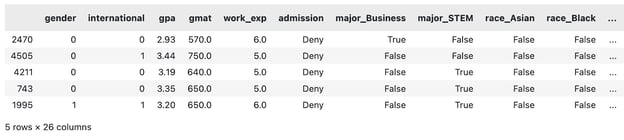
Một mẫu của tập dữ liệu MBA đã được chỉnh sửa. Ảnh: Tác giả.
Tiếp theo, tôi sẽ làm tương tự cho tập dữ liệu hồi quy.
Tập dữ liệu hồi quy
Tập dữ liệu hồi quy được chọn chứa một khoản phí bảo hiểm ($) là đặc trưng liên tục mà mô hình machine learning sẽ cố gắng dự đoán dựa trên các thuộc tính khác.
Việc tiền xử lý dữ liệu tôi thực hiện, một lần nữa, khá tối giản. Tóm gọn lại gồm:
- Chuẩn hóa các đặc trưng số (trung bình bằng 0, độ lệch chuẩn bằng 1)
- Chuyển các cột có hai hạng mục thành thuộc tính nhị phân
- Tạo cột giả (dummy) cho các đặc trưng có nhiều hạng mục
Nếu có thời gian, bạn cứ thoải mái bổ sung thêm bước cho pipeline.
Sao chép hàm sau để tải và tiền xử lý tập dữ liệu bảo hiểm:
def load_regression_dataset() -> pd.DataFrame:
# https://www.kaggle.com/datasets/mirichoi0218/insurance
df = pd.read_csv("MedicalCostPersonal.csv")
# Scale numerical features
cols_to_scale = ["age", "bmi", "children"]
scaler = StandardScaler()
df[cols_to_scale] = scaler.fit_transform(df[cols_to_scale])
# Binary features
df["sex"] = df["sex"].replace({"male": 0, "female": 1})
df["smoker"] = df["smoker"].replace({"no": 0, "yes": 1})
# Dummies
dummies_region = pd.get_dummies(df["region"], prefix="region", drop_first=True)
df = pd.concat([df, dummies_region], axis=1)
df = df.drop("region", axis=1)
return df
load_regression_dataset().sample(5)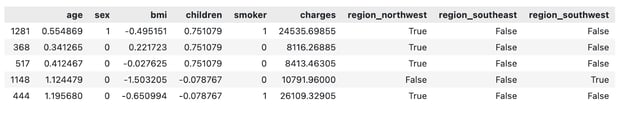
Một mẫu của tập dữ liệu bảo hiểm đã được chỉnh sửa. Ảnh: Tác giả.
Vậy là xong!
Trong phần tiếp theo, tôi sẽ chỉ bạn cách bắt đầu trực quan hóa các mô hình machine learning.
Trực quan hóa các mô hình dựa trên cây
Các mô hình dựa trên cây thường được dùng cho phân loại, nhưng hầu hết cũng có thể xử lý tác vụ hồi quy.
Trong phần này, tôi sẽ chỉ bạn cách trực quan hóa cây quyết định, tầm quan trọng của đặc trưng từ mô hình rừng ngẫu nhiên, và giải thích dự đoán với SHAP và LIME.
Lưu ý rằng các mô hình cây quyết định và rừng ngẫu nhiên có thể khó nắm bắt. Chúng tôi có một khóa học đầy đủ bao quát các nền tảng của mô hình machine learning dựa trên cây trong Python.
Để bắt đầu, hãy tải tập dữ liệu phân loại và chia thành tập huấn luyện và kiểm tra:
df = load_classification_dataset()
X = df.drop("admission", axis=1)
y = df["admission"]
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.25, random_state=42)Tiếp theo, hãy trực quan hóa một cây quyết định!
Cây quyết định
Hãy hình dung cây quyết định như một tập hợp các câu lệnh if lồng nhau trong đó các điều kiện được xác định bởi mô hình machine learning.
Còn nhiều điều khác, nhưng với phép so sánh này, bạn có thể thấy việc trực quan hóa các quyết định là khá đơn giản. Và đúng vậy: hàm plot_tree() từ sklearn xử lý phần lớn công việc nặng.
Bắt đầu bằng cách huấn luyện một mô hình cây quyết định. Tham số max_depth là tùy chọn và chỉ nhằm mục đích trực quan hóa. Nếu không giới hạn, cây sẽ quá sâu, và bạn sẽ bị lạc trong số lượng quyết định khổng lồ mà mô hình đưa ra, đặc biệt với các tập dữ liệu lớn.
Đoạn mã sau huấn luyện mô hình phân loại cây quyết định trên tập huấn luyện:
from sklearn import tree
decision_tree = tree.DecisionTreeClassifier(random_state=42, max_depth=4)
decision_tree.fit(X_train, y_train)Và để trực quan hóa, chỉ cần sao chép đoạn mã sau. Các tham số tùy chọn filled và feature_names giúp cây dễ diễn giải hơn:
plt.figure(figsize=(12,8))
tree.plot_tree(decision_tree, filled=True, feature_names=X.columns, class_names=y.unique())
plt.title("Decision Tree Visualization", size=20, loc="left", y=1.04, weight="bold")
plt.show()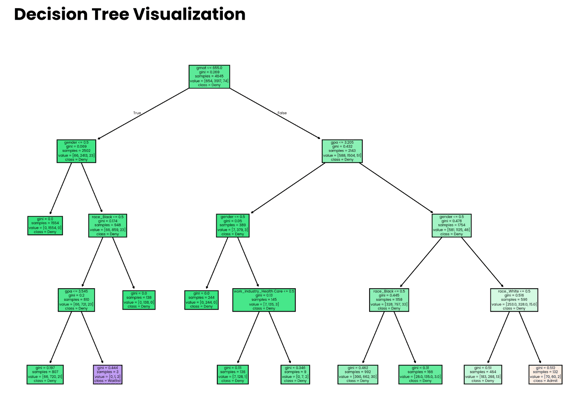
Cây quyết định sâu bốn mức. Ảnh: Tác giả.
Lưu ý rằng các quyết định do mô hình đưa ra không có nhiều ý nghĩa nếu mô hình không chính xác. Ở phần sau của bài, tôi sẽ chỉ bạn cách ước lượng độ chính xác.
Rừng ngẫu nhiên và tầm quan trọng đặc trưng
Nhớ phép ẩn dụ chiếc bánh lúc trước chứ? Đã đến lúc áp dụng vào thực tế.
Mỗi lần bạn huấn luyện mô hình cây với sklearn, bạn có quyền truy cập thuộc tính feature_importances_. Kết hợp điều đó với tên đặc trưng, bạn có đủ dữ liệu để xem thuộc tính nào đóng góp nhiều nhất vào dự đoán.
Hãy xem thực tế! Trước tiên, huấn luyện bộ phân loại rừng ngẫu nhiên trên tập huấn luyện:
from sklearn.ensemble import RandomForestClassifier
random_forest = RandomForestClassifier(n_estimators=25, random_state=42)
random_forest.fit(X_train, y_train)Giờ việc trực quan hóa chỉ còn là trích xuất và sắp xếp tầm quan trọng đặc trưng rồi thay chỉ mục bằng tên đặc trưng:
importances = random_forest.feature_importances_
indices = np.argsort(importances)[::-1]
plt.figure(figsize=(10,6))
bars = plt.bar(range(X.shape[1]), importances[indices], edgecolor="#008031", linewidth=1)
for bar in bars:
height = bar.get_height()
plt.text(bar.get_x() + bar.get_width() / 2, height, f"{height:.2f}", ha="center", va="bottom", size=8)
plt.title("Feature Importances", size=20, loc="left", y=1.04, weight="bold")
plt.ylabel("Importance")
plt.xticks(range(X.shape[1]), np.array(X.columns)[indices], rotation=90, size=12)
plt.show()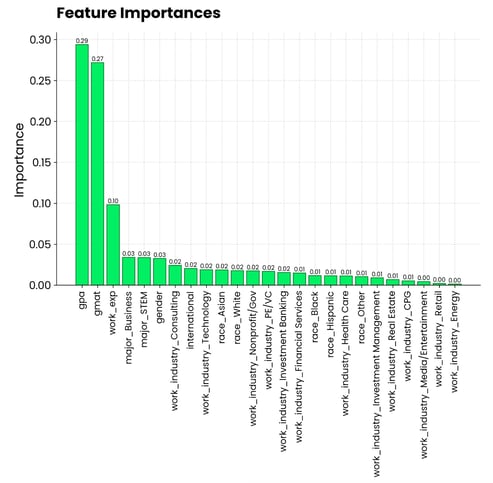
Biểu đồ tầm quan trọng đặc trưng của rừng ngẫu nhiên. Ảnh: Tác giả.
Có vẻ như điểm trung bình theo thang 4.0 và điểm GMAT đóng góp nhiều nhất cho việc được nhận vào chương trình MBA. Theo sau là kinh nghiệm làm việc, vốn là yêu cầu của chương trình MBA. Ngành học và lĩnh vực làm việc lại ít liên quan hơn nhiều.
Tree SHAP
Tầm quan trọng đặc trưng cho cái nhìn tổng quan, nhưng nếu bạn muốn trực quan hóa mô hình machine learning ở mức dự đoán cá nhân thì sao?
Đó là lúc SHAP và LIME phát huy tác dụng. Tôi sẽ bàn về SHAP trước. Bạn đã biết nó là gì, nên tôi sẽ bỏ qua phần lý thuyết.
Tôi sẽ fit một mô hình tăng cường độ dốc vào tập dữ liệu hồi quy để xem tác động của từng đặc trưng lên chi phí bảo hiểm. Đoạn mã dưới đây cho bạn biết cách fit mô hình và tính các giá trị SHAP từ mô hình shap.Explainer():
import shap
from xgboost import XGBRegressor
df = load_regression_dataset()
# No need for train-test splits
X = df.drop("charges", axis=1)
y = df["charges"]
model = XGBRegressor().fit(X, y)
# Shap explainer
explainer = shap.Explainer(model)
shap_values = explainer(X)Với SHAP, có một bộ các biểu đồ bạn có thể tạo.
Tôi sẽ bắt đầu với waterfall() và xem xét các giá trị SHAP cho dự đoán đầu tiên:
shap.plots.waterfall(shap_values[0])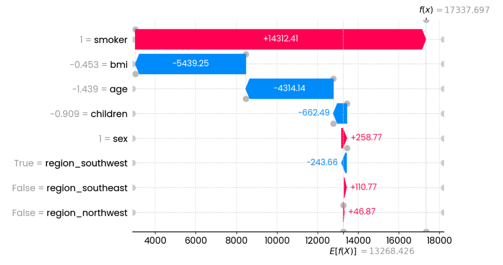
Giải thích cho dự đoán đầu tiên. Ảnh: Tác giả.
Trong trường hợp cụ thể này, việc là người hút thuốc làm tăng mạnh chi phí bảo hiểm. Các đặc trưng có tác động lớn nhất trong việc giảm chi phí là BMI (liên quan đến cân nặng) và tuổi. Các đặc trưng khác có tác động rất nhỏ hoặc không đáng kể.
Bạn có thể biểu diễn biểu đồ trên theo định dạng gọn hơn:
shap.plots.force(shap_values[0])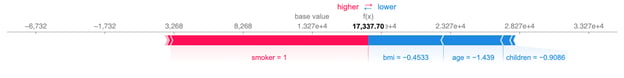
Giải thích ngắn gọn cho dự đoán đầu tiên. Ảnh: Tác giả.
Thông tin vẫn như cũ: các đặc trưng màu đỏ làm tăng chi phí, còn màu xanh làm giảm. Điểm nơi chúng gặp nhau cho thấy chi phí bảo hiểm cho một quan sát đơn lẻ.
Biểu đồ beeswarm cho bạn thấy đặc trưng nào quan trọng nhất bằng cách vẽ giá trị SHAP của mọi đặc trưng cho mọi mẫu. Các đặc trưng được sắp theo tổng độ lớn giá trị SHAP trên tất cả mẫu. Màu sắc thể hiện giá trị đặc trưng (đỏ là cao, xanh là thấp):
shap.plots.beeswarm(shap_values)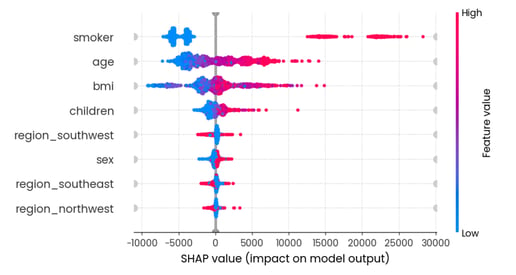
Tổng quan tác động của tất cả đặc trưng. Ảnh: Tác giả.
Diễn giải: là người trẻ, không hút thuốc với BMI hợp lý sẽ làm giảm chi phí bảo hiểm.
Trực quan hóa SHAP cuối cùng tôi muốn giới thiệu là biểu đồ cột giá trị tuyệt đối trung bình. Nó tính giá trị tuyệt đối trung bình của tất cả giá trị SHAP cho từng đặc trưng:
shap.plots.bar(shap_values)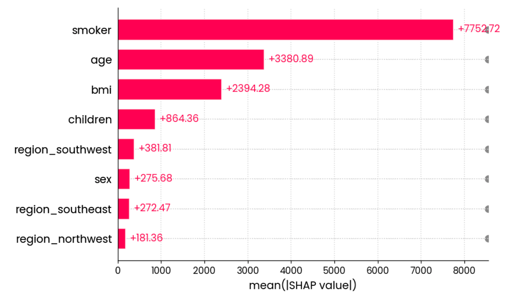
Giá trị tuyệt đối trung bình của tất cả giá trị SHAP cho mọi đặc trưng. Ảnh: Tác giả.
Nói cách khác, đây là cách tính tầm quan trọng đặc trưng toàn cục - đồ thị không gắn với một dự đoán cá nhân.
Và vậy là xong phần SHAP. Tiếp theo tôi sẽ chuyển sang LIME.
LIME
Giống như SHAP, LIME hướng đến machine learning có thể diễn giải.
Nó không có nhiều loại trực quan hóa như SHAP, nhưng làm một việc rất tốt—ít nhất là với các tập dữ liệu dạng bảng.
Để minh họa, tôi sẽ tải tập dữ liệu phân loại và chuyển tiếp nó thành một bài toán phân loại nhị phân bằng cách thay các mục chờ duyệt thành bị từ chối. Cách này sẽ giúp bạn dễ hiểu đầu ra của LIME hơn:
from lime import lime_tabular
df = load_classification_dataset()
# Convert to binary
df["admission"] = df["admission"].replace({"Waitlist": "Deny"})
X = df.drop("admission", axis=1)
y = df["admission"]
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.25, random_state=42)
X_train.shape, y_test.shape
random_forest = RandomForestClassifier(n_estimators=25, random_state=42)
random_forest.fit(X_train, y_train)Lớp LimeTabularExplainer() giờ nhận dữ liệu huấn luyện, tên cột, tên các hạng mục trong biến mục tiêu, và chế độ của mô hình (phân loại hay hồi quy):
explainer = lime_tabular.LimeTabularExplainer(
training_data=np.array(X_train),
feature_names=X_train.columns,
class_names=["Admit", "Deny"],
mode="classification"
)Xong rồi, bạn có thể gọi phương thức explain_instance() để diễn giải một dự đoán đơn lẻ dựa trên xác suất dự đoán theo lớp:
exp = explainer.explain_instance(
data_row=X_test.iloc[0],
predict_fn=random_forest.predict_proba
)
exp.show_in_notebook(show_table=True)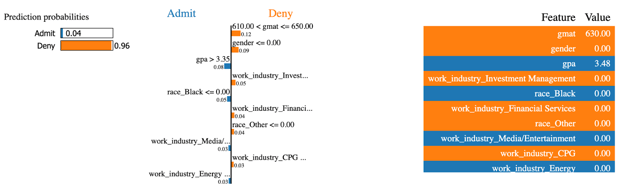
Giải thích LIME (1). Ảnh: Tác giả.
Mô hình LIME chắc chắn 96% rằng hồ sơ MBA này sẽ bị từ chối. Các đặc trưng như gmat và gender có tác động lớn nhất đến quyết định.
Giờ hãy làm điều tương tự cho một trường hợp được nhận vào chương trình MBA:
exp = explainer.explain_instance(
data_row=X_test.iloc[234],
predict_fn=random_forest.predict_proba
)
exp.show_in_notebook(show_table=True)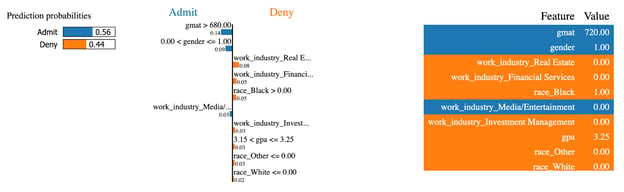
Giải thích LIME (2). Ảnh: Tác giả.
Các đặc trưng tương tự giờ lại có tác động ngược lại! Người này có điểm gmat cao, là yếu tố đóng góp lớn nhất giúp được nhận vào chương trình MBA.
Vậy là xong phần mô hình cây! Tiếp theo, bạn sẽ học cách trực quan hóa các mô hình tuyến tính cho tác vụ hồi quy.
Trực quan hóa mô hình tuyến tính
Nếu bạn mới bắt đầu với mô hình dự đoán, không gì cơ bản hơn hồi quy tuyến tính. Đây là mô hình đơn giản, dễ hiểu và hoạt động tốt, miễn là các mối quan hệ trong dữ liệu của bạn là tuyến tính.
Dĩ nhiên còn nhiều mô hình tuyến tính khác, nhưng trong phần này, tôi chỉ làm việc với hồi quy tuyến tính.
Bắt đầu bằng cách tải tập dữ liệu hồi quy, chia thành tập huấn luyện và kiểm tra, rồi fit một mô hình hồi quy tuyến tính vào phần huấn luyện:
from sklearn.linear_model import LinearRegression
df = load_regression_dataset()
X = df.drop("charges", axis=1)
y = df["charges"]
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.25, random_state=42)
model = LinearRegression().fit(X_train, y_train)Loại trực quan hóa đầu tiên tôi khám phá là các hệ số của mô hình.
Hệ số của mô hình tuyến tính
Nói một cách đơn giản, hồi quy tuyến tính quy về một phương trình. Bạn có thể nhớ y = mx+b từ thời phổ thông — ý tưởng tương tự vẫn đúng.
Phương trình hồi quy mở rộng thành y = w0 + w1_x1 + w2_x2 + … + wn_xn để chứa nhiều tham số. Mục tiêu của mô hình là tìm ước lượng tốt nhất cho các trọng số (w) với tập đặc trưng đầu vào (x).
Vậy vì sao điều này quan trọng?
Bởi vì bạn có thể truy cập các hệ số (trọng số) sau khi mô hình được huấn luyện và phân tích mức đóng góp của chúng; các đặc trưng có hệ số lớn hơn sẽ đóng góp nhiều hơn vào việc dự đoán biến mục tiêu.
Bạn có thể lấy hệ số bằng cách truy cập tham số coef_ trên mô hình đã huấn luyện.
Đoạn mã sau lấy các hệ số và vẽ chúng dưới dạng biểu đồ cột ngang:
features = X_train.columns
coefficients = model.coef_
plt.figure(figsize=(10, 4))
bars = plt.barh(y=features, width=coefficients, edgecolor="#008031", linewidth=1)
for bar in bars:
width = bar.get_width()
plt.text(width + 1, bar.get_y() + bar.get_height()/2, f"{width:.2f}",
va="center", ha="left")
plt.xlabel("Coefficient value")
plt.title("Linear Regression Model Coefficients", y=1.05)
plt.show()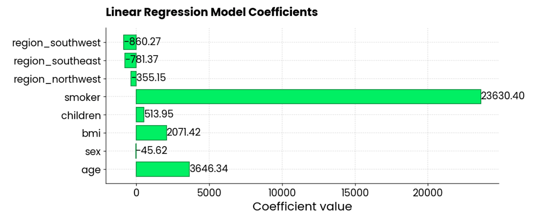
Các hệ số của mô hình hồi quy tuyến tính. Ảnh: Tác giả.
Các đặc trưng smoker, BMI và age là những yếu tố đóng góp dương lớn nhất vào chi phí bảo hiểm—khi chúng tăng, khoản phí cũng tăng. Cũng có vài hệ số âm, tức là chúng làm giảm tổng số tiền.
Biểu đồ phần dư
Loại trực quan hóa hồi quy phổ biến khác là biểu đồ phần dư. Nói nôm na, bạn đang tạo một biểu đồ phân tán với trục X là giá trị dự đoán và trục Y là phần dư (giá trị thực - giá trị dự đoán).
Lý tưởng nhất, không nên có mẫu hình nào rõ rệt trong phần dư, và chúng nên phân bố quanh 0. Nói cách khác, chúng nên phân phối chuẩn.
Dùng đoạn mã này để trực quan hóa phần dư của mô hình hồi quy tuyến tính trên tập dữ liệu bảo hiểm:
y_pred = model.predict(X_test)
residuals = y_test - y_pred
plt.figure(figsize=(10, 6))
plt.scatter(y_pred, residuals, color="#03EF62", alpha=0.6, edgecolors="#008031")
plt.axhline(0, color="red", linestyle="--")
plt.xlabel("Predicted Values")
plt.ylabel("Residuals")
plt.title("Residuals vs Predicted Values", y=1.05)
plt.grid(True)
plt.show()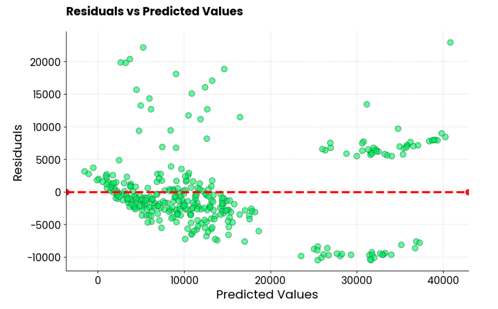
Phần dư của mô hình hồi quy tuyến tính. Ảnh: Tác giả.
Đây không phải là biểu đồ phần dư tốt nhất tôi từng thấy. Trông thì đẹp, nhưng các giá trị rải rác khắp nơi. Nếu bạn là người thực hành machine learning và nhận được biểu đồ phần dư tương tự, bạn còn rất nhiều việc phải làm phía trước.
Tiếp theo, tôi sẽ chỉ bạn 3 cách để trực quan hóa mô hình mạng nơ-ron.
Trực quan hóa mô hình mạng nơ-ron
Nếu có một lĩnh vực của machine learning mà trực quan hóa và diễn giải quan trọng nhất, thì đó hẳn là mạng nơ-ron.
Đây là chủ đề phức tạp để nắm bắt, ngay cả ở mức cơ bản nhất. Bạn có nhiều loại tầng, hàm kích hoạt, và lan truyền ngược — chỉ kể vài thứ. Vì lý do đó, mạng nơ-ron thường đồng nghĩa với mô hình hộp đen.
Không nhất thiết phải như vậy.
Trong phần này, tôi sẽ chỉ bạn ba cách để trực quan hóa mạng nơ-ron: sơ đồ kiến trúc, chỉ số huấn luyện theo thời gian thực, và Grad-CAM.
Thư viện tôi chọn là TensorFlow. Nếu bạn chưa từng nghe đến, chúng tôi có một khóa học TensorFlow cho người mới bắt đầu sẽ giúp bạn bắt nhịp nhanh chóng!
Kiến trúc mạng nơ-ron
Khi bạn trực quan hóa kiến trúc của mô hình mạng nơ-ron, bạn sẽ làm sáng tỏ một điều — các kích thước (shape).
Nói cách khác, bạn sẽ thấy ma trận nền tảng biến đổi kích thước thế nào khi đi qua các tầng. Đây có thể là chủ đề khó cho người mới, nên bất kỳ trực quan hóa nào cũng đáng giá.
Để minh họa, tôi sẽ dùng TensorFlow tạo một mô hình mạng nơ-ron cơ bản cho bài toán phân loại chữ số viết tay. Sau đó, tôi sẽ dùng hàm plot_model() để lưu ảnh kiến trúc mô hình vào tệp cục bộ.
Tự bạn xem nhé:
from tensorflow.keras import layers, models
from tensorflow.keras.utils import plot_model
model = models.Sequential()
model.add(layers.Input(shape=(28, 28, 1)))
model.add(layers.Conv2D(32, (3, 3), activation="relu"))
model.add(layers.MaxPooling2D((2, 2)))
model.add(layers.Conv2D(64, (3, 3), activation="relu"))
model.add(layers.MaxPooling2D((2, 2)))
model.add(layers.Flatten())
model.add(layers.Dense(64, activation="relu"))
model.add(layers.Dense(10, activation="softmax"))
plot_model(model, to_file="model_architecture.png", show_shapes=True, show_layer_names=True)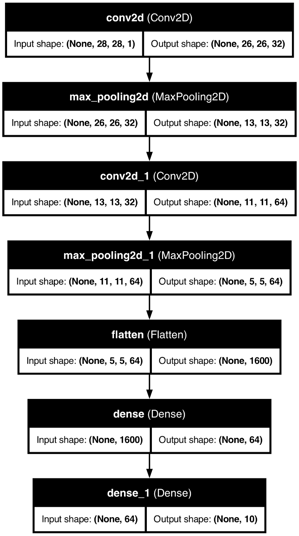
Kiến trúc mô hình mạng nơ-ron. Ảnh: Tác giả.
Dù hữu ích, kiểu trực quan hóa này chỉ giúp bạn đến một mức độ nhất định.
Bạn biết dữ liệu biến đổi ra sao trên đường đi, nhưng chưa rõ mô hình mạng nơ-ron đi đến kết luận như thế nào. Tôi sẽ đề cập điều đó ngay sau đây.
Grad-CAM
Grad-CAM, hay Gradient Class Activation Mapping, là kỹ thuật phổ biến dùng để trực quan hóa các mô hình mạng nơ-ron tích chập.
Cụ thể hơn, nó giúp bạn hiểu những phần nào của ảnh đầu vào đóng góp nhiều nhất vào dự đoán của mô hình. Hãy coi nó như biểu đồ tầm quan trọng đặc trưng của cây quyết định, nhưng mạnh mẽ hơn nhiều.
Đây là kỹ thuật diễn giải nâng cao, hoạt động với mọi mô hình tích chập bất kể kiến trúc, và giúp bạn hiểu vì sao mô hình mạng nơ-ron đưa ra một dự đoán nhất định.
Nhưng có một vấn đề — nó không hề đơn giản để triển khai trong Python. Dưới đây là cái nhìn tổng quan cấp cao về thuật toán:
- Dự đoán: Lấy một dự đoán từ mô hình tích chập.
- Gradient của đầu ra: Với đầu ra của một lớp cụ thể, thuật toán tính gradient của điểm số lớp đó đối với các bản đồ đặc trưng ở lớp tích chập cuối cùng. Điều này cho bạn biết mỗi nơ-ron trong các bản đồ đặc trưng đóng góp bao nhiêu vào dự đoán cuối cùng.
- Bản đồ đặc trưng có trọng số: Sau đó các gradient được lấy trung bình để tính trọng số tầm quan trọng, rồi áp dụng các trọng số này lên các bản đồ đặc trưng tương ứng. Nói cách khác, bước này làm nổi bật những vùng quan trọng của ảnh dẫn đến dự đoán.
- Bản đồ nhiệt (heatmap): Các bản đồ đặc trưng có trọng số được kết hợp để tạo ra một heatmap, hiển thị các vùng của ảnh có tác động lớn nhất đến dự đoán.
Đó là một quy trình khá cầu kỳ, và để mọi thứ dễ dàng hơn, tôi sẽ dùng một mô hình ResNet50 đã được huấn luyện sẵn có thể phân loại 1000 loại ảnh khác nhau.
Trước tiên, hãy nạp các thư viện cần thiết và bức ảnh bạn muốn xem Grad-CAM. Tôi đang dùng a ảnh chó có sẵn:
import cv2
import tensorflow as tf
from tensorflow.keras.applications.resnet50 import ResNet50
from tensorflow.keras.preprocessing.image import load_img
image = np.array(load_img("dog.jpg", target_size=(224, 224, 3)))
plt.grid(False)
plt.imshow(image)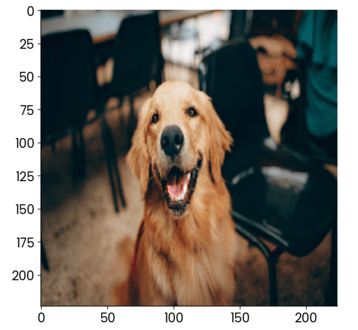
Ảnh chó mẫu. Ảnh của Tác giả.
Giờ đến phần thú vị. Ở đoạn mã sau, tôi triển khai quy trình bốn bước đã mô tả trước đó. Bạn sẽ thấy chú thích phía trên mỗi dòng mã để dễ hiểu hơn:
# Load the pre-trained ResNet50 model
model = ResNet50()
# Extract the output of the last convolutional layer
last_conv_layer = model.get_layer("conv5_block3_out")
# Create a model that outputs the last convolutional layer’s activations
last_conv_layer_model = tf.keras.Model(model.inputs, last_conv_layer.output)
# Prepare the classifier model using the layers after the last convolutional layer
classifier_input = tf.keras.Input(shape=last_conv_layer.output.shape[1:])
x = classifier_input
for layer_name in ["avg_pool", "predictions"]:
# Reuse the pooling and prediction layers from the ResNet50 model
x = model.get_layer(layer_name)(x)
# Create a new model that takes in the last conv layer output and returns predictions
classifier_model = tf.keras.Model(classifier_input, x)
# Use a GradientTape to record operations for automatic differentiation
with tf.GradientTape() as tape:
# Prepare the input image and get the activations from the last conv layer
inputs = image[np.newaxis, ...]
last_conv_layer_output = last_conv_layer_model(inputs)
tape.watch(last_conv_layer_output) # Watch the conv layer output
# Get predictions from the classifier model
preds = classifier_model(last_conv_layer_output)
# Get the index of the highest predicted class
top_pred_index = tf.argmax(preds[0])
# Focus on the prediction of the top class
top_class_channel = preds[:, top_pred_index]
# Compute the gradient of the top predicted class with respect to the conv layer output
grads = tape.gradient(top_class_channel, last_conv_layer_output)
# Average the gradients over the width and height dimensions
pooled_grads = tf.reduce_mean(grads, axis=(0, 1, 2))
# Multiply each channel in the conv layer output by its corresponding gradient
last_conv_layer_output = last_conv_layer_output.numpy()[0]
pooled_grads = pooled_grads.numpy()
for i in range(pooled_grads.shape[-1]):
last_conv_layer_output[:, :, i] *= pooled_grads[I]
# Compute the Grad-CAM by averaging the channels and apply a ReLU activation
gradcam = np.mean(last_conv_layer_output, axis=-1)
# Normalize the Grad-CAM to be between 0 and 1
gradcam = np.clip(gradcam, 0, np.max(gradcam)) / np.max(gradcam)
# Resize the Grad-CAM heatmap to the size of the original image (224x224)
gradcam = cv2.resize(gradcam, (224, 224))Khá nhiều đấy, nhưng giờ bạn đã có thể vẽ heatmap do thuật toán Grad-CAM tạo ra:
plt.grid(False)
plt.imshow(gradcam)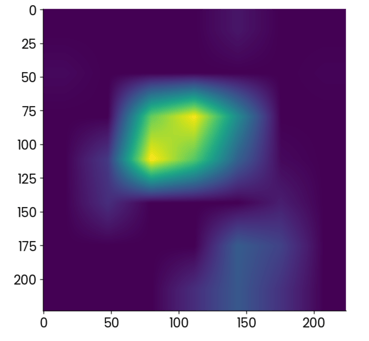
Heatmap Grad-CAM. Ảnh của Tác giả.
Các điểm sáng hơn cho biết những vùng có kích hoạt mạnh nhất, nhưng chỉ riêng heatmap thì không nói lên nhiều điều.
Bạn sẽ làm tốt hơn nếu chồng heatmap lên ảnh gốc và giảm nhẹ độ mờ:
plt.grid(False)
plt.imshow(image)
plt.imshow(gradcam, alpha=0.5)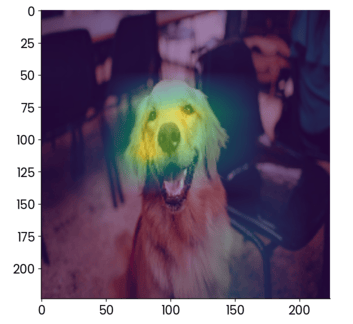
Ảnh chó với lớp phủ grad-CAM. Ảnh của Tác giả.
Khi diễn giải, yếu tố đóng góp nhiều nhất để ảnh này được phân loại là “golden retriever” là khuôn mặt, điều này hợp lý.
Bạn có thể dùng Grad-CAM để đảm bảo mô hình đang đưa ra dự đoán đúng cách. Trong trường hợp này, hãy tưởng tượng heatmap cho thấy một thứ khác, như chiếc ghế ở nền sau, là yếu tố đóng góp nhiều nhất. Bạn có tin mô hình đó không?
Trực quan hóa quá trình huấn luyện mô hình theo thời gian thực
Huấn luyện một mô hình mạng nơ-ron có thể mất rất nhiều thời gian. Điểm tốt là bạn không phải đợi huấn luyện xong mới có cái nhìn về hiệu năng của mô hình. Các thư viện như TensorBoard có thể hiển thị điều đó theo thời gian thực.
TensorBoard đi kèm với TensorFlow, nên bạn không cần cài thêm gì để làm theo.
Để minh họa, tôi sẽ huấn luyện một mô hình phân loại chữ số cơ bản trong 25 epoch. Phần quan trọng là callback—ở đó, bạn chỉ định đường dẫn và định dạng cho log huấn luyện, mà TensorBoard sẽ sử dụng ngay sau đó.
Đây là đoạn mã bạn cần để huấn luyện mô hình và lưu log huấn luyện:
import tensorflow as tf
from tensorflow.keras import layers, models
from datetime import datetime
# Load MNIST dataset
mnist = tf.keras.datasets.mnist
(x_train, y_train), (x_test, y_test) = mnist.load_data()
# Normalize pixel values between 0 and 1
x_train, x_test = x_train / 255.0, x_test / 255.0
# Add a channels dimension (for the Convolutional layer)
x_train = np.expand_dims(x_train, -1)
x_test = np.expand_dims(x_test, -1)
# Build a simple CNN model
model = models.Sequential([
layers.Conv2D(32, kernel_size=(3, 3), activation="relu", input_shape=(28, 28, 1)),
layers.MaxPooling2D(pool_size=(2, 2)),
layers.Flatten(),
layers.Dense(128, activation="relu"),
layers.Dense(10, activation="softmax")
])
# Compile the model
model.compile(
optimizer="adam",
loss="sparse_categorical_crossentropy",
metrics=["accuracy"]
)
# Set up TensorBoard callback
log_dir = "logs/fit/" + datetime.now().strftime("%Y%m%d-%H%M%S")
tensorboard_callback = tf.keras.callbacks.TensorBoard(log_dir=log_dir, histogram_freq=1)
# Train the model with TensorBoard monitoring
model.fit(
x_train,
y_train,
epochs=25,
validation_data=(x_test, y_test),
callbacks=[tensorboard_callback]
)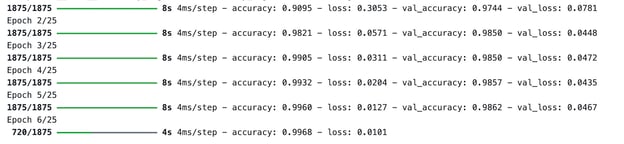
Quá trình huấn luyện mô hình. Ảnh của Tác giả.
Trong khi mô hình đang huấn luyện, hãy chạy TensorBoard từ terminal và chỉ định đường dẫn tới thư mục chứa log huấn luyện:
tensorboard --logdir=logs/fitTheo mặc định, TensorBoard sẽ chạy trên cổng 6006:
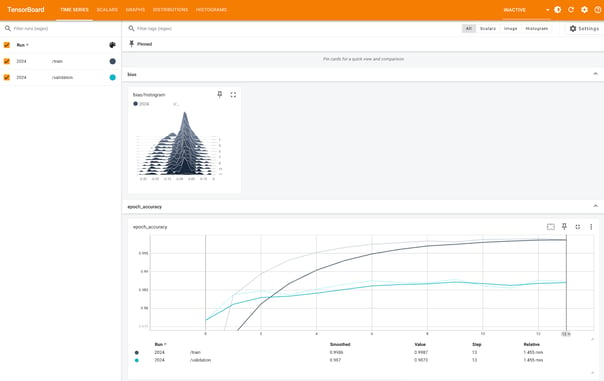
Các chỉ số TensorBoard (1). Ảnh của Tác giả.
Hình trên hiển thị biểu đồ histogram của bias và độ chính xác theo từng epoch, cho cả tập huấn luyện và tập kiểm định. Bạn có thể thấy độ chính xác rất cao cho cả hai, gần 100% — chỉ là thang Y hơi nhỏ.
Các thẻ khác sẽ đi sâu vào những chỉ số cụ thể hơn và cho phép bạn tinh chỉnh một số thứ, như bạn có thể thấy bên dưới:
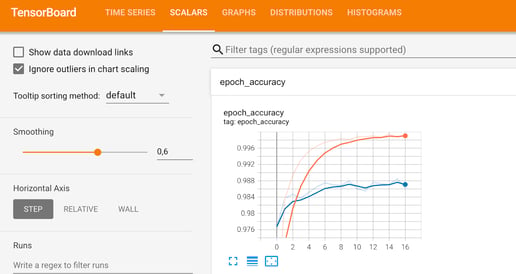
Các chỉ số TensorBoard (2). Ảnh của Tác giả.
Tóm lại, TensorBoard là một công cụ trực quan hóa hiệu năng mô hình tiện lợi và có thể giúp bạn phân tích hiệu năng trong khi mô hình đang huấn luyện.
Trực quan hóa các chỉ số hiệu năng mô hình
Ở phần cuối này, tôi muốn lùi lại một bước và đi sâu vào các chỉ số mục đích chung hơn để trực quan hóa hiệu năng của mô hình.
Bạn sẽ thấy ba loại: ma trận nhầm lẫn, biểu đồ đường cong ROC và biểu đồ đường cong Precision-Recall.
Vì chúng gắn với các bài toán phân loại, bạn sẽ phải nạp bộ dữ liệu MBA. Để mọi thứ dễ hơn, tôi cũng đã chuyển nó thành một bài toán phân loại nhị phân bằng cách gộp mục chờ xét duyệt vào bị từ chối. Phần còn lại của đoạn mã tách dữ liệu thành tập huấn luyện và kiểm định và huấn luyện trước một mô hình phân loại rừng ngẫu nhiên:
from sklearn.ensemble import RandomForestClassifier
df = load_classification_dataset()
df["admission"] = df["admission"].replace({"Waitlist": "Deny"})
df["admission"] = df["admission"].replace({"Deny": 0, "Admit": 1})
df.rename(columns={"admission": "is_admitted"}, inplace=True)
X = df.drop("is_admitted", axis=1)
y = df["is_admitted"]
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.25, random_state=42)
random_forest = RandomForestClassifier(n_estimators=25, random_state=42)
random_forest.fit(X_train, y_train)Hãy đi vào chỉ số đầu tiên — ma trận nhầm lẫn.
Ma trận nhầm lẫn
Ma trận nhầm lẫn cho bạn biết mô hình hoạt động tốt đến đâu. Trong kịch bản lý tưởng, các giá trị trên đường chéo từ góc trên trái đến góc dưới phải sẽ là các phần tử khác 0 duy nhất, cho thấy mô hình không mắc bất kỳ dự đoán sai nào.
Nhưng điều đó hiếm khi xảy ra trong thế giới thực.
Hãy dùng các hướng dẫn sau để diễn giải ma trận nhầm lẫn (cho phân loại nhị phân):
- Phần tử trên bên trái: True negatives (TN) — giá trị thực là âm và mô hình dự đoán là âm. Sinh viên không được nhận vào chương trình MBA và mô hình dự đoán họ không được nhận.
- Phần tử trên bên phải: False positives (FP) — giá trị thực là âm nhưng mô hình dự đoán là dương. Sinh viên không được nhận vào MBA, nhưng mô hình dự đoán họ được nhận.
- Phần tử dưới bên trái: False negatives (FN) — giá trị thực là dương nhưng mô hình dự đoán là âm. Sinh viên được nhận vào MBA, nhưng mô hình dự đoán họ không được nhận.
- Phần tử dưới bên phải: True positives (TP) — giá trị thực là dương và mô hình dự đoán là dương. Sinh viên được nhận vào MBA và mô hình dự đoán họ được nhận.
Không có quy tắc chung về việc bạn nên quan tâm nhiều hơn đến dương tính giả hay âm tính giả. Trường hợp thứ nhất gây “đau” hơn trong tuyển sinh MBA vì mô hình phân loại sinh viên được nhận, trong khi thực tế không phải vậy. Ở các trường hợp khác, như dự đoán ung thư, việc giảm thiểu số âm tính giả là cực kỳ quan trọng, vì bạn không muốn kết luận ai đó khỏe mạnh khi họ bị ung thư.
Đó là lúc kiến thức miền phát huy tác dụng.
Quay lại với mã. Đoạn sau tính ma trận nhầm lẫn từ mô hình rừng ngẫu nhiên trên tập kiểm định và dùng lớp ConfusionMatrixDisplay để tạo hình trực quan:
from sklearn.metrics import confusion_matrix
from sklearn.metrics import confusion_matrix, ConfusionMatrixDisplay
preds = random_forest.predict(X_test)
cm = confusion_matrix(y_true=y_test, y_pred=preds, labels=random_forest.classes_)
disp = ConfusionMatrixDisplay(confusion_matrix=cm, display_labels=random_forest.classes_)
disp.plot()
plt.grid(False)
plt.title("Confusion Matrix", y=1.04)
plt.show()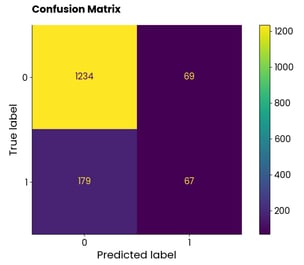
Biểu đồ ma trận nhầm lẫn. Ảnh của Tác giả.
Các lớp không cân bằng, nhưng số lượng dự đoán sai cao đến đáng kinh ngạc.
Hãy xem đường cong ROC nói gì.
Đường cong ROC
ROC là viết tắt của Receiver Operating Characteristics, và đó là một đường cong hiển thị đánh giá hiệu năng của mô hình phân loại nhị phân. Với phân loại đa lớp, bạn sẽ phải so sánh hai lớp một lần.
Đường cong ROC thể hiện sự đánh đổi giữa tỷ lệ dương tính thật (TPR, sensitivity, recall) và tỷ lệ dương tính giả (FPR) tại các ngưỡng phân loại khác nhau. TPR được vẽ trên trục Y so với FPR trên trục X. Mỗi điểm đại diện cho một ngưỡng khác nhau cho quyết định phân loại (điểm xác suất dùng để phân loại một trường hợp là dương hay âm).
Đường cong thường được vẽ so với đường chéo từ (0, 0) đến (1, 1), đại diện cho bộ phân loại ngẫu nhiên.
Nếu đường cong nằm phía trên đường chéo, nghĩa là mô hình của bạn tốt hơn bộ phân loại ngẫu nhiên. Có một giá trị vô hướng tóm tắt điều đó. Nó gọi là AUC (Area Under the Curve) và nằm trong khoảng từ 0 đến 1, càng cao càng tốt và 0,5 là ngẫu nhiên.
Tóm lại, bạn muốn đường cong càng gần góc trên bên trái càng tốt.
Dùng đoạn mã sau để tính ROC và AUC và vẽ đường cong:
from sklearn.metrics import roc_curve, auc
# Get predicted probabilities for the positive class
y_probs = random_forest.predict_proba(X_test)[:, 1]
fpr, tpr, roc_thresholds = roc_curve(y_test, y_probs)
roc_auc = auc(fpr, tpr)
plt.plot(fpr, tpr, label=f"AUC = {roc_auc:.2f}")
plt.plot([0, 1], [0, 1], color="navy", linestyle="--")
plt.xlim([0.0, 1.0])
plt.ylim([0.0, 1.05])
plt.xlabel("False Positive Rate")
plt.ylabel("True Positive Rate")
plt.title("ROC Curve", y=1.04)
plt.legend(loc="lower right")
plt.show()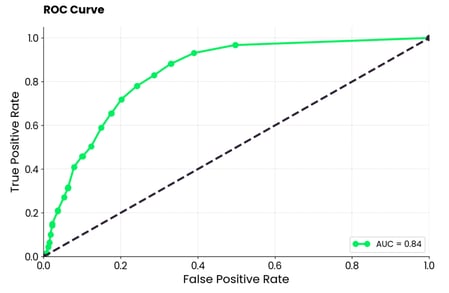
Biểu đồ đường cong ROC. Ảnh của Tác giả.
Khi diễn giải, mô hình rừng ngẫu nhiên tốt hơn nhiều so với bộ phân loại ngẫu nhiên và có sự cân bằng hợp lý giữa dương tính thật và dương tính giả. Vẫn có mức độ phân loại sai nhất định, và bạn nên cố gắng “nâng” đường cong lên trên và sang trái bằng cách tối ưu dữ liệu hoặc chọn một mô hình học máy khác.
Đường cong Precision-Recall
Đường cong này tương tự ROC nhưng thể hiện sự đánh đổi giữa precision và recall ở các ngưỡng phân loại khác nhau. Nó hiển thị precision trên trục Y và recall trên trục X và thường được ưu tiên hơn ROC khi các lớp không cân bằng.
Đó chính là trường hợp của bộ dữ liệu tuyển sinh MBA, vậy nên đường cong PR nghe có vẻ rất phù hợp!
Lưu ý rằng các đường cong precision-recall chỉ tập trung vào lớp thiểu số và cung cấp bức tranh tốt hơn về việc mô hình xác định các trường hợp quan trọng nhất (sinh viên được nhận, ca ung thư được phát hiện, v.v.) hiệu quả ra sao.
Dùng đoạn mã sau để tính các giá trị precision và recall và vẽ chúng trên đồ thị:
from sklearn.metrics import precision_recall_curve
# Get predicted probabilities for the positive class
y_probs = random_forest.predict_proba(X_test)[:, 1]
# Precision-Recall curve
precision, recall, pr_thresholds = precision_recall_curve(y_test, y_probs)
pr_auc = auc(recall, precision)
plt.plot(recall, precision, label=f"(AUC = {pr_auc:.2f})")
plt.xlabel("Recall")
plt.ylabel("Precision")
plt.title("Precision-Recall Curve", y=1.04)
plt.legend(loc="lower left")
plt.show()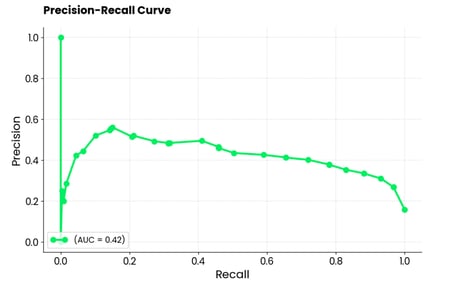
Biểu đồ đường cong Precision-Recall. Ảnh của Tác giả.
Khi diễn giải, mô hình hoạt động kém, thể hiện qua điểm AUC là 0,42. Khi mô hình cố tăng recall, nó hy sinh quá nhiều precision, dẫn đến nhiều dương tính giả. Tóm lại, mô hình này không phù hợp với bộ dữ liệu này, hoặc bản thân bộ dữ liệu chưa được tiền xử lý đủ tốt.
Tổng kết
Kết lại, lĩnh vực học máy phức tạp và thường khó nắm bắt. Nếu bạn là người mới bắt đầu, bạn sẽ gặp khó khi hiểu những ý tưởng lớn. Nếu bạn làm việc với khách hàng doanh nghiệp, họ có thể sẽ không hiểu các thuật ngữ kỹ thuật.
Trực quan hóa dữ liệu giúp thu hẹp khoảng cách trong cả hai trường hợp.
Hôm nay, bạn đã thấy tất cả các loại biểu đồ khác nhau có thể dùng để trực quan hóa các mô hình hồi quy và phân loại, cũng như quá trình ra quyết định của mạng nơ-ron và diễn giải một dự đoán đơn lẻ thông qua SHAP và LIME. Có rất nhiều thứ để tiêu hóa, nên cứ thoải mái xem lại bài viết này nhiều lần!
Nếu bạn hoàn toàn mới với chủ đề này, chúng tôi khuyến nghị xem khóa học nền tảng về học máy của chúng tôi để bắt đầu. Sau đó, một khóa học ứng dụng hơn với Python sẽ rất phù hợp.
Nếu bạn đã có chút kinh nghiệm nhưng chưa hiểu cách mọi thứ vận hành ở quy mô lớn hơn, chúng tôi khuyến khích bạn thử khóa học học máy cho môi trường sản xuất của chúng tôi.
Câu hỏi thường gặp
Tại sao tôi nên trực quan hóa các mô hình học máy?
Trực quan hóa mô hình giúp thu hẹp khoảng cách giữa kiến thức kỹ thuật chuyên sâu của bạn và hiểu biết của người làm kinh doanh; họ thường không hiểu biệt ngữ và sẽ được lợi từ các diễn giải đơn giản. Ngoài ra, nếu bạn mới bắt đầu với học máy, trực quan hóa mô hình có thể giúp bạn hiểu rõ hơn về các nền tảng.
Trực quan hóa mô hình có tốn thời gian không?
Hoàn toàn không! Đó là nguyên tắc “viết một lần, chạy mọi nơi.” Bạn sẽ viết (hoặc sao chép của tôi) mã trực quan hóa và dùng nó cho tất cả các dự án, với thay đổi mã bằng 0 hoặc tối thiểu.
Tôi có thể dùng cùng một hình trực quan cho bài toán hồi quy và phân loại không?
Thường là không. Các mô hình hồi quy dùng những bộ chỉ số đánh giá khác (ví dụ: biểu đồ hệ số, biểu đồ phần dư) so với các mô hình phân loại (ví dụ: ma trận nhầm lẫn, đường cong ROC/PR). Một số chỉ số như độ chính xác có thể dùng trong cả hai trường hợp, nhưng bạn thường sẽ phải dùng những bộ chỉ số và hình trực quan khác nhau.
Tôi có thể trực quan hóa quy trình ra quyết định đằng sau một dự đoán đơn lẻ không?
Có, đó là mục tiêu của học máy có khả năng giải thích. Các thư viện Python như SHAP và LIME làm hầu hết công việc nặng nhọc cho bạn, và chúng sẽ báo cáo mức độ ảnh hưởng của từng biến khi đưa ra một dự đoán đơn lẻ. Những thư viện này là phải có nếu bạn muốn hiểu quy trình ra quyết định hoặc muốn giải thích quy trình đó cho người làm kinh doanh.
Tôi có thể trực quan hóa quy trình ra quyết định của mạng nơ-ron tích chập không?
Có, một kỹ thuật gọi là Grad-CAM được dùng để lấy heatmap của các điểm quyết định của mô hình. Sau đó bạn có thể chồng heatmap lên ảnh gốc để xem vùng nào đóng góp nhiều nhất vào quy trình ra quyết định của mô hình.


Machine learning phức tạp và đậm đặc toán học.
Khi mới bắt đầu, gần như chắc chắn bạn sẽ chật vật khi tìm hiểu cơ chế hoạt động bên trong của hàng chục mô hình khác nhau sẵn có. Vấn đề càng nghiêm trọng hơn nếu bạn không có nền tảng toán. Nhưng ngay cả khi bạn có bằng tiến sĩ, việc giải thích kết quả mô hình cho người làm kinh doanh vẫn không hề dễ. Họ thường không chia sẻ mức độ hào hứng của bạn với các chi tiết kỹ thuật nhưng muốn chắc rằng các mô hình của bạn đưa ra quyết định đúng cách.
Vậy làm sao để thu hẹp khoảng cách?
Có một ngôn ngữ chung giữa giới kỹ thuật và kinh doanh: trực quan hóa dữ liệu. Biểu đồ dễ hiểu và giúp việc giải thích các chủ đề phức tạp trở nên dễ quản lý hơn, bất kể nền tảng của bạn.
Trong bài viết này, tôi sẽ hướng dẫn bạn các khái niệm cơ bản và nâng cao về trực quan hóa các mô hình machine learning có giám sát. Nếu bạn đang tìm tài liệu hay về học không giám sát, khóa học Unsupervised Learning with Python của chúng tôi sẽ đáp ứng nhu cầu đó.
Sau khi đọc xong, các thuật ngữ hệ số (coefficients), phần dư (residuals), tầm quan trọng đặc trưng (feature importance), SHAP, LIME và Grad-CAM sẽ không còn nghe như tiếng nước ngoài nữa.
Bắt đầu thôi!
Các kiểu trực quan hóa phổ biến nhất cho mô hình Machine Learning
Tôi sẽ bắt đầu với phần lý thuyết nhẹ về các kiểu trực quan hóa mô hình machine learning phổ biến nhất. Mục đích là để chúng ta cùng chung nền tảng.
Nếu bạn đã quen thuộc với các nội dung này, cứ thoải mái bỏ qua phần này.
Tầm quan trọng đặc trưng
Khi bạn muốn hiểu thuộc tính nào của bộ dữ liệu đóng góp nhiều nhất vào dự đoán của mô hình machine learning, đây chính là thứ bạn cần.
Hãy hình dung như nướng bánh: các nguyên liệu như bột mì và đường là thiết yếu, còn những thứ khác như rắc trang trí thì không đóng góp nhiều. Nói cách khác, bạn có thể có chiếc bánh không cần rắc trang trí, nhưng không thể thiếu bột mì và đường.
Nếu bạn bỏ một đặc trưng có điểm quan trọng cao, hiệu suất mô hình sẽ giảm đáng kể.
Biểu đồ tầm quan trọng đặc trưng thường gắn với các mô hình dạng cây (cây quyết định, rừng ngẫu nhiên, gradient boosting). Giá trị thực tế có sau khi huấn luyện mô hình và việc trực quan hóa chúng chỉ cần vài dòng mã.
Chỉ số hiệu năng mô hình
Các chỉ số phổ biến nhất để đánh giá mô hình machine learning (ví dụ, cho phân loại) là ma trận nhầm lẫn, đường cong ROC và đường cong PR (precision-recall).
Chỉ số đầu tiên hiển thị số dự đoán đúng trên mỗi lớp nằm trên đường chéo từ trên-trái xuống dưới-phải. Mọi thứ nằm ngoài đường chéo được xem là lỗi (hoặc dương tính giả hoặc âm tính giả).
Chỉ số thứ hai thể hiện đánh đổi giữa tỷ lệ dương tính thật và tỷ lệ dương tính giả cho một tập ngưỡng phân loại.
Và chỉ số thứ ba cho thấy sự cân bằng giữa dự đoán dương tính đúng (precision) và khả năng của mô hình trong việc nhận diện tất cả các trường hợp dương tính (recall). Cả đường ROC và PR chỉ áp dụng cho bài toán phân loại nhị phân. Với bài toán đa lớp, bạn sẽ phải so sánh từng cặp hai lớp một.
Có nhiều chỉ số đánh giá khác nữa, đúng vậy, nhưng ba chỉ số này là phổ biến nhất. Chúng được tích hợp sẵn trong scikit-learn, thư viện bạn sẽ dùng để huấn luyện mô hình machine learning.
Biểu đồ lỗi
Khi làm việc với các mô hình tuyến tính (ví dụ, hồi quy tuyến tính), bạn thường sẽ muốn vẽ phần dư.
Đây là chênh lệch giữa giá trị thực tế và giá trị dự đoán. Khi vẽ, bạn nên kiểm tra xem có mẫu hình rõ rệt nào không. Lý tưởng là chúng phân tán ngẫu nhiên quanh 0 (phân phối chuẩn). Nếu không, mô hình đang đưa ra dự đoán lệch, và bạn vẫn còn việc phải làm.
Nhìn chung, đây là biểu đồ rất dễ tạo nhưng có thể cho bạn biết nhiều điều về mô hình hồi quy của mình.
Giải thích dự đoán
Các mô hình machine learning thường bị xem như hộp đen, nhưng không nhất thiết phải vậy.
Các kỹ thuật diễn giải nâng cao như SHAP (SHapely Additive exPlanations) và LIME (Local Interpretable Model-agnostic Explanations) giúp trả lời câu hỏi mô hình đã đi đến một quyết định cụ thể như thế nào.
SHAP gán giá trị tầm quan trọng cho từng đặc trưng đối với một dự đoán cá thể (ví dụ: người này hút thuốc nên mức phí bảo hiểm sẽ cao hơn), trong khi LIME tạo một mô hình đơn giản hơn để xấp xỉ dự đoán của mô hình phức tạp cho một trường hợp cụ thể.
Tôi sẽ cho bạn thấy chính xác cách chúng hoạt động ở phần sau của bài viết.
Nhưng trước khi đi vào phần hấp dẫn, hãy bàn về một vài thư viện Python bạn sẽ cần để theo dõi nội dung.