Google a récemment dévoilé son nouveau modèle d’IA générative, Gemini. Il résulte d’un effort commun de plusieurs équipes chez Google, dont des membres de Google Research.
Ce modèle, que Google présente comme l’IA la plus performante et la plus polyvalente qu’ils aient développée à ce jour, a été conçu pour être multimodale. Concrètement, Gemini peut comprendre différents types de données comme du texte, de l’audio, des images, de la vidéo et du code.
Dans la suite de cet article, nous allons aborder :
- Qu’est-ce que Gemini ?
- Quelles sont les versions de Gemini ?
- Comment accéder à Gemini ?
- Les benchmarks de Gemini décryptés
- Gemini vs GPT-4
- Cas d’usage de Gemini
Qu’est-ce que Google Gemini ?
Le 6 décembre 2023, Google DeepMind a annoncé Gemini 1.0. À sa sortie, Google l’a décrit comme son ensemble de grands modèles de langage (LLM) le plus avancé, succédant ainsi au Pathways Language Model (PaLM 2), lancé en mai de la même année.
Gemini désigne une famille de LLM multimodaux capables de comprendre des textes, des images, des vidéos et de l’audio. Il serait également en mesure d’exécuter des tâches complexes en mathématiques et en physique, et de générer du code de haute qualité dans plusieurs langages de programmation.
Le saviez-vous ? Sergey Brin, cofondateur de Google, est crédité comme l’un des contributeurs au modèle Gemini.
Jusqu’à récemment, la démarche standard pour développer des modèles multimodaux consistait à entraîner des composants séparés pour chaque modalité, puis à les assembler pour reproduire certaines fonctionnalités. Ces modèles pouvaient exceller sur des tâches précises, comme la description d’images, mais peinaient dès qu’il s’agissait de raisonnement plus avancé et complexe.
Gemini a été conçu comme nativement multimodal : il a donc été pré-entraîné dès le départ sur plusieurs modalités. Pour accroître encore son efficacité, Google l’a affiné avec des données multimodales supplémentaires.
Résultat : selon Sundar Pichai, PDG de Google et Alphabet, et Demis Hassabis, PDG et cofondateur de Google DeepMind, Gemini est nettement plus performant que les modèles multimodaux existants pour comprendre et raisonner à partir d’un large éventail d’entrées, dès la base. Ils affirment également que les capacités de Gemini « établissent l’état de l’art dans presque tous les domaines ».
Fonctionnalités clés de Google Gemini
Parmi les principales fonctionnalités du modèle Gemini :
1. Compréhension du texte, des images, de l’audio, et plus encore
L’IA multimodale est un nouveau paradigme qui gagne du terrain : il combine différents types de données avec plusieurs algorithmes pour atteindre un meilleur niveau de performance. Gemini s’appuie sur ce paradigme et s’intègre ainsi naturellement à divers formats de données. Vous pouvez fournir des images, de l’audio, du texte et d’autres types de contenus, pour des interactions avec l’IA plus naturelles.
2. Fiabilité, mise à l’échelle et efficacité
Gemini exploite les puces TPUv5 de Google, ce qui le rendrait cinq fois plus puissant que GPT-4. Grâce à un traitement plus rapide, Gemini peut s’attaquer plus facilement à des tâches complexes et gérer simultanément de multiples requêtes.
3. Raisonnement avancé
Gemini a été entraîné sur un vaste jeu de données de textes et de code. Il peut ainsi accéder à des informations très récentes et fournir des réponses fiables et précises. D’après Google, le modèle dépasse GPT-4 d’OpenAI et des humains de « niveau expert » sur divers tests d’intelligence (par exemple, le benchmark MMLU).
4. Programmation avancée
Gemini 1.0 peut comprendre, expliquer et générer du code de haute qualité dans les langages les plus utilisés, comme Python, Java, C++ et Go : il s’impose ainsi comme l’un des principaux modèles de base pour le code au niveau mondial.
Le modèle surpasse également plusieurs benchmarks de programmation, notamment HumanEval, référence très utilisée dans l’industrie pour évaluer la performance sur des tâches de code ; il s’est aussi distingué sur un jeu de données interne et exclusif à Google, fondé sur du code produit par des auteurs plutôt que sur des informations issues du web.
5. Responsabilité et sécurité
De nouvelles protections ont été intégrées aux principes et politiques d’IA de Google pour tenir compte des capacités multimodales de Gemini. Google affirme : « Gemini a fait l’objet des évaluations de sécurité les plus complètes de tous nos modèles d’IA à ce jour, y compris en matière de biais et de toxicité. » L’entreprise indique aussi avoir « mené des recherches inédites sur des zones de risque potentielles comme la cyber-offensive, la persuasion et l’autonomie, et appliqué les meilleures techniques de tests adversariaux de Google Research pour identifier en amont des enjeux critiques de sécurité avant le déploiement de Gemini. »
Quelles sont les versions de Gemini ?
Selon Google, Gemini, qui succède à LaMDA et PaLM 2, est leur « modèle le plus flexible à ce jour — capable de fonctionner efficacement aussi bien dans des data centers que sur des appareils mobiles. » Ils estiment également que les capacités de pointe de Gemini vont transformer la manière dont les développeurs et les entreprises conçoivent et déploient l’IA à l’échelle.
La première version, logiquement baptisée Gemini 1.0, a été déclinée en trois tailles :
- Gemini Nano — le modèle le plus efficient pour des tâches embarquées, sans dépendre de serveurs externes. En d’autres termes, il est conçu pour tourner sur smartphone, notamment sur le Google Pixel 8.
- Gemini Pro — le modèle optimal pour se déployer à grande échelle sur différentes tâches. Il alimente Bard, le chatbot IA le plus récent de Google ; il peut donc comprendre des requêtes complexes et répondre rapidement.
- Gemini Ultra — le plus grand et le plus performant pour les tâches complexes, dépassant l’état de l’art sur 30 des 32 benchmarks courants utilisés en R&D sur les grands modèles de langage.
Depuis le 13 décembre 2023, les développeurs et les clients entreprise peuvent accéder à Gemini Pro via l’API de Gemini dans Google AI Studio ou Google Cloud Vertex AI.
À noter : Google AI Studio est un IDE accessible gratuitement dans le navigateur, que les développeurs peuvent utiliser pour prototyper des modèles génératifs et lancer facilement des applications via une clé API. Google Cloud Vertex est, quant à lui, une plateforme d’IA entièrement managée qui rassemble tous les outils nécessaires pour créer et exploiter l’IA générative. D’après Google, « Vertex AI permet de personnaliser Gemini avec un contrôle total des données et bénéficie des fonctionnalités Google Cloud en matière de sécurité, de fiabilité, de confidentialité, de gouvernance et de conformité des données. »
Grâce à AICore, une nouvelle fonctionnalité système d’Android 14, les développeurs Android peuvent, à partir des appareils Pixel 8 Pro, travailler avec Gemini Nano, le modèle le plus efficient pour les tâches embarquées.
Les benchmarks de Gemini décryptés
Avant leur sortie, les modèles Gemini ont été largement testés pour évaluer leurs performances sur un large éventail de tâches. Google indique que Gemini Ultra surpasse l’état de l’art existant sur 30 des 32 benchmarks académiques couramment utilisés pour la R&D sur les grands modèles de langage. Ces tâches couvrent notamment la compréhension d’images naturelles, d’audio, de vidéo, ainsi que le raisonnement mathématique.
Dans un billet de présentation, Google affirme que Gemini Ultra est le premier modèle à dépasser des experts humains sur le Massive Multitask Language Understanding (MMLU) avec un score de 90,0 %. Le MMLU intègre 57 disciplines, dont les mathématiques, la physique, l’histoire, le droit, la médecine et l’éthique, pour évaluer la capacité à résoudre des problèmes et la connaissance générale du monde.
La nouvelle méthode d’évaluation MMLU permet à Gemini de faire des progrès significatifs en mobilisant sa capacité de raisonnement pour délibérer plus en profondeur avant de répondre aux questions difficiles, plutôt que de s’en tenir à une première impression.
Voici les performances de Gemini sur des tâches textuelles :
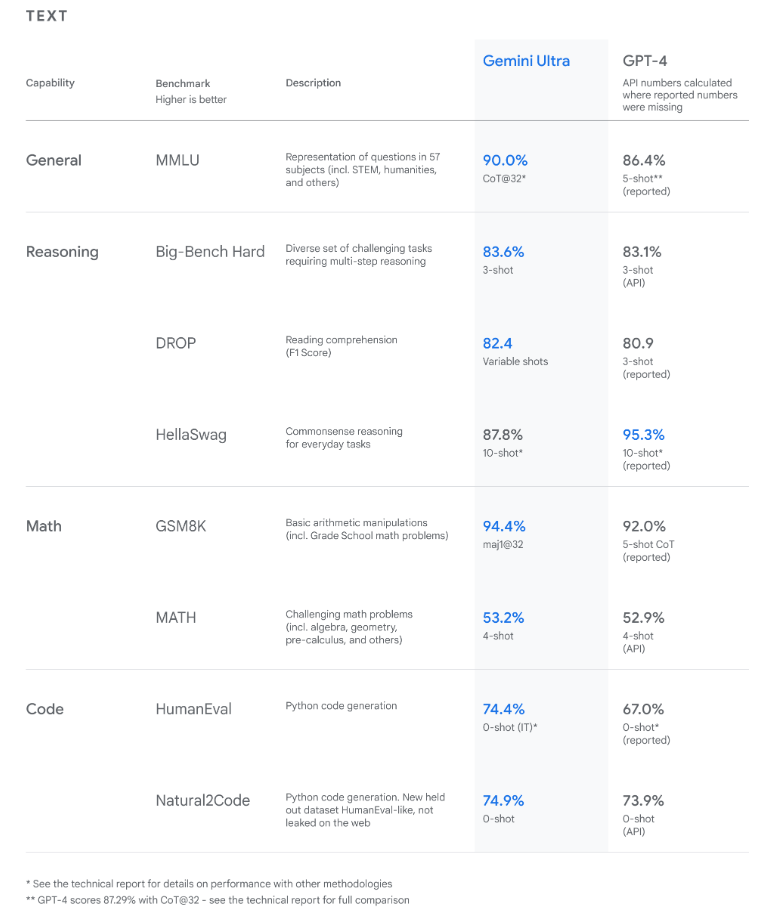
Les résultats montrent que Gemini dépasse l’état de l’art sur un large éventail de benchmarks, y compris en texte et en code. [Source]
Le modèle Gemini Ultra a également établi l’état de l’art sur le nouveau benchmark Massive Multidiscipline Multimodal Understanding (MMMU) avec un score de 59,4 %. Cette évaluation couvre des tâches multimodales dans divers domaines nécessitant un raisonnement délibéré.
Google précise : « Sur les benchmarks d’images testés, Gemini Ultra a dépassé les modèles antérieurs de référence sans l’aide de systèmes d’OCR (reconnaissance optique de caractères) qui extraient le texte des images pour un traitement ultérieur. »
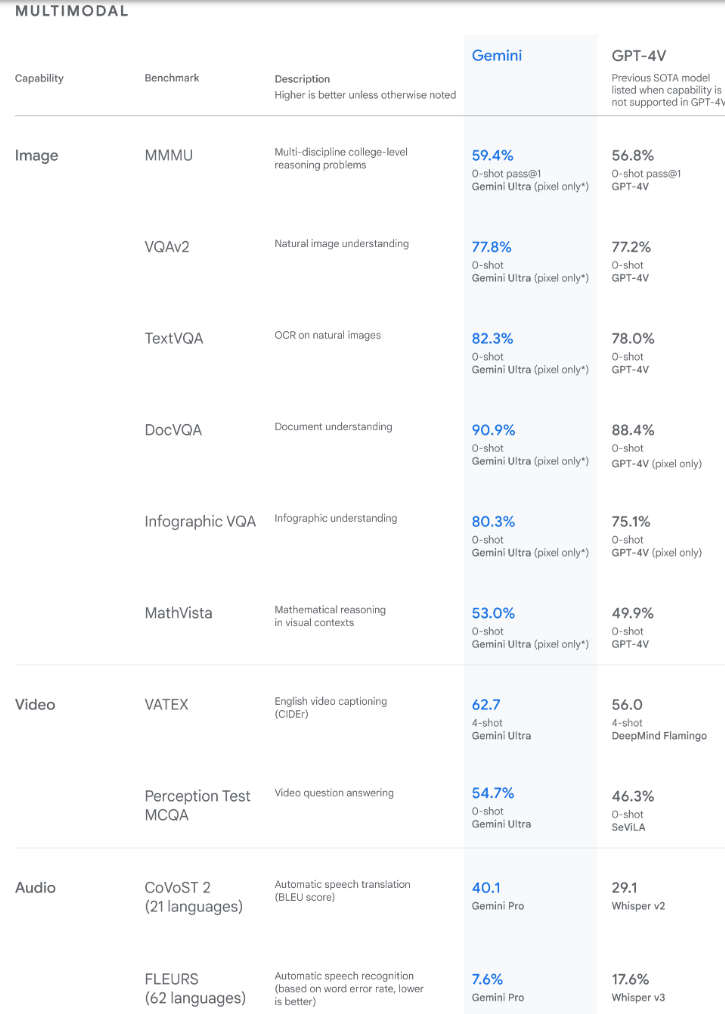
Les résultats montrent que Gemini dépasse aussi l’état de l’art sur de nombreux benchmarks multimodaux. [Source]
Les benchmarks atteints par Gemini témoignent de sa multimodalité intrinsèque et offrent des premiers indices de ses capacités de raisonnement plus sophistiquées.
Gemini vs GPT-4
La question qui vient naturellement ensuite est : « Comment Gemini se compare-t-il à GPT-4 ? »
Les deux modèles proposent des fonctionnalités proches et peuvent interagir avec du texte, des images, de la vidéo, de l’audio et du code, permettant de les appliquer à un grand nombre de cas d’usage.
Les utilisateurs des deux outils peuvent vérifier les faits, mais l’approche diffère. Quand GPT-4 d’OpenAI fournit des liens sources pour étayer ses affirmations, Gemini permet de lancer une recherche Google pour confirmer la réponse en un clic.
Il est aussi possible d’étendre les deux modèles avec des extensions, même si, au moment d’écrire ces lignes, Gemini de Google reste bien plus limité.
Par exemple, on peut exploiter des outils Google comme Flights, Maps, YouTube et la suite Workspace avec Gemini. À l’inverse, GPT-4 d’OpenAI dispose d’un choix bien plus large de plug-ins et d’extensions, pour la plupart créés par des tiers. La génération d’images à la volée est également possible avec GPT-4 ; Gemini est conçu pour pouvoir le faire, mais, à ce stade, ne le permet pas encore.
En revanche, Gemini répond plus vite que GPT-4, dont les temps de réponse peuvent parfois rallonger, voire être interrompus, en raison de la forte affluence sur la plateforme.
Cas d’usage de Gemini
Les modèles Gemini de Google peuvent exécuter de nombreuses tâches sur plusieurs modalités, comme la compréhension de texte, d’audio, d’images et de vidéo.
La combinaison de différentes modalités pour comprendre et générer des sorties est également possible grâce à la nature multimodale de Gemini.
Quelques exemples de cas d’usage :
Résumés de texte
Les modèles Gemini peuvent résumer des contenus issus de différents types de données. Selon un article de recherche intitulé GEMINI: Controlling The Sentence-Level Summary Style in Abstractive Text Summarization, le modèle Gemini « intègre des réécritures et un générateur pour reproduire respectivement les techniques de réécriture de phrases et d’abstraction. »
Concrètement, Gemini choisit de manière adaptative s’il convient de réécrire une phrase spécifique d’un document ou de générer une phrase de synthèse entièrement nouvelle. Les résultats expérimentaux montrent que l’approche de Gemini dépasse les baselines purement « abstractive » et « réécriture » sur trois jeux de données de référence, avec les meilleurs scores sur WikiHow.
Génération de texte
Gemini peut générer du texte en réponse à une invite utilisateur — y compris via une interface de chatbot en mode questions-réponses. Il peut ainsi être déployé pour traiter des demandes clients et offrir une assistance naturelle et engageante, libérant du temps aux agents humains pour se concentrer sur des tâches plus complexes et améliorer la satisfaction.
Il peut aussi être utilisé pour l’écriture créative : coécriture d’un roman, rédaction de poèmes dans différents styles, ou génération de scénarios pour films et pièces. De quoi doper la productivité des auteurs et atténuer le syndrome de la page blanche.
Traduction de texte et traitement audio
Grâce à leurs capacités multilingues étendues, les modèles Gemini comprennent et traduisent plus de 100 langues. Selon Google, Gemini dépasse les performances de pointe de Chat GPT-4V « sur une série de benchmarks multimodaux », comme la reconnaissance automatique de la parole (ASR) et la traduction automatique de la parole.
Traitement d’images et de vidéos
Gemini peut comprendre et interpréter des images, ce qui le rend adapté à la légendage d’images et aux cas d’usage de questions-réponses visuelles. Le modèle sait aussi analyser des visuels complexes, dont des schémas, figures et graphiques, sans nécessiter d’outils d’OCR externes.
Analyse et génération de code
Les développeurs peuvent utiliser Gemini pour résoudre des tâches de programmation complexes et déboguer leur code. Le modèle est capable de comprendre, d’expliquer et de générer dans les langages les plus utilisés, comme Python, Java, C++ et Go.
Conclusion
La nouvelle famille de grands modèles de langage (LLM) multimodaux de Google, Gemini, succède à LaMDA et PaLM 2. Elle est présentée comme l’ensemble de LLM le plus avancé de Google, capable de comprendre des textes, des images, des vidéos, de l’audio et d’aborder des tâches complexes comme les mathématiques et la physique. Gemini peut également générer du code de haute qualité dans de nombreux langages populaires.
Le modèle a atteint l’état de l’art sur diverses tâches, et beaucoup chez Google estiment qu’il marque une avancée majeure dans la manière dont l’IA peut améliorer notre quotidien.
Poursuivez votre apprentissage avec ces ressources :
Avant de partir, n’oubliez pas de vous abonner à notre chaîne YouTube. Nous publions du contenu de qualité sur les sujets les plus pertinents et tendances, dont un tutoriel pour créer des applications multimodales avec Gemini. À découvrir sans tarder.


 Kurtis Pykes · 9 min


 Lynn Heidmann



Google a récemment dévoilé son nouveau modèle d’IA générative, Gemini. Il résulte d’un effort commun de plusieurs équipes chez Google, dont des membres de Google Research.
Ce modèle, que Google présente comme l’IA la plus performante et la plus polyvalente qu’ils aient développée à ce jour, a été conçu pour être multimodale. Concrètement, Gemini peut comprendre différents types de données comme du texte, de l’audio, des images, de la vidéo et du code.
Dans la suite de cet article, nous allons aborder :
Qu’est-ce que Google Gemini ?
Le 6 décembre 2023, Google DeepMind a annoncé Gemini 1.0. À sa sortie, Google l’a décrit comme son ensemble de grands modèles de langage (LLM) le plus avancé, succédant ainsi au Pathways Language Model (PaLM 2), lancé en mai de la même année.
Gemini désigne une famille de LLM multimodaux capables de comprendre des textes, des images, des vidéos et de l’audio. Il serait également en mesure d’exécuter des tâches complexes en mathématiques et en physique, et de générer du code de haute qualité dans plusieurs langages de programmation.
Le saviez-vous ? Sergey Brin, cofondateur de Google, est crédité comme l’un des contributeurs au modèle Gemini.
Jusqu’à récemment, la démarche standard pour développer des modèles multimodaux consistait à entraîner des composants séparés pour chaque modalité, puis à les assembler pour reproduire certaines fonctionnalités. Ces modèles pouvaient exceller sur des tâches précises, comme la description d’images, mais peinaient dès qu’il s’agissait de raisonnement plus avancé et complexe.
Gemini a été conçu comme nativement multimodal : il a donc été pré-entraîné dès le départ sur plusieurs modalités. Pour accroître encore son efficacité, Google l’a affiné avec des données multimodales supplémentaires.
Résultat : selon Sundar Pichai, PDG de Google et Alphabet, et Demis Hassabis, PDG et cofondateur de Google DeepMind, Gemini est nettement plus performant que les modèles multimodaux existants pour comprendre et raisonner à partir d’un large éventail d’entrées, dès la base. Ils affirment également que les capacités de Gemini « établissent l’état de l’art dans presque tous les domaines ».
Fonctionnalités clés de Google Gemini
Parmi les principales fonctionnalités du modèle Gemini :
1. Compréhension du texte, des images, de l’audio, et plus encore
L’IA multimodale est un nouveau paradigme qui gagne du terrain : il combine différents types de données avec plusieurs algorithmes pour atteindre un meilleur niveau de performance. Gemini s’appuie sur ce paradigme et s’intègre ainsi naturellement à divers formats de données. Vous pouvez fournir des images, de l’audio, du texte et d’autres types de contenus, pour des interactions avec l’IA plus naturelles.
2. Fiabilité, mise à l’échelle et efficacité
Gemini exploite les puces TPUv5 de Google, ce qui le rendrait cinq fois plus puissant que GPT-4. Grâce à un traitement plus rapide, Gemini peut s’attaquer plus facilement à des tâches complexes et gérer simultanément de multiples requêtes.
3. Raisonnement avancé
Gemini a été entraîné sur un vaste jeu de données de textes et de code. Il peut ainsi accéder à des informations très récentes et fournir des réponses fiables et précises. D’après Google, le modèle dépasse GPT-4 d’OpenAI et des humains de « niveau expert » sur divers tests d’intelligence (par exemple, le benchmark MMLU).
4. Programmation avancée
Gemini 1.0 peut comprendre, expliquer et générer du code de haute qualité dans les langages les plus utilisés, comme Python, Java, C++ et Go : il s’impose ainsi comme l’un des principaux modèles de base pour le code au niveau mondial.
Le modèle surpasse également plusieurs benchmarks de programmation, notamment HumanEval, référence très utilisée dans l’industrie pour évaluer la performance sur des tâches de code ; il s’est aussi distingué sur un jeu de données interne et exclusif à Google, fondé sur du code produit par des auteurs plutôt que sur des informations issues du web.
5. Responsabilité et sécurité
De nouvelles protections ont été intégrées aux principes et politiques d’IA de Google pour tenir compte des capacités multimodales de Gemini. Google affirme : « Gemini a fait l’objet des évaluations de sécurité les plus complètes de tous nos modèles d’IA à ce jour, y compris en matière de biais et de toxicité. » L’entreprise indique aussi avoir « mené des recherches inédites sur des zones de risque potentielles comme la cyber-offensive, la persuasion et l’autonomie, et appliqué les meilleures techniques de tests adversariaux de Google Research pour identifier en amont des enjeux critiques de sécurité avant le déploiement de Gemini. »
Quelles sont les versions de Gemini ?
Selon Google, Gemini, qui succède à LaMDA et PaLM 2, est leur « modèle le plus flexible à ce jour — capable de fonctionner efficacement aussi bien dans des data centers que sur des appareils mobiles. » Ils estiment également que les capacités de pointe de Gemini vont transformer la manière dont les développeurs et les entreprises conçoivent et déploient l’IA à l’échelle.
La première version, logiquement baptisée Gemini 1.0, a été déclinée en trois tailles :
Comment accéder à Gemini ?
Depuis le 13 décembre 2023, les développeurs et les clients entreprise peuvent accéder à Gemini Pro via l’API de Gemini dans Google AI Studio ou Google Cloud Vertex AI.
À noter : Google AI Studio est un IDE accessible gratuitement dans le navigateur, que les développeurs peuvent utiliser pour prototyper des modèles génératifs et lancer facilement des applications via une clé API. Google Cloud Vertex est, quant à lui, une plateforme d’IA entièrement managée qui rassemble tous les outils nécessaires pour créer et exploiter l’IA générative. D’après Google, « Vertex AI permet de personnaliser Gemini avec un contrôle total des données et bénéficie des fonctionnalités Google Cloud en matière de sécurité, de fiabilité, de confidentialité, de gouvernance et de conformité des données. »
Grâce à AICore, une nouvelle fonctionnalité système d’Android 14, les développeurs Android peuvent, à partir des appareils Pixel 8 Pro, travailler avec Gemini Nano, le modèle le plus efficient pour les tâches embarquées.
Les benchmarks de Gemini décryptés
Avant leur sortie, les modèles Gemini ont été largement testés pour évaluer leurs performances sur un large éventail de tâches. Google indique que Gemini Ultra surpasse l’état de l’art existant sur 30 des 32 benchmarks académiques couramment utilisés pour la R&D sur les grands modèles de langage. Ces tâches couvrent notamment la compréhension d’images naturelles, d’audio, de vidéo, ainsi que le raisonnement mathématique.
Dans un billet de présentation, Google affirme que Gemini Ultra est le premier modèle à dépasser des experts humains sur le Massive Multitask Language Understanding (MMLU) avec un score de 90,0 %. Le MMLU intègre 57 disciplines, dont les mathématiques, la physique, l’histoire, le droit, la médecine et l’éthique, pour évaluer la capacité à résoudre des problèmes et la connaissance générale du monde.
La nouvelle méthode d’évaluation MMLU permet à Gemini de faire des progrès significatifs en mobilisant sa capacité de raisonnement pour délibérer plus en profondeur avant de répondre aux questions difficiles, plutôt que de s’en tenir à une première impression.
Voici les performances de Gemini sur des tâches textuelles :
Les résultats montrent que Gemini dépasse l’état de l’art sur un large éventail de benchmarks, y compris en texte et en code. [Source]
Le modèle Gemini Ultra a également établi l’état de l’art sur le nouveau benchmark Massive Multidiscipline Multimodal Understanding (MMMU) avec un score de 59,4 %. Cette évaluation couvre des tâches multimodales dans divers domaines nécessitant un raisonnement délibéré.
Google précise : « Sur les benchmarks d’images testés, Gemini Ultra a dépassé les modèles antérieurs de référence sans l’aide de systèmes d’OCR (reconnaissance optique de caractères) qui extraient le texte des images pour un traitement ultérieur. »
Les résultats montrent que Gemini dépasse aussi l’état de l’art sur de nombreux benchmarks multimodaux. [Source]
Les benchmarks atteints par Gemini témoignent de sa multimodalité intrinsèque et offrent des premiers indices de ses capacités de raisonnement plus sophistiquées.
Gemini vs GPT-4
La question qui vient naturellement ensuite est : « Comment Gemini se compare-t-il à GPT-4 ? »
Les deux modèles proposent des fonctionnalités proches et peuvent interagir avec du texte, des images, de la vidéo, de l’audio et du code, permettant de les appliquer à un grand nombre de cas d’usage.
Les utilisateurs des deux outils peuvent vérifier les faits, mais l’approche diffère. Quand GPT-4 d’OpenAI fournit des liens sources pour étayer ses affirmations, Gemini permet de lancer une recherche Google pour confirmer la réponse en un clic.
Il est aussi possible d’étendre les deux modèles avec des extensions, même si, au moment d’écrire ces lignes, Gemini de Google reste bien plus limité.
Par exemple, on peut exploiter des outils Google comme Flights, Maps, YouTube et la suite Workspace avec Gemini. À l’inverse, GPT-4 d’OpenAI dispose d’un choix bien plus large de plug-ins et d’extensions, pour la plupart créés par des tiers. La génération d’images à la volée est également possible avec GPT-4 ; Gemini est conçu pour pouvoir le faire, mais, à ce stade, ne le permet pas encore.
En revanche, Gemini répond plus vite que GPT-4, dont les temps de réponse peuvent parfois rallonger, voire être interrompus, en raison de la forte affluence sur la plateforme.
Cas d’usage de Gemini
Les modèles Gemini de Google peuvent exécuter de nombreuses tâches sur plusieurs modalités, comme la compréhension de texte, d’audio, d’images et de vidéo.
La combinaison de différentes modalités pour comprendre et générer des sorties est également possible grâce à la nature multimodale de Gemini.
Quelques exemples de cas d’usage :
Résumés de texte
Les modèles Gemini peuvent résumer des contenus issus de différents types de données. Selon un article de recherche intitulé GEMINI: Controlling The Sentence-Level Summary Style in Abstractive Text Summarization, le modèle Gemini « intègre des réécritures et un générateur pour reproduire respectivement les techniques de réécriture de phrases et d’abstraction. »
Concrètement, Gemini choisit de manière adaptative s’il convient de réécrire une phrase spécifique d’un document ou de générer une phrase de synthèse entièrement nouvelle. Les résultats expérimentaux montrent que l’approche de Gemini dépasse les baselines purement « abstractive » et « réécriture » sur trois jeux de données de référence, avec les meilleurs scores sur WikiHow.
Génération de texte
Gemini peut générer du texte en réponse à une invite utilisateur — y compris via une interface de chatbot en mode questions-réponses. Il peut ainsi être déployé pour traiter des demandes clients et offrir une assistance naturelle et engageante, libérant du temps aux agents humains pour se concentrer sur des tâches plus complexes et améliorer la satisfaction.
Il peut aussi être utilisé pour l’écriture créative : coécriture d’un roman, rédaction de poèmes dans différents styles, ou génération de scénarios pour films et pièces. De quoi doper la productivité des auteurs et atténuer le syndrome de la page blanche.
Traduction de texte et traitement audio
Grâce à leurs capacités multilingues étendues, les modèles Gemini comprennent et traduisent plus de 100 langues. Selon Google, Gemini dépasse les performances de pointe de Chat GPT-4V « sur une série de benchmarks multimodaux », comme la reconnaissance automatique de la parole (ASR) et la traduction automatique de la parole.
Traitement d’images et de vidéos
Gemini peut comprendre et interpréter des images, ce qui le rend adapté à la légendage d’images et aux cas d’usage de questions-réponses visuelles. Le modèle sait aussi analyser des visuels complexes, dont des schémas, figures et graphiques, sans nécessiter d’outils d’OCR externes.
Analyse et génération de code
Les développeurs peuvent utiliser Gemini pour résoudre des tâches de programmation complexes et déboguer leur code. Le modèle est capable de comprendre, d’expliquer et de générer dans les langages les plus utilisés, comme Python, Java, C++ et Go.
Conclusion
La nouvelle famille de grands modèles de langage (LLM) multimodaux de Google, Gemini, succède à LaMDA et PaLM 2. Elle est présentée comme l’ensemble de LLM le plus avancé de Google, capable de comprendre des textes, des images, des vidéos, de l’audio et d’aborder des tâches complexes comme les mathématiques et la physique. Gemini peut également générer du code de haute qualité dans de nombreux langages populaires.
Le modèle a atteint l’état de l’art sur diverses tâches, et beaucoup chez Google estiment qu’il marque une avancée majeure dans la manière dont l’IA peut améliorer notre quotidien.
Poursuivez votre apprentissage avec ces ressources :
Avant de partir, n’oubliez pas de vous abonner à notre chaîne YouTube. Nous publions du contenu de qualité sur les sujets les plus pertinents et tendances, dont un tutoriel pour créer des applications multimodales avec Gemini. À découvrir sans tarder.