
{count, plural, one {Corso} other {Corsi}}
Concetti di IA generativa
{hours} ore
120.1K
Google ha recentemente rilasciato il suo nuovo modello di IA generativa, Gemini. È il risultato di uno sforzo congiunto di diversi team in Google, inclusi membri di Google Research.
Il modello, che Google descrive come l'IA più capace e polivalente sviluppata finora, è stato progettato per essere multimodale. Ciò significa che Gemini può comprendere vari tipi di dati come testo, audio, immagini, video e codice.
Nel resto dell'articolo vedremo:
Il 6 dicembre 2023, Google DeepMind ha annunciato Gemini 1.0. Al momento del lancio, Google lo ha descritto come il suo set più avanzato di Large Language Models (LLM), superando quindi il Pathways Langauge Model (PaLM 2), presentato a maggio dello stesso anno.
Gemini definisce una famiglia di LLM multimodali in grado di comprendere testi, immagini, video e audio. Si dice inoltre che sia in grado di svolgere compiti complessi in matematica e fisica, oltre a generare codice di alta qualità in diversi linguaggi di programmazione.
Lo sapevi? Sergey Brin, cofondatore di Google, è accreditato come uno dei contributori al modello Gemini.
Fino a poco tempo fa, la procedura standard per sviluppare modelli multimodali consisteva nell'addestrare componenti separati per le varie modalità e poi assemblarli per imitare parte della funzionalità. Tali modelli a volte eccellevano in determinati compiti, come descrivere immagini, ma avevano difficoltà con forme di ragionamento più sofisticate e complesse.
Gemini è stato progettato per essere nativamente multimodale; è quindi stato pre-addestrato fin dall'inizio su più modalità. Per raffinarne ulteriormente l'efficacia, Google lo ha perfezionato con dati multimodali aggiuntivi.
Di conseguenza, Gemini è significativamente più capace dei modelli multimodali esistenti nel comprendere e ragionare su un'ampia gamma di input fin dalle fondamenta, secondo Sundar Pichai, CEO di Google e Alphabet, e Demis Hassabis, CEO e cofondatore di Google DeepMind. Aggiungono anche che le capacità di Gemini sono "allo stato dell'arte in quasi ogni ambito".
Le principali caratteristiche del modello Gemini includono:
L'IA multimodale è un nuovo paradigma in crescita, in cui diversi tipi di dati vengono combinati con più algoritmi per ottenere prestazioni superiori. Gemini sfrutta questo paradigma, integrandosi bene con vari tipi di dati. Puoi fornire in input immagini, audio, testo e altri tipi di dati, ottenendo interazioni con l'IA più naturali.
Gemini sfrutta i chip TPUv5 di Google, risultando a quanto pare cinque volte più potente di GPT-4. L'elaborazione più rapida rende Gemini capace di affrontare con relativa facilità compiti complessi e gestire più richieste simultaneamente.
Gemini è stato addestrato su un enorme dataset di testo e codice. Questo assicura che il modello possa accedere a informazioni aggiornate e fornire risposte accurate e affidabili alle tue domande. Secondo Google, il modello supera GPT-4 di OpenAI e gli esseri umani di livello "esperto" in vari test di intelligenza (ad esempio, il benchmark MMLU).
Gemini 1.0 può comprendere, spiegare e generare codice di alta qualità nei linguaggi di programmazione più diffusi, come Python, Java, C++ e Go: questo lo rende uno dei principali foundation model per il coding a livello globale.
Il modello eccelle anche in diversi benchmark di programmazione, tra cui HumanEval, uno standard molto apprezzato nel settore per valutare le prestazioni nei compiti di coding; si è comportato bene anche su un dataset interno e riservato di Google, che utilizza codice generato da autori invece di informazioni prese dal web.
Sono state aggiunte nuove tutele ai Principi di IA e alle policy di Google per tenere conto delle capacità multimodali di Gemini. Google afferma: "Gemini ha le valutazioni di sicurezza più complete mai effettuate su un modello di IA di Google, inclusi bias e tossicità". Ha anche dichiarato di aver "condotto ricerche innovative su potenziali aree di rischio come cyber-offense, persuasione e autonomia, e di aver applicato le tecniche di test avversariali all'avanguardia di Google Research per aiutare a identificare in anticipo criticità di sicurezza prima del deployment di Gemini".
Google afferma che Gemini, il successore di LaMDA e PaLM 2, è il suo "modello più flessibile di sempre — in grado di funzionare in modo efficiente da data center fino ai dispositivi mobili". Secondo l'azienda, le capacità allo stato dell'arte di Gemini miglioreranno il modo in cui sviluppatori e clienti business costruiscono e scalano con l'IA.
La prima versione di Gemini, chiamata prevedibilmente Gemini 1.0, è stata rilasciata in tre dimensioni diverse:
Dal 13 dicembre 2023, sviluppatori e clienti enterprise possono accedere a Gemini Pro tramite le API di Gemini in Google AI Studio o Google Cloud Vertex AI.
Nota: Google AI Studio è un IDE basato su browser, disponibile gratuitamente, che gli sviluppatori possono usare per prototipare modelli generativi e lanciare facilmente applicazioni utilizzando una chiave API. Google Cloud Vertex, invece, è una piattaforma di IA completamente gestita che offre tutti gli strumenti necessari per creare e utilizzare l'IA generativa. Secondo Google, "Vertex AI consente di personalizzare Gemini con pieno controllo sui dati e beneficia di funzionalità aggiuntive di Google Cloud per sicurezza, protezione, privacy e governance e conformità dei dati a livello enterprise".
Tramite AICore, una nuova funzionalità di sistema introdotta con Android 14, gli sviluppatori Android, a partire dai dispositivi Pixel 8 Pro, possono sviluppare con Gemini Nano, il modello più efficiente per attività on-device.
I modelli Gemini sono stati sottoposti a test approfonditi per valutarne le prestazioni su un'ampia gamma di compiti prima del rilascio. Google afferma che il suo modello Gemini Ultra supera i risultati allo stato dell'arte esistenti in 30 dei 32 benchmark accademici comunemente utilizzati per la ricerca e sviluppo sui Large Language Model (LLM). Nota: questi compiti spaziano dalla comprensione di immagini naturali, audio e video al ragionamento matematico.
In un post introduttivo sul blog dedicato a Gemini, Google sostiene che Gemini Ultra sia il primo modello in assoluto a superare esperti umani su Massive Multitask Language Understanding (MMLU) con un punteggio del 90,0%. MMLU comprende 57 discipline diverse, tra cui matematica, fisica, storia, diritto, medicina ed etica, per valutare la capacità di risolvere problemi e la comprensione generale del mondo.
Il nuovo metodo di benchmark MMLU consente a Gemini di ottenere miglioramenti significativi invece di limitarsi a sfruttare le prime impressioni, utilizzando il proprio potere di ragionamento per riflettere più a fondo prima di rispondere a domande impegnative.
Ecco come si è comportato Gemini nei compiti testuali:
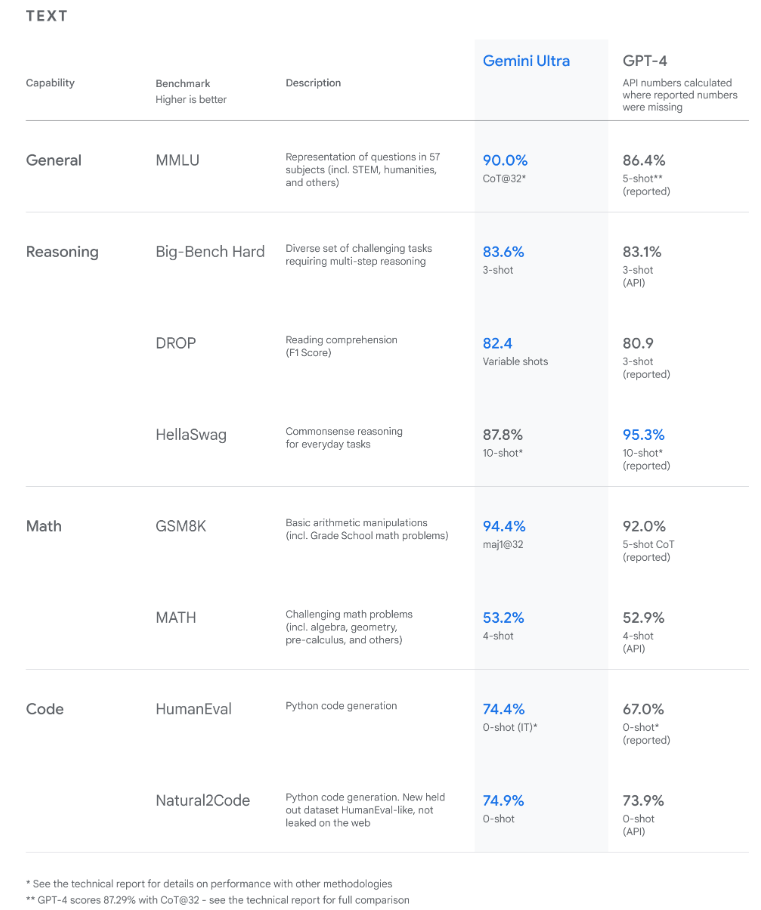
I risultati mostrano che Gemini supera le prestazioni allo stato dell'arte su un'ampia gamma di benchmark, inclusi testo e coding. [Fonte]
Il modello Gemini Ultra ha inoltre raggiunto lo stato dell'arte sul nuovo benchmark Massive Multidiscipline Multimodal Understanding (MMMU) con un punteggio del 59,4%. Questa valutazione consiste in compiti multimodali in vari domini che richiedono ragionamento deliberato.
Google ha dichiarato: "Nei benchmark sulle immagini che abbiamo testato, Gemini Ultra ha superato i precedenti modelli allo stato dell'arte senza l'assistenza di sistemi di riconoscimento ottico dei caratteri (OCR) che estraggono il testo dalle immagini per un'ulteriore elaborazione".
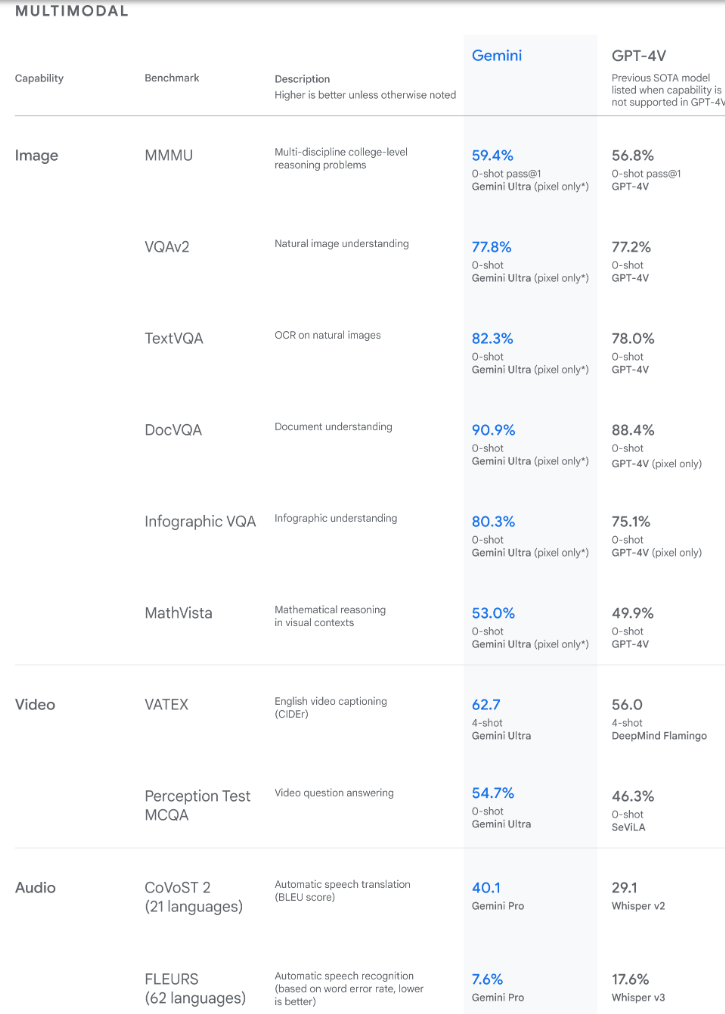
I risultati mostrano che Gemini supera inoltre le prestazioni allo stato dell'arte su un'ampia gamma di benchmark multimodali. [Fonte]
I benchmark fissati da Gemini dimostrano la multimodalità innata del modello e forniscono prove iniziali della sua capacità di ragionamento più sofisticato.
La domanda ovvia che sorge di solito è: "Come si confronta Gemini con GPT-4?"
Entrambi i modelli hanno set di funzionalità simili e possono interagire e interpretare dati testuali, di immagini, video, audio e codice, consentendo agli utenti di applicarli a vari compiti.
Gli utenti di entrambi gli strumenti hanno la possibilità di effettuare fact-checking, ma il modo in cui questa funzionalità viene fornita è diverso. Mentre GPT-4 di OpenAI fornisce link alle fonti per le affermazioni fatte, Gemini consente agli utenti di eseguire una ricerca Google per confermare la risposta tramite un pulsante.
È anche possibile potenziare entrambi i modelli con estensioni aggiuntive, sebbene, al momento della stesura, il modello Gemini di Google sia molto più limitato.
Ad esempio, con Gemini è possibile utilizzare strumenti Google come voli, mappe, YouTube e la suite di applicazioni Workspace. Al contrario, per GPT-4 di OpenAI è disponibile una selezione molto più ampia di plug-in ed estensioni, per lo più creati da terze parti. La creazione di immagini al volo è inoltre possibile con GPT-4; Gemini è progettato per supportare una funzionalità del genere, ma, al momento della stesura, non può farlo.
D'altra parte, i tempi di risposta di Gemini sono più rapidi rispetto a GPT-4, che talvolta può risultare rallentato o addirittura interrotto a causa dell'elevato volume di utenti sulla piattaforma.
I modelli Gemini di Google possono svolgere vari compiti attraverso diverse modalità, come la comprensione di testo, audio, immagini e video.
Grazie alla natura multimodale di Gemini, è anche possibile combinare modalità diverse per comprendere e generare output.
Esempi di casi d'uso di Gemini includono:
I modelli Gemini possono riassumere contenuti a partire da vari tipi di dati. Secondo un paper intitolato GEMINI: Controlling The Sentence-Level Summary Style in Abstractive Text Summarization, il modello Gemini "integra riscritture e un generatore per imitare, rispettivamente, le tecniche di riscrittura e astrazione delle frasi".
In pratica, Gemini seleziona in modo adattivo se riscrivere una specifica frase del documento o generare da zero una frase di riepilogo. I risultati degli esperimenti hanno rivelato che l'approccio usato da Gemini ha superato le baseline puramente astrattive e di riscrittura su tre dataset di riferimento, ottenendo i risultati migliori su WikiHow.
Gemini può generare testo in risposta a un prompt dell'utente — questo testo può anche essere prodotto tramite un'interfaccia chatbot in stile Q&A. Di conseguenza, Gemini può essere impiegato per gestire richieste dei clienti e offrire assistenza in modo naturale e coinvolgente, liberando gli agenti umani per dedicarsi a compiti più complessi e migliorando la soddisfazione dei clienti.
Può essere utilizzato anche per la scrittura creativa, ad esempio la co-scrittura di un romanzo, la composizione di poesie in vari stili o la generazione di sceneggiature per film e opere teatrali. Questo può aumentare significativamente la produttività degli autori e ridurre la tensione causata dal blocco dello scrittore.
Grazie alle loro ampie capacità multilingue, i modelli Gemini possono comprendere e tradurre oltre 100 lingue diverse. Secondo Google, Gemini supera le prestazioni allo stato dell'arte di Chat GPT-4V "su una serie di benchmark multimodali", come il riconoscimento automatico del parlato (ASR) e la traduzione automatica del parlato.
Gemini può comprendere e interpretare le immagini, rendendolo adatto per didascalie e casi d'uso di Q&A visivo. Il modello può anche analizzare elementi visivi complessi, inclusi diagrammi, figure e grafici, senza richiedere strumenti OCR esterni.
Gli sviluppatori possono usare Gemini per risolvere compiti di programmazione complessi e fare debugging del proprio codice. Il modello è in grado di comprendere, spiegare e generare nei linguaggi di programmazione più usati, come Python, Java, C++ e Go.
La nuova serie di Large Language Models (LLM) multimodali di Google, Gemini, è il successore di LaMDA e PaLM 2. Viene descritto come il set di LLM più avanzato dell'azienda, capace di comprendere testi, immagini, video, audio e compiti complessi come matematica e fisica. Gemini è anche in grado di generare codice di alta qualità in molti dei linguaggi di programmazione più popolari.
Il modello ha raggiunto capacità allo stato dell'arte in vari compiti e molti in Google ritengono che rappresenti un significativo passo avanti nel modo in cui l'IA può contribuire a migliorare la nostra vita quotidiana.
Continua a imparare con le seguenti risorse:
E prima di andare, non dimenticare di iscriverti al nostro canale YouTube. Abbiamo ottimi contenuti sui temi più rilevanti e di tendenza, incluso un tutorial su come creare app multimodali con Gemini, quindi dacci un'occhiata.
Inizia oggi il tuo percorso nell'IA!
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min



