
Kurs
Konzeptuelle Einführung in generative KI
2 Std.
117.2K
Google hat kürzlich sein neues generatives KI-Modell Gemini veröffentlicht. Es ist das Ergebnis einer Zusammenarbeit verschiedener Teams bei Google, darunter Mitglieder von Google Research.
Das Modell, das Google als das bislang leistungsfähigste und vielseitigste KI-System bezeichnet, wurde als multimodal konzipiert. Das bedeutet, Gemini kann unterschiedliche Datentypen wie Text, Audio, Bilder, Videos und Code verstehen.
Im weiteren Verlauf dieses Artikels gehen wir auf Folgendes ein:
Am 6. Dezember 2023 kündigte Google DeepMind Gemini 1.0 an. Zur Veröffentlichung beschrieb Google es als sein bislang fortschrittlichstes Set an Large Language Models (LLMs) und damit als Nachfolger des Pathways Language Model (PaLM 2), das im Mai desselben Jahres debütierte.
Gemini bezeichnet eine Familie multimodaler LLMs, die Texte, Bilder, Videos und Audio verstehen. Es heißt zudem, dass es komplexe Aufgaben in Mathematik und Physik lösen und hochwertigen Code in mehreren Programmiersprachen erzeugen kann.
Fun Fact: Sergey Brin, Mitgründer von Google, wird als einer der Beitragsleistenden zum Gemini-Modell genannt.
Bis vor Kurzem bestand der übliche Ansatz für multimodale Modelle darin, einzelne Komponenten für verschiedene Modalitäten zu trainieren und sie anschließend zusammenzusetzen, um bestimmte Funktionen nachzubilden. Solche Modelle brillierten mitunter bei einzelnen Aufgaben wie der Bildbeschreibung, taten sich aber mit anspruchsvollerer, komplexerem Schließen schwer.
Gemini wurde von Grund auf nativ multimodal entwickelt und bereits während des Pretrainings mit mehreren Modalitäten trainiert. Um die Wirksamkeit weiter zu steigern, hat Google das Modell mit zusätzlichen multimodalen Daten feinabgestimmt.
Laut Sundar Pichai, CEO von Google und Alphabet, und Demis Hassabis, CEO und Mitgründer von Google DeepMind, ist Gemini dadurch deutlich leistungsfähiger als bestehende multimodale Modelle, wenn es darum geht, eine breite Palette an Eingaben zu verstehen und zu begründen. Sie erklären zudem, Geminis Fähigkeiten seien „in nahezu allen Bereichen State of the Art“.
Zu den Kernfunktionen des Gemini-Modells gehören:
Multimodale KI ist ein neues, zunehmend verbreitetes Paradigma, bei dem unterschiedliche Datentypen mit mehreren Algorithmen kombiniert werden, um höhere Leistung zu erzielen. Gemini nutzt dieses Paradigma und integriert sich nahtlos mit verschiedenen Datentypen. Du kannst Bilder, Audio, Text und andere Formate eingeben und erhältst dadurch natürlichere Interaktionen mit der KI.
Gemini nutzt Googles TPUv5-Chips und soll damit fünfmal leistungsstärker sein als GPT-4. Die schnellere Verarbeitung erlaubt es, komplexe Aufgaben vergleichsweise mühelos anzugehen und mehrere Anfragen parallel zu bedienen.
Gemini wurde auf einem riesigen Datensatz aus Text und Code trainiert. So kann das Modell auf sehr aktuelle Informationen zugreifen und präzise, verlässliche Antworten liefern. Laut Google übertrifft das Modell OpenAIs GPT-4 und „Expert:innen-Niveau“-Menschen in verschiedenen Intelligenztests (z. B. MMLU-Benchmark).
Gemini 1.0 kann in den gebräuchlichsten Programmiersprachen wie Python, Java, C++ und Go hochwertigen Code verstehen, erklären und generieren – damit zählt es zu den führenden Foundation-Modellen für Programmierung weltweit.
Das Modell schneidet auch in mehreren Coding-Benchmarks hervorragend ab, darunter HumanEval, ein vielbeachteter Industriestandard zur Bewertung von Programmierleistungen; zudem lieferte es starke Ergebnisse auf Googles internem, zurückgehaltenem Datensatz, der auf von Autor:innen verfasstem Code statt auf Webdaten basiert.
Googles KI-Prinzipien und Richtlinien wurden um neue Schutzmechanismen erweitert, um Geminis multimodalen Fähigkeiten Rechnung zu tragen. Google sagt: „Gemini verfügt über die umfangreichsten Sicherheitsevaluierungen aller bisherigen Google-KI-Modelle, einschließlich zu Bias und Toxizität.“ Außerdem habe man „neue Forschung zu potenziellen Risikobereichen wie Cyber-Offense, Überzeugungskraft und Autonomie durchgeführt und die erstklassigen adversarialen Testverfahren von Google Research angewendet, um kritische Sicherheitsfragen vor der Einführung von Gemini zu identifizieren.“
Google sagt, Gemini, der Nachfolger von LaMDA und PaLM 2, sei das „flexibelste Modell bisher — es läuft effizient von Rechenzentren bis hin zu Mobilgeräten“. Man geht zudem davon aus, dass Geminis State-of-the-Art-Fähigkeiten die Art und Weise verbessern, wie Entwickler:innen und Unternehmen mit KI bauen und skalieren.
Die erste Version, naheliegenderweise Gemini 1.0 genannt, erschien in drei Größen:
Seit dem 13. Dezember 2023 können Entwickler:innen und Unternehmenskunden über die Gemini-API in Google AI Studio oder Google Cloud Vertex AI auf Gemini Pro zugreifen.
Hinweis: Google AI Studio ist eine frei verfügbare, browserbasierte IDE, mit der Entwickler:innen generative Modelle prototypen und Anwendungen per API-Schlüssel einfach starten können. Google Cloud Vertex ist hingegen eine voll verwaltete KI-Plattform, die alle Werkzeuge bietet, um generative KI zu entwickeln und zu nutzen. Laut Google „ermöglicht Vertex AI die Anpassung von Gemini mit voller Datenkontrolle und profitiert von zusätzlichen Google-Cloud-Funktionen für Enterprise-Sicherheit, Safety, Datenschutz sowie Data Governance und Compliance.“
Über AICore, eine neue Systemfunktion von Android 14, können Android-Entwickler:innen ab den Pixel-8-Pro-Geräten mit Gemini Nano – dem effizientesten Modell für On-Device-Aufgaben – entwickeln.
Die Gemini-Modelle wurden vor der Veröffentlichung intensiv getestet, um ihre Leistung über ein breites Aufgabenspektrum zu bewerten. Google sagt, sein Modell Gemini Ultra übertrifft in 30 von 32 gängigen akademischen Benchmarks für die Forschung und Entwicklung großer Sprachmodelle (LLMs) den bisherigen Stand der Technik. Diese Aufgaben reichen von natürlichem Bild-, Audio- und Videoverständnis bis hin zu mathematischem Schließen.
In einem Einführungsblogbeitrag zu Gemini behauptet Google, Gemini Ultra sei das erste Modell, das menschliche Expert:innen bei der Massive Multitask Language Understanding (MMLU) mit 90,0 % übertrifft. MMLU umfasst 57 verschiedene Fächer – darunter Mathematik, Physik, Geschichte, Recht, Medizin und Ethik – und bewertet Problemlösefähigkeit und Allgemeinwissen.
Die neue MMLU-Benchmark-Methode ermöglicht es Gemini, deutliche Fortschritte zu erzielen, indem das Modell seine Begründungsfähigkeit nutzt, um vor der Antwort länger über schwierige Fragen nachzudenken, statt nur auf den ersten Eindruck zu setzen.
So schnitt Gemini bei Textaufgaben ab:
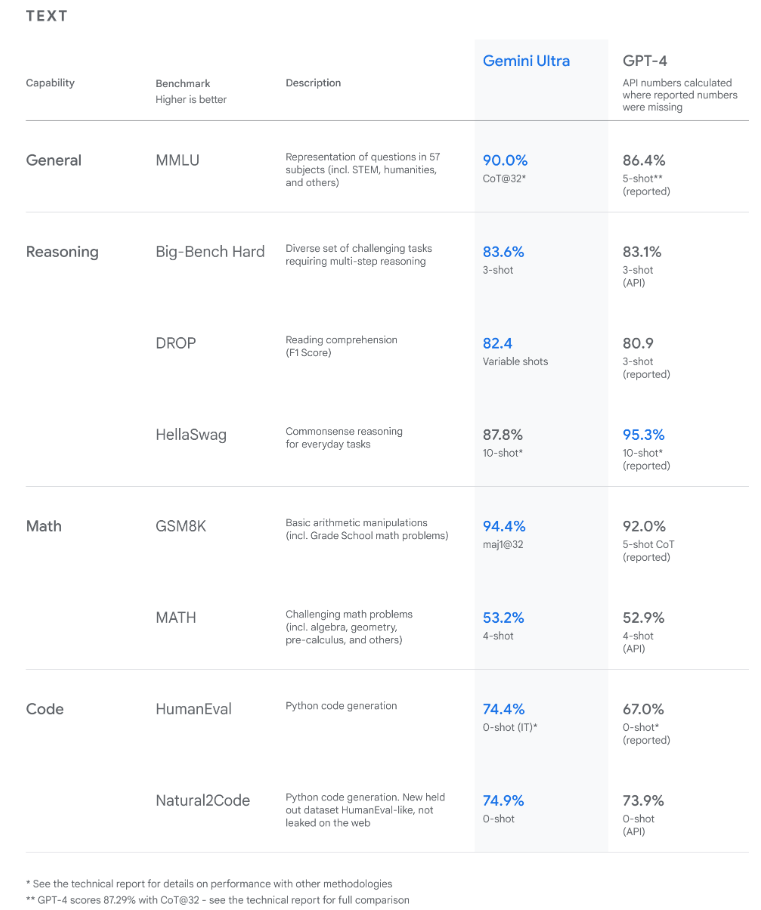
Die Ergebnisse zeigen, dass Gemini die bisherige Spitzenleistung in zahlreichen Benchmarks übertrifft, darunter Text und Coding. [Quelle]
Das Gemini-Ultra-Modell erreichte zudem State-of-the-Art auf dem neuen Massive Multidiscipline Multimodal Understanding (MMMU)-Benchmark mit 59,4 %. Diese Bewertung umfasst multimodale Aufgaben aus verschiedenen Bereichen, die bewusstes Begründen erfordern.
Google sagte: „Bei den von uns getesteten Bild-Benchmarks übertraf Gemini Ultra frühere State-of-the-Art-Modelle ohne Unterstützung durch OCR-Systeme, die Text aus Bildern für die Weiterverarbeitung extrahieren.“
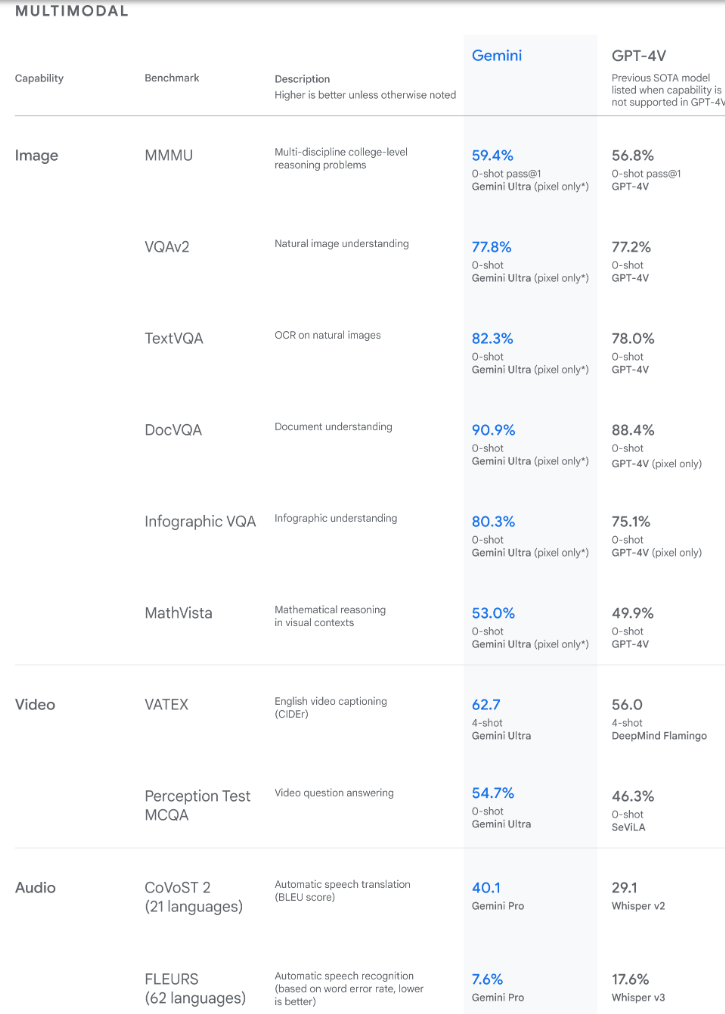
Die Ergebnisse zeigen, dass Gemini auch in einer Vielzahl multimodaler Benchmarks die Spitzenleistung übertrifft. [Quelle]
Die von Gemini erzielten Benchmarks belegen die angeborene Multimodalität des Modells und liefern frühe Hinweise auf seine Fähigkeit zu anspruchsvollerem Begründen.
Die naheliegende Frage lautet: „Wie schlägt sich Gemini im Vergleich zu GPT-4?“
Beide Modelle verfügen über ähnliche Funktionsumfänge und können mit Text-, Bild-, Video-, Audio- und Code-Daten interagieren und sie interpretieren. Dadurch lassen sie sich in vielen Aufgabenbereichen einsetzen.
Beide Tools bieten Möglichkeiten zum Faktencheck, setzen sie jedoch unterschiedlich um. Während OpenAIs GPT-4 Quelllinks zu seinen Aussagen liefert, ermöglicht Gemini per Klick eine Google-Suche zur Bestätigung der Antwort.
Beide Modelle lassen sich durch Erweiterungen ausbauen, wobei Googles Gemini zum Zeitpunkt des Schreibens noch deutlich eingeschränkter ist.
So lassen sich in Gemini Google-Dienste wie Flights, Maps, YouTube und die Workspace-Apps nutzen. Dem gegenüber steht bei OpenAIs GPT-4 eine deutlich größere Auswahl an Plug-ins und Erweiterungen, von denen die meisten von Drittanbietern stammen. Auch die spontane Bildgenerierung ist mit GPT-4 möglich; Gemini ist grundsätzlich dazu ausgelegt, kann es zum Zeitpunkt des Schreibens jedoch noch nicht.
Dafür sind Geminis Antwortzeiten schneller als die von GPT-4, das aufgrund der hohen Auslastung der Plattform gelegentlich langsamer wird oder Anfragen ganz abbricht.
Die Gemini-Modelle von Google können zahlreiche Aufgaben über mehrere Modalitäten hinweg ausführen, darunter das Verständnis von Text, Audio, Bildern und Videos.
Aufgrund der multimodalen Natur von Gemini ist es auch möglich, verschiedene Modalitäten zu kombinieren, um Ausgaben zu verstehen und zu generieren.
Beispiele für Anwendungsfälle von Gemini sind:
Gemini-Modelle können Inhalte aus verschiedenen Datentypen zusammenfassen. Laut dem Paper GEMINI: Controlling The Sentence-Level Summary Style in Abstractive Text Summarization „integriert das Gemini-Modell Umschreibungen und einen Generator, um Satzumschreibung bzw. Abstraktionstechniken zu imitieren“.
Konkret wählt Gemini adaptiv, ob ein bestimmter Satz eines Dokuments umgeschrieben oder ein zusammenfassender Satz komplett neu generiert wird. Die Experimente zeigten, dass Geminis Ansatz die rein abstraktiven und die reinen Umschreibungs-Baselines auf drei Benchmark-Datensätzen übertraf und auf WikiHow die besten Ergebnisse erzielte.
Gemini kann auf Prompts mit Textausgaben reagieren – auch über eine Q&A-Chatbot-Oberfläche. So lässt sich Gemini für Kundenanfragen einsetzen und bietet dabei natürliche, ansprechende Assistance. Das entlastet menschliche Teams, die sich stärker auf komplexe Aufgaben konzentrieren können, und steigert die Kundenzufriedenheit.
Auch für kreatives Schreiben kann es genutzt werden, etwa als Co-Autor für Romane, zum Verfassen von Gedichten in verschiedenen Stilen oder zum Erstellen von Drehbüchern für Filme und Theaterstücke. Das kann die Produktivität deutlich steigern und Schreibblockaden lösen.
Mit ihren breiten mehrsprachigen Fähigkeiten können die Gemini-Modelle über 100 Sprachen verstehen und übersetzen. Laut Google übertrifft Gemini die Spitzenleistung von Chat GPT-4V „in einer Reihe multimodaler Benchmarks“, etwa bei der automatischen Spracherkennung (ASR) und der automatischen Sprachübersetzung.
Gemini kann Bilder verstehen und interpretieren, was es für Bildunterschriften und visuelle Q&A-Szenarien geeignet macht. Das Modell kann komplexe Visualisierungen wie Diagramme, Abbildungen und Charts analysieren, ohne externe OCR-Tools zu benötigen.
Entwickler:innen können Gemini nutzen, um komplexe Programmieraufgaben zu lösen und Code zu debuggen. Das Modell versteht, erklärt und generiert in den am häufigsten genutzten Programmiersprachen wie Python, Java, C++ und Go.
Gemini, Googles neues Set multimodaler Large Language Models (LLMs), ist der Nachfolger von LaMDA und PaLM 2. Google beschreibt es als sein fortschrittlichstes Set an LLMs, das Texte, Bilder, Videos, Audio sowie komplexe Aufgaben wie Mathematik und Physik versteht. Zudem kann Gemini in vielen populären Programmiersprachen hochwertigen Code generieren.
Das Modell hat in verschiedenen Aufgaben State-of-the-Art-Leistung erreicht, und viele bei Google sehen darin einen großen Schritt nach vorn, wie KI unseren Alltag verbessern kann.
Lerne weiter mit diesen Ressourcen:
Und bevor du gehst: Abonniere unseren YouTube-Kanal. Dort findest du starke Inhalte zu allen relevanten und trendigen Themen – inklusive eines Tutorials, wie du multimodale Apps mit Gemini baust. Schau unbedingt rein.
Starte heute deine KI-Reise!
Kurs
Kurs
Kurs