
Curso
Conceitos de IA Generativa
2 h
117.2K
O Google lançou recentemente seu novo modelo de IA generativa, o Gemini. Ele é resultado de um esforço colaborativo de várias equipes do Google, incluindo membros do Google Research.
O modelo, que o Google descreve como a IA mais capaz e versátil que já desenvolveu, foi projetado para ser multimodal. Isso significa que o Gemini consegue compreender vários tipos de dados, como texto, áudio, imagens, vídeo e código.
Ao longo deste artigo, vamos abordar:
Em 6 de dezembro de 2023, o Google DeepMind anunciou o Gemini 1.0. No lançamento, o Google o descreveu como seu conjunto mais avançado de Large Language Models (LLMs), sucedendo o Pathways Language Model (PaLM 2), apresentado em maio do mesmo ano.
Gemini define uma família de LLMs multimodais capazes de entender textos, imagens, vídeos e áudio. Diz-se também que ele executa tarefas complexas em matemática e física, além de gerar código de alta qualidade em várias linguagens de programação.
Curiosidade: Sergey Brin, cofundador do Google, é creditado como um dos colaboradores do modelo Gemini.
Até recentemente, o procedimento padrão para desenvolver modelos multimodais consistia em treinar componentes individuais para diferentes modalidades e depois combiná-los para imitar parte da funcionalidade. Esses modelos às vezes se destacavam em tarefas específicas, como descrever imagens, mas tinham dificuldade com raciocínio mais sofisticado e complexo.
O Gemini foi projetado para ser multimodal desde a origem; por isso, foi pré-treinado em várias modalidades desde o começo. Para refinar ainda mais sua eficácia, o Google o ajustou com dados multimodais adicionais.
Como resultado, segundo Sundar Pichai, CEO do Google e da Alphabet, e Demis Hassabis, CEO e cofundador do Google DeepMind, o Gemini é significativamente mais capaz do que os modelos multimodais existentes para entender e raciocinar sobre uma ampla variedade de entradas, desde a base. Eles também afirmam que as capacidades do Gemini são “o estado da arte em praticamente todos os domínios”.
Os principais recursos do modelo Gemini incluem:
IA multimodal é um novo paradigma que vem ganhando força, no qual diferentes tipos de dados são combinados a múltiplos algoritmos para alcançar desempenho superior. O Gemini aproveita esse paradigma, integrando-se bem a diversos tipos de dados. Você pode enviar imagens, áudio, texto e outros formatos, o que resulta em interações com IA mais naturais.
O Gemini utiliza os chips TPUv5 do Google, o que supostamente o torna cinco vezes mais potente que o GPT-4. Com processamento mais rápido, o Gemini consegue lidar com tarefas complexas com relativa facilidade e atender múltiplas solicitações ao mesmo tempo.
O Gemini foi treinado em um enorme conjunto de textos e códigos. Isso garante que o modelo acesse informações atualizadas e forneça respostas precisas e confiáveis às suas perguntas. Segundo o Google, o modelo supera o GPT-4, da OpenAI, e humanos em “nível especialista” em vários testes de inteligência (por exemplo, o benchmark MMLU).
O Gemini 1.0 entende, explica e gera código de alta qualidade nas linguagens mais usadas, como Python, Java, C++ e Go — o que o coloca entre os principais modelos de base para programação no mundo.
O modelo também se destaca em vários benchmarks de programação, incluindo o HumanEval, um padrão amplamente respeitado para avaliar desempenho em tarefas de código; além disso, teve bom desempenho no conjunto de dados interno e reservado do Google, que utiliza código gerado por autores em vez de informações da web.
Novas proteções foram adicionadas aos Princípios de IA e às políticas do Google para contemplar as capacidades multimodais do Gemini. O Google afirma: “O Gemini tem as avaliações de segurança mais abrangentes de qualquer modelo de IA do Google até hoje, incluindo viés e toxicidade.” Eles também disseram que “conduziram pesquisas inéditas sobre áreas de risco como ciberofensiva, persuasão e autonomia, e aplicaram as técnicas de teste adversarial de ponta do Google Research para identificar questões críticas de segurança antes da implantação do Gemini.”
Segundo o Google, o Gemini, sucessor do LaMDA e do PaLM 2, é seu “modelo mais flexível até agora — capaz de rodar com eficiência desde data centers até dispositivos móveis”. O Google também acredita que as capacidades de ponta do Gemini vão melhorar como desenvolvedores e clientes corporativos constroem e escalam com IA.
A primeira versão do Gemini, como era de se esperar chamada de Gemini 1.0, foi lançada em três tamanhos:
Desde 13 de dezembro de 2023, desenvolvedores e clientes corporativos podem acessar o Gemini Pro via API do Gemini no Google AI Studio ou no Google Cloud Vertex AI.
Observação: o Google AI Studio é um IDE no navegador, gratuito, que desenvolvedores podem usar para prototipar modelos generativos e lançar aplicativos facilmente usando uma chave de API. Já o Google Cloud Vertex é uma plataforma de IA totalmente gerenciada que oferece todas as ferramentas necessárias para criar e usar IA generativa. De acordo com o Google, “o Vertex AI permite personalizar o Gemini com controle total dos dados e se beneficia de recursos adicionais do Google Cloud para segurança corporativa, proteção, privacidade, governança e conformidade de dados”.
Por meio do AICore, um novo recurso do sistema no Android 14, desenvolvedores Android, começando pelos dispositivos Pixel 8 Pro, podem construir com o Gemini Nano, o modelo mais eficiente para tarefas no dispositivo.
Os modelos Gemini passaram por testes extensivos para avaliar seu desempenho em uma ampla gama de tarefas antes do lançamento. O Google afirma que o modelo Gemini Ultra supera o estado da arte existente em 30 dos 32 benchmarks acadêmicos comumente usados para pesquisa e desenvolvimento de LLMs. Essas tarefas vão de compreensão de imagens, áudio e vídeo naturais até raciocínio matemático.
Em um post introdutório sobre o Gemini, o Google afirma que o Gemini Ultra é o primeiro modelo a superar especialistas humanos no Massive Multitask Language Understanding (MMLU), com pontuação de 90,0%. O MMLU abrange 57 disciplinas diferentes, incluindo matemática, física, história, direito, medicina e ética, para avaliar a capacidade de resolver problemas e o entendimento geral de mundo.
O novo método de benchmark do MMLU permite que o Gemini faça avanços significativos, em vez de apenas aproveitar suas primeiras impressões, usando seu poder de raciocínio para deliberar melhor antes de responder a perguntas desafiadoras.
Veja como o Gemini se saiu em tarefas de texto:
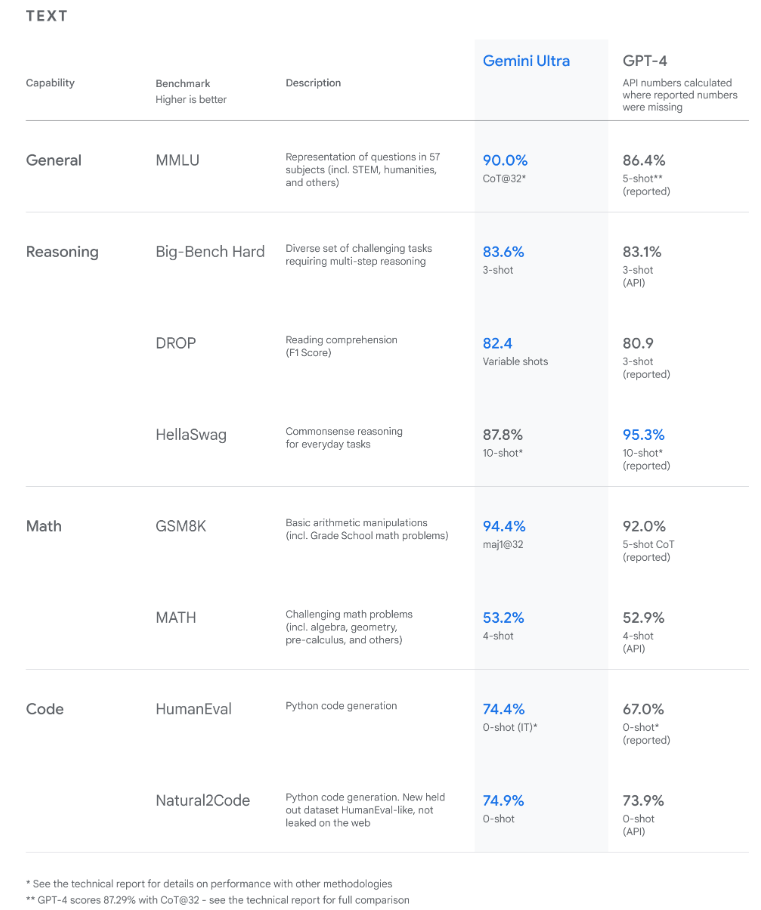
Os resultados mostram que o Gemini supera o desempenho de ponta em uma ampla variedade de benchmarks, incluindo texto e código. [Fonte]
O modelo Gemini Ultra também atingiu o estado da arte no novo benchmark Massive Multidiscipline Multimodal Understanding (MMMU), com pontuação de 59,4%. Essa avaliação consiste em tarefas multimodais em vários domínios que exigem raciocínio cuidadoso.
O Google disse: “Nos benchmarks de imagem que testamos, o Gemini Ultra superou os modelos anteriores de ponta sem ajuda de sistemas de reconhecimento óptico de caracteres (OCR) que extraem texto de imagens para processamento posterior.”
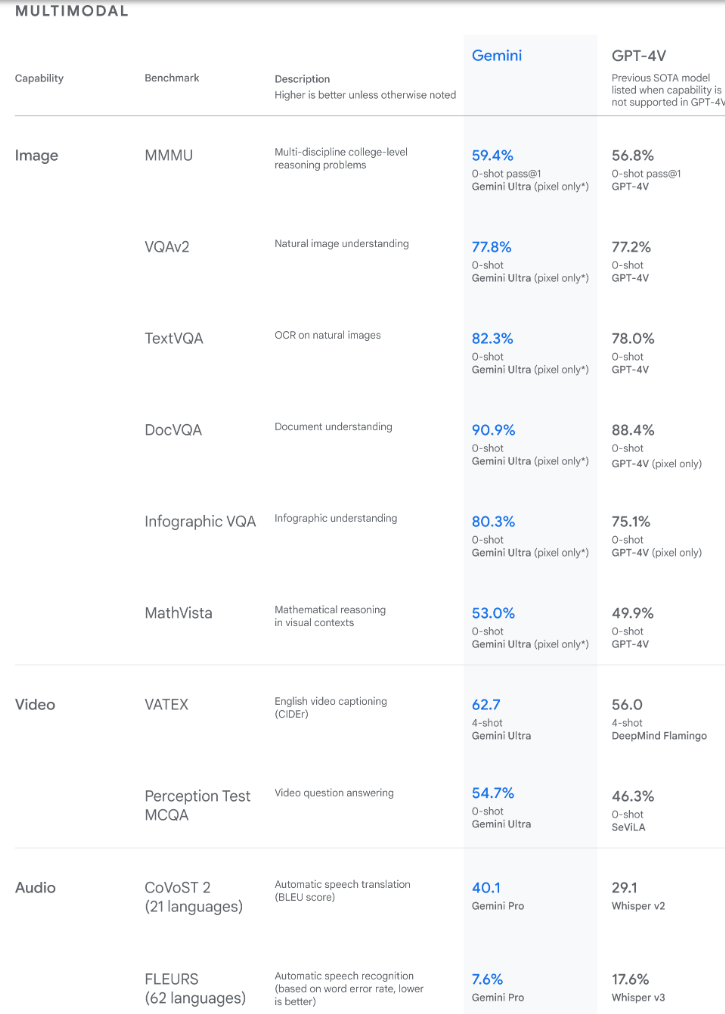
Os resultados mostram que o Gemini também supera o desempenho de ponta em uma ampla variedade de benchmarks multimodais. [Fonte]
Os benchmarks estabelecidos pelo Gemini demonstram sua multimodalidade nativa e mostram evidências iniciais de sua capacidade de raciocínio mais sofisticado.
A pergunta óbvia que costuma surgir em seguida é: “Como o Gemini se compara ao GPT-4?”
Ambos os modelos têm conjuntos de recursos semelhantes e conseguem interagir e interpretar dados de texto, imagem, vídeo, áudio e código, permitindo que os usuários os apliquem a várias tarefas.
Usuários das duas ferramentas podem verificar fatos, mas a forma como cada uma oferece essa função é diferente. Enquanto o GPT-4 da OpenAI fornece links de origem para as afirmações que faz, o Gemini permite que o usuário faça uma busca no Google para confirmar a resposta com um clique.
Também é possível ampliar as capacidades de ambos com extensões, embora, no momento da escrita, o Gemini do Google seja bem mais limitado.
Por exemplo, é possível usar ferramentas do Google como voos, Maps, YouTube e a suíte Workspace com o Gemini. Já para o GPT-4 da OpenAI há uma seleção muito maior de plug-ins e extensões, a maioria criada por terceiros. A criação de imagens em tempo real também é possível com o GPT-4; o Gemini foi projetado para ter essa capacidade, mas, até o momento, ainda não a oferece.
Por outro lado, os tempos de resposta do Gemini são mais rápidos que os do GPT-4, que às vezes pode ficar lento ou até interromper respostas devido ao grande volume de usuários na plataforma.
Os modelos Gemini do Google executam diversas tarefas em várias modalidades, como compreensão de texto, áudio, imagem e vídeo.
Também é possível combinar diferentes modalidades para entender e gerar saídas graças à natureza multimodal do Gemini.
Alguns exemplos de casos de uso do Gemini incluem:
Os modelos Gemini conseguem resumir conteúdo de diferentes tipos de dados. Segundo o artigo GEMINI: Controlling The Sentence-Level Summary Style in Abstractive Text Summarization, o modelo Gemini “integra reescritas e um gerador para imitar técnicas de reescrita de sentenças e de abstração, respectivamente”.
Ou seja, o Gemini seleciona de forma adaptativa se deve reescrever uma frase específica do documento ou gerar uma frase de resumo totalmente do zero. Os resultados dos experimentos mostraram que a abordagem do Gemini superou as linhas de base puramente abstrativas e de reescrita em três conjuntos de benchmark, alcançando os melhores resultados no WikiHow.
O Gemini pode gerar texto em resposta a um prompt do usuário — e também pode operar em um formato de chatbot de perguntas e respostas. Assim, o Gemini pode ser implantado para lidar com dúvidas de clientes e oferecer suporte de forma natural e envolvente, liberando os agentes humanos para se dedicarem a tarefas mais complexas e melhorarem a satisfação do cliente.
Ele também pode ser usado para escrita criativa, como coautoria de um romance, composição de poesias em diferentes estilos ou criação de roteiros para filmes e peças. Isso pode aumentar significativamente a produtividade de escritores e reduzir o bloqueio criativo.
Com ampla capacidade multilíngue, os modelos Gemini entendem e traduzem mais de 100 idiomas. Segundo o Google, o Gemini supera o desempenho de ponta do Chat GPT-4V “em uma série de benchmarks multimodais”, como reconhecimento automático de fala (ASR) e tradução automática de fala.
O Gemini entende e interpreta imagens, sendo adequado para legendas de imagens e casos de uso de perguntas e respostas visuais. O modelo também interpreta visuais complexos, como diagramas, figuras e gráficos, sem precisar de ferramentas externas de OCR.
Desenvolvedores podem usar o Gemini para resolver tarefas complexas de programação e depurar seus códigos. O modelo entende, explica e gera nas linguagens mais usadas, como Python, Java, C++ e Go.
O novo conjunto de LLMs multimodais do Google, o Gemini, sucede o LaMDA e o PaLM 2. O Google o descreve como seu conjunto mais avançado de LLMs, capaz de compreender textos, imagens, vídeos, áudio e tarefas complexas como matemática e física. O Gemini também gera código de alta qualidade em muitas das linguagens de programação mais populares.
O modelo alcançou desempenho de ponta em várias tarefas, e muitos no Google acreditam que ele representa um grande salto em como a IA pode melhorar nosso dia a dia.
Continue aprendendo com estes recursos:
E antes de ir, não esqueça de se inscrever no nosso canal no YouTube. Temos conteúdos incríveis sobre os temas mais relevantes e em alta, incluindo um tutorial sobre como construir apps multimodais com o Gemini. Vale a pena conferir.
Comece sua jornada em IA hoje!
Curso
Curso
Curso
blog
Javier Canales Luna
14 min
blog
Josep Ferrer
8 min
blog
Abid Ali Awan
9 min
Tutorial
Josep Ferrer
11 min
Tutorial
Dimitri Didmanidze
8 min
Tutorial
Moez Ali
11 min






