
Last chance! 50% off DataCamp Premium
Sale ends in
Google ने हाल ही में अपना नया जनरेटिव एआई मॉडल, Gemini, जारी किया है। यह Google की विभिन्न टीमों, जिनमें Google Research के सदस्य भी शामिल हैं, के सहयोग का परिणाम है।
Google के अनुसार अब तक विकसित किया गया उनका सबसे सक्षम और जनरल-पर्पस एआई होने के नाते, यह मॉडल मल्टीमोडल रूप में डिज़ाइन किया गया है। यानी Gemini पाठ, ऑडियो, चित्र, वीडियो और कोड जैसे विविध डेटा प्रकारों को समझ सकता है।
इस लेख के शेष भाग में, हम कवर करेंगे:
6 दिसंबर, 2023 को, Google DeepMind ने Gemini 1.0 की घोषणा की। जारी करते समय, Google ने इसे अपने सबसे उन्नत लार्ज लैंग्वेज मॉडल्स (LLMs) के सेट के रूप में वर्णित किया, जो उसी वर्ष मई में लॉन्च हुए Pathways Language Model (PaLM 2) से आगे निकलता है।
Gemini मल्टीमोडल LLMs का एक परिवार है जो पाठ, चित्र, वीडियो और ऑडियो को समझने में सक्षम है। कहा जाता है कि यह गणित और भौतिकी में जटिल कार्यों को करने में सक्षम है, साथ ही कई प्रोग्रामिंग भाषाओं में उच्च-गुणवत्ता का कोड जेनरेट कर सकता है।
रोचक तथ्य: Google के सह-संस्थापक सर्गेई ब्रिन को Gemini मॉडल के योगदानकर्ताओं में से एक के रूप में श्रेय दिया जाता है।
हाल तक, मल्टीमोडल मॉडल विकसित करने की मानक प्रक्रिया में विभिन्न मोडॅलिटी के लिए अलग-अलग घटकों को प्रशिक्षित करना और फिर कुछ कार्यक्षमता की नकल करने के लिए उन्हें जोड़ना शामिल था। ऐसे मॉडल कभी-कभी कुछ कार्यों, जैसे कि छवियों का वर्णन करने में उत्कृष्ट प्रदर्शन करते थे, लेकिन अधिक परिष्कृत और जटिल तर्क में उन्हें परेशानी होती थी।
Gemini को मूल रूप से मल्टीमोडल होने के लिए डिज़ाइन किया गया था; इसलिए, इसे शुरू से ही कई मोडॅलिटी पर प्री-ट्रेन किया गया। इसकी प्रभावशीलता को और निखारने के लिए, Google ने इसे अतिरिक्त मल्टीमोडल डेटा के साथ फाइन-ट्यून किया।
नतीजतन, सुंदर पिचाई, जो Google और Alphabet के CEO हैं, और डेमिस हासाबिस, Google DeepMind के CEO और सह-संस्थापक, के अनुसार, Gemini मौजूदा मल्टीमोडल मॉडलों की तुलना में जमीनी स्तर से विस्तृत इनपुट को समझने और उन पर तर्क करने में काफी अधिक सक्षम है। वे यह भी कहते हैं कि Gemini की क्षमताएँ “लगभग हर डोमेन में स्टेट-ऑफ-द-आर्ट” हैं।
Gemini मॉडल की प्रमुख विशेषताएँ शामिल हैं:
मल्टीमोडल एआई एक उभरता हुआ प्रतिमान है जिसमें अलग-अलग डेटा प्रकारों को अनेक एल्गोरिद्म के साथ जोड़ा जाता है ताकि बेहतर प्रदर्शन हासिल हो सके। Gemini इसी प्रतिमान का उपयोग करता है, यानी यह विभिन्न डेटा प्रकारों के साथ अच्छी तरह एकीकृत होता है। आप चित्र, ऑडियो, पाठ और अन्य डेटा प्रकार इनपुट कर सकते हैं, जिससे एआई के साथ अधिक स्वाभाविक बातचीत संभव होती है।
Gemini Google के TPUv5 चिप्स का लाभ उठाता है, जिससे कथित तौर पर यह GPT-4 से पाँच गुना अधिक शक्तिशाली बनता है। तेज प्रोसेसिंग Gemini को जटिल कार्यों को अपेक्षाकृत आसानी से निपटाने और एक साथ कई अनुरोधों को संभालने में सक्षम बनाती है।
Gemini को पाठ और कोड के एक विशाल डेटासेट पर प्रशिक्षित किया गया है। यह सुनिश्चित करता है कि मॉडल नवीनतम जानकारी तक पहुँच रखता है और आपकी क्वेरीज के लिए सटीक और विश्वसनीय उत्तर प्रदान कर सकता है। Google के अनुसार, यह मॉडल OpenAI के GPT-4 और विभिन्न इंटेलिजेंस परीक्षणों (जैसे, MMLU बेंचमार्क) में “विशेषज्ञ स्तर” के मनुष्यों से भी बेहतर प्रदर्शन करता है।
Gemini 1.0 सबसे व्यापक रूप से उपयोग की जाने वाली प्रोग्रामिंग भाषाओं, जैसे Python, Java, C++, और Go में उच्च-गुणवत्ता का कोड समझ, समझा और जेनरेट कर सकता है — यह इसे वैश्विक स्तर पर कोडिंग के लिए प्रमुख फ़ाउंडेशन मॉडलों में से एक बनाता है।
मॉडल कई कोडिंग बेंचमार्क्स में भी उत्कृष्ट प्रदर्शन करता है, जिनमें HumanEval शामिल है, जो कोडिंग कार्यों पर प्रदर्शन का आकलन करने के लिए एक प्रतिष्ठित इंडस्ट्री स्टैंडर्ड है; इसने Google के आंतरिक, होल्ड-आउट डेटासेट पर भी अच्छा प्रदर्शन किया, जो वेब की जानकारी के बजाय लेखक-जनित कोड का उपयोग करता है।
Google के एआई प्रिंसिपल्स और नीतियों में Gemini की मल्टीमोडल क्षमताओं को ध्यान में रखते हुए नए सुरक्षा उपाय जोड़े गए हैं। Google कहता है, “Gemini में अब तक के किसी भी Google एआई मॉडल की तुलना में सबसे व्यापक सुरक्षा मूल्यांकन शामिल हैं, जिनमें बायस और टॉक्सिसिटी भी शामिल हैं।” उन्होंने यह भी कहा कि उन्होंने “संभावित जोखिम क्षेत्रों जैसे साइबर-ऑफेंस, मनोविनय और स्वायत्तता पर नई रिसर्च की है, और Google Research की सर्वश्रेष्ठ-इन-क्लास विरोधी परीक्षण तकनीकों को लागू किया है ताकि Gemini की तैनाती से पहले महत्वपूर्ण सुरक्षा मुद्दों की पहचान की जा सके।”
Google का कहना है कि LaMDA और PaLM 2 के उत्तराधिकारी के रूप में Gemini उनका “अब तक का सबसे लचीला मॉडल है — जो डेटा सेंटर्स से लेकर मोबाइल डिवाइसेज तक हर जगह कुशलतापूर्वक चल सकता है।” उनका यह भी मानना है कि Gemini की स्टेट-ऑफ-द-आर्ट क्षमताएँ डेवलपर्स और बिजनेस क्लाइंट्स के एआई के साथ बिल्ड और स्केल करने के तरीकों में सुधार करेंगी।
Gemini का पहला संस्करण, जिसका नाम स्वाभाविक रूप से Gemini 1.0 है, तीन अलग-अलग साइज में जारी किया गया:
13 दिसंबर, 2023 से, डेवलपर्स और एंटरप्राइज ग्राहक Google AI Studio या Google Cloud Vertex AI में Gemini की API के माध्यम से Gemini Pro तक पहुँच सकते हैं।
ध्यान दें कि Google AI Studio एक निःशुल्क, ब्राउज़र-आधारित IDE है जिसका उपयोग डेवलपर्स जनरेटिव मॉडलों का प्रोटोटाइप बनाने और API कुंजी के माध्यम से आसानी से एप्लिकेशन लॉन्च करने के लिए कर सकते हैं। दूसरी ओर, Google Cloud Vertex एक पूर्ण-प्रबंधित एआई प्लेटफ़ॉर्म है जो जनरेटिव एआई बनाने और उपयोग करने के लिए आवश्यक सभी टूल प्रदान करता है। Google के अनुसार, “Vertex AI Gemini के कस्टमाइजेशन की अनुमति देता है, जिसमें पूर्ण डेटा नियंत्रण होता है, और एंटरप्राइज सुरक्षा, सेफ्टी, प्राइवेसी तथा डेटा गवर्नेंस और अनुपालन के लिए अतिरिक्त Google Cloud फीचर्स का लाभ मिलता है।”
AICore के माध्यम से, जो Android 14 के साथ एक नया सिस्टम फीचर है, Android डेवलपर्स Pixel 8 Pro डिवाइस से शुरू करते हुए, ऑन-डिवाइस कार्यों के लिए सबसे दक्ष मॉडल Gemini Nano के साथ बिल्ड कर सकते हैं।
रिलीज़ से पहले Gemini मॉडलों का व्यापक परीक्षण किया गया ताकि विभिन्न प्रकार के कार्यों पर उनके प्रदर्शन का आकलन किया जा सके। Google का कहना है कि उसका Gemini Ultra मॉडल लार्ज लैंग्वेज मॉडल (LLM) अनुसंधान और विकास के लिए सामान्यतः उपयोग किए जाने वाले 32 में से 30 अकादमिक बेंचमार्क्स पर मौजूदा स्टेट-ऑफ-द-आर्ट परिणामों से बेहतर है। ध्यान दें कि ये कार्य नेचुरल इमेज, ऑडियो और वीडियो समझ से लेकर गणितीय तर्क तक फैले हुए हैं।
Gemini के परिचयात्मक ब्लॉग पोस्ट में, Google का दावा है कि Gemini Ultra Massive Multitask Language Understanding (MMLU) पर 90.0% स्कोर के साथ मानव विशेषज्ञों से बेहतर प्रदर्शन करने वाला पहला मॉडल है। ध्यान दें कि MMLU में 57 अलग-अलग विषय शामिल हैं, जिनमें गणित, भौतिकी, इतिहास, कानून, चिकित्सा और नैतिकता शामिल हैं, ताकि किसी की समस्या-समाधान क्षमता और दुनिया की सामान्य समझ का आकलन किया जा सके।
MMLU के लिए नई बेंचमार्क विधि Gemini को केवल अपनी पहली छाप का सहारा लेने के बजाय, उत्तर देने से पहले अधिक गहराई से विचार करने हेतु अपनी तर्क शक्ति का उपयोग करके महत्वपूर्ण सुधार करने में सक्षम बनाती है।
यहाँ पाठ-संबंधी कार्यों पर Gemini का प्रदर्शन है:
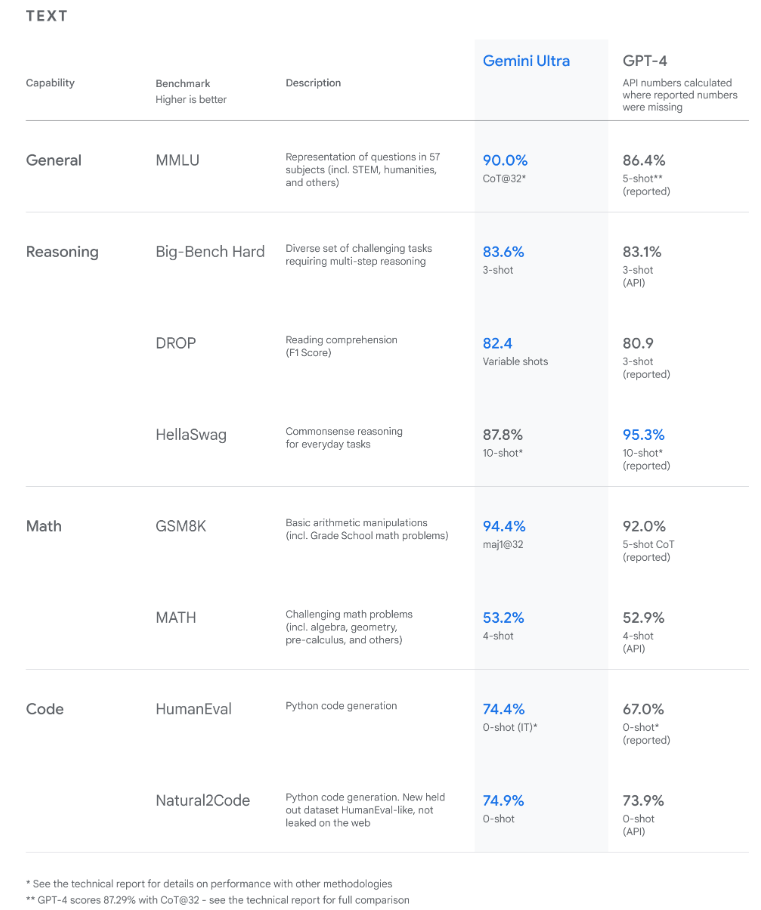
परिणाम दिखाते हैं कि Gemini पाठ और कोडिंग सहित, विस्तृत बेंचमार्क्स पर स्टेट-ऑफ-द-आर्ट प्रदर्शन से आगे निकलता है। [Source]
Gemini Ultra मॉडल ने नए Massive Multidiscipline Multimodal Understanding (MMMU) बेंचमार्क पर भी 59.4% स्कोर के साथ स्टेट-ऑफ-द-आर्ट हासिल किया। यह आकलन विभिन्न डोमेन्स में मल्टीमोडल कार्यों से बना है, जिन्हें सोद्देश्य तर्क की आवश्यकता होती है।
Google ने कहा, “जिन इमेज बेंचमार्क्स का हमने परीक्षण किया, उनमें Gemini Ultra ने ऑप्टिकल कैरेक्टर रिकग्निशन (OCR) सिस्टम की सहायता के बिना, जो आगे की प्रोसेसिंग के लिए छवियों से पाठ निकालते हैं, पिछले स्टेट-ऑफ-द-आर्ट मॉडलों से बेहतर प्रदर्शन किया।”
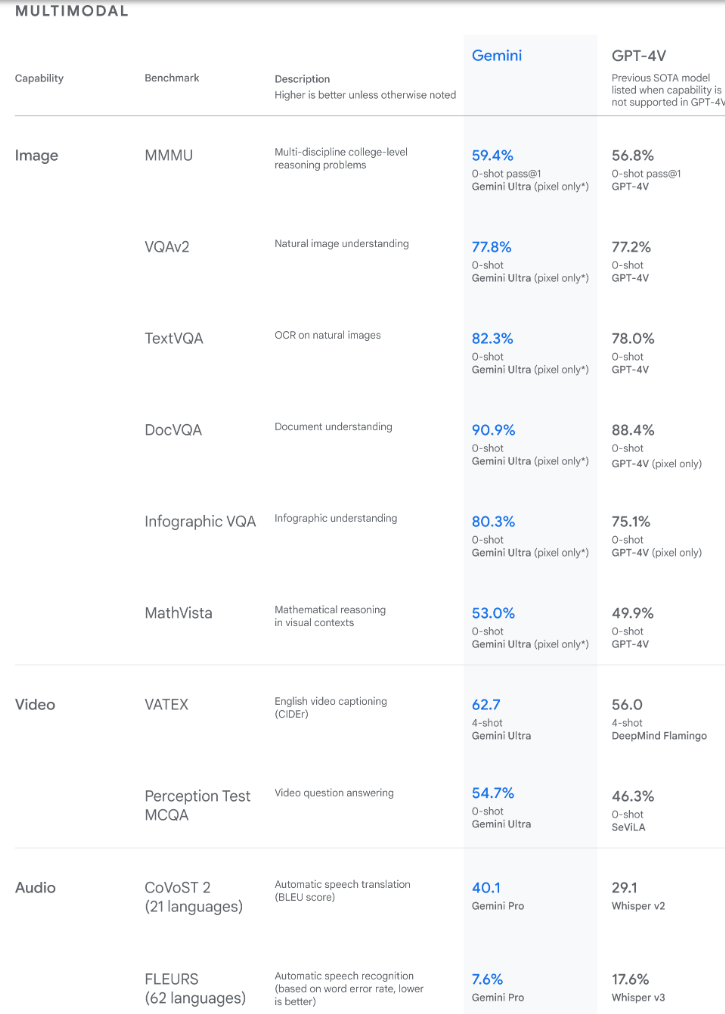
परिणाम दिखाते हैं कि Gemini व्यापक मल्टीमोडल बेंचमार्क्स पर भी स्टेट-ऑफ-द-आर्ट प्रदर्शन से आगे निकलता है। [Source]
Gemini द्वारा स्थापित बेंचमार्क्स मॉडल की अंतर्निहित मल्टीमोडलिटी को प्रदर्शित करते हैं और अधिक परिष्कृत तर्क क्षमता की इसकी योग्यता के शुरुआती प्रमाण दिखाते हैं।
आम तौर पर अगला स्वाभाविक प्रश्न होता है, “GPT-4 की तुलना में Gemini कैसा है?”
दोनों मॉडलों में समान फीचर सेट हैं और वे पाठ, छवि, वीडियो, ऑडियो और कोड डेटा के साथ इंटरैक्ट और उसकी व्याख्या कर सकते हैं, जिससे उपयोगकर्ता उन्हें विभिन्न कार्यों में लागू कर सकते हैं।
दोनों टूल्स के उपयोगकर्ताओं के पास तथ्य-जांच का विकल्प है, लेकिन यह सुविधा प्रदान करने का उनका तरीका अलग है। जहाँ OpenAI का GPT-4 अपने दावों के लिए स्रोत लिंक प्रदान करता है, वहीं Gemini उपयोगकर्ताओं को एक बटन पर क्लिक करके Google खोज के माध्यम से उत्तर की पुष्टि करने में सक्षम बनाता है।
दोनों मॉडलों को अतिरिक्त एक्सटेंशनों के साथ बढ़ाना भी संभव है, हालाँकि, लेखन के समय, Google का Gemini मॉडल काफी अधिक सीमित है।
उदाहरण के लिए, Gemini के साथ Google के टूल्स जैसे Flights, Maps, YouTube और उनकी Workspace एप्लिकेशंस की श्रृंखला का उपयोग करना संभव है। इसके विपरीत, OpenAI के GPT-4 के लिए प्लग-इन्स और एक्सटेंशनों का कहीं बड़ा चयन उपलब्ध है, जिनमें से अधिकांश थर्ड पार्टियों द्वारा बनाए गए हैं। GPT-4 के साथ ऑन-द-फ्लाई इमेज क्रिएशन भी संभव है; Gemini को ऐसी कार्यक्षमता में सक्षम होने के लिए डिज़ाइन किया गया है, लेकिन लेखन के समय, यह ऐसा नहीं कर सकता।
दूसरी ओर, Gemini के रिस्पॉन्स टाइम GPT-4 की तुलना में तेज़ हैं, जिसे प्लेटफ़ॉर्म पर उपयोगकर्ताओं की भारी संख्या के कारण कभी-कभी धीमा किया जा सकता है या पूरी तरह बाधित भी किया जा सकता है।
Google के Gemini मॉडल्स विभिन्न मोडॅलिटीज़ में कई प्रकार के कार्य कर सकते हैं, जैसे कि पाठ, ऑडियो, छवि और वीडियो की समझ।
Gemini की मल्टीमोडल प्रकृति के कारण, अलग-अलग मोडॅलिटीज़ को संयोजित करके समझना और आउटपुट जेनरेट करना भी संभव है।
Gemini के उपयोग मामलों के उदाहरण शामिल हैं:
Gemini मॉडल विभिन्न डेटा प्रकारों से सामग्री का सार प्रस्तुत कर सकते हैं। GEMINI: Controlling The Sentence-Level Summary Style in Abstractive Text Summarization शीर्षक वाले एक शोध पत्र के अनुसार, Gemini मॉडल “क्रमशः वाक्य को पुनर्लेखन और अमूर्त करने की तकनीकों की नकल करने के लिए रीराइट्स और एक जेनरेटर को इंटीग्रेट करता है।”
अर्थात, Gemini अनुकूली रूप से चुनता है कि किसी दस्तावेज़ के विशेष वाक्य को फिर से लिखा जाए या पूरी तरह से शुरुआत से सार वाक्य जेनरेट किया जाए। प्रयोगों के निष्कर्षों से पता चला कि Gemini द्वारा अपनाया गया दृष्टिकोण तीन बेंचमार्क डेटासेट्स पर शुद्ध एब्सट्रैक्टिव और रीराइटिंग बेसलाइन्स से बेहतर रहा, और WikiHow पर सर्वश्रेष्ठ परिणाम प्राप्त किए।
Gemini उपयोगकर्ता प्रॉम्प्ट के जवाब में टेक्स्ट-आधारित आउटपुट जेनरेट कर सकता है — यह पाठ Q&A-स्टाइल चैटबॉट इंटरफेस द्वारा भी संचालित हो सकता है। इस प्रकार, Gemini को ग्राहक पूछताछ संभालने और स्वाभाविक किन्तु आकर्षक तरीके से सहायता प्रदान करने के लिए तैनात किया जा सकता है, जिससे मानव एजेंटों की जिम्मेदारियाँ मुक्त होकर वे अधिक जटिल कार्यों पर ध्यान दे सकें और ग्राहक संतुष्टि में सुधार हो।
इसे रचनात्मक लेखन के लिए भी उपयोग किया जा सकता है, जैसे उपन्यास का सह-लेखन, विभिन्न शैलियों में कविता लिखना, या फिल्मों और नाटकों के लिए पटकथाएँ बनाना। यह रचनात्मक लेखकों की उत्पादकता को काफी बढ़ा सकता है और राइटर्स ब्लॉक से होने वाले तनाव को कम कर सकता है।
अपनी व्यापक बहुभाषी क्षमताओं के साथ, Gemini मॉडल 100 से अधिक विभिन्न भाषाओं को समझ और अनुवाद कर सकते हैं। Google के अनुसार, Gemini ऑटोमैटिक स्पीच रिकग्निशन (ASR) और स्वत: वाक् अनुवाद जैसे “विभिन्न मल्टीमोडल बेंचमार्क्स” पर Chat GPT-4V के स्टेट-ऑफ-द-आर्ट प्रदर्शन से आगे निकलता है।
Gemini छवियों को समझ और उनकी व्याख्या कर सकता है, जिससे यह इमेज कैप्शनिंग और विजुअल Q&A जैसे उपयोग मामलों के लिए उपयुक्त हो जाता है। मॉडल जटिल विजुअल्स, जिनमें डायग्राम, फ़िगर्स और चार्ट शामिल हैं, को भी बाहरी OCR टूल्स की आवश्यकता के बिना पार्स कर सकता है।
डेवलपर्स Gemini का उपयोग जटिल कोडिंग कार्यों को हल करने और अपने कोड को डिबग करने के लिए कर सकते हैं। मॉडल सबसे अधिक उपयोग की जाने वाली प्रोग्रामिंग भाषाओं, जैसे Python, Java, C++ और Go में समझने, समझाने और जेनरेट करने में सक्षम है।
Google के मल्टीमोडल लार्ज लैंग्वेज मॉडल्स (LLMs) का नया सेट, Gemini, LaMDA और PaLM 2 का उत्तराधिकारी है। इसे उनके सबसे उन्नत LLMs के सेट के रूप में वर्णित किया गया है, जो पाठ, चित्र, वीडियो, ऑडियो और गणित तथा भौतिकी जैसे जटिल कार्यों को समझने में सक्षम हैं। Gemini कई लोकप्रिय प्रोग्रामिंग भाषाओं में उच्च-गुणवत्ता का कोड जेनरेट करने में भी सक्षम है।
मॉडल ने विभिन्न कार्यों में स्टेट-ऑफ-द-आर्ट क्षमता हासिल की है, और Google में कई लोगों का मानना है कि यह इस बात में एक महत्वपूर्ण छलाँग का प्रतिनिधित्व करता है कि एआई हमारी रोजमर्रा की ज़िंदगी को बेहतर बनाने में कैसे मदद कर सकता है।
अपनी सीख जारी रखें निम्नलिखित संसाधनों के साथ:
और जाने से पहले, हमारे YouTube चैनल को सब्सक्राइब करना न भूलें। हमारे पास सभी प्रासंगिक और ट्रेंडिंग विषयों पर बेहतरीन सामग्री है, जिनमें यह ट्यूटोरियल भी शामिल है कि Gemini के साथ मल्टीमोडल ऐप्स कैसे बनाएं, इसलिए अवश्य देखें।
आज ही अपनी एआई यात्रा शुरू करें!
कोर्स
कोर्स
कोर्स
