Curso
Conceptos de la IA generativa
2 h
117.2K
Google ha lanzado recientemente su nuevo modelo de IA generativa, Gemini. Es el resultado del trabajo conjunto de varios equipos de Google, incluidos miembros de Google Research.
El modelo, que Google describe como su IA más capaz y versátil hasta la fecha, se ha diseñado para ser multimodal. Esto significa que Gemini puede comprender distintos tipos de datos como texto, audio, imágenes, vídeo y código.
En lo que queda de artículo veremos:
El 6 de diciembre de 2023, Google DeepMind anunció Gemini 1.0. Con su lanzamiento, Google lo describió como su conjunto más avanzado de modelos de lenguaje grandes (LLM), sucediendo así a Pathways Language Model (PaLM 2), presentado en mayo del mismo año.
Gemini define una familia de LLM multimodales capaces de entender textos, imágenes, vídeos y audio. Además, según Google, puede resolver tareas complejas de matemáticas y física, y generar código de alta calidad en varios lenguajes de programación.
Curiosidad: Sergey Brin, cofundador de Google, figura como uno de los colaboradores del modelo Gemini.
Hasta hace poco, el enfoque habitual para crear modelos multimodales consistía en entrenar por separado componentes para cada modalidad y después combinarlos para imitar parte de la funcionalidad. Estos modelos a veces destacaban en tareas concretas, como describir imágenes, pero tenían dificultades con razonamientos más sofisticados y complejos.
Gemini se ha diseñado como multimodal de forma nativa; es decir, se preentrenó desde el principio con varias modalidades. Para refinar aún más su eficacia, Google lo ajustó con datos multimodales adicionales.
En consecuencia, Gemini es significativamente más capaz que los modelos multimodales existentes a la hora de comprender y razonar sobre una amplia variedad de entradas desde la base, según Sundar Pichai, CEO de Google y Alphabet, y Demis Hassabis, CEO y cofundador de Google DeepMind. También afirman que las capacidades de Gemini son «vanguardia en prácticamente todos los ámbitos».
Entre las funciones principales del modelo Gemini destacan:
La IA multimodal es un nuevo paradigma en auge en el que se combinan distintos tipos de datos con múltiples algoritmos para lograr mayor rendimiento. Gemini se apoya en este paradigma, por lo que se integra bien con diversos tipos de datos. Puedes introducir imágenes, audio, texto y otros formatos, logrando interacciones con la IA más naturales.
Gemini aprovecha los chips TPUv5 de Google, lo que según se informa lo hace cinco veces más potente que GPT-4. Un procesamiento más rápido permite a Gemini abordar tareas complejas con relativa facilidad y gestionar varias solicitudes a la vez.
Gemini se entrenó con un conjunto de datos enorme de texto y código. Así el modelo puede acceder a información muy actualizada y ofrecer respuestas precisas y fiables a tus consultas. Según Google, el modelo supera a GPT-4 de OpenAI y a personas de nivel «experto» en diversas pruebas de inteligencia (por ejemplo, el benchmark MMLU).
Gemini 1.0 puede comprender, explicar y generar código de alta calidad en los lenguajes de programación más utilizados, como Python, Java, C++ y Go; por ello es uno de los modelos base líderes para programación a nivel mundial.
El modelo también destaca en varios benchmarks de codificación, incluido HumanEval, un estándar muy reconocido en la industria para evaluar el rendimiento en tareas de programación; también rindió bien en un conjunto de datos interno y reservado de Google que utiliza código generado por autores en lugar de información de la web.
Se han incorporado nuevas protecciones a los Principios de IA y a las políticas de Google para tener en cuenta las capacidades multimodales de Gemini. Google afirma que «Gemini cuenta con las evaluaciones de seguridad más completas de cualquier modelo de IA de Google hasta la fecha, incluidas las de sesgo y toxicidad». También señalan que han «llevado a cabo investigaciones novedosas sobre posibles áreas de riesgo como la ciberdelincuencia, la persuasión y la autonomía, y han aplicado las técnicas de prueba adversaria de Google Research, líderes del sector, para ayudar a identificar cuestiones críticas de seguridad antes del despliegue de Gemini».
Google afirma que Gemini, el sucesor de LaMDA y PaLM 2, es su «modelo más flexible hasta ahora: capaz de ejecutarse de forma eficiente desde centros de datos hasta dispositivos móviles». También creen que sus capacidades de vanguardia mejorarán la forma en que desarrolladores y clientes empresariales construyen y escalan con IA.
La primera versión, Gemini 1.0, se lanzó en tres tamaños:
Desde el 13 de diciembre de 2023, los desarrolladores y clientes empresariales pueden acceder a Gemini Pro mediante la API de Gemini en Google AI Studio o en Google Cloud Vertex AI.
Ten en cuenta que Google AI Studio es un IDE en el navegador, gratuito, que los desarrolladores pueden usar para crear prototipos de modelos generativos y lanzar aplicaciones fácilmente con una clave de API. Google Cloud Vertex, por su parte, es una plataforma de IA totalmente gestionada que ofrece todas las herramientas necesarias para crear y usar IA generativa. Según Google, «Vertex AI permite personalizar Gemini con control total de los datos y se beneficia de funciones adicionales de Google Cloud para seguridad empresarial, protección, privacidad y gobierno y cumplimiento de datos».
A través de AICore, una nueva función del sistema en Android 14, los desarrolladores de Android, empezando por dispositivos Pixel 8 Pro, pueden construir con Gemini Nano, el modelo más eficiente para tareas en el dispositivo.
Antes de su lanzamiento, los modelos Gemini se sometieron a pruebas exhaustivas para evaluar su rendimiento en una amplia gama de tareas. Google afirma que su modelo Gemini Ultra supera los resultados de vanguardia en 30 de los 32 benchmarks académicos más utilizados en investigación y desarrollo de LLM. Estas tareas abarcan desde comprensión de imágenes, audio y vídeo hasta razonamiento matemático.
En una entrada de presentación, Google sostiene que Gemini Ultra es el primer modelo que supera a expertos humanos en Massive Multitask Language Understanding (MMLU) con una puntuación del 90,0%. MMLU incluye 57 materias distintas, como matemáticas, física, historia, derecho, medicina y ética, para evaluar la capacidad de resolver problemas y el conocimiento general del mundo.
El nuevo método de evaluación de MMLU permite a Gemini lograr mejoras significativas al usar su capacidad de razonamiento para deliberar más antes de responder a preguntas desafiantes, en lugar de quedarse con su primera impresión.
Así rindió Gemini en tareas de texto:
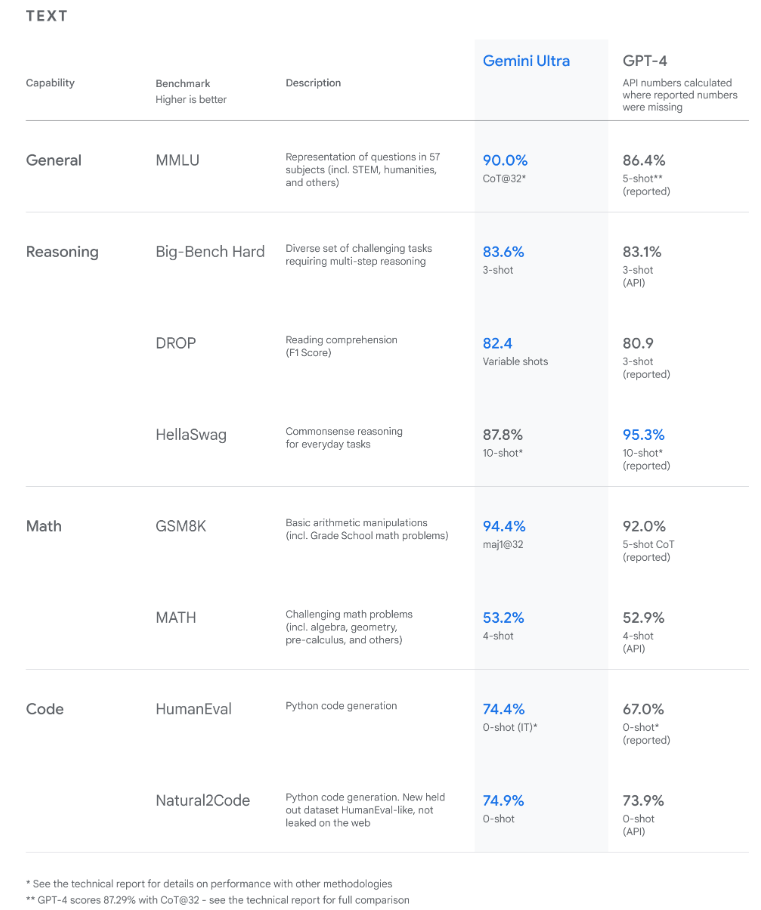
Los resultados muestran que Gemini supera el estado del arte en una amplia gama de benchmarks, incluidos texto y programación. [Source]
El modelo Gemini Ultra también logró el mejor resultado en el nuevo benchmark Massive Multidiscipline Multimodal Understanding (MMMU) con una puntuación del 59,4%. Esta evaluación reúne tareas multimodales en distintos dominios que requieren razonamiento deliberado.
Google indicó que «en los benchmarks de imagen que probamos, Gemini Ultra superó a modelos anteriores de referencia sin ayuda de sistemas de reconocimiento óptico de caracteres (OCR) que extraen texto de imágenes para su procesamiento posterior».
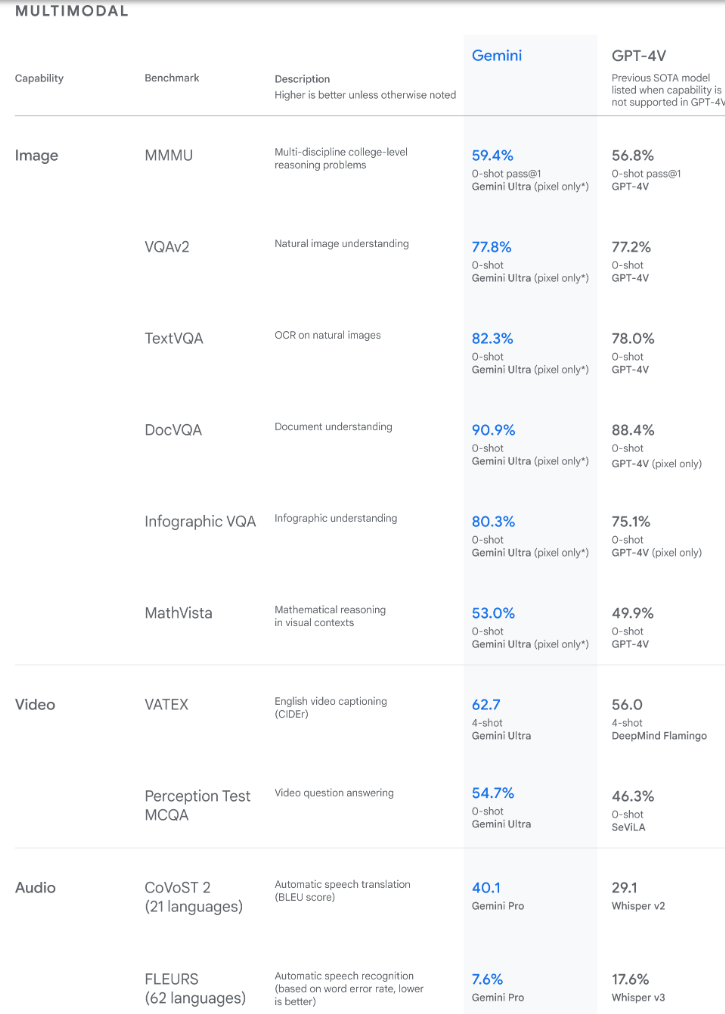
Los resultados muestran que Gemini también supera el estado del arte en una amplia variedad de benchmarks multimodales. [Source]
Los benchmarks de Gemini demuestran su multimodalidad innata y aportan evidencia temprana de su capacidad para un razonamiento más sofisticado.
La pregunta obvia que suele surgir es: «¿Cómo se compara Gemini con GPT-4?»
Ambos modelos ofrecen funciones similares y pueden interactuar e interpretar datos de texto, imagen, vídeo, audio y código, lo que permite aplicarlos a multitud de tareas.
En ambos casos puedes verificar hechos, pero la forma de ofrecer esta función es distinta. Mientras que GPT-4 de OpenAI aporta enlaces a fuentes para respaldar sus afirmaciones, Gemini permite realizar una búsqueda en Google para confirmar la respuesta con solo pulsar un botón.
También es posible ampliar ambos modelos con extensiones, aunque, en el momento de escribir estas líneas, el modelo Gemini de Google es mucho más limitado.
Por ejemplo, con Gemini es posible usar herramientas de Google como vuelos, Maps, YouTube y su suite de aplicaciones de Workspace. En cambio, para GPT-4 de OpenAI hay una selección mucho mayor de complementos y extensiones, en su mayoría creados por terceros. La creación de imágenes al vuelo también es posible con GPT-4; Gemini está diseñado para ser capaz de ello, pero por ahora no puede.
Por otro lado, los tiempos de respuesta de Gemini son más rápidos que los de GPT-4, que en ocasiones se ralentiza o incluso se interrumpe por el gran volumen de usuarios en la plataforma.
Los modelos Gemini de Google pueden realizar diversas tareas en varias modalidades, como comprensión de texto, audio, imagen y vídeo.
También es posible combinar distintas modalidades para comprender y generar salidas gracias a la naturaleza multimodal de Gemini.
Algunos ejemplos de uso de Gemini:
Los modelos Gemini pueden resumir contenido a partir de varios tipos de datos. Según el artículo GEMINI: Controlling The Sentence-Level Summary Style in Abstractive Text Summarization, el modelo Gemini «integra reescrituras y un generador para imitar técnicas de reescritura de frases y abstracción, respectivamente».
En concreto, Gemini decide de forma adaptativa si reescribir una frase concreta de un documento o generar una frase de resumen completamente desde cero. Los experimentos mostraron que el enfoque de Gemini superó las líneas base puramente abstractivas y de reescritura en tres conjuntos de datos de referencia, logrando los mejores resultados en WikiHow.
Gemini puede generar texto en respuesta a un prompt del usuario; este texto también puede producirse mediante una interfaz de chatbot de preguntas y respuestas. Así, se puede desplegar Gemini para atender consultas de clientes y ofrecer ayuda de forma natural y atractiva, liberando a los agentes humanos para que se centren en tareas más complejas y mejoren la satisfacción del cliente.
También puede utilizarse para escritura creativa, como coescribir una novela, redactar poesía en varios estilos o generar guiones para cine y teatro. Esto puede impulsar notablemente la productividad de los creadores y reducir el bloqueo creativo.
Gracias a sus amplias capacidades multilingües, los modelos Gemini pueden entender y traducir más de 100 idiomas. Según Google, Gemini supera el rendimiento de Chat GPT-4V «en una serie de benchmarks multimodales», como el reconocimiento automático del habla (ASR) y la traducción automática del habla.
Gemini puede comprender e interpretar imágenes, lo que lo hace idóneo para subtitulado automático y aplicaciones de preguntas y respuestas visuales. El modelo también es capaz de analizar visuales complejos, incluidos diagramas, figuras y gráficos, sin necesidad de herramientas OCR externas.
Los desarrolladores pueden usar Gemini para resolver tareas de programación complejas y depurar su código. El modelo entiende, explica y genera en los lenguajes más usados, como Python, Java, C++ y Go.
El nuevo conjunto de LLM multimodales de Google, Gemini, sucede a LaMDA y PaLM 2. Google lo describe como su conjunto de LLM más avanzado, capaz de comprender textos, imágenes, vídeos, audio y de abordar tareas complejas como matemáticas y física. Gemini también puede generar código de alta calidad en muchos de los lenguajes de programación más populares.
El modelo ha alcanzado resultados de vanguardia en diversas tareas, y en Google muchos creen que supone un gran salto adelante en cómo la IA puede ayudarnos a mejorar nuestro día a día.
Continúa aprendiendo con estos recursos:
Y antes de irte, no olvides suscribirte a nuestro canal de YouTube. Tenemos contenido muy potente sobre los temas más relevantes y en tendencia, incluido un tutorial sobre cómo crear apps multimodales con Gemini. Échale un vistazo.
¡Empieza hoy tu camino en IA!
Curso
Curso
Curso
blog
Matt Crabtree
13 min
blog
Abid Ali Awan
9 min
blog
Josep Ferrer
8 min
blog
Abid Ali Awan
9 min
Tutorial
Adel Nehme
9 min
Tutorial
Dimitri Didmanidze
8 min