
Kurs
Datenstrukturen und Algorithmen in Python
4 Std.
47K
Datenstrukturen gibt es in der digitalen wie in der physischen Welt. Ein Wörterbuch ist ein physisches Beispiel: Die Daten sind Wortbedeutungen, alphabetisch in einem Buch geordnet. Diese Struktur ermöglicht eine gezielte Abfrage: Zu einem Wort lässt sich die Definition nachschlagen.
Im Kern ist eine Datenstruktur eine Art, Daten zu organisieren, die bestimmte Abfragen und Operationen auf diesen Daten erleichtert.
Wir starten mit linearen Datenstrukturen wie Arrays, Listen, Queues und Stacks. Danach klären wir den Unterschied zwischen linearen und nichtlinearen Strukturen und tauchen dann in Hashtabellen, Bäume und Graphen ein.
Wenn du tiefer einsteigen willst, schau dir diesen Kurs zu Datenstrukturen und Algorithmen in Python an.
Arrays sind grundlegende Datenstrukturen und in vielen Programmiersprachen verfügbar. Sie erlauben, eine feste Anzahl (N) von Werten hintereinander im Speicher abzulegen.
Array-Elemente sind vom ersten Element am Index (0) bis zum letzten Element am Index (N-1) nummeriert.
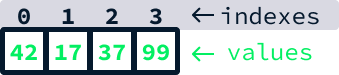
Sie unterstützen unter anderem folgende Operationen:
Arrays sind ideal, wenn die Anzahl der zu speichernden Werte im Voraus feststeht und vor allem Lese- und Schreibzugriffe an bestimmten Indizes nötig sind.
Stell dir vor, du möchtest tägliche Temperaturmessungen für den Dezember speichern. Nutzer sollen die Temperatur für einen bestimmten Tag abrufen können, und du willst statistische Auswertungen über den Monat hinweg durchführen.
Da die Anzahl der Tage im Dezember mit 31 feststeht, eignen sich Arrays hervorragend für diese Messwerte. Zunächst legst du ein Array mit 31 leeren Positionen an. Nach jeder Messung ordnest du die Temperatur dem entsprechenden Index zu: Tag 1 liegt an Index 0, Tag 2 an Index 1 und so weiter, bis Tag 31 an Index 30.
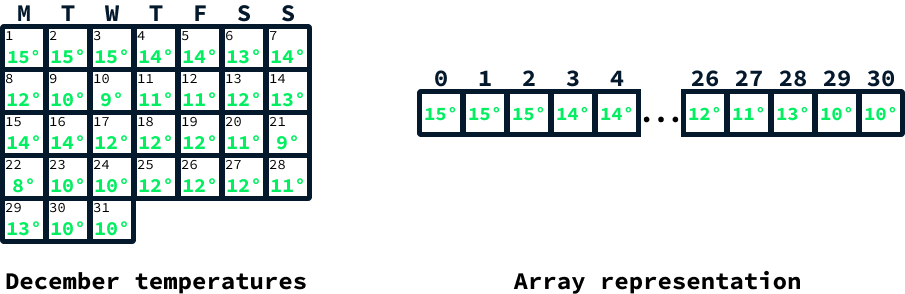
Über den passenden Index lässt sich die Temperatur für einen bestimmten Tag abrufen. Statistiken wie die Durchschnittstemperatur erhältst du, indem du über alle Elemente iterierst, eine Summe bildest und anschließend durch die Array-Größe teilst.
Arrays sind in Python nicht nativ verfügbar. Sie werden intern als zugrunde liegende Struktur für verschiedene Datentypen genutzt, sind aber nicht direkt in der Sprache vorgesehen. Um Arrays explizit zu verwenden, kannst du Bibliotheken wie array nutzen, die eine Array-Implementierung bieten. In der Praxis ist es jedoch oft sinnvoller, eine Liste mit fester Größe zu verwenden. Listen sind flexibel und fester Bestandteil von Python – dazu gleich mehr.
Wir können eine Liste erzeugen, die ein Array mit 31 Elementen simuliert und jeweils mit None initialisiert ist, mittels [None] * 31. None steht hier dafür, dass noch keine Temperatur erfasst wurde.
december_temperatures = [None] * 31Um den Wert an einem bestimmten Index zu setzen, verwenden wir december_temperatures[index], wobei index eine Zahl von 0 bis 30 ist. So speicherst du zum Beispiel die Temperatur für den ersten Tag (Index 0):
december_temperatures[0] = 15Der Zugriff auf eine Temperatur funktioniert analog über december_temperatures[index].
print(december_temperatures[0])15Angenommen, statt nur im Dezember misst ein Sensor in regelmäßigen Abständen über einen unbestimmten Zeitraum die Temperatur. Ein Array wäre hier ungeeignet, da es beim Anlegen eine feste Größe hat und der Platz knapp werden könnte.
Die passendere Datenstruktur ist eine Liste. Es gibt zwei Arten von Listen:
Array-Listen sind die flexiblere Variante von Arrays. Sie können alles, was Arrays können, aber zusätzlich neue Werte anhängen – ihre Größe ist also nicht beim Anlegen festgelegt. In Python entspricht das der Verwendung von list().
Unter der Haube basiert die Implementierung auf einem Array, das bei Platzmangel vergrößert wird – daher der Name Array-Liste. Aber Arrays können doch gar nicht wachsen – wie geht das?
Wenn das zugrunde liegende Array voll ist und ein neuer Wert angehängt werden soll, wird intern ein größeres Array erzeugt. Alle bisherigen Werte werden in dieses größere Array kopiert. Dann wird der neue Wert an die erste freie Position im neuen Array geschrieben.
Stell dir vor, wir wollen den Wert 71 an dieses Array anhängen:
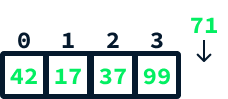
Das lässt sich so umsetzen:
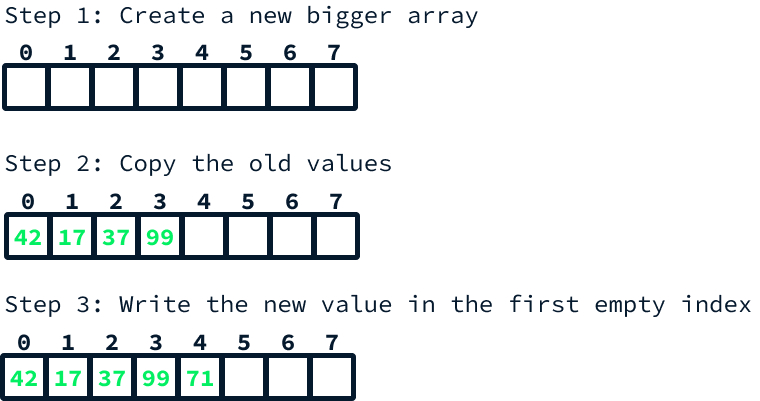
Wie viel neuer Platz bei dieser Operation reserviert wird, ist entscheidend für die Performance der Array-Liste. Würden wir bei jedem Anhängen nur genau eine zusätzliche Position schaffen, müsste bei jedem Append der gesamte vorhandene Inhalt kopiert werden – extrem ineffizient, insbesondere bei Millionen Einträgen.
Stattdessen wird üblicherweise die Kapazität bei Bedarf verdoppelt. So gleicht sich der Aufwand der zusätzlichen Kopierschritte über die Zeit aus.
In Python fügst du Elemente mit der Methode .append() hinzu. Hier ein Beispiel, wie du eine leere Liste anlegst und einen Temperaturwert hinzufügst:
temperatures = []
temperatures.append(35)Um Daten im Computer zu strukturieren, brauchen wir eine Möglichkeit, Werte zueinander in Beziehung zu setzen. Arrays tun dies, indem sie zusammenhängende Speicherbereiche reservieren und Werte nacheinander ablegen. Stell dir eine Häuserreihe vor: Jedes Haus hat eine eindeutige Adresse (Index) und sie liegen physisch nebeneinander.
Das ist aber nicht die einzige Art, Daten zu organisieren. Eine Alternative ist eine knotenbasierte Struktur.
Ein Knoten ist ein Objekt, das einen Wert und Referenzen auf andere Knoten speichert. Um eine listenähnliche Struktur zu bauen, kann ein Knoten zum Beispiel neben seinem Wert eine Referenz auf das nächste Element enthalten. In Python lässt sich das mit einer Klasse umsetzen:
class Node:
    def __init__(self, value, next_node):
        self.value = value
        self.next_node = next_node
So kannst du über die Referenz next_node Werte zu einer Liste verketten. Der folgende Code erzeugt eine Liste mit den Werten 42, 17 und 37:
node_37 = Node(37, None) # Nach 37 kommt kein weiterer Knoten, daher next_node = None
node_17 = Node(17, node_37)
node_42 = Node(42, node_17)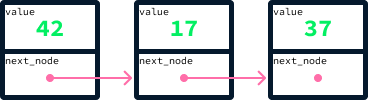
Knoten manuell so zu verknüpfen, ist unpraktisch. In der Praxis ergänzt man eine weitere Klasse, die Referenzen auf den ersten und letzten Knoten verwaltet. Um einen neuen Wert anzuhängen, gehen wir so vor:
Stell dir vor, wir wollen den Wert 71 an unser Beispiel-Array anhängen:
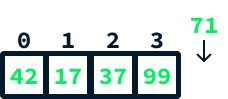
Das lässt sich so umsetzen:
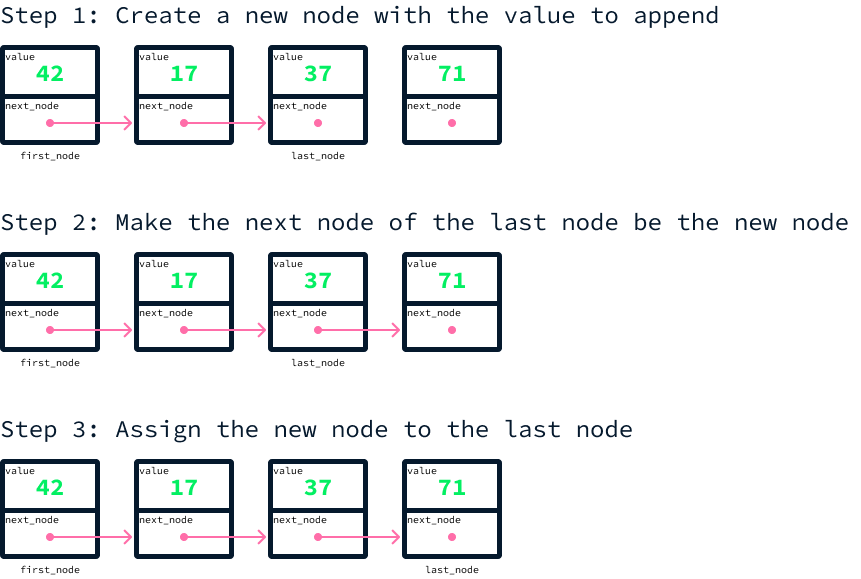
class LinkedList:
    def __init__(self):
        self.first_node = None
        self.last_node = None

    def append(self, value):
        node = Node(value, None)
        if self.first_node is None:
            self.first_node = node
            self.last_node = node
        else:
            self.last_node.next_node = node
            self.last_node = node
Im Gegensatz zu Array-Listen können wir hier nicht direkt über Indizes zugreifen. Um den Wert an einem Index zu lesen, müssen wir beim ersten Knoten starten und nacheinander weitergehen, bis wir am gewünschten Index ankommen. Das ist deutlich langsamer als Direktzugriff. Bei Millionen Einträgen müsstest du potenziell Millionen Werte durchlaufen, um einen bestimmten Index zu erreichen.
Der Vorteil einer verketteten Liste ist, dass wir Elemente am Anfang oder Ende der Liste in konstanter Zeit einfügen und entfernen können. Damit lassen sich zwei weitere Datenstrukturen effizient umsetzen: Queues und Stacks – dazu gleich mehr.
Angenommen, du entwickelst eine Restaurant-App, die Bestellungen der Gäste erfasst und an die Küche weiterleitet. Die Gäste stellen sich an, um zu bestellen, und erwarten Bedienung in der Reihenfolge ihrer Ankunft. Das heißt: Der erste in der Schlange wird zuerst bedient, der letzte zuletzt.
In der Küche möchte der Koch sich jeweils auf eine Bestellung konzentrieren, also sollte die App immer nur die aktuelle Bestellung anzeigen. Sobald eine Bestellung fertig ist, wird die nächste in der Schlange angezeigt.
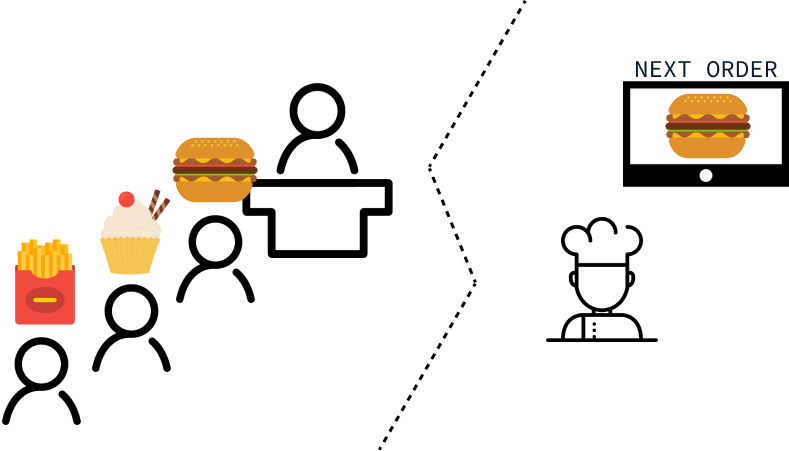
Daraus leiten sich folgende Anforderungen an eine Datenstruktur ab:
Genau das bietet eine Queue. Sie lässt sich mit einer verketteten Liste implementieren, wobei neue Elemente am Ende angehängt werden. Da die Reihenfolge der Ankunft zählt, ist der erste Knoten immer der nächste zur Bedienung.
So würden die obigen Bestellungen in der Queue gespeichert:
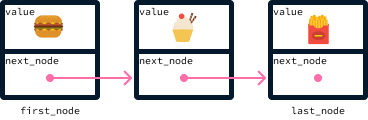
Sobald eine Bestellung fertig ist, entfernen wir sie, indem wir den ersten Knoten auf dessen next_node setzen, sofern es einen gibt. Der neue erste Knoten ist dann der vorherige zweite:
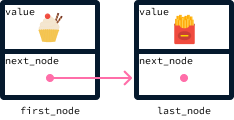
Queues werden als First-in, First-out (FIFO) beschrieben, weil das zuerst hinzugefügte Element auch als erstes entfernt wird. In unserem Restaurant-Beispiel wird der erste Gast zuerst bedient (und aus der Liste des Kochs entfernt).
In Python kannst du dafür die deque-Collection aus dem Modul collections verwenden. Importiere das Modul und lege eine leere Queue an:
from collections import deque
orders = deque()
Ein neues Element hinten anstellen geht mit der Methode .append():
orders.append("burger")
orders.append("sunday")
orders.append("fries")
Um die nächste Bestellung vorne aus der Schlange zu entnehmen, nutzt du .popleft():
orders.append("burger")
orders.append("sunday")
orders.append("fries")
burger
sunday
friesManchmal brauchen wir das Gegenteil des Queue-Verhaltens – wir wollen das zuletzt hinzugefügte Element im Blick behalten.
Beispiel: Du sollst eine Undo-Funktion in einen Bildeditor einbauen. Dazu musst du die Aktionen der Nutzerin nachhalten und schnell auf die jüngsten Schritte zugreifen. Denn Undo macht in der Regel die letzte Aktion zuerst rückgängig und arbeitet sich rückwärts vor.
Ein Stack ist genau die Datenstruktur dafür. Er unterstützt:
Wie Queues lassen sich Stacks mit einer verketteten Liste umsetzen. Elemente fügst du wieder am Ende an. Unser Fokus liegt aber auf dem letzten Element. Um das aktuellste Element zu erhalten, greifen wir auf das letzte Listenelement zu; um es zu entfernen, löschen wir dieses letzte Element.
In unserer Knotenstruktur hatten wir bisher nur den nächsten Knoten gespeichert. Um das letzte Element effizient zu entfernen, müssen wir auf den davorliegenden Knoten zugreifen, dessen next_node löschen und diesen Knoten zum neuen letzten machen. Dafür erweitern wir die Struktur um eine Referenz auf den vorherigen Knoten. Eine solche Liste heißt doppelt verkettete Liste.
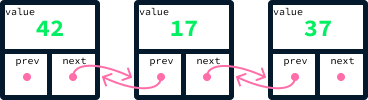
Stacks werden als Last-in, First-out (LIFO) beschrieben, weil das zuletzt hinzugefügte Element als erstes entfernt wird.
Für einen Stack in Python kannst du ebenfalls deque verwenden. Neue Elemente fügst du mit .append() hinzu:
from collections import deque
actions = deque()

actions.append("crop")
actions.append("desaturate")
actions.append("resize")
Um das oberste Element vom Stack zu entnehmen, nutzt du .pop():
print(actions.pop())
print(actions.pop())
print(actions.pop())
resize
desaturate
cropBisher haben wir fünf Datenstrukturen betrachtet: Arrays, Array-Listen, verkettete Listen, Queues und Stacks. All diese sind linear, da ihre Elemente in einer Sequenz angeordnet sind und jeweils einen klaren Vorgänger und Nachfolger haben.
Als Nächstes wenden wir uns nichtlinearen Datenstrukturen zu. Anders als lineare Strukturen ordnen sie Elemente nicht nebeneinander in einer linearen Folge an. Es gibt also kein festes Konzept von „vorher“ und „nachher“. Stattdessen definieren sie andere Arten von Beziehungen zwischen den Elementen.
Das macht sie besonders geeignet, um spezielle Abfragen auf den Daten sehr effizient auszuführen – nicht nur, um Daten im Speicher zu halten.
Wir haben mit einem realen Beispiel begonnen: Wörterbücher. Daten so zu organisieren, dass sie über ein bestimmtes Feld nachschlagbar sind (z. B. Definition zu einem Wort), ist allgemein extrem nützlich – daher gibt es dafür auch eine passende Datenstruktur.
Um sie zu verstehen, bauen wir ein virtuelles Wörterbuch – also eine Struktur, in der wir:
Erinnere dich an das Dezember-Temperaturbeispiel. Wir nutzten ein Array mit 31 Elementen für die Tage und speicherten die Temperaturen an den jeweiligen Indizes. So lässt sich effizient die Temperatur für einen bestimmten Tag finden.
Das ist im Grunde ein Arbeiten mit Paaren (day, temperature), wobei wir die temperature über den Tag abrufen. Im Wörterbuch-Fall arbeiten wir mit (word, definition) und wollen die definition über das word finden.
Solche Paare heißen Schlüssel-Wert-Paare oder Einträge. Der Schlüssel ist der Parameter der Abfrage, der Wert ist das Ergebnis.
|
Schlüssel |
Wert |
|
|
Dezember-Temperaturen |
day |
temperature |
|
Wörterbuch |
word |
definition |
Warum nutzen wir für das Wörterbuch-Problem kein Array? Unsere Schlüssel sind Strings statt Zahlen. Bei numerischen Schlüsseln kann man Werte direkt an den passenden Indizes ablegen.
Zur Lösung müssen wir Wörter zunächst in Zahlen abbilden. Eine Funktion, die das tut, heißt Hashfunktion. Es gibt viele Ansätze. Man könnte Buchstaben Zahlen zuweisen – a = 1, b = 2, c = 3 usw. – und dann aufsummieren.
Das Wort data ergäbe so 4 + 1 + 20 + 1 = 26. Diese Funktion hat jedoch Schwächen, auf die wir gleich zurückkommen. Die genaue Entwicklung guter Hashfunktionen sprengt hier den Rahmen. Praktisch stellt Python eine effiziente hash()-Funktion bereit.
hash("data")-6138587229816301269Im Beispiel siehst du, dass die Hashfunktion eine negative Zahl liefern kann. Array-Indizes liegen jedoch zwischen 0 und N - 1. Nachdem wir Schlüssel in Zahlen umgewandelt haben, können wir sie per Modulo-Operator % in den Bereich 0 bis N - 1 abbilden (10 % 3 ergibt z. B. 1).
Beachte außerdem: Pythons hash() kann zwischen Programmstarts unterschiedliche Werte liefern. Innerhalb eines einzelnen Laufs ist er deterministisch, über mehrere Läufe hinweg aber nicht.
Angenommen, ein Array hat 100 Elemente. So finden wir den Index für den String "data":
hash("data") % 10031Eine Hashtabelle ist im Wesentlichen ein großes Array, das Schlüssel-Wert-Paare an Indizes speichert, die durch Anwenden der Hashfunktion auf die Schlüssel entstehen.
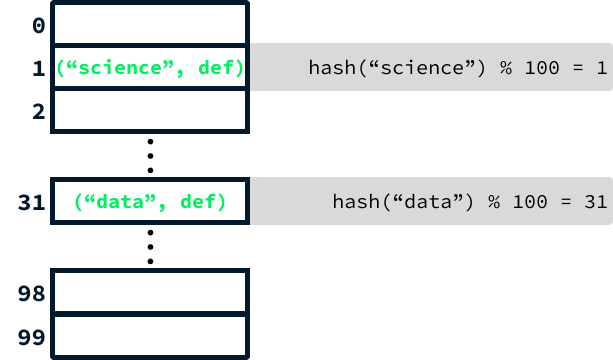
Aus Platzgründen steht in der Grafik nur „def“ als Abkürzung für die Definition. In der Praxis wäre das zweite Element eines Eintrags natürlich die vollständige Definition.
Ein wichtiger Punkt: Es gibt deutlich mehr als 100 Wörter – fügt man weiter welche hinzu, werden zwangsläufig unterschiedliche Wörter denselben Hashwert liefern. Statt an jedem Array-Index nur ein einzelnes Schlüssel-Wert-Paar zu erlauben, speichern wir deshalb alle Einträge mit demselben Hashwert in einer verketteten Liste.
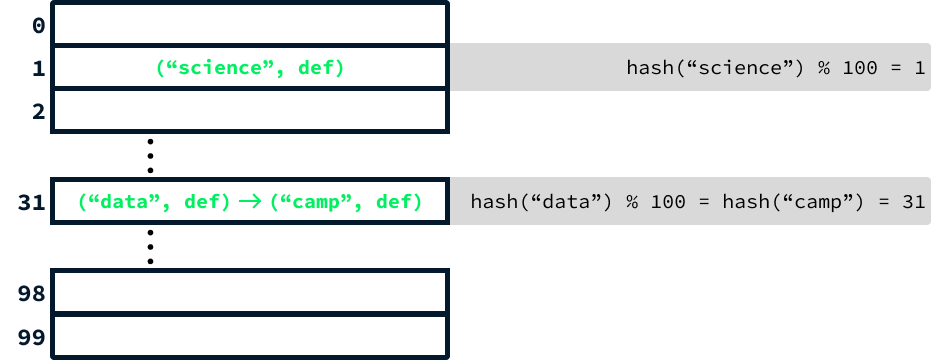
Wenn zwei Einträge denselben Hash erzeugen, nennt man das eine Kollision. Das verändert die Suche leicht: Nach dem Berechnen des Hashcodes muss die Liste an diesem Index durchlaufen werden, um den richtigen Eintrag zu finden. Das verlangsamt die Suche etwas, aber mit einer ausreichend großen Anfangsgröße (größer als 100) und einer guten Hashfunktion lässt sich der Effekt stark reduzieren – die Effizienz bleibt nahezu auf Array-Niveau.
Bei einer guten Hashfunktion sollten unterschiedliche Werte nur selten denselben Hash liefern. Deshalb ist die simple Summierung der Zeichenwerte ungeeignet: Zwei Wörter aus denselben Buchstaben in anderer Reihenfolge hätten denselben Hash, etwa „listen“ und „silent“. Die eingebaute Hashfunktion von Python ist deutlich robuster und darauf ausgelegt, Kollisionen zu minimieren.
Hashtabellen sind wohl die wichtigste Datenstruktur überhaupt. Sie sind extrem effizient und vielseitig. In Python werden sie durch die Klasse dict() umgesetzt. Wegen der Ähnlichkeit heißt die Struktur in Python tatsächlich Dictionary statt Hashtabelle.
Zur Vereinfachung konzentriert sich unser Beispiel aufs Hinzufügen und Nachschlagen. Allgemein sind Dictionaries flexibler und unterstützen u. a. das Löschen. Ein leeres Dictionary (Hashtabelle) erzeugst du mit {} so:
word_definitions = {}
word_definitions["data"] = "Facts or information."
Auf die Definition eines Worts greifst du mit dem Wort als Schlüssel zu, etwa so:
print(word_definitions["data"])Facts or information.Stell dir vor, du entwickelst eine Website für eine Immobilienagentur. Du sollst ein Feature bauen, mit dem Nutzende nach Preis filtern können. Es soll möglich sein:
Typischerweise würdest du alle Inserate durchgehen und die außerhalb des gewünschten Bereichs herausfiltern. Wir wollen aber eine Lösung, die besser skaliert und nicht das gesamte Dataset scannen muss. Bäume sind dafür die perfekte Datenstruktur.
Bäume sind, wie verkettete Listen, knotenbasierte Strukturen. Statt „vorher“ und „nachher“ hält jeder Knoten einen Wert und zwei Referenzen: auf den linken und den rechten Knoten.
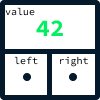
Im Beispiel der Immobilien-Website repräsentiert jeder Knoten ein Inserat. Um Preisabfragen zu optimieren, legen wir eine Regel fest: Günstigere Inserate stehen immer links eines Knotens, teurere immer rechts.
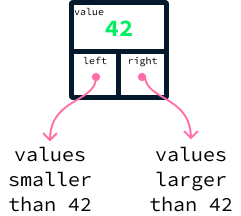
Ein konkretes Beispiel: der folgende Baum enthält die Werte 42, 17, 73, 4, 22 und 89.
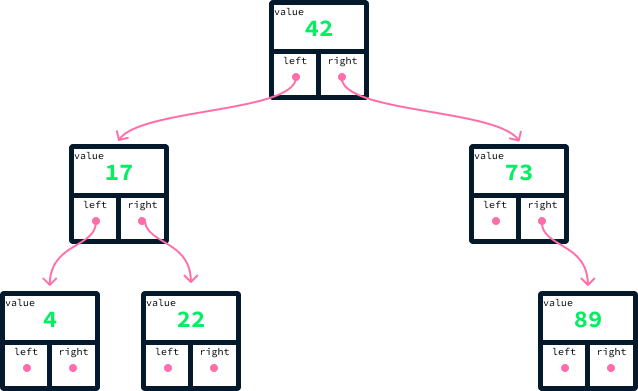
Für jeden Knoten gilt: Links stehen nur kleinere Werte, rechts nur größere. Ein Baum mit dieser Eigenschaft heißt Binary Search Tree (BST). „Binary“, weil jeder Knoten höchstens zwei Kinder hat, und „Search“, weil die Ordnung die effiziente Suche ermöglicht.
Wie hilft ein BST, schnell das günstigste bzw. teuerste Inserat zu finden? Durch die Anordnung ist das günstigste immer der linkeste Knoten, das teuerste der rechteste Knoten.
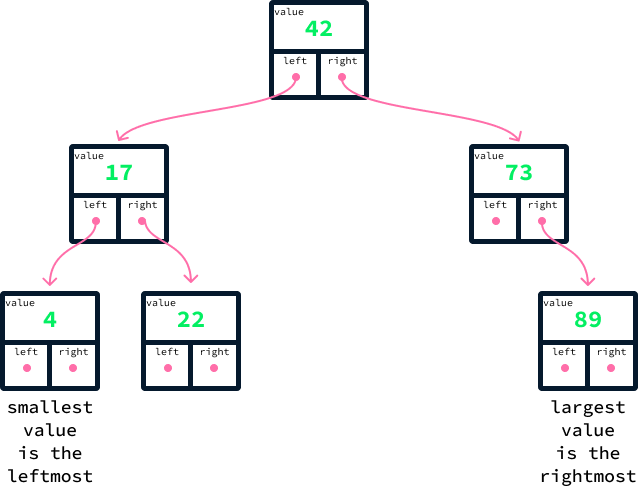
Das bedeutet, wir finden sie, ohne den Großteil der Daten anzusehen. Vom obersten Knoten, der Wurzel, folgen wir für das Minimum immer den linken Verweisen und für das Maximum den rechten. Nur die Knoten entlang dieser Pfade müssen betrachtet werden.
Angenommen, wir suchen alle Knoten mit einem Wert von mindestens 50. So gehen wir vor:
50 mit dem Wert der Wurzel, 42.50 ist größer – die Wurzel und alle Knoten links davon sind kleiner und können ignoriert werden.73. 50 ist kleiner als 73. Damit erfüllen alle Knoten rechts von 73 unser Kriterium.73 kein linkes Kind hat, endet die Suche hier.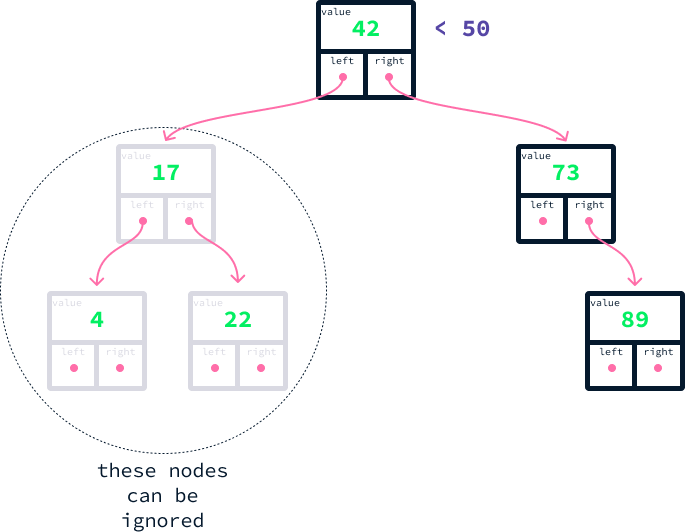
Schon hier siehst du, wie BSTs Abfragen deutlich beschleunigen. Selbst in diesem kleinen Beispiel haben wir die Hälfte der Daten übersprungen.
Allgemein erfordert das Finden aller Knoten in einem Bereich nur die Inspektion einer Anzahl von Knoten, die in der Größenordnung der Treffer liegt. Das ist ein enormer Vorteil gegenüber dem Prüfen jedes einzelnen Datensatzes. Stell dir 1.000.000 Inserate und eine Abfrage mit 10 Treffern vor: Mit einer Liste müsstest du alle eine Million prüfen. Mit einem BST inspizierst du etwa 10. Das ist ein Geschwindigkeitsfaktor von 100.000.
Die Effizienz eines BST hängt stark von dessen Balance ab. Fügen wir dieselben Werte wie zuvor in aufsteigender Reihenfolge ein – 4, 17, 22, 42, 73, 89 – kann ein unausbalancierter Baum entstehen, wie hier gezeigt:
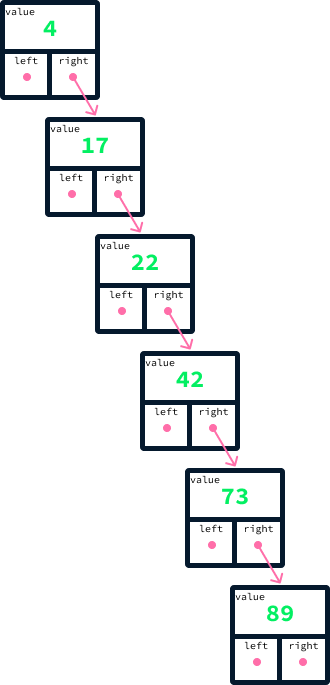
Erinnere dich: Um das Maximum zu finden, gehen wir von der Wurzel immer nach rechts, bis kein rechter Knoten mehr vorhanden ist. In einem unausbalancierten Baum wie oben müssen wir dabei jeden Knoten besuchen. Ideal ist eine gleichmäßige Verteilung links und rechts. Wie man diese Balance garantiert, sprengt hier den Rahmen. Ein BST-Typ, der Balance sichert, ist der AVL-Baum.
Das Paket avltree stellt eine Implementierung bereit. Der folgende Code zeigt den Einsatz auf diesem Listing-Datensatz, einem bereinigten Ausschnitt aus diesem USA Real Estate Dataset.
import csv
from avltree import AvlTree as Tree

# Load the listings CSV data
with open("listings.csv", "rt") as f:
    reader = csv.reader(f)
    listings = list(reader)

# Create the tree based on the price column (column index 2)
tree = Tree()
for listing in listings[1:]:
    price = float(listing[2])
    tree[price] = listing

# Display the cheapest listing price
print("Cheapest:", tree.minimum())

# Display the most expensive listing price
print("Most expensive:", tree.maximum())

# Display the number of listings whose price is between 100,000 and 110,000
listings_in_range = list(tree.between(100000, 110000))
print("Num listings between 100000 and 110000:", len(listings_in_range))
Cheapest: 50017.0
Most expensive: 19999900.0
Num listings between 100000 and 110000: 403Zuerst lesen wir den Datensatz listings.csv mit dem csv-Modul ein. Anschließend erzeugen wir einen AVL-Baum basierend auf der Preisspalte. Mit den Methoden minimum(), maximum() und between() bestimmen wir anschließend den Mindestpreis, den Höchstpreis und die Anzahl der Inserate zwischen 100.000 und 110.000 US-Dollar.
Zum Schluss betrachten wir noch Graphen.
Angenommen, du analysierst Daten einer Social-Media-Plattform: eine Liste von Nutzenden und deren Freundschaften. Du möchtest Communities im Netzwerk identifizieren. Eine Community kann man unterschiedlich definieren, meist ist es eine Gruppe, in der es besonders viele Freundschaften untereinander gibt.
Graphen sind die ideale Struktur, wenn es Entitäten und Beziehungen zwischen Paaren dieser Entitäten gibt. In unserem Beispiel sind die Entitäten die Nutzenden, die Beziehungen ihre Freundschaften.
Graphen sind knotenbasierte Strukturen. Anders als verkettete Listen und Bäume, die lineare oder hierarchische Verbindungen abbilden, kann in einem Graphen jeder Knoten mit mehreren anderen Knoten verbunden sein. Diese Verbindungen heißen Kanten und stellen die Beziehungen dar.
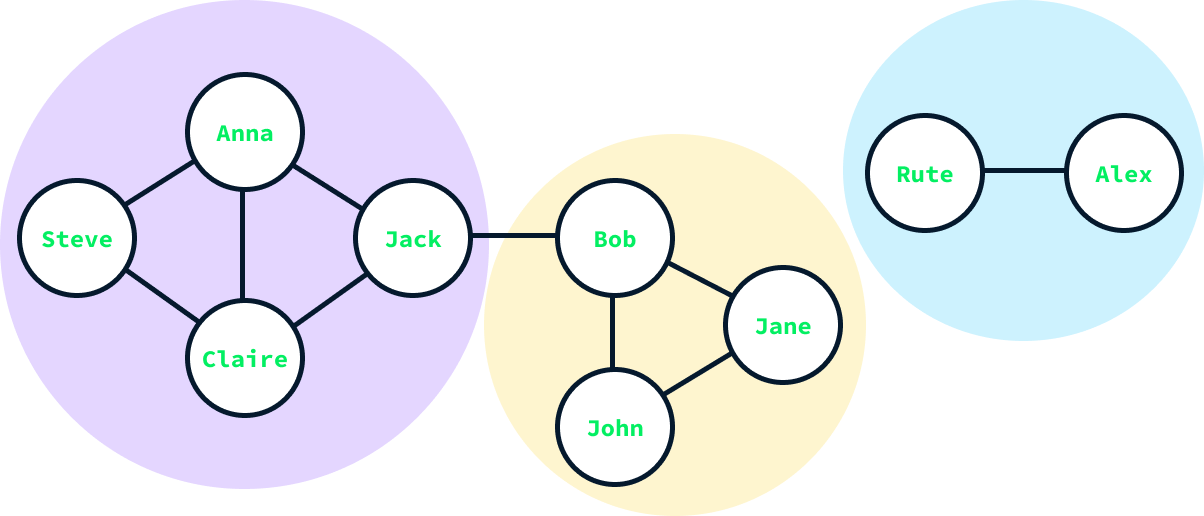
In unserem sozialen Netzwerk ist jeder Nutzer ein Knoten. Eine Kante zwischen zwei Knoten bedeutet eine Freundschaft zwischen den entsprechenden Personen.
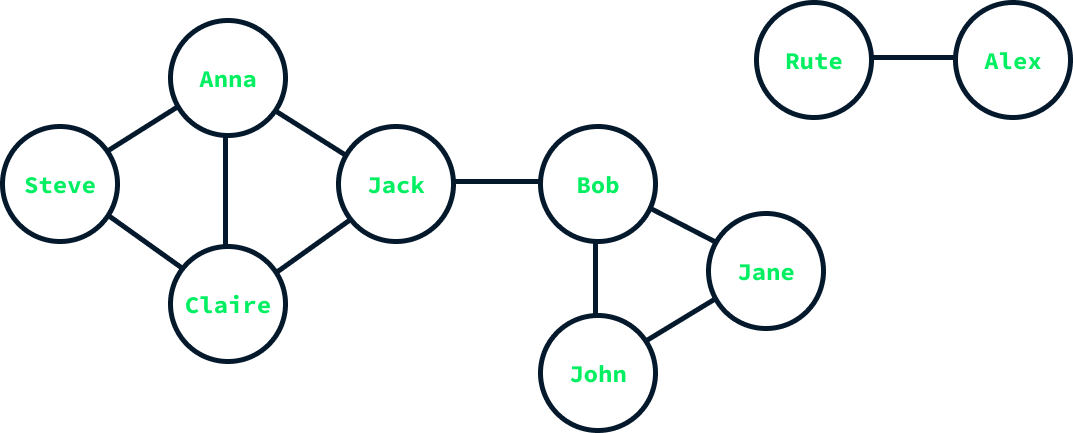
Die Grafik zeigt einen Graphen mit Freundschaften in einem kleinen Netzwerk. Knoten stehen für die Nutzenden und sind mit ihren Namen beschriftet, Kanten für die Freundschaften. Anna ist etwa mit Steve, Claire und Jack befreundet – entsprechend gibt es Kanten zwischen ihrem Knoten und deren Knoten.
Ein Graph sollte folgende Operationen unterstützen:
Eine gängige Implementierung nutzt Hashtabellen und Listen. Man legt eine Hashtabelle mit einem Eintrag pro Knoten an. Der Schlüssel ist der Knoten, der Wert eine Liste aller Knoten, mit denen er verbunden ist.
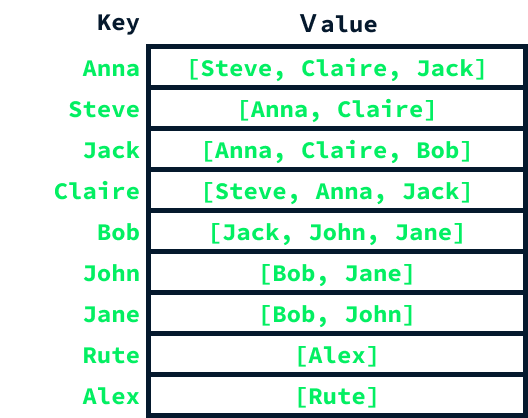
Das Paket networkx bietet eine Python-Implementierung zum Erstellen und Bearbeiten von Graphen. Außerdem bringt networkx zahlreiche Graph-Algorithmen mit, darunter Methoden zur Community-Erkennung. Wir bauen damit den obigen Graphen nach und wenden ein verbreitetes Verfahren zur Community-Erkennung an.
Zur Initialisierung importieren wir networkx und erzeugen einen leeren Graphen:
import networkx as nx
G = nx.Graph()
Knoten fügst du mit der Methode add_node() hinzu.
G.add_node("Anna")
G.add_node("Steve")
G.add_node("Jack")
G.add_node("Claire")
G.add_node("Bob")
G.add_node("Jane")
G.add_node("John")
G.add_node("Rute")
G.add_node("Alex")
Kanten fügst du mit der Methode add_edge() hinzu.
G.add_edge("Anna", "Steve")
G.add_edge("Anna", "Jack")
G.add_edge("Anna", "Claire")
G.add_edge("Steve", "Claire")
G.add_edge("Claire", "Jack")
G.add_edge("Jack", "Bob")
G.add_edge("Bob", "John")
G.add_edge("Bob", "Jane")
G.add_edge("John", "Jane")
G.add_edge("Rute", "Alex")
Mit dem erstellten Graphen können wir Communities berechnen. Es gibt mehrere Algorithmen dafür, hier nutzen wir die Louvain-Methode. Die Community-Algorithmen findest du im Unterpaket community von networkx. Konkret verwenden wir die Funktion louvain_communities().
So setzt du sie ein:
communities = nx.community.louvain_communities(G)
print(communities)
[{'Jack', 'Claire', 'Anna', 'Steve'}, {'Bob', 'John', 'Jane'}, {'Rute', 'Alex'}]Die Ausgabe ist eine Liste von Sets, wobei jedes Set eine Community repräsentiert. Der Algorithmus erkennt drei Communities – passend zur Struktur unseres Graphen.
Wenn du mehr über Graphen lernen willst, sieh dir dieses Tutorial zum Dijkstra-Algorithmus in Python an.
Zu jeder Datenstruktur haben wir die unterstützten Operationen genannt. Diese sind ein guter Leitfaden für den Einsatz – die Struktur ist genau darauf optimiert.
Zum Beispiel unterstützt die Python-list() weitere Operationen wie das Entfernen von Elementen. Dennoch ist das nicht die Stärke einer Array-Liste. Insbesondere das Entfernen in der Mitte erfordert das Kopieren nahezu aller Daten in eine neue Liste – das kann sehr zeitintensiv sein.
Wenn Daten natürlich numerisch indiziert sind und die Anzahl der Einträge feststeht (etwa die Tage eines Monats), ist ein Array meist erste Wahl. Für allgemeinere Indizes oder dynamische Datenmengen sind Dictionaries eine gute Alternative.
Wenn Daten sequentiell verarbeitet werden sollen – jeweils ein Eintrag nach dem anderen –, kommen je nach gewünschter Reihenfolge Queues oder Stacks zum Einsatz.
Bei komplexeren Abfragen wie Bereichssuchen oder Extremen sind häufig Bäume die richtige Antwort.
Gibt es Beziehungen zwischen Datenpaaren, bieten Graphen eine effiziente Art, diese Beziehungen zu speichern und zu analysieren. Es gibt zahlreiche Graph-Algorithmen, die typische Fragestellungen zu solchen Datensätzen beantworten.
Datenstrukturen sind ein weites Feld, und wir haben hier nur an der Oberfläche gekratzt. Manchmal ist die beste Lösung, eine passgenaue neue Struktur zu entwerfen. Mit den hier vorgestellten Datenstrukturen hast du jedoch eine solide Grundlage, um deine Datenprobleme gezielt anzugehen.
In diesem Artikel hast du gelernt: Datenstrukturen organisieren Daten in bestimmten Formaten, um Informationen effizient abzurufen.
Es gibt zwei grundlegende Arten von Datenstrukturen: array-basierte (z. B. Hashtabellen) und knotenbasierte (z. B. Graphen) Strukturen.
Lineare Strukturen wie Arrays, Queues und Stacks ordnen Elemente der Reihe nach an. Nichtlineare Strukturen wie Hashtabellen, Bäume und Graphen organisieren Daten anhand der Beziehungen zwischen den Daten.
Welche Datenstruktur passt, hängt davon ab, welche Abfragen du darauf ausführen willst.
Wenn du die verschiedenen Datenstrukturen in Python kennenlernen möchtest, lies dieses Tutorial zu Python-Datenstrukturen.
Lerne Python mit diesen Kursen!
Kurs
Kurs
Kurs