
Kurs
Einführung in Python
4 Std.
7M
Speichereffiziente Klassen in Python zu schreiben ist entscheidend, wenn du robuste Anwendungen entwickeln willst, die auch unter engen Systemvorgaben performant laufen. Ein effizienter Umgang mit Speicher beschleunigt die Laufzeit und verbessert die Skalierbarkeit, da weniger Ressourcen verbraucht werden — besonders relevant in Umgebungen mit begrenztem Arbeitsspeicher.
In diesem Artikel bekommst du einen Überblick über die Grundlagen des Speichermanagements in Python und lernst praktische Techniken kennen, um speichereffiziente Klassen zu schreiben. Ob komplexes System oder kleines Skript — diese Insights helfen dir, saubereren und effizienteren Python-Code zu schreiben.
Pythons Speichermanagement ist ausgeklügelt und nimmt dir viel Komplexität ab, indem es Speicheroperationen automatisiert. Dieses System ist essenziell, damit Python-Anwendungen effizient laufen.
Im Zentrum des Speichermanagements steht der private Heap. Dort werden alle Python-Objekte und Datenstrukturen abgelegt. Entwicklerinnen und Entwickler greifen nicht direkt auf diesen Heap zu, sondern arbeiten über Pythons Speichermanagement mit Objekten.
Das Speichermanagement nutzt:
Python kombiniert zwei Ansätze für Garbage Collection:
Speichernutzung zu verstehen und zu optimieren ist entscheidend für stabile Performance.
Python bietet mehrere Tools fürs Memory-Profiling, die tiefer gehen als klassisches Debugging und helfen, Ineffizienzen aufzuspüren und zu beheben:
In diesem Tutorial nutzen wir die pympler-Bibliothek. Du installierst sie mit pip im Terminal:
pip install pymplerMehr zum Memory-Profiling findest du in unserem Tutorial — Introduction to Memory Profiling in Python.
Jetzt, da die Basics des Speichermanagements klar sind, schauen wir uns fortgeschrittene Techniken an, um speichereffiziente Klassen zu schreiben.
__slots__ optimierenIn Python hat jede Klasseninstanz ein Dictionary namens __dict__ zur Speicherung von Instanzvariablen. Das ermöglicht zwar dynamisches Hinzufügen neuer Attribute, bringt aber spürbaren Overhead mit sich — insbesondere bei sehr vielen Instanzen. Definierst du __slots__, reserviert Python Speicher nur für eine feste Attributmenge und spart sich das dynamische Dictionary.
Der Einsatz von __slots__ bringt zwei Hauptvorteile:
__slots__ ist schneller als über ein Dictionary, da die direkte Lookup-Struktur Hash-Operationen umgeht.Betrachten wir eine einfache Klasse für einen Punkt im zweidimensionalen Raum:
class PointWithoutSlots:
   def __init__(self, x, y):
       self.x = x
       self.y = y

class PointWithSlots:
   __slots__ = ('x', 'y')
   def __init__(self, x, y):
       self.x = x
       self.y = y
In der Klasse PointWithoutSlots besitzt jede Instanz ein __dict__ für die Attribute x und y, während PointWithSlots darauf verzichtet und pro Instanz weniger Speicher verbraucht.
Um den Unterschied zu zeigen, erzeugen wir tausend Punkte und messen den Gesamtverbrauch mit pympler:
from pympler import asizeof

points_without_slots = [PointWithoutSlots(i, i) for i in range(1000)]
points_with_slots = [PointWithSlots(i, i) for i in range(1000)]

print("Total memory (without __slots__):", asizeof.asizeof(points_without_slots))
print("Total memory (with __slots__):", asizeof.asizeof(points_with_slots))
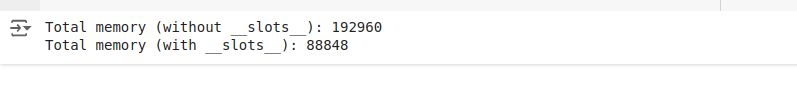
Die Ausgabe sieht so aus:
Speichervergleich mit und ohne Slots
Typischerweise zeigt sich, dass PointWithSlots weniger Speicher verbraucht als PointWithoutSlots — ein klarer Beleg für die Wirksamkeit von __slots__ zur Reduktion des Overheads pro Instanz.
__slots__Trotz der Vorteile gibt es Grenzen bei __slots__:
__slots__ definiert, kannst du nicht mehr dynamisch neue Attribute hinzufügen.__slots__ vererbt, muss die Subklasse ebenfalls __slots__ definieren, um weiterhin von der Optimierung zu profitieren. Das kann das Design verkomplizieren. Trotzdem sind __slots__ ein starkes Werkzeug, um den Speicherverbrauch zu senken — besonders bei vielen Instanzen oder in Umgebungen mit strengen Speicherlimits.
Speichereffiziente Design-Patterns sind architektonische Lösungen, die den Speicherbedarf in Python-Anwendungen reduzieren.
Zwei besonders wirksame Patterns sind Flyweight und Singleton. Richtig eingesetzt — etwa bei vielen Instanzen oder geteilten Daten — können sie den Speicherverbrauch drastisch senken.
Das Flyweight-Pattern teilt gemeinsame Teile des Zustands zwischen mehreren Objekten, anstatt alle Daten pro Objekt zu duplizieren. So sinkt der Gesamtspeicher deutlich.
Beispiel: Eine Zeichenanwendung mit Kreisen, die jeweils Farbe, Radius und Koordinaten haben. Mit Flyweight lassen sich geteilte Eigenschaften wie Farbe und Radius auslagern:
class Circle:
   # Flyweight object
   def __init__(self, color):
       self.color = color
   def draw(self, radius, x, y):
       print(f"Drawing a {self.color} circle with radius {radius} at ({x},{y})")

class CircleFactory:
   # Factory to manage Flyweight objects
   _circles = {}
   @classmethod
   def get_circle(cls, color):
       if not cls._circles.get(color):
           cls._circles[color] = Circle(color)
       return cls._circles[color]
In diesem Beispiel teilen sich mehrere Kreisinstanzen das Circle-Objekt aus der CircleFactory anhand der Farbe. Farbwerte werden dadurch nur einmal gespeichert.
Erzeugen wir nun Instanzen und schauen, wie Speicher gespart wird.
import sys

factory = CircleFactory()
circle1 = factory.get_circle("Red")
circle2 = factory.get_circle("Red")
circle3 = factory.get_circle("Blue")

print("Memory address of circle1:", id(circle1))
print("Memory address of circle2:", id(circle2))
print("Memory address of circle3:", id(circle3))
print ("-----------------------------")
print("Memory used by circle1:", sys.getsizeof(circle1))
print("Memory used by circle2:", sys.getsizeof(circle2))
print("Memory used by circle3:", sys.getsizeof(circle3))
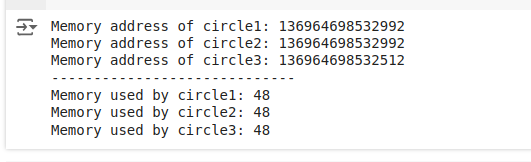
Die Ausgabe sieht so aus:
Speichernutzung beim Flyweight-Pattern
Wir sehen: circle1 und circle2 haben dieselbe Speicheradresse — sie sind also dasselbe Objekt (geteilte Instanz für „Red“). circle3 hat eine andere Adresse, da die Farbe „Blue“ eine eigene Instanz nötig macht.
circle1 und circle2 als gleiche Instanz belegen, dass die CircleFactory die Circle-Instanz erfolgreich teilt. Bei tausend roten Kreisen würdest du so nur eine einzige Farb-Instanz halten — und massiv Speicher sparen.
Das Singleton-Pattern stellt sicher, dass eine Klasse genau eine Instanz hat, die global zugreifbar ist. Das ist nützlich für Konfigurationen oder geteilte Ressourcen und spart Speicher, da keine mehrfachen, identischen Objekte entstehen.
Betrachte diese Database-Klasse:
class Database:
   _instance = None
   def __new__(cls):
       if cls._instance is None:
           cls._instance = super(Database, cls).__new__(cls)
           # Initialize any attributes of the instance here
       return cls._instance
   def connect(self):
       # method to simulate database connection
       return "Connection established"
Hier sorgt Database dafür, dass unabhängig von der Anzahl der Instanziierungen nur eine geteilte Instanz genutzt wird — das vermeidet duplizierte Objekte und spart Speicher.
Das prüfen wir so:
db1 = Database()
print(db1.connect())
db2 = Database()
print(db1 is db2)
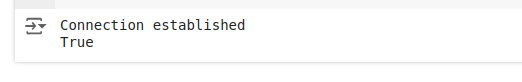
Die Ausgabe ist wie folgt:
Instanzerzeugung beim Singleton-Pattern
Das „True“ zeigt, dass die Variablen db1 und db2 auf dieselbe Instanz zeigen.
Diese Patterns zeigen, wie durchdachtes Design die Speichereffizienz deutlich steigern kann. Mit den passenden Patterns baust du Python-Anwendungen schlanker und performanter.
Die richtige Wahl des eingebauten Datentyps in Python hat großen Einfluss auf die Speichereffizienz. Built-ins sind in der Interpreter-Implementierung auf Performance und Speicher optimiert.
Je nach Anwendungsfall sind Tupel und Sets oft speicherschonender als Listen und Dictionaries.
Tupel brauchen in der Regel weniger Speicher als Listen, da sie eine feste Größe haben und unveränderlich sind. Das ermöglicht interne Optimierungen. Für Klassen, die Daten nach der Erstellung nicht mehr ändern, sind Tupel daher eine gute Wahl.
Zwei einfache Polygon-Klassen, eine mit Tupeln, eine mit Listen zur Speicherung:
class PolygonWithTuple:
   def __init__(self, points):
       self.points = tuple(points)  # Storing points as a tuple
   def display_points(self):
       return self.points

class PolygonWithList:
   def __init__(self, points):
       self.points = list(points)  # Storing points as a list
   def display_points(self):
       return self.points
Erzeugen wir Instanzen beider Klassen und vergleichen den Speicherverbrauch:
from pympler import asizeof

points = [(1, 2), (3, 4), (5, 6), (7, 8)]

# Creating instances of each class
polygon_tuple = PolygonWithTuple(points)
polygon_list = PolygonWithList(points)

# Memory usage comparison using pympler
print("Total memory used by Polygon with Tuple:", asizeof.asizeof(polygon_tuple))
print("Total memory used by Polygon with List:", asizeof.asizeof(polygon_list))
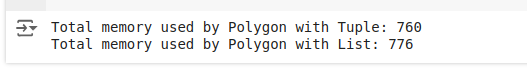
Die Ausgabe ist:
Speichervergleich für Tupel und Listen
Das Ergebnis zeigt: Das Tupel benötigt typischerweise weniger Speicher als die Liste — PolygonWithTuple ist daher für feste, unveränderliche Daten wie Koordinaten die speichereffizientere Wahl.
In Python sind Generatoren ein starkes Mittel für speicherschonende Verarbeitung, besonders bei großen Datenmengen.
Generatoren verarbeiten Daten Element für Element und laden jeweils nur das Nötige in den Speicher. Diese Lazy Evaluation ist ideal, wenn große Datenmengen schrittweise verarbeitet werden, wodurch der Footprint gering bleibt.
Angenommen, eine Anwendung berechnet das Durchschnittsalter vieler Nutzer. Anstatt alle Datensätze in eine Liste zu laden, verarbeitet ein Generator jeweils nur eine Zeile.
def process_records(file_name):
   """Generator that yields user ages from a file one at a time."""
   with open(file_name, 'r') as file:
       for line in file:
           user_data = line.strip().split(',')
           yield int(user_data[1])

def average_age(file_name):
   """Calculate the average age from user records."""
   total_age = 0
   count = 0
   for age in process_records(file_name):
       total_age += age
       count += 1
   return total_age / count if count else 0

print("Average Age:", average_age('user_data.csv'))
Hier liest process_records() zeilenweise aus einer Datei, wandelt den relevanten Teil in eine Zahl um und liefert ihn per yield zurück. So befindet sich immer nur eine Zeile im Speicher. average_age() konsumiert den Generator und akkumuliert Summe und Anzahl — ohne den gesamten Datensatz gleichzeitig laden zu müssen.
Mit diesem Lazy-Ansatz sparst du Speicher und erhöhst Reaktionsfähigkeit und Skalierbarkeit deiner Anwendung.
Zirkuläre Referenzen entstehen, wenn sich zwei oder mehr Objekte gegenseitig referenzieren. Das passiert leicht mit Strukturen wie Listen, Dictionaries oder komplexeren Klassen, in denen Instanzen wechselseitig Verweise halten.
Wie in den Grundlagen gesehen, erkennt Pythons zusätzlicher Garbage Collector solche Zyklen und bereinigt sie. Sich ausschließlich darauf zu verlassen, kann jedoch die Speichernutzung erhöhen und ineffizient sein:
Ein typischer Fall sind Bäume, in denen ein Knoten Referenzen auf seine Kinder und optional auf den Elternknoten hält. Diese Parent-Child-Verknüpfung erzeugt leicht Zyklen.
class TreeNode:
   def __init__(self, value, parent=None):
       self.value = value
       self.parent = parent
       self.children = []
   def add_child(self, child):
       child.parent = self  # Set parent reference
       self.children.append(child)

root = TreeNode("root")
child = TreeNode("child1", root)
root.add_child(child)
Hier referenziert root sein child über die children-Liste, und child referenziert root über das Attribut parent. So kann ohne weiteres Zutun ein Zyklus entstehen.
Schwache Referenzen sind ein wirkungsvolles Mittel, um zirkuläre Referenzen zu durchbrechen, ohne die Datenstruktur komplett neu zu entwerfen.
Pythons Modul weakref ermöglicht Referenzen, die den Referenzzähler nicht erhöhen. Dadurch kann das referenzierte Objekt trotz Verweises gesammelt werden — Speicherlecks durch Zyklen werden vermieden.
So passen wir die Klasse an:
import weakref

class TreeNode:
   def __init__(self, value, parent=None):
       self.value = value
       self.parent = weakref.ref(parent) if parent else None
       self.children = []
   def add_child(self, child):
       child.parent = weakref.ref(self)
       self.children.append(child)
root = TreeNode("root")
child = TreeNode("child1", root)
root.add_child(child)
Das Attribut parent ist nun eine schwache Referenz. Der Elternknoten kann also gesammelt werden, auch wenn das Kind noch existiert, solange keine weiteren starken Referenzen auf den Eltern zeigen.
So verhinderst du effizient Speicherlecks, die typischerweise mit zirkulären Referenzen einhergehen.
Dieser Artikel hat die Grundlagen des Speichermanagements in Python erklärt und fünf fortgeschrittene Techniken für speichereffiziente Klassen vorgestellt — inklusive Praxisbeispielen und Speichervergleichen. Wir hoffen, du setzt diese Techniken in deinen Projekten ein, um skalierbare und effiziente Anwendungen zu bauen.
Schau dir auch unseren Python Programming track an, der Software-Engineering-Prinzipien und objektorientierte Programmierung abdeckt — inklusive Writing Efficient Python Code.
Lerne mehr über Python mit diesen Kursen!
Kurs
Kurs
Kurs