
Cours
Structures de données et algorithmes en Python
4 h
47.1K
Les structures de données existent autant dans le monde numérique que physique. Un dictionnaire en est un exemple concret : les données (les définitions) y sont classées par ordre alphabétique. Cette organisation permet une requête précise : à partir d’un mot, on en retrouve la définition.
Au fond, une structure de données est une façon d’organiser l’information afin de faciliter certains types de requêtes et d’opérations.
Nous allons commencer par les structures linéaires comme les tableaux, listes, files (queues) et piles (stacks). Nous reviendrons ensuite sur la différence entre structures linéaires et non linéaires avant d’aborder les tables de hachage, les arbres et les graphes.
Pour aller plus loin, découvrez ce cours sur les structures de données et algorithmes en Python.
Les tableaux sont des structures de données fondamentales, largement disponibles dans les langages de programmation. Ils permettent de stocker un nombre fixe (N) de valeurs, placées séquentiellement en mémoire.
Les éléments d’un tableau sont indexés du premier élément à l’index (0) jusqu’au dernier à l’index (N-1).
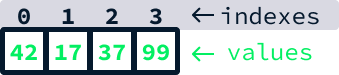
Ils permettent notamment les opérations suivantes :
Les tableaux sont très efficaces lorsque le nombre de valeurs à stocker est connu à l’avance et que les opérations principales consistent à lire et écrire à des indexes précis.
Supposons que vous deviez stocker les relevés quotidiens de température pour le mois de décembre. Vous souhaitez permettre aux utilisateurs de retrouver la température d’un jour précis et de calculer diverses statistiques sur le mois.
Comme le nombre de jours de décembre est connu (31), un tableau est un excellent choix pour stocker ces relevés. On crée d’abord un tableau de 31 cases vides. Puis, à chaque nouveau relevé, on affecte la température du jour à l’index correspondant : le jour 1 à l’index 0, le jour 2 à l’index 1, …, et le jour 31 à l’index 30.
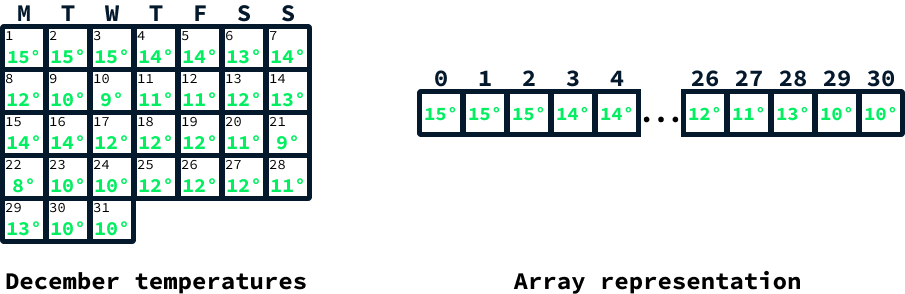
Accéder à l’index correspondant permet de retrouver la température d’un jour donné. Des statistiques comme la moyenne se calculent en parcourant tous les éléments, en conservant une somme cumulée, puis en divisant par la taille du tableau.
Les tableaux ne sont pas disponibles nativement en Python. Ils servent en coulisses de structure sous-jacente à divers types, mais ne sont pas directement pris en charge dans le langage. Pour les utiliser explicitement, on peut recourir à des bibliothèques comme array. Toutefois, il est souvent plus pratique d’utiliser une liste de taille fixe dans les situations où l’on emploierait un tableau. Les listes sont flexibles et au cœur de Python, comme nous allons le voir.
On peut créer une liste pour simuler un tableau de 31 éléments, chacun initialisé à None, avec [None] * 31. Ici, None indique qu’aucun relevé n’a encore été enregistré.
december_temperatures = [None] * 31Pour définir la valeur à un index spécifique, on utilise december_temperatures[index], où index est un nombre de 0 à 30. Par exemple, pour enregistrer la température du premier jour (stockée à l’index 0) :
december_temperatures[0] = 15L’accès à une température se fait de la même manière, via december_temperatures[index].
print(december_temperatures[0])15Imaginons maintenant qu’au lieu de se limiter à décembre, nous installions un capteur pour relever périodiquement la température sur une durée indéterminée. Dans ce cas, un tableau n’est pas idéal, car sa taille fixe risque de ne pas suffire.
Une structure plus adaptée serait une liste. Il en existe deux grandes familles :
Les listes par tableau sont une version plus flexible des tableaux. Elles offrent les mêmes fonctionnalités, mais peuvent aussi ajouter de nouvelles valeurs, leur taille n’étant pas figée à la création. En Python, cela correspond à list().
Elles s’appuient sur un tableau sous-jacent qui est agrandi lorsque l’espace vient à manquer, d’où le nom de array list. Mais puisque les tableaux ne peuvent pas grandir, comment est-ce possible ?
Quand le tableau sous-jacent est plein et qu’on souhaite ajouter une nouvelle valeur, un tableau plus grand est créé en arrière-plan. Toutes les valeurs précédentes y sont copiées, puis la nouvelle valeur est ajoutée à la première position disponible.
Imaginons que nous voulions ajouter la valeur 71 à ce tableau :
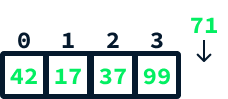
Voici comment cela peut se passer :
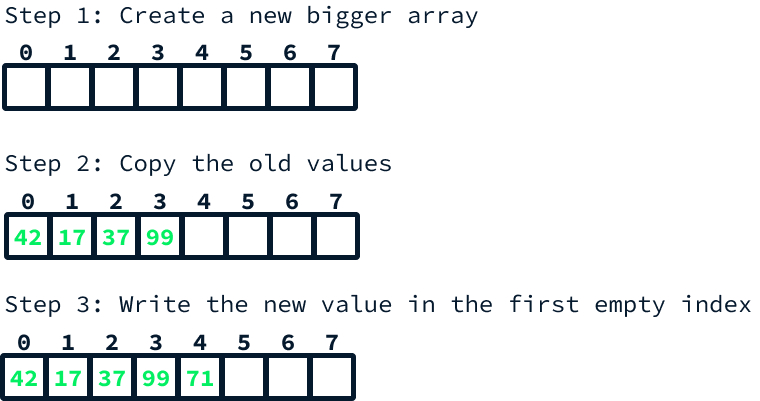
La quantité d’espace supplémentaire allouée à chaque réallocation est cruciale pour les performances. Si, à chaque ajout, on créait un tableau avec une seule case de plus, chaque ajout impliquerait de copier l’intégralité des données existantes — extrêmement inefficace à grande échelle.
La stratégie courante consiste plutôt à doubler la taille du tableau à chaque agrandissement. On peut montrer que, sur le long terme, cela annule l’effet des copies supplémentaires.
Pour ajouter des éléments à une liste Python, on utilise la méthode .append(). Exemple : créer une liste vide et y ajouter une température :
temperatures = []
temperatures.append(35)Pour structurer des données en informatique, il faut relier les valeurs entre elles. Les tableaux le font en allouant des emplacements contigus en mémoire et en stockant les valeurs séquentiellement. On peut les comparer à une rangée de maisons : chaque maison a son adresse (index) et toutes sont côte à côte.
Ce n’est toutefois pas la seule manière d’organiser les données. Une alternative consiste à utiliser une structure à base de nœuds.
Un nœud est un objet qui stocke une valeur et des références vers d’autres nœuds. Pour créer une structure de type liste, un nœud peut contenir une valeur et une référence vers l’élément suivant de la liste. En Python, on peut l’implémenter avec une classe :
class Node:
    def __init__(self, value, next_node):
        self.value = value
        self.next_node = next_node
Avec cette approche, on crée une liste en chaînant les valeurs via la référence next_node. Voici un extrait qui crée une liste avec les valeurs 42, 17 et 37 :
node_37 = Node(37, None) # Aucun nœud après 37, next_node vaut None
node_17 = Node(17, node_37)
node_42 = Node(42, node_17)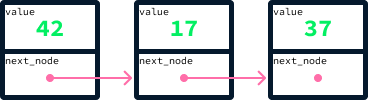
Relier manuellement les nœuds n’est pas pratique. En réalité, on crée une autre classe qui maintient des références vers le premier et le dernier nœud de la liste. Pour ajouter une valeur, on :
Imaginons que nous voulions ajouter la valeur 71 à notre exemple :
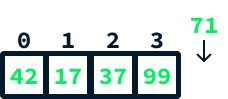
On peut procéder ainsi :
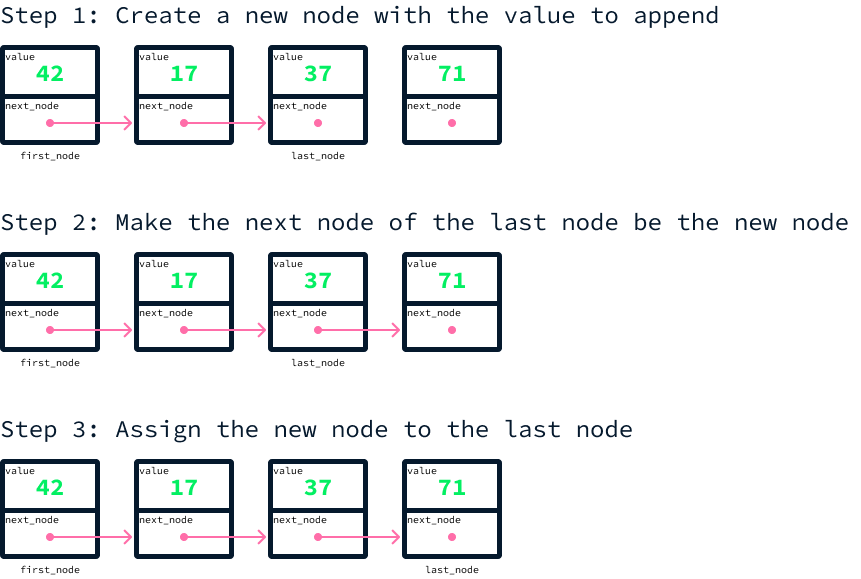
class LinkedList:
    def __init__(self):
        self.first_node = None
        self.last_node = None

    def append(self, value):
        node = Node(value, None)
        if self.first_node is None:
            self.first_node = node
            self.last_node = node
        else:
            self.last_node.next_node = node
            self.last_node = node
Contrairement aux listes par tableau, on ne peut pas accéder directement à une valeur par son index. Pour lire la valeur à un index donné, il faut partir du premier nœud et avancer de nœud en nœud jusqu’à l’index visé. C’est bien plus lent que l’accès direct. Avec des millions de valeurs, il faudrait parcourir autant d’éléments en mémoire pour atteindre un index précis.
L’intérêt d’une liste chaînée est de pouvoir ajouter et retirer instantanément des éléments en tête ou en fin de liste. Cela permet d’implémenter efficacement deux autres structures : les files (queues) et les piles (stacks), que nous allons voir.
Imaginez que vous développez une application de restaurant qui enregistre les commandes des clients et les envoie en cuisine. Les clients font la queue pour commander et s’attendent à être servis dans l’ordre d’arrivée : le premier arrivé est servi le premier, le dernier arrivé est servi en dernier.
En cuisine, le chef préfère traiter une commande à la fois ; l’application ne doit donc afficher que la commande en cours. Une fois une commande préparée et envoyée, la suivante dans la file doit s’afficher.
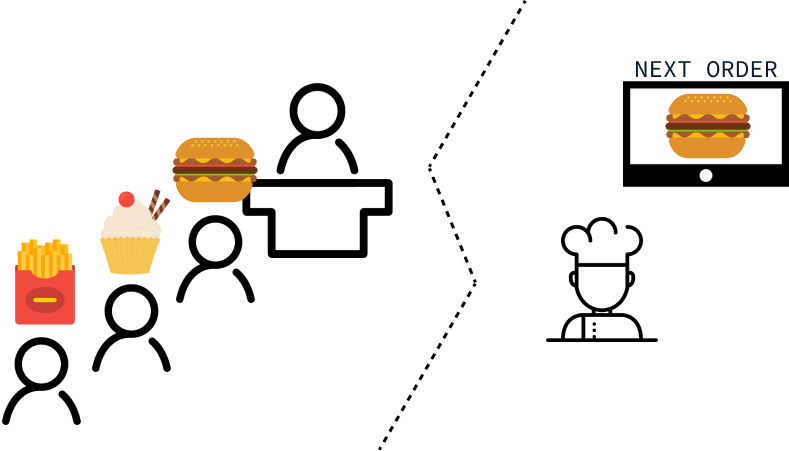
Les besoins se traduisent par une structure de données qui gère les opérations suivantes :
C’est exactement ce que propose une file. On peut l’implémenter avec une liste chaînée, en ajoutant les éléments en fin de liste. L’ordre étant celui d’arrivée, le premier nœud est toujours le prochain à servir.
Voici comment les commandes ci-dessus seraient stockées dans la file :
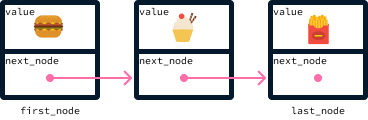
Une fois une commande prête, on la retire en mettant à jour le premier élément vers son next_node, s’il existe. Le nouveau premier nœud devient l’ancien deuxième :
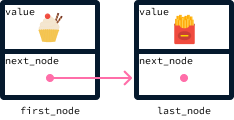
Les files sont dites first-in, first-out (FIFO) : le premier élément ajouté est le premier retiré. Dans notre exemple, le premier client arrivé est le premier servi (et retiré de la liste du chef).
En Python, on peut utiliser la collection deque du module collections. Importez le module et créez une file vide comme suit :
from collections import deque
orders = deque()
Pour ajouter un élément en fin de file, utilisez la méthode .append() :
orders.append("burger")
orders.append("sunday")
orders.append("fries")
Pour récupérer et retirer la prochaine commande en tête de file, utilisez la méthode .popleft() :
orders.append("burger")
orders.append("sunday")
orders.append("fries")
burger
sunday
friesDans certaines situations, on souhaite l’inverse du comportement d’une file : suivre l’élément ajouté le plus récemment.
Par exemple, vous devez ajouter une fonction d’annulation (undo) dans un éditeur d’images. Il faut pouvoir suivre les actions de l’utilisateur et accéder en priorité aux plus récentes, car l’annulation revient généralement sur la dernière action effectuée, puis remonte dans l’historique.
Une pile est précisément la structure qui prend en charge ces opérations :
Comme les files, les piles peuvent s’appuyer sur une liste chaînée. On ajoute toujours en fin de liste. Mais l’intérêt porte sur le dernier élément, pas le premier. Pour récupérer l’élément le plus récent, on lit le dernier élément ; pour le retirer, on le supprime.
Dans notre structure de nœuds, nous ne suivions que le nœud suivant. Pour faciliter la suppression du dernier élément, nous devons accéder à l’élément qui le précède, supprimer son next_node et le promouvoir en dernier. Pour cela, on enrichit la structure pour suivre aussi le nœud précédent : on parle alors de liste chaînée doublement chaînée.
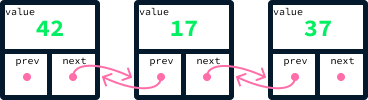
Les piles sont dites LIFO (last-in, first-out) : le dernier élément ajouté est le premier retiré.
Pour utiliser une pile en Python, on peut réutiliser deque. On ajoute des éléments avec .append() :
from collections import deque
actions = deque()

actions.append("crop")
actions.append("desaturate")
actions.append("resize")
Pour récupérer et retirer l’élément au sommet de la pile, on utilise .pop() :
print(actions.pop())
print(actions.pop())
print(actions.pop())
resize
desaturate
cropJusqu’ici, nous avons vu cinq structures : tableaux, listes par tableau, listes chaînées, files et piles. Chacune est dite linéaire car ses éléments sont ordonnés en séquence, avec pour chacun un précédent et un suivant.
Passons maintenant aux structures non linéaires. À la différence des précédentes, elles n’organisent pas les éléments de façon strictement séquentielle. Il n’y a donc pas de notion unique de précédent/suivant ; on y encode plutôt d’autres types de relations entre éléments.
Elles se prêtent particulièrement bien à des requêtes spécialisées et très efficaces sur les données, au-delà du simple stockage en mémoire.
Nous avons commencé avec un exemple réel : les dictionnaires. Organiser les données de façon à pouvoir les retrouver via un champ spécifique (par exemple, obtenir une définition à partir d’un mot) est extrêmement utile. Les informaticiens ont donc conçu une structure qui permet cela.
Pour la comprendre, créons un dictionnaire virtuel — une structure permettant :
Rappelons l’exemple des températures de décembre. Nous avons utilisé un tableau de 31 éléments correspondant aux jours du mois, ce qui permet de retrouver efficacement la température d’un jour donné.
On manipule ainsi des paires (jour, température) pour récupérer la température à partir du jour. De même, dans le cas d’un dictionnaire, on manipule des paires (mot, définition) pour retrouver la définition à partir d’un mot.
Ces paires sont appelées paires clé-valeur (ou entrées). La clé sert à la recherche, la valeur est le résultat renvoyé.
|
clé |
valeur |
|
|
Problème des températures de décembre |
jour |
température |
|
Problème du dictionnaire |
mot |
définition |
Ce qui nous empêche d’utiliser un tableau pour le dictionnaire, c’est que les clés sont des chaînes, pas des nombres. Avec des clés numériques, on peut associer directement clés et valeurs en positionnant la valeur à l’index correspondant.
Pour résoudre cela, il faut d’abord convertir les mots en nombres. Une fonction qui effectue cette conversion est une fonction de hachage. Il en existe de nombreuses. Par exemple, on peut attribuer une valeur numérique à chaque lettre (a=1, b=2, c=3, etc.) et sommer ces valeurs.
Par exemple, le mot data donnerait 4 + 1 + 20 + 1 = 26. Cette fonction a toutefois des limites, que nous verrons. Les détails d’une bonne fonction de hachage dépassent le cadre de cet article, mais Python fournit une fonction hash() qui s’en charge efficacement.
hash("data")-6138587229816301269Vous avez peut‑être noté que la fonction a renvoyé un nombre négatif. Or, les indexes positifs d’un tableau vont de 0 à N − 1. Une fois les clés converties en nombres, on peut les ramener dans l’intervalle 0 à N − 1 avec l’opérateur modulo % (qui renvoie le reste d’une division — par exemple, 10 % 3 renvoie 1).
À noter : la fonction hash() de Python peut retourner des valeurs différentes entre exécutions. Elle n’est déterministe qu’au sein d’un même lancement du programme ; vous pouvez donc observer des hachages différents pour le même objet entre deux exécutions.
Considérons un tableau de 100 éléments. Pour obtenir l’index correspondant à la chaîne "data" :
hash("data") % 10031Une table de hachage est essentiellement un grand tableau qui stocke des paires clé‑valeur à des indexes déterminés par l’application d’une fonction de hachage aux clés.
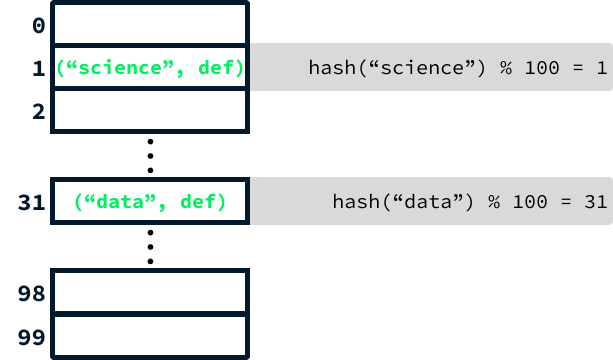
Par manque d’espace, le schéma n’affiche que « def » pour représenter la définition. En pratique, le second élément de chaque entrée serait bien la définition complète du mot.
Un autre point clé : comme il existe bien plus de 100 mots, si l’on continue d’ajouter des entrées, des mots distincts finiront par produire la même valeur de hachage. Pour y remédier, au lieu de limiter chaque case du tableau à une seule paire clé‑valeur, on utilise une liste chaînée pour stocker toutes les entrées partageant la même valeur de hachage.
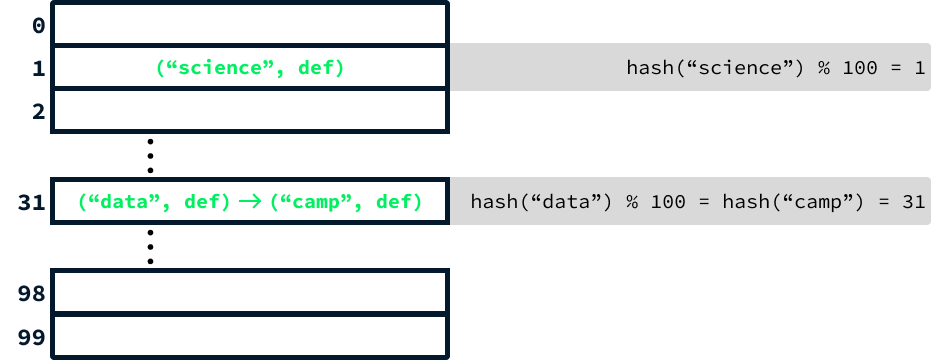
Lorsque deux entrées produisent le même hachage, on parle de collision. Cela modifie un peu la recherche : après avoir calculé le code de hachage, il faut parcourir la liste pour trouver la bonne entrée. C’est plus lent, mais avec une taille initiale de tableau suffisante et une bonne fonction de hachage, l’impact des collisions reste très limité ; l’efficacité se rapproche alors de celle d’un tableau.
Avec une fonction de hachage bien conçue, trouver des valeurs distinctes ayant le même hachage doit être rare. C’est pourquoi une fonction se contentant d’additionner les valeurs des lettres n’est pas idéale : deux anagrammes auraient le même hachage (par exemple « listen » et « silent »). À l’inverse, la fonction intégrée de Python est bien plus robuste et vise à minimiser les collisions.
Les tables de hachage sont sans doute la structure la plus importante. Elles sont extrêmement efficaces et polyvalentes. En Python, elles sont implémentées via la classe dict(). En raison de la ressemblance avec un dictionnaire, la structure est d’ailleurs appelée « dictionnaire » en Python.
Pour simplifier, notre exemple se limite à l’ajout et à la recherche. En pratique, les dictionnaires offrent plus d’opérations, dont la suppression. Pour créer un dictionnaire (table de hachage) vide en Python, utilisez {} comme ceci :
word_definitions = {}
word_definitions["data"] = "Facts or information."
Vous pouvez accéder à la définition d’un mot en utilisant ce mot comme clé :
print(word_definitions["data"])Facts or information.Supposons que vous développiez un site pour une agence immobilière. Vous devez proposer un filtre par prix permettant de :
Classiquement, on parcourrait toutes les annonces et on filtrerait celles qui sortent de la fourchette. Notre objectif est plutôt d’obtenir une solution qui passe à l’échelle, sans devoir examiner l’ensemble des données. Les arbres sont parfaits pour ce type de requête.
Les arbres sont des structures à base de nœuds, comme les listes chaînées. Mais au lieu de références « précédent » et « suivant », chaque nœud contient une valeur et deux références : un nœud gauche et un nœud droit.
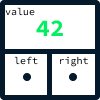
Dans l’exemple de l’agence immobilière, chaque nœud représente une annonce. Pour optimiser les requêtes liées au prix, on impose une règle : les annonces moins chères sont toujours stockées à gauche d’un nœud, les plus chères à droite.
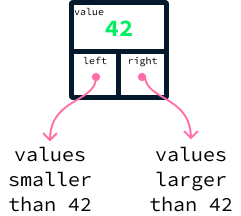
Par exemple, considérons l’arbre contenant les valeurs 42, 17, 73, 4, 22 et 89.
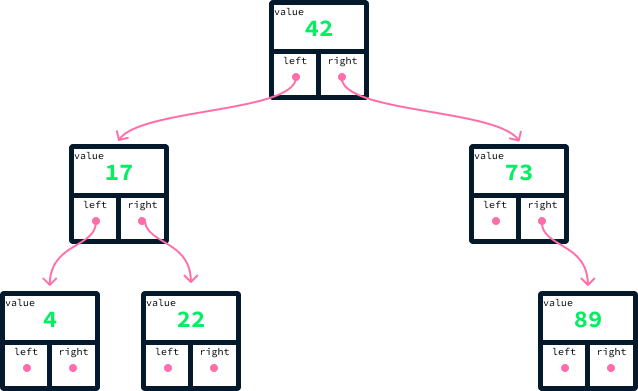
Pour chaque nœud, tous les nœuds à gauche ont une valeur plus petite et tous ceux à droite une valeur plus grande. Un arbre respectant cette propriété est un arbre binaire de recherche (BST). Il est binaire car chaque nœud a au plus deux enfants. La recherche est rendue efficace grâce à cet ordre gauche/droite.
On voit immédiatement comment un BST accélère la recherche des extrêmes : la valeur minimale se trouve toujours tout à gauche, la maximale tout à droite.
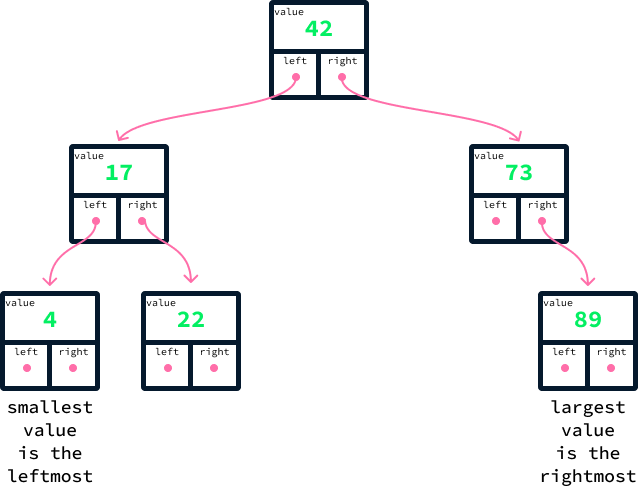
On peut ainsi les localiser sans examiner la majorité des données. En partant de la racine (root), on suit systématiquement les liens à gauche pour le minimum et à droite pour le maximum. Seuls les nœuds sur ces chemins sont inspectés.
Imaginons que nous voulions trouver tous les nœuds dont la valeur est au moins 50. Voici les étapes :
50 à la valeur de la racine 42.50 est plus grand, on sait que la racine et tous les nœuds de son côté gauche sont plus petits : on peut les ignorer.73. 50 est plus petit que 73 : tous les nœuds à droite de 73 satisfont notre critère.73 n’a pas d’enfant gauche, la recherche s’arrête là.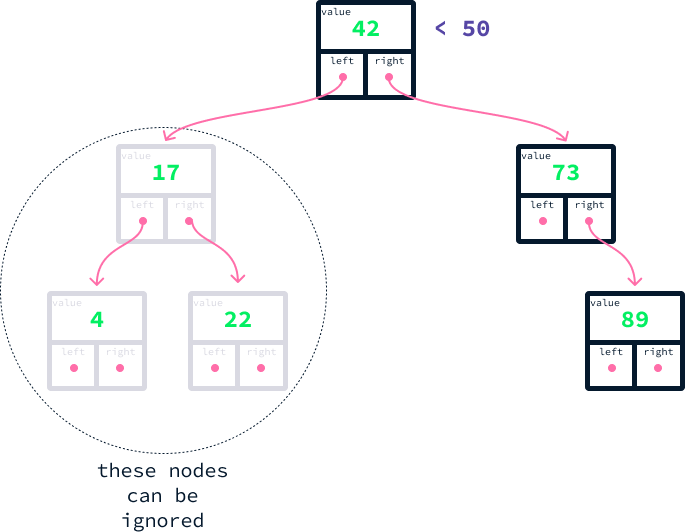
On voit déjà comment les BST accélèrent fortement les requêtes. Même dans ce petit exemple, nous avons évité d’examiner la moitié des données.
De manière générale, identifier tous les nœuds d’un BST dans une plage donnée nécessite d’inspecter un nombre de nœuds proche du nombre de résultats. C’est un atout majeur par rapport à l’inspection exhaustive. Imaginez 1 000 000 d’annonces pour seulement 10 résultats pertinents : avec une liste, il faudrait parcourir le million d’entrées ; avec un BST, on en inspecte environ 10 — un gain d’un facteur 100 000.
L’efficacité d’un BST dépend fortement de son équilibre. Si l’on ajoute les valeurs précédentes dans l’ordre croissant — 4, 17, 22, 42, 73, puis 89 — on peut obtenir un arbre déséquilibré, comme ci‑dessous :
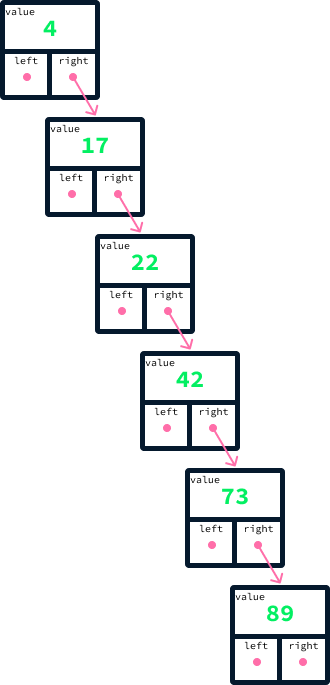
Pour trouver le maximum dans un BST, on part de la racine et on suit les liens à droite jusqu’à un nœud sans enfant droit. Dans un arbre très déséquilibré, il faut examiner tous les nœuds. L’idéal est une répartition équilibrée entre gauche et droite. Les mécanismes de rééquilibrage dépassent ce billet ; un type d’arbre binaire de recherche connu pour maintenir l’équilibre est l’arbre AVL.
Le package avltree propose une implémentation d’AVL. L’exemple ci‑dessous l’utilise sur ce jeu de données d’annonces, un sous‑ensemble nettoyé de ce dataset immobilier USA.
import csv
from avltree import AvlTree as Tree

# Load the listings CSV data
with open("listings.csv", "rt") as f:
    reader = csv.reader(f)
    listings = list(reader)

# Create the tree based on the price column (column index 2)
tree = Tree()
for listing in listings[1:]:
    price = float(listing[2])
    tree[price] = listing

# Display the cheapest listing price
print("Cheapest:", tree.minimum())

# Display the most expensive listing price
print("Most expensive:", tree.maximum())

# Display the number of listings whose price is between 100,000 and 110,000
listings_in_range = list(tree.between(100000, 110000))
print("Num listings between 100000 and 110000:", len(listings_in_range))
Cheapest: 50017.0
Most expensive: 19999900.0
Num listings between 100000 and 110000: 403Nous utilisons d’abord le module csv pour lire le fichier listings.csv. Nous créons ensuite un arbre AVL basé sur la colonne de prix. Les méthodes minimum(), maximum() et between() nous servent à obtenir le prix minimum, le prix maximum et le nombre d’annonces entre 100 000 $ et 110 000 $.
La dernière structure que nous aborderons ici est le graphe.
Supposons que vous analysiez des données issues d’un réseau social. Elles comprennent une liste d’utilisateurs et les amitiés entre eux, et vous cherchez à identifier des communautés. Sans entrer dans les détails, une communauté désigne un groupe d’utilisateurs ayant un nombre significatif de liens entre eux.
Les graphes sont la structure idéale lorsqu’il y a des entités et des relations par paires entre ces entités. Dans notre exemple, les entités sont les utilisateurs et les relations, leurs amitiés.
Les graphes sont des structures à base de nœuds. Contrairement aux listes chaînées et aux arbres (linéaires ou hiérarchiques), un graphe permet à un nœud de se connecter à plusieurs autres nœuds sans contrainte hiérarchique. Ces connexions, appelées arêtes, représentent les relations.
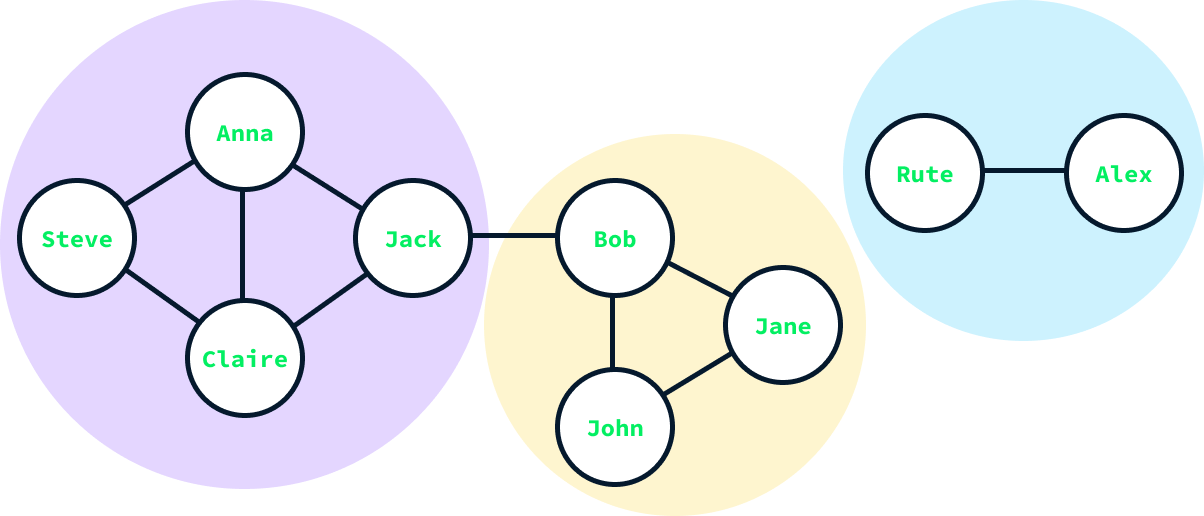
Dans notre réseau social, chaque utilisateur est un nœud. Une arête entre deux nœuds matérialise une amitié.
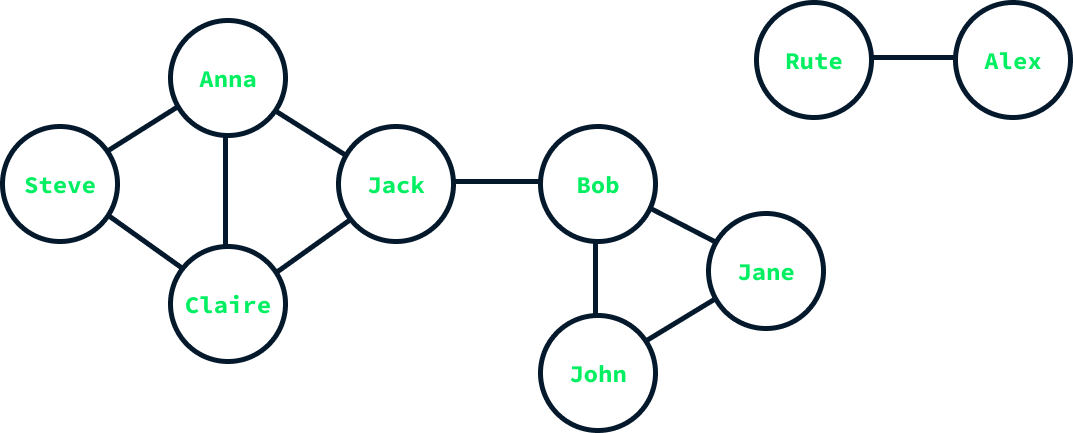
Le schéma ci‑dessus représente un petit réseau d’amitiés. Les nœuds sont les utilisateurs, étiquetés par leurs prénoms, et les arêtes sont les amitiés. Par exemple, Anna est amie avec Steve, Claire et Jack : des arêtes relient son nœud aux leurs.
Les opérations qu’un graphe doit supporter incluent :
Une implémentation courante s’appuie sur une table de hachage et des listes. On crée une table avec une entrée par nœud : la clé est le nœud, la valeur est la liste des nœuds auxquels il est connecté.
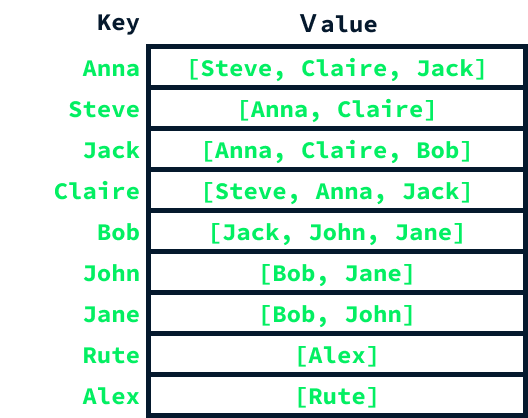
Le package networkx offre une implémentation Python pour créer et manipuler des graphes. Il inclut aussi de nombreux algorithmes, notamment pour la détection de communautés. Utilisons‑le pour construire le graphe précédent et appliquer un algorithme courant afin d’en observer les résultats.
Pour commencer, importons networkx et initialisons un graphe vide :
import networkx as nx
G = nx.Graph()
On ajoute des nœuds avec la méthode add_node().
G.add_node("Anna")
G.add_node("Steve")
G.add_node("Jack")
G.add_node("Claire")
G.add_node("Bob")
G.add_node("Jane")
G.add_node("John")
G.add_node("Rute")
G.add_node("Alex")
On ajoute des arêtes avec add_edge().
G.add_edge("Anna", "Steve")
G.add_edge("Anna", "Jack")
G.add_edge("Anna", "Claire")
G.add_edge("Steve", "Claire")
G.add_edge("Claire", "Jack")
G.add_edge("Jack", "Bob")
G.add_edge("Bob", "John")
G.add_edge("Bob", "Jane")
G.add_edge("John", "Jane")
G.add_edge("Rute", "Alex")
Une fois le graphe construit, nous pouvons calculer ses communautés. Plusieurs algorithmes existent ; ici nous utilisons la méthode de Louvain. Les algorithmes de communautés sont disponibles dans le sous‑package community de networkx, et nous allons employer la fonction louvain_communities().
Voici comment l’utiliser :
communities = nx.community.louvain_communities(G)
print(communities)
[{'Jack', 'Claire', 'Anna', 'Steve'}, {'Bob', 'John', 'Jane'}, {'Rute', 'Alex'}]La sortie est une liste d’ensembles, chaque ensemble représentant une communauté. L’algorithme a détecté trois communautés, ce qui correspond à la structure du graphe.
Pour en savoir plus sur les graphes, apprenez à implémenter l’algorithme de Dijkstra en Python.
Pour chaque structure, nous avons listé les opérations prises en charge. Elles servent de guide : utilisez une structure lorsqu’elle réalise efficacement les opérations dont vous avez besoin.
Par exemple, list() en Python permet aussi de supprimer des éléments. Mais ce n’est pas le point fort d’une liste par tableau : retirer un élément au milieu nécessite de copier toutes les données (sauf l’élément supprimé) dans une nouvelle liste, ce qui peut être coûteux.
Quand les données sont naturellement indexées par des nombres et que le nombre d’entrées est connu (par exemple, les jours d’un mois), un tableau est souvent le meilleur choix. Pour un indexage plus générique ou des jeux de données dynamiques, les dictionnaires sont une bonne alternative.
Pour traiter les données séquentiellement, une entrée à la fois, on utilisera plutôt des files ou des piles, selon l’ordre souhaité de traitement.
Les arbres répondent bien aux requêtes plus complexes, comme la recherche d’entrées dans une plage de valeurs ou d’extrêmes.
Enfin, lorsqu’il existe des relations par paires entre points de données, un graphe est une manière efficace de les stocker et de les représenter. De nombreux algorithmes de graphes permettent de répondre à des questions fréquentes sur ces jeux de données relationnels.
Les structures de données constituent un vaste domaine, et nous n’en avons vu qu’un aperçu. Dans certains cas, la bonne solution consiste à concevoir une structure sur mesure pour le problème. Néanmoins, maîtriser celles présentées ici vous mettra sur la bonne voie pour résoudre vos problématiques data.
Dans cet article, nous avons vu que les structures de données organisent l’information selon des formats spécifiques pour en faciliter l’accès.
On distingue deux grandes familles : les structures basées sur des tableaux (par exemple les tables de hachage) et celles basées sur des nœuds (par exemple les graphes).
Les structures linéaires, comme les tableaux, files et piles, organisent les éléments de manière séquentielle. À l’inverse, les structures non linéaires, comme les tables de hachage, arbres et graphes, organisent les données selon leurs relations.
Le choix de la bonne structure dépend de la nature des requêtes à exécuter.
Pour découvrir les différentes structures de données en Python, consultez ce tutoriel sur les structures de données en Python.
Apprenez Python avec ces cours !
Cours
Cours
Cours