Kurs
Datenwissenschaft verstehen
2 Std.
872K
Nachdem du auf einer interaktiven Online-Lernplattform wie Datacamp geübt hast, steht als nächster Schritt an, deine in Python, R, Git oder der Unix-Shell erworbenen Kompetenzen auf deinem eigenen Rechner anzuwenden. Es ist nicht immer offensichtlich, was du für unterschiedliche Projekte installieren musst. Dieses Tutorial zeigt dir, welche Pakete und welche Software du für den Einstieg in die jeweiligen Technologien brauchst. Also, legen wir los!
Um Python lokal nutzen zu können, musst du es zuerst installieren. Es gibt viele verschiedene Python-Distributionen, für Data Science ist jedoch die Anaconda Python Distribution am verbreitetsten.
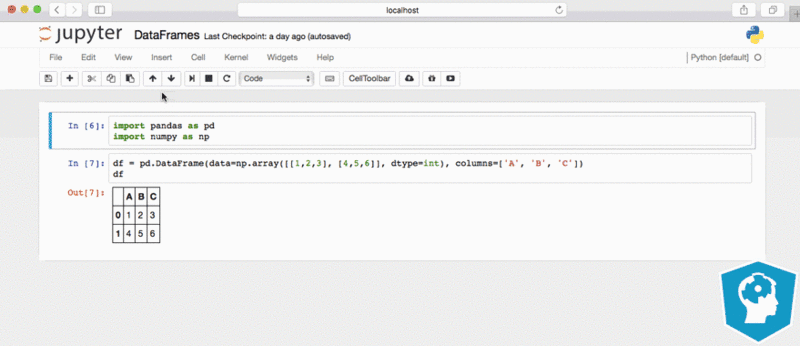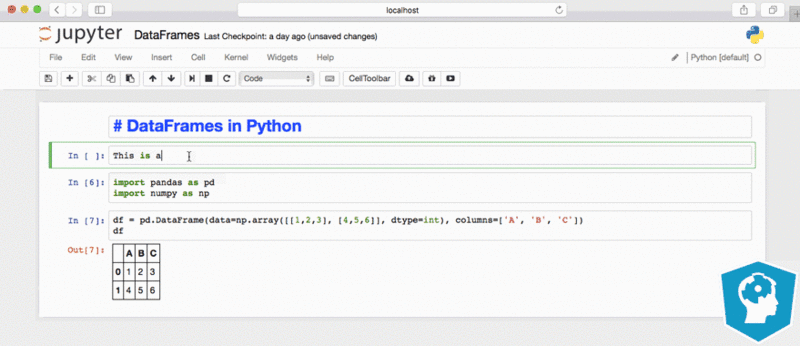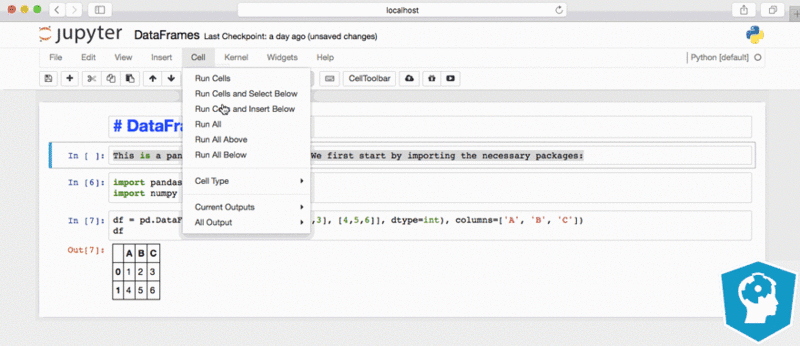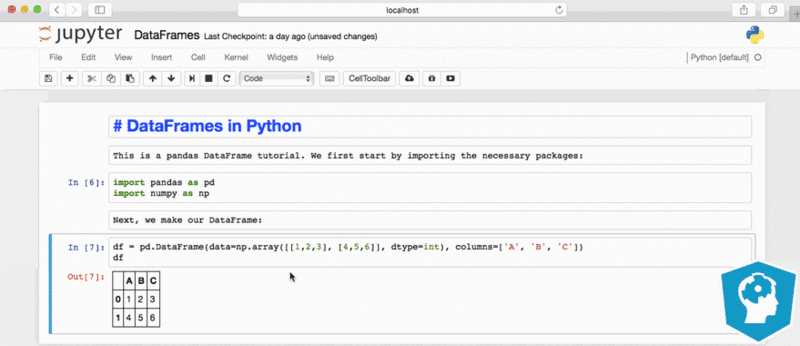
Anaconda ist Paketmanager, Umgebungsmanager und Python-Distribution in einem und bündelt viele Open-Source-Pakete. Eine Anaconda-Installation bringt zahlreiche Pakete wie numpy, scikit-learn, scipy und pandas bereits mit und ist außerdem der empfohlene Weg, um Jupyter Notebooks zu installieren. Das folgende Bild zeigt ein Jupyter Notebook in Aktion. Jupyter Notebooks enthalten sowohl Code als auch formatierten Text, etwa Abbildungen, Links und Gleichungen. Mehr über Jupyter Notebooks erfährst du hier.
Weitere Vorteile von Anaconda sind:
Wenn du nach der Installation zusätzliche Pakete brauchst, kannst du sie mit dem Paketmanager conda oder mit pip nachinstallieren. Das ist besonders praktisch, weil du Abhängigkeiten zwischen mehreren Paketen nicht selbst verwalten musst. Mit conda kannst du sogar bequem zwischen Python 2 und 3 wechseln (hier erfährst du mehr).
Anaconda enthält Spyder, eine integrierte Entwicklungsumgebung (IDE) für Python. Eine IDE ist ein Tool, mit dem du Code schreibst, testest und debugst. Typischerweise bietet sie unter anderem Code-Vervollständigung, Syntax-Hervorhebung, Ressourcenverwaltung und Debugging-Werkzeuge. Du kannst Anaconda auch mit anderen Python-IDEs wie PyCharm und Atom integrieren. Mehr über verschiedene Python-IDEs erfährst du hier.
Hier findest du Anleitungen zur Installation von Anaconda auf deinem Betriebssystem.
Anaconda auf dem Mac installieren
Anaconda unter Windows installieren
Die meisten installieren RStudio zusammen mit der Programmiersprache R. Die integrierte Entwicklungsumgebung (IDE) RStudio gilt allgemein als der einfachste und beste Weg, mit R zu arbeiten.
Die Installation der Programmiersprache R liefert dir Funktionen und Objekte aus R sowie einen R-Interpreter, mit dem du Befehle erstellst und ausführst. RStudio stellt dir eine integrierte Entwicklungsumgebung zur Verfügung, die zusammen mit dem R-Interpreter arbeitet.
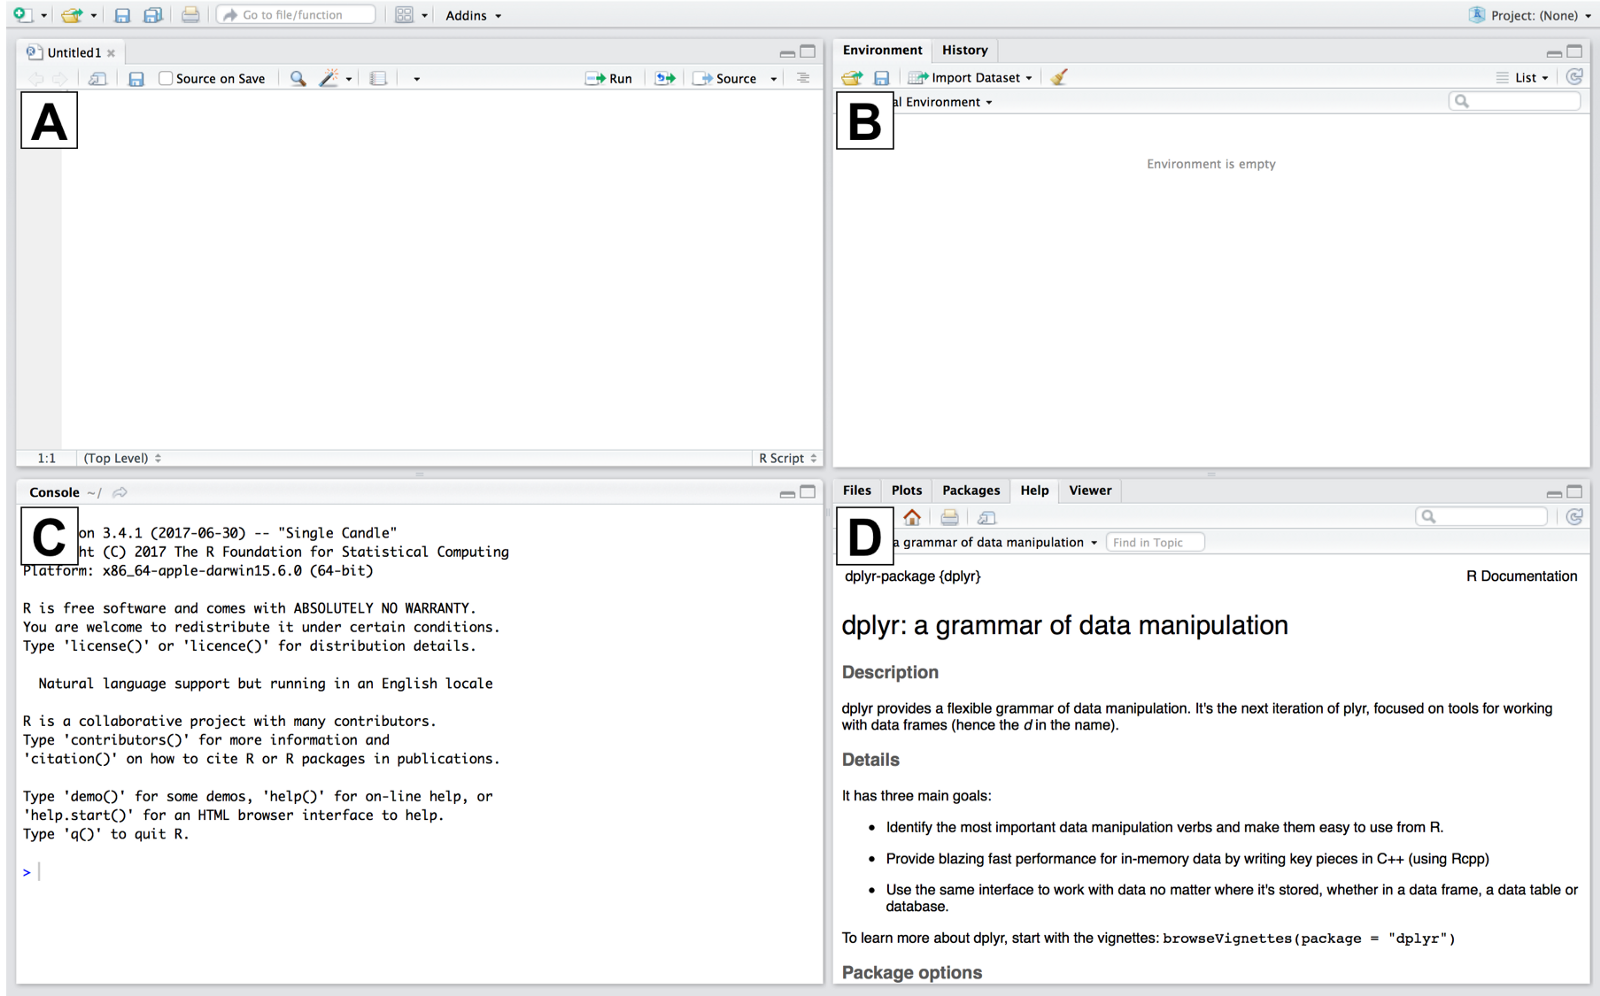
Wenn du RStudio öffnest, erscheint ein Bildschirm wie oben. In den vier RStudio-Fenstern findest du unter anderem: (A) einen Texteditor, (B) ein Dashboard für deine Arbeitsumgebung, (C) den R-Interpreter und (D) ein Hilfe- und Paketverwaltungs-Fenster. Damit hast du nach der R-Installation im Grunde alles, was du brauchst.
Hier findest du Anleitungen zur Installation von R und RStudio auf deinem Betriebssystem.
R und RStudio auf dem Mac installieren
R und RStudio unter Windows installieren
Durch Verzeichnisse navigieren, Dateien kopieren, virtuelle Maschinen nutzen und mehr gehört zum Alltag von Data Scientists. Häufig kommt dafür die Unix-Shell zum Einsatz.
1 - Viele Cloud-Computing-Plattformen basieren auf Linux (und damit auf einer Unix-Shell-Variante). Wenn du zum Beispiel eine Data-Science-Umgebung in der Google Cloud einrichten oder Deep Learning mit Jupyter Notebooks in der Cloud (AWS EC2) machen willst, brauchst du Shell-Kenntnisse. Manchmal ist auch eine Windows-VM sinnvoll, das ist aber seltener.
2 - Die Unix-Shell bietet viele nützliche Befehle, zum Beispiel: wc zum Zählen von Zeilen oder Wörtern in einer Datei, cat zum Zusammenführen von Dateien sowie head und tail zum Auszug großer Dateien. Mehr dazu in 8 Useful Shell Commands for Data Science. Sieh dir auch den DataCamp-Kurs Data Processing in Shell an.
3 - Du findest die Unix-Shell oft in andere Technologien integriert, wie du im weiteren Verlauf des Artikels siehst.
Unix-Shell-Befehle sind häufig in andere Tools eingebettet. In Jupyter Notebooks findest du zum Beispiel oft Shell-Befehle neben Python-Code. In Jupyter Notebook rufst du Shell-Befehle auf, indem du mit einem ! in die Shell wechselst. Im folgenden Code wird das Ergebnis des Shell-Befehls ls (listet alle Dateien im aktuellen Verzeichnis auf) der Python-Variable myfiles zugewiesen.
myfiles = !ls
Das Bild unten zeigt Python-Code in einem Workflow zum Zusammenführen mehrerer Datensätze. Beachte den Unix-Shell-Befehl (rot markiert) in einem Jupyter Notebook. 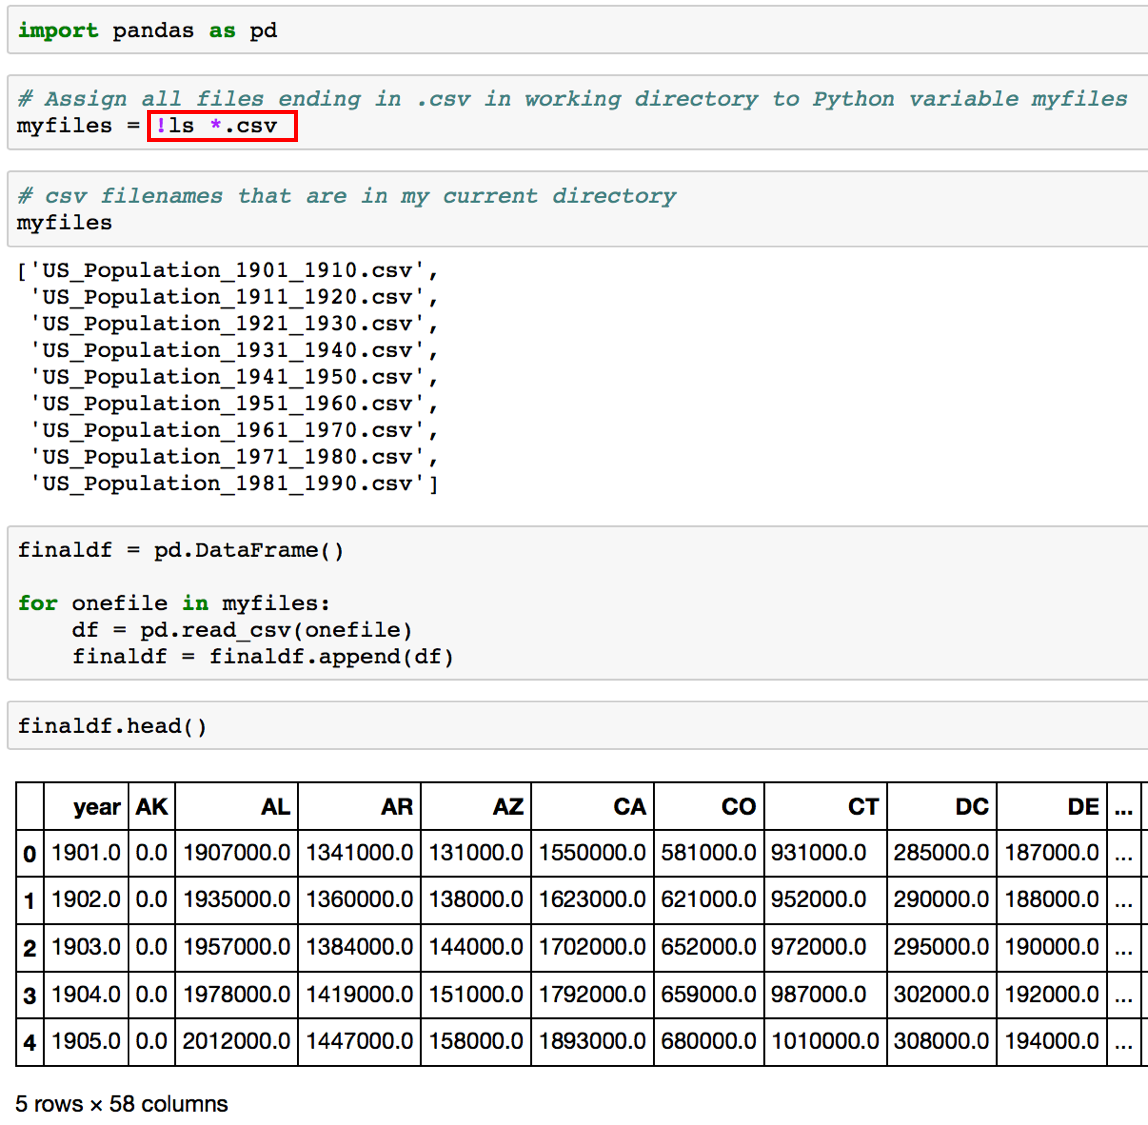
Behalte im Hinterkopf: Der Code im Bild ist keine besondere Methode, sondern nur ein kleines Beispiel dafür, wie die Unix-Shell eingebunden sein kann. Wenn du lernen möchtest, wie du Unix für Data Science nutzt, hat Datacamp einen kostenlosen Kurs Introduction to Shell for Data Science, den ich sehr empfehle. Viele angehende Data Scientists übersehen diese Kompetenz, dabei ist sie im Arbeitsalltag sehr wichtig.
Der Mac wird mit einer Unix-Shell ausgeliefert, du musst also in der Regel nichts installieren! Wichtig: Es gibt verschiedene Unix-Systeme mit teils unterschiedlichen Befehlen. Manchmal fehlt dir ein Befehl (wie wget), der auf einem anderen System vorhanden ist. Ähnlich wie es in RStudio und Anaconda Paketmanager gibt, kannst du auf dem Mac Homebrew als Paketmanager nutzen, wenn du es installierst. Der folgende Link erklärt Installation und Nutzung von Homebrew.
How to Install and Use Homebrew
Windows bringt keine Unix-Shell mit. Wichtig ist: Die Unix-Shell liefert dir praktische Befehle für Data Science. Es gibt viele Wege, diese Befehle unter Windows zu bekommen. Du kannst Git unter Windows installieren und die optionalen Unix-Tools mitnehmen, sodass du die Shell-Befehle in der Eingabeaufforderung nutzen kannst. Alternativ kannst du Gnu on Windows (GOW) (10 MB), Cygwin (mind. 100 MB) und andere Optionen installieren.
Git ist das am weitesten verbreitete Versionsverwaltungssystem. Es zeichnet Änderungen an Dateien im Zeitverlauf auf, damit du jederzeit frühere Versionen wiederherstellen kannst. Git ist wichtig, weil es die Zusammenarbeit deutlich erleichtert und in vielen Unternehmen Standard ist. Einige Vorteile von Git sind:
Versionierte Inhalte gehen mit Git nicht verloren, du kannst also jederzeit auf ältere Stände deines Codes zurückgreifen.
Git warnt dich bei Konflikten mit der Arbeit anderer, sodass du nicht so leicht versehentlich etwas überschreibst.
Git kann Arbeit von verschiedenen Personen auf unterschiedlichen Rechnern synchronisieren und wächst mit deinem Team.
Mit Git fällt es leichter, zu Open-Source-Paketen in R und Python beizutragen.
Git ist oft in andere Tools integriert. Wie erwähnt, gilt RStudio als einer der besten Wege, mit R zu arbeiten. RStudio bietet Unterstützung für Versionskontrolle und viele Python-IDEs (mehr dazu hier) unterstützen sie ebenfalls.
Wenn du lernen möchtest, wie du Git für Data Science nutzt, hat DataCamp den kostenlosen Kurs Introduction to Git for Data Science, den ich sehr empfehle.
Hier findest du Anleitungen zur Installation von Git auf deinem Betriebssystem.
Git unter Windows installieren
Dieses Tutorial zeigt dir, wie du eine lokale Data-Science-Umgebung auf deinem Rechner einrichtest. Wichtig ist dabei: Diese Technologien lassen sich oft sinnvoll miteinander kombinieren. Wenn du Fragen oder Anmerkungen zum Tutorial hast, schreib gern einen Kommentar unten oder melde dich über Twitter. Schau dir auch meine weiteren Installationsanleitungen auf Github oder in meinem Medium-Blog an.
Mehr über Data Science erfahren
Kurs
Kurs