
Lernpfad
Ingenieur für maschinelles Lernen
44 Std.
Als Data Scientists kümmern wir uns in der Regel nicht um Deployment und Wartung—wir bauen statistische Modelle, und Engineers erledigen den Rest.
Doch das ändert sich gerade!
Weil Data Scientists immer gefragter sind, die die Lücke zwischen Modellbau und Produktion schließen, verschafft dir der Umgang mit Automatisierung und CI/CD (Continuous Integration/Continuous Deployment) einen echten Vorsprung.
In diesem Tutorial schauen wir uns zwei beliebte Automatisierungstools an: Make (lokale Automatisierung) und GitHub Actions (Cloud-Automatisierung). Unser Fokus liegt darauf, diese Tools in Datenprojekten einzusetzen.
GitHub Action und Make. Bild von Abid Ali Awan.
Wenn du Automatisierung im Kontext von Data Science vertiefen möchtest, wirf einen Blick auf diesen Kurs zu Fully Automated MLOps.
Ein Makefile ist der Bauplan für das Erstellen und Verwalten von Softwareprojekten. Es enthält Anweisungen, um Aufgaben zu automatisieren, komplexe Build-Prozesse zu vereinfachen und Konsistenz sicherzustellen.
Um die Befehle im Makefile auszuführen, nutzen wir das Kommandozeilentool make. Dieses Tool lässt sich wie ein Python-Programm starten, indem du Argumente übergibst oder es einfach solo ausführst.
Ein Makefile besteht in der Regel aus Zielen, Abhängigkeiten, Aktionen und Variablen:
python test.py sein.python test.py $variable_1 $variable_2.Kurz gesagt, so könnte eine Makefile-Vorlage aussehen:
Variable = some_value

Target: Dependencies
    Actions (commands to build the target) $Variable
Mit unseren Beispielen von oben könnte das Makefile so aussehen:
# Define variables
variable_1 = 5
variable_2 = 10

# Target to run a test with variables
test: test_data.txt # Dependency on test data file
python test.py $variable_1 $variable_2Wir können das Make-CLI-Tool auf allen Betriebssystemen installieren.
Unter Linux verwenden wir im Terminal folgenden Befehl:
$ sudo apt install makeUnter macOS können wir make mit Homebrew installieren:
$ brew install makeUnter Windows ist es etwas anders. Das Make-Tool lässt sich auf mehrere Arten nutzen. Die beliebtesten Optionen sind WSL (Ubuntu Linux), w64devkit und GnuWin32.
Lade GnuWin32 von der SourceForge-Seite herunter und installiere es.
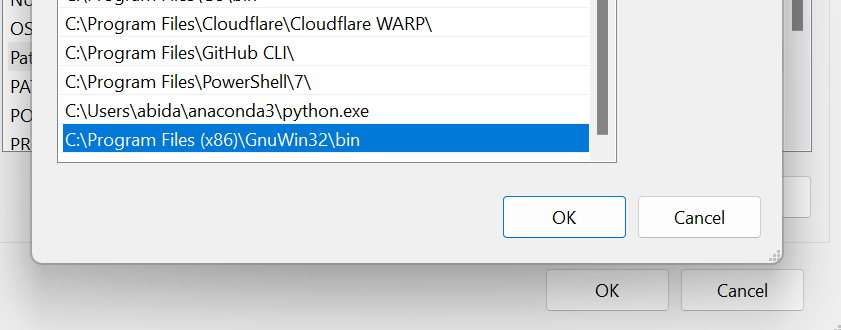
Damit es als Kommandozeilentool im Terminal funktioniert, müssen wir den Ordnerpfad zur Windows-Umgebungsvariable hinzufügen. So gehst du vor:
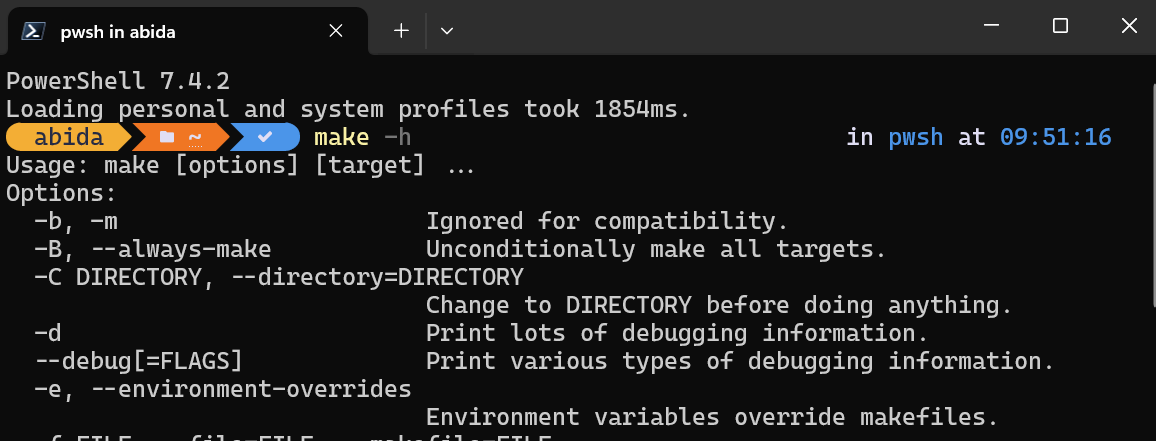
Um zu testen, ob Make erfolgreich installiert wurde, tippe make -h in die PowerShell.
In diesem Abschnitt lernen wir, wie wir Makefile und das Make-CLI-Tool in einem Data-Science-Projekt nutzen.
Wir verwenden den Datensatz World Happiness Report 2023, um Datenverarbeitung, Analyse sowie das Speichern von Zusammenfassungen und Visualisierungen abzudecken.
Wir wechseln ins Projektverzeichnis und erstellen einen Ordner namens Makefile-Action. Dann legen wir darin die Datei data_processing.py an und öffnen sie in VSCode.
$ cd GitHub
$ mkdir Makefile-Action
$ cd .\Makefile-Action\
$ code data_processing.pyWir starten mit der Verarbeitung der Daten in Python. Im folgenden Codeblock führen wir diese Schritte aus (Hinweis: Beispielcode—in der Praxis wären meist weitere Schritte nötig):
Datei: data_processing.py
import sys
import pandas as pd

# Check if the data location argument is provided
if len(sys.argv) != 2:
    print("Usage: python data_processing.py <data_location>")
    sys.exit(1)

# Load the raw dataset (step 1)
df = pd.read_csv(sys.argv[1])

# Rename columns to more descriptive names (step 2)
df.columns = [
    "Country",
    "Happiness Score",
    "Happiness Score Error",
    "Upper Whisker",
    "Lower Whisker",
    "GDP per Capita",
    "Social Support",
    "Healthy Life Expectancy",
    "Freedom to Make Life Choices",
    "Generosity",
    "Perceptions of Corruption",
    "Dystopia Happiness Score",
    "GDP per Capita",
    "Social Support",
    "Healthy Life Expectancy",
    "Freedom to Make Life Choices",
    "Generosity",
    "Perceptions of Corruption",
    "Dystopia Residual",
]

# Handle missing values by replacing them with the mean (step 3)
df.fillna(df.mean(numeric_only=True), inplace=True)

# Check for missing values after cleaning
print("Missing values after cleaning:")
print(df.isnull().sum())

print(df.head())

# Save the cleaned and normalized dataset to a new CSV file (step 4)
df.to_csv("processed_data\WHR2023_cleaned.csv", index=False)Als Nächstes analysieren wir die Daten und speichern den gesamten Code in einer Datei namens data_analysis.py. Diese Datei können wir mit folgendem Terminalbefehl anlegen:
$ code data_analysis.pyWir können auch den echo-Befehl verwenden, um die Python-Datei zu erstellen und sie in einem anderen Editor zu öffnen.
$ echo "" > data_analysis.pyIm folgenden Codeblock:
Datei: data_analysis.py
import io
import sys

import matplotlib.pyplot as plt
import pandas as pd
import seaborn as sns

# Check if the data location argument is provided
if len(sys.argv) != 2:
    print("Usage: python data_analysis.py <data_location>")
    sys.exit(1)

# Load the clean dataset (step 1)
df = pd.read_csv(sys.argv[1])

# Data summary (step 2)
print("Data Summary:")
summary = df.describe()
data_head = df.head()
print(summary)
print(data_head)

# Collecting data information
buffer = io.StringIO()
df.info(buf=buffer)
info = buffer.getvalue()

## Write metrics to file
with open("processed_data/summary.txt", "w") as outfile:
    f"\n## Data Summary\n\n{summary}\n\n## Data Info\n\n{info}\n\n## Dataframe\n\n{data_head}"

print("Data summary saved in processed_data folder!")

# Distribution of Happiness Score (step 3)
plt.figure(figsize=(10, 6))
sns.displot(df["Happiness Score"])
plt.title("Distribution of Happiness Score")
plt.xlabel("Happiness Score")
plt.ylabel("Frequency")
plt.savefig("figures/happiness_score_distribution.png")

# Top 20 countries by Happiness Score
top_20_countries = df.nlargest(20, "Happiness Score")
plt.figure(figsize=(10, 6))
sns.barplot(x="Country", y="Happiness Score", data=top_20_countries)
plt.title("Top 20 Countries by Happiness Score")
plt.xlabel("Country")
plt.ylabel("Happiness Score")
plt.xticks(rotation=90)
plt.savefig("figures/top_20_countries_by_happiness_score.png")

# Scatter plot of Happiness Score vs GDP per Capita
plt.figure(figsize=(10, 6))
sns.scatterplot(x="GDP per Capita", y="Happiness Score", data=df)
plt.title("Happiness Score vs GDP per Capita")
plt.xlabel("GDP per Capita")
plt.ylabel("Happiness Score")
plt.savefig("figures/happiness_score_vs_gdp_per_capita.png")

# Visualize the relationship between Happiness Score and Social Support
plt.figure(figsize=(10, 6))
plt.scatter(x="Social Support", y="Happiness Score", data=df)
plt.xlabel("Social Support")
plt.ylabel("Happiness Score")
plt.title("Relationship between Social Support and Happiness Score")
plt.savefig("figures/social_support_happiness_relationship.png")

# Heatmap of correlations between variables
corr_matrix = df.drop("Country", axis=1).corr()
plt.figure(figsize=(12, 10))
sns.heatmap(corr_matrix, annot=True, cmap="coolwarm", square=True)
plt.title("Correlation Heatmap")
plt.savefig("figures/correlation_heatmap.png")
print("Visualizations saved to figures folder!")Bevor wir ein Makefile anlegen, brauchen wir eine requirements.txt, um alle benötigten Python-Pakete auf einer neuen Maschine zu installieren. So sieht die requirements.txt aus:
pandas
numpy
seaborn
matplotlib
black
Unser Makefile besteht aus Variablen, Abhängigkeiten, Zielen und Aktionen—wir lernen alle Bausteine kennen. Wir erstellen eine Datei namens Makefile und fügen Aktionen für folgende Ziele hinzu:
data_processing.py mit einem Raw-Data-Pfad als Variable und Abhängigkeit aus.data_analysis.py mit einem Pfad zu den verarbeiteten Daten als Variable und Abhängigkeit aus.Datei: Makefile
RAW_DATA_PATH = "raw_data/WHR2023.csv"
PROCESSED_DATA = "processed_data/WHR2023_cleaned.csv"

install:
    pip install --upgrade pip &&\
        pip install -r requirements.txt

format:
        black *.py --line-length 88

process: ./raw_data/WHR2023.csv
        python data_processing.py $(RAW_DATA_PATH)

analyze: ./processed_data/WHR2023_cleaned.csv
        python data_analysis.py $(PROCESSED_DATA)

clean:
        rm -f processed_data/* **/*.png

all: install format process analyze
Zum Ausführen eines Ziels nutzen wir das Tool make und geben den Zielnamen im Terminal an.
$ make formatDas Black-Skript wurde erfolgreich ausgeführt.
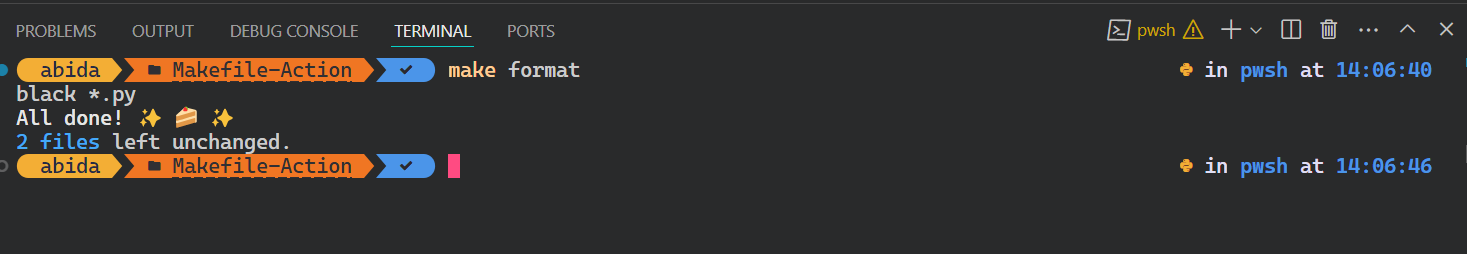
Versuchen wir, das Python-Skript zur Datenverarbeitung auszuführen.
Wichtig: Vor dem Ausführen des Ziels process prüft Make die Abhängigkeiten. In unserem Fall kontrolliert es, ob die Rohdatendatei existiert. Falls nicht, startet der Befehl nicht.
$ make processWie du siehst, ist das ganz unkompliziert.
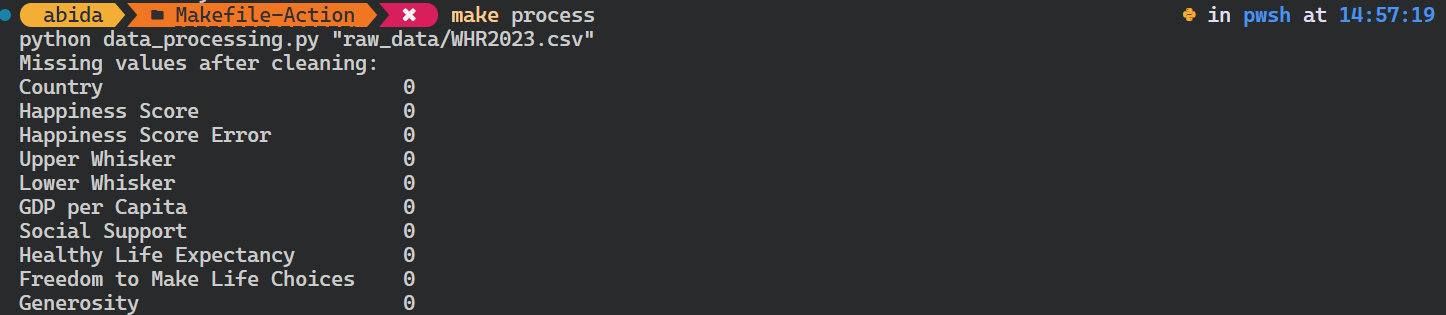
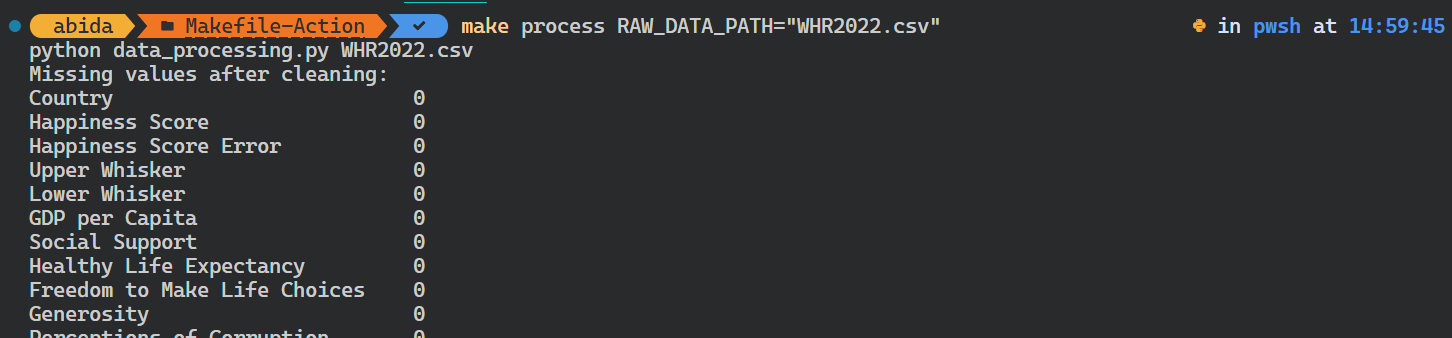
Du kannst sogar bestehende Variablen überschreiben, indem du ein zusätzliches Argument an den make-Befehl übergibst.
In unserem Fall haben wir den Pfad der Rohdaten geändert.
$ make process RAW_DATA_PATH="WHR2022.csv"Das Python-Skript wurde mit dem geänderten Eingabeargument ausgeführt.
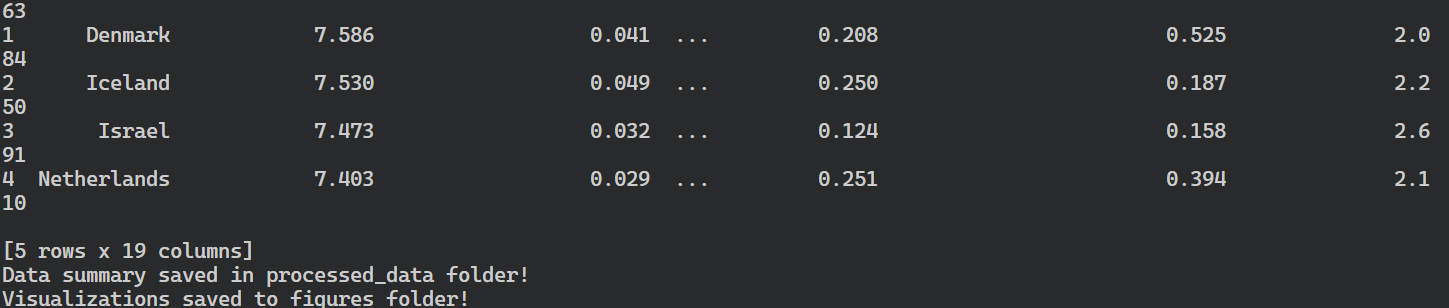
Um den gesamten Workflow zu automatisieren, nutzen wir das Ziel all. Damit werden die Ziele install, format, process und analyze nacheinander ausgeführt.
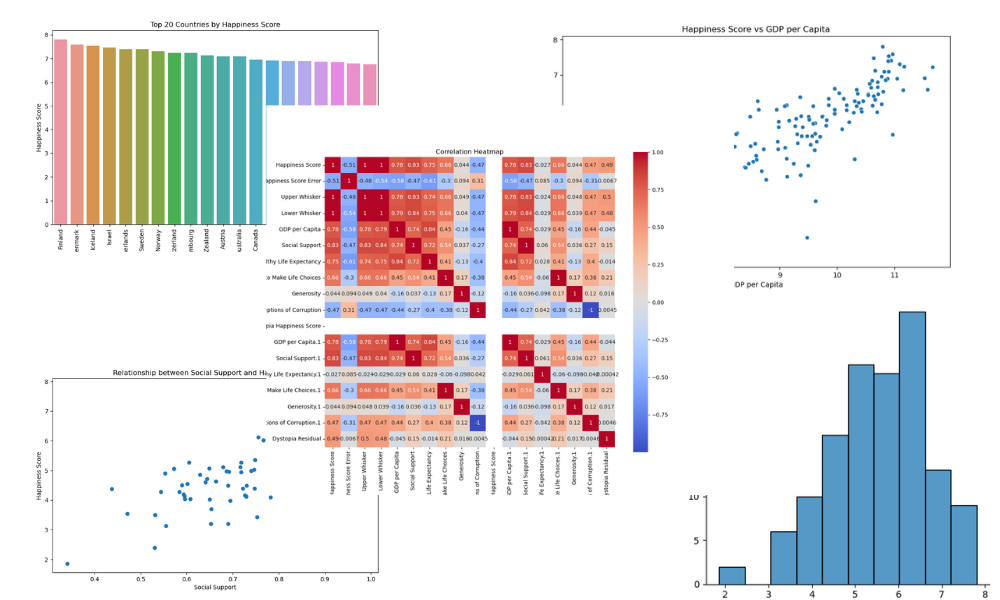
$ make allDer make-Befehl hat die Python-Pakete installiert, den Code formatiert, die Daten verarbeitet sowie Summary und Visualisierungen gespeichert.
So sollte dein Projektverzeichnis nach dem Ausführen von make all aussehen:
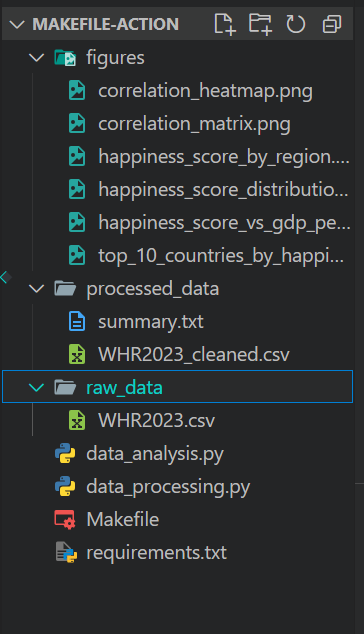
Während Make in unserer Entwicklungsumgebung bei der lokalen Automatisierung punktet, bietet GitHub Actions eine cloudbasierte Alternative.
GitHub Actions wird typischerweise für CI/CD genutzt. Damit können Entwickler Anwendungen direkt aus GitHub heraus kompilieren, bauen, testen und in Produktion deployen.
Zum Beispiel können wir einen eigenen Workflow erstellen, der durch bestimmte Events wie Push oder Pull Request ausgelöst wird. Dieser Workflow kann Shell- und Python-Skripte ausführen oder wir nutzen vorgefertigte Actions. Der Custom-Workflow ist eine YML-Datei und in der Regel leicht zu verstehen und anzupassen.
Schauen wir uns die Kernelemente von GitHub Actions an:
In diesem Abschnitt lernen wir GitHub Actions kennen und versuchen, die zuvor im Makefile genutzten Befehle nachzubilden.
Um unseren Code nach GitHub zu bringen, machen wir unseren Projektordner zunächst zu einem Git-Repository:
$ git initDann erstellen wir ein neues Repository auf GitHub und kopieren die URL.
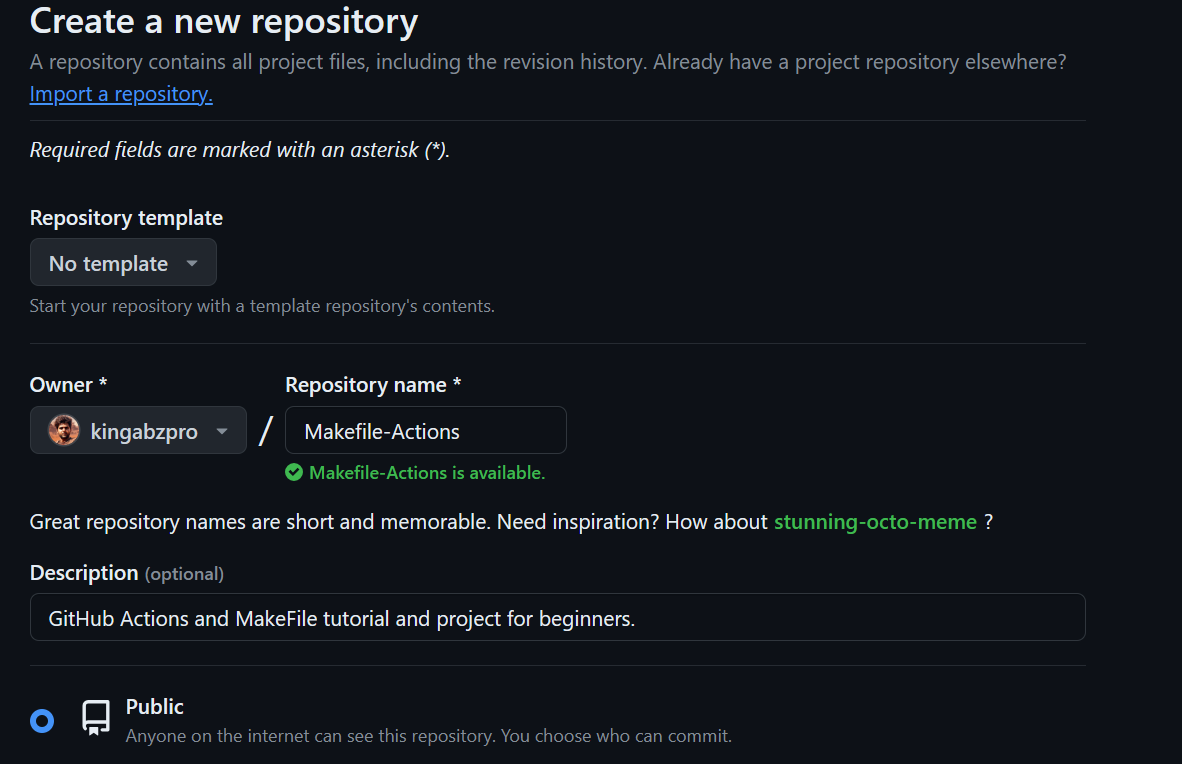
Im Terminal geben wir folgende Befehle ein, um:
master in den Remote-Branch main zu pushen.$ git remote add github https://github.com/kingabzpro/Makefile-Actions.git
$ git pull github main
$ git add .
$ git commit -m "adding all the files"
$ git push github master:mainFalls du eine kurze Auffrischung zu GitHub oder Git brauchst, schau dir dieses einsteigerfreundliche Tutorial zu GitHub and Git an. Damit kannst du dein Data-Science-Projekt versionieren und im Team über die Git-CLI teilen.
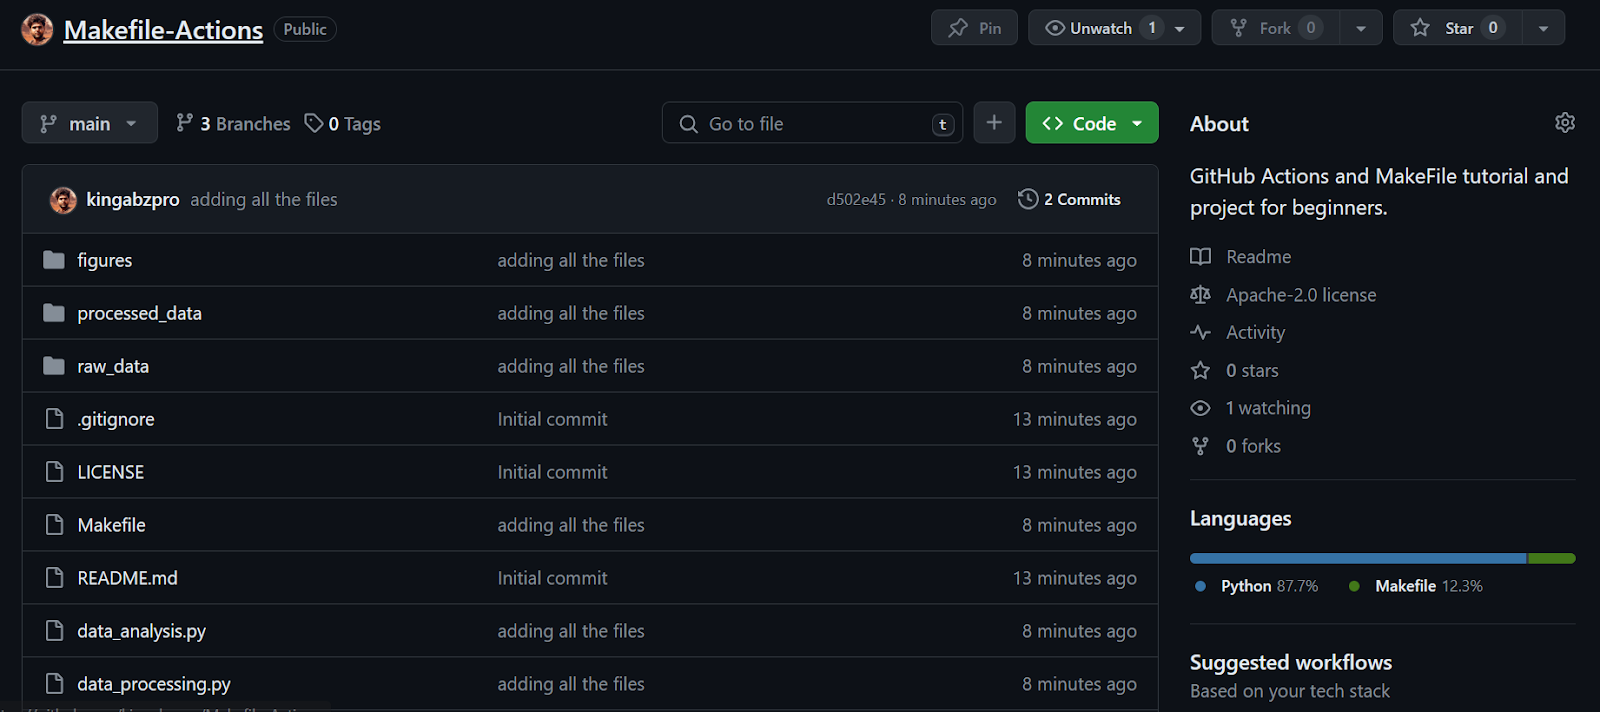
Weiter im Text—wir sehen, dass alle Dateien erfolgreich ins Remote-Repository übertragen wurden.
Als Nächstes erstellen wir einen GitHub-Actions-Workflow. Dazu gehen wir im Repository kingabzpro/Makefile-Actions auf den Tab Actions und klicken auf den blauen Link „set up a workflow yourself“.
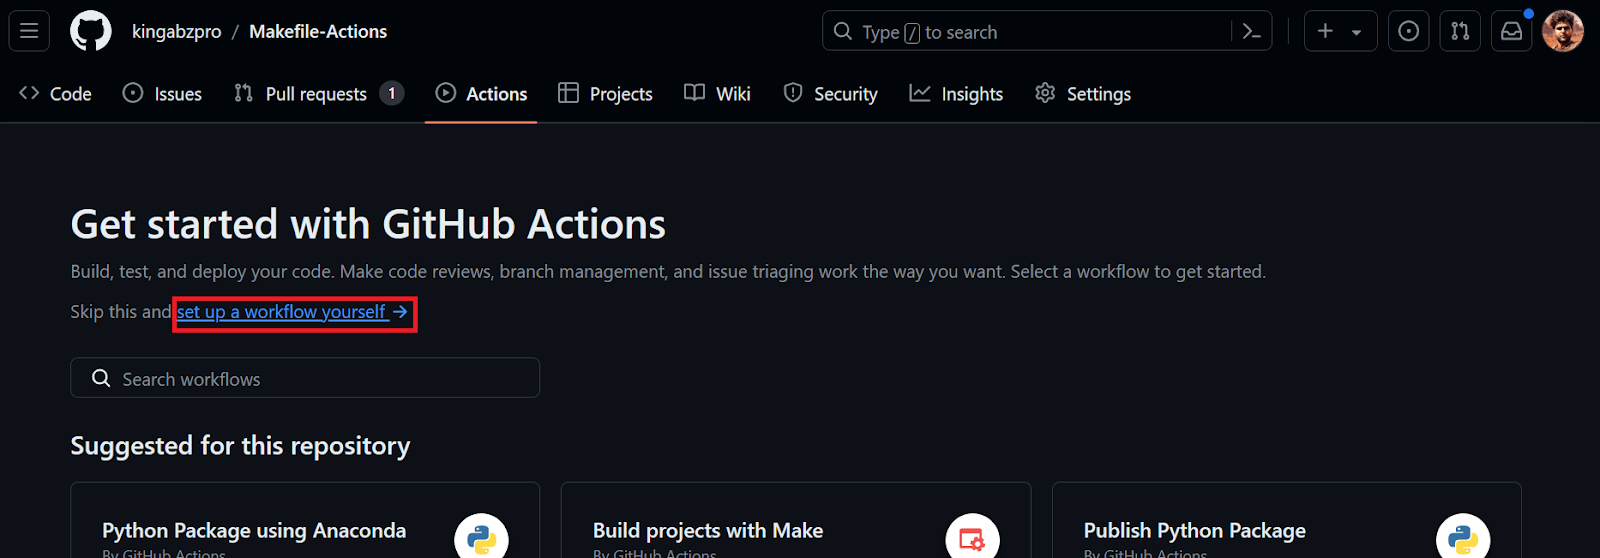
Wir werden zur YML-Datei weitergeleitet und schreiben dort den Code, um die Umgebung aufzusetzen und Befehle auszuführen. Wir werden:
main-Branch oder bei Pull Requests gegen main läuft.name: Data Processing and Analysis
on:
push:
branches: [ "main" ]
pull_request:
branches: [ "main" ]
jobs:
build:
runs-on: ubuntu-latest
steps:
- uses: actions/checkout@v3
- name: Install Packages
run: |
pip install --upgrade pip
pip install -r requirements.txt
- name: Format
run: black *.py --line-length 88
- name: Data Processing
env:
RAW_DATA_DIR: "./raw_data/WHR2023.csv"
run: python data_processing.py $RAW_DATA_DIR
- name: Data Analysis
env:
CLEAN_DATA_DIR: "./processed_data/WHR2023_cleaned.csv"
run: python data_analysis.py $CLEAN_DATA_DIRNach dem Committen der Workflow-Datei mit einer Nachricht startet der Workflow automatisch.
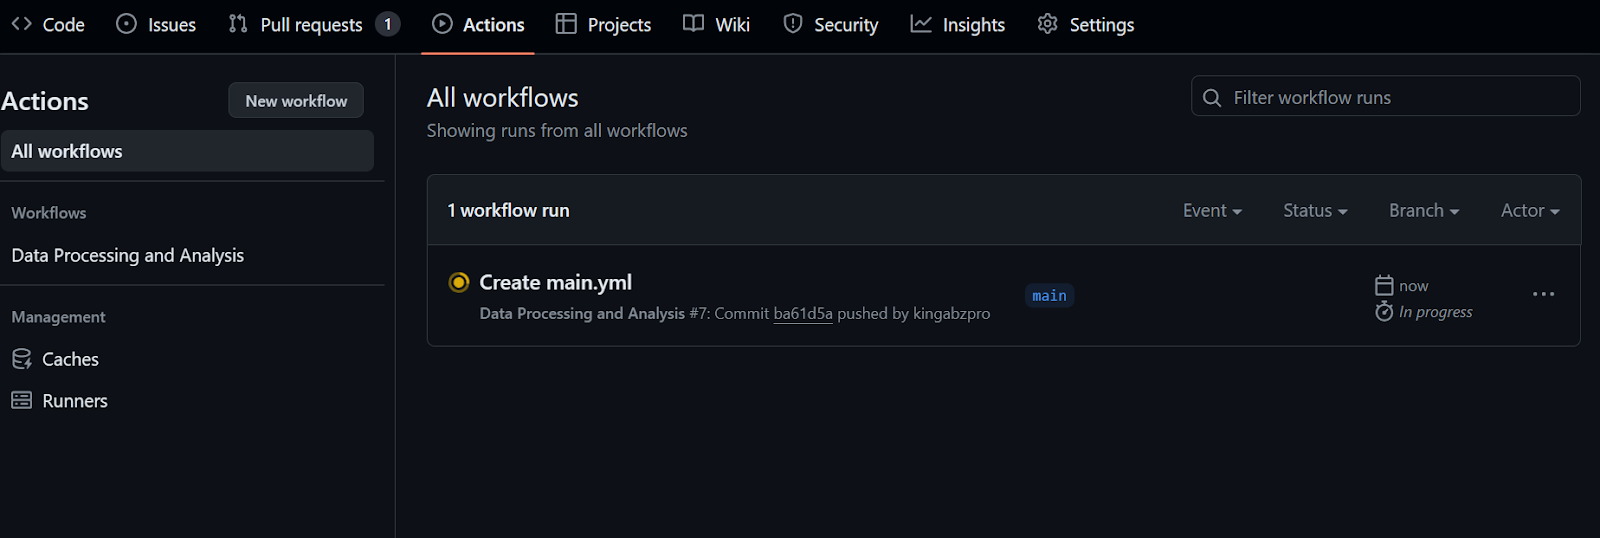
Alle Schritte sind in mindestens 20 Sekunden erledigt.
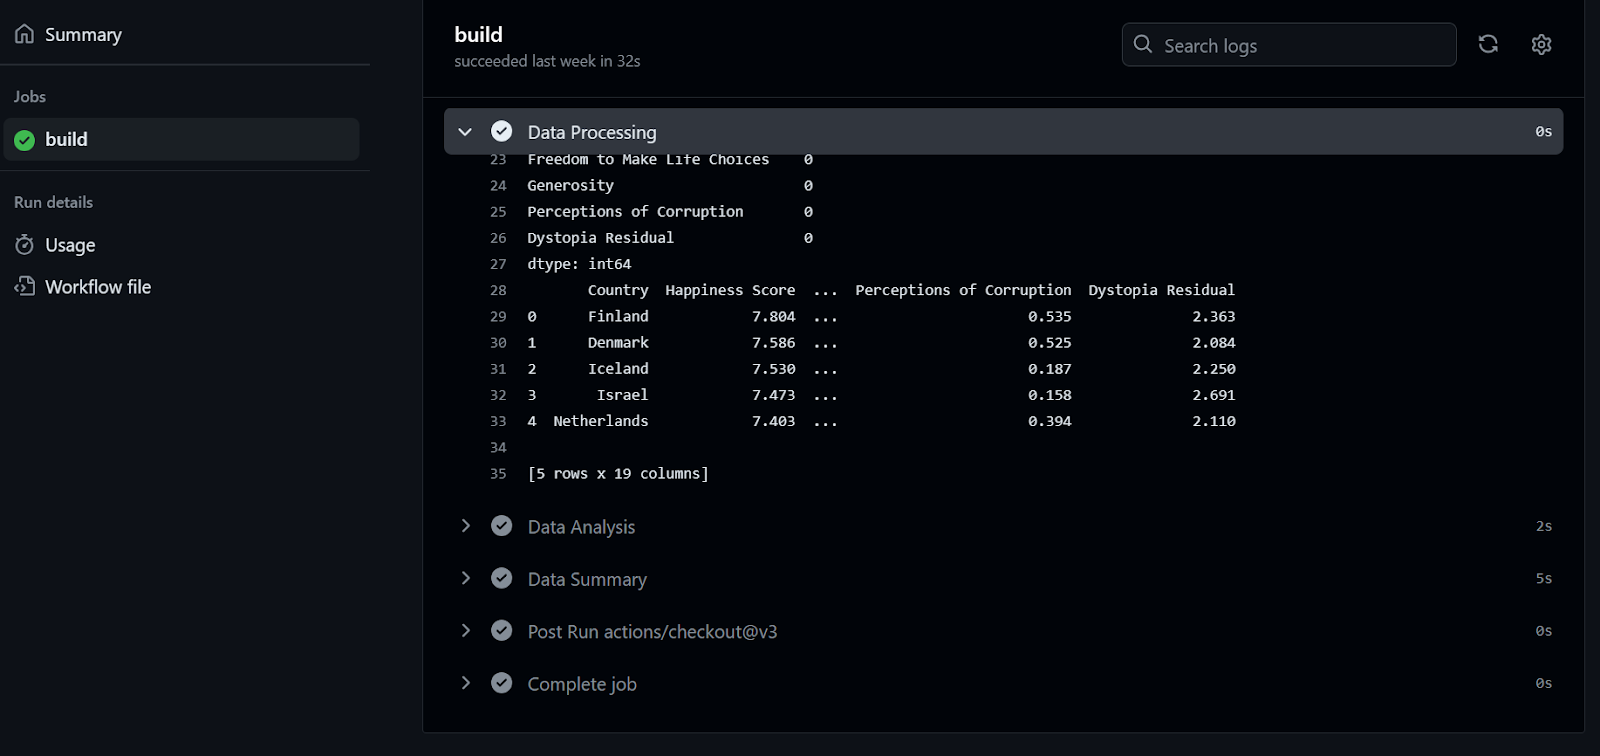
Um die Logs zu prüfen, klicken wir zuerst auf den Workflow-Run, dann auf den Button Build und anschließend auf jeden Job, um die Logs einzusehen.
Wenn dir das Spaß gemacht hat, gefällt dir sicher auch dieser Beginner's Guide to CI/CD for Machine Learning, der die Grundlagen eines automatisierten Machine-Learning-Workflows abdeckt.
Um GitHub-Actions-Workflows zu vereinfachen und zu standardisieren, nutzen Entwickler Make-Befehle innerhalb der Workflow-Datei. In diesem Abschnitt vereinfachen wir unseren Workflow-Code mit dem Make-Befehl und verwenden die Continuous Machine Learning (CML) Action.
Bevor wir starten, pullen wir die Workflow-Datei aus dem Remote-Repository.
$ git pullContinuous Machine Learning (CML) ist eine Open-Source-Bibliothek von iterative.ai, mit der wir Continuous Integration in unserem Data-Science-Projekt umsetzen.
In diesem Projekt verwenden wir die GitHub Action iterative/setup-cml, die CML-Funktionen im Workflow nutzt, um anhand von Grafiken und Statistiken einen Analysebericht zu erzeugen.
Der Bericht wird erstellt und an unseren GitHub-Commit angehängt, damit das Team ihn vor dem Mergen prüfen und freigeben kann.
Wir passen das Makefile an und fügen ein weiteres Ziel „summary“ hinzu. Beachte dabei:
cml, um einen Datenanalysebericht zu erstellen und ihn als Kommentar unter dem Commit anzuzeigen.Stell dir vor, all diese Zeilen stünden direkt in der Workflow-Datei—das wäre schwer lesbar und unhandlich. Stattdessen nutzen wir make summary.
Datei: Makefile
summary: ./processed_data/summary.txt
echo "# Data Summary" > report.md
cat ./processed_data/summary.txt >> report.md
echo '\n# Data Analysis' >> report.md
echo '\n## Correlation Heatmap' >> report.md
echo '' >> report.md
echo '\n## Happiness Score Distribution' >> report.md
echo '' >> report.md
echo '\n## Happiness Score vs GDP per Capita' >> report.md
echo '' >> report.md
echo '\n## Social Support vs Happiness Relationship' >> report.md
echo '' >> report.md
echo '\n## Top 20 Countries by Happiness Score' >> report.md
echo '' >> report.md
cml comment create report.md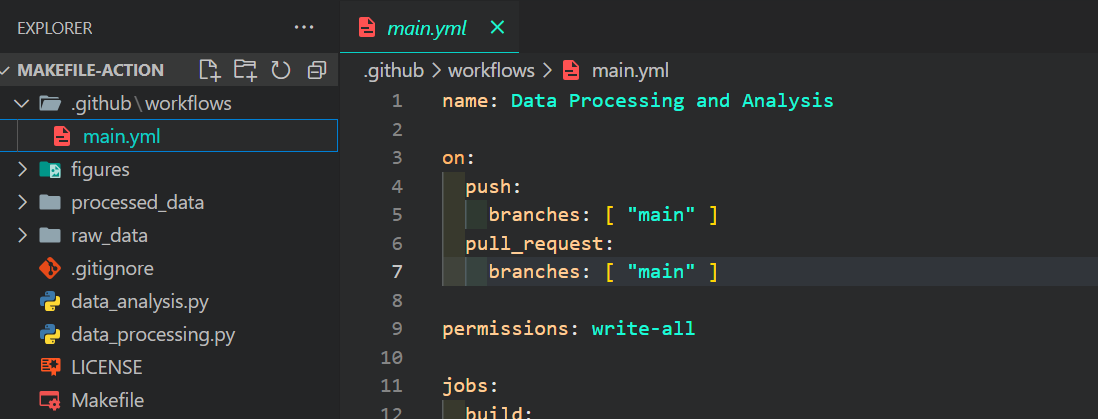
Jetzt bearbeiten wir unsere main.yml, die im Verzeichnis .github/workflows liegt.
Wir ersetzen alle Befehle und Python-Skripte durch den make-Befehl und geben der CML-Action die nötigen Berechtigungen, um den Datenbericht als Commit-Kommentar zu erstellen. Außerdem fügen wir die Action iterative/setup-cml@v3 hinzu.
name: Data Processing and Analysis

on:
  push:
    branches: [ "main" ]
  pull_request:
    branches: [ "main" ]

permissions: write-all

jobs:
  build:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v3
      - uses: iterative/setup-cml@v3
      - name: Install Packages
        run: make install
      - name: Format
        run: make format
      - name: Data Processing
        env:
          RAW_DATA_DIR: "./raw_data/WHR2023.csv"
        run: make process RAW_DATA_PATH=$RAW_DATA_DIR
      - name: Data Analysis
        env:
          CLEAN_DATA_DIR: "./processed_data/WHR2023_cleaned.csv"
        run: make analyze PROCESSED_DATA=$CLEAN_DATA_DIR
      - name: Data Summary
        env:
          REPO_TOKEN: ${{ secrets.GITHUB_TOKEN }}
run: make summaryUm den Workflow zu starten, committen wir alle Änderungen und synchronisieren sie mit dem Remote-Branch main.
$ git commit -am "makefile and github action combo"
$ git push github master:main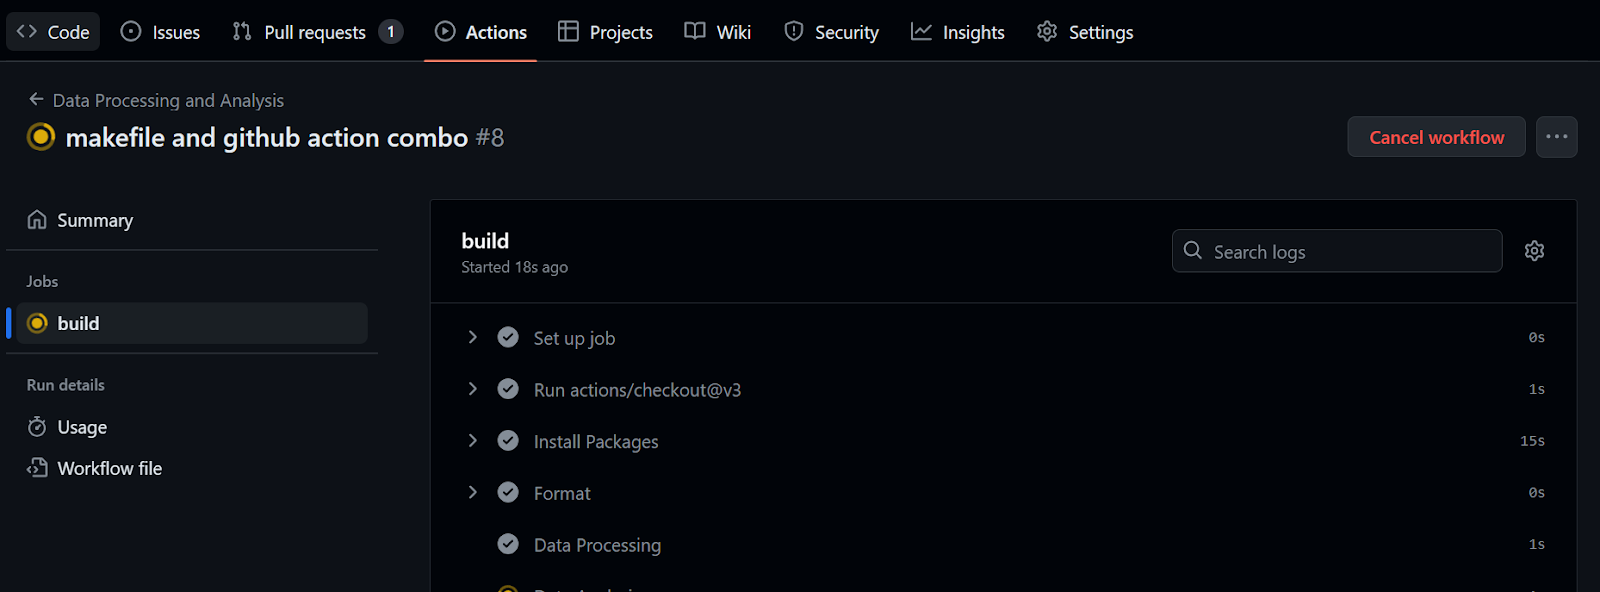
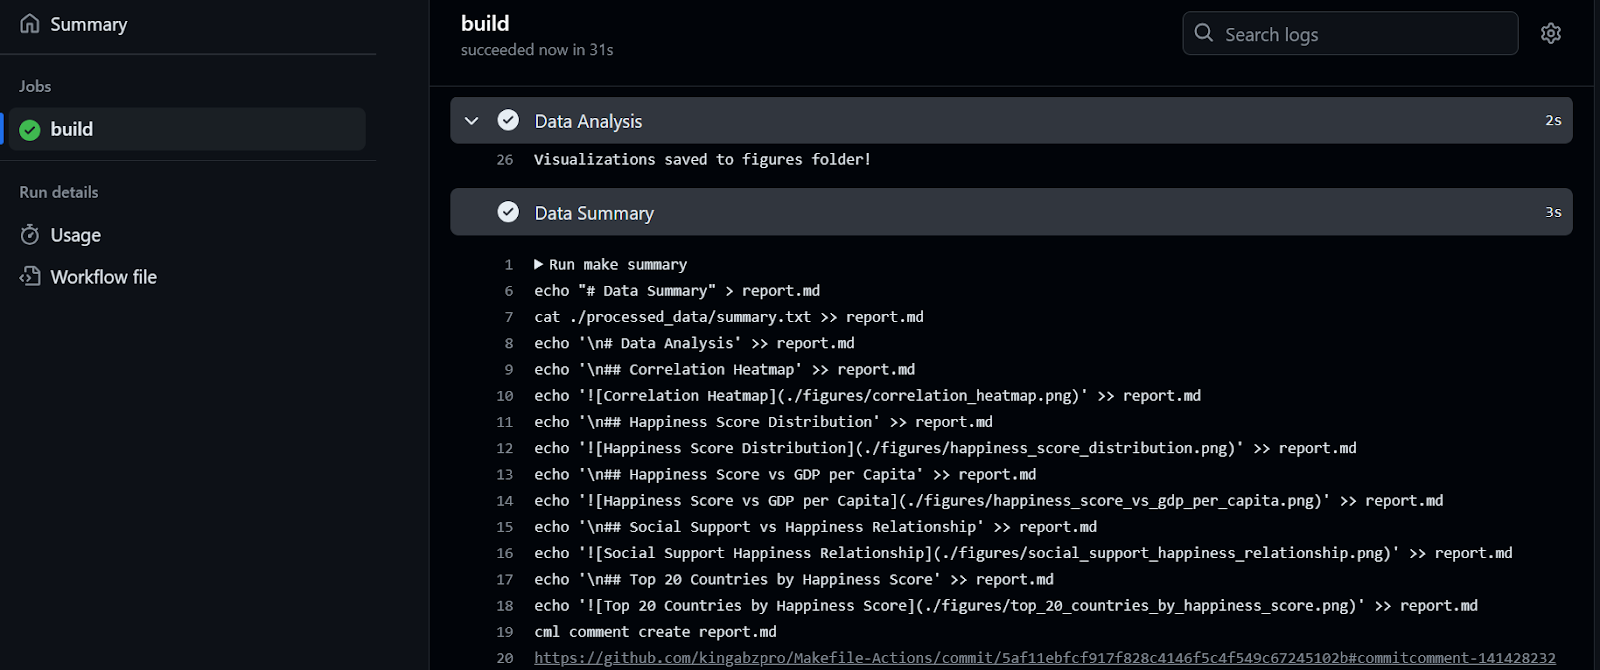
Der Workflow lief in 32 Sekunden durch—unser Bericht ist bereit zur Review. Dazu gehen wir in die Build-Übersicht, scrollen zum Tab Data Summary und klicken dann auf den Kommentarlink (der Link in Zeile 20 in der Abbildung unten):
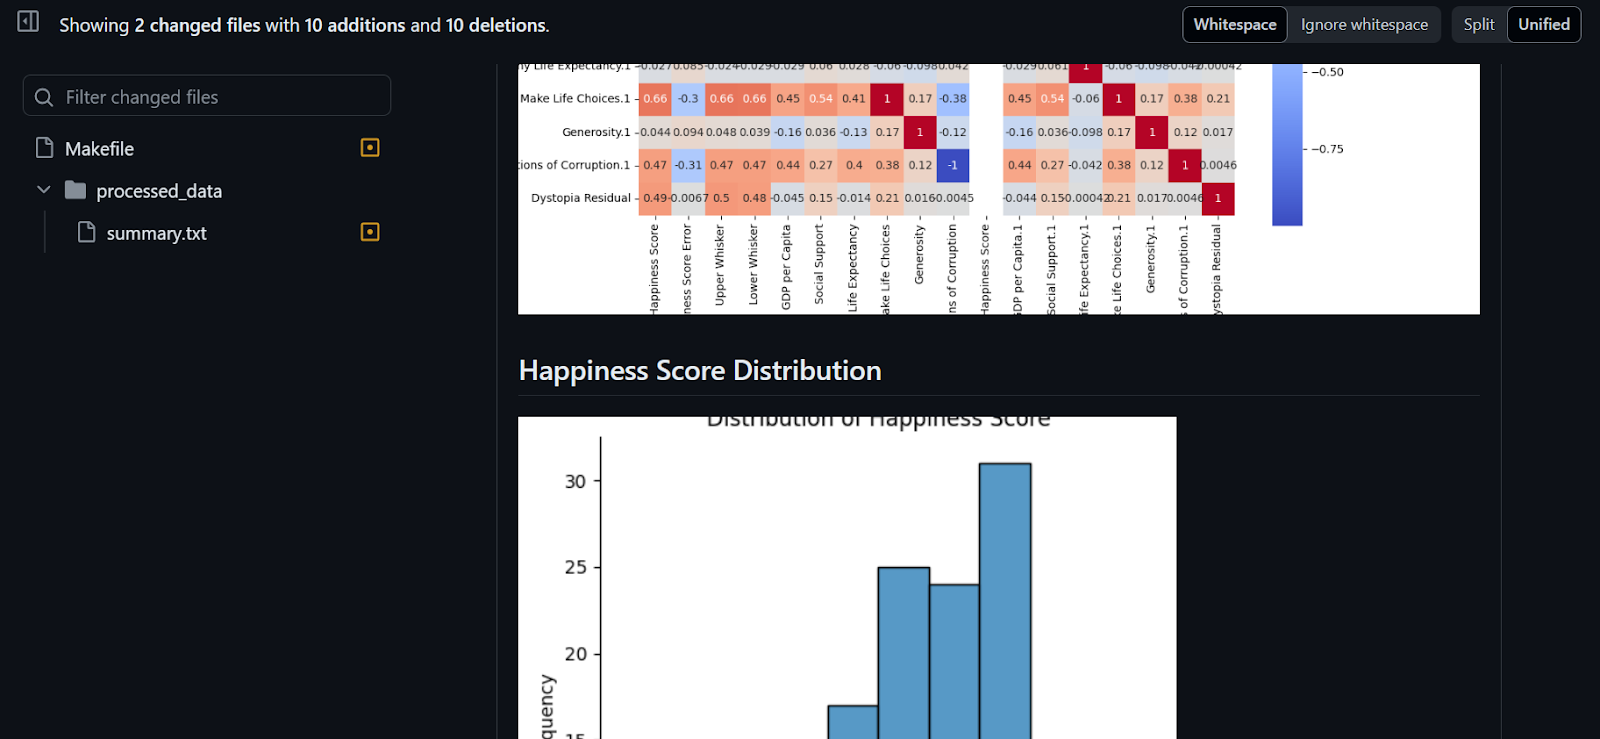
Wie du siehst, sind Datensummary und Visualisierungen an unseren Commit angehängt.
Das Projekt ist unter kingabzpro/Makefile-Actions verfügbar. Du kannst es als Leitfaden nutzen, wenn du mal nicht weiterkommst. Das Repository ist öffentlich—forke es und probiere es selbst aus!
Du möchtest dich in GitHub zertifizieren lassen? Dann lies unsere umfassende Übersicht zu den verschiedenen GitHub certifications!
In diesem Tutorial haben wir uns auf Makefile und GitHub Actions konzentriert, um die Erstellung von Datenanalyse-Reports zu automatisieren.
Außerdem haben wir gelernt, wie man den Workflow aufsetzt und ausführt und das Make-Tool im GitHub-Workflow nutzt, um die Automatisierung zu verschlanken. Anstatt viele Zeilen Code zu schreiben, können wir mit make summary einen Analysebericht erzeugen, der an unseren Commit angehängt wird.
Wenn du CI/CD für Data Science meistern willst, probiere diesen Kurs zu CI/CD for Machine Learning aus. Er behandelt die Grundlagen von CI/CD, GitHub Actions, Datenversionierung sowie die Automatisierung von Hyperparameter-Optimierung und Modellauswertung.
Werde Machine-Learning-Engineer!
Lernpfad
Lernpfad
Kurs