
Cursus
Ingénieur en apprentissage automatique
44 h
En tant que data scientists, nous intervenons rarement sur le déploiement et la maintenance : nous concevons les modèles statistiques, et les ingénieurs prennent le relais.
Mais les choses évoluent !
Avec la demande croissante de profils capables de faire le lien entre la création de modèles et la production, se familiariser avec l’automatisation et les outils de CI/CD (intégration et déploiement continus) devient un véritable atout.
Dans ce tutoriel, nous allons découvrir deux outils d’automatisation populaires : Make (automatisation locale) et GitHub Actions (automatisation dans le cloud). Notre objectif principal sera de les intégrer à nos projets data.
GitHub Actions et Make. Image d’Abid Ali Awan.
Pour aller plus loin sur l’automatisation appliquée à la data science, découvrez ce cours sur les MLOps entièrement automatisés.
Un Makefile est un plan d’exécution pour construire et gérer des projets logiciels. C’est un fichier qui contient des instructions pour automatiser des tâches, simplifier des processus de build complexes et garantir la cohérence.
Pour exécuter les commandes du Makefile, on utilise l’outil en ligne de commande make. Cet outil se lance comme un programme Python en lui passant des arguments, ou seul.
Un Makefile se compose généralement d’une liste de cibles, de dépendances, d’actions et de variables :
python test.py.python test.py $variable_1 $variable_2.En résumé, voici à quoi peut ressembler le gabarit d’un Makefile :
Variable = some_value

Target: Dependencies
    Actions (commands to build the target) $Variable
En reprenant nos exemples, le Makefile pourrait ressembler à ceci :
# Define variables
variable_1 = 5
variable_2 = 10

# Target to run a test with variables
test: test_data.txt # Dependency on test data file
python test.py $variable_1 $variable_2Nous pouvons installer l’outil CLI Make sur tous les systèmes d’exploitation.
Sous Linux, exécutez la commande suivante dans le terminal :
$ sudo apt install makeSous macOS, utilisez Homebrew pour installer Make :
$ brew install makeWindows fonctionne un peu différemment. Make peut être utilisé de plusieurs façons. Les options les plus courantes sont WSL (Ubuntu Linux), w64devkit et GnuWin32.
Téléchargez et installez GnuWin32 depuis la page SourceForge.
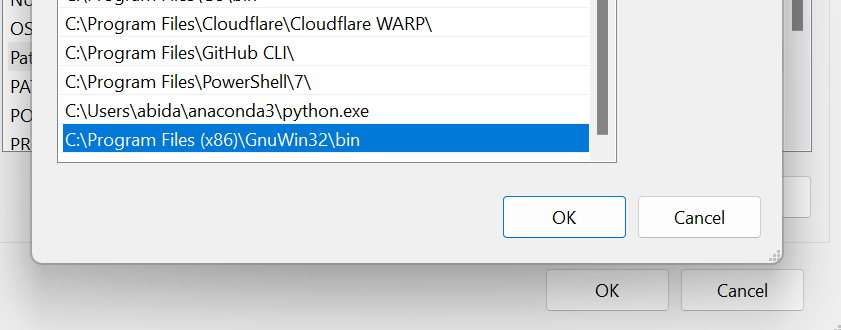
Pour l’utiliser en ligne de commande dans le terminal, ajoutez le chemin du dossier à la variable d’environnement Windows. Voici les étapes :
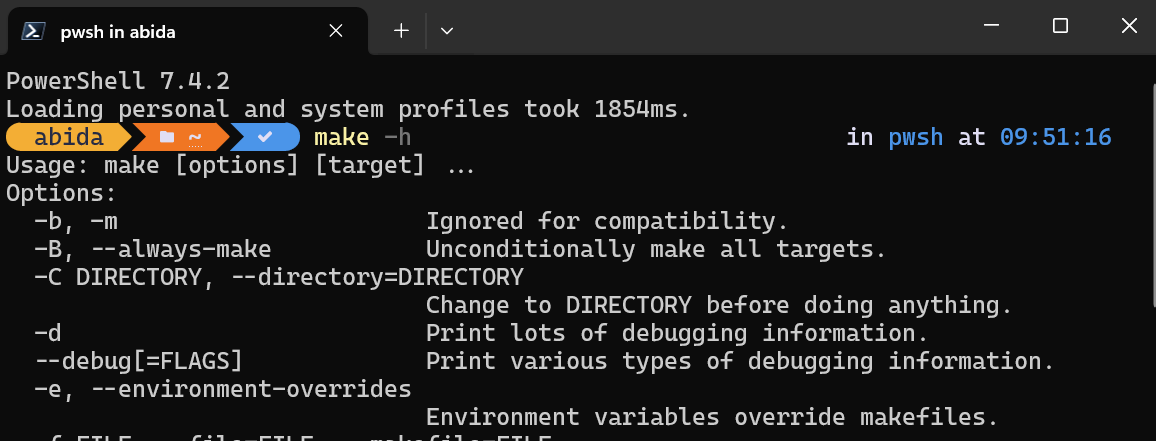
Pour vérifier l’installation, tapez make -h dans PowerShell.
Dans cette section, nous allons apprendre à utiliser Makefile et l’outil Make CLI dans un projet data science.
Nous utiliserons le jeu de données World Happiness Report 2023 pour couvrir le traitement, l’analyse et l’enregistrement de synthèses et visualisations.
Commencez par vous rendre dans le répertoire du projet et créez un dossier nommé Makefile-Action. Créez ensuite le fichier data_processing.py dans ce dossier et lancez l’éditeur VSCode.
$ cd GitHub
$ mkdir Makefile-Action
$ cd .\Makefile-Action\
$ code data_processing.pyNous commençons par traiter nos données avec Python. Dans le bloc de code ci‑dessous, nous effectuons les étapes suivantes (exemple simplifié : en production, il faudrait sans doute en faire davantage) :
Fichier : data_processing.py
import sys
import pandas as pd

# Check if the data location argument is provided
if len(sys.argv) != 2:
    print("Usage: python data_processing.py <data_location>")
    sys.exit(1)

# Load the raw dataset (step 1)
df = pd.read_csv(sys.argv[1])

# Rename columns to more descriptive names (step 2)
df.columns = [
    "Country",
    "Happiness Score",
    "Happiness Score Error",
    "Upper Whisker",
    "Lower Whisker",
    "GDP per Capita",
    "Social Support",
    "Healthy Life Expectancy",
    "Freedom to Make Life Choices",
    "Generosity",
    "Perceptions of Corruption",
    "Dystopia Happiness Score",
    "GDP per Capita",
    "Social Support",
    "Healthy Life Expectancy",
    "Freedom to Make Life Choices",
    "Generosity",
    "Perceptions of Corruption",
    "Dystopia Residual",
]

# Handle missing values by replacing them with the mean (step 3)
df.fillna(df.mean(numeric_only=True), inplace=True)

# Check for missing values after cleaning
print("Missing values after cleaning:")
print(df.isnull().sum())

print(df.head())

# Save the cleaned and normalized dataset to a new CSV file (step 4)
df.to_csv("processed_data\WHR2023_cleaned.csv", index=False)Poursuivons avec l’analyse et enregistrons tout notre code dans un fichier nommé data_analysis.py. Créez ce fichier avec la commande suivante :
$ code data_analysis.pyVous pouvez aussi utiliser la commande echo pour créer le fichier Python et l’ouvrir dans un autre éditeur.
$ echo "" > data_analysis.pyDans le bloc de code ci‑dessous, nous :
Fichier : data_analysis.py
import io
import sys

import matplotlib.pyplot as plt
import pandas as pd
import seaborn as sns

# Check if the data location argument is provided
if len(sys.argv) != 2:
    print("Usage: python data_analysis.py <data_location>")
    sys.exit(1)

# Load the clean dataset (step 1)
df = pd.read_csv(sys.argv[1])

# Data summary (step 2)
print("Data Summary:")
summary = df.describe()
data_head = df.head()
print(summary)
print(data_head)

# Collecting data information
buffer = io.StringIO()
df.info(buf=buffer)
info = buffer.getvalue()

## Write metrics to file
with open("processed_data/summary.txt", "w") as outfile:
    f"\n## Data Summary\n\n{summary}\n\n## Data Info\n\n{info}\n\n## Dataframe\n\n{data_head}"

print("Data summary saved in processed_data folder!")

# Distribution of Happiness Score (step 3)
plt.figure(figsize=(10, 6))
sns.displot(df["Happiness Score"])
plt.title("Distribution of Happiness Score")
plt.xlabel("Happiness Score")
plt.ylabel("Frequency")
plt.savefig("figures/happiness_score_distribution.png")

# Top 20 countries by Happiness Score
top_20_countries = df.nlargest(20, "Happiness Score")
plt.figure(figsize=(10, 6))
sns.barplot(x="Country", y="Happiness Score", data=top_20_countries)
plt.title("Top 20 Countries by Happiness Score")
plt.xlabel("Country")
plt.ylabel("Happiness Score")
plt.xticks(rotation=90)
plt.savefig("figures/top_20_countries_by_happiness_score.png")

# Scatter plot of Happiness Score vs GDP per Capita
plt.figure(figsize=(10, 6))
sns.scatterplot(x="GDP per Capita", y="Happiness Score", data=df)
plt.title("Happiness Score vs GDP per Capita")
plt.xlabel("GDP per Capita")
plt.ylabel("Happiness Score")
plt.savefig("figures/happiness_score_vs_gdp_per_capita.png")

# Visualize the relationship between Happiness Score and Social Support
plt.figure(figsize=(10, 6))
plt.scatter(x="Social Support", y="Happiness Score", data=df)
plt.xlabel("Social Support")
plt.ylabel("Happiness Score")
plt.title("Relationship between Social Support and Happiness Score")
plt.savefig("figures/social_support_happiness_relationship.png")

# Heatmap of correlations between variables
corr_matrix = df.drop("Country", axis=1).corr()
plt.figure(figsize=(12, 10))
sns.heatmap(corr_matrix, annot=True, cmap="coolwarm", square=True)
plt.title("Correlation Heatmap")
plt.savefig("figures/correlation_heatmap.png")
print("Visualizations saved to figures folder!")Avant de créer un Makefile, nous devons préparer un fichier requirements.txt pour installer tous les packages Python requis sur une nouvelle machine. Il ressemblera à :
pandas
numpy
seaborn
matplotlib
black
Notre Makefile se compose de variables, dépendances, cibles et actions : voyons chaque brique. Créons un fichier nommé Makefile et ajoutons les actions pour les cibles :
Fichier : Makefile
RAW_DATA_PATH = "raw_data/WHR2023.csv"
PROCESSED_DATA = "processed_data/WHR2023_cleaned.csv"

install:
    pip install --upgrade pip &&\
        pip install -r requirements.txt

format:
        black *.py --line-length 88

process: ./raw_data/WHR2023.csv
        python data_processing.py $(RAW_DATA_PATH)

analyze: ./processed_data/WHR2023_cleaned.csv
        python data_analysis.py $(PROCESSED_DATA)

clean:
        rm -f processed_data/* **/*.png

all: install format process analyze
Pour exécuter une cible, nous allons utiliser l’outil make et préciser le nom de la cible dans le terminal.
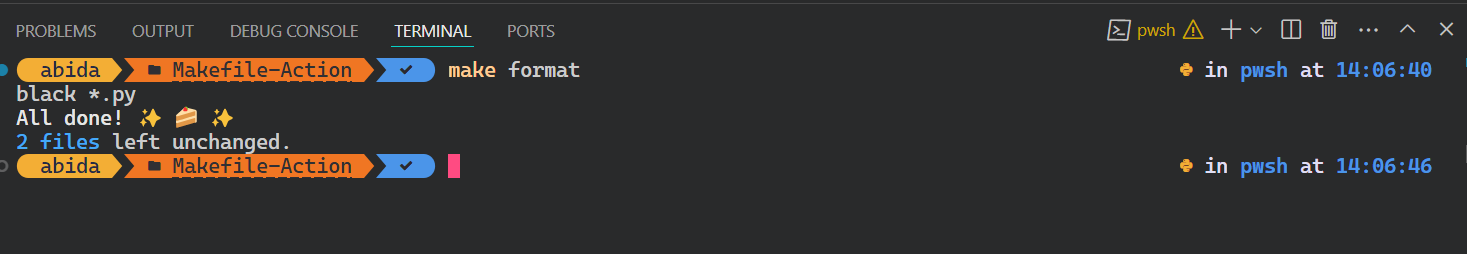
$ make formatLe formatage Black s’est exécuté avec succès.
Essayons d’exécuter le script Python de traitement des données.
À noter : Make vérifie les dépendances de la cible avant d’exécuter la cible process. Ici, il vérifie l’existence du fichier de données brutes. S’il est absent, la commande ne démarre pas.
$ make processComme vous le voyez, c’est très simple.
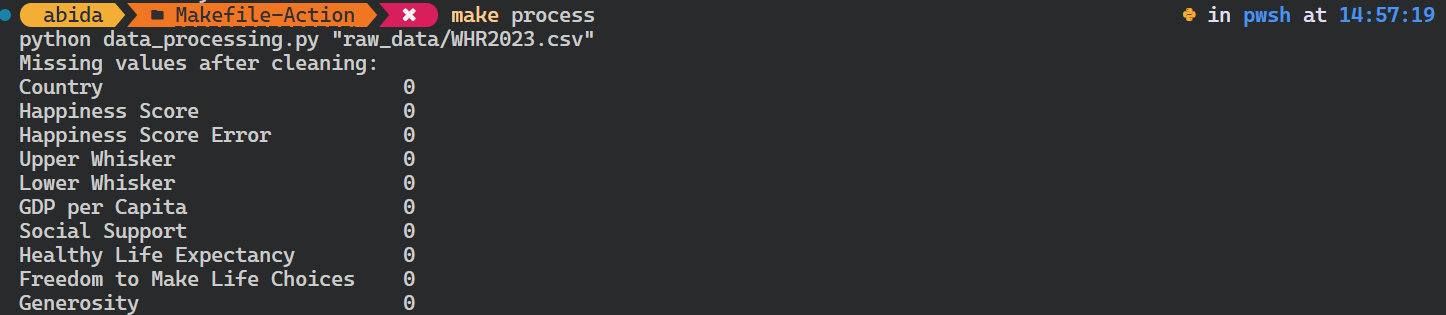
Vous pouvez même surcharger une variable existante en fournissant un argument supplémentaire à la commande make.
Ici, nous avons changé le chemin des données brutes.
$ make process RAW_DATA_PATH="WHR2022.csv"Le script Python s’est exécuté avec un argument d’entrée différent.
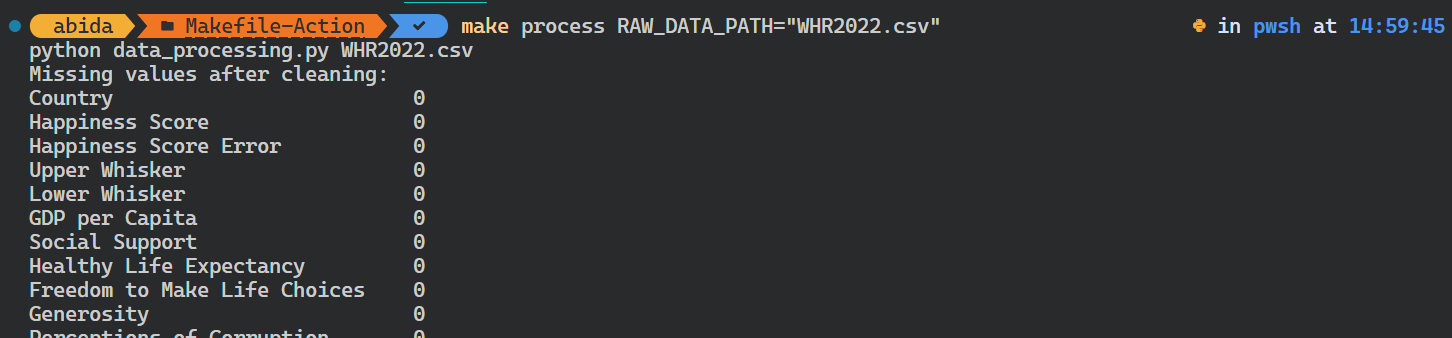
Pour automatiser l’ensemble du workflow, utilisons la cible all, qui exécutera successivement l’installation, le formatage, le traitement et l’analyse.
$ make allLa commande make a installé les packages Python, formaté le code, traité les données et enregistré le résumé ainsi que les visualisations.
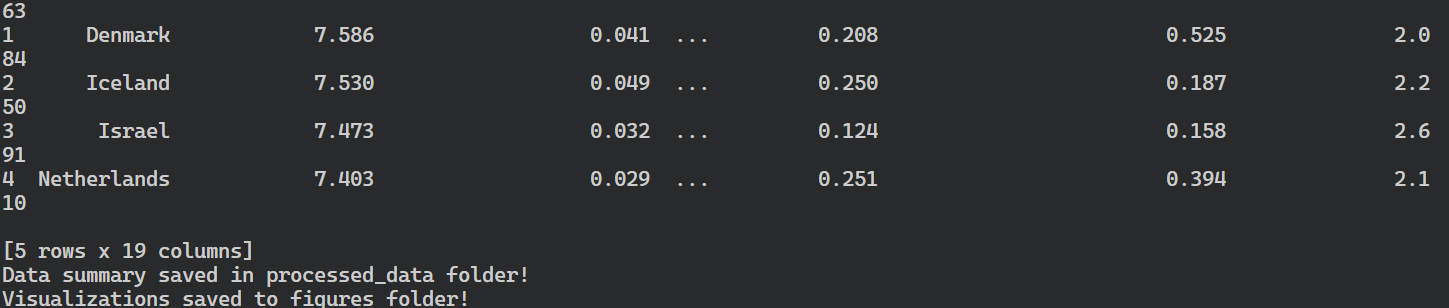
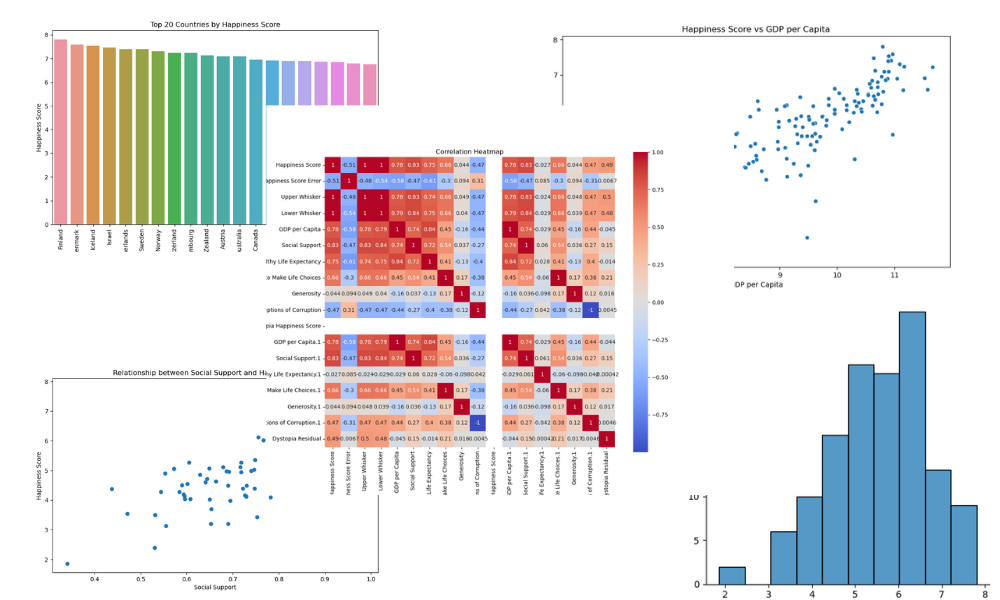
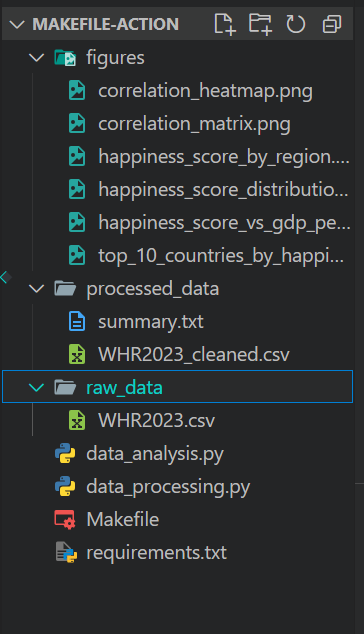
Voici à quoi votre répertoire de projet devrait ressembler après make all :
Si Make excelle pour l’automatisation locale dans notre environnement de développement, GitHub Actions propose une alternative cloud.
GitHub Actions est généralement utilisé pour la CI/CD, permettant de compiler, construire, tester et déployer une application en production directement depuis GitHub.
Par exemple, nous pouvons créer un workflow personnalisé déclenché par des événements spécifiques comme des push ou des pull requests. Ce workflow exécutera des scripts shell et Python, ou utilisera des actions préconstruites. Le workflow personnalisé est un fichier YML, généralement simple à lire et à écrire.
Explorons les composants essentiels de GitHub Actions :
Dans cette section, nous allons apprendre à utiliser GitHub Actions et tenter de reproduire les commandes utilisées précédemment dans le Makefile.
Pour transférer notre code sur GitHub, convertissons notre dossier de projet en dépôt Git avec :
$ git initEnsuite, créons un nouveau repository sur GitHub et copions son URL.
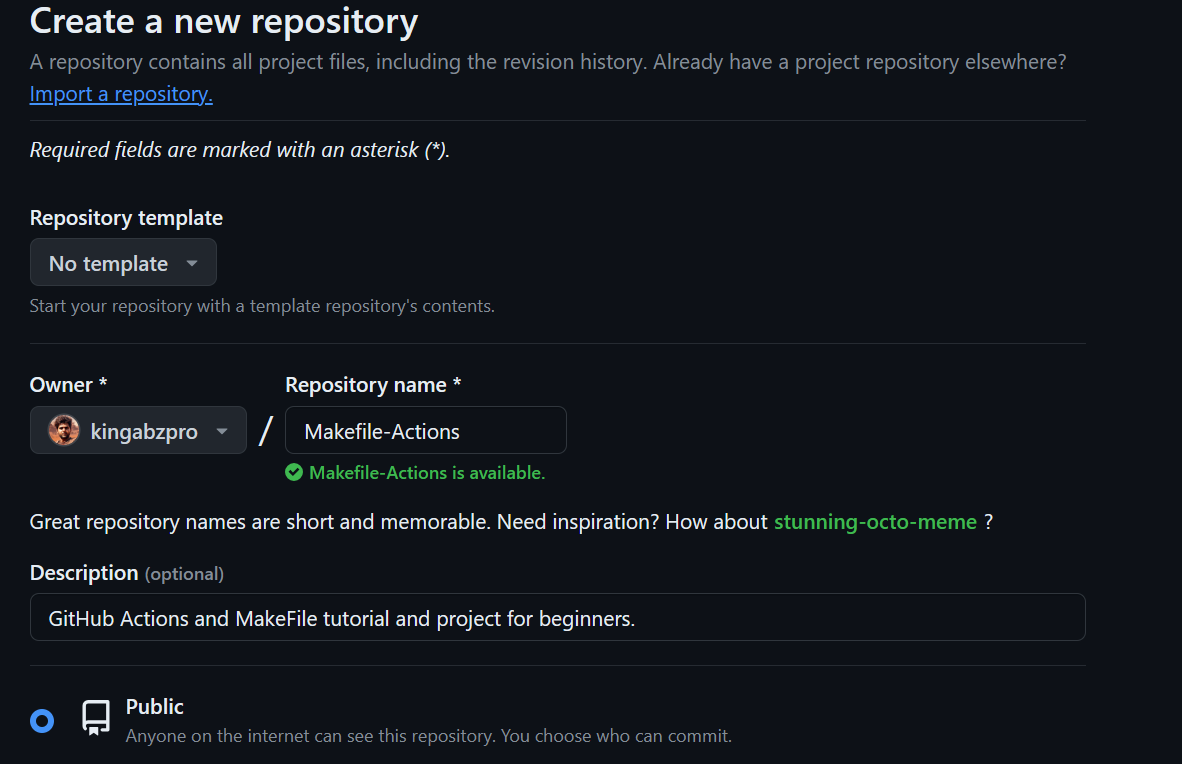
Dans le terminal, tapez les commandes ci‑dessous pour :
master local vers la branche distante main.$ git remote add github https://github.com/kingabzpro/Makefile-Actions.git
$ git pull github main
$ git add .
$ git commit -m "adding all the files"
$ git push github master:mainAu passage, si vous avez besoin d’une piqûre de rappel sur GitHub ou Git, consultez ce tutoriel pour débuter : GitHub et Git. Il vous aidera à versionner votre projet data et à le partager avec l’équipe via l’outil Git en ligne de commande.
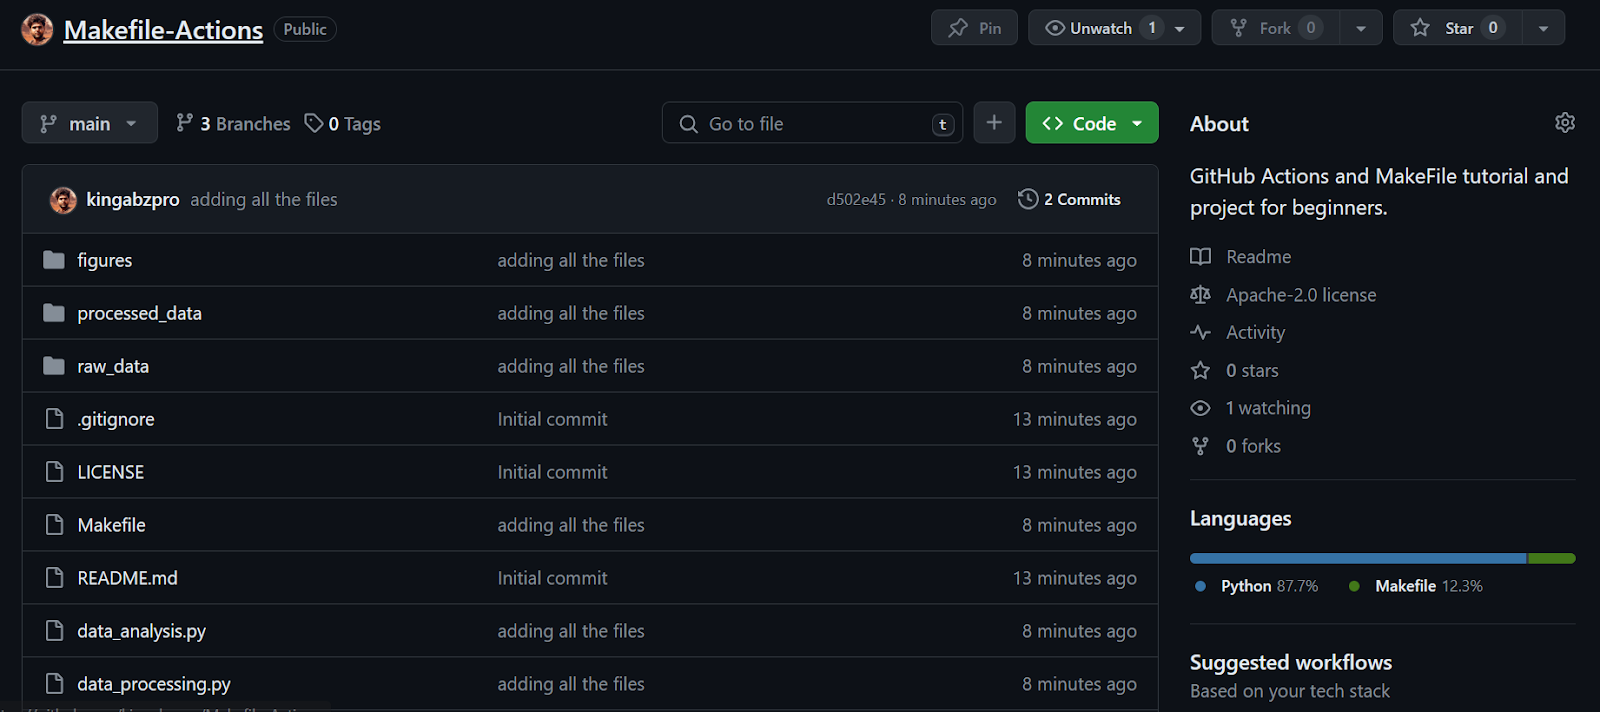
Revenons à notre sujet : tous les fichiers ont bien été transférés vers le dépôt distant.
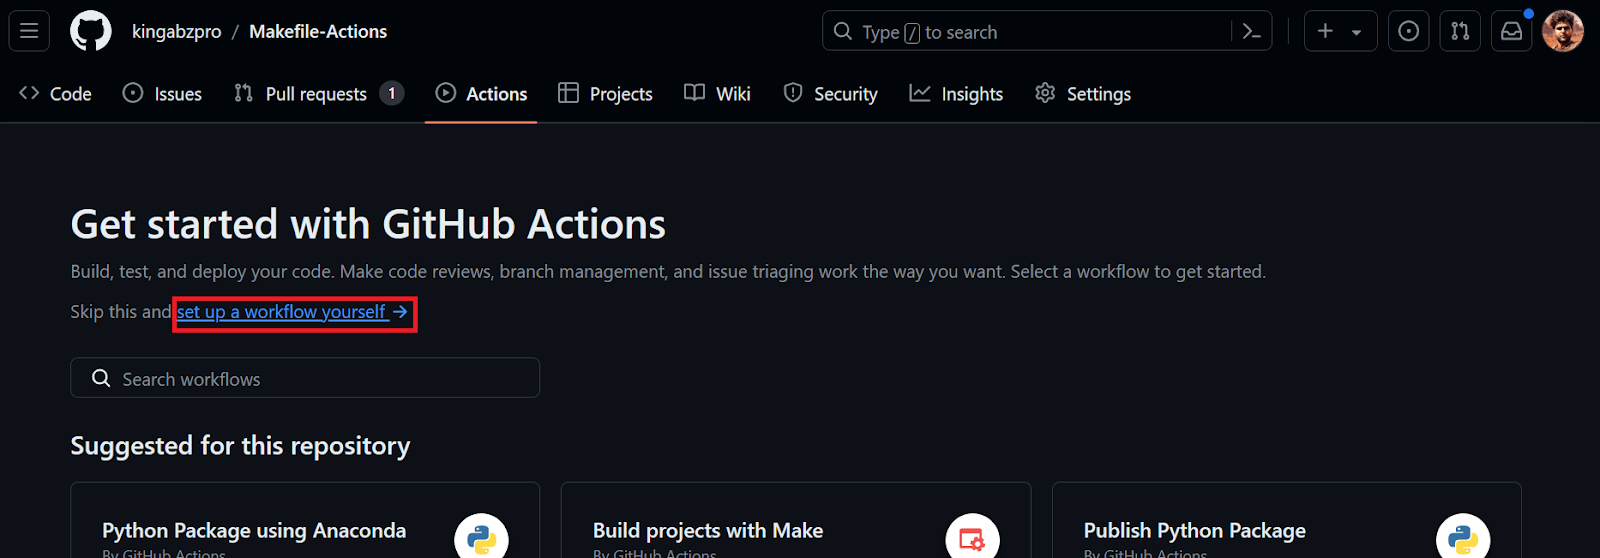
Créons maintenant un workflow GitHub Action. Rendez‑vous d’abord dans l’onglet Actions de notre dépôt kingabzpro/Makefile-Actions. Cliquez ensuite sur le lien bleu « set up a workflow yourself. »
Vous êtes redirigé vers le fichier YML, où nous écrirons tout le code pour préparer l’environnement et exécuter les commandes. Nous allons :
main ou d’une pull request sur main.name: Data Processing and Analysis
on:
push:
branches: [ "main" ]
pull_request:
branches: [ "main" ]
jobs:
build:
runs-on: ubuntu-latest
steps:
- uses: actions/checkout@v3
- name: Install Packages
run: |
pip install --upgrade pip
pip install -r requirements.txt
- name: Format
run: black *.py --line-length 88
- name: Data Processing
env:
RAW_DATA_DIR: "./raw_data/WHR2023.csv"
run: python data_processing.py $RAW_DATA_DIR
- name: Data Analysis
env:
CLEAN_DATA_DIR: "./processed_data/WHR2023_cleaned.csv"
run: python data_analysis.py $CLEAN_DATA_DIRAprès avoir validé le fichier de workflow avec un message de commit, l’exécution démarre automatiquement.
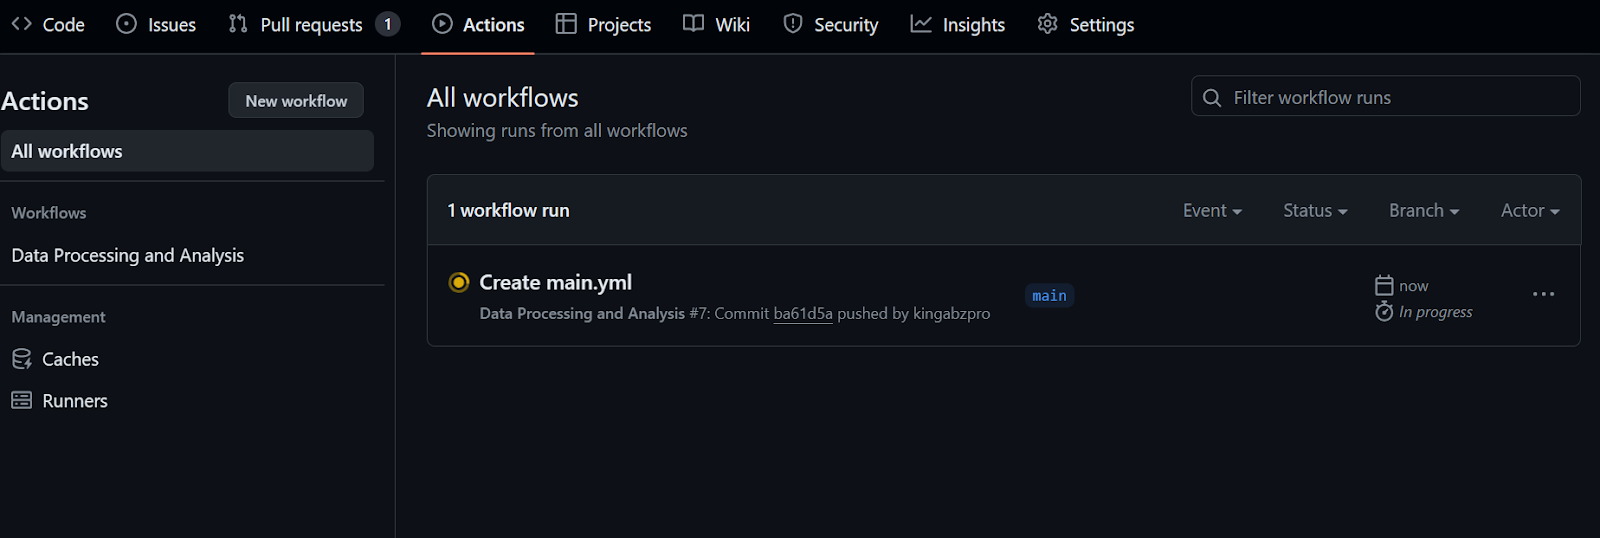
L’exécution prend au minimum 20 secondes.
Pour consulter les logs, cliquez d’abord sur le run du workflow, puis sur le bouton Build, et enfin sur chaque job pour accéder aux journaux.
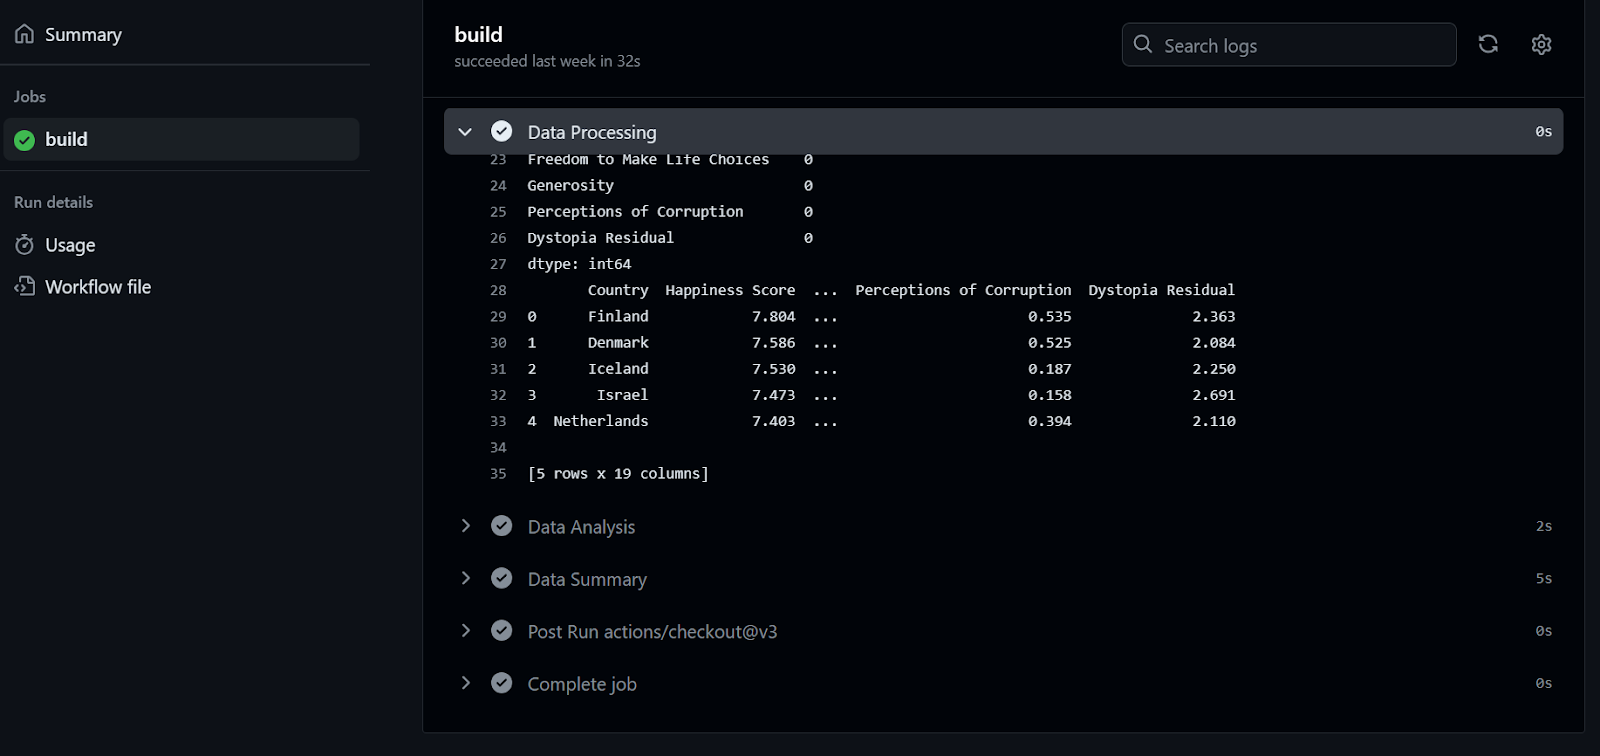
Si cela vous a plu, vous apprécierez sûrement ce guide du débutant sur la CI/CD pour le machine learning, qui couvre les bases de la création et de l’automatisation d’un workflow ML.
Pour simplifier et standardiser les workflows GitHub Actions, les développeurs utilisent souvent des commandes Make au sein du fichier de workflow. Dans cette section, nous allons simplifier notre workflow avec Make et découvrir l’action Continuous Machine Learning (CML).
Avant de commencer, récupérons le fichier de workflow depuis le dépôt distant.
$ git pullContinuous Machine Learning (CML) est une bibliothèque open source d’iterative.ai qui permet d’implémenter l’intégration continue dans un projet data science.
Dans ce projet, nous allons utiliser l’action GitHub iterative/setup-cml, qui s’appuie sur les fonctions CML dans le workflow pour générer un rapport d’analyse à partir des figures et des statistiques.
Le rapport sera créé et joint à notre commit GitHub pour que l’équipe puisse le relire et l’approuver avant le merge.
Nous allons modifier le Makefile et ajouter une nouvelle cible « summary ». Notez que :
cml pour créer un rapport d’analyse de données et l’afficher dans les commentaires du commit.Imaginez ajouter toutes ces lignes dans le workflow GitHub : ce serait peu lisible et difficile à maintenir. À la place, nous utiliserons make summary.
Fichier : Makefile
summary: ./processed_data/summary.txt
echo "# Data Summary" > report.md
cat ./processed_data/summary.txt >> report.md
echo '\n# Data Analysis' >> report.md
echo '\n## Correlation Heatmap' >> report.md
echo '' >> report.md
echo '\n## Happiness Score Distribution' >> report.md
echo '' >> report.md
echo '\n## Happiness Score vs GDP per Capita' >> report.md
echo '' >> report.md
echo '\n## Social Support vs Happiness Relationship' >> report.md
echo '' >> report.md
echo '\n## Top 20 Countries by Happiness Score' >> report.md
echo '' >> report.md
cml comment create report.md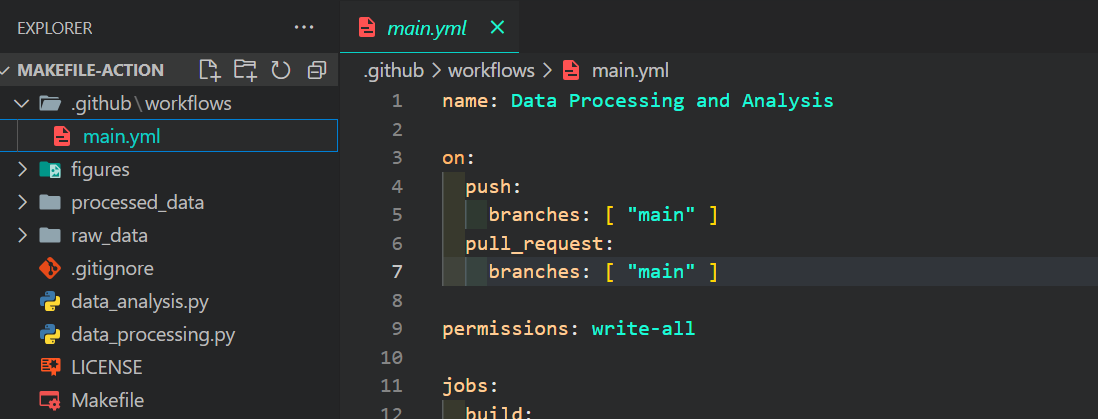
Nous allons maintenant éditer notre fichier main.yml, situé dans le répertoire .github/workflows.
Nous remplaçons toutes les commandes et scripts Python par des commandes make et donnons les autorisations nécessaires à l’action CML pour créer le rapport dans le commentaire du commit. N’oublions pas d’ajouter l’action iterative/setup-cml@v3 à notre run.
name: Data Processing and Analysis

on:
  push:
    branches: [ "main" ]
  pull_request:
    branches: [ "main" ]

permissions: write-all

jobs:
  build:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v3
      - uses: iterative/setup-cml@v3
      - name: Install Packages
        run: make install
      - name: Format
        run: make format
      - name: Data Processing
        env:
          RAW_DATA_DIR: "./raw_data/WHR2023.csv"
        run: make process RAW_DATA_PATH=$RAW_DATA_DIR
      - name: Data Analysis
        env:
          CLEAN_DATA_DIR: "./processed_data/WHR2023_cleaned.csv"
        run: make analyze PROCESSED_DATA=$CLEAN_DATA_DIR
      - name: Data Summary
        env:
          REPO_TOKEN: ${{ secrets.GITHUB_TOKEN }}
run: make summaryPour lancer le workflow, il suffit de valider toutes les modifications et de les synchroniser avec la branche distante main.
$ git commit -am "makefile and github action combo"
$ git push github master:main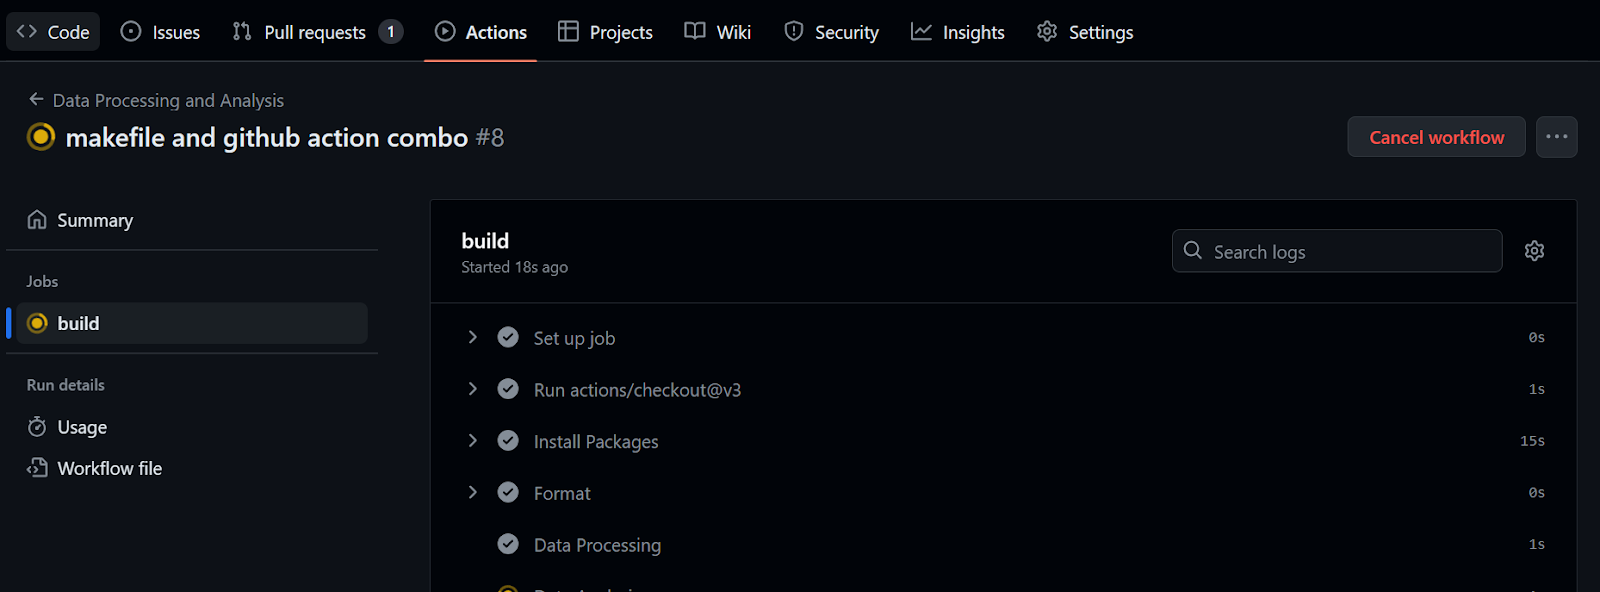
L’exécution a pris 32 secondes : notre rapport est prêt à être relu. Pour l’afficher, rendez‑vous dans le récapitulatif du build, faites défiler jusqu’à l’onglet Data Summary, puis cliquez sur le lien du commentaire (le lien visible à la ligne 20 sur la capture ci‑dessous) :
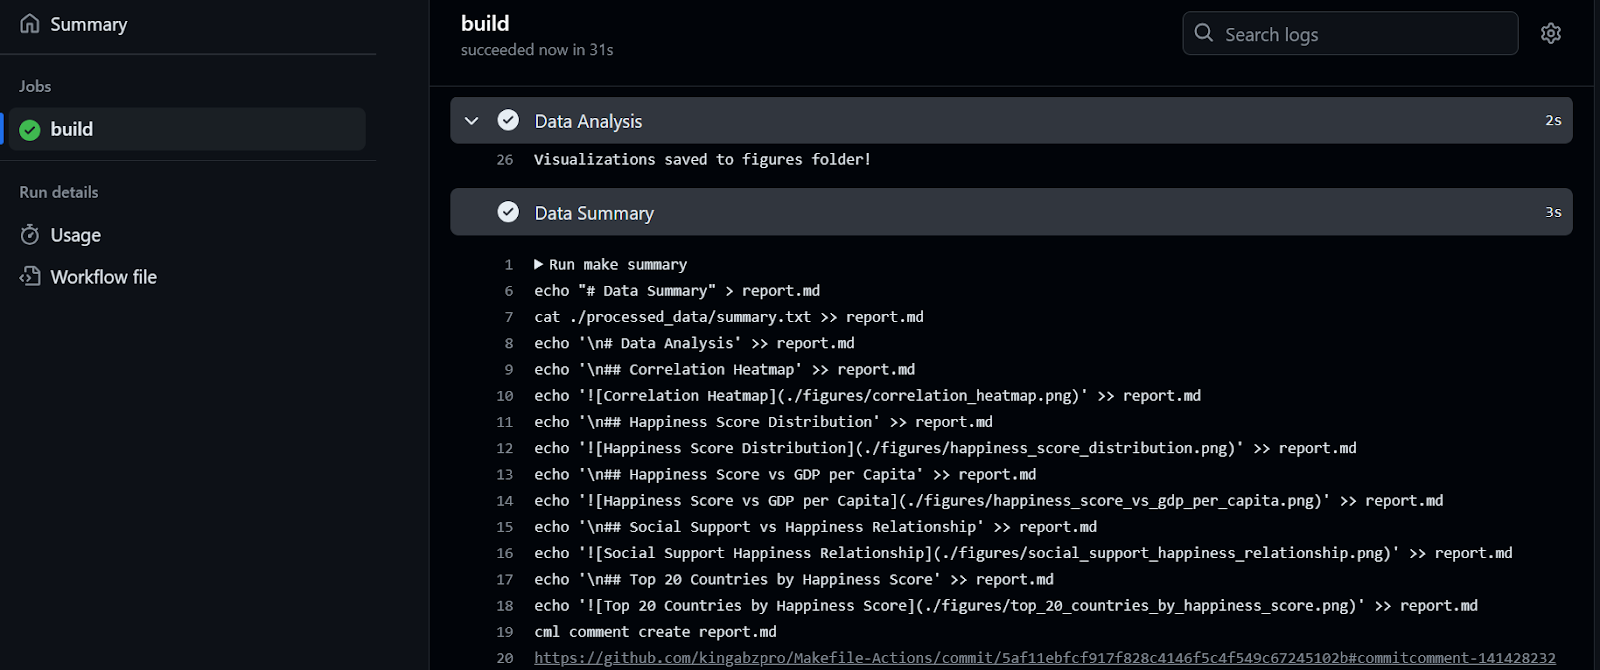
Comme vous pouvez le voir, le résumé des données et les visualisations sont joints à notre commit.
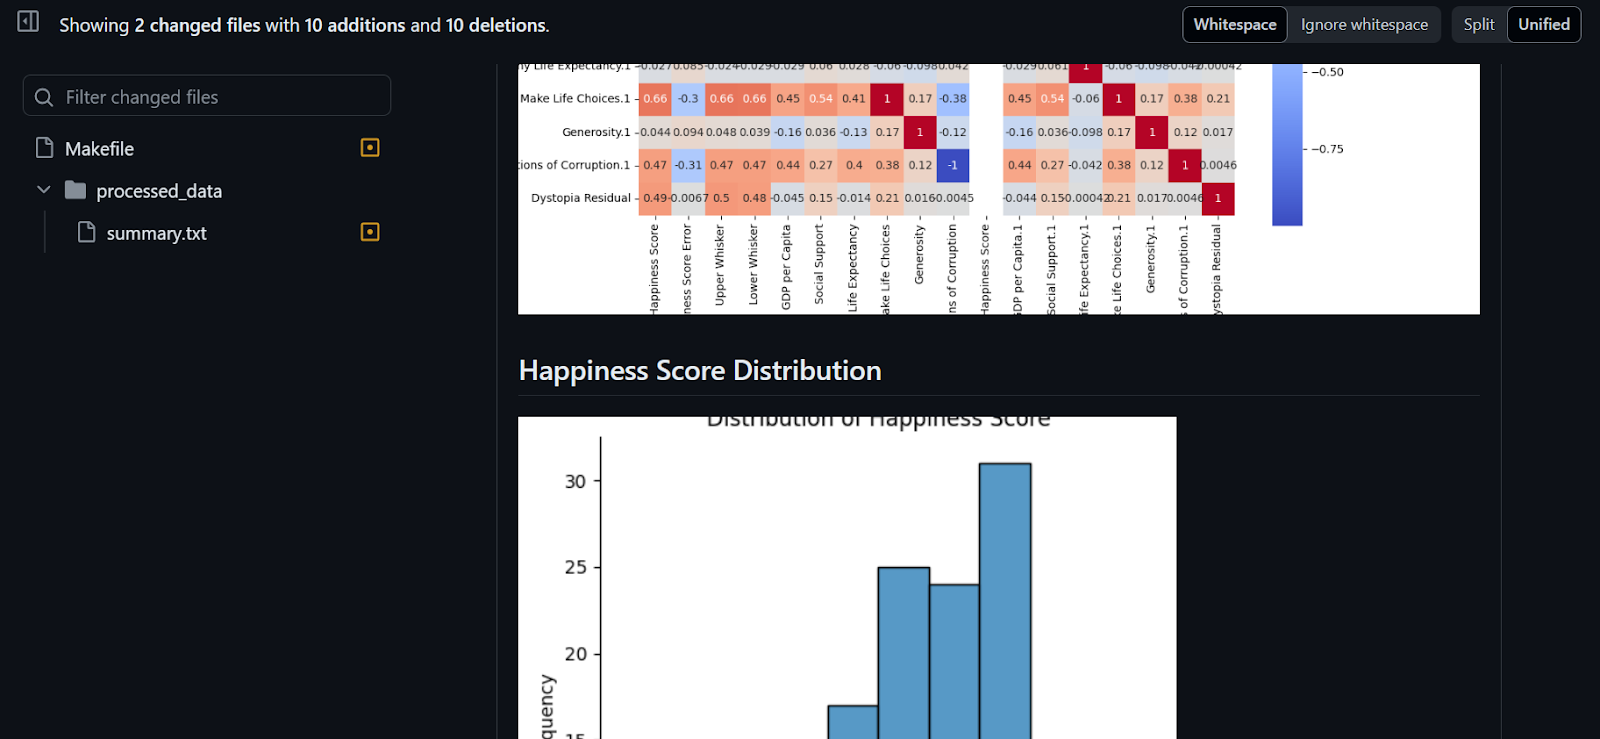
Le projet est disponible sur kingabzpro/Makefile-Actions. Vous pouvez vous y référer en cas de blocage. Le dépôt est public : faites un fork et testez par vous‑même !
Vous souhaitez obtenir une certification GitHub ? Consultez notre guide complet des certifications GitHub !
Dans ce tutoriel, nous nous sommes concentrés sur Makefile et GitHub Actions pour automatiser la génération de rapports d’analyse de données.
Nous avons également vu comment construire et exécuter le workflow et comment utiliser Make au sein du workflow GitHub pour optimiser et simplifier l’automatisation. Plutôt que d’écrire des dizaines de lignes, il suffit d’utiliser make summary pour générer un rapport d’analyse joint au commit.
Si vous souhaitez maîtriser la CI/CD pour la data science, essayez ce cours sur la CI/CD pour le machine learning. Il couvre les fondamentaux de la CI/CD, GitHub Actions, la version des données et l’automatisation de l’optimisation et de l’évaluation des hyperparamètres de modèles.
Devenez machine learning engineer !
Cursus
Cursus
Cours