Microsoft Synapse Analytics, anteriormente conocido como Azure SQL Data Warehouse, es un servicio de análisis integrado que ofrece una plataforma unificada para big data y almacenamiento de datos.
Al combinar a la perfección el almacenamiento de datos empresariales y el análisis de macrodatos, Synapse permite a los usuarios ingestar, preparar, gestionar y servir datos para satisfacer las necesidades inmediatas de inteligencia empresarial y machine learning. Este potente servicio es compatible con múltiples lenguajes, como SQL, Python y Spark, lo que permite una amplia gama de capacidades de procesamiento y transformación de datos. Además, su arquitectura sin servidor garantiza la escalabilidad necesaria para gestionar cualquier volumen de datos, lo que lo convierte en una herramienta indispensable para los profesionales de datos modernos.
Esta guía proporciona temas y preguntas esenciales para ayudarte a prepararte para tu entrevista con Synapse. Estas preguntas reflejan mi propia experiencia entrevistando y trabajando con profesionales de datos que utilizan Synapse, y proporcionan una valiosa información sobre lo que buscan los responsables de contratación.
Además de seguir esta guía de entrevista, te sugiero que consultes la documentación de Microsoft Azure Synapse Analytics si tienes alguna pregunta específica durante el proceso.
Preguntas básicas para una entrevista de Synapse
En el nivel básico, las preguntas abarcarán tus conocimientos fundamentales sobre Synapse, incluyendo tareas como navegar por Synapse Studio, comprender sus componentes básicos y realizar exploraciones de datos sencillas. Prepárate para estas preguntas si tienes poca experiencia con Synapse o si el entrevistador está evaluando tus conocimientos básicos.
¿Cuáles son los temas clave con los que debes estar familiarizado?
Si te piden que des una visión general de alto nivel sobre Synapse, deberías ser capaz de describir Synapse Analytics y su función en un panorama de datos moderno.
- Características principales e interfaz de usuario: Comprender Synapse Studio, sus diferentes centros (Datos, Desarrollo, Integración, Supervisión, Gestión) y sus funcionalidades.
- Casos de uso sencillos: Proporciona ejemplos de cómo las organizaciones utilizan Synapse, incluyendo información básica sobre su arquitectura.
¿Qué es Microsoft Synapse Analytics y cuáles son sus características principales?
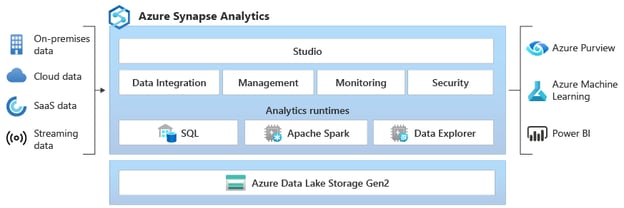
Synapse Analytics es un servicio de análisis sin límites que combina el almacenamiento de datos empresariales y el análisis de macrodatos. Las características principales incluyen:
- Grupo SQL (almacén de datos): Un motor de consultas distribuido para el análisis de alto rendimiento de datos estructurados.
- Spark Pool: Integración con Apache Spark para el procesamiento de big data y machine learning.
- Soporte técnico para Data Lake: Integración nativa con Azure Data Lake Storage Gen2 para analizar datos in situ.
- Synapse Studio: Un espacio de trabajo unificado para la preparación de datos, el almacenamiento de datos, el análisis de big data y las tareas de inteligencia artificial.
- Integración de datos: Funciones integradas de integración de datos con Azure Data Factory.
Explica la arquitectura central de Synapse Analytics.
La arquitectura central incluye:
- Synapse Studio: La interfaz de usuario central para todas las actividades de Synapse.
- Grupos SQL: Proporciona capacidades de consulta basadas en T-SQL para datos estructurados. Los grupos SQL dedicados proporcionan recursos garantizados, mientras que los grupos SQL sin servidor ofrecen consultas de datos bajo demanda en el lago de datos.
- Spark Pools: Proporciona Apache Spark como servicio para tareas de procesamiento de big data, ingeniería de datos y machine learning.
- Almacenamiento de lago de datos: Azure Data Lake Storage Gen2 sirve como base para almacenar grandes volúmenes de datos estructurados, semiestructurados y no estructurados.
- Tuberías: Canales de integración de datos impulsados por Azure Data Factory para procesos ETL/ELT.
¿Cómo se consultan los datos en Synapse Analytics?
Puedes consultar datos en Synapse utilizando:
- T-SQL: Uso del grupo SQL para datos estructurados.
- Spark SQL: Uso de Spark Pools para los datos del lago de datos.
- Grupo SQL sin servidor: Consulta datos directamente en el lago de datos utilizando T-SQL sin necesidad de aprovisionar recursos.
Estas preguntas evalúan tu comprensión profunda de Synapse y su configuración. Deberás demostrar tu capacidad para gestionar recursos, implementar flujos de trabajo de procesamiento de datos y optimizar el rendimiento.
Esto se basa en tus conocimientos básicos y requiere comprender:
- Gestión de recursos: Cómo aprovisionar y gestionar grupos SQL y grupos Spark.
- Integración de datos: Creación y administración de canalizaciones de datos mediante Synapse Pipelines (Azure Data Factory).
- Optimización del rendimiento: Comprensión de las técnicas de optimización de consultas y las estrategias de partición de datos.
¿Cómo se crean y gestionan los grupos SQL en Synapse Analytics?
Para crear un grupo SQL, accede a Synapse Studio, selecciona el centro «Administrar» y, a continuación, «Grupos SQL». A continuación, puedes configurar el nivel de rendimiento del grupo (unidades de almacén de datos, DWU) en función de los requisitos de tu carga de trabajo.
La gestión implica supervisar el rendimiento, escalar los recursos y pausar/reanudar el grupo según sea necesario.
Explica cómo se utiliza Spark en Synapse Analytics.
Synapse utiliza Spark Pools para proporcionar Apache Spark como servicio. Esto te permite:
- Procesa grandes conjuntos de datos utilizando Spark DataFrame.
- Realizar tareas de ingeniería de datos utilizando lenguajes como Python, Scala y Java.
- Crea y entrena modelos de machine learning con Spark MLlib.
¿Qué son las canalizaciones de datos y cómo se crean en Synapse?
Las canalizaciones de datos son flujos de trabajo automatizados para la ingesta, transformación y carga de datos. En Synapse, tú los creas utilizando el centro «Integrate», que proporciona una interfaz visual (Azure Data Factory) para diseñar y administrar canalizaciones.
Estas canalizaciones pueden conectarse a diversas fuentes de datos, realizar transformaciones mediante actividades como el flujo de datos o la ejecución de procedimientos almacenados, y cargar datos en los sistemas de destino.
¿Cómo supervisas y gestionas los recursos en Synapse Analytics?
Puedes supervisar los recursos a través del centro «Monitor» en Synapse Studio. Este centro proporciona información sobre el rendimiento de SQL Pool y Spark Pool, las ejecuciones de canalizaciones y el estado general del sistema. También puedes utilizar Azure Monitor para obtener funciones de supervisión y alertas más detalladas.
Describe las opciones de almacenamiento de datos disponibles en Synapse Analytics.
Synapse Analytics ofrece una variedad de opciones de almacenamiento de datos que se adaptan a diferentes necesidades y situaciones, lo que garantiza flexibilidad y eficiencia en el manejo de diversos conjuntos de datos. Estas opciones incluyen:
- Almacenamiento de lago de datos de Azure Gen2: Almacenamiento primario para el lago de datos, optimizado para análisis a gran escala.
- Almacenamiento en grupo SQL: Almacena datos estructurados en el almacén de datos.
- Almacenamiento de blobs de Azure: Se puede utilizar para almacenar datos, aunque Data Lake Storage Gen2 suele ser la opción preferida para las cargas de trabajo de análisis.
Preguntas avanzadas para entrevistas sobre Synapse
Se espera que los usuarios avanzados se encarguen de la optimización del rendimiento, creen flujos de trabajo complejos e implementen modelos sofisticados de análisis y machine learning. Estas preguntas son típicas para puestos de alto nivel relacionados con los datos o funciones con un componente de DevOps.
Esto se basa en conocimientos básicos e intermedios, y requiere experiencia práctica en:
- Optimización del rendimiento: Ajustar las configuraciones de SQL Pool y Spark Pool, optimizar las consultas y gestionar la partición de datos.
- machine learning: Integración de Synapse con Azure Machine Learning, implementación de modelos y gestión del ciclo de vida de los modelos.
- Canales de CI/CD: Implementación de integración continua y despliegue continuo para las soluciones Synapse.
¿Qué estrategias utilizas para optimizar el rendimiento en Synapse?
Indexación adecuada: Optimiza el rendimiento del grupo SQL mediante índices de almacenamiento en columnas agrupados e índices no agrupados adecuados.
- Partición de datos: Particiona los datos en SQL Pools y Data Lake Storage según los patrones de consulta para mejorar el rendimiento.
- Optimización de consultas: Utiliza sugerencias de consulta, reescribe consultas complejas y analiza los planes de ejecución de consultas para identificar cuellos de botella.
- Asignación de recursos: Ajusta el tamaño de los grupos SQL y Spark en función de los requisitos de carga de trabajo.
¿Cómo puedes implementar canalizaciones CI/CD para Synapse Analytics?
Utiliza Azure DevOps o GitHub Actions para automatizar la compilación, las pruebas y la implementación de soluciones Synapse. Esto incluye:
- Control de código fuente: Almacenar artefactos de Synapse (scripts SQL, cuadernos Spark, canalizaciones) en un sistema de control de versiones.
- Pruebas automatizadas: Implementar pruebas unitarias y pruebas de integración para scripts SQL y canalizaciones de datos.
- Implementación automatizada: Utiliza plantillas de Azure Resource Manager (ARM) o API de Synapse para implementar cambios en diferentes entornos (desarrollo, pruebas, producción).
¿Cómo se gestionan los análisis complejos en Synapse Analytics?
Para gestionar análisis complejos y garantizar operaciones de datos fluidas dentro de Synapse Analytics, es necesario adoptar un enfoque multifacético. Esto implica pruebas automatizadas, estrategias de implementación y técnicas analíticas avanzadas.
A continuación, encontrarás métodos esenciales para alcanzar estos objetivos de manera eficaz:
- Consultas SQL avanzadas: Utiliza funciones de ventana, expresiones de tabla comunes (CTE) y otras características avanzadas de T-SQL para realizar análisis de datos complejos en grupos SQL.
- Spark para el procesamiento de macrodatos: Utiliza Spark Pools para procesar grandes conjuntos de datos, realizar transformaciones complejas y crear modelos de machine learning.
- Integración con Azure Machine Learning: Aprovecha Azure Machine Learning para escenarios de análisis avanzados, como el modelado predictivo y la detección de anomalías.
¿Cómo se implementan los modelos de machine learning en Synapse Analytics?
La implementación de modelos de machine learning en Synapse Analytics implica varios pasos clave, desde el entrenamiento y el registro de los modelos hasta su implementación para su uso práctico. A continuación, se presenta un enfoque estructurado para implementar con éxito modelos de machine learning:
- Modelos de trenes: Entrena modelos de machine learning con Spark MLlib en Synapse o Azure Machine Learning.
- Registrar modelos: Registra modelos entrenados en el Registro de modelos de Azure Machine Learning.
- Implementar modelos: Implementa modelos como puntos finales REST con Azure Machine Learning o intégralos en canalizaciones de Synapse para la puntuación por lotes.
Preguntas de la entrevista de Synapse para puestos de ingeniero de datos
Los ingenieros de datos son responsables de diseñar, crear y mantener canales de datos, garantizar la calidad de los datos y optimizar el rendimiento. Para los puestos de ingeniero de datos centrados en Synapse, debes comprender:
- Arquitectura del canal de datos: Diseña canalizaciones de datos escalables y fiables para procesos ETL/ELT.
- Procesamiento en tiempo real: Implementa la ingesta y el procesamiento de datos en tiempo real con Azure Event Hubs, Azure Stream Analytics y Synapse.
- Seguridad de los datos: Implementa medidas de seguridad para proteger los datos en reposo y en tránsito.
¿Cómo se diseñan los flujos de datos en Synapse Analytics?
Al diseñar canalizaciones de datos en Synapse Analytics, hay que tener en cuenta varios componentes clave para garantizar un procesamiento de datos eficiente y fiable:
- Identifica las fuentes de datos: Determina las fuentes de datos (por ejemplo, bases de datos, API, archivos) y sus métodos de ingestión.
- Diseña procesos ETL/ELT: Crea canalizaciones de datos con Synapse Pipelines (Azure Data Factory) para extraer, transformar y cargar datos.
- Implementar controles de calidad de datos: Añade pasos de validación de datos y gestión de errores para garantizar la calidad de los datos.
- Automatizar la ejecución del proceso: Programa las canalizaciones para que se ejecuten automáticamente mediante desencadenadores y ejecuciones programadas.
¿Cuáles son las mejores prácticas para los procesos ETL en Synapse Analytics?
En el contexto de Synapse Analytics, la implementación de procesos ETL (extraer, transformar, cargar) eficaces es fundamental para garantizar una gestión y un análisis eficientes de los datos. Se recomiendan las siguientes prácticas recomendadas para optimizar los procesos ETL en Synapse Analytics:
- Utiliza Delta Lake: Utiliza Delta Lake para almacenar datos en el lago de datos y habilitar transacciones ACID y control de versiones de datos.
- Código modular: Escribe código modular y reutilizable en cuadernos Synapse y scripts SQL.
- Parametrización: Parametrizad los procesos y los scripts SQL para que sean más flexibles y reutilizables.
- Supervisión: Supervisa las ejecuciones y el rendimiento de las canalizaciones con Synapse Studio y Azure Monitor.
¿Cómo gestionas el procesamiento de datos en tiempo real en Synapse?
Como ingeniero de datos, uno se enfrenta a numerosos retos que requieren soluciones innovadoras y metodologías sólidas. Trabajar y manejar datos en tiempo real es uno de ellos. A continuación, se describen algunas experiencias y técnicas que se emplean habitualmente:
- Ingesta de datos en tiempo real: Usa Azure Event Hubs o Azure IoT Hub para incorporar flujos de datos en tiempo real.
- Procesar datos con análisis de flujos: Usa Azure Stream Analytics para realizar transformaciones y agregaciones en tiempo real.
- Cargar datos en Synapse: Carga los datos procesados en SQL Pools o Data Lake Storage para realizar análisis en tiempo real.
¿Cómo garantizas la seguridad de los datos en Synapse Analytics?
Garantizar la seguridad de los datos en Synapse Analytics es fundamental para proteger la información confidencial y mantener el cumplimiento de las normas reglamentarias. Se pueden implementar varias estrategias clave para proteger los datos dentro del entorno Synapse:
- Control de acceso: Implementa el control de acceso basado en roles (RBAC) para gestionar el acceso a los recursos de Synapse.
- Datos cifrado: Habilita el cifrado en reposo y en tránsito con Azure Key Vault.
- Seguridadde la red : Utiliza la integración de redes virtuales (VNet) y los puntos de conexión privados para proteger el acceso a la red.
- Auditoría: Habilita la auditoría para realizar un seguimiento de la actividad de los usuarios y el acceso a los datos.
- Enmascaramiento de datos: Implementa el enmascaramiento de datos para proteger la información confidencial.
Reflexiones finales
Esta guía te ha proporcionado información clave para afrontar con confianza tu entrevista para Microsoft Synapse Analytics, tanto si eres ingeniero de datos como ingeniero de software.
Recuerda destacar no solo tus conocimientos teóricos, sino también tu experiencia práctica en el diseño de canales de datos, la optimización del rendimiento y la garantía de una seguridad de datos sólida.
Más allá de los aspectos técnicos, destaca tus habilidades para resolver problemas y tu capacidad para aprender continuamente, ya que Synapse Analytics es una plataforma en rápida evolución. Mantén tu curiosidad, sigue explorando los recursos de Microsoft y demuestra tu pasión por aprovechar los datos para impulsar resultados empresariales impactantes. ¡Buena suerte!




Microsoft Synapse Analytics, anteriormente conocido como Azure SQL Data Warehouse, es un servicio de análisis integrado que ofrece una plataforma unificada para big data y almacenamiento de datos.
Al combinar a la perfección el almacenamiento de datos empresariales y el análisis de macrodatos, Synapse permite a los usuarios ingestar, preparar, gestionar y servir datos para satisfacer las necesidades inmediatas de inteligencia empresarial y machine learning. Este potente servicio es compatible con múltiples lenguajes, como SQL, Python y Spark, lo que permite una amplia gama de capacidades de procesamiento y transformación de datos. Además, su arquitectura sin servidor garantiza la escalabilidad necesaria para gestionar cualquier volumen de datos, lo que lo convierte en una herramienta indispensable para los profesionales de datos modernos.
Esta guía proporciona temas y preguntas esenciales para ayudarte a prepararte para tu entrevista con Synapse. Estas preguntas reflejan mi propia experiencia entrevistando y trabajando con profesionales de datos que utilizan Synapse, y proporcionan una valiosa información sobre lo que buscan los responsables de contratación.
Además de seguir esta guía de entrevista, te sugiero que consultes la documentación de Microsoft Azure Synapse Analytics si tienes alguna pregunta específica durante el proceso.
Preguntas básicas para una entrevista de Synapse
En el nivel básico, las preguntas abarcarán tus conocimientos fundamentales sobre Synapse, incluyendo tareas como navegar por Synapse Studio, comprender sus componentes básicos y realizar exploraciones de datos sencillas. Prepárate para estas preguntas si tienes poca experiencia con Synapse o si el entrevistador está evaluando tus conocimientos básicos.
¿Cuáles son los temas clave con los que debes estar familiarizado?
Si te piden que des una visión general de alto nivel sobre Synapse, deberías ser capaz de describir Synapse Analytics y su función en un panorama de datos moderno.
¿Qué es Microsoft Synapse Analytics y cuáles son sus características principales?
Synapse Analytics es un servicio de análisis sin límites que combina el almacenamiento de datos empresariales y el análisis de macrodatos. Las características principales incluyen:
Explica la arquitectura central de Synapse Analytics.
La arquitectura central incluye:
¿Cómo se consultan los datos en Synapse Analytics?
Puedes consultar datos en Synapse utilizando:
Preguntas de entrevista sobre sinapsis intermedias
Estas preguntas evalúan tu comprensión profunda de Synapse y su configuración. Deberás demostrar tu capacidad para gestionar recursos, implementar flujos de trabajo de procesamiento de datos y optimizar el rendimiento.
Esto se basa en tus conocimientos básicos y requiere comprender:
¿Cómo se crean y gestionan los grupos SQL en Synapse Analytics?
Para crear un grupo SQL, accede a Synapse Studio, selecciona el centro «Administrar» y, a continuación, «Grupos SQL». A continuación, puedes configurar el nivel de rendimiento del grupo (unidades de almacén de datos, DWU) en función de los requisitos de tu carga de trabajo.
La gestión implica supervisar el rendimiento, escalar los recursos y pausar/reanudar el grupo según sea necesario.
Explica cómo se utiliza Spark en Synapse Analytics.
Synapse utiliza Spark Pools para proporcionar Apache Spark como servicio. Esto te permite:
¿Qué son las canalizaciones de datos y cómo se crean en Synapse?
Las canalizaciones de datos son flujos de trabajo automatizados para la ingesta, transformación y carga de datos. En Synapse, tú los creas utilizando el centro «Integrate», que proporciona una interfaz visual (Azure Data Factory) para diseñar y administrar canalizaciones.
Estas canalizaciones pueden conectarse a diversas fuentes de datos, realizar transformaciones mediante actividades como el flujo de datos o la ejecución de procedimientos almacenados, y cargar datos en los sistemas de destino.
¿Cómo supervisas y gestionas los recursos en Synapse Analytics?
Puedes supervisar los recursos a través del centro «Monitor» en Synapse Studio. Este centro proporciona información sobre el rendimiento de SQL Pool y Spark Pool, las ejecuciones de canalizaciones y el estado general del sistema. También puedes utilizar Azure Monitor para obtener funciones de supervisión y alertas más detalladas.
Describe las opciones de almacenamiento de datos disponibles en Synapse Analytics.
Synapse Analytics ofrece una variedad de opciones de almacenamiento de datos que se adaptan a diferentes necesidades y situaciones, lo que garantiza flexibilidad y eficiencia en el manejo de diversos conjuntos de datos. Estas opciones incluyen:
Preguntas avanzadas para entrevistas sobre Synapse
Se espera que los usuarios avanzados se encarguen de la optimización del rendimiento, creen flujos de trabajo complejos e implementen modelos sofisticados de análisis y machine learning. Estas preguntas son típicas para puestos de alto nivel relacionados con los datos o funciones con un componente de DevOps.
Esto se basa en conocimientos básicos e intermedios, y requiere experiencia práctica en:
¿Qué estrategias utilizas para optimizar el rendimiento en Synapse?
Indexación adecuada: Optimiza el rendimiento del grupo SQL mediante índices de almacenamiento en columnas agrupados e índices no agrupados adecuados.
¿Cómo puedes implementar canalizaciones CI/CD para Synapse Analytics?
Utiliza Azure DevOps o GitHub Actions para automatizar la compilación, las pruebas y la implementación de soluciones Synapse. Esto incluye:
¿Cómo se gestionan los análisis complejos en Synapse Analytics?
Para gestionar análisis complejos y garantizar operaciones de datos fluidas dentro de Synapse Analytics, es necesario adoptar un enfoque multifacético. Esto implica pruebas automatizadas, estrategias de implementación y técnicas analíticas avanzadas.
A continuación, encontrarás métodos esenciales para alcanzar estos objetivos de manera eficaz:
¿Cómo se implementan los modelos de machine learning en Synapse Analytics?
La implementación de modelos de machine learning en Synapse Analytics implica varios pasos clave, desde el entrenamiento y el registro de los modelos hasta su implementación para su uso práctico. A continuación, se presenta un enfoque estructurado para implementar con éxito modelos de machine learning:
Preguntas de la entrevista de Synapse para puestos de ingeniero de datos
Los ingenieros de datos son responsables de diseñar, crear y mantener canales de datos, garantizar la calidad de los datos y optimizar el rendimiento. Para los puestos de ingeniero de datos centrados en Synapse, debes comprender:
¿Cómo se diseñan los flujos de datos en Synapse Analytics?
Al diseñar canalizaciones de datos en Synapse Analytics, hay que tener en cuenta varios componentes clave para garantizar un procesamiento de datos eficiente y fiable:
¿Cuáles son las mejores prácticas para los procesos ETL en Synapse Analytics?
En el contexto de Synapse Analytics, la implementación de procesos ETL (extraer, transformar, cargar) eficaces es fundamental para garantizar una gestión y un análisis eficientes de los datos. Se recomiendan las siguientes prácticas recomendadas para optimizar los procesos ETL en Synapse Analytics:
¿Cómo gestionas el procesamiento de datos en tiempo real en Synapse?
Como ingeniero de datos, uno se enfrenta a numerosos retos que requieren soluciones innovadoras y metodologías sólidas. Trabajar y manejar datos en tiempo real es uno de ellos. A continuación, se describen algunas experiencias y técnicas que se emplean habitualmente:
¿Cómo garantizas la seguridad de los datos en Synapse Analytics?
Garantizar la seguridad de los datos en Synapse Analytics es fundamental para proteger la información confidencial y mantener el cumplimiento de las normas reglamentarias. Se pueden implementar varias estrategias clave para proteger los datos dentro del entorno Synapse:
Reflexiones finales
Esta guía te ha proporcionado información clave para afrontar con confianza tu entrevista para Microsoft Synapse Analytics, tanto si eres ingeniero de datos como ingeniero de software.
Recuerda destacar no solo tus conocimientos teóricos, sino también tu experiencia práctica en el diseño de canales de datos, la optimización del rendimiento y la garantía de una seguridad de datos sólida.
Más allá de los aspectos técnicos, destaca tus habilidades para resolver problemas y tu capacidad para aprender continuamente, ya que Synapse Analytics es una plataforma en rápida evolución. Mantén tu curiosidad, sigue explorando los recursos de Microsoft y demuestra tu pasión por aprovechar los datos para impulsar resultados empresariales impactantes. ¡Buena suerte!