Ir al contenido principal

¿Qué tan fluidas son las operaciones de tu equipo de datos? Descubre el nivel de madurez en MLOps de tu organización

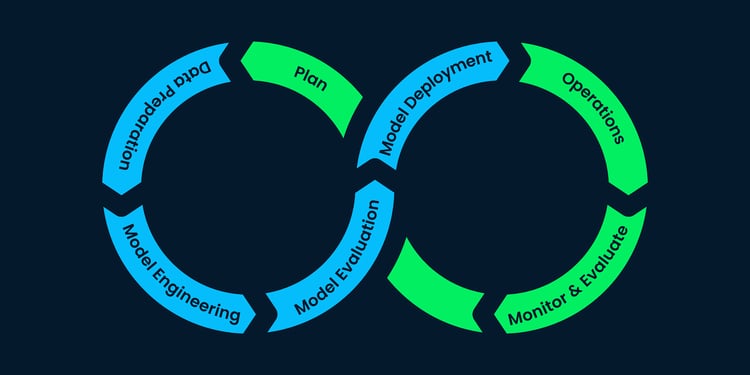
Este artículo presenta una introducción a los modelos de madurez en MLOps para que los equipos de datos los sigan y tengan en cuenta al evolucionar sus capacidades de machine learning.
Actualizado 17 sept 2026  · 12 min leer

Explorar con IA

ChatGPTClaudePerplexity

MLOps, u Operaciones de Machine Learning, es un aspecto clave del flujo de trabajo de machine learning y se está consolidando como un campo propio. Combina el aprendizaje automático con las mejores prácticas de la ingeniería de software para garantizar que los modelos pasen del experimento a producción y, al mismo tiempo, reducir la deuda técnica en los equipos de datos.

Para tener éxito con el machine learning a escala, es esencial evaluar el nivel de madurez en MLOps de tu organización. A menudo hay barreras para desplegar modelos, como la infraestructura, la cultura organizativa o la incapacidad de reentrenar el modelo cuando deriva. Esto puede traducirse en mucho menos valor del esperado (o peor aún, en posibles perjuicios para las personas que interactúan con tus modelos). Todo ello puede generar desconfianza en la capacidad del equipo de datos para aportar valor con machine learning. Para aprovechar al máximo el potencial del machine learning y la IA, se necesita un enfoque bien planteado de MLOps.

MLOps también permite a los data scientists centrarse en lo que de verdad importa: recopilar y depurar datos, desarrollar modelos y utilizar las técnicas adecuadas. Esto es así porque MLOps incrementa significativamente la automatización en todas las fases del ciclo de vida del machine learning.

Este artículo asume que ya tienes conocimientos prácticos de MLOps y comprendes su importancia; para más información sobre MLOps, echa un vistazo a nuestros artículos Getting Started with MLOps y MLOps Best Practices. 

¿Por qué hablar de niveles de madurez?

MLOps no va solo de adoptar herramientas o cambiar formas de trabajar. Implementarlo exige un enfoque holístico del uso de herramientas y tecnología para derribar silos dentro de los equipos técnicos y aumentar la automatización. Puede implicar reestructurar la organización o mover personas entre equipos, pero la solución de cada empresa será distinta y única. 

Analizar MLOps desde la óptica de la madurez, es decir, medir en qué punto está tu empresa dentro del proceso de implantación de MLOps, ayuda a situar a la organización y a definir qué puede hacer para aumentar su madurez y qué beneficios aportará ese avance. Además, la madurez en MLOps puede escalar con la organización. Las empresas pequeñas con pocos modelos no necesitan el mismo nivel de madurez que las organizaciones grandes y complejas. Sin embargo, incluso organizaciones pequeñas cuya propuesta de valor dependa del machine learning necesitarán una práctica de MLOps relativamente madura.

También conviene recordar que avanzar en el modelo de madurez no es lineal. Tu organización puede tener elementos con una madurez alta y otros con una madurez baja. En la siguiente sección, describimos el modelo de madurez en MLOps de Microsoft, que ofrece una visión holística de cómo evoluciona MLOps dentro de una organización. 

El modelo de madurez en MLOps de Microsoft

El modelo de madurez en MLOps de Microsoft define tres grandes dimensiones para evaluar la madurez en MLOps:

  • Personas: Los distintos roles dentro de un equipo de datos y cómo interactúan entre sí.
  • Ciclo de vida del machine learning: Cómo se gestiona el ciclo de vida, desde la recopilación de datos hasta la creación y liberación del modelo.
  • Aplicación: Cómo se prueban, implementan, despliegan y reentrenan los modelos de machine learning.

Además, el modelo de Microsoft define cinco etapas de madurez para una práctica de MLOps, que son:

  1. Sin MLOps: Sistemas aislados y opacos, equipos de datos en silos y entrenamiento, despliegue y pruebas manuales de los modelos.
  2. DevOps sin MLOps: El equipo de datos entrena los modelos mientras otro equipo distinto los despliega. El ciclo de feedback sobre el rendimiento del modelo es opaco y la reproducibilidad es limitada. 
  3. Entrenamiento automatizado: Los modelos son reproducibles y las liberaciones son menos manuales. El entrenamiento es automático y el uso de pipelines está extendido.
  4. Despliegue automatizado: Los despliegues están automatizados y se pueden rastrear hasta los datos originales. Se pueden hacer pruebas A/B tras el despliegue y las pruebas están automatizadas.
  5. MLOps completo: El sistema está totalmente automatizado, desde la ingesta de datos hasta el despliegue y las pruebas del modelo, con analíticas centralizadas y monitorizadas del rendimiento. Estos sistemas suelen construirse a medida.

En las secciones siguientes cubriremos cada nivel de madurez, con una tabla resumen de los puntos clave.

Sin MLOps

En esta fase hay muy poca automatización y el equipo de datos está aislado tanto del resto de la organización como internamente. La adopción de herramientas es baja y algunas funciones, como la ingeniería de datos, pueden no existir o recaer en los data scientists. Con este nivel de madurez, desplegar incluso un único modelo es difícil y requiere mucho tiempo, y reentrenar modelos implica volver a ejecutar por completo el análisis y los trabajos de entrenamiento. No hay trazabilidad del modelo tras el despliegue, por lo que puede no ser posible analizar su impacto.

Personas

Data scientists

Sin comunicación con el resto del equipo, trabajan de forma independiente.

Data engineers

Pueden no existir.

Software engineers

Reciben modelos de los data scientists y están aislados del equipo de datos.

Ciclo de vida de ML

Preparación de datos

Aunque puede haber bases de datos, los datos se recopilan manualmente para entrenar modelos. 

Entrenamiento del modelo

Los experimentos no se rastrean y no existen pipelines de datos ni de machine learning establecidos. 

Despliegue del modelo

Los modelos suelen entregarse manualmente con entradas y salidas. No hay control de versiones y el script de scoring se crea manualmente; el despliegue suele recaer en los data scientists.

Aplicación

Integración

Pruebas y liberación totalmente manuales cada vez que un modelo está listo para desplegar, con gran dependencia de los data scientists. 

DevOps sin MLOps

Con la integración de las mejores prácticas de DevOps, el equipo de datos sigue en silos, aunque puede haber data engineers dedicados. Puede que se adopten tecnologías cloud, pero sin aprovechar todo su potencial. En esta etapa, la obtención de datos de las bases y la preparación para ML se automatizan en pipelines reutilizables. También puede haber pruebas de integración al desplegar modelos. Los data scientists asumen múltiples funciones y participan de forma intensa en las pruebas tras el despliegue.

Personas

Data scientists

Sin comunicación con el resto del equipo, trabajan de forma independiente.

Data engineers

Sin comunicación con el resto del equipo, trabajan de forma independiente.

Software engineers

Reciben modelos de los data scientists y están aislados del equipo de datos.

Ciclo de vida de ML

Preparación de datos

Existen pipelines de datos automatizados y pueden ejecutarse en recursos cloud gestionados.

Entrenamiento del modelo

Los experimentos no son reproducibles y no se rastrean de forma predecible. 

Despliegue del modelo

Los modelos suelen entregarse manualmente con entradas y salidas. Hay control de versiones, pero el script de scoring sigue creándose manualmente; el despliegue suele gestionarlo el equipo de datos o de ingeniería.

Aplicación

Integración

Las liberaciones están automatizadas y hay pruebas básicas de integración, pero dependen en gran medida de la pericia de los data scientists. 

Entrenamiento automatizado

En este punto, la colaboración dentro del equipo de datos aumenta de forma notable. Los data scientists trabajan con los ingenieros para convertir su código de entrenamiento en scripts repetibles que usan pipelines de datos automatizados. Los experimentos se rastrean y el control de versiones está mucho más extendido. El despliegue es más automatizado, aunque los archivos de modelo siguen pasándose a los software engineers.

Personas

Data scientists

Los data scientists trabajan con data engineers para convertir el código de experimentos en scripts repetibles.

Data engineers

Software engineers

Reciben modelos de los data scientists y están aislados del equipo de datos.

Ciclo de vida de ML

Preparación de datos

Pipelines de datos automatizados que se ejecutan en recursos cloud gestionados.

Entrenamiento del modelo

Los experimentos se rastrean y el código de entrenamiento y los modelos tienen control de versiones.

Despliegue del modelo

Los modelos aún se despliegan manualmente; sin embargo, el script de scoring tiene control de versiones y ahora la liberación la gestiona el equipo de software engineering. 

Aplicación

Integración

Las liberaciones están automatizadas y hay pruebas básicas de integración, pero dependen en gran medida de la pericia de los data scientists. 

Despliegue automatizado de modelos

Los software engineers ahora colaboran mucho más estrechamente con los data engineers para desplegar los modelos, así como sus pipelines de entrenamiento y de recopilación de datos. Los experimentos se rastrean completamente y hay pruebas unitarias e integraciones automatizadas para cada liberación del modelo y para la propia aplicación. También puede haber CI/CD en algunas áreas.

Personas

Data scientists

Los data scientists trabajan con data engineers para convertir el código de experimentos en scripts repetibles.

Data engineers

Software engineers

Trabajan con data engineers para automatizar la integración de modelos en las aplicaciones. 

Ciclo de vida de ML

Preparación de datos

Pipelines de datos automatizados que se ejecutan en recursos cloud gestionados.

Entrenamiento del modelo

Los experimentos se rastrean y el código de entrenamiento y los modelos tienen control de versiones.

Despliegue del modelo

Los modelos se despliegan automáticamente, el script de scoring tiene control de versiones y la liberación ahora la gestiona un pipeline de entrega continua (CI/CD).

Aplicación

Integración

La integración en el código de la aplicación depende menos de los data scientists y existen pruebas unitarias e integraciones para cada liberación del modelo.

MLOps completo con reentrenamiento automatizado

En la fase final de madurez, data engineers, data scientists y software engineers trabajan codo con codo para lograr la máxima automatización posible en el desarrollo y el despliegue. Además, los experimentos, el entrenamiento y el reentrenamiento de modelos se automatizan en función de métricas de producción; los modelos se liberan automáticamente y los gestiona un pipeline de CI/CD, y se prueban dentro del código de la aplicación. 

Personas

Data scientists

Los data scientists trabajan con data engineers para convertir los experimentos en scripts repetibles y con software engineers para automatizar procesos.


Data engineers y software engineers colaboran para automatizar la integración de modelos en la aplicación y recopilar métricas de rendimiento tras el despliegue. 

Data engineers

Software engineers

Ciclo de vida de ML

Preparación de datos

Pipelines de datos automatizados que se ejecutan en recursos cloud gestionados.

Entrenamiento del modelo

Los experimentos se rastrean y el código de entrenamiento y los modelos tienen control de versiones; los modelos se reentrenan automáticamente tras el despliegue en función de métricas de rendimiento. 

Despliegue del modelo

Los modelos se despliegan automáticamente, el script de scoring tiene control de versiones y la liberación ahora la gestiona un pipeline de entrega continua (CI/CD).

Aplicación

Integración

La integración en el código de la aplicación depende menos de los data scientists y existen pruebas unitarias e integraciones para cada liberación del modelo.

Diferencias entre los modelos de MLOps más populares

Una diferencia notable entre este modelo de madurez en MLOps y el de Google es la implementación de los conceptos de CI/CD. Google sugiere que suelen situarse en el nivel final de madurez, mientras que Microsoft considera que el reentrenamiento es la etapa final.

En la práctica, el reentrenamiento es uno de los principales motivos para adoptar MLOps y puede integrarse antes de la fase final. Sin embargo, el reentrenamiento del modelo tiene prerrequisitos, como una fuerte automatización e infraestructura, así como pipelines de datos y de entrenamiento de alta calidad. Los conceptos de CI/CD seguirán perfeccionándose hasta las etapas más avanzadas de madurez en MLOps. 

Organizaciones muy maduras como Google y Microsoft suelen contar con software a medida que se ejecuta en sus propias soluciones de computación en la nube y aprovecha herramientas específicas al máximo. Los software engineers suelen decir que en estas empresas la tecnología "simplemente funciona", con despliegues de modelos sin fricciones y acceso eficiente a los datos. Esto es necesario porque tienen cientos de modelos en producción para su amplia gama de productos.

Cómo aumentar tu madurez en MLOps

MLOps sigue siendo una de las áreas más críticas de la ciencia de datos, ya que muchas organizaciones aún tienen dificultades para llevar modelos a producción. Los modelos de madurez en MLOps ofrecen un excelente marco para entender en qué punto se encuentran hoy los equipos de datos en sus capacidades de machine learning y cómo pueden evolucionar de aquí en adelante. 

Si quieres aprender más sobre MLOps, echa un vistazo a estos recursos:


Temas
Aprendizaje automático
Ciencia de datos

Cursos de machine learning

Curso

Aprendizaje supervisado con scikit-learn

4 h
303.3K
Mejora tu machine learning con scikit-learn en Python. Haz predicciones potentes con conjuntos de datos reales en este curso interactivo.
Ver detallesRight Arrow
Iniciar Curso
Ver másRight Arrow
Relacionado
Top MLOps Tools

blog

25 Herramientas MLOps que debes conocer en 2025

Descubre las mejores herramientas MLOps para el seguimiento de experimentos, la gestión de metadatos de modelos, la orquestación de flujos de trabajo, el versionado de datos y canalizaciones, el despliegue y servicio de modelos, y la supervisión de modelos en producción.
Abid Ali Awan's photo

Abid Ali Awan

15 min

MachineLearningLifecycle

blog

Explicación del ciclo de vida del machine learning

Conoce los pasos de un proyecto estándar de machine learning mientras exploramos los entresijos del ciclo de vida del machine learning utilizando CRISP-ML(Q).
Abid Ali Awan's photo

Abid Ali Awan

10 min

blog

8 modelos de machine learning explicados en 20 minutos

Descubre todo lo que necesitas saber sobre los tipos de modelos de machine learning, incluyendo para qué se utilizan y ejemplos de cómo ponerlos en práctica.
Natassha Selvaraj's photo

Natassha Selvaraj

15 min

Machine Learning Concept

blog

¿Qué es el machine learning? Definición, tipos, herramientas y más

Descubre todo lo que necesitas saber sobre el machine learning en 2023, incluidos sus tipos, usos, carreras profesionales y cómo iniciarte en el sector.
Matt Crabtree's photo

Matt Crabtree

14 min

blog

Los 15 mejores libros sobre machine learning para leer en 2026

Machine learning es uno de los temas más candentes en la ciencia de datos. Aquí tienes una lista de 15 libros para iniciarte en este campo o convertirte en un experto.
Javier Canales Luna's photo

Javier Canales Luna

8 min

Tutorial

Una introducción a los valores SHAP y a la interpretabilidad del machine learning

Los modelos de machine learning son potentes, pero difíciles de interpretar. Sin embargo, los valores SHAP pueden ayudarte a comprender cómo influyen las características del modelo en las predicciones.
Abid Ali Awan's photo

Abid Ali Awan

9 min

Ver MásVer Más