Ir al contenido principal

Primeros pasos con MLOps

Descubre el auge de MLOps y cómo empezar con un conjunto completo de recursos
Actualizado 17 sept 2026  · 14 min leer

Explorar con IA

ChatGPTClaudePerplexity

Hoy en día, demasiados modelos de machine learning no llegan a producción y se quedan en los laboratorios de datos. Como en cualquier campo emergente, aún no han madurado ni se han estandarizado las mejores prácticas, herramientas, técnicas y funciones que deben adoptar los equipos de datos modernos. Esto supone un problema tanto para las empresas que quieren extraer valor del machine learning a escala como para los data scientists que desean ir más allá de experimentar en un notebook. MLOps (Machine Learning Operations) ha surgido en los últimos años con el objetivo de resolver los retos de despliegue a los que se enfrentan los equipos de datos. 

La pista está en el nombre: del mismo modo que DevOps dio forma al desarrollo ágil y rápido de aplicaciones en torno a las necesidades del negocio, MLOps busca lo mismo, cerrando la brecha entre la complejidad y el despliegue de modelos de machine learning.

¿Cómo aborda exactamente MLOps estos retos? En este artículo, queremos desmitificar algunos conceptos de MLOps como disciplina emergente y responder a preguntas clave como

  1. ¿Qué es MLOps y cuáles son los componentes clave de una práctica de MLOps eficaz?
  2. ¿En qué se diferencia MLOps de DevOps?
  3. ¿Cómo reimagina MLOps el flujo de trabajo de machine learning?
  4. ¿Cómo puedes empezar hoy mismo con MLOps?

¿Qué es MLOps?

Alessya Visnjic, CEO de WhyLabs, una startup de MLOps centrada en la monitorización de modelos, describió con acierto MLOps como “un conjunto de herramientas, prácticas, técnicas, cultura y mentalidad que garantizan el despliegue fiable y escalable de sistemas de machine learning”

Poniendo esta definición en contexto, MLOps se apoya en la disciplina existente de DevOps, la práctica moderna de escribir, desplegar y ejecutar aplicaciones empresariales de forma eficiente. Es un proceso transversal, colaborativo e iterativo que operacionaliza la ciencia de datos. MLOps trata el machine learning como una disciplina de ingeniería, en la que los modelos se consideran artefactos de software reutilizables que pueden desplegarse mediante un proceso repetible. 

MLOps también implica la monitorización continua y el reentrenamiento de los modelos en producción para asegurar que rinden de forma óptima a medida que los datos cambian con el tiempo, un fenómeno conocido como deriva de datos

En pocas palabras, MLOps permite a los equipos de datos escalar el valor que aportan al posibilitar: 

  • Desplegar más modelos, más rápido, mediante procesos automatizados
  • Optimizar la productividad gracias a la colaboración y la reutilización de modelos
  • Reducir el riesgo y el coste de los modelos que nunca llegan a producción
  • Monitorizar y actualizar continuamente los modelos cuando se produce deriva de datos

Retomando la definición de Visnjic, lo anterior exige tanto innovación en herramientas para los equipos de datos modernos como un cambio de mentalidad para muchos data scientists.

¿Por qué es importante MLOps?

Ya hemos visto cómo MLOps busca resolver los retos de despliegue de muchos equipos de datos. Pero, ¿qué hace que el machine learning sea tan particular como para requerir nuevas funciones operativas especializadas como MLOps?  

Las aplicaciones de machine learning son fundamentalmente distintas del software tradicional. Estos son algunos de los retos más importantes a los que se enfrentan las organizaciones al llevar sistemas de machine learning a producción. 

  • Propiedad y colaboración: Tradicionalmente, los data scientists crean y desarrollan modelos de machine learning, y los equipos de TI se encargan de desplegarlos y gestionarlos. Sin embargo, la colaboración entre estos dos equipos no es todo lo eficiente que podría ser y suele generar fricciones. Por ejemplo, los equipos de data science reciben cada vez más peticiones desde distintas áreas del negocio para resolver un número creciente de problemas. Dada la complejidad de los sistemas de TI modernos, los data scientists prestan poca atención al entorno de producción y a los sistemas de TI existentes—porque esa es responsabilidad del equipo de TI. Del mismo modo, los equipos de TI suelen no centrarse en el funcionamiento interno de las soluciones que producen los data scientists—lo que genera expectativas poco realistas sobre la desplegabilidad de muchos modelos. Esta dinámica genera fricción y anti‑patrones que hay que evitar a toda costa—cuando los equipos de datos se conforman con el razonamiento de "construyamos un modelo, se lo mandamos a TI y ellos se encargan".
  • Los datos definen el software impulsado por machine learning: Los datos son el alma de los sistemas de machine learning. A diferencia del software tradicional, donde los ingenieros diseñan un proceso bien definido que toma unas entradas y produce unas salidas, los sistemas de machine learning se apoyan en métodos estadísticos que usan datos del mundo real, desordenados, como entrada para entregar predicciones como salida. Esto implica que el comportamiento de los sistemas de machine learning cambia cuando cambian los datos. Además, evaluar el rendimiento de los modelos de machine learning requiere observación y análisis. Por último, el flujo de trabajo de machine learning es enrevesado, experimental por naturaleza y demanda un conjunto de habilidades distinto al de la ingeniería de software tradicional.
  • Complejidad del despliegue: Los sistemas de modelos de machine learning son cada vez más complejos. A diferencia del software tradicional, desplegar modelos de machine learning implica orquestar una variedad de pasos interconectados y herramientas dispares. Incluye recopilación, almacenamiento y transformación de datos, ingeniería de características y más. Además, la reproducibilidad y el control de versiones suponen grandes retos para los equipos de datos. Dado el carácter experimental del machine learning, los equipos de data science construyen muchas versiones de un modelo usando diferentes versiones del mismo conjunto de datos. Por tanto, el control de versiones tradicional debe ser más robusto. 

MLOps vs. DevOps—¿en qué se diferencian?

En la sección anterior explicamos por qué el machine learning necesita una función operativa especializada. Ahora bien, ¿en qué se diferencia MLOps de DevOps en la práctica? 

DevOps es la contracción de Development (Dev) y Operations (Ops). Aúna dos funciones esenciales del departamento de TI: el desarrollo de aplicaciones y la ingeniería de sistemas. DevOps intenta acortar los ciclos de desarrollo y acelerar el ritmo de entrega de los equipos de ingeniería de software. Lo consigue introduciendo automatización, procesos actualizados y nuevas formas de trabajo para los equipos de desarrollo. En términos generales, DevOps incorpora dos principios al proceso de desarrollo de software:

  • Integración continua (CI)—el proceso de realizar iteraciones frecuentes y pequeñas en los repositorios de control de versiones. Esto reduce los problemas de despliegue porque el código llega a producción con frecuencia.
  • Entrega continua (CD)—el proceso de automatizar los pasos necesarios para llevar aplicaciones y software a los entornos de producción.

Dada la naturaleza particular del machine learning, estas son algunas formas prácticas en que MLOps difiere de DevOps: 

  • Integración continua se amplía más allá de probar y validar código para incluir la prueba y validación de modelos y datos
  • Entrega continua se extiende desde automatizar pasos para llevar aplicaciones a producción hasta entregar automáticamente pipelines de datos que desencadenan una predicción de machine learning
  • Entrenamiento continuo se introduce—algo propio del machine learning—para reentrenar automáticamente los modelos antes del despliegue
  • Monitorización continua se introduce—para vigilar rupturas de calidad en los datos de producción, el rendimiento del modelo y las métricas de negocio ligadas al modelo de machine learning

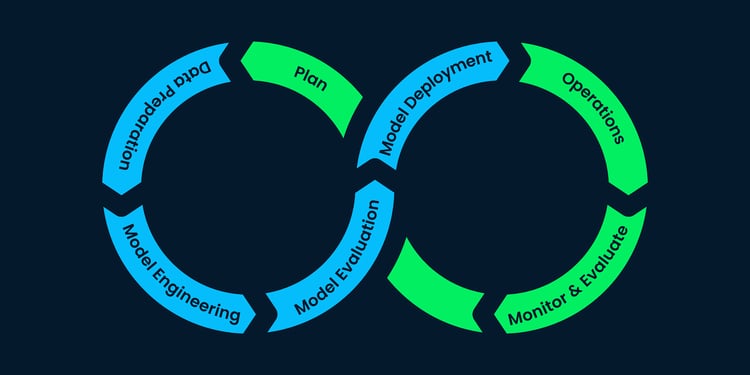
El flujo de trabajo de MLOps

Reimaginar el flujo de trabajo de data science para MLOps

Dada la complejidad adicional de llevar modelos de machine learning a producción, ¿cómo pueden los equipos de datos empezar a adoptar MLOps en sus flujos de trabajo de data science? En esta sección, presentamos un enfoque simplificado paso a paso dentro de un proceso de MLOps:   

  • Construcción: una vez creados, los modelos suelen almacenarse en un repositorio auditable bajo control de versiones para facilitar su reutilización en toda la organización.
  • Evaluación: en esta fase se cuantifica la calidad de las predicciones del modelo midiendo el rendimiento del nuevo modelo entrenado sobre un conjunto de datos nuevo e independiente.
  • Puesta en producción: exporta, despliega e integra el modelo o el pipeline en los sistemas y aplicaciones de producción.
  • Pruebas: las pruebas continuas son clave en aplicaciones basadas en ML y se centran en el reentrenamiento y el servicio automatizados de los modelos.
  • Despliegue: se requiere monitorización continua para garantizar un rendimiento óptimo. El modelo puede reentrenarse o sustituirse por uno nuevo cuando cambian los datos.
  • Monitorización y observabilidad: muchas empresas se encuentran con dificultades a la hora de llevar modelos de machine learning a entornos de producción.

Reimaginar los roles de datos para MLOps

En equipos pequeños de data science, una misma persona puede asumir varios roles. En equipos más grandes y con más procesos, encontrarás una variedad de perfiles y competencias que se responsabilizan de distintas partes del flujo de trabajo de MLOps. Estos roles suelen ser:

  • Data scientist: a menudo es la figura central de cualquier equipo de MLOps. Es la persona experta que utiliza los datos de la empresa para generar valor. Su función es entender, estructurar e interpretar los datos para extraer insights en forma de modelos predictivos. Crea, prueba y evalúa modelos de machine learning. En algunas empresas, también despliega y monitoriza el rendimiento de los modelos una vez en producción.
  • Data engineer: es quien crea y mantiene el entorno que permite trabajar al resto del equipo de datos. Se encarga de desarrollar, construir, mantener y probar arquitecturas, como bases de datos y sistemas de procesamiento. En pocas palabras, facilita el flujo de datos desde la extracción, pasando por la transformación, hasta la entrega.
  • Software engineer: en un proceso de MLOps, integra los modelos de machine learning en las aplicaciones y sistemas de la empresa. También se asegura de que los modelos funcionen sin fricciones con las aplicaciones no basadas en machine learning existentes.  
  • Machine learning engineer: se sitúa en la intersección entre data science e ingeniería de datos. Su función es optimizar y poner en producción los modelos desarrollados por el data scientist dentro de la infraestructura preparada por el data engineer.

Cómo empezar con MLOps

Como hemos comentado a lo largo del artículo, MLOps es un campo aún incipiente, con muchas herramientas, buenas prácticas y metodologías en plena evolución. En esta sección verás distintas formas de empezar con MLOps, herramientas con las que puedes experimentar y recursos de aprendizaje que puedes aprovechar desde hoy. 

Herramientas a considerar para MLOps

  • Kubeflow: Kubeflow es un conjunto de herramientas para ejecutar flujos de trabajo de machine learning en clústeres de Kubernetes. Su objetivo es permitir que las mejores soluciones open source de machine learning se ejecuten en un clúster de Kubernetes de forma sencilla, portable y escalable. Originalmente, Kubeflow era la implementación open source de TensorFlow Extended (TFX), una plataforma de extremo a extremo para desplegar pipelines de machine learning en producción. Así, Kubeflow permitió simplificar la ejecución de trabajos de TensorFlow en KubernetesMLFlow: MLflow es una herramienta para industrializar el proceso de desarrollo end‑to‑end de proyectos de machine learning. Su objetivo es simplificar el desarrollo de proyectos de machine learning en las empresas facilitando la monitorización, la reproducción, la gestión y el despliegue de modelos.

  • Data Version Control (DVC): DVC (Data Version Control) es un paquete de Python que facilita la gestión de tus proyectos de ciencia de datos. Esta herramienta es una extensión de Git para machine learning, como señaló su principal contribuidor Dmitry Petrov en esta presentación. DVC es a la vez comparable y complementario a Git.

  • Pachyderm: Pachyderm es una herramienta de control de versiones para machine learning y data science similar a DVC. Además, se basa en Docker y Kubernetes, lo que ayuda a ejecutar y desplegar proyectos de machine learning en cualquier plataforma cloud. También garantiza que todos los datos ingeridos en un modelo de machine learning estén versionados y sean trazables.

Recursos de aprendizaje para MLOps

Fundamentos de machine learning

  • Machine Learning For Absolute Beginners: A Plain English Introduction (Second Edition), de Oliver Theobald. Como indica el título, este libro ofrece a principiantes una introducción completa al machine learning. Y cuando hablamos de principiantes, hablamos de verdaderos novatos: no necesitas conocimientos básicos de matemáticas ni experiencia en programación. Es una introducción básica al machine learning para cualquier persona interesada en el tema. El lenguaje es sencillo para no abrumar con jerga incomprensible. Los distintos algoritmos van acompañados de explicaciones claras y fáciles de seguir, junto con ejemplos visuales. También presenta nociones simples de programación para contextualizar mejor el machine learning.
  • Machine Learning For Dummies, de John Paul Mueller y Luca Massaron. Para novatos, la serie "for dummies" también es un buen punto de partida. Este libro introduce los conceptos y teorías básicas del machine learning y explica cómo aplicarlas al mundo real. Presenta los lenguajes y herramientas esenciales, y muestra cómo convertir un concepto relativamente esotérico en una herramienta práctica. Trata los lenguajes Python y R, usados para enseñar a las máquinas a detectar patrones y analizar resultados. 
  • Fundamentals of Machine Learning for Predictive Data Analytics: Algorithms, Worked Examples, and Case Studies, de John D. Kelleher, Brian Mac Namee y Aoife D'Arcy. Este libro cubre todas las nociones fundamentales de machine learning, presentando tanto el aspecto teórico como las aplicaciones prácticas. Ofrece ejemplos concretos y casos de uso para facilitar el aprendizaje. Se recomienda tener conocimientos básicos de analítica para sacar más partido a estas nociones. Presenta los diferentes enfoques del machine learning e ilustra cada concepto con algoritmos y modelos, además de ejemplos prácticos para ponerlos en marcha.
  • Machine Learning for Hackers, de Drew Conway y John Myles White. El término "hackers" aquí se refiere a programadores que crean código con fines concretos y proyectos prácticos. Este libro está pensado para lectores sin base matemática, pero que saben programar y usar lenguajes de programación. Aunque el machine learning se apoya en conceptos matemáticos, muchos programadores experimentados no tienen una base matemática muy desarrollada. En lugar de centrarse en la teoría, este libro presenta aplicaciones reales basadas en estudios prácticos. Aborda problemas clásicos de machine learning y explica cómo resolverlos usando el lenguaje R. Desde comparar senadores por los votos recibidos, crear un sistema de recomendaciones de a quién seguir en Twitter, o detectar spam por su contenido, las posibilidades del machine learning son enormes.
  • Los itinerarios de DataCamp para Machine Learning Scientist con Python o con R. Tanto si usas R como Python, estos dos itinerarios cubren a fondo el machine learning: desde los fundamentos hasta temas avanzados como deep learning e ingeniería de características. 

Fundamentos de ingeniería de datos

  • Data Engineering Cookbook, de Andreas Kretz. Hay mucha confusión sobre cómo convertirse en data engineer. Este eBook de Andreas Kretz incluye casos prácticos detallados, código, pódcasts, entrevistas y más. Es un paquete muy completo para cualquiera que quiera convertirse en data engineer. ¿Y lo mejor? ¡Este ebook es gratuito! Sí, puedes empezar a usarlo al instante.
  • DW 2.0 - The Architecture for the Next Generation of Data Warehousing, del padre del data warehousing, W. H. Inmon. Este libro describe el futuro del data warehousing que ya es tecnológicamente posible hoy, tanto a nivel arquitectónico como tecnológico. Está cuidadosamente estructurado y cubre la mayoría de los temas relacionados con la arquitectura de datos y sus retos. Explica cómo aprovechar el sistema existente y construir un data warehouse a su alrededor, y las mejores prácticas para justificar la inversión de forma muy práctica.
  • Agile data warehouse design: collaborative dimensional modeling, from blackboard to star schema, de Laurent Corr. Un gran libro. Lawrence Corr ofrece una guía paso a paso para capturar requisitos de business intelligence y data warehousing y convertirlos en modelos de alto rendimiento mediante una técnica llamada model storming. Además, presenta el concepto BEAM, un enfoque ágil de modelado dimensional para mejorar la comunicación entre quienes diseñan el data warehouse y los interlocutores de negocio.
  • DataCamp’s Data Engineering with Python Career Track. Este itinerario incluye decenas de cursos que cubren a fondo cómo construir arquitecturas de datos eficaces, agilizar la ingesta de datos, crear pipelines y mucho más. 

Adéntrate en MLOps

  • MLOps Fundamentals Skill Track. Este itinerario de habilidades cubre el ciclo de vida completo de una aplicación de machine learning, desde la recopilación de requisitos de negocio hasta las fases de diseño, desarrollo, despliegue, operación y mantenimiento.
  • MLOps: Operationalizing Data Science, de David Sweenor, Dev Kannabiran, Thomas Hill, Steven Hillion, Dan Rope y Michael O'Connell. Seis expertos en analítica de datos proponen un enfoque en cuatro pasos para crear aplicaciones basadas en machine learning que lleguen a producción. 
  • Building Machine Learning Powered Applications, de Emmanuel Ameisen. En este libro, Emmanuel Ameisen te enseña a construir una aplicación impulsada por machine learning desde la idea inicial hasta el producto desplegado.
  • Building Machine Learning Pipelines, de Hannes Hapke y Catherine Nelson. A lo largo del libro, los autores muestran los pasos para automatizar un pipeline de machine learning usando el ecosistema de TensorFlow. 
  • Practical MLOps, de Noah Gift y Alfredo Deza. Destacando la diferencia entre DevOps y MLOps, este libro te ayuda a entender de qué va MLOps y cómo garantiza la puesta en operación de tus modelos. Presenta herramientas y métodos para implementar proyectos de MLOps en AWS, Microsoft Azure y Google Cloud. Además, no te pierdas la formación en directo de Noah sobre Practical MLOps en DataCamp.
  • Introducing MLOps, de Mark Treveil y el equipo de Dataiku. Los autores facilitan una comprensión profunda de los conceptos clave de MLOps para que los equipos de data science puedan operacionalizar modelos de machine learning, impulsar el cambio en el negocio y mejorar los modelos con el tiempo. 
  • Google Cloud ofrece artículos, blogs y documentos que te guían por las mejores prácticas y procesos para construir modelos de machine learning eficientes. En el artículo seleccionado, aprenderás procesos de MLOps y cómo pasar de procesos manuales a automatizados.
  • Nvidia publica en su blog artículos que explican el ciclo de vida de MLOps y muestran casos de éxito en el campo.
  • Ml-ops.org fue creado por la Dra. Larysa Visengeriyeva, Anja Kammer, Isabel Bär, Alexander Kniesz y Michael Plöd. Este sitio web reúne información esencial sobre MLOps y detalla cada paso del proceso de extremo a extremo. 

Esperamos que este conjunto de recursos te ayude a iniciar tu camino de aprendizaje en MLOps. Si quieres más artículos y recursos sobre MLOps, echa un vistazo a los siguientes:
Itinerario de habilidades en MLOps Fundamentals

Fundamentos de MLOps

IntermediateSkill Level
14 h
Sumérgete en los fundamentos de las Operaciones de Machine Learning (MLOps), aprendiendo los conceptos de producción y supervisión de los modelos de machine learning.
See DetailsRight Arrow
Start Track
Temas
Aprendizaje automático
Relacionado
Top MLOps Tools

blog

25 Herramientas MLOps que debes conocer en 2025

Descubre las mejores herramientas MLOps para el seguimiento de experimentos, la gestión de metadatos de modelos, la orquestación de flujos de trabajo, el versionado de datos y canalizaciones, el despliegue y servicio de modelos, y la supervisión de modelos en producción.
Abid Ali Awan's photo

Abid Ali Awan

15 min

MachineLearningLifecycle

blog

Explicación del ciclo de vida del machine learning

Conoce los pasos de un proyecto estándar de machine learning mientras exploramos los entresijos del ciclo de vida del machine learning utilizando CRISP-ML(Q).
Abid Ali Awan's photo

Abid Ali Awan

10 min

blog

8 modelos de machine learning explicados en 20 minutos

Descubre todo lo que necesitas saber sobre los tipos de modelos de machine learning, incluyendo para qué se utilizan y ejemplos de cómo ponerlos en práctica.
Natassha Selvaraj's photo

Natassha Selvaraj

15 min

Machine Learning Concept

blog

¿Qué es el machine learning? Definición, tipos, herramientas y más

Descubre todo lo que necesitas saber sobre el machine learning en 2023, incluidos sus tipos, usos, carreras profesionales y cómo iniciarte en el sector.
Matt Crabtree's photo

Matt Crabtree

14 min

blog

Machine learning supervisado

Descubre qué es el machine learning supervisado, en qué se diferencia del machine learning no supervisado y cómo funcionan algunos algoritmos esenciales del machine learning supervisado
Moez Ali's photo

Moez Ali

8 min

Machine Learning

blog

33 proyectos de machine learning para todos los niveles en 2026

Proyectos de machine learning para principiantes, estudiantes de último año y profesionales. La lista incluye proyectos guiados, tutoriales y código fuente de ejemplo.
Abid Ali Awan's photo

Abid Ali Awan

15 min

Ver MásVer Más