Muchos proyectos de machine learning fracasan
Muchas organizaciones están invirtiendo con fuerza en IA y machine learning. Aun así, eso no significa que estén capturando el valor del machine learning dentro de la empresa. Según VentureBeat, el 87% de los proyectos de data science no llegan a producción. En su keynote en Transform 2019 de VentureBeat, Deborah Leff, CTO de Data Science and AI en IBM, y Chris Chap, vicepresidente sénior de datos y analítica en Gap, sostienen que a muchos equipos les faltan el liderazgo y el apoyo adecuados para crear las condiciones que llevan al éxito.
Leff y Chap señalan la calidad de los datos, la democratización de los datos y los flujos organizativos como obstáculos clave para los que muchas empresas no cuentan con las herramientas o la estructura adecuadas. Los equipos de datos que no pueden acceder a datos de alta calidad y relevantes o que no trabajan en un entorno colaborativo adecuado no pueden sacar adelante estos proyectos, por muy competentes que sean. También describen el problema del deterioro de modelos: hay organizaciones que implementan modelos que dejan de funcionar y nadie se da cuenta durante más de tres años. Esto se evidenció con la llegada del Covid-19, cuando los confinamientos cambiaron por completo el comportamiento de los consumidores y muchos modelos de analítica retail fallaron en producción.
Otro aspecto clave en proyectos de ML es el auge del uso de tecnologías open source para probar y poner modelos en producción. Incluyen lenguajes de programación como Python y su ecosistema de librerías como scikit-learn, pandas, PySpark y más. Cambiar la versión de cualquiera de estos componentes en el entorno de producción puede afectar de forma crítica al éxito del proyecto o incluso hacer que deje de funcionar. Gestionar estas versiones y frameworks open source exige un sistema organizado para ser eficaz a escala.
La necesidad de MLOps
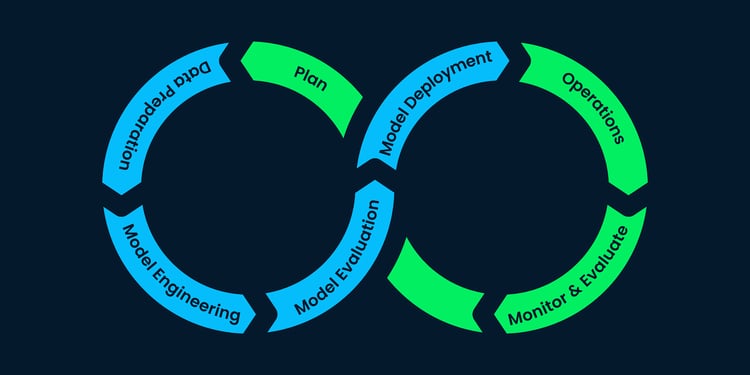
La gestión de la operacionalización de modelos de machine learning (MLOps) estandariza y agiliza la gestión del ciclo de vida de un proyecto de machine learning. En su libro, Dataiku destaca tres factores clave por los que MLOps es cada vez más importante para las empresas: existen muchas dependencias, falta competencia en datos y un lenguaje común en torno a los datos, y a los data scientists les faltan habilidades de ingeniería.
Muchas dependencias: Los datos reflejan comportamientos y procesos del mundo real y, de forma natural, cambian con el tiempo (por ejemplo, los hábitos de compra de papel higiénico durante el Covid-19). A medida que los datos cambian —algo constante—, los modelos en producción deben adaptarse continuamente para que la organización siga resolviendo el problema original para el que se diseñaron.
Sin un lenguaje común de datos: En el ciclo de vida del machine learning participan personas de equipos muy diversos y con trayectorias distintas: data scientists, data engineers y también expertos de negocio. Estos grupos no comparten las mismas habilidades ni la misma fluidez para hablar de datos, y su alineación es crucial para desplegar modelos en producción y evaluar su éxito.
Los data scientists no tienen habilidades de ingeniería: Suelen especializarse en construir y evaluar modelos, no en desarrollar aplicaciones listas para desplegar. A medida que las organizaciones dependen de más modelos y más complejos, los data scientists se enfrentan a un dilema entre desarrollar e iterar modelos y mantenerlos en producción.
Por qué MLOps es útil
Los modelos de machine learning están cada vez más integrados en los procesos de negocio. Este aumento de volumen hace necesario usar MLOps para mitigar riesgos, desplegar modelos con responsabilidad y operarlos a escala.
Desplegar un modelo implica varios riesgos:
-
El modelo puede no estar disponible durante un tiempo. La tecnología puede fallar en producción. Si una organización depende de estos modelos, puede afrontar grandes problemas cuando la tecnología no está disponible.
-
El modelo puede dar malos resultados para un colectivo. Puede rendir muy bien en la mayoría de grupos, pero ofrecer resultados pobres para uno. Hay que corregirlo o entenderlo para evitar decisiones de negocio erróneas basadas en las salidas del modelo para el grupo con bajo rendimiento. Este rendimiento desigual también puede derivar en problemas éticos si afecta a variables protegidas (raza, edad, género, etc.).
-
El modelo puede perder equidad o precisión en el futuro. A medida que el mundo cambia, los datos de entrenamiento dejan de representar la realidad que el modelo intenta comprender. Esto puede llevar a un mal rendimiento con datos futuros.
-
El talento de data science puede abandonar la organización con el tiempo. Mantener estos modelos requiere habilidades técnicas y dedicación que los data scientists no siempre pueden aportar para asegurar una fiabilidad total.
Estos riesgos escalan según el impacto del modelo en la organización y la probabilidad de que ocurran. Muchos se pueden mitigar asegurando que los datos de entrenamiento reflejan bien los datos del entorno de producción y garantizando la estabilidad del entorno de producción, ya que los modelos son muy sensibles a los cambios. MLOps es cada vez más necesario para mitigar los riesgos asociados al crecimiento del número de modelos de machine learning que se despliegan para decisiones importantes.
A medida que los modelos se usan más en la toma de decisiones, es clave garantizar que se despliegan con responsabilidad. Existen muchas causas de sesgo algorítmico que hay que evitar cuando se automatizan decisiones con sistemas de IA. No minimizar el sesgo puede acarrear sanciones por regulación gubernamental o pérdida de demanda y beneficios para la marca. Para un despliegue responsable, los modelos deben entrenarse con fuentes de datos conformes y sin sesgos, ofrecer resultados interpretables y explicables y contar con mecanismos de rendición de cuentas en toda la organización, de modo que sea fácil localizar en la cadena de desarrollo dónde pudo surgir un problema y corregirlo con eficacia. Para desplegar modelos de IA con responsabilidad, las organizaciones necesitan un ciclo de vida de ML ágil y bien orquestado.
Desplegar cada vez más modelos exige MLOps para tener éxito. Es necesario un proceso ágil para llevar el control de versiones, comparar el rendimiento de un modelo con el de sus retrainings y asegurar que el modelo mantiene un buen desempeño con el tiempo. Sin estas prácticas de MLOps, es muy difícil aportar valor e impacto de negocio con los modelos.
Los roles en un programa de MLOps
Aunque MLOps es aún incipiente y evoluciona rápido, es clave contar con buenos perfiles en estos roles: expertos de negocio, data scientists, data engineers y software/DevOps engineers.
Los expertos de negocio entienden cómo medir y evaluar de forma continua el éxito de los modelos durante el entrenamiento y tras el despliegue. Para que un programa de MLOps funcione, deben definir métricas de rendimiento de negocio fáciles de entender y un bucle de feedback que permita detectar modelos que no cumplen con las expectativas. Además, los expertos en riesgos son parte esencial del programa: su objetivo es minimizar y clarificar el riesgo que asume la empresa al desplegar modelos de ML en producción.
Recomendación de cursos: Understanding Data Topics
Los data scientists se encargan de construir los modelos que responden a las preguntas de negocio planteadas por los expertos. Estos modelos deben ser desplegables en entornos de producción con datos de producción. Los data scientists deben asegurar que los modelos se despliegan fácil y de forma segura, que cuentan con tests de aseguramiento de calidad y de posibles mejoras, y que existe una visibilidad sencilla de todos los modelos desplegados desde un único lugar.
Recomendación de cursos: Machine Learning Scientists Career Track (R/Python), Image Processing in Python, Machine Learning with PySpark
Los data engineers crean las canalizaciones de datos para estos modelos. Para que MLOps funcione, el rendimiento de todos los modelos desplegados debe ser visible con facilidad, así como el detalle de cada pipeline para localizar posibles incidencias abordables.
Por último, los software y DevOps engineers ayudan a integrar con éxito estos modelos con el resto de aplicaciones que no son de machine learning. Para una práctica de MLOps eficaz, deben aplicar buenas prácticas de ingeniería de datos para que los modelos funcionen en paralelo con las aplicaciones existentes de forma fiable, continua y fluida.
Recomendación de cursos: Data Engineer with Python Career Track
Un programa de MLOps de éxito requiere muchos roles bien coordinados. Desplegar cientos de modelos a escala exige la participación, además de los expertos en datos, de especialistas de negocio y de software para lograr resultados reales. Las organizaciones que quieran implantar programas de MLOps con éxito deben construir un lenguaje común de datos entre todos los stakeholders mediante formación continua y aprendizaje constante.
Más información sobre DataCamp for Business:
DataCamp for Business ofrece una plataforma de aprendizaje interactiva para empresas que necesitan formar y reciclar a su gente en habilidades de datos. Con temas que van desde la competencia en datos y la ciencia de datos hasta la ingeniería de datos y el machine learning, más de 1.600 empresas confían en DataCamp for Business para impulsar el desarrollo de su talento.