Curso
Comprender el machine learning
2 h
308.6K
Esta entrada presenta el concepto de "transfer learning" y cómo se usa en aplicaciones de machine learning. El transfer learning no es un modelo ni una técnica; es más bien una "metodología de diseño" dentro del machine learning. Otro ejemplo de "metodología de diseño" es el active learning.
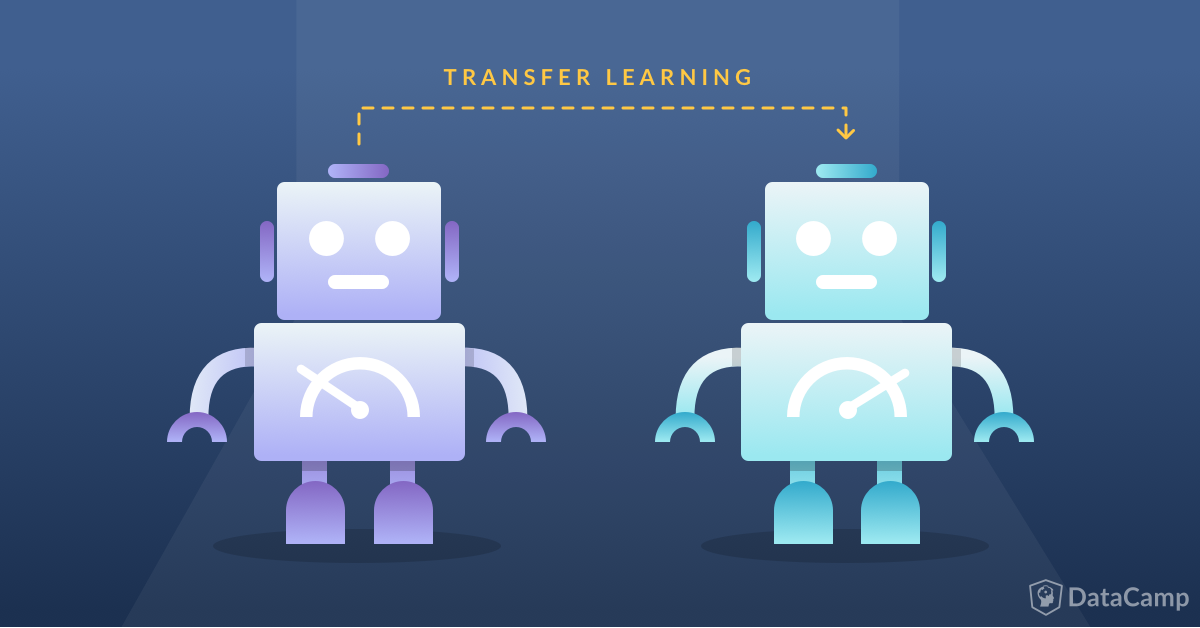
En una próxima entrada del blog explicaremos cómo combinar el active learning con el transfer learning para exprimir al máximo los datos existentes (y los nuevos). En sentido amplio, las aplicaciones de machine learning que aprovechan información externa para mejorar el rendimiento o la capacidad de generalización emplean transfer learning.
La idea general del transfer learning consiste en reutilizar el conocimiento aprendido en tareas para las que hay muchos datos etiquetados en contextos donde solo hay pocos datos etiquetados. Crear datos etiquetados es costoso, así que aprovechar bien los conjuntos de datos existentes es clave.
En un modelo tradicional de machine learning, el objetivo principal es generalizar a datos no vistos a partir de los patrones aprendidos en el entrenamiento. Con transfer learning, intentas impulsar ese proceso de generalización partiendo de patrones aprendidos para otra tarea. En esencia, en lugar de empezar el aprendizaje desde cero (a menudo con inicialización aleatoria), arrancas desde patrones ya aprendidos para resolver una tarea distinta.
La transferencia de conocimiento y patrones es posible en una gran variedad de dominios. La publicación de hoy ilustra el transfer learning con varios ejemplos de distintos ámbitos. El objetivo es animar a los científicos de datos a experimentar con transfer learning en sus proyectos de machine learning y a que conozcan sus ventajas y desventajas.
Hay tres razones por las que creo que comprender bien el transfer learning es una habilidad fundamental para cualquier científico de datos:
 |
 |
El transfer learning, como indica su nombre, requiere poder transferir conocimiento de un dominio a otro. Puede interpretarse a alto nivel: por ejemplo, reutilizar arquitecturas de modelos de NLP en problemas de predicción de secuencias, ya que muchos problemas de NLP pueden reducirse a eso. También puede interpretarse a bajo nivel, donde realmente reutilizas parámetros de un modelo en otro distinto (skip-gram, continuous bag-of-words, etc.). Los requisitos del transfer learning dependen por un lado del problema y por otro del modelo. Las dos secciones siguientes tratan, respectivamente, un enfoque de alto nivel y otro de bajo nivel. Aunque en la literatura estos conceptos reciben distintos nombres, la idea general de transfer learning sigue presente.
En el aprendizaje multitarea, entrenas un modelo en diferentes tareas al mismo tiempo. Normalmente se usan modelos de deep learning por su flexibilidad de adaptación.
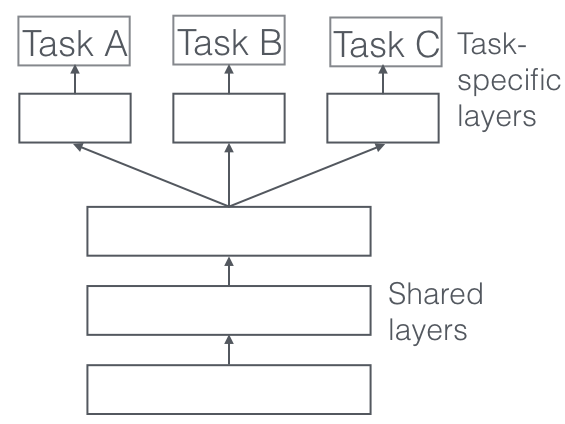
La arquitectura de la red se adapta de modo que las primeras capas se compartan entre distintas tareas y, a continuación, se añadan capas y salidas específicas para cada tarea. La idea es que, al entrenar en varias tareas, la red generalice mejor, ya que el modelo debe rendir bien en tareas que requieren un "conocimiento" o un "procesamiento" similares.
Un ejemplo en NLP es un modelo cuyo objetivo final es reconocer entidades. En lugar de entrenarlo solo para reconocimiento de entidades, también lo usas para clasificación de categorías gramaticales, predicción de la siguiente palabra, etc. Así, el modelo se beneficia de la estructura aprendida en esas tareas y de los distintos datasets. Te recomiendo mucho este blog de Sebastian Ruder y este artículo, ambos sobre aprendizaje multitarea.
Una de las grandes ventajas de un modelo de deep learning es que la extracción de características es "automática". A partir de los datos etiquetados y el backpropagation, la red identifica las características útiles para una tarea. La red "descubre" qué parte de la entrada es importante para, por ejemplo, clasificar una imagen. Esto abstrae el trabajo manual de definir características. Las redes de deep learning pueden reutilizarse en otros problemas, ya que el tipo de rasgos que extraen suele ser útil en otros contextos. En esencia, en un featurizer usas las primeras capas de la red para obtener las características útiles, pero no utilizas la salida final, porque es demasiado específica de la tarea.
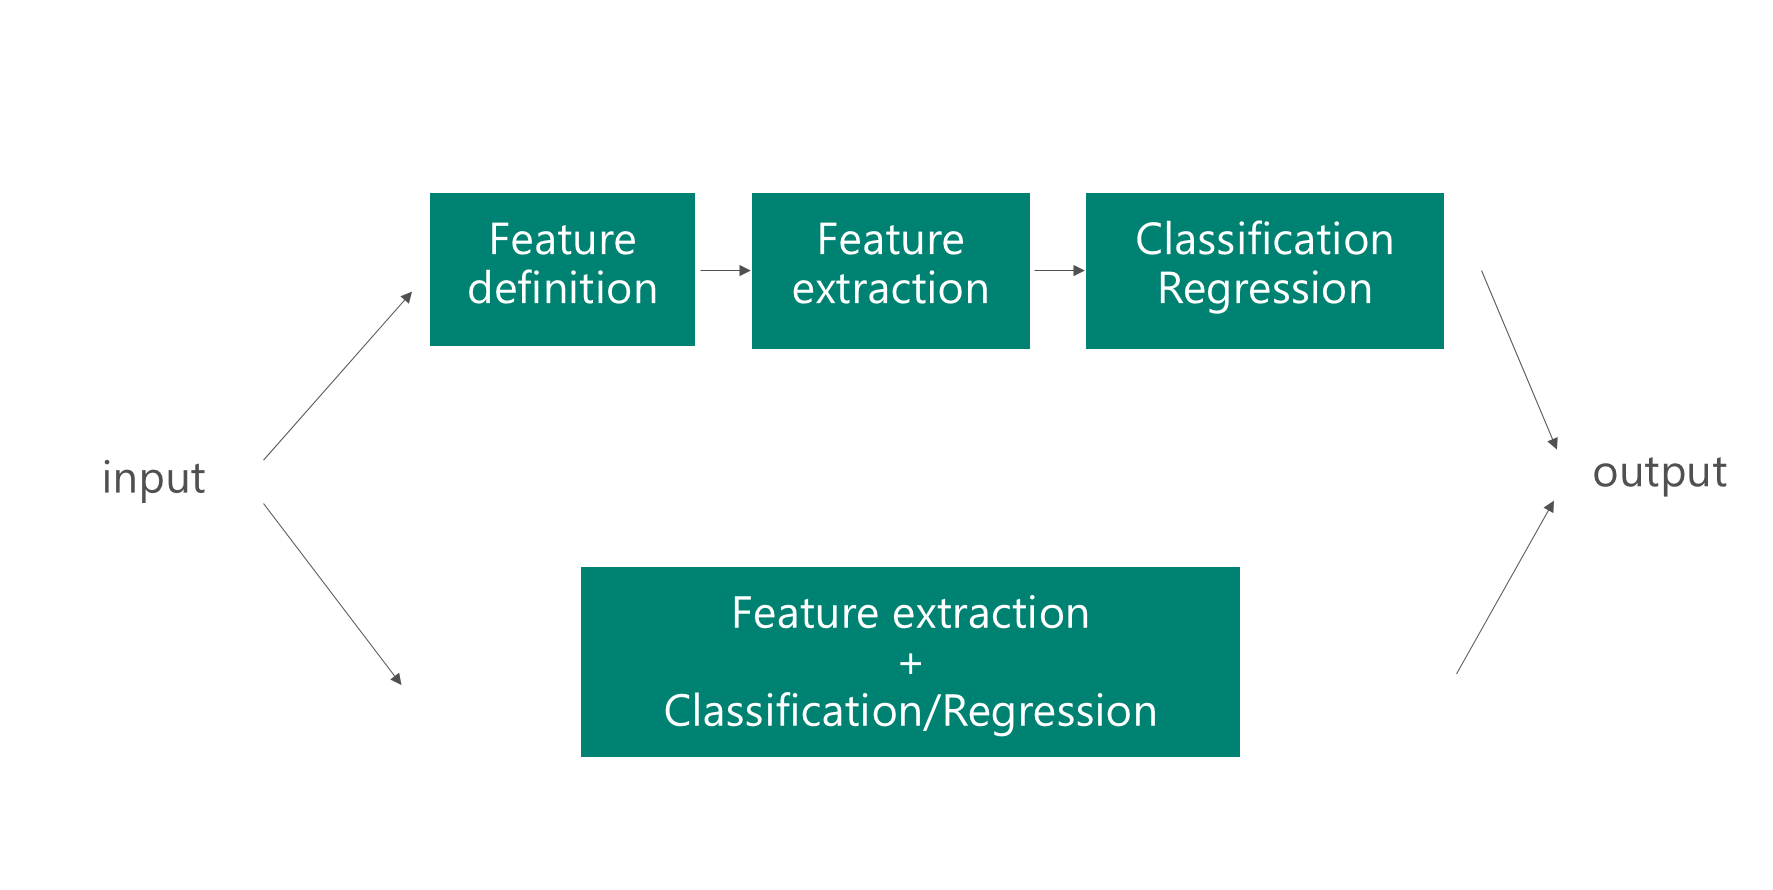
Dado que los sistemas de deep learning son buenos extrayendo características, ¿cómo puedes reutilizar redes existentes para hacer extracción de características en otras tareas? Es posible introducir una muestra de datos en la red y tomar como salida una de las capas intermedias. Esta capa intermedia puede interpretarse como una representación procesada y de longitud fija de los datos en bruto. Normalmente, el concepto de featurizer se usa en visión por ordenador. Se introducen imágenes en una red preentrenada (por ejemplo, VGG o AlexNet) y se aplica otro método de machine learning sobre la nueva representación. Extraer una capa intermedia como representación de la imagen reduce significativamente el tamaño original de los datos, lo que las hace más manejables para técnicas tradicionales (por ejemplo, la regresión logística o las SVM funcionan mejor con una representación pequeña, como dimensión 128, que con la original, por ejemplo, 128x128=16384 dimensiones).
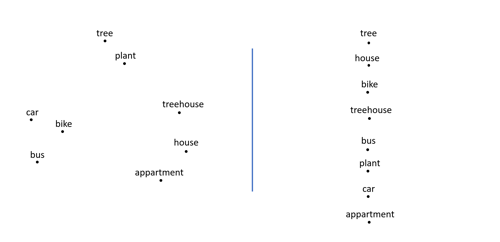
En una entrada anterior vimos cómo muchas canalizaciones de NLP hoy en día usan word embeddings. Estos embeddings representan las palabras de forma más informativa que los one-hot encodings. Están muy extendidos y existen distintas variantes. Suelen diferir en el corpus de origen (Wikipedia, noticias, etc.) y en los modelos de embedding. Es importante entender el trasfondo de estos modelos y corpus para saber si tiene sentido aplicar transfer learning con embeddings. Mucha gente no llamaría transfer learning al uso de embeddings, pero discrepo, dada su similitud con el transfer learning en visión por ordenador. En el fondo, usar embeddings significa que utilizas un featurizer o la red de embeddings para convertir palabras en vectores.
Aunque word2vec tenga ya unos años, sigue siendo un enfoque muy influyente. Por otro lado, técnicas más recientes como FastText han llevado los embeddings a un gran número de idiomas. Los embeddings de word2vec o FastText suponen un avance importante frente a los enfoques de bolsa de palabras. Aun así, su utilidad suele venir determinada por el dominio del problema.
Imagina que construyes un servicio de recomendación de noticias para equipos de ventas. Quieren recibir noticias sobre empresas que podrían estar interesadas en su producto. El vocabulario de las noticias suele ser bastante general, lo que significa que la mayoría de embeddings lo cubrirán (según el corpus en el que se entrenaron). Además, si haces que el equipo de ventas recopile durante unas semanas las noticias que lee, enseguida tendrás un corpus etiquetado amplio. Al poder reutilizar embeddings, es posible que el motor de recomendación rinda mucho mejor.
En cambio, imagina que necesitas clasificar temas en contratos legales. No en cualquier contrato, sino en contratos legales franceses en el ámbito del derecho de la competencia. Estos datasets suelen no estar etiquetados, o solo hay un conjunto limitado de documentos etiquetados. La siguiente sección explica por qué el transfer learning "tal cual" solo te llevará hasta cierto punto en este caso:
Te recomiendo leer esta excelente entrada sobre el estado actual de los word embeddings. Tener en cuenta los problemas y soluciones que se mencionan es clave para crear sistemas de NLP y embeddings robustos cuando trabajas con pocos datos.
Gensim, spaCy y FastText son tres grandes frameworks que te permiten usar embeddings rápidamente en tu aplicación de machine learning. Además, también soportan entrenar embeddings a medida. Échale un ojo a este tutorial de gensim, a esta guía de spaCy o a este tutorial de FastText para saber más.
Los métodos de deep learning han logrado grandes éxitos en visión por ordenador. En lugar de definir manualmente rasgos específicos del problema (por ejemplo, Histogram of Oriented Gradients, histogramas, etc.), el deep learning permite entrenar modelos que toman imágenes en bruto como entrada. La complejidad original de definir rasgos se ha desplazado a la complejidad de diseñar la red. Aunque se reutilizan arquitecturas, no existe una única estrategia para componerlas. Por lo general, las técnicas de deep learning se inventan y aplican en investigación sobre datasets enormes (como ImageNet o MS COCO). Para mejorar el rendimiento en estos conjuntos, se han propuesto arquitecturas cada vez más profundas y complejas. Esto da lugar a modelos con millones de parámetros que (normalmente) no escalan bien a datasets pequeños. Entrenar una arquitectura como ResNet o VGG en un conjunto con menos de 5.000 imágenes llevará, sencillamente, a un sobreajuste considerable. La tendencia del deep learning ha traído grandes avances, pero parece que quienes trabajan con pocos datos se han quedado fuera.
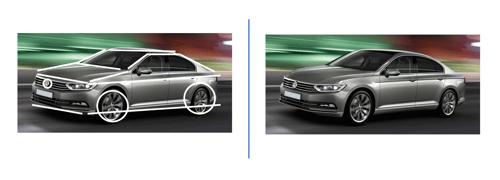
Resulta que las redes de deep learning aprenden representaciones jerárquicas de características (consulta esta entrada de Distill). Las capas inferiores aprenden rasgos de bajo nivel, como bordes; las superiores, conceptos de mayor nivel —a menudo poco interpretables—, como formas. Esta idea de representaciones jerárquicas aparece incluso cuando la red se entrena en distintos datasets, lo que indica que pueden reutilizarse en diferentes dominios.
Al aplicar transfer learning en visión por ordenador se usan dos enfoques.
La API de Keras permite cargar redes preentrenadas y fijar varias capas durante el entrenamiento. En la siguiente sección vuelvo a comentar dos casos de uso: uno donde el transfer learning es útil y otro donde no lo es.
Imagina que trabajas en conservación de fauna salvaje y quieres clasificar los animales que aparecen en una cámara en directo. Si monitorizas especies en peligro de extinción, es posible que no consigas muchos datos etiquetados. Dado que las redes preentrenadas suelen entrenarse en dominios muy amplios (desde comida a animales y objetos), usar una red preentrenada como featurizer o como inicializador es, sin duda, una opción.
Por otro lado, imagina que necesitas analizar radiografías para oncólogos. No son las típicas imágenes de gatos y perros, sino el resultado de una exploración a un paciente. Aunque se conviertan a RGB, suelen mostrarse en escala de grises para resaltar el resultado del escáner. Aunque una red preentrenada detecte formas y bordes en imágenes RGB, probablemente le cueste hacerlo en radiografías, ya que no forman parte de su entrenamiento. Además, en escenarios médicos, la cantidad de datos etiquetados suele ser baja. Existen varias técnicas para aprovechar los datos no etiquetados (a menudo abundantes), pero requieren más trabajo y ajuste fino. Normalmente, estas técnicas intentan preentrenar los pesos de la red de clasificación entrenando iterativamente cada capa para reconstruir las imágenes (usando capas convolucionales y deconvolucionales). A menudo se combina esto con redes preentrenadas para mejorar la convergencia.
Ambos métodos de visión por ordenador mencionados se apoyan en una suposición importante: que los patrones extraídos en el dataset original son útiles en el nuevo. Esta utilidad es difícil de cuantificar, pero es una hipótesis crucial. Las imágenes sísmicas, hiperespectrales o médicas se parecen poco a las de ImageNet. En cambio, determinar qué señal de tráfico aparece en una imagen sí se apoya en patrones bastante similares. Entender bien el dominio de visión por ordenador es clave para aplicar estas técnicas con éxito. Conocer el contexto de los modelos (datasets, técnicas, etc.) que reutilizas en transfer learning te ayuda a no perder tiempo en experimentos y a centrarte en afinar los modelos que realmente pueden marcar la diferencia.
Cursos de machine learning
Curso
Curso
Curso
blog
Zoumana Keita
14 min
blog
Matt Crabtree
14 min
blog
Kurtis Pykes
8 min
blog
Natassha Selvaraj
15 min
Tutorial
Abid Ali Awan
15 min
Tutorial
Moez Ali
14 min