Curso
Introducción a Python
4 h
7M
Este tutorial te guiará por conceptos y pasos básicos de preparación de datos. La preparación de datos es el primer paso tras obtener cualquier conjunto de datos. Aquí es donde preprocesas los datos en bruto para dejarlos en un formato que se pueda analizar de forma sencilla y precisa. Una preparación adecuada permite analizar con eficiencia: ayuda a eliminar errores e imprecisiones ocurridas durante la recopilación y, por tanto, a reducir sesgos derivados de una mala calidad de datos. Por eso, gran parte del tiempo de una persona analista se dedica a este paso clave.
Cargar datos, limpiarlos (eliminar datos innecesarios o erróneos), transformar formatos y reorganizar estructuras son algunas de las tareas que componen la preparación de datos. En este tutorial trabajarás con la librería Pandas de Python para preparar datos.
Asegúrate de comprender conceptos como DataFrame, Series, etc. de Pandas, ya que aparecerán continuamente a lo largo del tutorial. Puedes profundizar en pandas en el tutorial de Pandas de DataCamp.
En este tutorial:
Por el camino encontrarás consejos, trucos y referencias para profundizar si te interesa un tema en particular.
Empecemos con una breve introducción a Pandas…
Pandas es una librería de software escrita para Python. Es muy popular en la comunidad de ciencia de datos porque ofrece estructuras de datos potentes, expresivas y flexibles que facilitan la manipulación y el análisis de datos, y además es gratuita. Si tienes un caso de uso específico o nuevo, incluso puedes compartirlo en una lista de correo de Python o en el GitHub de pandas; de hecho, muchas funcionalidades de pandas han surgido de casos de uso reales.
Para una introducción excelente a pandas, echa un vistazo al curso Pandas Foundation de DataCamp. Es muy interactivo y el primer capítulo es gratis.
Para usar la librería pandas, primero tienes que importarla. Escribe esto en tu consola de Python:
import pandas as pdEl primer paso de la preparación es… conseguir datos. Si tienes un archivo .csv, puedes cargarlo fácilmente en tu entorno con la función .read_csv() de pandas. Por ejemplo:
data = pd.read_csv('path_to_file.csv')
Sin embargo, en este tutorial trabajaremos con DataFrames y Series más pequeños y sencillos, creados sobre la marcha.
Es un problema muy común en análisis de datos.
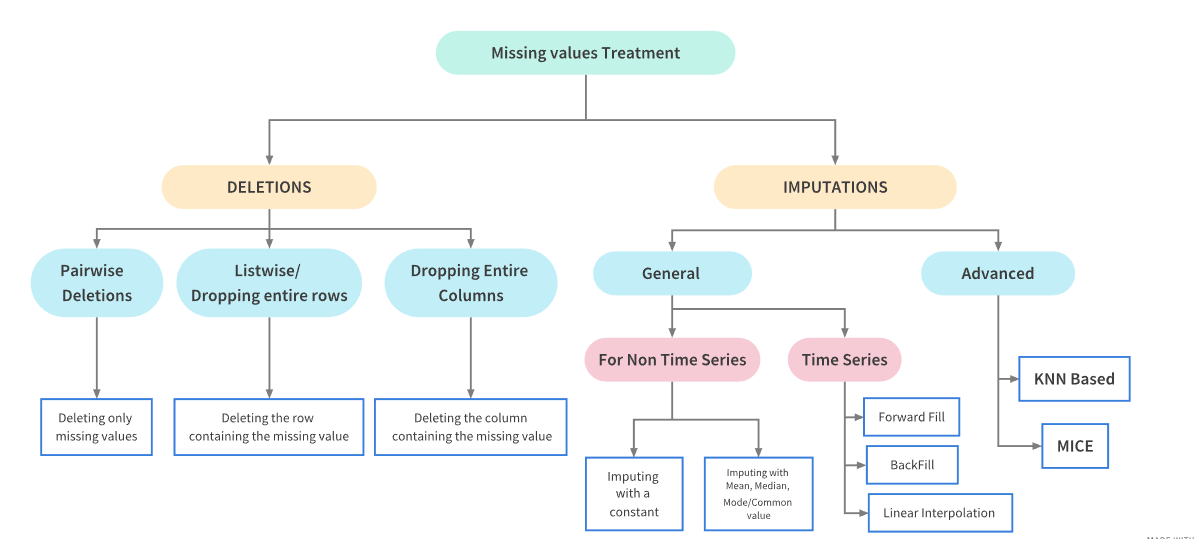
Los datos ausentes pueden aparecer por múltiples razones: el usuario o la aplicación de recogida no introdujo el valor, se perdieron al transferirlos manualmente, hubo un error de programación, etc. A veces es clave entender la causa, porque influirá en cómo tratarlos. Hablaremos de ello más adelante; por ahora, centrémonos en qué hacer cuando tienes valores perdidos…
Para datos numéricos, pandas utiliza el valor en coma flotante NaN (Not a Number) para representar datos ausentes. Es un valor único definido en NumPy, así que también habrá que importarlo. NaN es el marcador por defecto de valores faltantes por velocidad y comodidad computacional. Es un valor centinela: un dato ficticio o bandera que las funciones de pandas detectan y manejan fácilmente.
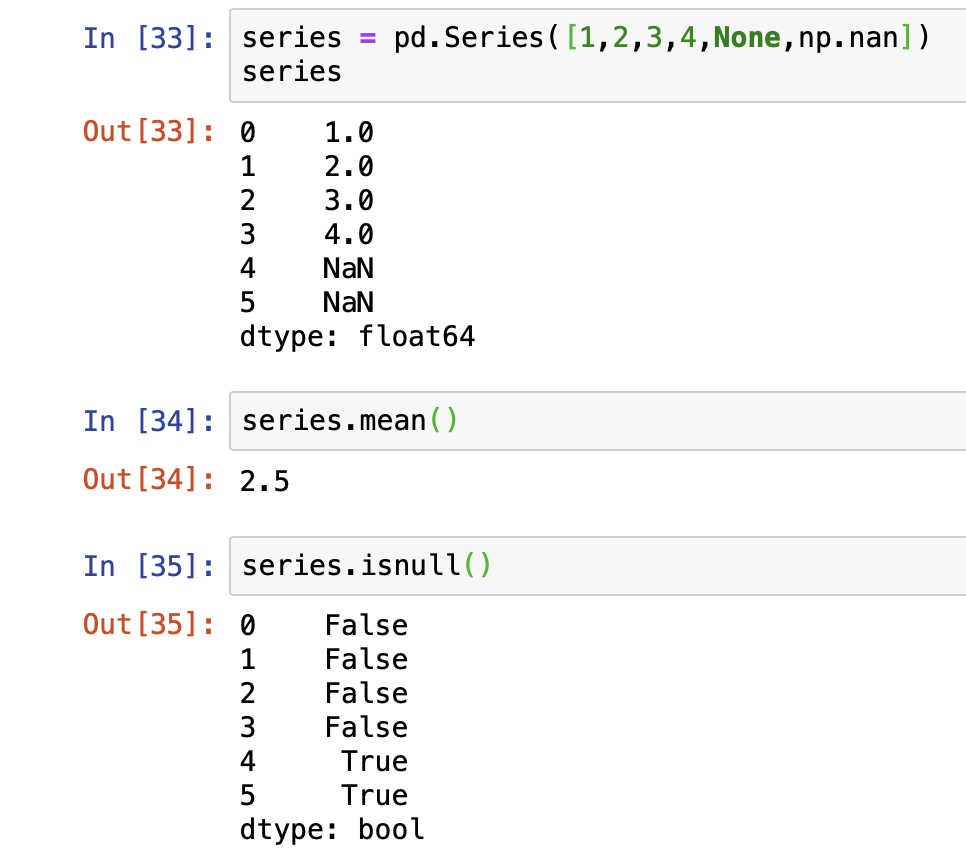
Vamos a jugar con algunos datos…
import numpy as np

# Creación de una serie de pandas
data = pd.Series([0, 1, 2, 3, 4, 5, np.nan, 6, 7, 8])

# Para comprobar si hay valores nulos y en qué índices
data.isnull()
0    False
1    False
2    False
3    False
4    False
5    False
6     True
7    False
8    False
9    False
dtype: bool
Arriba usamos la función isnull(), que devuelve valores booleanos. Devuelve True cuando el dato en ese índice está ausente o es NaN. Su opuesto es notnull().
# Para comprobar dónde no hay valores nulos: opuesto de isnull()
data.notnull()
0     True
1     True
2     True
3     True
4     True
5     True
6    False
7     True
8     True
9     True
dtype: bool
Además, podemos usar dropna() para filtrar los valores ausentes y ver solo los no nulos. Sin embargo, el valor NaN no se elimina realmente y sigue en el conjunto original.
# No mostrará el índice 6 porque contiene un NaN
data.dropna()
0    0.0
1    1.0
2    2.0
3    3.0
4    4.0
5    5.0
7    6.0
8    7.0
9    8.0
dtype: float64
data
0    0.0
1    1.0
2    2.0
3    3.0
4    4.0
5    5.0
6    NaN
7    6.0
8    7.0
9    8.0
dtype: float64
Para "eliminar" de verdad los NaN puedes guardar el nuevo conjunto (sin NaN) en otra variable para no tocar la serie original, o aplicar el borrado inplace. El argumento inplace es false por defecto.
not_null_data = data.dropna()
not_null_data
0    0.0
1    1.0
2    2.0
3    3.0
4    4.0
5    5.0
7    6.0
8    7.0
9    8.0
dtype: float64
# Elimina el índice 6 de 'data' original porque tiene un NaN
data.dropna(inplace = True)
data
0    0.0
1    1.0
2    2.0
3    3.0
4    4.0
5    5.0
7    6.0
8    7.0
9    8.0
dtype: float64
Pero los dataframes pueden ser más complejos y tener 2 dimensiones, con filas y columnas. Pandas también cubre estos casos…
# Creamos un dataframe de 4 filas y 4 columnas (matriz 4*4)
data_dim = pd.DataFrame([[1,2,3,np.nan],[4,5,np.nan,np.nan],[7,np.nan,np.nan,np.nan],[np.nan,np.nan,np.nan,np.nan]])
data_dim
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | NaN | NaN |
| 2 | 7.0 | NaN | NaN | NaN |
| 3 | NaN | NaN | NaN | NaN |
Imagina que quieres eliminar solo filas o columnas que sean completamente nulas, o solo aquellas con cierta cantidad de nulos. Explora estos casos; recuerda que el borrado no es inplace, así que el dataset real no se altera. Fíjate en los argumentos de dropna() para controlar cómo se eliminan los ausentes.
# Elimina todas las filas y columnas que contengan NaN
data_dim.dropna()
| 0 | 1 | 2 | 3 |
|---|
# Elimina filas y columnas que sean enteramente NaN
data_dim.dropna(how = 'all')
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | NaN | NaN |
| 2 | 7.0 | NaN | NaN | NaN |
# Elimina solo columnas que sean completamente NaN
# Por defecto axis = 0 (filas)
data_dim.dropna(axis = 1, how = 'all')
| 0 | 1 | 2 | |
|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 |
| 1 | 4.0 | 5.0 | NaN |
| 2 | 7.0 | NaN | NaN |
| 3 | NaN | NaN | NaN |
# Elimina columnas con más de 2 valores NaN
data_dim.dropna(axis = 1, thresh = 2)
| 0 | 1 | |
|---|---|---|
| 0 | 1.0 | 2.0 |
| 1 | 4.0 | 5.0 |
| 2 | 7.0 | NaN |
| 3 | NaN | NaN |
# Elimina filas con más de 2 valores NaN
data_dim.dropna(thresh = 2)
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | NaN | NaN |
Ya sabes identificar y eliminar valores ausentes, tanto para previsualizar el resultado como para borrar inplace. En muchos casos, simplemente eliminar nulos no es viable y querrás rellenarlos con algún valor. Veamos cómo…
Para reemplazar o "rellenar" datos nulos, puedes usar fillna(). Por ejemplo, usemos el mismo dataset y rellenemos los NaN con 0.
# Vuelve a ver cómo es el dataset
data_dim
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | NaN | NaN |
| 2 | 7.0 | NaN | NaN | NaN |
| 3 | NaN | NaN | NaN | NaN |
# Rellena los NaN con 0
data_dim_fill = data_dim.fillna(0)
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | 0.0 |
| 1 | 4.0 | 5.0 | 0.0 | 0.0 |
| 2 | 7.0 | 0.0 | 0.0 | 0.0 |
| 3 | 0.0 | 0.0 | 0.0 | 0.0 |
Al igual que con dropna(), puedes hacer muchas más cosas según el argumento que pases. Recuerda que si añades inplace = True, el cambio se aplica al dataset original.
# Pasa un diccionario para usar valores distintos por columna
data_dim_fill = data_dim.fillna({0: 0, 1: 8, 2: 9, 3: 10})
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | 10.0 |
| 1 | 4.0 | 5.0 | 9.0 | 10.0 |
| 2 | 7.0 | 8.0 | 9.0 | 10.0 |
| 3 | 0.0 | 8.0 | 9.0 | 10.0 |
Puedes pasar el argumento method a fillna() para propagar automáticamente valores no nulos hacia delante (ffill o pad) o hacia atrás (bfill o backfill).
# Usa method para decidir cómo rellenar la columna: hacia delante aquí
data_dim_fill = data_dim.fillna(method='ffill')
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | 3.0 | NaN |
| 2 | 7.0 | 5.0 | 3.0 | NaN |
| 3 | 7.0 | 5.0 | 3.0 | NaN |
También puedes limitar cuántos valores seguidos rellenas. Por ejemplo, rellenar solo dos posiciones en las columnas. Además, si pasas axis = 1 rellenarás por filas.
# Relleno hacia delante con límite de 2
data_dim_fill = data_dim.fillna(method='ffill', limit = 2)
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | 3.0 | NaN |
| 2 | 7.0 | 5.0 | 3.0 | NaN |
| 3 | 7.0 | 5.0 | NaN | NaN |
# Relleno por filas (axis=1) hacia delante
data_dim_fill = data_dim.fillna(axis = 1, method='ffill')
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | 3.0 |
| 1 | 4.0 | 5.0 | 5.0 | 5.0 |
| 2 | 7.0 | 7.0 | 7.0 | 7.0 |
| 3 | NaN | NaN | NaN | NaN |
Con algo de conocimiento del dato y tu caso de uso, puedes usar fillna() de muchas otras formas además de números. Por ejemplo, rellenar con la media con mean() o con la mediana con median()…
# Revisa el dataset data_dim
data_dim
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | NaN | NaN |
| 2 | 7.0 | NaN | NaN | NaN |
| 3 | NaN | NaN | NaN | NaN |
# Rellena NaN con la media de su columna correspondiente
data_dim_fill = data_dim.fillna(data_dim.mean())
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | 3.0 | NaN |
| 2 | 7.0 | 3.5 | 3.0 | NaN |
| 3 | 4.0 | 3.5 | 3.0 | NaN |
Hasta ahora has trabajado con valores ausentes (NaN), pero puede que quieras reemplazar un valor no nulo por otro. O quizá un valor nulo se guardó como un número cualquiera y deba tratarse como NaN y no como número. Aquí entra en juego replace()…
Creemos un dataset distinto.
data = pd.Series([1,2,-99,4,5,-99,7,8,-99])
data
0     1
1     2
2   -99
3     4
4     5
5   -99
6     7
7     8
8   -99
dtype: int64
# Sustituye el marcador -99 por NaN
data.replace(-99, np.nan)
0    0.0
1    1.0
2    2.0
3    3.0
4    4.0
5    5.0
7    6.0
8    7.0
9    8.0
dtype: float64
Ya no verás el -99 porque se ha reemplazado por NaN y, por tanto, no se muestra. Del mismo modo, puedes pasar múltiples valores a reemplazar. Para ello, crearemos otra serie, concatenaremos la original con la nueva y aplicaremos el reemplazo múltiple.
Para ello puedes usar concat() en pandas. Si quieres que el índice continúe después de concatenar, pasa ignore_index = True.
# Crea una nueva Series
new_data = pd.Series([-100, 11, 12, 13])
combined_series = pd.concat([data, new_data], ignore_index = True)
combined_series
0       1
1       2
2     -99
3       4
4       5
5     -99
6       7
7       8
8     -99
9    -100
10     11
11     12
12     13
dtype: int64
# Reemplacemos -99 y -100 por NaN en combined_series
data_replaced = combined_series.replace([-99, -100], np.nan)
data_replaced
0      1.0
1      2.0
2      NaN
3      4.0
4      5.0
5      NaN
6      7.0
7      8.0
8      NaN
9      NaN
10    11.0
11    12.0
12    13.0
dtype: float64
# También puedes pasar un diccionario con valores separados
data_replaced = combined_series.replace({-99: np.nan, -100: 0})

# Equivalente a: new_data.replace([-99, -100], [np.nan, 0])
data_replaced
0      1.0
1      2.0
2      NaN
3      4.0
4      5.0
5      NaN
6      7.0
7      8.0
8      NaN
9      0.0
10    11.0
11    12.0
12    13.0
dtype: float64
En algunas situaciones querrás enriquecer lo que ya tienes aplicando cierta lógica. Para ello puedes ayudarte de mapeos y combinar funciones. La lógica puede ser más compleja; entiende la idea con este ejemplo.
Supón que tienes un dataframe de números mapeados a su conteo correspondiente en inglés.
data_number = pd.DataFrame({'english': ['zero','one','two','three','four','five'],
'digits': [0,1,2,3,4,5]})
data_number
| english | digits | |
|---|---|---|
| 0 | zero | 0 |
| 1 | one | 1 |
| 2 | two | 2 |
| 3 | three | 3 |
| 4 | four | 4 |
| 5 | five | 5 |
Ahora quieres añadir otra columna que indique si son múltiplos de dos con "yes" y el resto "no". Puedes escribir un mapeo de cada término en inglés a su "yes" o "no" correspondiente.
english_to_multiple = {
    'two': 'yes',
    'four': 'yes'
}
Luego llamas a map para añadir la columna cuando el valor en inglés sea múltiplo de 2. ¿Qué se rellena en las demás filas que no son múltiplos? Vamos a verlo…
data_number['multiple'] = data_number['english'].map(english_to_multiple)
data_number
| english | digits | multiple | |
|---|---|---|---|
| 0 | zero | 0 | NaN |
| 1 | one | 1 | NaN |
| 2 | two | 2 | yes |
| 3 | three | 3 | NaN |
| 4 | four | 4 | yes |
| 5 | five | 5 | NaN |
El resto de filas se rellenan con NaN; ya sabes cómo trabajar después con valores ausentes. Es un ejemplo sencillo, pero puede darte ideas para usar map en tus casos de uso.
A veces querrás categorizar según cierta lógica y agrupar los datos en intervalos o bins para analizarlos. Puedes usar cut() para esto. Por ejemplo, primero creamos un conjunto con 30 números aleatorios entre 1 y 100.
import random

data = random.sample(range(1, 101), 30)
# data
[45,
 39,
 25,
 83,
 27,
 6,
 73,
 43,
 36,
 93,
 97,
 17,
 15,
 99,
 37,
 5,
 31,
 22,
 65,
 30,
 3,
 26,
 91,
 12,
 52,
 76,
 63,
 84,
 59,
 53]
Digamos que queremos categorizarlos en intervalos definidos por nosotros: 1 - 25, 25 - 35, 40 - 60, 60 - 80 y el resto. Definimos los intervalos…
Luego usamos la función cut.
# Definimos el valor inicial de cada intervalo
bucket = [1, 25, 35, 60, 80, 100]

cut_data = pd.cut(data, bucket)
cut_data
[(35, 60], (35, 60], (1, 25], (80, 100], (25, 35], ..., (60, 80], (60, 80], (80, 100], (35, 60], (35, 60]]
Length: 30
Categories (5, interval[int64]): [(1, 25] < (25, 35] < (35, 60] < (60, 80] < (80, 100]]
cut() es muy útil y permite mucho más. Te recomendamos consultar la documentación de Pandas para aprender más.
Este tema es especialmente útil cuando quieres convertir datos categóricos en valores numéricos para usarlos en tu modelo de análisis. Es clave en aprendizaje automático, donde el one-hot encoding es muy conocido. En términos técnicos: el one-hot encoding convierte valores categóricos en un vector numérico unidimensional.
En pandas, una forma de hacerlo es con get_dummies(). Si una columna de tu dataframe tiene "n" valores distintos, la función generará una matriz con "n" columnas con 1s y 0s. Veámoslo con un ejemplo para asimilar mejor el concepto…
# Creamos una Serie con los caracteres individuales de la lista
data = pd.Series(list('abcdababcdabcd'))
data
0     a
1     b
2     c
3     d
4     a
5     b
6     a
7     b
8     c
9     d
10    a
11    b
12    c
13    d
dtype: object
Ahora queremos vectores individuales que indiquen la aparición de cada carácter para pasarlos a una función.
Algo así: para 'a' = [1,0,0,0,1,0,1,0,0,0,1,0,0,0], con 1 donde aparece 'a' y 0 donde no. Con get_dummies() la tarea es más sencilla.
pd.get_dummies(data)
| a | b | c | d | |
|---|---|---|---|---|
| 0 | 1 | 0 | 0 | 0 |
| 1 | 0 | 1 | 0 | 0 |
| 2 | 0 | 0 | 1 | 0 |
| 3 | 0 | 0 | 0 | 1 |
| 4 | 1 | 0 | 0 | 0 |
| 5 | 0 | 1 | 0 | 0 |
| 6 | 1 | 0 | 0 | 0 |
| 7 | 0 | 1 | 0 | 0 |
| 8 | 0 | 0 | 1 | 0 |
| 9 | 0 | 0 | 0 | 1 |
| 10 | 1 | 0 | 0 | 0 |
| 11 | 0 | 1 | 0 | 0 |
| 12 | 0 | 0 | 1 | 0 |
| 13 | 0 | 0 | 0 | 1 |
Este es un ejemplo simple para empezar. En casos reales, la pertenencia de un carácter puede corresponder a varias categorías a la vez, así que necesitarás técnicas más avanzadas. Para datasets mucho mayores, esta función quizá no sea la más eficiente en velocidad. El artículo de DataCamp Handling Categorical Data in Python trata estos casos y el tema con más profundidad.
Has llegado al final del tutorial y ya dominas algunas herramientas básicas para dar el primer paso en tu camino de análisis de datos. Otras habilidades útiles para la fase de preparación incluyen detectar y filtrar valores atípicos, y si el dataset es muy grande, quizá empezar con muestreo aleatorio. Son temas amplios y difíciles de generalizar.
Los casos reales suelen ser más complejos y requerir soluciones a medida, pero la idea es empezar con algo pequeño, aprender sobre la marcha, explorar más y ensuciarte las manos con distintos datasets. No te pierdas el curso Cleaning Data in Python de DataCamp para aprender más herramientas y trucos y, al final, trabajar con un dataset real y desordenado de la Gapminder Foundation. ¡A por ello!
Cursos de Python
Curso
Curso
Curso
Tutorial
Vidhi Chugh
15 min
Tutorial
Kurtis Pykes
10 min
Tutorial
Karlijn Willems
15 min
Tutorial
DataCamp Team
13 min
Tutorial
DataCamp Team
7 min
Tutorial
Moez Ali
14 min





