Curso
Introdução ao Python
4 h
7M
Este tutorial vai guiar você por alguns conceitos e etapas básicas de preparação de dados. A preparação de dados é o primeiro passo depois que você tem em mãos qualquer conjunto de dados. É quando você pré-processa dados brutos para um formato que pode ser analisado de forma fácil e precisa. Uma boa preparação de dados permite análises eficientes — ela elimina erros e imprecisões que podem ter surgido na coleta e ajuda a reduzir vieses causados por baixa qualidade dos dados. Não por acaso, boa parte do tempo de um analista é dedicada a essa etapa essencial.
Carregar dados, limpar dados (remover dados desnecessários ou com erro), transformar formatos e reorganizar dados são algumas das ações envolvidas na preparação de dados. Neste tutorial, você vai usar a biblioteca Pandas do Python para preparar dados.
Garanta que você entende conceitos como DataFrame e Series do Pandas, entre outros, porque eles aparecem bastante por aqui. Você pode se aprofundar em pandas no tutorial de Pandas da DataCamp.
Neste tutorial:
No caminho, há dicas, truques e links para materiais mais aprofundados caso você queira se aprofundar em algum tópico.
Vamos começar com uma breve introdução ao Pandas...
Pandas é uma biblioteca escrita para Python. É muito popular na comunidade de ciência de dados porque oferece estruturas de dados poderosas, expressivas e flexíveis que facilitam a manipulação e a análise — e é gratuita. Além disso, se você tiver um caso de uso específico e novo, pode compartilhá-lo em uma das listas de e-mail de Python ou no repositório do pandas no GitHub — na prática, muitas funcionalidades do pandas surgiram assim, a partir de casos reais.
Para uma ótima introdução a pandas, confira o curso Pandas Foundation da DataCamp. Ele é super interativo e o primeiro capítulo é grátis!
Para usar a biblioteca pandas, primeiro importe-a. Digite no seu console Python:
import pandas as pdO primeiro passo da preparação é... conseguir alguns dados. Se você tiver um arquivo .csv, dá para carregá-lo facilmente com a função .read_csv() do pandas. Você pode então digitar:
data = pd.read_csv('path_to_file.csv')
Mas, para este tutorial, vamos trabalhar com alguns DataFrames e Series menores, criados na hora para facilitar o entendimento.
Esse é um problema muito comum no mundo da análise de dados.
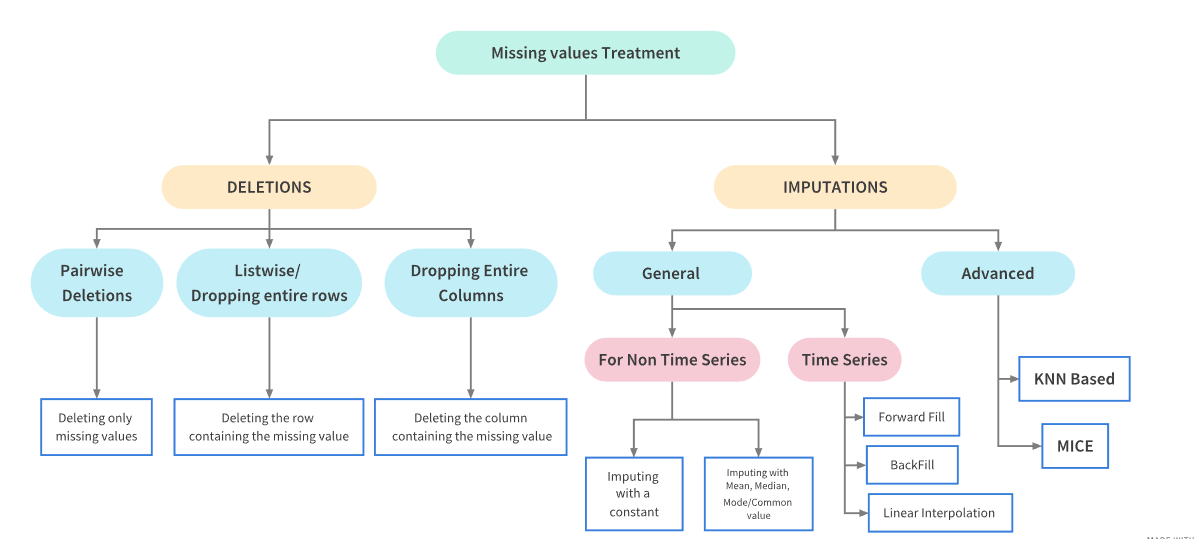
Dados ausentes podem surgir por vários motivos: a aplicação ou o usuário não forneceu aquele campo, houve perda na transferência manual, erro de programação etc. Às vezes, entender a causa é essencial, porque isso influencia a estratégia de tratamento. Mas falamos disso mais adiante. Por agora, foque no que fazer quando você tem valores faltantes...
Para dados numéricos, o pandas usa o valor de ponto flutuante NaN (Not a Number) para representar ausências. É um valor único definido na biblioteca Numpy, então vamos importá-la também. O NaN é o marcador padrão de valores ausentes por motivos de desempenho e conveniência. Ele é um valor sentinela, ou seja, um valor de bandeira que pode ser detectado e manipulado facilmente com as funções do pandas.
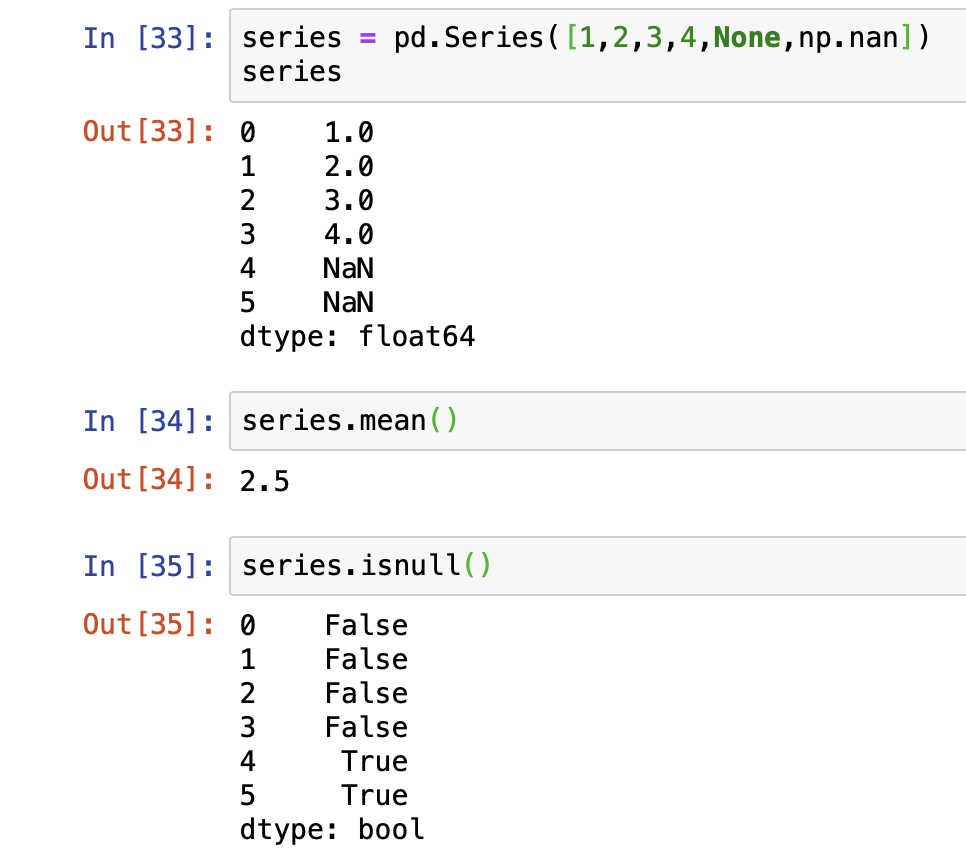
Vamos brincar com alguns dados...
import numpy as np

# Creating a pandas series
data = pd.Series([0, 1, 2, 3, 4, 5, np.nan, 6, 7, 8])

# To check if and what index in the dataset contains null value
data.isnull()
0    False
1    False
2    False
3    False
4    False
5    False
6     True
7    False
8    False
9    False
dtype: bool
Acima, usamos a função isnull(), que retorna valores booleanos. True indica que, naquele índice, o dado está ausente (NaN). O oposto é a função notnull().
# To check where the dataset does not contain null value - opposite of isnull()
data.notnull()
0     True
1     True
2     True
3     True
4     True
5     True
6    False
7     True
8     True
9     True
dtype: bool
Também podemos usar a função dropna() para filtrar e remover os valores nulos e ver apenas os valores não nulos. Porém, o NaN não é realmente deletado do objeto original e continua presente na Series original.
# Will not show the index 6 cause it contains null (NaN) value
data.dropna()
0    0.0
1    1.0
2    2.0
3    3.0
4    4.0
5    5.0
7    6.0
8    7.0
9    8.0
dtype: float64
data
0    0.0
1    1.0
2    2.0
3    3.0
4    4.0
5    5.0
6    NaN
7    6.0
8    7.0
9    8.0
dtype: float64
Para realmente "remover" o NaN, você pode armazenar o novo conjunto de dados (sem NaN) em outra variável — assim a Series original não é alterada — ou aplicar o drop inplace. O argumento inplace é false por padrão.
not_null_data = data.dropna()
not_null_data
0    0.0
1    1.0
2    2.0
3    3.0
4    4.0
5    5.0
7    6.0
8    7.0
9    8.0
dtype: float64
# Drop the 6th index in the original 'data' since it has a NaN place
data.dropna(inplace = True)
data
0    0.0
1    1.0
2    2.0
3    3.0
4    4.0
5    5.0
7    6.0
8    7.0
9    8.0
dtype: float64
Mas DataFrames podem ser mais complexos e bidimensionais, com linhas e colunas. O pandas também dá conta...
# Creating a dataframe with 4 rows and 4 columns (4*4 matrix)
data_dim = pd.DataFrame([[1,2,3,np.nan],[4,5,np.nan,np.nan],[7,np.nan,np.nan,np.nan],[np.nan,np.nan,np.nan,np.nan]])
data_dim
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | NaN | NaN |
| 2 | 7.0 | NaN | NaN | NaN |
| 3 | NaN | NaN | NaN | NaN |
Agora, digamos que você queira remover apenas as linhas ou colunas que são totalmente nulas, ou apenas aquelas que têm uma certa quantidade de nulos. Veja alguns cenários — lembre que o drop não está sendo feito inplace, então o dataset real não é alterado. Repare nos argumentos passados para dropna() para controlar como descartar os dados ausentes.
# Drop all rows and columns containing NaN value
data_dim.dropna()
| 0 | 1 | 2 | 3 |
|---|
# Drop all rows and columns containing entirely of NaN value
data_dim.dropna(how = 'all')
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | NaN | NaN |
| 2 | 7.0 | NaN | NaN | NaN |
# Drop only columns that contain entirely NaN value
# Default is 0 - which signifies rows
data_dim.dropna(axis = 1, how = 'all')
| 0 | 1 | 2 | |
|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 |
| 1 | 4.0 | 5.0 | NaN |
| 2 | 7.0 | NaN | NaN |
| 3 | NaN | NaN | NaN |
# Drop all columns that have more than 2 NaN values
data_dim.dropna(axis = 1, thresh = 2)
| 0 | 1 | |
|---|---|---|
| 0 | 1.0 | 2.0 |
| 1 | 4.0 | 5.0 |
| 2 | 7.0 | NaN |
| 3 | NaN | NaN |
# Drop all rows that have more than 2 NaN values
data_dim.dropna(thresh = 2)
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | NaN | NaN |
Agora você já sabe identificar e remover valores ausentes — seja para visualizar o resultado, seja para fazer a exclusão inplace. Em muitos casos, simplesmente descartar nulos não é viável; você pode preferir preencher os dados faltantes com outro valor. Vamos ver como fazer isso...
Para substituir — ou melhor, "preencher" — dados nulos, use a função fillna(). Por exemplo, vamos usar o mesmo dataset de cima e preencher os NaNs com 0.
# Check what the dataset looks like again
data_dim
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | NaN | NaN |
| 2 | 7.0 | NaN | NaN | NaN |
| 3 | NaN | NaN | NaN | NaN |
# Fill the NaN values with 0
data_dim_fill = data_dim.fillna(0)
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | 0.0 |
| 1 | 4.0 | 5.0 | 0.0 | 0.0 |
| 2 | 7.0 | 0.0 | 0.0 | 0.0 |
| 3 | 0.0 | 0.0 | 0.0 | 0.0 |
Assim como em dropna(), você pode fazer outras coisas dependendo dos argumentos. E lembrete: passar inplace = True altera o dataset original.
# Pass a dictionary to use differnt values for each column
data_dim_fill = data_dim.fillna({0: 0, 1: 8, 2: 9, 3: 10})
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | 10.0 |
| 1 | 4.0 | 5.0 | 9.0 | 10.0 |
| 2 | 7.0 | 8.0 | 9.0 | 10.0 |
| 3 | 0.0 | 8.0 | 9.0 | 10.0 |
Você pode passar o argumento method para fillna() e propagar automaticamente valores não nulos para frente (ffill ou pad) ou para trás (bfill ou backfill).
# Pass method to determine how to fill-up the column - forward here
data_dim_fill = data_dim.fillna(method='ffill')
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | 3.0 | NaN |
| 2 | 7.0 | 5.0 | 3.0 | NaN |
| 3 | 7.0 | 5.0 | 3.0 | NaN |
Você também pode limitar o número de preenchimentos. Por exemplo, preencher apenas dois valores em cada coluna... Além disso, se você passar axis = 1, o preenchimento ocorre ao longo da linha.
# Pass method to determine how to fill-up the column - forward here
data_dim_fill = data_dim.fillna(method='ffill', limit = 2)
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | 3.0 | NaN |
| 2 | 7.0 | 5.0 | 3.0 | NaN |
| 3 | 7.0 | 5.0 | NaN | NaN |
# Pass method to determine how to fill-up the row - forward here
data_dim_fill = data_dim.fillna(axis = 1, method='ffill')
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | 3.0 |
| 1 | 4.0 | 5.0 | 5.0 | 5.0 |
| 2 | 7.0 | 7.0 | 7.0 | 7.0 |
| 3 | NaN | NaN | NaN | NaN |
Com algum entendimento do seu dado e do seu caso de uso, dá para usar fillna() de várias formas além de números fixos. Você pode, por exemplo, preencher com a média usando mean() ou a mediana com median()...
# Check the data_dim dataset
data_dim
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | NaN | NaN |
| 2 | 7.0 | NaN | NaN | NaN |
| 3 | NaN | NaN | NaN | NaN |
# Fill the NaN value with mean values in the corresponding column
data_dim_fill = data_dim.fillna(data_dim.mean())
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | 3.0 | NaN |
| 2 | 7.0 | 3.5 | 3.0 | NaN |
| 3 | 4.0 | 3.5 | 3.0 | NaN |
Até aqui, trabalhamos apenas com ausências (NaN), mas pode haver situações em que você queira trocar um valor não nulo por outro. Ou talvez um valor ausente foi registrado como um número arbitrário e, por isso, precisa ser tratado como NaN e não como número. É aí que a função replace() ajuda...
Vamos criar um dataset diferente desta vez.
data = pd.Series([1,2,-99,4,5,-99,7,8,-99])
data
0     1
1     2
2   -99
3     4
4     5
5   -99
6     7
7     8
8   -99
dtype: int64
# Replace the placeholder -99 as NaN
data.replace(-99, np.nan)
0    0.0
1    1.0
2    2.0
3    3.0
4    4.0
5    5.0
7    6.0
8    7.0
9    8.0
dtype: float64
Você não verá mais o -99, pois ele foi substituído por NaN e, por isso, não aparece. Da mesma forma, dá para passar múltiplos valores para substituir. Para isso, vamos criar outra Series, concatená-la com a original e aplicar a substituição múltipla.
Para isso, usamos a função concat() do pandas. Para reiniciar a indexação após a concatenação, passe o argumento ignore_index = True.
# Create a new Series
new_data = pd.Series([-100, 11, 12, 13])
combined_series = pd.concat([data, new_data], ignore_index = True)
combined_series
0       1
1       2
2     -99
3       4
4       5
5     -99
6       7
7       8
8     -99
9    -100
10     11
11     12
12     13
dtype: int64
# Let's replace -99 and -100 as NaN in the new combined_series
data_replaced = combined_series.replace([-99, -100], np.nan)
data_replaced
0      1.0
1      2.0
2      NaN
3      4.0
4      5.0
5      NaN
6      7.0
7      8.0
8      NaN
9      NaN
10    11.0
11    12.0
12    13.0
dtype: float64
# Argument passed can also be a dictionary with separate values
data_replaced = combined_series.replace({-99: np.nan, -100: 0})

# Same as: new_data.replace([-99, -100], [np.nan, 0])
data_replaced
0      1.0
1      2.0
2      NaN
3      4.0
4      5.0
5      NaN
6      7.0
7      8.0
8      NaN
9      0.0
10    11.0
11    12.0
12    13.0
dtype: float64
Em algumas situações, você pode querer adicionar mais contexto ao que já tem com base em alguma lógica. Dá para fazer isso com mapeamentos e a combinação de funções. A lógica pode ficar mais complexa, mas vamos entender pelo exemplo.
Suponha que você tenha um DataFrame com números mapeados às suas palavras em inglês.
data_number = pd.DataFrame({'english': ['zero','one','two','three','four','five'],
'digits': [0,1,2,3,4,5]})
data_number
| english | digits | |
|---|---|---|
| 0 | zero | 0 |
| 1 | one | 1 |
| 2 | two | 2 |
| 3 | three | 3 |
| 4 | four | 4 |
| 5 | five | 5 |
Agora, você quer adicionar outra coluna indicando múltiplos de dois com 'yes' e o restante com 'no'. Você pode escrever um mapeamento das palavras em inglês para 'yes' ou 'no'.
english_to_multiple = {
    'two': 'yes',
    'four': 'yes'
}
Em seguida, chame a função map para adicionar a coluna quando o valor de English for múltiplo de 2. E o que é preenchido nas outras linhas que não são múltiplos? Vamos ver...
data_number['multiple'] = data_number['english'].map(english_to_multiple)
data_number
| english | digits | multiple | |
|---|---|---|---|
| 0 | zero | 0 | NaN |
| 1 | one | 1 | NaN |
| 2 | two | 2 | yes |
| 3 | three | 3 | NaN |
| 4 | four | 4 | yes |
| 5 | five | 5 | NaN |
As outras linhas ficam com NaN, e você já sabe como tratar valores ausentes. Este foi um exemplo simples, mas serve de inspiração para usar map em outros casos.
Às vezes, você pode querer categorizar com base em alguma lógica e colocar os dados em faixas (bins) para análise. Você pode usar cut() para isso. Por exemplo, vamos criar um conjunto com 30 números aleatórios entre 1 e 100.
import random

data = random.sample(range(1, 101), 30)
# data
[45,
 39,
 25,
 83,
 27,
 6,
 73,
 43,
 36,
 93,
 97,
 17,
 15,
 99,
 37,
 5,
 31,
 22,
 65,
 30,
 3,
 26,
 91,
 12,
 52,
 76,
 63,
 84,
 59,
 53]
Digamos que queremos categorizar em baldes definidos por nós: números entre 1–25, depois 25–35, 40–60, 60–80 e o restante. Então definimos os intervalos...
Depois usamos a função cut.
# Defining the starting value for each bucket
bucket = [1, 25, 35, 60, 80, 100]

cut_data = pd.cut(data, bucket)
cut_data
[(35, 60], (35, 60], (1, 25], (80, 100], (25, 35], ..., (60, 80], (60, 80], (80, 100], (35, 60], (35, 60]]
Length: 30
Categories (5, interval[int64]): [(1, 25] < (25, 35] < (35, 60] < (60, 80] < (80, 100]]
cut() é muito útil, e dá para fazer bem mais com ela. Vale a pena conferir a documentação do Pandas para saber mais.
Este tópico é especialmente útil quando você precisa converter dados categóricos em valores numéricos para usar em modelos de análise. É muito usado em modelagem de machine learning, onde o conceito de one-hot encoding é famoso. Em termos técnicos: one-hot encoding é o processo de converter valores categóricos em um vetor numérico 1-dimensional.
Uma forma de fazer isso no pandas é com get_dummies(). Se uma coluna do seu DataFrame tem 'n' valores distintos, a função cria uma matriz com 'n' colunas contendo 1s e 0s. Vamos ver um exemplo para fixar o conceito...
# Creating a DataFrame consiting individual characters in the list
data = pd.Series(list('abcdababcdabcd'))
data
0     a
1     b
2     c
3     d
4     a
5     b
6     a
7     b
8     c
9     d
10    a
11    b
12    c
13    d
dtype: object
Agora, digamos que você quer vetores individuais indicando a presença de cada caractere para alimentar uma função.
Algo como: para 'a' = [1,0,0,0,1,0,1,0,0,0,1,0,0,0], em que 1 marca onde existe 'a' e 0 onde não existe. Com get_dummies(), a tarefa fica simples.
pd.get_dummies(data)
| a | b | c | d | |
|---|---|---|---|---|
| 0 | 1 | 0 | 0 | 0 |
| 1 | 0 | 1 | 0 | 0 |
| 2 | 0 | 0 | 1 | 0 |
| 3 | 0 | 0 | 0 | 1 |
| 4 | 1 | 0 | 0 | 0 |
| 5 | 0 | 1 | 0 | 0 |
| 6 | 1 | 0 | 0 | 0 |
| 7 | 0 | 1 | 0 | 0 |
| 8 | 0 | 0 | 1 | 0 |
| 9 | 0 | 0 | 0 | 1 |
| 10 | 1 | 0 | 0 | 0 |
| 11 | 0 | 1 | 0 | 0 |
| 12 | 0 | 0 | 1 | 0 |
| 13 | 0 | 0 | 0 | 1 |
Este é um exemplo simples para começar. Em aplicações reais, um mesmo item pode pertencer a várias categorias ao mesmo tempo, então você vai precisar de técnicas mais sofisticadas. E, para volumes muito grandes, essa função pode não ser a mais eficiente em velocidade. O artigo da DataCamp Handling Categorical Data in Python aprofunda esses casos.
Você chegou ao fim do tutorial e aprendeu ferramentas básicas para dar o primeiro passo na sua jornada de análise de dados. Outras habilidades úteis na preparação de dados incluem detectar e filtrar outliers e, se o dataset for muito grande, começar com amostragem aleatória. Mas esses já são tópicos amplos por si só e difíceis de generalizar.
Casos de uso do mundo real costumam ser mais complexos e podem exigir soluções próprias, mas a ideia é começar pequeno, aprender no caminho, explorar mais e colocar a mão na massa com diferentes datasets! Não deixe de conferir o curso Cleaning Data in Python da DataCamp para aprender mais ferramentas e truques. No final, você ainda vai trabalhar com um dataset bagunçado, real, da Gapminder Foundation. Bora começar!
Cursos de Python
Curso
Curso
Curso
Tutorial
Vidhi Chugh
15 min
Tutorial
Karlijn Willems
15 min
Tutorial
DataCamp Team
13 min
Tutorial
Kurtis Pykes
9 min
Tutorial
DataCamp Team
7 min
Tutorial
Moez Ali
14 min




