Kurs
Einführung in Python
4 Std.
7M
Dieses Tutorial führt dich durch grundlegende Konzepte und Schritte der Datenaufbereitung. Die Datenaufbereitung ist der erste Schritt, sobald du ein Dataset in den Händen hast. In diesem Schritt verarbeitest du Rohdaten vor, sodass sie sich leicht und präzise analysieren lassen. Saubere Datenaufbereitung ermöglicht eine effiziente Analyse – sie kann Fehler und Ungenauigkeiten aus dem Datenerhebungsprozess beseitigen und dadurch Verzerrungen durch schlechte Datenqualität reduzieren. Deshalb fließt ein Großteil der Arbeitszeit von Analysten in diesen entscheidenden Schritt.
Daten laden, Daten bereinigen (unnötige oder fehlerhafte Daten entfernen), Formate transformieren und Daten umstrukturieren – all das gehört zur Datenaufbereitung. In diesem Tutorial arbeitest du dafür mit Pythons pandas-Bibliothek.
Stelle sicher, dass du Konzepte wie das pandas DataFrame, Series usw. kennst, denn sie tauchen hier häufig auf. Mehr zu pandas lernst du im Pandas-Tutorial von DataCamp.
In diesem Tutorial:
Unterwegs findest du Tipps, Tricks und Verweise auf vertiefendes Material, falls du tiefer einsteigen möchtest.
Los geht’s mit einer kurzen Einführung in pandas ...
pandas ist eine für Python geschriebene Softwarebibliothek. Sie ist in der Data-Science-Community sehr beliebt, weil sie mächtige, ausdrucksstarke und flexible Datenstrukturen bietet, die Datenmanipulation und -analyse einfach machen – und sie ist frei verfügbar. Wenn du einen speziellen, neuen Use Case hast, kannst du ihn sogar auf einer der Python-Mailinglisten oder auf der pandas GitHub-Seite teilen – tatsächlich sind viele Funktionen in pandas durch reale Anwendungsfälle entstanden.
Für einen gelungenen Einstieg in pandas schau dir den Pandas Foundation Course von DataCamp an. Er ist sehr interaktiv, und das erste Kapitel ist kostenlos!
Um die pandas-Bibliothek zu verwenden, musst du sie zuerst importieren. Tippe dazu in deine Python-Konsole:
import pandas as pdDer erste Schritt der Datenaufbereitung ist – klar – Daten zu besorgen. Wenn du eine .csv-Datei hast, kannst du sie mit der Funktion .read_csv() in pandas ganz einfach laden. Dann etwa so:
data = pd.read_csv('path_to_file.csv')
Für dieses Tutorial arbeitest du jedoch mit kleineren, leicht nachvollziehbaren DataFrames und Series, die wir ad hoc erstellen.
Das ist ein sehr verbreitetes Problem in der Datenanalyse.
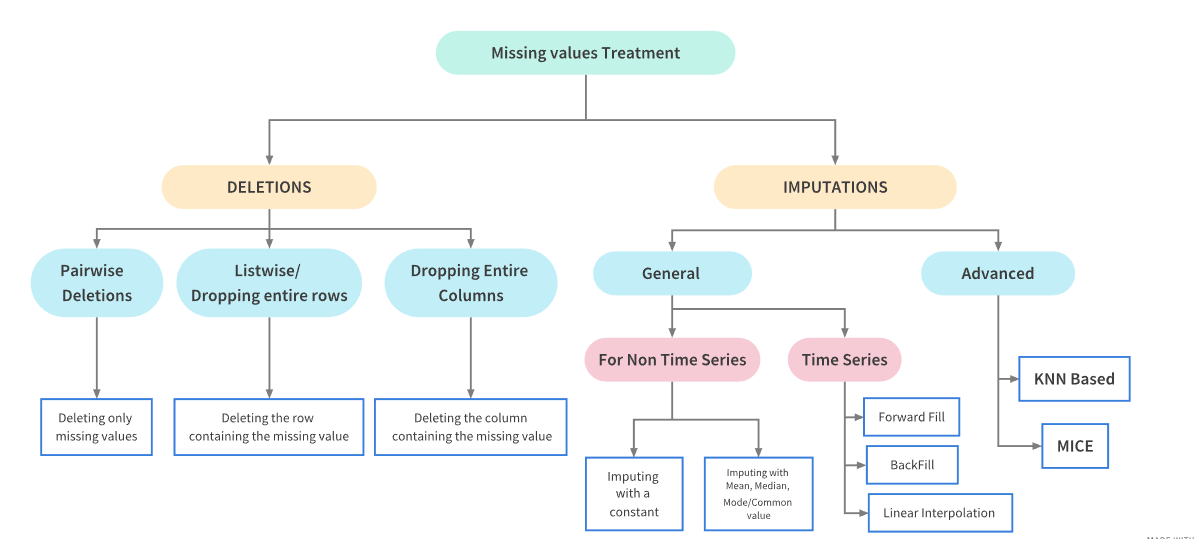
Fehlende Daten können aus unterschiedlichen Gründen entstehen: Ein Feld wurde vom User oder der Erfassungsanwendung nicht ausgefüllt, Daten gingen bei manueller Übertragung verloren, ein Programmierfehler usw. Manchmal ist es wichtig, die Ursache zu verstehen, denn sie beeinflusst, wie du damit umgehst. Darauf kommen wir später zurück. Fokussieren wir uns zunächst darauf, was du tun kannst, wenn Daten fehlen ...
Für numerische Daten verwendet pandas den Fließkommawert NaN (Not a Number), um fehlende Daten darzustellen. Er ist als spezieller Wert in der Bibliothek NumPy definiert, daher müssen wir diese ebenfalls importieren. NaN ist aus Gründen der Rechengeschwindigkeit und Bequemlichkeit der Standardmarker für fehlende Werte. Es handelt sich um einen sogenannten Sentinel-Wert, also einen leicht erkennbaren Platzhalter, mit dem pandas-Funktionen gut umgehen können.
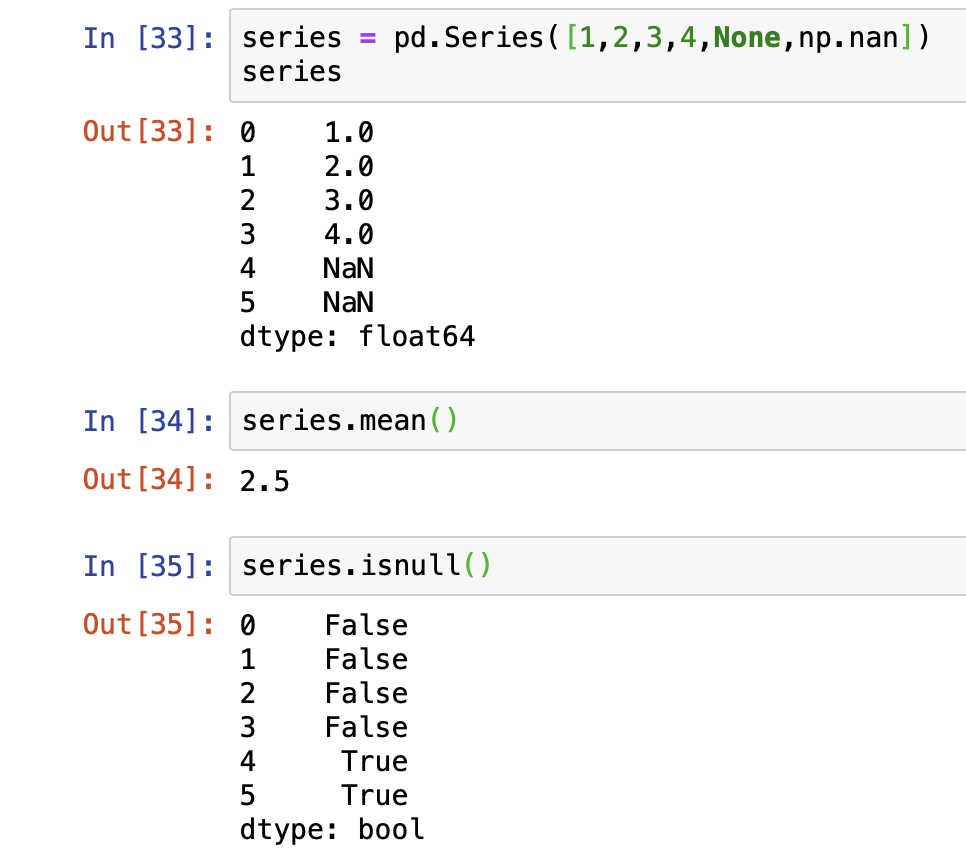
Lass uns mit ein paar Daten spielen ...
import numpy as np

# Creating a pandas series
data = pd.Series([0, 1, 2, 3, 4, 5, np.nan, 6, 7, 8])

# To check if and what index in the dataset contains null value
data.isnull()
0    False
1    False
2    False
3    False
4    False
5    False
6     True
7    False
8    False
9    False
dtype: bool
Oben haben wir die Funktion isnull() verwendet, die einen booleschen Wert zurückgibt: True, wenn der Wert an diesem Index fehlt (NaN). Das Gegenstück dazu ist die Funktion notnull().
# To check where the dataset does not contain null value - opposite of isnull()
data.notnull()
0     True
1     True
2     True
3     True
4     True
5     True
6    False
7     True
8     True
9     True
dtype: bool
Außerdem können wir mit der Funktion dropna() fehlende Daten herausfiltern, also Nullwerte entfernen und nur die nicht-leeren Werte sehen. Der NaN-Wert wird dabei jedoch nicht wirklich gelöscht und ist im Originaldatensatz weiterhin vorhanden.
# Will not show the index 6 cause it contains null (NaN) value
data.dropna()
0    0.0
1    1.0
2    2.0
3    3.0
4    4.0
5    5.0
7    6.0
8    7.0
9    8.0
dtype: float64
data
0    0.0
1    1.0
2    2.0
3    3.0
4    4.0
5    5.0
6    NaN
7    6.0
8    7.0
9    8.0
dtype: float64
Um NaN wirklich zu „droppen“ bzw. zu löschen, kannst du entweder den neuen Datensatz ohne NaN separat speichern, damit die ursprüngliche Series unangetastet bleibt, oder das Drop inplace anwenden. Das Argument inplace ist standardmäßig auf false gesetzt.
not_null_data = data.dropna()
not_null_data
0    0.0
1    1.0
2    2.0
3    3.0
4    4.0
5    5.0
7    6.0
8    7.0
9    8.0
dtype: float64
# Drop the 6th index in the original 'data' since it has a NaN place
data.dropna(inplace = True)
data
0    0.0
1    1.0
2    2.0
3    3.0
4    4.0
5    5.0
7    6.0
8    7.0
9    8.0
dtype: float64
DataFrames sind jedoch oft zweidimensional und damit komplexer, also mit Zeilen und Spalten. pandas hat auch dafür passende Funktionen ...
# Creating a dataframe with 4 rows and 4 columns (4*4 matrix)
data_dim = pd.DataFrame([[1,2,3,np.nan],[4,5,np.nan,np.nan],[7,np.nan,np.nan,np.nan],[np.nan,np.nan,np.nan,np.nan]])
data_dim
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | NaN | NaN |
| 2 | 7.0 | NaN | NaN | NaN |
| 3 | NaN | NaN | NaN | NaN |
Angenommen, du möchtest nur Zeilen oder Spalten droppen, die komplett leer sind, oder nur solche, die mehr als eine bestimmte Anzahl an Nullwerten enthalten. Schau dir die folgenden Fälle an. Denk daran: Das Drop passiert hier nicht inplace, der Originaldatensatz bleibt also unverändert. Achte auf die übergebenen Argumente der Funktion dropna(), um das Verhalten zu steuern.
# Drop all rows and columns containing NaN value
data_dim.dropna()
| 0 | 1 | 2 | 3 |
|---|
# Drop all rows and columns containing entirely of NaN value
data_dim.dropna(how = 'all')
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | NaN | NaN |
| 2 | 7.0 | NaN | NaN | NaN |
# Drop only columns that contain entirely NaN value
# Default is 0 - which signifies rows
data_dim.dropna(axis = 1, how = 'all')
| 0 | 1 | 2 | |
|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 |
| 1 | 4.0 | 5.0 | NaN |
| 2 | 7.0 | NaN | NaN |
| 3 | NaN | NaN | NaN |
# Drop all columns that have more than 2 NaN values
data_dim.dropna(axis = 1, thresh = 2)
| 0 | 1 | |
|---|---|---|
| 0 | 1.0 | 2.0 |
| 1 | 4.0 | 5.0 |
| 2 | 7.0 | NaN |
| 3 | NaN | NaN |
# Drop all rows that have more than 2 NaN values
data_dim.dropna(thresh = 2)
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | NaN | NaN |
Jetzt weißt du, wie du fehlende Werte erkennst und droppst – sei es, um das Ergebnis zu inspizieren oder per inplace dauerhaft zu löschen. Oft ist reines Droppen jedoch nicht sinnvoll, dann möchtest du die Lücken mit anderen Werten füllen. Schauen wir uns das an ...
Zum Ersetzen bzw. „Auffüllen“ fehlender Werte kannst du die Funktion fillna() verwenden. Nehmen wir wieder den obigen Datensatz und füllen NaN-Werte mit 0.
# Check what the dataset looks like again
data_dim
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | NaN | NaN |
| 2 | 7.0 | NaN | NaN | NaN |
| 3 | NaN | NaN | NaN | NaN |
# Fill the NaN values with 0
data_dim_fill = data_dim.fillna(0)
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | 0.0 |
| 1 | 4.0 | 5.0 | 0.0 | 0.0 |
| 2 | 7.0 | 0.0 | 0.0 | 0.0 |
| 3 | 0.0 | 0.0 | 0.0 | 0.0 |
Wie bei dropna() gibt es viele Varianten, abhängig von den übergebenen Argumenten. Denk auch hier daran: Mit inplace = True änderst du den Originaldatensatz.
# Pass a dictionary to use differnt values for each column
data_dim_fill = data_dim.fillna({0: 0, 1: 8, 2: 9, 3: 10})
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | 10.0 |
| 1 | 4.0 | 5.0 | 9.0 | 10.0 |
| 2 | 7.0 | 8.0 | 9.0 | 10.0 |
| 3 | 0.0 | 8.0 | 9.0 | 10.0 |
Du kannst das Argument method an fillna() übergeben, um Nicht-Null-Werte automatisch vorwärts (ffill oder pad) bzw. rückwärts (bfill oder backfill) fortzuschreiben.
# Pass method to determine how to fill-up the column - forward here
data_dim_fill = data_dim.fillna(method='ffill')
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | 3.0 | NaN |
| 2 | 7.0 | 5.0 | 3.0 | NaN |
| 3 | 7.0 | 5.0 | 3.0 | NaN |
Du kannst die Anzahl der Füllungen auch begrenzen. Beispielsweise nur zwei Positionen pro Spalte auffüllen. Mit axis = 1 füllst du entsprechend zeilenweise.
# Pass method to determine how to fill-up the column - forward here
data_dim_fill = data_dim.fillna(method='ffill', limit = 2)
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | 3.0 | NaN |
| 2 | 7.0 | 5.0 | 3.0 | NaN |
| 3 | 7.0 | 5.0 | NaN | NaN |
# Pass method to determine how to fill-up the row - forward here
data_dim_fill = data_dim.fillna(axis = 1, method='ffill')
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | 3.0 |
| 1 | 4.0 | 5.0 | 5.0 | 5.0 |
| 2 | 7.0 | 7.0 | 7.0 | 7.0 |
| 3 | NaN | NaN | NaN | NaN |
Mit Verständnis für deine Daten und den Use Case kannst du fillna() weit mehr als nur mit Zahlen füllen. Du könntest z. B. den Mittelwert mit mean() oder den Median mit median() verwenden ...
# Check the data_dim dataset
data_dim
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | NaN | NaN |
| 2 | 7.0 | NaN | NaN | NaN |
| 3 | NaN | NaN | NaN | NaN |
# Fill the NaN value with mean values in the corresponding column
data_dim_fill = data_dim.fillna(data_dim.mean())
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | 3.0 | NaN |
| 2 | 7.0 | 3.5 | 3.0 | NaN |
| 3 | 4.0 | 3.5 | 3.0 | NaN |
Bislang hast du nur mit fehlenden Werten (NaN) gearbeitet, aber es gibt Situationen, in denen du einen vorhandenen Wert durch einen anderen ersetzen willst. Oder ein fehlender Wert wurde als Zufallszahl erfasst und sollte deshalb als NaN statt als Zahl behandelt werden. Hier hilft die Funktion replace() ...
Lass uns diesmal einen anderen Datensatz erstellen.
data = pd.Series([1,2,-99,4,5,-99,7,8,-99])
data
0     1
1     2
2   -99
3     4
4     5
5   -99
6     7
7     8
8   -99
dtype: int64
# Replace the placeholder -99 as NaN
data.replace(-99, np.nan)
0    0.0
1    1.0
2    2.0
3    3.0
4    4.0
5    5.0
7    6.0
8    7.0
9    8.0
dtype: float64
Der Wert -99 wird nicht mehr angezeigt, weil er durch NaN ersetzt wurde. Ebenso kannst du mehrere Werte ersetzen. Dafür erstellen wir eine weitere Series, verketten sie mit der ursprünglichen und wenden dann das Ersetzen für mehrere Werte an.
Dazu nutzt du die Funktion concat() in pandas. Damit die Indizes nach dem Verketten fortlaufend sind, übergibst du das Argument ignore_index = True.
# Create a new Series
new_data = pd.Series([-100, 11, 12, 13])
combined_series = pd.concat([data, new_data], ignore_index = True)
combined_series
0       1
1       2
2     -99
3       4
4       5
5     -99
6       7
7       8
8     -99
9    -100
10     11
11     12
12     13
dtype: int64
# Let's replace -99 and -100 as NaN in the new combined_series
data_replaced = combined_series.replace([-99, -100], np.nan)
data_replaced
0      1.0
1      2.0
2      NaN
3      4.0
4      5.0
5      NaN
6      7.0
7      8.0
8      NaN
9      NaN
10    11.0
11    12.0
12    13.0
dtype: float64
# Argument passed can also be a dictionary with separate values
data_replaced = combined_series.replace({-99: np.nan, -100: 0})

# Same as: new_data.replace([-99, -100], [np.nan, 0])
data_replaced
0      1.0
1      2.0
2      NaN
3      4.0
4      5.0
5      NaN
6      7.0
7      8.0
8      NaN
9      0.0
10    11.0
11    12.0
12    13.0
dtype: float64
In manchen Situationen möchtest du auf Basis einer Logik zusätzliche Information zu deinen Daten ergänzen. Dabei helfen Mappings und Funktionskombinationen. Die Logik kann komplexer werden, aber das Prinzip zeigt dieses Beispiel.
Angenommen, du hast ein DataFrame mit Zahlen und deren englischen Schreibweisen.
data_number = pd.DataFrame({'english': ['zero','one','two','three','four','five'],
'digits': [0,1,2,3,4,5]})
data_number
| english | digits | |
|---|---|---|
| 0 | zero | 0 |
| 1 | one | 1 |
| 2 | two | 2 |
| 3 | three | 3 |
| 4 | four | 4 |
| 5 | five | 5 |
Nun willst du eine weitere Spalte hinzufügen, die Vielfache von zwei als „Yes“ markiert, den Rest als „No“. Du kannst dazu ein Mapping von jeder eindeutigen englischen Bezeichnung auf „Yes“ oder „No“ anlegen.
english_to_multiple = {
    'two': 'yes',
    'four': 'yes'
}
Dann rufst du die map-Funktion auf, um die Spalte zu füllen, wenn der Eintrag in der Spalte „english“ ein Vielfaches von 2 ist. Was steht in den übrigen Zeilen? Finde es heraus ...
data_number['multiple'] = data_number['english'].map(english_to_multiple)
data_number
| english | digits | multiple | |
|---|---|---|---|
| 0 | zero | 0 | NaN |
| 1 | one | 1 | NaN |
| 2 | two | 2 | yes |
| 3 | three | 3 | NaN |
| 4 | four | 4 | yes |
| 5 | five | 5 | NaN |
Die anderen Zeilen enthalten NaN – und du weißt bereits, wie du mit Missing Values weiterarbeitest. Das war ein einfaches Beispiel, soll dir aber Ideen geben, wie du map in deinen Use Cases einsetzen kannst.
Manchmal willst du Daten nach einer Logik kategorisieren und in diskrete Gruppen (Bins) einsortieren. Dafür kannst du cut() verwenden. Erstellen wir zunächst 30 Zufallszahlen zwischen 1 und 100.
import random

data = random.sample(range(1, 101), 30)
# data
[45,
 39,
 25,
 83,
 27,
 6,
 73,
 43,
 36,
 93,
 97,
 17,
 15,
 99,
 37,
 5,
 31,
 22,
 65,
 30,
 3,
 26,
 91,
 12,
 52,
 76,
 63,
 84,
 59,
 53]
Angenommen, wir wollen eigene Bins definieren: Zahlen zwischen 1–25, dann 25–35, 40–60, 60–80 und den Rest. Also definieren wir die Grenzen ...
Dann nutzen wir die cut-Funktion.
# Defining the starting value for each bucket
bucket = [1, 25, 35, 60, 80, 100]

cut_data = pd.cut(data, bucket)
cut_data
[(35, 60], (35, 60], (1, 25], (80, 100], (25, 35], ..., (60, 80], (60, 80], (80, 100], (35, 60], (35, 60]]
Length: 30
Categories (5, interval[int64]): [(1, 25] < (25, 35] < (35, 60] < (60, 80] < (80, 100]]
cut() ist sehr nützlich, und du kannst noch viel mehr damit machen. Lies dazu am besten die pandas-Dokumentation.
Dieses Thema ist besonders hilfreich, wenn du kategoriale Daten in numerische Werte umwandeln willst, um sie in Analysemodellen zu verwenden. Gerade im Machine Learning ist One-Hot-Encoding verbreitet. Technisch gesprochen: One-Hot-Encoding wandelt kategoriale Werte in einen eindimensionalen numerischen Vektor um.
In pandas gelingt das unter anderem mit get_dummies(). Wenn eine Spalte in deinem DataFrame „n“ unterschiedliche Werte hat, erzeugt die Funktion eine Matrix mit „n“ Spalten aus 1ern und 0ern. Schauen wir uns ein Beispiel an ...
# Creating a DataFrame consiting individual characters in the list
data = pd.Series(list('abcdababcdabcd'))
data
0     a
1     b
2     c
3     d
4     a
5     b
6     a
7     b
8     c
9     d
10    a
11    b
12    c
13    d
dtype: object
Jetzt willst du einzelne Vektoren, die das Vorkommen jedes Zeichens anzeigen, um sie einer Funktion zu übergeben.
Zum Beispiel für „a“ = [1,0,0,0,1,0,1,0,0,0,1,0,0,0], wobei 1 dort steht, wo „a“ vorkommt, und 0, wo nicht. Mit get_dummies() wird das einfach.
pd.get_dummies(data)
| a | b | c | d | |
|---|---|---|---|---|
| 0 | 1 | 0 | 0 | 0 |
| 1 | 0 | 1 | 0 | 0 |
| 2 | 0 | 0 | 1 | 0 |
| 3 | 0 | 0 | 0 | 1 |
| 4 | 1 | 0 | 0 | 0 |
| 5 | 0 | 1 | 0 | 0 |
| 6 | 1 | 0 | 0 | 0 |
| 7 | 0 | 1 | 0 | 0 |
| 8 | 0 | 0 | 1 | 0 |
| 9 | 0 | 0 | 0 | 1 |
| 10 | 1 | 0 | 0 | 0 |
| 11 | 0 | 1 | 0 | 0 |
| 12 | 0 | 0 | 1 | 0 |
| 13 | 0 | 0 | 0 | 1 |
Das ist ein einfaches Beispiel zum Einstieg. In realen Szenarien kann ein Zeichen mehreren Kategorien gleichzeitig angehören – dann brauchst du ausgefeiltere Methoden. Und bei sehr großen Datenmengen kann diese Funktion in Sachen Performance an Grenzen stoßen. DataCamps Handling Categorical Data in Python geht auf solche Fälle und das Thema insgesamt tiefer ein.
Du bist am Ende des Tutorials angekommen und hast erste Werkzeuge für den Start in die Datenanalyse kennengelernt. Weitere nützliche Skills für die Datenaufbereitung sind das Erkennen und Filtern von Ausreißern und – bei sehr großen Datasets – der Start mit einer Zufallsstichprobe. Das sind jedoch wieder eigene, umfangreiche Themen.
Reale Anwendungsfälle sind oft komplexer und brauchen individuelle Lösungen, aber der Trick ist: klein anfangen, unterwegs lernen und unterschiedliche Datasets praktisch erkunden. Schau dir unbedingt den Kurs DataCamp's Cleaning Data in Python an, um weitere Tools und Kniffe zu lernen. Am Ende arbeitest du damit an einem echten, unaufgeräumten Datensatz der Gapminder Foundation. Leg los!
Python-Kurse
Kurs
Kurs
Kurs