Cours
Introduction à Python
4 h
7M
Ce tutoriel vous guide à travers des concepts et étapes de base pour préparer des données. La préparation des données est la première étape dès que vous mettez la main sur un jeu de données. Il s’agit de transformer des données brutes en un format facilement et correctement analysable. Une bonne préparation des données permet une analyse efficace : elle peut éliminer les erreurs et imprécisions survenues lors de la collecte et contribuer à réduire certains biais dus à une mauvaise qualité de données. C’est pourquoi une grande partie du temps d’un analyste est consacrée à cette étape clé.
Charger, nettoyer (supprimer les données inutiles ou erronées), transformer les formats et réorganiser les données sont les étapes principales de la préparation. Dans ce tutoriel, vous utiliserez la bibliothèque Pandas de Python pour préparer vos données.
Assurez-vous de maîtriser des notions comme les DataFrame et Series de pandas, que vous verrez très souvent dans ce tutoriel. Pour aller plus loin, consultez le tutoriel Pandas de DataCamp.
Dans ce tutoriel :
Au fil de l’eau, vous trouverez des conseils pratiques ainsi que des liens vers des ressources approfondies si vous souhaitez creuser un sujet.
Commençons par une courte introduction à Pandas…
Pandas est une bibliothèque logicielle écrite pour Python. Elle est très prisée par la communauté data science car elle propose des structures de données puissantes, expressives et flexibles qui facilitent la manipulation et l’analyse des données — et elle est librement disponible. De plus, si vous avez un cas d’usage spécifique et nouveau, vous pouvez le partager sur l’une des listes de diffusion Python ou sur le GitHub de pandas : en pratique, de nombreuses fonctionnalités de pandas ont été guidées par des cas d’usage réels.
Pour une excellente introduction à pandas, pensez à suivre le cours Pandas Foundation de DataCamp. Il est très interactif et le premier chapitre est gratuit !
Pour utiliser la bibliothèque pandas, vous devez d’abord l’importer. Tapez simplement ceci dans votre console Python :
import pandas as pdLa première étape de la préparation consiste à… obtenir des données. Si vous avez un fichier .csv, vous pouvez le charger facilement avec la fonction .read_csv() de pandas. Vous pouvez ensuite taper :
data = pd.read_csv('path_to_file.csv')
Cependant, pour ce tutoriel, vous allez travailler avec de petits DataFrame et Series simples à comprendre, créés à la volée.
C’est un problème très répandu en analyse de données.
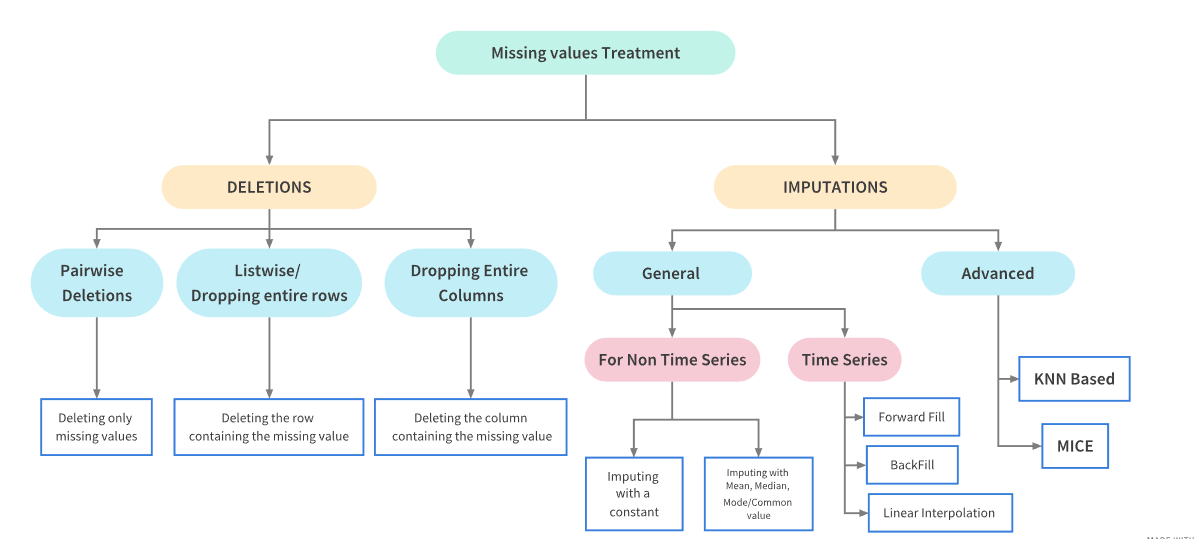
Les données manquantes peuvent apparaître pour de multiples raisons : un champ non renseigné par l’utilisateur ou l’outil de collecte, une perte lors d’un transfert manuel, une erreur de programmation, etc. Il est parfois important d’en comprendre la cause, car elle influencera la manière de traiter ces données. Nous y reviendrons plus tard dans ce tutoriel. Pour l’instant, concentrons-nous sur ce qu’il faut faire lorsque vous avez des valeurs manquantes…
Pour les données numériques, pandas utilise la valeur flottante NaN (Not a Number) pour représenter les données manquantes. C’est une valeur unique définie dans la bibliothèque NumPy, que nous devons donc aussi importer. NaN est l’indicateur de valeur manquante par défaut pour des raisons de performance et de praticité. C’est une valeur sentinelle, c’est-à-dire une valeur factice/indicatrice facilement détectable et manipulable avec les fonctions de pandas.
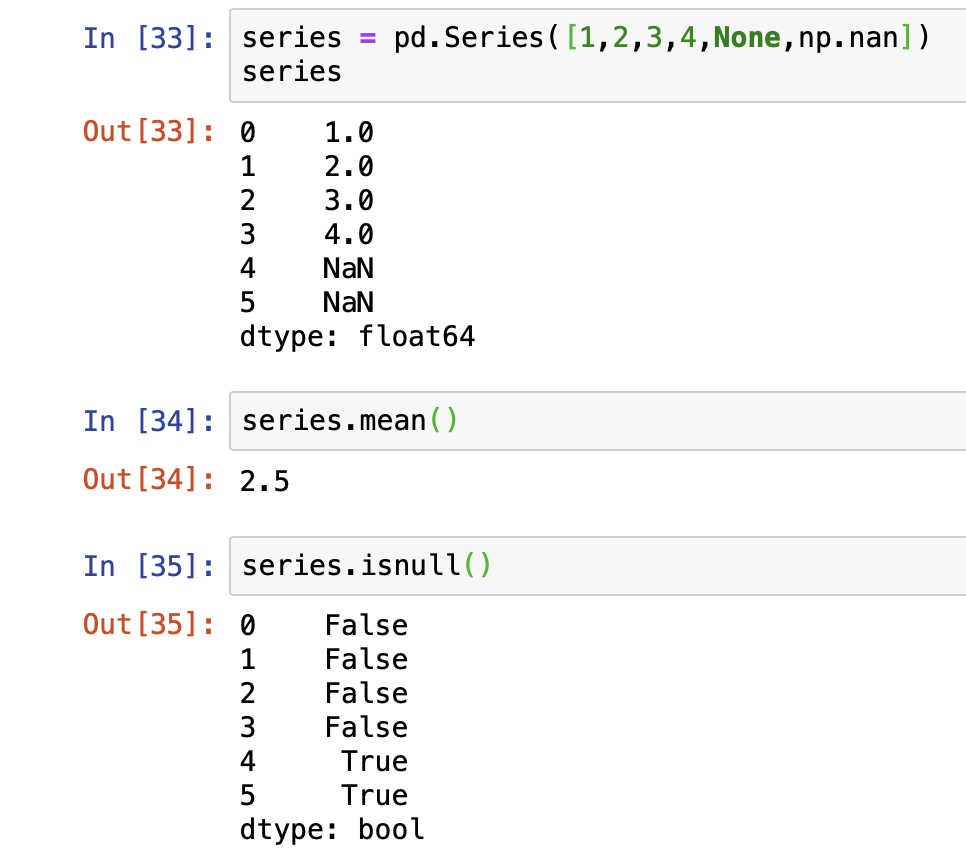
Jouons un peu avec des données…
import numpy as np

# Création d'une Series pandas
data = pd.Series([0, 1, 2, 3, 4, 5, np.nan, 6, 7, 8])

# Vérifier si et quels index du jeu de données contiennent une valeur nulle
data.isnull()
0    False
1    False
2    False
3    False
4    False
5    False
6     True
7    False
8    False
9    False
dtype: bool
Ci-dessus, nous avons utilisé la fonction isnull() qui renvoie un booléen vrai ou faux. True lorsque la donnée à cet index est manquante (NaN). L’inverse est la fonction notnull().
# Vérifier où le jeu de données ne contient pas de valeur nulle - inverse de isnull()
data.notnull()
0     True
1     True
2     True
3     True
4     True
5     True
6    False
7     True
8     True
9     True
dtype: bool
Nous pouvons aussi utiliser la fonction dropna() pour filtrer les données manquantes, retirer les valeurs nulles et n’afficher que les valeurs non nulles. Toutefois, la valeur NaN n’est pas réellement supprimée et reste présente dans le jeu de données original.
# N'affichera pas l'index 6 car il contient une valeur nulle (NaN)
data.dropna()
0    0.0
1    1.0
2    2.0
3    3.0
4    4.0
5    5.0
7    6.0
8    7.0
9    8.0
dtype: float64
data
0    0.0
1    1.0
2    2.0
3    3.0
4    4.0
5    5.0
6    NaN
7    6.0
8    7.0
9    8.0
dtype: float64
Pour vraiment « supprimer » la valeur NaN, vous pouvez soit enregistrer le nouveau jeu de données (sans NaN) afin de ne pas modifier la Series originale, soit appliquer la suppression inplace. L’argument inplace vaut false par défaut.
not_null_data = data.dropna()
not_null_data
0    0.0
1    1.0
2    2.0
3    3.0
4    4.0
5    5.0
7    6.0
8    7.0
9    8.0
dtype: float64
# Supprimer l'index 6 dans 'data' car il contient un NaN
data.dropna(inplace = True)
data
0    0.0
1    1.0
2    2.0
3    3.0
4    4.0
5    5.0
7    6.0
8    7.0
9    8.0
dtype: float64
Cependant, les DataFrame peuvent être plus complexes et à 2 dimensions, avec des lignes et des colonnes. Pandas gère aussi très bien ces cas…
# Création d'un DataFrame 4 x 4 (matrice 4*4)
data_dim = pd.DataFrame([[1,2,3,np.nan],[4,5,np.nan,np.nan],[7,np.nan,np.nan,np.nan],[np.nan,np.nan,np.nan,np.nan]])
data_dim
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | NaN | NaN |
| 2 | 7.0 | NaN | NaN | NaN |
| 3 | NaN | NaN | NaN | NaN |
Supposons maintenant que vous ne souhaitiez supprimer que les lignes ou colonnes entièrement nulles, ou seulement celles qui contiennent un certain nombre de valeurs nulles. Testez les différents scénarios ci-dessous ; souvenez-vous que la suppression ne se fait pas inplace, donc l’ensemble de données original n’est pas modifié. Faites attention aux arguments de la fonction dropna() pour piloter la suppression.
# Supprimer toutes les lignes et colonnes contenant au moins un NaN
data_dim.dropna()
| 0 | 1 | 2 | 3 |
|---|
# Supprimer toutes les lignes et colonnes entièrement composées de NaN
data_dim.dropna(how = 'all')
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | NaN | NaN |
| 2 | 7.0 | NaN | NaN | NaN |
# Supprimer uniquement les colonnes entièrement NaN
# Par défaut axis=0 - lignes
data_dim.dropna(axis = 1, how = 'all')
| 0 | 1 | 2 | |
|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 |
| 1 | 4.0 | 5.0 | NaN |
| 2 | 7.0 | NaN | NaN |
| 3 | NaN | NaN | NaN |
# Supprimer toutes les colonnes ayant plus de 2 valeurs NaN
data_dim.dropna(axis = 1, thresh = 2)
| 0 | 1 | |
|---|---|---|
| 0 | 1.0 | 2.0 |
| 1 | 4.0 | 5.0 |
| 2 | 7.0 | NaN |
| 3 | NaN | NaN |
# Supprimer toutes les lignes ayant plus de 2 valeurs NaN
data_dim.dropna(thresh = 2)
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | NaN | NaN |
Vous savez maintenant identifier et supprimer des valeurs manquantes — que ce soit pour visualiser le résultat ou effectuer une suppression inplace. Dans bien des cas, supprimer n’est pas envisageable, et vous voudrez plutôt renseigner les valeurs manquantes avec d’autres valeurs. Voyons comment faire…
Pour remplacer ou « remplir » les valeurs nulles, vous pouvez utiliser la fonction fillna(). Par exemple, reprenons le même jeu de données que ci-dessus et remplissons les NaN avec 0.
# Vérifier à nouveau l'état du jeu de données
data_dim
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | NaN | NaN |
| 2 | 7.0 | NaN | NaN | NaN |
| 3 | NaN | NaN | NaN | NaN |
# Remplir les valeurs NaN avec 0
data_dim_fill = data_dim.fillna(0)
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | 0.0 |
| 1 | 4.0 | 5.0 | 0.0 | 0.0 |
| 2 | 7.0 | 0.0 | 0.0 | 0.0 |
| 3 | 0.0 | 0.0 | 0.0 | 0.0 |
Comme avec dropna(), vous pouvez faire bien d’autres choses selon les arguments fournis. Rappel : passer l’argument inplace = True modifiera le jeu de données original.
# Passer un dictionnaire pour utiliser des valeurs différentes par colonne
data_dim_fill = data_dim.fillna({0: 0, 1: 8, 2: 9, 3: 10})
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | 10.0 |
| 1 | 4.0 | 5.0 | 9.0 | 10.0 |
| 2 | 7.0 | 8.0 | 9.0 | 10.0 |
| 3 | 0.0 | 8.0 | 9.0 | 10.0 |
Vous pouvez passer un argument method à fillna() pour propager automatiquement les valeurs non nulles vers l’avant (ffill ou pad) ou vers l’arrière (bfill ou backfill).
# Déterminer la méthode de remplissage de la colonne - propagation vers l'avant ici
data_dim_fill = data_dim.fillna(method='ffill')
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | 3.0 | NaN |
| 2 | 7.0 | 5.0 | 3.0 | NaN |
| 3 | 7.0 | 5.0 | 3.0 | NaN |
Vous pouvez aussi limiter le nombre de remplissages. Par exemple, ne remplir que deux positions dans les colonnes… De plus, si vous passez axis = 1, le remplissage s’effectuera ligne par ligne.
# Déterminer la méthode de remplissage de la colonne - propagation vers l'avant ici
data_dim_fill = data_dim.fillna(method='ffill', limit = 2)
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | 3.0 | NaN |
| 2 | 7.0 | 5.0 | 3.0 | NaN |
| 3 | 7.0 | 5.0 | NaN | NaN |
# Déterminer la méthode de remplissage de la ligne - propagation vers l'avant ici
data_dim_fill = data_dim.fillna(axis = 1, method='ffill')
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | 3.0 |
| 1 | 4.0 | 5.0 | 5.0 | 5.0 |
| 2 | 7.0 | 7.0 | 7.0 | 7.0 |
| 3 | NaN | NaN | NaN | NaN |
Avec une bonne compréhension de vos données et de votre cas d’usage, vous pouvez utiliser fillna() de bien d’autres façons que de simples nombres. Vous pouvez, par exemple, renseigner avec la moyenne via mean() ou la médiane via median()…
# Vérifier le jeu de données data_dim
data_dim
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | NaN | NaN |
| 2 | 7.0 | NaN | NaN | NaN |
| 3 | NaN | NaN | NaN | NaN |
# Remplir les NaN par la moyenne de la colonne correspondante
data_dim_fill = data_dim.fillna(data_dim.mean())
data_dim_fill
| 0 | 1 | 2 | 3 | |
|---|---|---|---|---|
| 0 | 1.0 | 2.0 | 3.0 | NaN |
| 1 | 4.0 | 5.0 | 3.0 | NaN |
| 2 | 7.0 | 3.5 | 3.0 | NaN |
| 3 | 4.0 | 3.5 | 3.0 | NaN |
Jusqu’ici, vous n’avez travaillé qu’avec des valeurs manquantes (NaN), mais il peut arriver que vous deviez remplacer une valeur non nulle par une autre. Ou bien une valeur manquante a été encodée par un nombre arbitraire et doit être traitée comme NaN plutôt que comme un nombre. C’est là que la fonction replace() est très utile…
Créons cette fois un jeu de données différent.
data = pd.Series([1,2,-99,4,5,-99,7,8,-99])
data
0     1
1     2
2   -99
3     4
4     5
5   -99
6     7
7     8
8   -99
dtype: int64
# Remplacer le marqueur -99 par NaN
data.replace(-99, np.nan)
0    0.0
1    1.0
2    2.0
3    3.0
4    4.0
5    5.0
7    6.0
8    7.0
9    8.0
dtype: float64
Vous ne voyez plus le -99, car il a été remplacé par NaN et n’est donc pas affiché. De la même manière, vous pouvez remplacer plusieurs valeurs à la fois. Pour cela, créons une autre Series, concaténons-la avec la Series d’origine, puis appliquons un remplacement multiple.
Pour ce faire, utilisez la fonction concat() de pandas. Pour réindexer de manière continue après concaténation, passez l’argument ignore_index = True.
# Créer une nouvelle Series
new_data = pd.Series([-100, 11, 12, 13])
combined_series = pd.concat([data, new_data], ignore_index = True)
combined_series
0       1
1       2
2     -99
3       4
4       5
5     -99
6       7
7       8
8     -99
9    -100
10     11
11     12
12     13
dtype: int64
# Remplaçons -99 et -100 par NaN dans combined_series
data_replaced = combined_series.replace([-99, -100], np.nan)
data_replaced
0      1.0
1      2.0
2      NaN
3      4.0
4      5.0
5      NaN
6      7.0
7      8.0
8      NaN
9      NaN
10    11.0
11    12.0
12    13.0
dtype: float64
# L'argument peut aussi être un dictionnaire avec des remplacements distincts
data_replaced = combined_series.replace({-99: np.nan, -100: 0})

# Équivalent à : new_data.replace([-99, -100], [np.nan, 0])
data_replaced
0      1.0
1      2.0
2      NaN
3      4.0
4      5.0
5      NaN
6      7.0
7      8.0
8      NaN
9      0.0
10    11.0
11    12.0
12    13.0
dtype: float64
Dans certaines situations, vous souhaiterez enrichir vos données en ajoutant de l’information selon une logique métier. Vous pouvez pour cela utiliser des mappings et des fonctions combinées. La logique peut devenir plus complexe, mais comprenez le principe avec cet exemple.
Supposons que vous ayez un DataFrame associant des nombres à leur écriture en anglais.
data_number = pd.DataFrame({'english': ['zero','one','two','three','four','five'],
'digits': [0,1,2,3,4,5]})
data_number
| english | digits | |
|---|---|---|
| 0 | zero | 0 |
| 1 | one | 1 |
| 2 | two | 2 |
| 3 | three | 3 |
| 4 | four | 4 |
| 5 | five | 5 |
Imaginons maintenant que vous souhaitiez ajouter une colonne indiquant les multiples de deux par « yes » et les autres par « No ». Vous pouvez écrire une correspondance pour chaque mot anglais distinct vers « yes » ou « No ».
english_to_multiple = {
    'two': 'yes',
    'four': 'yes'
}
Appelez ensuite la fonction map pour ajouter la colonne lorsque l’anglais correspond à un multiple de 2. Qu’est-ce qui est rempli pour les autres valeurs non multiples ? Voyons…
data_number['multiple'] = data_number['english'].map(english_to_multiple)
data_number
| english | digits | multiple | |
|---|---|---|---|
| 0 | zero | 0 | NaN |
| 1 | one | 1 | NaN |
| 2 | two | 2 | yes |
| 3 | three | 3 | NaN |
| 4 | four | 4 | yes |
| 5 | five | 5 | NaN |
Les autres lignes sont remplies avec NaN, et vous savez déjà comment traiter ces valeurs manquantes. C’était un exemple simple. Nous espérons qu’il vous inspirera pour utiliser map dans vos cas d’usage spécifiques.
Parfois, vous voudrez catégoriser selon une logique et regrouper vos données en classes (buckets/bins) pour les analyser. Utilisez pour cela la fonction cut(). Par exemple, commençons par créer un jeu de 30 nombres aléatoires entre 1 et 100.
import random

data = random.sample(range(1, 101), 30)
# data
[45,
 39,
 25,
 83,
 27,
 6,
 73,
 43,
 36,
 93,
 97,
 17,
 15,
 99,
 37,
 5,
 31,
 22,
 65,
 30,
 3,
 26,
 91,
 12,
 52,
 76,
 63,
 84,
 59,
 53]
Disons que vous souhaitez les catégoriser selon des intervalles définis : 1–25, puis 25–35, 40–60, 60–80 et le reste. Définissons d’abord les bornes…
Ensuite, utilisons la fonction cut.
# Définir la borne de départ de chaque intervalle
bucket = [1, 25, 35, 60, 80, 100]

cut_data = pd.cut(data, bucket)
cut_data
[(35, 60], (35, 60], (1, 25], (80, 100], (25, 35], ..., (60, 80], (60, 80], (80, 100], (35, 60], (35, 60]]
Length: 30
Categories (5, interval[int64]): [(1, 25] < (25, 35] < (35, 60] < (60, 80] < (80, 100]]
cut() est une fonction très utile qui permet bien plus encore. Nous vous recommandons vivement de consulter la documentation Pandas pour en savoir plus.
Ce sujet est particulièrement utile lorsque vous devez convertir des variables catégorielles en valeurs numériques afin de les utiliser dans un modèle d’analyse. C’est très pratique en apprentissage automatique, où le one-hot encoding est courant. En termes techniques : le one-hot encoding consiste à convertir des valeurs catégorielles en un vecteur numérique unidimensionnel.
Une façon de procéder avec pandas consiste à utiliser la fonction get_dummies(). Si une colonne de votre DataFrame comporte « n » modalités distinctes, la fonction génère une matrice de « n » colonnes contenant des 1 et des 0. Voyons un exemple pour bien saisir le concept…
# Création d'une Series contenant des caractères individuels
data = pd.Series(list('abcdababcdabcd'))
data
0     a
1     b
2     c
3     d
4     a
5     b
6     a
7     b
8     c
9     d
10    a
11    b
12    c
13    d
dtype: object
Supposons maintenant que vous souhaitiez obtenir des vecteurs indiquant la présence de chaque caractère pour alimenter une fonction.
Par exemple : pour « a » = [1,0,0,0,1,0,1,0,0,0,1,0,0,0], où 1 marque la position où « a » apparaît et 0 ailleurs. La fonction get_dummies() simplifie cette tâche.
pd.get_dummies(data)
| a | b | c | d | |
|---|---|---|---|---|
| 0 | 1 | 0 | 0 | 0 |
| 1 | 0 | 1 | 0 | 0 |
| 2 | 0 | 0 | 1 | 0 |
| 3 | 0 | 0 | 0 | 1 |
| 4 | 1 | 0 | 0 | 0 |
| 5 | 0 | 1 | 0 | 0 |
| 6 | 1 | 0 | 0 | 0 |
| 7 | 0 | 1 | 0 | 0 |
| 8 | 0 | 0 | 1 | 0 |
| 9 | 0 | 0 | 0 | 1 |
| 10 | 1 | 0 | 0 | 0 |
| 11 | 0 | 1 | 0 | 0 |
| 12 | 0 | 0 | 1 | 0 |
| 13 | 0 | 0 | 0 | 1 |
Ceci reste un exemple simple pour démarrer. Dans des applications réelles, un caractère peut appartenir à plusieurs catégories à la fois, ce qui nécessitera des méthodes plus sophistiquées. Et pour des volumes bien plus importants, cette fonction peut ne pas être optimale en vitesse. L’article de DataCamp Handling Categorical Data in Python couvre ces cas et le sujet en profondeur.
Vous arrivez au terme de ce tutoriel et vous avez vu des outils de base pour bien démarrer votre parcours d’analyse de données. Parmi les autres compétences utiles à acquérir pour la préparation des données : détecter et filtrer les valeurs aberrantes, et si le jeu de données est très volumineux, commencer par un échantillonnage aléatoire. Mais ce sont à nouveau des sujets vastes, difficiles à généraliser.
Les cas d’usage réels sont souvent plus complexes et peuvent nécessiter des solutions sur mesure, mais l’idée est de commencer petit, d’apprendre en chemin, d’explorer et de pratiquer sur des jeux de données variés ! N’oubliez pas de consulter le cours Cleaning Data in Python de DataCamp pour découvrir d’autres outils et astuces ; vous travaillerez, en fin de parcours, sur un jeu de données réel et « désordonné » de la Gapminder Foundation. Lancez-vous !
Cours Python
Cours
Cours
Cours