

Instalar pandas
Instala pandas con el comando pip install en tu terminal. pandas 3 requiere Python 3.11 o superior; en un Python más antiguo, pip instalará la versión más reciente de pandas 2.x compatible con tu Python.
pip install pandasComo alternativa, puedes instalarlo vía conda:
conda install pandasTras instalar pandas, es buena práctica comprobar la versión instalada para asegurarte de que todo funciona correctamente:
import pandas as pd
print(pd.__version__) # Prints the pandas versionEsto confirma que pandas está instalado y te permite verificar la compatibilidad con otros paquetes.
Qué cambió en pandas 3.0 y 3.1
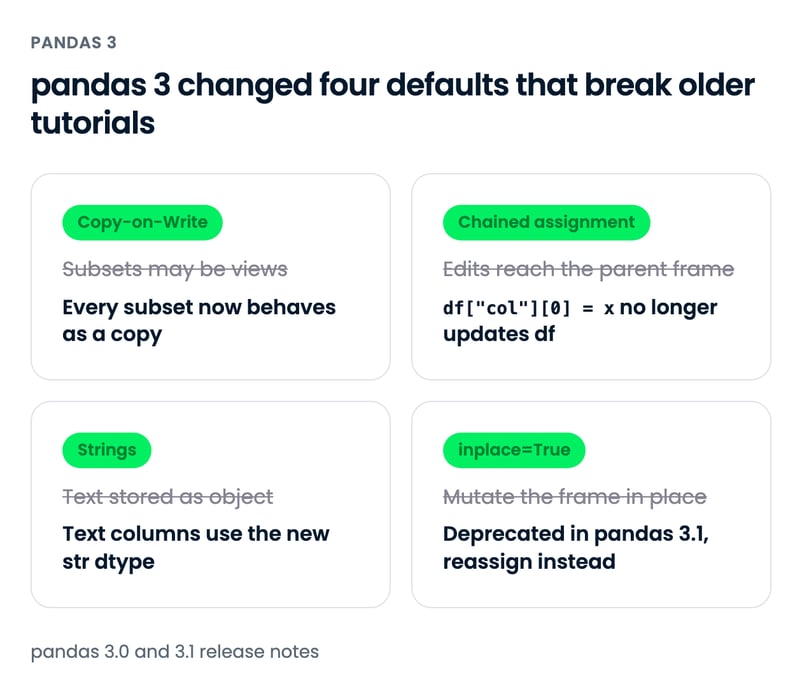
pandas 3.0, publicado en enero de 2026, cambió cómo funcionan las copias, las cadenas y las asignaciones, y pandas 3.1 (octubre de 2026) desaprobó la mayoría de usos de inplace=True. El código de tutoriales antiguos suele seguir funcionando, pero cuatro cambios suelen pillar desprevenido:
- Copy-on-Write es el valor por defecto. Cualquier subconjunto o resultado de un método se comporta como una copia, así que cambiarlo no cambia el DataFrame original. Desaparece el
SettingWithCopyWarningy también la necesidad de llamadas defensivas a.copy(). - La asignación encadenada ya no funciona.
df["Age"][0] = 35actualiza una copia temporal y dejadfsin cambios, y pandas avisa con unChainedAssignmentError. Usa una única llamada a.loc[]en su lugar. - Las cadenas tienen su propio tipo de datos. Las columnas de texto ahora se infieren como
stren lugar deobject, con PyArrow por debajo cuando está instalado. inplace=Trueestá en desuso parasort_values(),reset_index(),dropna(),drop_duplicates(),rename()y otros métodos. Reasigna el resultado:df = df.dropna().
Aquí tienes el cambio de asignación encadenada en un DataFrame pequeño:
import pandas as pd
patients = pd.DataFrame({"name": ["Ana", "Ben", "Chloe"], "age": [34, 51, 28]})
patients["age"][0] = 35 # chained assignment: patients is not changed
patients.loc[0, "age"] = 35 # a single .loc[] call: patients is updated
print(patients.dtypes)name str
age int64
dtype: objectCada ejemplo de este tutorial sigue las reglas de pandas 3. Para la lista completa de cambios, consulta las notas oficiales de pandas 3.0 y pandas 3.1. Si mantienes código antiguo, nuestra guía sobre el SettingWithCopyWarning explica el comportamiento que Copy-on-Write sustituyó.
Importación de datos en pandas
Para empezar a trabajar con pandas, importa el paquete de Python como se muestra abajo. Al importar pandas, el alias más común es pd.
import pandas as pdImportar archivos CSV
Usa read_csv() con la ruta al archivo CSV para leer un archivo de valores separados por comas (consulta nuestro tutorial sobre importar datos con read_csv() para más detalle).
df = pd.read_csv("diabetes.csv")Esta lectura carga el archivo CSV diabetes.csv en un DataFrame de pandas llamado df. A lo largo de este tutorial usamos el conjunto de datos Pima Indians Diabetes: 768 pacientes, ocho medidas de salud como Glucose, BMI y Age, y una columna Outcome donde 1 significa diagnóstico de diabetes.
Importar archivos de texto
Leer archivos de texto es similar a los CSV. La única diferencia es que debes indicar un separador con el argumento sep, como se muestra abajo. El separador es el carácter que separa los valores (columnas) en cada línea. Los más comunes son la coma (sep=","), el tabulador (sep="\t"), los dos puntos (sep=":") y el espacio en blanco (sep=r"\s+"). r"\s+" es una expresión regular que coincide con uno o más caracteres en blanco; el prefijo r la convierte en una cadena raw, para que Python no trate \s como una secuencia de escape inválida.
df = pd.read_csv("diabetes.txt", sep=r"\s+")Importar archivos de Excel (una hoja)
Lee archivos de Excel con la función read_excel(), pasando la ruta del archivo como entrada. pandas necesita un motor adicional para Excel: instala openpyxl para archivos .xlsx o xlrd para los antiguos .xls.
df = pd.read_excel('diabetes.xlsx')También puedes indicar otros argumentos, como header para definir qué fila se convierte en cabecera del DataFrame. Su valor por defecto es 0, que designa la primera fila como nombres de columna. También puedes especificar nombres de columna como una lista en el argumento names. El argumento index_col (por defecto es None) puede usarse si el archivo contiene un índice de filas.
Nota: En un DataFrame o Series de pandas, el índice es un identificador que apunta a la ubicación de una fila o columna. En resumen, el índice etiqueta la fila o columna de un DataFrame y te permite acceder a una fila o columna concreta usando su índice (lo verás más adelante). El índice de filas de un DataFrame puede ser un rango (p. ej., de 0 a 303), una serie temporal (fechas o marcas de tiempo), un identificador único (p. ej., employee_ID en una tabla employees) u otros tipos de datos. Para columnas, suele ser una cadena (el nombre de la columna).
Importar archivos de Excel (varias hojas)
Leer archivos de Excel con varias hojas no es muy diferente. Solo necesitas indicar un argumento adicional, sheet_name, donde puedes pasar una cadena con el nombre de la hoja o un entero con su posición (ten en cuenta que Python usa indexación desde 0, donde la primera hoja se accede con sheet_name = 0)
# Extraer la segunda hoja porque Python usa indexación desde 0
df = pd.read_excel('diabetes_multi.xlsx', sheet_name=1)Importar un archivo JSON
De forma similar a read_csv(), puedes usar read_json() para archivos JSON pasando el nombre del archivo (para más detalle lee este tutorial sobre importar datos JSON y HTML en pandas). El siguiente código lee un archivo JSON del disco y crea un DataFrame df.
df = pd.read_json("diabetes.json")Si quieres aprender más sobre importación de datos con pandas, echa un vistazo a esta chuleta sobre cómo importar varios tipos de archivo con Python.
Importar datos desde bases de datos SQL
Para cargar datos desde una base de datos relacional, usa pd.read_sql() junto con una conexión a base de datos.
import sqlite3
# Establecer conexión a una base de datos SQLite
conn = sqlite3.connect("my_database.db")
# Leer datos de una tabla
df = pd.read_sql("SELECT * FROM my_table", conn)Para otras bases de datos, como PostgreSQL o MySQL, pasa un motor de SQLAlchemy como conexión en lugar de una conexión sqlite3. Para tablas grandes, usa el argumento chunksize para leer el resultado por lotes.
Importar datos desde una API (formato JSON)
Si tus datos vienen de una API web, pandas puede leerlos directamente usando pd.read_json():
df = pd.read_json("https://api.example.com/data.json")Si la respuesta de la API es JSON anidado, aplánala con pd.json_normalize(), que convierte claves anidadas en columnas separadas por puntos:
records = [
{"id": 1, "vitals": {"glucose": 148, "bmi": 33.6}},
{"id": 2, "vitals": {"glucose": 85, "bmi": 26.6}},
]
pd.json_normalize(records) id vitals.glucose vitals.bmi
0 1 148 33.6
1 2 85 26.6Exportación de datos en pandas
Así como pandas puede importar datos de varios formatos, también te permite exportarlos. Esto es habitual cuando transformas datos con pandas y necesitas guardarlos localmente. Abajo verás cómo exportar DataFrames de pandas a distintos formatos.
Exportar un DataFrame a un archivo CSV
Un DataFrame de pandas (aquí usamos df) se guarda como CSV con el método .to_csv(). Pasa la ruta del archivo y establece index=False salvo que necesites el índice de filas en el archivo (por defecto, index=True, lo escribe como una columna adicional sin nombre). Nuestro tutorial sobre guardar un DataFrame en CSV cubre otros argumentos.
df.to_csv("diabetes_out.csv", index=False)Exportar un DataFrame a un archivo JSON
Exporta un DataFrame a JSON llamando al método .to_json().
df.to_json("diabetes_out.json")Nota: Un archivo JSON almacena un objeto tabular como pares clave-valor. Por eso verás encabezados de columna repetidos en un JSON.
Exportar un DataFrame a un archivo de texto
Como al escribir DataFrames a CSV, puedes llamar a .to_csv(). Las únicas diferencias son que el formato de salida es .txt y debes indicar un separador con el argumento sep.
df.to_csv('diabetes_out.txt', header=df.columns, index=None, sep=' ')Exportar un DataFrame a un archivo de Excel
Llama a .to_excel() en el DataFrame para guardarlo como un archivo .xlsx (requiere openpyxl). pandas ya no puede escribir archivos .xls antiguos.
df.to_excel("diabetes_out.xlsx", index=False)Visualización y comprensión de DataFrames en pandas
Tras leer datos tabulares como DataFrame, querrás echar un vistazo. Puedes ver una pequeña muestra del conjunto o un resumen de estadísticas.
Cómo ver datos con .head() y .tail()
Puedes ver las primeras o últimas filas de un DataFrame con los métodos .head() o .tail(), respectivamente. Puedes indicar el número de filas con el argumento n (por defecto es 5).
df.head()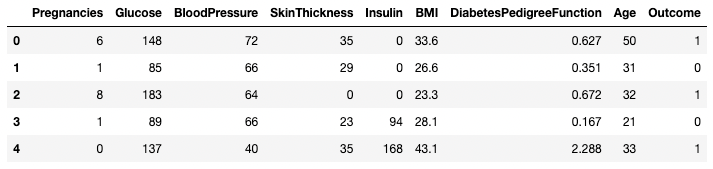
Primeras cinco filas del DataFrame
df.tail(n = 10)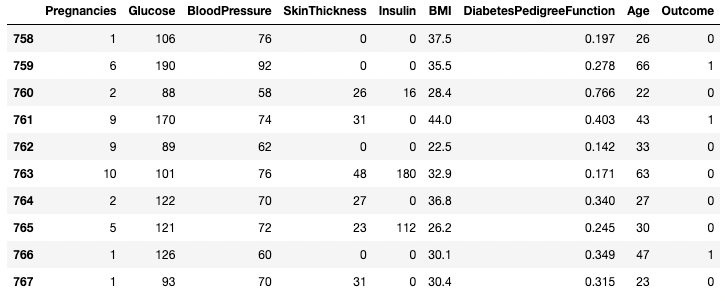
Últimas 10 filas del DataFrame
Entender los datos con .describe()
El método .describe() imprime estadísticas de resumen de todas las columnas numéricas, como recuento, media, desviación estándar, rango y cuartiles.
df.describe()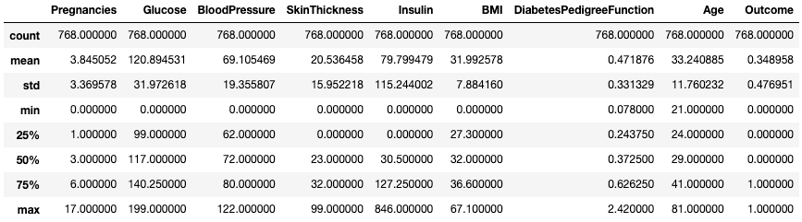
Obtén estadísticas de resumen con .describe()
Ofrece una visión rápida de la escala, asimetría y rango de los datos numéricos.
También puedes modificar los cuartiles con el argumento percentiles. Aquí, por ejemplo, vemos los percentiles 30%, 50% y 70% de las columnas numéricas del DataFrame df.
df.describe(percentiles=[0.3, 0.5, 0.7])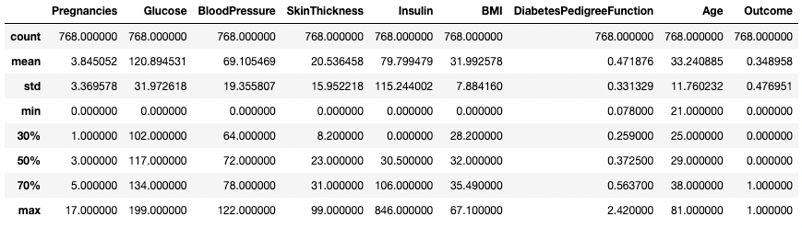
Estadísticas de resumen con percentiles específicos
También puedes aislar tipos de datos concretos en tu resumen usando el argumento include. Aquí, por ejemplo, solo resumimos las columnas con tipo de datos integer.
df.describe(include=[int])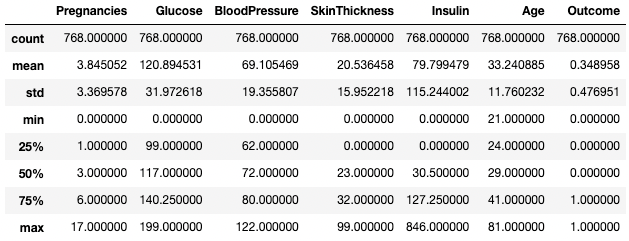
Estadísticas de columnas enteras solamente
Del mismo modo, puedes excluir ciertos tipos de datos con el argumento exclude.
df.describe(exclude=[int]) BMI DiabetesPedigreeFunction
count 768.000000 768.000000
mean 31.992578 0.471876
std 7.884160 0.331329
min 0.000000 0.078000
25% 27.300000 0.243750
50% 32.000000 0.372500
75% 36.600000 0.626250
max 67.100000 2.420000
A menudo resulta más cómodo ver estas estadísticas transponiéndolas con el atributo .T.
df.describe().T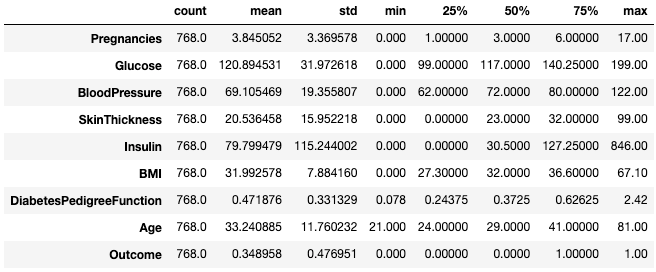
Transponer estadísticas de resumen con .T
Para más sobre cómo describir DataFrames, consulta la siguiente chuleta.
Entender los datos con .info()
El método .info() es una forma rápida de ver los tipos de datos, los valores faltantes y el tamaño de un DataFrame. Aquí establecemos el argumento show_counts en True, que muestra el número de valores no faltantes en cada columna. También establecemos memory_usage en True, que muestra el uso total de memoria de los elementos del DataFrame. Cuando verbose es True, imprime el resumen completo de .info().
df.info(show_counts=True, memory_usage=True, verbose=True)<class 'pandas.DataFrame'>
RangeIndex: 768 entries, 0 to 767
Data columns (total 9 columns):
# Column Non-Null Count Dtype
--- ------ -------------- -----
0 Pregnancies 768 non-null int64
1 Glucose 768 non-null int64
2 BloodPressure 768 non-null int64
3 SkinThickness 768 non-null int64
4 Insulin 768 non-null int64
5 BMI 768 non-null float64
6 DiabetesPedigreeFunction 768 non-null float64
7 Age 768 non-null int64
8 Outcome 768 non-null int64
dtypes: float64(2), int64(7)
memory usage: 54.1 KBEntender tus datos con .shape
El número de filas y columnas de un DataFrame se identifica con el atributo .shape. Devuelve una tupla (filas, columnas) y puede indexarse para obtener solo el número de filas o de columnas.
df.shape # Número de filas y columnas
df.shape[0] # Solo número de filas
df.shape[1] # Solo número de columnas(768,9)
768
9Obtener todas las columnas y sus nombres
Al llamar al atributo .columns de un DataFrame obtienes los nombres de columna en forma de objeto Index. Recuerda: un índice de pandas es la dirección/etiqueta de la fila o columna.
df.columnsIndex(['Pregnancies', 'Glucose', 'BloodPressure', 'SkinThickness', 'Insulin', 'BMI',
'DiabetesPedigreeFunction', 'Age', 'Outcome'],
dtype='str')Se puede convertir en lista usando list().
list(df.columns)['Pregnancies',
'Glucose',
'BloodPressure',
'SkinThickness',
'Insulin',
'BMI',
'DiabetesPedigreeFunction',
'Age',
'Outcome']Comprobar valores faltantes en pandas con .isnull()
El DataFrame de ejemplo no tiene valores faltantes. Vamos a introducir algunos para que sea más interesante. El método .copy() crea una copia del DataFrame original. Trabajar sobre una copia mantiene df intacto para los ejemplos siguientes. Usando .loc (lo cubrimos más adelante), puedes establecer como faltantes las filas etiquetadas de 2 a 5 en la columna Pregnancies. Como los valores faltantes se almacenan como NaN, un float, pandas convierte la columna de int64 a float64.
df2 = df.copy()
df2.loc[2:5,'Pregnancies'] = None
df2.head(7)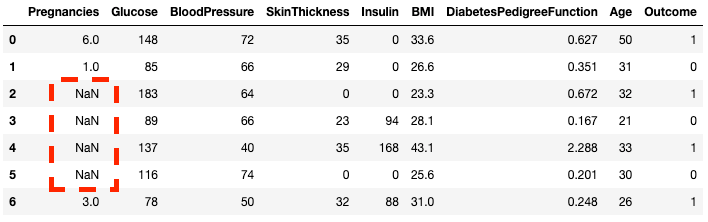
Ahora las filas 2 a 5 son NaN
Puedes comprobar si cada elemento de un DataFrame falta usando el método .isnull().
df2.isnull().head(7)Como suele ser más útil saber cuánto dato falta, puedes combinar .isnull() con .sum() para contar los nulos en cada columna.
df2.isnull().sum()Pregnancies 4
Glucose 0
BloodPressure 0
SkinThickness 0
Insulin 0
BMI 0
DiabetesPedigreeFunction 0
Age 0
Outcome 0
dtype: int64También puedes hacer una doble suma para obtener el total de nulos del DataFrame.
df2.isnull().sum().sum()4Ordenar, dividir y extraer datos en pandas
El paquete pandas ofrece varias formas de ordenar, subconfigurar, filtrar y aislar datos en tus DataFrames. Aquí veremos las más comunes.
Ordenar datos
Para ordenar un DataFrame por una columna concreta, usa .sort_values(). Devuelve un DataFrame nuevo y ordenado y deja df sin cambios, así que asigna el resultado a una variable si quieres conservarlo:
df.sort_values(by="Age", ascending=False) # Ordenar por Age en orden descendentePuedes ordenar por varias columnas:
df.sort_values(by=["Age", "Glucose"], ascending=[False, True])Reiniciar el índice
Ordenar o filtrar mantiene las etiquetas de fila originales, así que el índice puede quedar desordenado. Usa .reset_index() para obtener un índice nuevo empezando en 0 (consulta nuestro tutorial para resetear el índice en pandas para más opciones):
df_sorted = df.sort_values(by="Age", ascending=False).reset_index(drop=True) # drop=True descarta el índice antiguo
df_sorted[["Age", "Glucose", "Outcome"]].head(3) Age Glucose Outcome
0 81 134 0
1 72 119 0
2 70 145 1Aislar una columna usando [ ]
Puedes aislar una sola columna usando corchetes [ ] con el nombre de la columna. La salida es un objeto Series de pandas. Una Series es un array unidimensional con datos de cualquier tipo: entero, float, cadena, booleano, objetos de Python, etc. Un DataFrame está compuesto por muchas series que actúan como columnas.
df['Outcome']0 1
1 0
2 1
3 0
4 1
..
763 0
764 0
765 0
766 1
767 0
Name: Outcome, Length: 768, dtype: int64Aislar dos o más columnas usando [[ ]]
También puedes proporcionar una lista de nombres de columna dentro de los corchetes para obtener más de una columna. Aquí, los corchetes se usan de dos formas: los exteriores indican un subconjunto de un DataFrame y los interiores crean una lista.
df[['Pregnancies', 'Outcome']] Pregnancies Outcome
0 6 1
1 1 0
2 8 1
3 1 0
4 0 1
.. ... ...
763 10 0
764 2 0
765 5 0
766 1 1
767 1 0
[768 rows x 2 columns]Aislar una fila usando [ ]
Se puede obtener una sola fila pasando una serie booleana con un único True. En el ejemplo siguiente, se devuelve la segunda fila con index = 1. Aquí, .index devuelve las etiquetas de fila del DataFrame, y la comparación lo convierte en un array booleano unidimensional.
df[df.index==1]
Aislar una fila en pandas
Aislar dos o más filas usando [ ]
Del mismo modo, se pueden devolver dos o más filas usando el método .isin() en lugar del operador ==.
df[df.index.isin(range(2,10))]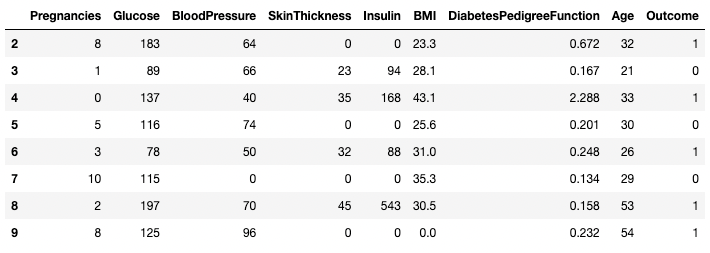
Aislar filas específicas en pandas
Usar .loc[] y .iloc[] para obtener filas
Puedes obtener filas específicas por etiquetas o condiciones usando .loc[] e .iloc[] ("location" e "integer location"). .loc[] usa una etiqueta para señalar una fila, columna o celda, mientras que .iloc[] usa la posición numérica. Nuestra guía de loc vs iloc cubre todas las diferencias; para ver la principal aquí, cambiemos el índice de df2 creado antes para que etiquetas y posiciones ya no coincidan.
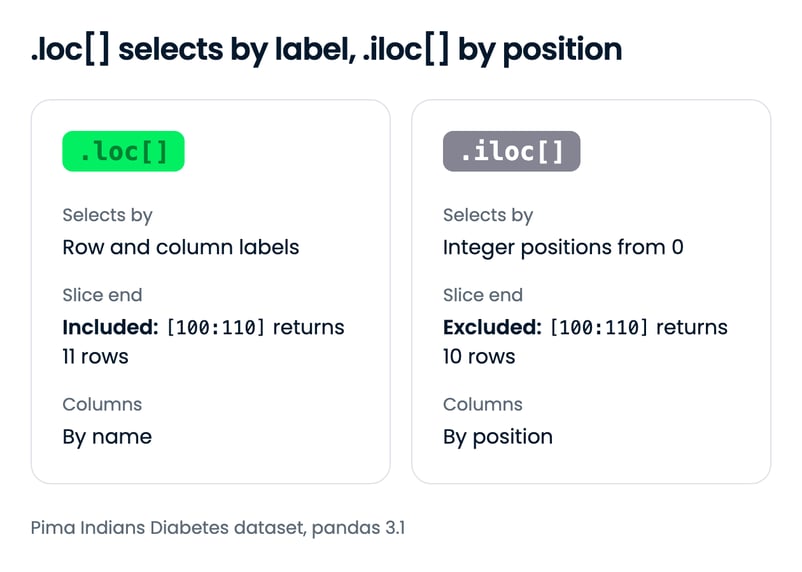
df2.index = range(1,769)El siguiente ejemplo devuelve una Series en lugar de un DataFrame. En .loc[1], 1 es una etiqueta, así que devuelve la fila etiquetada como 1 (la primera fila tras reindexar). En .iloc[1], 1 es una posición basada en cero, así que devuelve la segunda fila, que lleva la etiqueta 2.
df2.loc[1]Pregnancies 6.000
Glucose 148.000
BloodPressure 72.000
SkinThickness 35.000
Insulin 0.000
BMI 33.600
DiabetesPedigreeFunction 0.627
Age 50.000
Outcome 1.000
Name: 1, dtype: float64df2.iloc[1]Pregnancies 1.000
Glucose 85.000
BloodPressure 66.000
SkinThickness 29.000
Insulin 0.000
BMI 26.600
DiabetesPedigreeFunction 0.351
Age 31.000
Outcome 0.000
Name: 2, dtype: float64También puedes obtener varias filas indicando un rango entre corchetes. Los dos accesores tratan el final del rango de forma distinta: .loc[100:110] incluye la etiqueta 110 y devuelve 11 filas, mientras que .iloc[100:110] se detiene antes de la posición 110 y devuelve 10 filas.
df2.loc[100:110]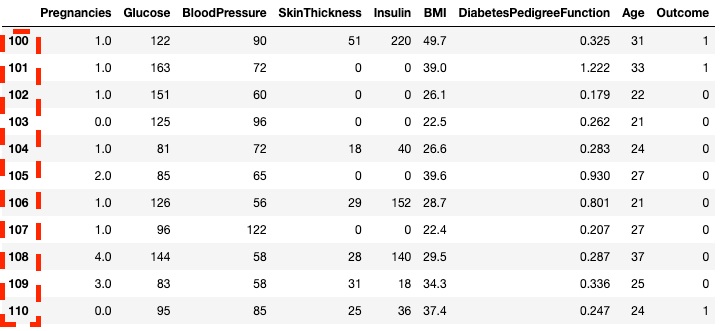
Aislar filas en pandas con .loc[]
df2.iloc[100:110]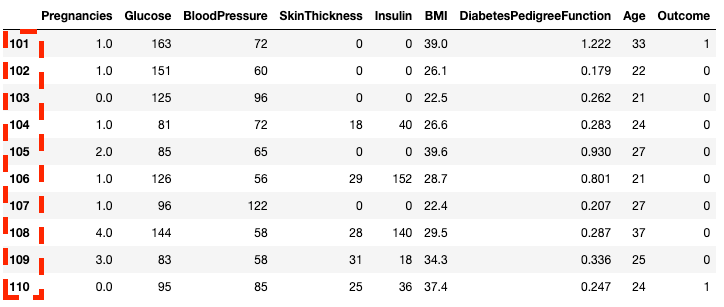
Aislar filas en pandas con .iloc[]
También puedes obtener subconjuntos con .loc[] e .iloc[] usando una lista en lugar de un rango.
df2.loc[[100, 200, 300]]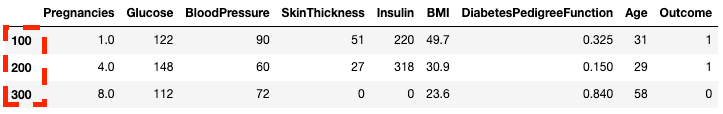
Aislar filas con una lista en pandas con .loc[]
df2.iloc[[100, 200, 300]]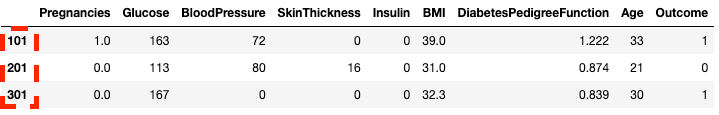
Aislar filas con una lista en pandas con .iloc[]
También puedes seleccionar columnas específicas junto con filas. Aquí es donde .iloc[] se diferencia de .loc[]: requiere posiciones de columna y no etiquetas.
df2.loc[100:110, ['Pregnancies', 'Glucose', 'BloodPressure']] Pregnancies Glucose BloodPressure
100 1.0 122 90
101 1.0 163 72
102 1.0 151 60
103 0.0 125 96
104 1.0 81 72
105 2.0 85 65
106 1.0 126 56
107 1.0 96 122
108 4.0 144 58
109 3.0 83 58
110 0.0 95 85df2.iloc[100:110, :3] Pregnancies Glucose BloodPressure
101 1.0 163 72
102 1.0 151 60
103 0.0 125 96
104 1.0 81 72
105 2.0 85 65
106 1.0 126 56
107 1.0 96 122
108 4.0 144 58
109 3.0 83 58
110 0.0 95 85Para flujos más rápidos, puedes pasar el índice inicial de una fila como rango.
df2.loc[760:, ['Pregnancies', 'Glucose', 'BloodPressure']] Pregnancies Glucose BloodPressure
760 6.0 190 92
761 2.0 88 58
762 9.0 170 74
763 9.0 89 62
764 10.0 101 76
765 2.0 122 70
766 5.0 121 72
767 1.0 126 60
768 1.0 93 70df2.iloc[760:, :3] Pregnancies Glucose BloodPressure
761 2.0 88 58
762 9.0 170 74
763 9.0 89 62
764 10.0 101 76
765 2.0 122 70
766 5.0 121 72
767 1.0 126 60
768 1.0 93 70Puedes actualizar valores combinando .loc[] con el operador de asignación =. Construye la condición desde el mismo DataFrame que estás actualizando: una condición construida desde df ya no se alinea con el índice nuevo de df2, y pandas lanzará un error.
df2.loc[df2["Age"] == 81, "Age"] = 80Filtrar filas con condiciones
pandas te permite filtrar datos por condiciones sobre valores de filas/columnas. Por ejemplo, el siguiente código selecciona la fila donde la presión arterial es exactamente 122. Aquí estamos aislando filas usando los corchetes [ ] como en secciones anteriores. Pero, en lugar de pasar índices de fila o nombres de columna, pasamos una condición donde la columna BloodPressure es igual a 122. Esta condición se expresa con df.BloodPressure == 122.
df[df.BloodPressure == 122]
Aislar filas basadas en una condición en pandas
El ejemplo siguiente obtiene todas las filas donde Outcome es 1. Aquí df.Outcome selecciona esa columna, df.Outcome == 1 devuelve una Series booleana que indica qué Outcome valen 1, y luego [] toma el subconjunto de df donde esa Series es True.
df[df.Outcome == 1]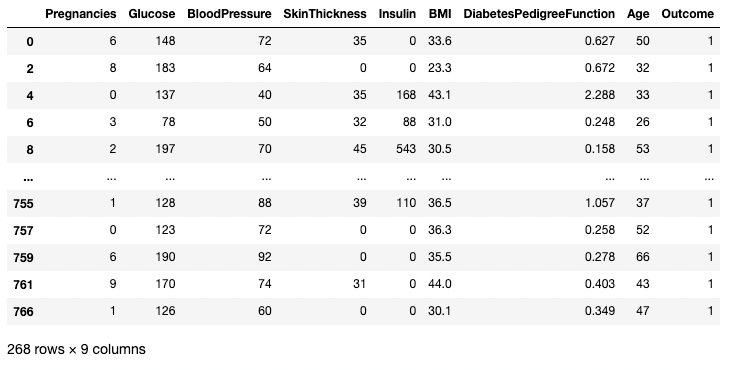
Aislar filas basadas en una condición en pandas
Puedes usar el operador > para comparar. El siguiente código obtiene Pregnancies, Glucose y BloodPressure para todos los registros con BloodPressure mayor que 100.
df.loc[df['BloodPressure'] > 100, ['Pregnancies', 'Glucose', 'BloodPressure']] Pregnancies Glucose BloodPressure
43 9 171 110
84 5 137 108
106 1 96 122
177 0 129 110
207 5 162 104
362 5 103 108
369 1 133 102
440 0 189 104
549 4 189 110
658 11 127 106
662 8 167 106
672 10 68 106
691 13 158 114Limpieza de datos en pandas
La limpieza de datos es una de las tareas más comunes en ciencia de datos. pandas te permite preprocesar datos para cualquier uso, incluido entrenar modelos de machine y deep learning. Usemos el DataFrame df2 de antes, con cuatro valores faltantes, para ilustrar algunos casos de limpieza. Como recordatorio, así ves cuántos valores faltan en un DataFrame.
df2.isnull().sum()Pregnancies 4
Glucose 0
BloodPressure 0
SkinThickness 0
Insulin 0
BMI 0
DiabetesPedigreeFunction 0
Age 0
Outcome 0
dtype: int64Técnica #1 para tratar datos faltantes: eliminar valores faltantes
Una forma de tratar datos faltantes es eliminarlos. Es útil cuando tienes muchos datos y perder una pequeña parte no afectará al análisis posterior. Puedes usar el método .dropna() como se muestra abajo. Aquí guardamos los resultados de .dropna() en el DataFrame df3.
df3 = df2.copy()
df3 = df3.dropna()
df3.shape(764, 9) # esto son 4 filas menos que df2El argumento axis te permite indicar si eliminas filas o columnas con valores faltantes. Por defecto, axis elimina filas con NaN. Usa axis = 1 para eliminar columnas con uno o más NaN. Como en todos los ejemplos de este tutorial, reasignamos el resultado en lugar de pasar inplace=True, que pandas 3.1 desaprueba para .dropna().
df3 = df2.dropna(axis=1)
list(df3.columns)['Glucose', 'BloodPressure', 'SkinThickness', 'Insulin', 'BMI', 'DiabetesPedigreeFunction', 'Age', 'Outcome']Por defecto, .dropna() elimina una fila si cualquiera de sus valores falta. Establece el argumento how a 'all' para eliminar solo filas donde todos los valores falten. Ninguna fila en df2 está completamente vacía, así que no se elimina nada:
df3 = df2.dropna(how="all")
df3.shape(768, 9)Técnica #2 para tratar datos faltantes: reemplazarlos
En lugar de eliminar, puedes reemplazar los valores faltantes con una estadística resumen o un valor fijo. Por ejemplo, si falta un día en una semana de lecturas de temperatura, rellenarlo con la media semanal conserva la fila y pierde poca información. El código siguiente rellena los valores faltantes de Pregnancies con la media de esa columna.
df3 = df2.copy()
# Obtener la media de Pregnancies
mean_value = df3["Pregnancies"].mean()
# Rellenar solo los valores faltantes de esa columna
df3["Pregnancies"] = df3["Pregnancies"].fillna(mean_value)
df3["Pregnancies"].head(7)1 6.000000
2 1.000000
3 3.846859
4 3.846859
5 3.846859
6 3.846859
7 3.000000
Name: Pregnancies, dtype: float64Tratar datos duplicados
Añadamos algunos duplicados a los datos originales para aprender a eliminarlos en un DataFrame. Aquí usamos la función pd.concat() para concatenar las filas de df2 con df2, añadiendo duplicados perfectos de cada fila de df2.
df3 = pd.concat([df2, df2])
df3.shape(1536, 9)Puedes eliminar todas las filas duplicadas (por defecto) del DataFrame usando el método .drop_duplicates().
df3 = df3.drop_duplicates()
df3.shape(768, 9)Renombrar columnas
Una tarea común de limpieza es renombrar columnas. Pasa al método .rename() un diccionario columns que mapee nombres antiguos a nuevos:
df3 = df3.rename(columns={"DiabetesPedigreeFunction": "DPF"})
df3[["Glucose", "BMI", "DPF", "Age"]].head() Glucose BMI DPF Age
1 148 33.6 0.627 50
2 85 26.6 0.351 31
3 183 23.3 0.672 32
4 89 28.1 0.167 21
5 137 43.1 2.288 33También puedes asignar una lista completa de nombres a .columns. La lista debe nombrar todas las columnas en su orden actual: pandas asigna nombres por posición, así que una lista en orden incorrecto etiquetará mal tus datos sin avisar.
df3.columns = ["Pregnancies", "Glucose", "BloodPressure", "SkinThickness", "Insulin", "BMI", "DPF", "Age", "Outcome"]
list(df3.columns)['Pregnancies', 'Glucose', 'BloodPressure', 'SkinThickness', 'Insulin', 'BMI', 'DPF', 'Age', 'Outcome']Para más sobre limpieza de datos, y para flujos de limpieza más sencillos y predecibles, consulta la siguiente checklist, que te proporciona un conjunto completo de tareas comunes de limpieza de datos.
Combinar DataFrames en pandas
pandas combina DataFrames de dos formas: .merge() une tablas por columnas clave compartidas, como en SQL, y pd.concat() apila tablas una encima de otra o una al lado de otra.
Unir DataFrames con .merge()
Usa .merge() cuando dos tablas comparten una columna clave. Supón que una segunda tabla asigna a cada código de Outcome una etiqueta legible. Un left merge sobre Outcome añade esa etiqueta a cada fila de paciente:
outcome_labels = pd.DataFrame({"Outcome": [0, 1], "Diagnosis": ["Non-diabetic", "Diabetic"]})
df_labeled = df.merge(outcome_labels, on="Outcome", how="left")
df_labeled[["Glucose", "Outcome", "Diagnosis"]].head(3) Glucose Outcome Diagnosis
0 148 1 Diabetic
1 85 0 Non-diabetic
2 183 1 DiabeticEl argumento how define el tipo de unión: "left" mantiene todas las filas de df, "inner" mantiene solo filas con coincidencia en ambas tablas y "outer" conserva todas las filas de ambas. Nuestro tutorial sobre unir DataFrames en pandas cubre .join() y todos los tipos en detalle.
Concatenar DataFrames con pd.concat()
Usa pd.concat() cuando las tablas tienen las mismas columnas y quieres apilar sus filas, por ejemplo, registros de pacientes que llegan en dos tandas. Establece ignore_index=True para obtener un índice nuevo desde 0 en lugar de mantener las etiquetas de cada lote:
batch_1 = df.iloc[:500]
batch_2 = df.iloc[500:]
df_combined = pd.concat([batch_1, batch_2], ignore_index=True)
df_combined.shape(768, 9)Con axis=1, pd.concat() coloca las tablas lado a lado, haciendo coincidir filas por sus etiquetas de índice:
measurements = df[["Glucose", "BMI"]]
outcomes = df[["Outcome"]]
pd.concat([measurements, outcomes], axis=1).head(3) Glucose BMI Outcome
0 148 33.6 1
1 85 26.6 0
2 183 23.3 1Para practicar con ambos métodos, prueba nuestro curso Joining Data with pandas.
Análisis de datos en pandas
La principal propuesta de valor de pandas está en su rapidez para analizar datos. En esta sección veremos un conjunto de técnicas de análisis que puedes usar en pandas.
Operadores de resumen (media, moda, mediana)
Como viste antes, puedes obtener la media de cada columna con el método .mean().
df.mean()Pregnancies 3.845052
Glucose 120.894531
BloodPressure 69.105469
SkinThickness 20.536458
Insulin 79.799479
BMI 31.992578
DiabetesPedigreeFunction 0.471876
Age 33.240885
Outcome 0.348958
dtype: float64La moda se calcula de forma similar con el método .mode().
df.mode()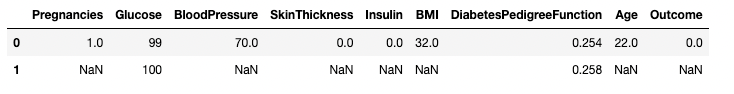
Imprimir la moda de las columnas en pandas
De forma similar, la mediana de cada columna se obtiene con .median()
df.median()Pregnancies 3.0000
Glucose 117.0000
BloodPressure 72.0000
SkinThickness 23.0000
Insulin 30.5000
BMI 32.0000
DiabetesPedigreeFunction 0.3725
Age 29.0000
Outcome 0.0000
dtype: float64Crear columnas nuevas a partir de columnas existentes
pandas ofrece cálculo rápido y eficiente combinando dos o más columnas como si fueran escalares. El siguiente código divide cada valor de la columna Glucose por el valor correspondiente de la columna Insulin para calcular una nueva columna llamada Glucose_Insulin_Ratio.
df2['Glucose_Insulin_Ratio'] = df2['Glucose']/df2['Insulin']
df2.head()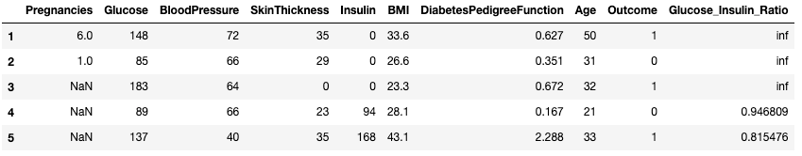
Crear una columna nueva a partir de columnas existentes en pandas
Las filas donde Insulin vale 0 muestran inf, porque dividir por cero da infinito. En este conjunto de datos, un 0 en Insulin significa que falta la medición (374 de las 768 filas), así que trata esos ceros como faltantes antes de dividir:
df2["Glucose_Insulin_Ratio"] = df2["Glucose"] / df2["Insulin"].where(df2["Insulin"] > 0)
df2["Glucose_Insulin_Ratio"].head()1 NaN
2 NaN
3 NaN
4 0.946809
5 0.815476
Name: Glucose_Insulin_Ratio, dtype: float64.where() mantiene los valores que cumplen la condición y reemplaza el resto con NaN, así que la razón queda como faltante en lugar de infinita en esas filas. Nuestro tutorial sobre añadir columnas en pandas muestra más formas de derivar columnas nuevas.
Contar con .value_counts()
Cuando una columna contiene categorías, a menudo querrás contar cuántas observaciones caen en cada una. El método .value_counts() hace justo esto. Aquí, por ejemplo, contamos cuántas observaciones tienen Outcome diabético (1) y cuántas no diabético (0).
df['Outcome'].value_counts()Outcome
0 500
1 268
Name: count, dtype: int64Añadiendo el argumento normalize devuelve proporciones en lugar de recuentos absolutos.
df['Outcome'].value_counts(normalize=True)Outcome
0 0.651042
1 0.348958
Name: proportion, dtype: float64
Desactiva el ordenado automático de resultados usando el argumento sort (por defecto es True). El ordenado por defecto se basa en los recuentos en orden descendente.
df['Outcome'].value_counts(sort=False)Outcome
1 268
0 500
Name: count, dtype: int64También puedes aplicar .value_counts() a un objeto DataFrame y a columnas específicas dentro de él, no solo a una columna. Aquí, por ejemplo, lo aplicamos a df con el argumento subset, que acepta una lista de columnas.
df.value_counts(subset=['Pregnancies', 'Outcome'])Pregnancies Outcome
1 0 106
2 0 84
0 0 73
3 0 48
4 0 45
0 1 38
5 0 36
6 0 34
1 1 29
3 1 27
7 1 25
4 1 23
8 1 22
5 1 21
7 0 20
2 1 19
9 1 18
6 1 16
8 0 16
10 0 14
1 10
9 0 10
11 1 7
13 0 5
1 5
12 0 5
11 0 4
12 1 4
14 1 2
15 1 1
17 1 1
Name: count, dtype: int64Agregar datos con .groupby() en pandas
pandas te permite agregar valores agrupándolos por columnas concretas. Puedes hacerlo combinando el método .groupby() con el método de resumen que elijas. El código siguiente muestra la media de cada columna numérica agrupada por Outcome.
df.groupby('Outcome').mean()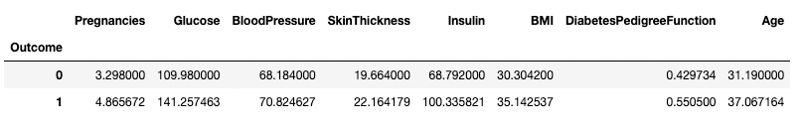
Agregar datos por una columna en pandas
.groupby() permite agrupar por más de una columna pasando una lista de nombres, como se muestra abajo.
df.groupby(['Pregnancies', 'Outcome']).mean()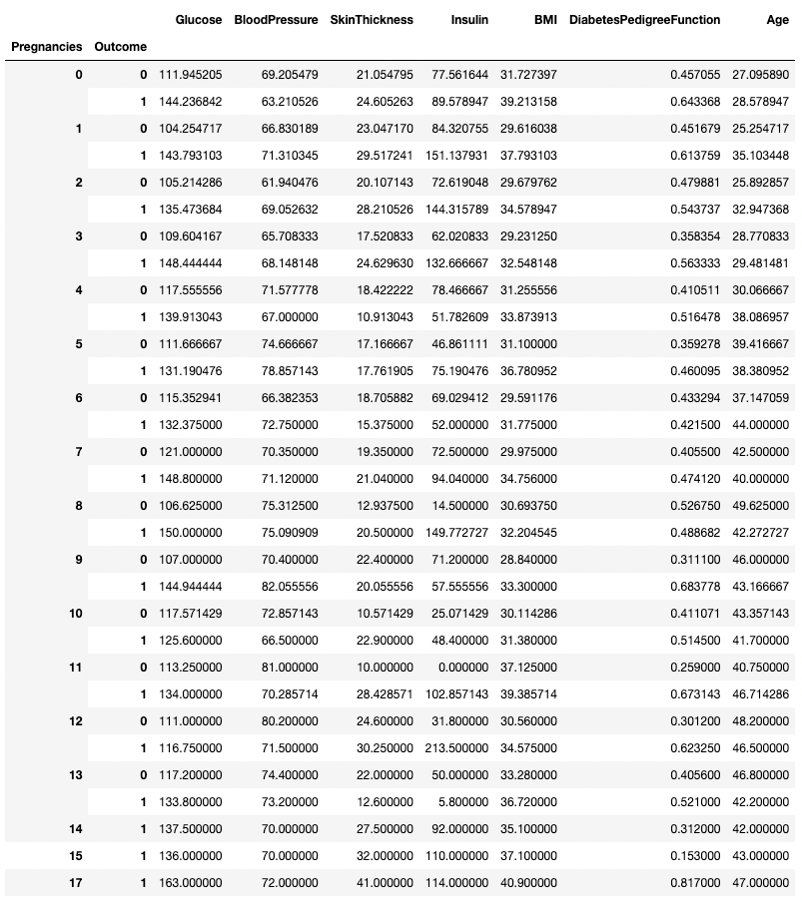
Agregar datos por dos columnas en pandas
Cualquier método de resumen puede usarse junto a .groupby(), incluidos .min(), .max(), .mean(), .median(), .sum() y más. Nuestro tutorial de GroupBy en pandas cubre agregaciones múltiples con .agg() y otros patrones.
Tablas dinámicas (pivot)
pandas también permite calcular estadísticas de resumen como tablas dinámicas. Esto facilita sacar conclusiones basadas en la combinación de variables. El código siguiente usa como filas los valores únicos de Pregnancies, como columnas los valores únicos de Outcome, y en las celdas la media de BMI del grupo correspondiente.
Por ejemplo, para Pregnancies = 5 y Outcome = 0, la media de BMI es 31.1.
pd.pivot_table(df, values="BMI", index='Pregnancies',
columns=['Outcome'], aggfunc='mean')Outcome 0 1
Pregnancies
0 31.727397 39.213158
1 29.616038 37.793103
2 29.679762 34.578947
3 29.231250 32.548148
4 31.255556 33.873913
5 31.100000 36.780952
6 29.591176 31.775000
7 29.975000 34.756000
8 30.693750 32.204545
9 28.840000 33.300000
10 30.114286 31.380000
11 37.125000 39.385714
12 30.560000 34.575000
13 33.280000 36.720000
14 NaN 35.100000
15 NaN 37.100000
17 NaN 40.900000Visualización de datos en pandas
pandas ofrece envoltorios de conveniencia sobre las funciones de trazado de Matplotlib para que sea fácil visualizar tus DataFrames. A continuación verás cómo crear visualizaciones comunes con pandas.
Gráficos de líneas en pandas
pandas te permite representar relaciones entre variables con gráficos de líneas. Abajo hay un gráfico de BMI y Glucose frente al índice de filas.
df[['BMI', 'Glucose']].plot.line()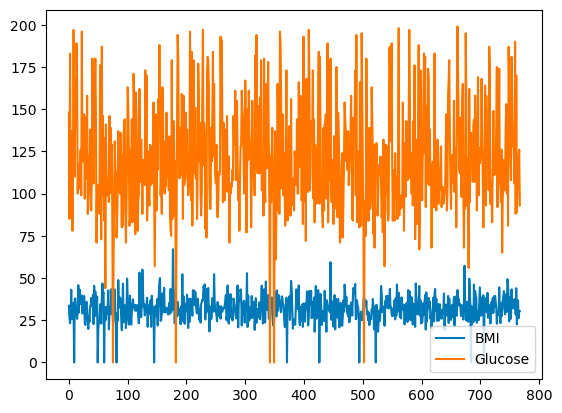
Gráfico de líneas básico con pandas
Puedes elegir los colores con el argumento color.
df[['BMI', 'Glucose']].plot.line(color={"BMI": "red", "Glucose": "blue"})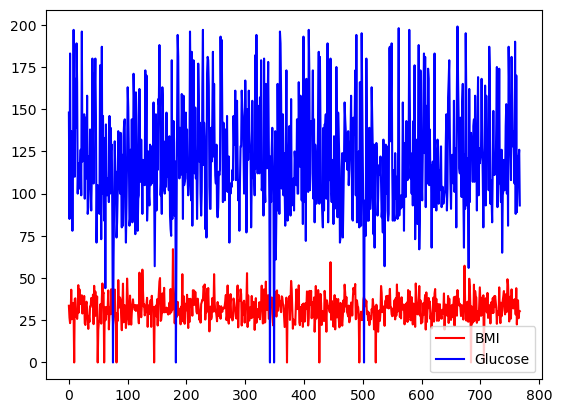
Gráfico de líneas básico con pandas, con colores personalizados
Todas las columnas de df también pueden graficarse en escalas y ejes distintos usando el argumento subplots.
df.plot.line(subplots=True)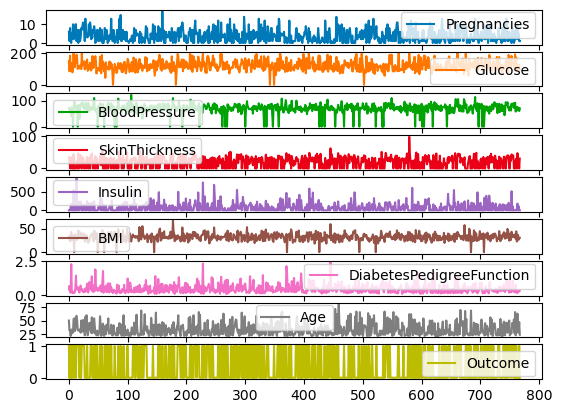
Subplots para gráficos de líneas con pandas
Gráficos de barras en pandas
Para columnas discretas, puedes usar un gráfico de barras sobre los recuentos de categorías para visualizar su distribución. La variable Outcome con valores binarios se visualiza abajo.
df['Outcome'].value_counts().plot.bar()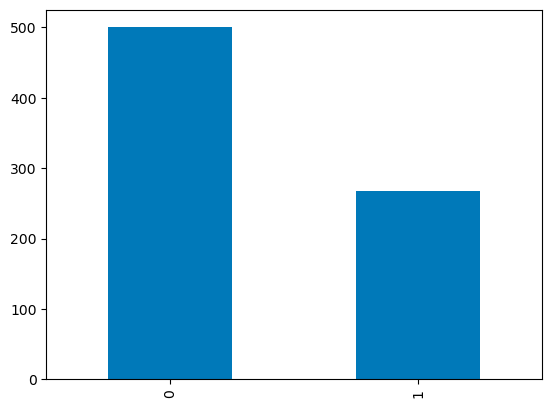
Gráficos de barras en pandas
Diagramas de caja en pandas
La distribución por cuartiles de variables continuas puede visualizarse con un diagrama de caja. El siguiente código crea un boxplot con pandas.
df.boxplot(column=['BMI'], by='Outcome')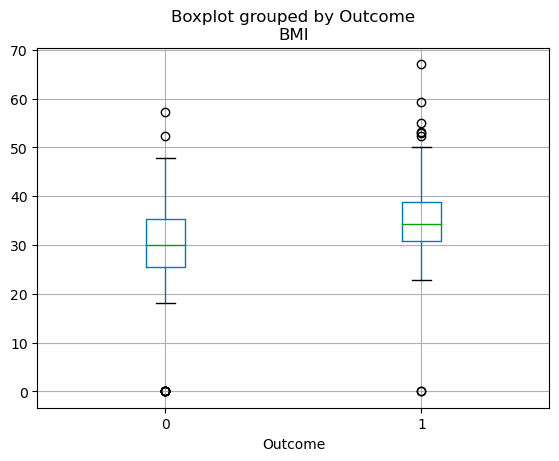
Diagramas de caja en pandas
Conclusiones
Ya dominas el flujo básico de pandas: leer un archivo en un DataFrame, inspeccionarlo con .head(), .info() y .describe(), seleccionar filas con .loc[] e .iloc[], limpiar valores faltantes y duplicados, unir tablas y resumir con .groupby() y tablas dinámicas.
Si aprendiste pandas antes de 2026, hay un hábito que merece la pena cambiar: reasignar resultados en lugar de pasar inplace=True, y hacer cada actualización con una única llamada a .loc[]. La forma más rápida de afianzar el resto es repetir el flujo con un conjunto de datos que te importe. Estos recursos te ayudan a ir más allá:
- [Chuletas] Un montón de chuletas de Python y pandas para consultar durante tu aprendizaje
- [Formaciones en vivo] Nuestras sesiones de code-along gratuitas, muchas de ellas con pandas
- [Cursos] Data Manipulation with pandas y Joining Data with pandas para practicar de forma interactiva
- [Preparación de entrevistas] Nuestras principales preguntas de entrevista sobre pandas para poner a prueba lo que sabes
- [Más tutoriales] Explora el resto de tutoriales sobre pandas y el ecosistema PyData, incluyendo cómo implementar medias móviles en pandas y usar el método .apply() de pandas
pandas: preguntas frecuentes
¿Qué es pandas en Python?
pandas es una librería de código abierto de Python para trabajar con datos tabulares. Sus dos estructuras de datos principales, el DataFrame (una tabla) y la Series (una sola columna), incluyen funciones para importar, limpiar, reestructurar, agregar y graficar datos, por lo que es la herramienta estándar para análisis de datos en Python.
¿Por qué debería aprender pandas?
Si trabajas con datos en Python, pandas es prácticamente imprescindible. Simplifica el manejo y análisis de datos para que puedas centrarte en extraer insights y generar valor. Tanto si tratas con conjuntos pequeños como con datos a gran escala, pandas te facilita la vida por su rapidez, flexibilidad y estructuras de datos fáciles de usar.
¿Cómo instalo pandas?
Ejecuta pip install pandas en tu terminal, o conda install pandas si usas conda. pandas 3 requiere Python 3.11 o superior. Anaconda incluye pandas por defecto y DataLab de DataCamp lo trae preinstalado.
¿Cuáles son las estructuras de datos básicas en pandas?
Las dos estructuras básicas de datos en pandas son Series y DataFrame. Una Series es, esencialmente, una columna, y un DataFrame es una tabla multidimensional compuesta por una colección de Series. Estas estructuras son flexibles y pueden contener datos de distintos tipos (p. ej., entero, cadena, float).
¿Es pandas adecuado para conjuntos de datos grandes?
pandas maneja millones de filas sin problema, siempre que los datos quepan en la memoria de tu equipo. Para datos que no caben, léelos por lotes con el argumento chunksize o cambia a una herramienta preparada para datos más grandes, como Polars, Dask o PySpark.
¿Cómo importo datos en pandas?
pandas puede leer datos de varios formatos como CSV, Excel, bases de datos SQL, JSON y más. Los comandos pd.read_csv(), pd.read_excel(), pd.read_sql() y pd.read_json() se usan para importar datos de cada tipo. Todos devuelven un DataFrame, que luego puedes manipular con pandas.
¿Qué cambió en pandas 3.0?
pandas 3.0, publicado en enero de 2026, estableció Copy-on-Write como predeterminado, de modo que cada subconjunto se comporta como una copia y la asignación encadenada como df["col"][0] = x ya no actualiza el DataFrame original. También infiere las columnas de texto como un tipo dedicado str en lugar de object, y requiere Python 3.11 o superior. Luego, pandas 3.1 desaprobó inplace=True en métodos como dropna() y sort_values().
¿Cuál es la diferencia entre loc e iloc en pandas?
.loc[] selecciona filas y columnas por etiqueta, y .iloc[] por posición entera empezando en 0. Los cortes también difieren: .loc[100:110] incluye la etiqueta final, mientras que .iloc[100:110] se detiene antes de la posición 110. Consulta nuestra guía de loc vs iloc para más ejemplos.
¿Cómo uno dos DataFrames en pandas?
Usa df1.merge(df2, on="key", how="left") para unir dos DataFrames sobre una columna compartida, igual que un join de SQL. El argumento how elige el tipo de join ("left", "right", "inner" u "outer"). Para apilar DataFrames, usa pd.concat().

Transformadora de Datos y Estratega de IA | Conferenciante Internacional | Ética de la IA | Inventora | Mujer Logradora Global | Autora



pandas es el paquete estándar de Python para análisis de datos, con más de 500 millones de descargas al mes en PyPI. Lee y escribe CSV, Excel, JSON, SQL y muchos otros formatos, y sus funciones cubren el trabajo diario de limpiar, reestructurar, agregar y graficar datos tabulares.
En este tutorial de pandas, recorremos el flujo completo con un conjunto de datos real: instalar pandas, importar y exportar datos, inspeccionar un DataFrame, seleccionar y filtrar filas, limpiar valores faltantes y duplicados, combinar tablas, agregar y graficar. Cada ejemplo funciona con pandas 3.1, la versión actual, y señalamos los cambios de pandas 3 que rompen código de tutoriales antiguos.
Necesitas Python básico y nada de experiencia previa con pandas. Para un plan de aprendizaje más largo, consulta nuestra guía sobre cómo aprender pandas y, para practicar de forma interactiva, nuestro curso Data Manipulation with pandas.
TL;DR
pip install pandas; pandas 3 requiere Python 3.11 o superior..loc[]selecciona por etiqueta,.iloc[]por posición..loc[].df = df.dropna()) en lugar de usar el obsoletoinplace=True.¿Qué es pandas?
pandas es un paquete de manipulación de datos en Python para datos tabulares; es decir, datos en forma de filas y columnas, también conocidos como DataFrames. De forma intuitiva, puedes pensar en un DataFrame como una hoja de Excel.
Las funcionalidades de pandas incluyen transformaciones de datos, como ordenar filas y obtener subconjuntos, calcular estadísticas de resumen como la media, reestructurar DataFrames y unirlos. pandas se integra bien con otros paquetes populares de ciencia de datos en Python, el ecosistema PyData, entre ellos
¿Para qué se usa pandas?
pandas se usa a lo largo de todo el flujo de análisis de datos. Con pandas puedes:
pandas también incluye funcionalidades para series temporales y análisis de texto.
Principales ventajas de pandas
pandas tiene cinco ventajas prácticas para el trabajo con datos del día a día:
Cómo instalar pandas
Antes de usar pandas, necesitas instalarlo. Puedes saltarte este paso registrándote gratis en DataCamp y usando DataLab, un IDE en la nube que incluye pandas (junto con los principales paquetes de ciencia de datos en Python) preinstalado.