Curso
Aprendizaje no supervisado en Python
4 h
183.2K
En pocas palabras, el clustering consiste en agrupar un conjunto de objetos de modo que los que están en el mismo grupo se parezcan más entre sí que a los de otros grupos. La similitud refleja la fuerza de la relación entre dos objetos. El clustering se usa sobre todo para la exploración en minería de datos. Tiene múltiples usos en campos como el aprendizaje automático, el reconocimiento de patrones, el análisis de imagen, la recuperación de información, la bioinformática, la compresión de datos y los gráficos por ordenador.
Existen muchas familias de técnicas de clustering, y quizá te suene la más popular: K-Means (que pertenece a la familia del clustering basado en centroides). Como recordatorio rápido, K-Means determina k centroides en los datos y agrupa los puntos asignándolos al centroide más cercano.
Aunque K-Means es fácil de entender e implementar, el algoritmo no gestiona bien los valores atípicos: todos los puntos se asignan a algún grupo aunque no encajen en ninguno. En detección de anomalías, esto es problemático porque los puntos anómalos acaban en el mismo grupo que los datos “normales”. Estos puntos anómalos arrastran el centroide hacia ellos, dificultando clasificarlos como tales.
En este tutorial veremos otro tipo de técnica, el clustering basado en densidad, en concreto DBSCAN (una técnica de clustering basada en densidad). A diferencia del clustering por centroides como K-Means, el basado en densidad identifica zonas “densas” de puntos, lo que permite aprender grupos de forma arbitraria e identificar outliers en los datos.
Antes de hablar de sus desventajas, hagamos una breve introducción. Un centroide es un punto (real o imaginario) situado en el centro de un grupo. En el clustering basado en centroides, los grupos se representan mediante un vector central o centroide, que no tiene por qué pertenecer al conjunto de datos. Es un algoritmo iterativo en el que la similitud se define por la cercanía de un punto de datos al centroide del grupo.
A veces un conjunto de datos contiene valores extremos fuera del rango esperado y distintos del resto. Son los llamados valores atípicos u outliers. Más formalmente, un outlier es una observación que se encuentra a una distancia anómala de otros valores en una muestra aleatoria de una población.
El fundamento del clustering por centroides se basa en medir distancias entre los puntos y los centroides. Por ello, suele fallar al identificar puntos que se desvían mucho de la distribución “normal” de los datos. Incluso antes de construir modelos predictivos, los outliers pueden dar lugar a representaciones e interpretaciones engañosas. Esto no es deseable si quieres modelos predictivos y analíticos eficientes.
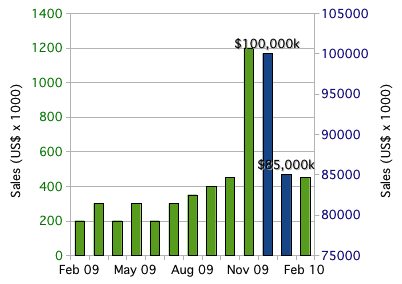
Puedes considerar las dos barras más altas (respecto al resto) como outliers en esos datos:
Antes de entrar en materia, conviene cubrir un concepto: las ɛ-vecindades.
La idea general de las ɛ-vecindades es que, dado un punto de datos, puedas razonar sobre los puntos que hay a su alrededor. Formalmente, para un ɛ > 0 real y un punto p, la ɛ-vecindad de p se define como el conjunto de puntos que están a una distancia como máximo ɛ de p.
Si recuerdas la geometría, la figura en la que todos los puntos están a la misma distancia del centro es el círculo. En 2D, la ɛ-vecindad de un punto p es el conjunto de puntos contenidos en un círculo de radio ɛ centrado en p. En 3D es una esfera de radio ɛ; en dimensiones superiores, es la N-esfera de radio ɛ centrada en p.
Veamos un ejemplo para hacerlo más concreto. En la imagen inferior, 100 puntos se reparten en el intervalo [1,3]X[2,4]. Elige el punto (3,2) como nuestro punto p.

Primero consideremos la vecindad de p con radio 0,5 (ɛ = 0,5), el conjunto de puntos a distancia 0,5 de p.

La elipse verde opaca representa nuestra vecindad y hay 31 puntos en ella. Como hay 100 puntos en total y 31 están en la vecindad, algo menos de un tercio de los puntos caen dentro de la vecindad de p con radio 0,5.
Ahora cambiemos el radio a 0,15 (ɛ = 0,15) y consideremos la vecindad más pequeña resultante.

La vecindad se ha encogido, y ahora solo contiene 3 puntos. Al reducir ɛ de 0,5 a 0,15 (un 70% menos), el número de puntos en la vecindad pasa de 31 a 3 (un 90% menos).
Con esta noción de “vecindad” clara, pasemos al siguiente concepto: la “densidad” de una vecindad (al fin y al cabo te estás acercando al “clustering basado en densidad”).
En ciencias en el colegio nos enseñan que densidad = masa/volumen. Usemos esta idea en un punto p. Si consideras p y su vecindad de radio ɛ, puedes definir la masa como el número de puntos (o la fracción de puntos) contenidos en la vecindad, y el volumen como el volumen de la figura resultante. En 2D, la vecindad es un círculo, así que su “volumen” es el área del círculo. En 3D y dimensiones superiores, la vecindad es una esfera o n-esfera, cuyo volumen puedes calcular.
Por ejemplo, retomemos la vecindad de p = (3,2) con radio 0,5.
La masa es el número de puntos en la vecindad: masa = 31. El volumen es el área del círculo: volumen = π0,52 = π/4. Por tanto, nuestra aproximación de densidad local en p = (3,2) es densidad = masa/volumen = 31/(π/4) = 124/π ≈ 39,5.
Este valor en sí no dice nada, pero si calculas la densidad local para todos los puntos, podrías agrupar diciendo que los puntos cercanos (en la misma vecindad) y con densidades similares pertenecen al mismo grupo. Si disminuyes ɛ, construyes vecindades más pequeñas (menos volumen) que también contienen menos puntos. Idealmente, quieres identificar vecindades muy densas donde caiga la mayoría de puntos, pero con un volumen relativamente pequeño.
Aunque esto no es exactamente lo que hacen DBSCAN o el algoritmo Level Set Tree (otro método de la familia basada en densidad), aporta la intuición general detrás del clustering por densidad.
En resumen, has visto las ɛ-vecindades y cómo permiten razonar sobre el espacio alrededor de un punto. Luego, una noción de densidad en un punto para una vecindad concreta. En la siguiente sección conocerás DBSCAN, donde la ɛ-bola es una herramienta fundamental para definir grupos.
DBSCAN significa Density-Based Spatial Clustering of Applications with Noise y es, sin duda, el algoritmo de clustering basado en densidad más conocido. Fue presentado por primera vez en 1996 por Ester et al.. Por su impacto teórico y práctico, recibió el Test of Time Award en SIGKDD 2014.
A diferencia de K-Means, DBSCAN no requiere el número de grupos como parámetro. Lo infiere a partir de los datos y puede descubrir grupos de forma arbitraria (mientras que K-Means suele encontrar grupos esféricos). Como viste, la ɛ-vecindad es clave en DBSCAN para aproximar la densidad local, así que el algoritmo tiene dos parámetros:
Con estos dos parámetros, DBSCAN clasifica los puntos en tres categorías:
Estas definiciones pueden parecer abstractas, así que veamos cada una con más detalle.
Puntos núcleo:
Son la base de nuestros grupos y se apoyan en la aproximación de densidad de la sección anterior. Usas el mismo ɛ para calcular la vecindad de cada punto, así que el volumen de todas las vecindades es el mismo. Lo que cambia es cuántos puntos contiene cada una. Como dije, puedes pensar el número de puntos como su masa. El volumen es constante y la masa varía; al establecer un umbral mínimo de masa para ser punto núcleo, estás fijando un umbral mínimo de densidad. Por tanto, los puntos núcleo son los que cumplen un requisito mínimo de densidad. Los grupos se construyen alrededor de ellos (de ahí “núcleo”), así que ajustando minPts puedes afinar cuán densos deben ser los núcleos.
Puntos frontera:
Son los puntos del grupo que no son núcleo. En la definición usé el término alcanzable por densidad (density-reachable). Aún no lo definí, pero la idea es simple. Volvamos al ejemplo de vecindad con ɛ = 0,15. Considera el punto r (el punto negro) que está fuera de la vecindad de p.

Todos los puntos dentro de la vecindad de p son directamente alcanzables desde p. Ahora, exploremos la vecindad de q, un punto directamente alcanzable desde p. El círculo amarillo representa la vecindad de q.

Aunque tu punto objetivo r no está en la vecindad de p, sí está en la vecindad de q. Esta es la idea de alcanzable por densidad: si puedes llegar a r saltando de vecindad en vecindad, empezando en p, entonces r es alcanzable por densidad desde p.

Como analogía, piensa en los puntos alcanzables por densidad como “amigos de un amigo”. Si los directamente alcanzables desde un punto núcleo p son sus “amigos”, los alcanzables por densidad (los que están en las vecindades de los “amigos” de p) son los “amigos de sus amigos”. Y no se limita a dos saltos: mientras puedas llegar mediante “saltos de vecindad” desde un punto núcleo p, el punto es alcanzable por densidad, así que también entran los “amigos de un amigo de un amigo …”.
Ten en cuenta que esta idea depende del valor de ɛ. Si eliges un ɛ mayor, más puntos se vuelven alcanzables por densidad; si lo reduces, serán menos.
Outliers:
Por último, la clase “otra”. Los outliers no son puntos núcleo ni están lo bastante cerca de un grupo como para ser alcanzables por densidad desde un núcleo. No se asignan a ningún grupo y, según el contexto, pueden considerarse anómalos.
DBSCAN ya está implementado de forma excelente en la popular librería de machine learning de Python Scikit-Learn, y como es escalable y está muy probada, la usaremos para ver cómo funciona en la práctica.
Los pasos del algoritmo DBSCAN son:
Para este estudio de caso usaremos un conjunto de datos con información anual de clientes de un distribuidor mayorista.
Vamos allá.
# Importa primero todas las dependencias

from sklearn.cluster import DBSCAN
from sklearn.preprocessing import StandardScaler
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
El conjunto tiene 440 clientes y 8 atributos por cliente. Usarás la librería Pandas para importar el archivo .csv y convertirlo en un DataFrame.
Al importar el archivo .csv, asegúrate de indicar la ruta correcta.
# Importa el archivo .csv y conviértelo en un DataFrame
df = pd.read_csv("C:/Users/Sayak/data/customers.csv");

print(df.head())
   Channel  Region  Fresh  Milk  Grocery  Frozen  Detergents_Paper  \
0        2       3  12669  9656     7561     214              2674
1        2       3   7057  9810     9568    1762              3293
2        2       3   6353  8808     7684    2405              3516
3        1        3  13265  1196     4221    6404               507
4        2       3  22615  5410     7198    3915              1777

   Delicatessen
0          1338
1          1776
2          7844
3          1788
4          5185
Antes de aplicar DBSCAN, es importante entender bien los datos: qué variables hay, qué distribución siguen y cuáles son numéricas.
Según la descripción del repositorio UCI de machine learning, las características del conjunto son:
Ahora que conoces las variables, veamos algunas estadísticas.
print(df.info())
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 440 entries, 0 to 439
Data columns (total 8 columns):
Channel             440 non-null int64
Region              440 non-null int64
Fresh               440 non-null int64
Milk                440 non-null int64
Grocery             440 non-null int64
Frozen              440 non-null int64
Detergents_Paper    440 non-null int64
Delicatessen        440 non-null int64
dtypes: int64(8)
memory usage: 27.6 KB
None
Como ves, no hay valores ausentes y los datos son de tipo entero. Esto reduce la carga de preprocesamiento. Profundicemos un poco más.
print(df.describe())
          Channel      Region          Fresh          Milk       Grocery  \
count  440.000000  440.000000     440.000000    440.000000    440.000000
mean     1.322727    2.543182   12000.297727   5796.265909   7951.277273
std      0.468052    0.774272   12647.328865   7380.377175   9503.162829
min      1.000000    1.000000       3.000000     55.000000      3.000000
25%      1.000000    2.000000    3127.750000   1533.000000   2153.000000
50%      1.000000    3.000000    8504.000000   3627.000000   4755.500000
75%      2.000000    3.000000   16933.750000   7190.250000  10655.750000
max      2.000000    3.000000  112151.000000  73498.000000  92780.000000

             Frozen  Detergents_Paper  Delicatessen
count    440.000000        440.000000    440.000000
mean    3071.931818       2881.493182   1524.870455
std     4854.673333       4767.854448   2820.105937
min       25.000000          3.000000      3.000000
25%      742.250000        256.750000    408.250000
50%     1526.000000        816.500000    965.500000
75%     3554.250000       3922.000000   1820.250000
max    60869.000000      40827.000000  47943.000000
De aquí puedes extraer medidas como desviación estándar, media o máximo de cada variable. Verás que la mayoría de los datos son continuos, salvo dos: Channel y Region. Para simplificar, vamos a eliminarlas:
df.drop(["Channel", "Region"], axis = 1, inplace = True)
# Veamos los datos tras el borrado

print(df.head())
   Fresh  Milk  Grocery  Frozen  Detergents_Paper  Delicatessen
0  12669  9656     7561     214              2674          1338
1   7057  9810     9568    1762              3293          1776
2   6353  8808     7684    2405              3516          7844
3  13265  1196     4221    6404               507          1788
4  22615  5410     7198    3915              1777          5185
Para visualizar los datos, usaremos dos variables:
# Ahora dibujemos los datos
x = df['Grocery']
y = df['Milk']

plt.scatter(x,y)
plt.xlabel("Groceries")
plt.ylabel("Milk")
plt.show()
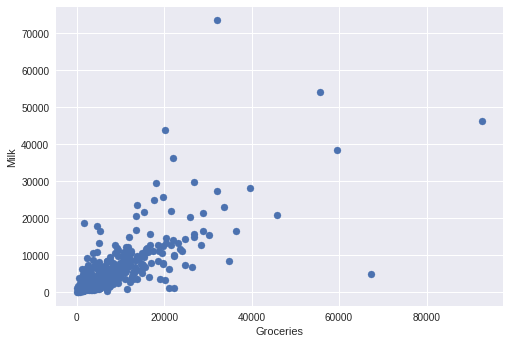
Un breve repaso de las funciones usadas para la gráfica: plt.scatter(): crea el diagrama de dispersión con los datos (parámetros x e y). plt.xlabel(): añade la etiqueta del eje X (Groceries en este caso). plt.ylabel(): etiqueta del eje Y (Milk). plt.show(): muestra la figura.
Explora el mundo de Matplotlib para todas tus visualizaciones. Su documentación es fantástica.
Se distinguen fácilmente puntos muy alejados del resto, ¿verdad? Esos son los outliers.
Con DBSCAN queremos identificar el grupo principal de clientes y además marcar como outliers a quienes tienen hábitos de compra anuales poco comunes.
Como los valores están en miles, vas a normalizar cada atributo escalándolo a media 0 y varianza unitaria. Esto ayuda a mantener las relaciones entre variables, de modo que un pequeño cambio en una se refleje en la otra.
df = df[["Grocery", "Milk"]]
df = df.as_matrix().astype("float32", copy = False)
stscaler = StandardScaler().fit(df)
df = stscaler.transform(df)
Crearemos un objeto DBSCAN que requiera un mínimo de 15 puntos en una vecindad de radio 0,5 para considerar un punto como núcleo.
dbsc = DBSCAN(eps = .5, min_samples = 15).fit(df)
Después extraeremos las etiquetas de grupo y los outliers para representar los resultados.
labels = dbsc.labels_
core_samples = np.zeros_like(labels, dtype = bool)
core_samples[dbsc.core_sample_indices_] = True

Tal y como intuíamos, DBSCAN identificó un grupo de clientes alrededor de la media de gasto en alimentación y lácteos. Además, señaló a los clientes cuyo comportamiento anual se desviaba en exceso del resto.
Como los outliers correspondían a comportamientos de compra más extremos, el mayorista podría dirigirse a ellos con descuentos exclusivos para incentivar compras mayores.
Imagina un e-commerce en el que quieres aumentar ventas recomendando productos relevantes. No sabes exactamente qué busca cada cliente, pero con un conjunto de datos puedes predecir y recomendar. Puedes aplicar DBSCAN al histórico (base de datos del e-commerce) y encontrar grupos según los productos comprados. Con esos grupos identificas similitudes: si el cliente A compró un bolígrafo, un libro y unas tijeras, y el cliente B compró un libro y unas tijeras, puedes recomendar un bolígrafo al cliente B.
Antes del auge de metodologías avanzadas basadas en deep learning, se usó DBSCAN para separar genes en conjuntos con probabilidad de mediar en procesos cancerígenos.
También se ha empleado DBSCAN para detectar paradas en trayectorias procedentes de GPS móviles. Las paradas suelen ser la parte más significativa e importante de una trayectoria.
En este artículo has visto las principales desventajas del clustering por centroides y te has familiarizado con otra familia: el clustering basado en densidad. También has visto cómo supera las limitaciones del primero.
Has aprendido cómo funciona DBSCAN y lo has aplicado en un estudio de caso. Además, has obtenido una visión de los problemas reales donde DBSCAN se ha utilizado con éxito. Como lectura adicional, te recomiendo explorar otros métodos basados en densidad como el Level Set Tree clustering y en qué se diferencia de DBSCAN.
Si quieres seguir aprendiendo sobre clustering en Python, echa un vistazo a nuestro curso Unsupervised Learning in Python.
Martin Ester, Hans-Peter Kriegel, Jörg Sander y Xiaowei Xu. 1996. A density-based algorithm for discovering clusters a density-based algorithm for discovering clusters in large spatial databases with noise. In Proceedings of the Second International Conference on Knowledge Discovery and Data Mining (KDD'96), Evangelos Simoudis, Jiawei Han y Usama Fayyad (Eds.). AAAI Press 226-231.
https://towardsdatascience.com/how-dbscan-works-and-why-should-i-use-it-443b4a191c80
https://www.coursera.org/learn/predictive-analytics/lecture/EVHfy/dbscan
Más sobre Python
Curso
Curso
Curso
Tutorial
Kevin Babitz
8 min
Tutorial
Duong Vu
11 min
Tutorial
Abid Ali Awan
14 min
Tutorial
Karlijn Willems
15 min
Tutorial
Aditya Sharma
15 min
Tutorial
Satyam Tripathi
9 min