Kurs
Unsupervised Learning in Python
4 Std.
183.2K
Kurz gesagt: Beim Clustering geht es darum, Objekte so zu gruppieren, dass sich Objekte innerhalb eines Clusters stärker ähneln als Objekte in anderen Clustern. Ähnlichkeit beschreibt, wie eng zwei Datenobjekte miteinander verbunden sind. Clustering wird vor allem in der explorativen Datenanalyse eingesetzt. Es findet breite Anwendung in Bereichen wie Machine Learning, Mustererkennung, Bildanalyse, Information Retrieval, Bioinformatik, Datenkompression und Computergrafik.
Es gibt viele Familien von Clustering-Verfahren, und du kennst vermutlich den Klassiker: K-Means (gehört zur Familie der zentroidbasierten Verfahren). Zur Auffrischung: K-Means bestimmt k Zentroiden in den Daten und ordnet Punkte dem jeweils nächstgelegenen Zentroid zu.
K-Means ist zwar leicht verständlich und einfach umzusetzen, aber der Algorithmus berücksichtigt Ausreißer nicht. Dadurch werden alle Punkte einem Cluster zugeordnet, selbst wenn sie eigentlich zu keinem gehören. In der Anomalieerkennung ist das problematisch, weil anomale Punkte im selben Cluster wie „normale“ Daten landen. Diese Ausreißer ziehen das Zentroid zu sich hin und erschweren die korrekte Einordnung als Anomalien.
In diesem Tutorial lernst du ein anderes Clustering-Verfahren kennen: dichtebasiertes Clustering, konkret DBSCAN (ein dichtebasiertes Clustering-Verfahren). Im Vergleich zu zentroidbasierten Methoden wie K-Means identifiziert dichtebasiertes Clustering „dichte“ Punktansammlungen. Dadurch erkennt es Cluster beliebiger Form und findet zugleich Ausreißer in den Daten.
Bevor wir die Nachteile betrachten, ein kurzer Überblick: Ein Zentroid ist ein (realer oder imaginärer) Datenpunkt im Zentrum eines Clusters. Bei zentroidbasiertem Clustering werden Cluster durch einen zentralen Vektor, also ein Zentroid, repräsentiert. Dieses Zentroid muss nicht zwingend Teil des Datensatzes sein. Das Verfahren iteriert und misst Ähnlichkeit darüber, wie nah ein Punkt am Zentroid seines Clusters liegt.
Datensätze enthalten manchmal Extremwerte außerhalb des Erwartungsbereichs, die sich stark vom Rest unterscheiden. Diese nennt man Ausreißer. Formal ist ein Ausreißer eine Beobachtung, die in einer Stichprobe ungewöhnlich weit von anderen Werten entfernt liegt.
Der Kern zentroidbasierter Verfahren sind Distanzmessungen zwischen Datenpunkten und Zentroiden. Deshalb scheitern solche Verfahren häufig daran, Punkte zu identifizieren, die stark von der „normalen“ Datenverteilung abweichen. Schon bevor Vorhersagemodelle trainiert werden, können Ausreißer zu irreführenden Darstellungen und Interpretationen führen. Das ist unerwünscht, wenn man effiziente prädiktive und analytische Modelle entwickeln möchte.
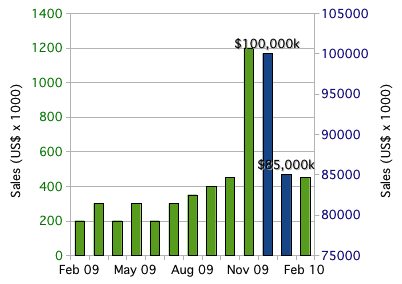
In diesem Balkendiagramm kannst du die zwei höheren Balken als Ausreißer betrachten:
Bevor wir ins dichtebasierte Clustering einsteigen, brauchen wir ein Konzept: ɛ-Nachbarschaften.
Die Idee dahinter: Zu einem gegebenen Punkt möchtest du die Punkte in seiner Umgebung betrachten können. Formal gilt für ein reelles ɛ > 0 und einen Punkt p: Die ɛ-Nachbarschaft von p ist die Menge aller Punkte in höchstens ɛ Abstand zu p.
Aus der Geometrie weißt du: In 2D ist die Menge aller Punkte mit gleichem Abstand zum Zentrum ein Kreis. In 2D ist die ɛ-Nachbarschaft eines Punkts p also die Punktmenge innerhalb eines Kreises mit Radius ɛ um p. In 3D ist es eine Kugel, in höheren Dimensionen die N-Sphäre mit Radius ɛ um p.
Ein Beispiel macht es greifbarer. Im folgenden Bild sind 100 Punkte im Intervall [1,3]X[2,4] verteilt. Wählen wir den Punkt (3,2) als p.

Betrachten wir zuerst die Nachbarschaft von p mit Radius 0,5 (ɛ = 0,5), also die Punkte im Abstand höchstens 0,5 zu p.

Die halbtransparente grüne Ellipse stellt unsere Nachbarschaft dar, sie enthält 31 Punkte. Bei 100 Punkten insgesamt heißt das: Knapp ein Drittel der Punkte liegt in der ɛ-Nachbarschaft von p mit Radius 0,5.
Ändern wir nun den Radius auf 0,15 (ɛ = 0,15) und betrachten die kleinere Nachbarschaft.

Die Nachbarschaft ist geschrumpft und enthält nur noch 3 Punkte. Durch die Verringerung von ɛ von 0,5 auf 0,15 (−70%) sank die Punktzahl in der Nachbarschaft von 31 auf 3 (−90%).
Mit diesem Verständnis von „Nachbarschaft“ kommt der nächste wichtige Begriff: die „Dichte“ einer Nachbarschaft (wir steuern ja auf „dichtebasiertes Clustering“ zu).
Aus dem Schulunterricht kennst du Dichte = Masse/Volumen. Übertragen wir das auf einen Punkt p: Für die Nachbarschaft mit Radius ɛ ist die Masse die Anzahl der darin enthaltenen Datenpunkte (oder der Anteil daran), und das Volumen ist das Volumen der Nachbarschaftsform. In 2D ist das ein Kreis, das Volumen entspricht also der Kreisfläche. In 3D und darüber ist es das Kugel- bzw. Sphärenvolumen.
Betrachten wir wieder p = (3,2) mit Radius 0,5.
Die Masse ist die Punktzahl in der Nachbarschaft, also Masse = 31. Das Volumen ist die Kreisfläche, also Volumen = π0,52 = π/4. Unsere lokale Dichteabschätzung an p = (3,2) lautet damit: Dichte = Masse/Volumen = 31/(π/4) = 124/π ≈ 39,5.
Der absolute Wert ist allein nicht aussagekräftig. Berechnest du aber für alle Punkte die lokale Dichte, könntest du clustern, indem du Punkte, die nah beieinander liegen (in derselben Nachbarschaft) und ähnliche lokale Dichten haben, demselben Cluster zuordnest. Verringerst du ɛ, entstehen kleinere Nachbarschaften (weniger Volumen) mit weniger Punkten. Ideal ist es, sehr dichte Nachbarschaften zu finden, in denen viele Punkte liegen, deren Volumen aber klein ist.
Das ist nicht exakt, wie DBSCAN oder der Level-Set-Tree-Algorithmus (ein weiteres dichtebasiertes Verfahren) arbeiten, liefert aber die grundlegende Intuition hinter dichtebasiertem Clustering.
Zusammengefasst: Du hast ɛ-Nachbarschaften kennengelernt und wie sie helfen, den Raum um einen Punkt zu betrachten. Dann hast du eine Dichtedefinition für eine gegebene Nachbarschaft gesehen. Im nächsten Abschnitt lernst du den DBSCAN-Algorithmus kennen, bei dem die ɛ-Kugel ein zentrales Werkzeug zur Clusterdefinition ist.
DBSCAN steht für Density-Based Spatial Clustering of Applications with Noise und ist das bekannteste dichtebasierte Clustering-Verfahren. Es wurde 1996 von Ester et al. vorgestellt. Aufgrund seiner Bedeutung in Theorie und Praxis erhielt es 2014 auf der SIGKDD einen Test of Time Award.
Im Gegensatz zu K-Means benötigt DBSCAN keine Vorgabe der Clusteranzahl. Es leitet sie aus den Daten ab und findet Cluster beliebiger Form (K-Means entdeckt meist kugelförmige Cluster). Wie oben gesehen, ist die ɛ-Nachbarschaft zentral für die lokale Dichteabschätzung. Der Algorithmus hat zwei Parameter:
Mit diesen Parametern teilt DBSCAN Punkte in drei Kategorien ein:
Diese Definitionen wirken abstrakt. Schauen wir genauer hin.
Kernpunkte:
Kernpunkte bilden das Fundament unserer Cluster und basieren auf der zuvor beschriebenen Dichteabschätzung. Du nutzt überall dasselbe ɛ, daher ist das Volumen aller Nachbarschaften gleich. Unterschiedlich ist die Punktzahl in jeder Nachbarschaft. Du kannst die Punktzahl als „Masse“ ansehen. Bei konstantem Volumen und variabler Masse setzt ein Schwellwert für die minimale Masse faktisch eine Mindestdichte. Kernpunkte sind also Punkte, die eine Mindestdichte erfüllen. Um sie herum bauen wir die Cluster auf, und über den Parameter minPts steuerst du, wie dicht die Clusterkerne sein müssen.
Randpunkte:
Randpunkte liegen im Cluster, sind aber keine Kernpunkte. In der Definition habe ich „dichte-erreichbar“ verwendet. Der Begriff ist simpel. Betrachten wir erneut das Beispiel mit ɛ = 0,15. Der schwarze Punkt r liegt außerhalb der Nachbarschaft von p.

Alle Punkte in der Nachbarschaft von p sind direkt von p erreichbar. Untersuchen wir nun die Nachbarschaft eines Punkts q, der direkt von p erreichbar ist. Der gelbe Kreis zeigt die Nachbarschaft von q.

Der Zielpunkt r liegt zwar nicht in der Nachbarschaft von p, aber in der Nachbarschaft von q. Das ist die Idee von dichte-erreichbar: Wenn du r durch „Nachbarschaftssprünge“ ab einem Punkt p erreichen kannst, ist r von p dichte-erreichbar.

Als Analogie: Dichte-erreichbare Punkte sind „Freunde von Freunden“. Direkt erreichbare Punkte eines Kernpunkts p sind seine „Freunde“, Punkte in den Nachbarschaften dieser Freunde sind „Freunde der Freunde“. Wichtig: Dichte-Erreichbarkeit ist nicht auf zwei Sprünge begrenzt. Solange du mit Nachbarschaftssprüngen von einem Kernpunkt p aus dorthin kommst, ist der Punkt dichte-erreichbar – also auch „Freunde von Freunden von Freunden …“.
Behalte im Kopf: Dichte-Erreichbarkeit hängt von ɛ ab. Größeres ɛ macht mehr Punkte dichte-erreichbar, kleineres ɛ weniger.
Ausreißer:
Schließlich die „sonstige“ Klasse. Ausreißer sind Punkte, die keine Kernpunkte sind und nicht nah genug an einem Cluster liegen, um von einem Kernpunkt aus dichte-erreichbar zu sein. Sie werden keinem Cluster zugeordnet und können je nach Kontext als Anomalien gelten.
DBSCAN ist bereits hervorragend in der beliebten Python-Machine-Learning-Bibliothek Scikit-Learn implementiert. Da diese Implementierung skalierbar und gut getestet ist, verwenden wir sie, um DBSCAN in der Praxis zu demonstrieren.
Die Schritte des DBSCAN-Algorithmus sind:
Für die Fallstudie nutzen wir einen Datensatz mit jährlichen Kundendaten eines Großhändlers.
Also los geht’s.
# Let's import all your dependencies first

from sklearn.cluster import DBSCAN
from sklearn.preprocessing import StandardScaler
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
Der Datensatz umfasst 440 Kundinnen und Kunden und enthält 8 Attribute pro Kunde. Mit Pandas importierst du die CSV-Datei und wandelst sie in ein DataFrame um.
Beim Import der CSV-Datei in das DataFrame achte auf den korrekten Dateipfad.
# Import .csv file and convert it to a DataFrame object
df = pd.read_csv("C:/Users/Sayak/data/customers.csv");

print(df.head())
   Channel  Region  Fresh  Milk  Grocery  Frozen  Detergents_Paper  \
0        2       3  12669  9656     7561     214              2674
1        2       3   7057  9810     9568    1762              3293
2        2       3   6353  8808     7684    2405              3516
3        1       3  13265  1196     4221    6404               507
4        2       3  22615  5410     7198    3915              1777

   Delicatessen
0          1338
1          1776
2          7844
3          1788
4          5185
Bevor du DBSCAN anwendest, ist es wichtig, die Daten zu verstehen: Welche Merkmale gibt es, welche Verteilungen liegen vor, welche Features sind numerisch usw.
Laut Beschreibung im offiziellen UCI Machine Learning Repository gelten für die Features:
Jetzt, da du die Features kennst, schauen wir uns ein paar Statistiken an.
print(df.info())
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 440 entries, 0 to 439
Data columns (total 8 columns):
Channel             440 non-null int64
Region              440 non-null int64
Fresh               440 non-null int64
Milk                440 non-null int64
Grocery             440 non-null int64
Frozen              440 non-null int64
Detergents_Paper    440 non-null int64
Delicatessen        440 non-null int64
dtypes: int64(8)
memory usage: 27.6 KB
None
Wie du siehst, gibt es keine fehlenden Werte und alle Daten sind vom Typ Integer. Das reduziert den Vorverarbeitungsaufwand. Schauen wir noch genauer hin.
print(df.describe())
          Channel      Region          Fresh          Milk       Grocery  \
count  440.000000  440.000000     440.000000    440.000000    440.000000
mean     1.322727    2.543182   12000.297727   5796.265909   7951.277273
std      0.468052    0.774272   12647.328865   7380.377175   9503.162829
min      1.000000    1.000000       3.000000     55.000000      3.000000
25%      1.000000    2.000000    3127.750000   1533.000000   2153.000000
50%      1.000000    3.000000    8504.000000   3627.000000   4755.500000
75%      2.000000    3.000000   16933.750000   7190.250000  10655.750000
max      2.000000    3.000000  112151.000000  73498.000000  92780.000000

             Frozen  Detergents_Paper  Delicatessen
count    440.000000        440.000000    440.000000
mean    3071.931818       2881.493182   1524.870455
std     4854.673333       4767.854448   2820.105937
min       25.000000          3.000000      3.000000
25%      742.250000        256.750000    408.250000
50%     1526.000000        816.500000    965.500000
75%     3554.250000       3922.000000   1820.250000
max    60869.000000      40827.000000  47943.000000
Hier erhältst du die wichtigsten Kennzahlen wie Standardabweichung, Mittelwert und Maximum für jedes Feature. Die meisten Daten sind stetig; zwei Ausnahmen sind Channel und Region. Zur Vereinfachung lassen wir diese weg:
df.drop(["Channel", "Region"], axis = 1, inplace = True)
# Let's get a view of the data after the drop

print(df.head())
   Fresh  Milk  Grocery  Frozen  Detergents_Paper  Delicatessen
0  12669  9656     7561     214              2674          1338
1   7057  9810     9568    1762              3293          1776
2   6353  8808     7684    2405              3516          7844
3  13265  1196     4221    6404               507          1788
4  22615  5410     7198    3915              1777          5185
Zur Visualisierung nutzen wir zwei Features:
# Let's plot the data now
x = df['Grocery']
y = df['Milk']

plt.scatter(x,y)
plt.xlabel("Groceries")
plt.ylabel("Milk")
plt.show()
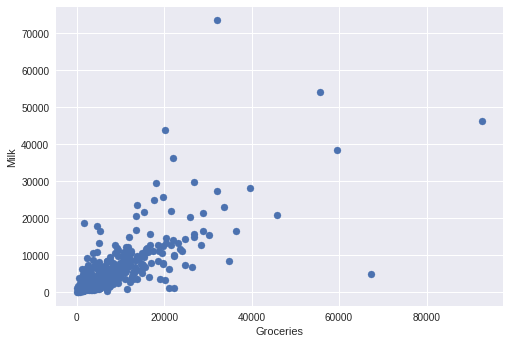
Kurz zu den verwendeten Funktionen: plt.scatter() erstellt den Scatterplot aus den übergebenen Daten (x und y). plt.xlabel() beschriftet die X-Achse (hier: Groceries). plt.ylabel() beschriftet die Y-Achse (hier: Milk). plt.show() zeigt die Grafik an.
Für deine Visualisierungsaufgaben lohnt sich ein Blick in die Welt von Matplotlib. Die Dokumentation ist hervorragend.
Die weit abliegenden Punkte springen ins Auge, oder? Das sind deine Ausreißer.
Mit DBSCAN möchten wir die Hauptgruppe der Kundschaft identifizieren und zugleich Kundinnen und Kunden mit ungewöhnlichen Kaufmustern als Ausreißer markieren.
Da die Werte im Tausenderbereich liegen, normalisieren wir die Attribute auf Mittelwert 0 und Varianz 1. So bleiben die Beziehungen zwischen den Features erhalten und kleine Änderungen in einem Merkmal spiegeln sich in anderen wider.
df = df[["Grocery", "Milk"]]
df = df.as_matrix().astype("float32", copy = False)
stscaler = StandardScaler().fit(df)
df = stscaler.transform(df)
Wir erzeugen ein DBSCAN-Objekt, das mindestens 15 Punkte in einer Nachbarschaft mit Radius 0,5 für einen Kernpunkt verlangt.
dbsc = DBSCAN(eps = .5, min_samples = 15).fit(df)
Als Nächstes extrahieren wir die Clusterlabels und die Ausreißer und visualisieren das Ergebnis.
labels = dbsc.labels_
core_samples = np.zeros_like(labels, dtype = bool)
core_samples[dbsc.core_sample_indices_] = True

Wie erwartet erkennt DBSCAN einen Cluster von Kundinnen und Kunden mit Ausgaben nahe dem Mittelwert für Lebensmittel und Milchprodukte. Zudem markiert der Algorithmus Personen, deren Kaufverhalten stark vom Rest abweicht.
Da Ausreißer Kundinnen und Kunden mit extremen Kaufmustern entsprechen, könnte der Großhändler sie gezielt mit exklusiven Rabatten ansprechen, um größere Einkäufe zu fördern.
Angenommen, wir betreiben einen E-Commerce-Shop und möchten den Umsatz mit relevanten Produktempfehlungen steigern. Wir wissen nicht exakt, wonach Kundinnen und Kunden suchen, können aber auf Basis von Daten passende Empfehlungen aussprechen. Mit DBSCAN clustern wir Kaufmuster aus dem Shop-Datensatz. Über diese Cluster finden wir Kundinnen und Kunden mit ähnlichem Verhalten. Beispiel: Kundin A kauft Stift, Buch und Schere, Kunde B kauft Buch und Schere – dann empfehlen wir B einen Stift.
Vor dem Aufkommen tiefer neuronaler Verfahren nutzten Forschende DBSCAN, um in Gendatensätzen die Gene zu separieren, die potenziell an Krebs beteiligt sind.
Wissenschaftlerinnen und Wissenschaftler setzten DBSCAN ein, um Stopps in Trajektoriendaten von mobilen GPS-Geräten zu erkennen. Stopps stellen die aussagekräftigsten Abschnitte einer Trajektorie dar.
In diesem Beitrag hast du die zentralen Nachteile zentroidbasierter Verfahren kennengelernt und eine alternative Familie – dichtebasiertes Clustering – entdeckt, die diese Schwächen adressiert.
Du hast verstanden, wie DBSCAN funktioniert, und eine kleine Fallstudie umgesetzt. Außerdem hast du einen Eindruck gewonnen, in welchen realen Problemstellungen DBSCAN erfolgreich eingesetzt wird. Als weiterführende Lektüre empfehle ich dir Methoden wie das Level-Set-Tree-Clustering und die Unterschiede zu DBSCAN.
Wenn du mehr über Clustering in Python lernen möchtest, schau dir unseren Kurs Unsupervised Learning in Python an.
Martin Ester, Hans-Peter Kriegel, Jörg Sander und Xiaowei Xu. 1996. A density-based algorithm for discovering clusters a density-based algorithm for discovering clusters in large spatial databases with noise. In Proceedings of the Second International Conference on Knowledge Discovery and Data Mining (KDD'96), Evangelos Simoudis, Jiawei Han und Usama Fayyad (Hrsg.). AAAI Press 226-231.
https://towardsdatascience.com/how-dbscan-works-and-why-should-i-use-it-443b4a191c80
https://www.coursera.org/learn/predictive-analytics/lecture/EVHfy/dbscan
Mehr über Python lernen
Kurs
Kurs
Kurs