Curso
Unsupervised Learning em Python
4 h
183.3K
De forma resumida, clusterização é a tarefa de agrupar um conjunto de objetos de modo que os objetos no mesmo grupo sejam mais parecidos entre si do que com os de outros grupos. Similaridade é uma medida que reflete a força da relação entre dois objetos de dados. A clusterização é usada principalmente para exploração em mineração de dados. Ela tem aplicações em diversas áreas como machine learning, reconhecimento de padrões, análise de imagens, recuperação de informação, bioinformática, compressão de dados e computação gráfica.
Existem muitas famílias de técnicas de clusterização, e você provavelmente conhece a mais famosa: K-Means (que pertence à família de clusterização baseada em centróides). Relembrando rapidamente, K-Means determina k centróides nos dados e agrupa os pontos atribuindo-os ao centróide mais próximo.
Embora K-Means seja fácil de entender e implementar na prática, o algoritmo não lida com outliers: todos os pontos são atribuídos a algum cluster, mesmo quando não pertencem a nenhum. No contexto de detecção de anomalias, isso causa problemas, pois pontos anômalos acabam no mesmo cluster de pontos “normais”. Esses pontos anômalos puxam o centróide do cluster na direção deles, dificultando classificá-los como anômalos.
Este tutorial aborda outro tipo de técnica de clusterização conhecida como clusterização baseada em densidade, especificamente o DBSCAN (uma técnica de clusterização baseada em densidade). Em comparação com métodos baseados em centróides como K-Means, a clusterização por densidade identifica regiões “densas” de pontos, permitindo aprender clusters de formato arbitrário e identificar outliers nos dados.
Antes de falar das desvantagens, um breve contexto: um centróide é um ponto de dados (imaginário ou real) no centro de um cluster. Na clusterização baseada em centróides, os clusters são representados por um vetor central, o centróide. Esse centróide não precisa, necessariamente, ser um membro do conjunto de dados. Essa abordagem é iterativa e a noção de similaridade vem da proximidade de um ponto de dados ao centróide do cluster.
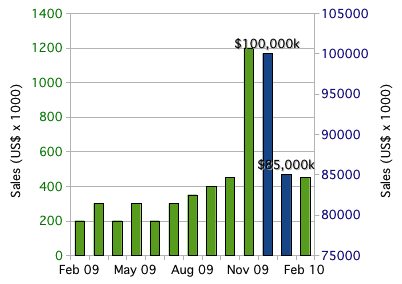
Às vezes, um conjunto de dados contém valores extremos fora do padrão esperado e diferentes do restante. Esses são os outliers. De forma mais formal, um outlier é uma observação que está a uma distância anormal dos demais valores em uma amostra aleatória de uma população.
O fundamento das técnicas baseadas em centróides é a medida de distância entre pontos e centróides. Por isso, essas técnicas geralmente falham em identificar pontos que se desviam fortemente da distribuição “normal” dos dados. Mesmo antes de construir modelos preditivos, outliers podem levar a representações enganosas e, consequentemente, a interpretações equivocadas dos dados coletados. Isso não é desejável para construir modelos preditivos e analíticos eficientes.
Você pode considerar as duas barras mais altas (em relação ao restante) como outliers nesse conjunto de dados específico:
Antes de falar de clusterização por densidade, precisamos abordar um tópico: vizinhanças-ɛ.
A ideia geral por trás de vizinhanças-ɛ é: dado um ponto de dados, queremos raciocinar sobre os pontos no espaço ao seu redor. Formalmente, para algum ɛ real > 0 e um ponto p, a vizinhança-ɛ de p é o conjunto de pontos a, no máximo, distância ɛ de p.
Se você lembrar de geometria, a forma em que todos os pontos estão a mesma distância do centro é o círculo. Em 2D, a vizinhança-ɛ de um ponto p é o conjunto de pontos contidos em um círculo de raio ɛ, centrado em p. Em 3D, é uma esfera de raio ɛ, centrada em p, e em dimensões superiores, é a N-esfera de raio ɛ, centrada em p.
Vamos a um exemplo para concretizar a ideia. Na imagem abaixo, 100 pontos estão distribuídos no intervalo [1,3]X[2,4]. Vamos escolher o ponto (3,2) como nosso p.

Primeiro, considere a vizinhança de p com raio 0,5 (ɛ = 0,5), o conjunto de pontos a uma distância de até 0,5 de p.

A elipse verde opaca representa nossa vizinhança, que contém 31 pontos. Como distribuímos 100 pontos e 31 estão na vizinhança, isso significa que pouco menos de um terço dos pontos estão dentro da vizinhança de p com raio 0,5.
Agora, vamos mudar o raio para 0,15 (ɛ = 0,15) e considerar a vizinhança menor resultante.

A vizinhança encolheu e agora apenas 3 pontos estão contidos nela. Ao diminuir ɛ de 0,5 para 0,15 (redução de 70%), o número de pontos na vizinhança caiu de 31 para 3 (redução de 90%).
Com a noção de “vizinhança” mais clara, vamos ao próximo conceito importante: a noção de “densidade” de uma vizinhança (afinal, estamos a caminho de aprender clusterização baseada em densidade).
No ensino fundamental, aprendemos que densidade = massa/volume. Vamos usar essa ideia para definir a densidade em um ponto p. Dado p e sua vizinhança de raio ɛ, podemos definir a massa da vizinhança como o número de pontos (ou a fração de pontos) contidos nela, e o volume como o volume da forma geométrica correspondente. Em 2D, a vizinhança é um círculo, então o volume é a área do círculo. Em 3D e dimensões superiores, é a esfera ou n-esfera, e podemos calcular seu volume.
Por exemplo, considere novamente a vizinhança de p = (3,2) com raio 0,5.
A massa é o número de pontos na vizinhança, então massa = 31. O volume é a área do círculo, logo volume = π0,52 = π/4. Portanto, nossa aproximação de densidade local em p = (3,2) é densidade = massa/volume = 31/(π/4) = 124/π ~= 39,5.
Esse valor, isoladamente, não diz muito, mas se calcularmos a densidade local aproximada para todos os pontos do conjunto, podemos agrupar dizendo que pontos próximos (contidos na mesma vizinhança) e com densidades locais semelhantes pertencem ao mesmo cluster. Se diminuirmos ɛ, construímos vizinhanças menores (menos volume) que também contêm menos pontos. Idealmente, queremos identificar vizinhanças altamente densas, onde a maioria dos pontos está contida, mas com volume relativamente pequeno.
Embora isso não seja exatamente o que o DBSCAN ou o algoritmo Level Set Tree (outro método da família baseada em densidade) fazem, essa é a intuição por trás da clusterização por densidade.
Recapitulando: vimos as vizinhanças-ɛ e como elas permitem raciocinar sobre o espaço ao redor de um ponto. Em seguida, entendemos uma noção de densidade em um ponto para uma vizinhança específica. Na próxima seção, você conhecerá o algoritmo DBSCAN, no qual a “bola-ɛ” é uma ferramenta fundamental para definir clusters.
DBSCAN significa Density-Based Spatial Clustering of Applications with Noise e é, de longe, o algoritmo de clusterização por densidade mais conhecido. Ele foi apresentado pela primeira vez em 1996 por Ester et al.. Pela sua importância teórica e prática, foi um dos três algoritmos premiados com o Test of Time Award no SIGKDD 2014.
Diferente do K-Means, o DBSCAN não exige o número de clusters como parâmetro. Ele infere essa quantidade a partir dos dados e consegue descobrir clusters de formas arbitrárias (enquanto K-Means tende a encontrar clusters esféricos). Como vimos, a vizinhança-ɛ é fundamental para aproximar a densidade local, então o algoritmo tem dois parâmetros:
Usando esses dois parâmetros, o DBSCAN classifica os pontos em três categorias:
Essas definições podem parecer abstratas, então vamos detalhar.
Pontos centrais:
Pontos centrais são a base dos nossos clusters e se apoiam na aproximação de densidade vista antes. Usamos o mesmo ɛ para calcular a vizinhança de cada ponto, então o volume de todas as vizinhanças é o mesmo. O que varia é a quantidade de pontos em cada vizinhança. Lembre-se: podemos pensar no número de pontos como a “massa” da vizinhança. O volume é constante e a massa é variável; ao definir um limiar mínimo de massa para ser ponto central, estamos, na prática, definindo um limiar mínimo de densidade. Portanto, pontos centrais são aqueles que satisfazem um requisito mínimo de densidade. Os clusters são construídos ao redor desses pontos (daí o “central”), e ajustando minPts você controla quão densos devem ser os núcleos dos clusters.
Pontos de borda:
Pontos de borda são os que pertencem aos clusters, mas não são centrais. Na definição acima, usamos o termo “alcançável por densidade”. Ainda não definimos formalmente, mas o conceito é simples. Para explicar, vamos revisitar o exemplo da vizinhança com epsilon = 0,15. Considere o ponto r (o ponto preto) que está fora da vizinhança de p.

Todos os pontos dentro da vizinhança de p são diretamente alcançáveis a partir de p. Agora, vamos explorar a vizinhança do ponto q, que é diretamente alcançável a partir de p. O círculo amarelo representa a vizinhança de q.

Embora o ponto-alvo r não esteja na vizinhança de p, ele está contido na vizinhança de q. Essa é a ideia de “alcançável por densidade”: se você pode chegar a r pulando de vizinhança em vizinhança, começando em p, então r é alcançável por densidade a partir de p.

Por analogia, pense em pontos alcançáveis por densidade como “amigos de um amigo”. Se os diretamente alcançáveis de um ponto central p são seus “amigos”, então os alcançáveis por densidade — os pontos nas vizinhanças dos “amigos” de p — são os “amigos dos amigos”. E não se limita a dois pulos de vizinhança: enquanto você conseguir chegar ao ponto com “pulos de vizinhança”, começando em um ponto central p, ele é alcançável por densidade a partir de p — ou seja, “amigo do amigo do amigo … do amigo” também conta.
É importante lembrar que essa ideia depende do valor de ɛ. Ao escolher ɛ maiores, mais pontos se tornam alcançáveis por densidade; com ɛ menores, menos pontos serão alcançáveis.
Outliers:
Por fim, a “classe restante”. Outliers são pontos que não são centrais nem estão próximos o suficiente de um cluster para serem alcançáveis por densidade a partir de um ponto central. Eles não são atribuídos a nenhum cluster e, dependendo do contexto, podem ser considerados anômalos.
O DBSCAN já está muito bem implementado na popular biblioteca de machine learning em Python Scikit-Learn, e como essa implementação é escalável e bem testada, vamos usá-la para ver o DBSCAN na prática.
Os passos do algoritmo DBSCAN são:
Para este estudo de caso, vamos usar um conjunto de dados com informações anuais de clientes de um distribuidor atacadista.
Vamos começar.
# Vamos importar todas as dependências primeiro

from sklearn.cluster import DBSCAN
from sklearn.preprocessing import StandardScaler
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
O conjunto de dados tem 440 clientes e 8 atributos para cada um. Vamos usar a biblioteca Pandas para importar o arquivo .csv e convertê-lo em um DataFrame.
Ao importar seu arquivo .csv, certifique-se de informar o caminho correto.
# Importa o arquivo .csv e converte para DataFrame
df = pd.read_csv("C:/Users/Sayak/data/customers.csv");

print(df.head())
   Channel  Region  Fresh  Milk  Grocery  Frozen  Detergents_Paper  \
0        2       3  12669  9656     7561     214              2674
1        2       3   7057  9810     9568    1762              3293
2        2       3   6353  8808     7684    2405              3516
3        1       3  13265  1196     4221    6404               507
4        2       3  22615  5410     7198    3915              1777

   Delicatessen
0          1338
1          1776
2          7844
3          1788
4          5185
Antes de aplicar o DBSCAN, é importante conhecer bem os dados: que tipo de informação há no dataset, qual a distribuição e quais features são numéricas ou não.
De acordo com a descrição no repositório UCI, as features do dataset são:
Agora que você conhece as features, vamos exibir algumas estatísticas dos dados.
print(df.info())
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 440 entries, 0 to 439
Data columns (total 8 columns):
Channel             440 non-null int64
Region              440 non-null int64
Fresh               440 non-null int64
Milk                440 non-null int64
Grocery             440 non-null int64
Frozen              440 non-null int64
Detergents_Paper    440 non-null int64
Delicatessen        440 non-null int64
dtypes: int64(8)
memory usage: 27.6 KB
None
Como dá para ver, não há valores ausentes e todos os dados são do tipo inteiro. Isso reduz o esforço de pré-processamento. Vamos aprofundar um pouco.
print(df.describe())
          Channel      Region          Fresh          Milk       Grocery  \
count  440.000000  440.000000     440.000000    440.000000    440.000000
mean     1.322727    2.543182   12000.297727   5796.265909   7951.277273
std      0.468052    0.774272   12647.328865   7380.377175   9503.162829
min      1.000000    1.000000       3.000000     55.000000      3.000000
25%      1.000000    2.000000    3127.750000   1533.000000   2153.000000
50%      1.000000    3.000000    8504.000000   3627.000000   4755.500000
75%      2.000000    3.000000   16933.750000   7190.250000  10655.750000
max      2.000000    3.000000  112151.000000  73498.000000  92780.000000

             Frozen  Detergents_Paper  Delicatessen
count    440.000000        440.000000    440.000000
mean    3071.931818       2881.493182   1524.870455
std     4854.673333       4767.854448   2820.105937
min       25.000000          3.000000      3.000000
25%      742.250000        256.750000    408.250000
50%     1526.000000        816.500000    965.500000
75%     3554.250000       3922.000000   1820.250000
max    60869.000000      40827.000000  47943.000000
A partir desse output, você obtém medidas como desvio padrão, média e máximo de cada feature. Dá para ver que a maior parte dos dados é contínua, com exceção de duas: Channel e Region. Para simplificar os cálculos, vamos removê-las:
df.drop(["Channel", "Region"], axis = 1, inplace = True)
# Vamos ver os dados após a remoção

print(df.head())
   Fresh  Milk  Grocery  Frozen  Detergents_Paper  Delicatessen
0  12669  9656     7561     214              2674          1338
1   7057  9810     9568    1762              3293          1776
2   6353  8808     7684    2405              3516          7844
3  13265  1196     4221    6404               507          1788
4  22615  5410     7198    3915              1777          5185
Para visualizar os dados, vamos usar duas features:
# Vamos plotar os dados agora
x = df['Grocery']
y = df['Milk']

plt.scatter(x,y)
plt.xlabel("Groceries")
plt.ylabel("Milk")
plt.show()
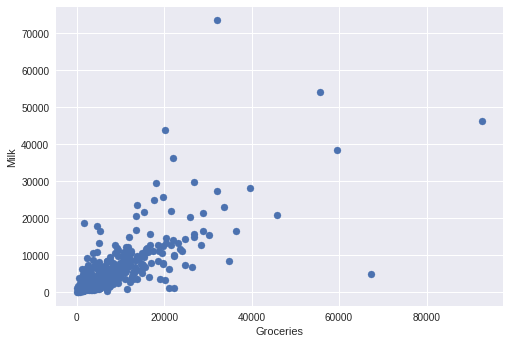
Um breve resumo das funções usadas na plotagem: plt.scatter(): cria o diagrama de dispersão a partir dos dados (os parâmetros x e y que você fornece). plt.xlabel(): define o rótulo do eixo X (neste caso, Groceries). plt.ylabel(): define o rótulo do eixo Y (aqui, Milk). plt.show(): exibe o gráfico gerado.
Vale a pena explorar o universo do Matplotlib para visualização. A documentação é excelente.
Fica fácil notar pontos que estão bem afastados, certo? Esses são os seus outliers.
Com o DBSCAN, queremos identificar o cluster principal de clientes e também sinalizar clientes com hábitos de compra anuais mais incomuns como outliers.
Como os valores estão na casa dos milhares, vamos normalizar cada atributo, escalonando para média 0 e variância 1. Isso ajuda a manter as relações entre as features, de modo que uma pequena variação em uma se reflita nas outras.
df = df[["Grocery", "Milk"]]
df = df.as_matrix().astype("float32", copy = False)
stscaler = StandardScaler().fit(df)
df = stscaler.transform(df)
Vamos construir um objeto DBSCAN que exige, no mínimo, 15 pontos em uma vizinhança de raio 0,5 para considerar um ponto como central.
dbsc = DBSCAN(eps = .5, min_samples = 15).fit(df)
Em seguida, podemos extrair os rótulos dos clusters e os outliers para plotar os resultados.
labels = dbsc.labels_
core_samples = np.zeros_like(labels, dtype = bool)
core_samples[dbsc.core_sample_indices_] = True

De acordo com a intuição, o DBSCAN identificou um cluster de clientes próximos às médias de compras de mercearia e leite. Além disso, conseguiu sinalizar clientes cujo comportamento anual de compras se desviava demais dos demais.
Como os outliers correspondiam a clientes com comportamento de compra mais extremo, o distribuidor atacadista poderia segmentá-los com descontos exclusivos para incentivar compras maiores.
Suponha que temos um e-commerce e queremos melhorar as vendas recomendando produtos relevantes. Não sabemos exatamente o que cada cliente busca, mas com base em um dataset podemos prever e recomendar itens relevantes a um cliente específico. Podemos aplicar DBSCAN ao conjunto de dados (derivado do banco do e-commerce) e encontrar clusters com base nos produtos comprados. A partir desses clusters, identificamos semelhanças entre clientes. Por exemplo, se o cliente A comprou uma caneta, um livro e uma tesoura, enquanto o cliente B comprou um livro e uma tesoura, podemos recomendar uma caneta ao cliente B.
Antes da popularização de metodologias avançadas baseadas em deep learning, pesquisadores usavam DBSCAN para separar genes em datasets que tinham chance de mediar câncer.
Cientistas já usaram DBSCAN para detectar “paradas” em trajetórias geradas por GPS móvel. As paradas representam a parte mais significativa e importante de uma trajetória.
Neste post, você viu as principais desvantagens da clusterização baseada em centróides e conheceu outra família de técnicas: a clusterização baseada em densidade. Também viu como elas superam limitações dos métodos por centróides.
Você aprendeu como o DBSCAN funciona e ainda fez um estudo de caso. Além disso, teve uma boa visão de problemas reais em que o DBSCAN é aplicado. Para continuar, recomendo explorar outros métodos baseados em densidade, como o Level Set Tree clustering, e entender como ele difere do DBSCAN.
Se quiser aprender mais sobre clusterização em Python, faça nosso curso Unsupervised Learning in Python.
Martin Ester, Hans-Peter Kriegel, Jörg Sander e Xiaowei Xu. 1996. A density-based algorithm for discovering clusters a density-based algorithm for discovering clusters in large spatial databases with noise. In Proceedings of the Second International Conference on Knowledge Discovery and Data Mining (KDD'96), Evangelos Simoudis, Jiawei Han e Usama Fayyad (Eds.). AAAI Press 226-231.
https://towardsdatascience.com/how-dbscan-works-and-why-should-i-use-it-443b4a191c80
https://www.coursera.org/learn/predictive-analytics/lecture/EVHfy/dbscan
Saiba mais sobre Python
Curso
Curso
Curso
blog
Moez Ali
15 min
blog
Kurtis Pykes
7 min
Tutorial
Kevin Babitz
8 min
Tutorial
Eugenia Anello
8 min
Tutorial
Abid Ali Awan
14 min
Tutorial
Moez Ali
9 min