Cours
Apprentissage non supervisé en Python
4 h
183.2K
En bref, le clustering consiste à regrouper un ensemble d’objets de sorte que ceux d’un même groupe soient plus similaires entre eux qu’avec ceux des autres groupes. La similarité reflète l’intensité de la relation entre deux objets de données. Le clustering sert principalement à l’exploration en fouille de données. Il est largement utilisé en apprentissage automatique, reconnaissance de formes, analyse d’images, recherche d’information, bio-informatique, compression de données et infographie.
Il existe de nombreuses familles de méthodes de clustering, et vous connaissez sans doute la plus populaire : K-Means (qui relève de la famille des méthodes à centroïdes). Rappel express : K-Means détermine k centroïdes dans les données et assigne chaque point au centroïde le plus proche.
Si K-Means est simple à comprendre et à mettre en œuvre, l’algorithme ne gère pas les valeurs aberrantes : tous les points sont affectés à un cluster, même s’ils n’appartiennent à aucun. En détection d’anomalies, cela pose problème, car les points anormaux se retrouvent dans le même cluster que les points « normaux ». Ces points tirent alors le centroïde vers eux, ce qui complique leur identification comme anomalies.
Ce tutoriel présente une autre approche : le clustering à base de densité, et plus précisément DBSCAN (Density-Based Spatial Clustering of Applications with Noise). Contrairement aux méthodes à centroïdes comme K-Means, le clustering à base de densité identifie des zones « denses » de points, ce qui lui permet d’apprendre des clusters de forme arbitraire et de repérer les valeurs aberrantes.
Avant d’entrer dans les limites, rappelons la notion de centroïde. Un centroïde est un point de données (imaginaire ou réel) situé au centre d’un cluster. Dans le clustering à centroïde, les clusters sont représentés par un vecteur central. Ce centroïde n’est pas nécessairement un élément du jeu de données. C’est un algorithme itératif où la similarité se mesure à la distance d’un point au centroïde du cluster.
Un jeu de données peut parfois contenir des valeurs extrêmes, en dehors de l’intervalle attendu et différentes du reste : ce sont des valeurs aberrantes. Plus formellement, une valeur aberrante est une observation située à une distance anormalement grande des autres valeurs dans un échantillon aléatoire.
Le principe des méthodes à centroïdes repose sur les distances entre points et centroïdes. Elles peinent donc à identifier les points qui s’écartent fortement de la distribution « normale ». Avant même de construire des modèles prédictifs, ces outliers peuvent induire des représentations et des interprétations trompeuses des données. Ce n’est évidemment pas souhaitable pour bâtir des modèles prédictifs et analytiques fiables.
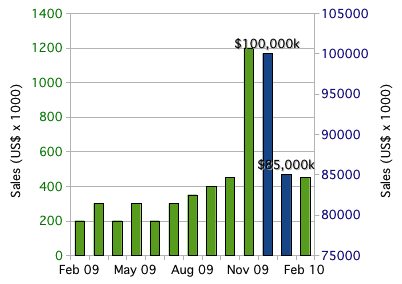
Vous pouvez considérer les deux barres les plus hautes (par rapport aux autres) comme des valeurs aberrantes dans cet exemple :
Avant d’aborder le clustering par densité, commençons par une notion : les ɛ-voisinages.
L’idée générale des ɛ-voisinages est la suivante : pour un point donné, raisonner sur les points situés dans son espace proche. Formellement, pour un ɛ réel > 0 et un point p, le ɛ-voisinage de p est l’ensemble des points à une distance au plus égale à ɛ de p.
Souvenez-vous de la géométrie : l’ensemble des points équidistants d’un centre forme un cercle. En 2D, le ɛ-voisinage de p est l’ensemble des points contenus dans un cercle de rayon ɛ, centré en p. En 3D, c’est une sphère de rayon ɛ, centrée en p, et en dimension supérieure, c’est la N-sphère de rayon ɛ, centrée en p.
Illustrons pour concrétiser. Ci-dessous, 100 points sont dispersés dans l’intervalle [1,3]X[2,4]. Prenons (3,2) comme point p.

Commençons par le voisinage de p de rayon 0,5 (ɛ = 0,5), l’ensemble des points à une distance 0,5 de p.

L’ovale vert opaque représente notre voisinage ; il contient 31 points. Sur 100 points dispersés, un peu moins d’un tiers se trouve donc dans le ɛ-voisinage de p avec un rayon de 0,5.
Changeons maintenant le rayon à 0,15 (ɛ = 0,15) et observons le voisinage plus petit obtenu.

Le voisinage a rétréci : il ne contient plus que 3 points. En diminuant ɛ de 0,5 à 0,15 (−70 %), le nombre de points dans le voisinage est passé de 31 à 3 (−90 %).
Maintenant que la notion de « voisinage » est claire, passons à la suivante : la « densité » d’un voisinage (vous progressez vers le « clustering à base de densité », après tout).
À l’école, on apprend que densité = masse/volume. Reprenons cette idée pour définir la densité en un point p. Pour un point p et son voisinage de rayon ɛ, on définit la masse comme le nombre de points (ou la fraction de points) contenus dans le voisinage, et le volume comme le volume de la forme du voisinage. En 2D, le voisinage est un cercle : le volume est donc l’aire du cercle. En 3D et au-delà, il s’agit d’une sphère ou d’une n-sphère : on calcule alors son volume.
Par exemple, reprenons notre voisinage de p = (3,2) de rayon 0,5.
La masse est le nombre de points dans le voisinage : masse = 31. Le volume est l’aire du cercle : volume = π0,52 = π/4. Notre approximation de densité locale en p = (3,2) vaut donc densité = masse/volume = 31/(π/4) = 124/π ≈ 39,5.
Cette valeur, isolément, n’a pas de sens. Mais si vous calculez la densité locale pour tous les points du jeu de données, vous pouvez regrouper les points proches (dans un même voisinage) ayant des densités locales similaires. En diminuant ɛ, vous construisez des voisinages plus petits (volume moindre) contenant aussi moins de points. L’idéal est d’identifier des voisinages très denses : beaucoup de points dans un volume relativement réduit.
Ce n’est pas exactement ainsi que fonctionnent DBSCAN ou l’algorithme Level Set Tree (autre méthode de la famille densité), mais cela donne l’intuition générale du clustering à base de densité.
En résumé, vous avez vu les ɛ-voisinages et comment raisonner sur l’espace autour d’un point. Puis une notion de densité locale pour un voisinage donné. Dans la section suivante, vous allez découvrir l’algorithme DBSCAN, où la boule de rayon ɛ est un outil clé pour définir les clusters.
DBSCAN signifie Density-Based Spatial Clustering of Applications with Noise et c’est de loin l’algorithme de clustering par densité le plus connu. Il a été introduit en 1996 par Ester et al.. En raison de son importance théorique et pratique, il a reçu l’un des Test of Time Awards à SIGKDD 2014.
Contrairement à K-Means, DBSCAN ne requiert pas de spécifier le nombre de clusters. Il l’infère à partir des données et peut découvrir des clusters de forme arbitraire (K-Means trouve généralement des clusters sphériques). Comme vous l’avez vu, le ɛ-voisinage est fondamental pour approximer la densité locale ; l’algorithme a donc deux paramètres :
Avec ces deux paramètres, DBSCAN classe les points en trois catégories :
Ces définitions peuvent sembler abstraites ; détaillons-les.
Points cœurs :
Les points cœurs constituent la base des clusters, selon l’approximation de densité vue plus haut. Vous utilisez le même ɛ pour tous les points : le volume des voisinages est donc constant. Ce qui varie, c’est le nombre de points dans chaque voisinage (la « masse »). En fixant un seuil minimal de masse pour être un point cœur, vous fixez un seuil minimal de densité. Les points cœurs sont donc ceux qui satisfont une densité minimale. Les clusters se construisent autour d’eux ; en ajustant minPts, vous affinez la densité requise au cœur des clusters.
Points frontières :
Les points frontières appartiennent aux clusters mais ne sont pas des points cœurs. Dans la définition, nous avons utilisé « atteignable par densité » (density-reachable). La notion est simple. Reprenons l’exemple de voisinage avec ɛ = 0,15. Considérons le point r (point noir) en dehors du voisinage de p.

Tous les points à l’intérieur du voisinage de p sont dits directement atteignables depuis p. Explorons maintenant le voisinage d’un point q, directement atteignable depuis p. Le cercle jaune représente le voisinage de q.

Votre point cible r n’est pas dans le voisinage de p, mais il est dans celui de q. C’est l’idée d’atteignabilité par densité : si vous pouvez atteindre r en « sautant de voisinage en voisinage » à partir d’un point p, alors r est atteignable par densité depuis p.

Par analogie, pensez aux « amis d’amis ». Les points directement atteignables depuis un point cœur p sont ses « amis » ; les points atteignables par densité (dans le voisinage des « amis » de p) sont les « amis de ses amis ». Et il ne s’agit pas que de deux sauts : tant que vous pouvez atteindre un point par une chaîne de voisinages à partir d’un point cœur p, il est atteignable par densité (« l’ami de l’ami de l’ami… »).
Gardez à l’esprit que cette atteignabilité dépend de ɛ : plus ɛ est grand, plus de points deviennent atteignables ; plus ɛ est petit, moins il y en a.
Valeurs aberrantes :
Enfin, la classe « autre ». Les outliers ne sont ni cœurs ni suffisamment proches d’un cluster pour être atteignables par densité depuis un point cœur. Ils ne sont affectés à aucun cluster et, selon le contexte, peuvent être considérés comme anormaux.
DBSCAN est déjà très bien implémenté dans la bibliothèque d’apprentissage automatique Scikit-Learn en Python. Comme cette implémentation est scalable et éprouvée, nous allons l’utiliser pour voir DBSCAN en pratique.
Les étapes de l’algorithme DBSCAN :
Pour l’étude de cas, vous utiliserez un jeu de données annuel de clients d’un grossiste.
Allons-y.
# Let's import all your dependencies first

from sklearn.cluster import DBSCAN
from sklearn.preprocessing import StandardScaler
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
Le jeu de données contient 440 clients et 8 attributs par client. Vous allez utiliser Pandas pour importer le fichier .csv et le convertir en DataFrame.
Lors de l’import du fichier .csv, veillez à fournir le chemin exact.
# Import .csv file and convert it to a DataFrame object
df = pd.read_csv("C:/Users/Sayak/data/customers.csv");

print(df.head())
   Channel  Region  Fresh  Milk  Grocery  Frozen  Detergents_Paper  \
0        2       3  12669  9656     7561     214              2674
1        2       3   7057  9810     9568    1762              3293
2        2       3   6353  8808     7684    2405              3516
3        1       3  13265  1196     4221    6404               507
4        2       3  22615  5410     7198    3915              1777

   Delicatessen
0          1338
1          1776
2          7844
3          1788
4          5185
Avant d’appliquer DBSCAN, il est essentiel de bien connaître les données : type d’information, distribution, et nature des variables (numériques ou non).
D’après la description du référentiel UCI de ce jeu de données, les variables sont les suivantes :
Maintenant que vous connaissez les variables, affichons quelques statistiques.
print(df.info())
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 440 entries, 0 to 439
Data columns (total 8 columns):
Channel             440 non-null int64
Region              440 non-null int64
Fresh               440 non-null int64
Milk                440 non-null int64
Grocery             440 non-null int64
Frozen              440 non-null int64
Detergents_Paper    440 non-null int64
Delicatessen        440 non-null int64
dtypes: int64(8)
memory usage: 27.6 KB
None
Comme on le voit, aucune valeur manquante et toutes les colonnes sont de type entier. Cela allège le prétraitement. Allons un peu plus loin.
print(df.describe())
          Channel      Region          Fresh          Milk       Grocery  \
count  440.000000  440.000000     440.000000    440.000000    440.000000
mean     1.322727    2.543182   12000.297727   5796.265909   7951.277273
std      0.468052    0.774272   12647.328865   7380.377175   9503.162829
min      1.000000    1.000000       3.000000     55.000000      3.000000
25%      1.000000    2.000000    3127.750000   1533.000000   2153.000000
50%      1.000000    3.000000    8504.000000   3627.000000   4755.500000
75%      2.000000    3.000000   16933.750000   7190.250000  10655.750000
max      2.000000    3.000000  112151.000000  73498.000000  92780.000000

             Frozen  Detergents_Paper  Delicatessen
count    440.000000        440.000000    440.000000
mean    3071.931818       2881.493182   1524.870455
std     4854.673333       4767.854448   2820.105937
min       25.000000          3.000000      3.000000
25%      742.250000        256.750000    408.250000
50%     1526.000000        816.500000    965.500000
75%     3554.250000       3922.000000   1820.250000
max    60869.000000      40827.000000  47943.000000
Vous pouvez en déduire les statistiques utiles (écart type, moyenne, max, etc.) pour chaque variable. La plupart des données sont de type continu, à l’exception de Channel et Region. Pour simplifier les calculs, supprimons-les :
df.drop(["Channel", "Region"], axis = 1, inplace = True)
# Let's get a view of the data after the drop

print(df.head())
   Fresh  Milk  Grocery  Frozen  Detergents_Paper  Delicatessen
0  12669  9656     7561     214              2674          1338
1   7057  9810     9568    1762              3293          1776
2   6353  8808     7684    2405              3516          7844
3  13265  1196     4221    6404               507          1788
4  22615  5410     7198    3915              1777          5185
Pour visualiser, utilisons deux variables :
# Let's plot the data now
x = df['Grocery']
y = df['Milk']

plt.scatter(x,y)
plt.xlabel("Groceries")
plt.ylabel("Milk")
plt.show()
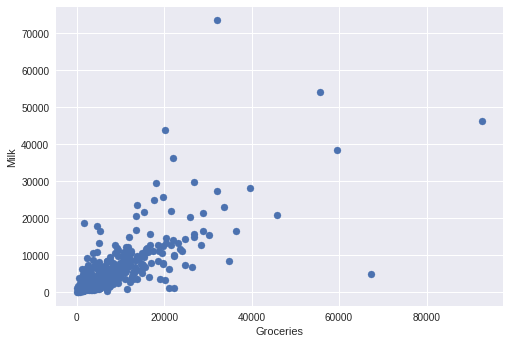
Petit rappel des fonctions utilisées pour tracer : plt.scatter() crée le nuage de points à partir des données (paramètres x et y). plt.xlabel() ajoute un libellé à l’axe X (Groceries ici). plt.ylabel() ajoute un libellé à l’axe Y (Milk). plt.show() affiche la figure.
N’hésitez pas à explorer le riche univers de Matplotlib pour vos visualisations. Sa documentation est excellente.
Vous repérez facilement des points nettement à l’écart, n’est-ce pas ? Ce sont des valeurs aberrantes.
Avec DBSCAN, nous voulons identifier le cluster principal de clients, mais aussi signaler les clients aux comportements d’achat annuels plus atypiques comme outliers.
Comme les valeurs sont de l’ordre de plusieurs milliers, nous allons normaliser chaque attribut (centrage-réduction : moyenne 0, variance 1). Cela préserve les relations entre variables : une petite variation d’une variable se reflète correctement sur l’autre.
df = df[["Grocery", "Milk"]]
df = df.as_matrix().astype("float32", copy = False)
stscaler = StandardScaler().fit(df)
df = stscaler.transform(df)
Construisons un objet DBSCAN qui exige au minimum 15 points dans un voisinage de rayon 0,5 pour considérer un point comme cœur.
dbsc = DBSCAN(eps = .5, min_samples = 15).fit(df)
Ensuite, extrayons les étiquettes de cluster et les outliers pour tracer le résultat.
labels = dbsc.labels_
core_samples = np.zeros_like(labels, dtype = bool)
core_samples[dbsc.core_sample_indices_] = True

Conformément à l’intuition, DBSCAN identifie un cluster de clients proches des moyennes d’achats en épicerie et en lait. Il signale aussi les clients dont le comportement s’écarte fortement de celui des autres.
Comme les outliers correspondent à des comportements d’achat plus extrêmes, le grossiste peut cibler spécifiquement ces clients avec des remises exclusives pour encourager des achats plus importants.
Supposons un site e-commerce souhaitant doper ses ventes par des recommandations pertinentes. On ne sait pas exactement ce que cherche chaque client, mais à partir des données on peut prédire et recommander des produits adaptés. En appliquant DBSCAN au jeu de données (issu de la base e-commerce), on trouve des clusters selon les produits achetés. On peut alors mesurer des similarités : si le client A a acheté un stylo, un livre et une paire de ciseaux, et le client B un livre et une paire de ciseaux, on peut recommander un stylo au client B.
Avant l’essor des méthodes avancées de deep learning, les chercheurs utilisaient DBSCAN pour isoler, dans des jeux de gènes, ceux susceptibles d’être impliqués dans la médiation du cancer.
Des scientifiques ont utilisé DBSCAN pour détecter les arrêts dans des trajectoires issues de GPS mobiles. Les arrêts représentent les segments les plus significatifs et informatifs d’une trajectoire.
Dans cet article, vous avez découvert les principales limites des méthodes à centroïdes et fait connaissance avec une autre famille : le clustering à base de densité. Vous avez vu comment ces méthodes contournent les écueils des approches à centroïdes.
Vous avez appris le fonctionnement de DBSCAN et mené une étude de cas. Vous avez également obtenu un aperçu des problèmes réels où DBSCAN s’avère utile. Pour aller plus loin, nous vous recommandons d’étudier d’autres méthodes basées sur la densité comme le Level Set Tree clustering et leurs différences avec DBSCAN.
Pour en savoir plus sur le clustering en Python, suivez notre cours Unsupervised Learning in Python.
Martin Ester, Hans-Peter Kriegel, Jörg Sander, and Xiaowei Xu. 1996. A density-based algorithm for discovering clusters a density-based algorithm for discovering clusters in large spatial databases with noise. In Proceedings of the Second International Conference on Knowledge Discovery and Data Mining (KDD'96), Evangelos Simoudis, Jiawei Han, and Usama Fayyad (Eds.). AAAI Press 226-231.
https://towardsdatascience.com/how-dbscan-works-and-why-should-i-use-it-443b4a191c80
https://www.coursera.org/learn/predictive-analytics/lecture/EVHfy/dbscan
En savoir plus sur Python
Cours
Cours
Cours