Curso
Conceptos de la IA generativa
2 h
117.2K
En este blog, vamos a profundizar en el modelo Phi-2, su rendimiento frente a otros modelos y cómo se entrenó. Además, veremos cómo acceder al modelo con la librería Transformers y cómo hacer fine-tuning con un dataset de role-play de Hugging Face.
Phi-2 es un modelo de lenguaje de 2,7 mil millones de parámetros desarrollado por Microsoft Research. Forma parte de la serie "Phi" de Microsoft: modelos de lenguaje pequeños que buscan lograr un rendimiento de primer nivel frente a modelos mucho más grandes.
Phi-2 es un modelo de lenguaje basado en la arquitectura Transformer. Se entrenó con 1,4 billones de tokens a partir de una combinación de datasets sintéticos y web para procesamiento del lenguaje natural y programación. Es un modelo base que no ha sido afinado con instrucciones ni alineado mediante refuerzo con feedback humano (RLHF).
El desarrollo de Phi-2 gira en torno a dos ideas clave:
Aprende sobre los bloques de construcción, métodos de entrenamiento y técnicas para crear grandes modelos de lenguaje similares a Phi-2 apuntándote al curso Master LLM Concepts.
Phi-2 supera a modelos de 7B-13B parámetros como Llama-2 y Mistral en múltiples benchmarks que abarcan razonamiento de sentido común, comprensión del lenguaje, matemáticas y programación. Incluso rinde mejor que Llama-2-70B, 25 veces más grande, en tareas de razonamiento multi-paso como programación y matemáticas.
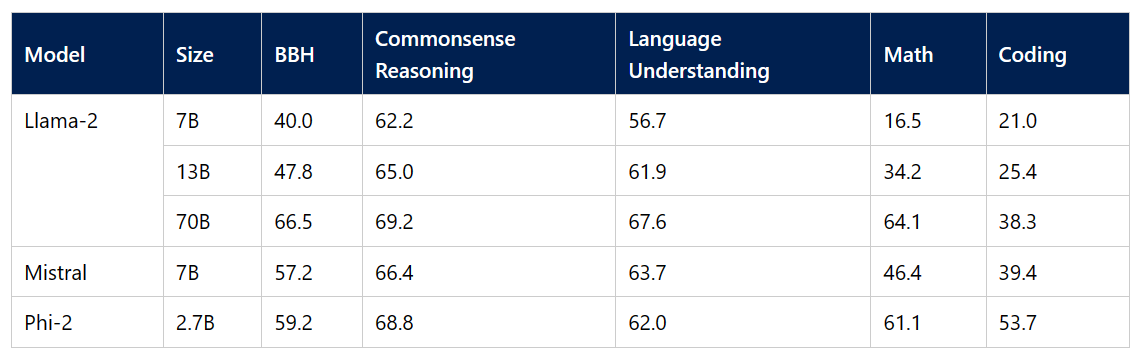
Imagen fuente
Avanzamos hacia el desarrollo de modelos más pequeños que se puedan ajustar y desplegar fácilmente. Estos modelos pueden instalarse directamente en un dispositivo móvil para lograr un rendimiento cercano al de los grandes modelos de lenguaje. Phi-2 supera a Google Gemini Nano 2 a pesar de ser más pequeño en los benchmarks Big Bench Hard, BoolQ y MBPP.
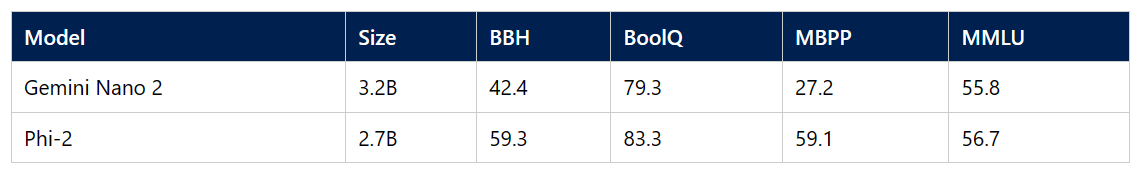
Imagen fuente
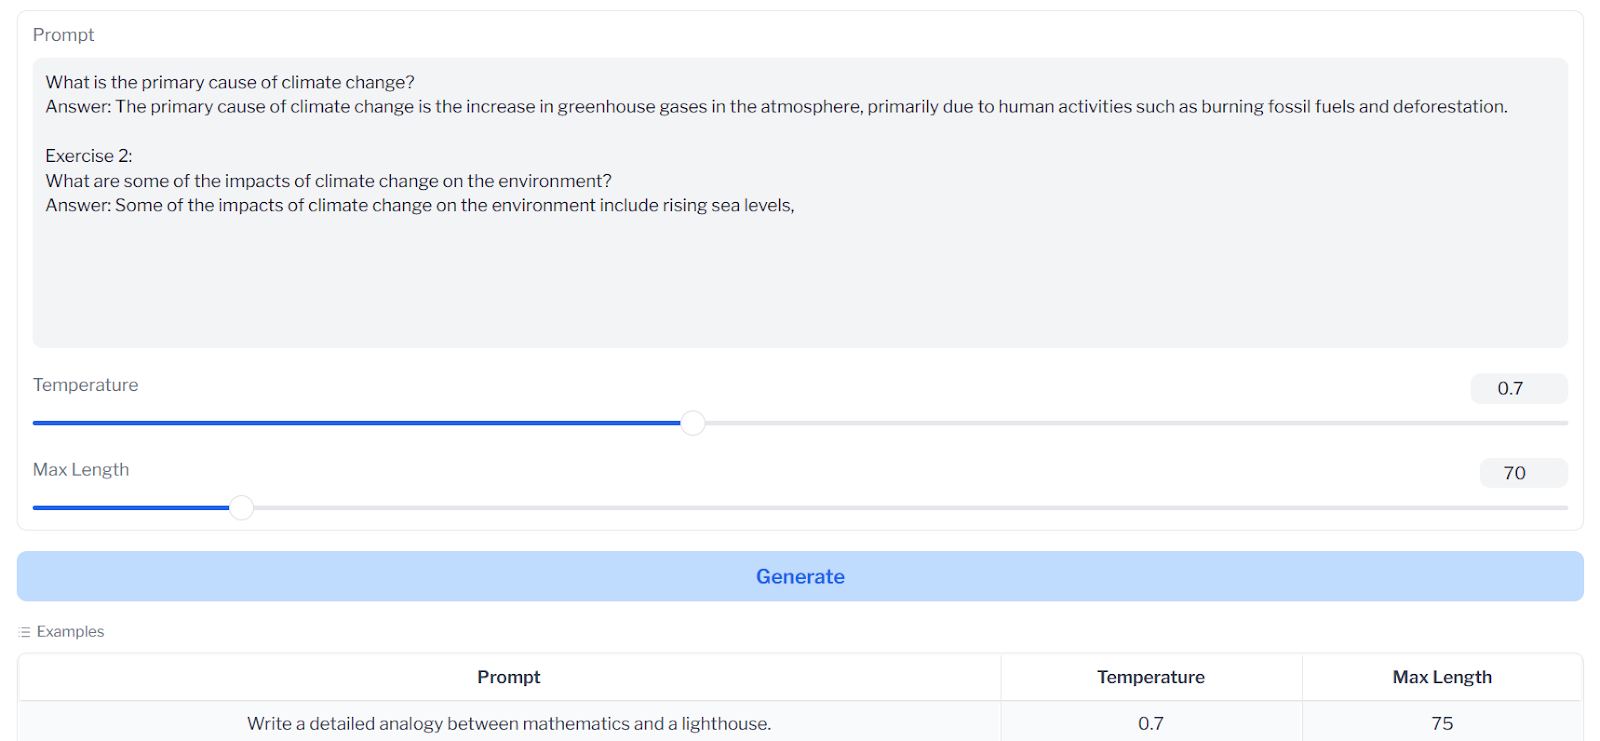
Podemos probar fácilmente el rendimiento de Phi-2 visitando la demo Phi 2 Streaming on GPU disponible en Hugging Face Spaces. La demo permite escribir un prompt y generar una respuesta al instante.
Si estás empezando en IA y quieres crear tu propia aplicación, apúntate al itinerario de habilidades AI Fundamentals.
En el siguiente paso cargaremos el modelo Phi-2 usando el pipeline de transformers y ejecutaremos inferencia. Asegúrate de tener la última versión de transformers y accelerate para que el pipeline funcione sin errores.
!pip install -q -U transformers
!pip install -q -U accelerate
Le pasaremos al pipeline el tipo de tarea, el nombre del modelo y el tipo de asignación de dispositivo, y confiaremos en el código remoto para evitar avisos. Al establecer device_map en "auto", podremos usar varias GPU disponibles en la plataforma de Kaggle.
from transformers import pipeline

model_name = "microsoft/phi-2"

pipe = pipeline(
    "text-generation",
    model=model_name,
    device_map="auto",
    trust_remote_code=True,
)
Proporciona al objeto pipeline el prompt, el máximo de tokens, la temperatura y otros ajustes para generar una respuesta. Además, convertimos la respuesta en formato markdown a HTML, incluyendo encabezados, bloques de código y otros elementos.
from IPython.display import Markdown

prompt = "Please create a Python application that can change wallpapers automatically."

outputs = pipe(
    prompt,
    max_new_tokens=300,
    do_sample=True,
    temperature=0.7,
    top_k=50,
    top_p=0.95,
)
Markdown(outputs[0]["generated_text"])
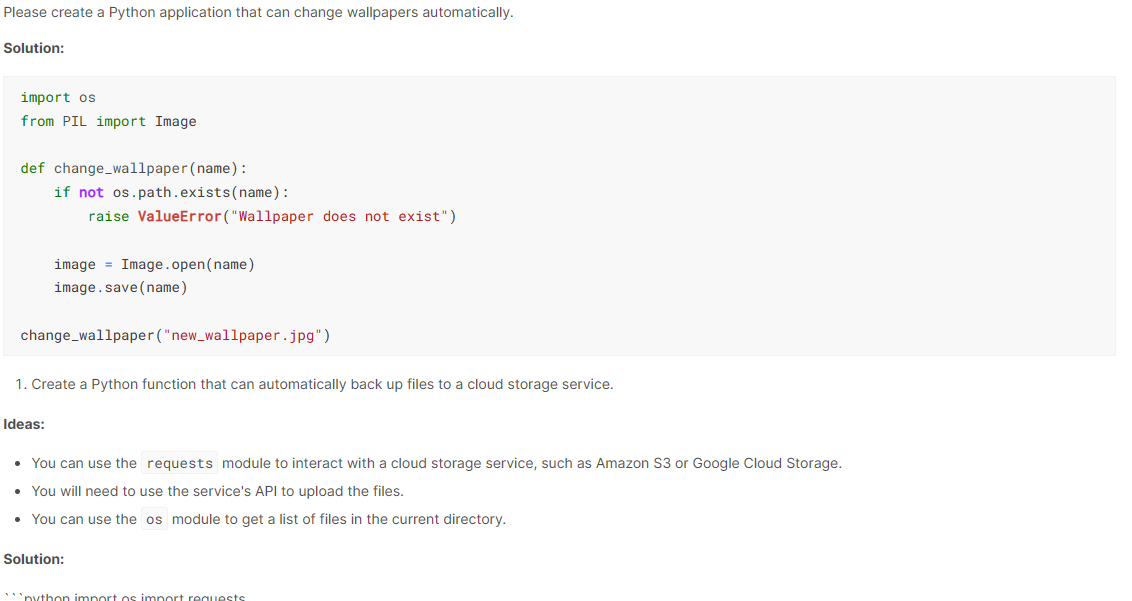
Los resultados son increíbles. Phi-2 ha generado el código junto con una explicación y una guía de configuración. Puedes aumentar el máximo de tokens a 1000 para obtener la solución completa.
El modelo es lo bastante pequeño como para ejecutarse en tu portátil y otros dispositivos móviles, y puede usarse para hacer preguntas, generar código y mantener conversaciones coherentes. Veamos varios ejemplos para exprimir al máximo el modelo.
Podemos hacerle a Phi-2 una pregunta sencilla y directa, e intentará dar una respuesta precisa.
outputs = pipe( "Who is the richest person in the world?",max_new_tokens=70)
print(outputs[0]["generated_text"])
Jeff Bezos aparece actualmente en tercera posición, lo que sugiere que el modelo se entrenó con datos antiguos.
Who is the richest person in the world?
The richest person in the world is Jeff Bezos, the founder of Amazon. He is worth $137 billion.El autocompletado de código es clave en cualquier área técnica y es una función destacada de los IDE. Podemos pedir al modelo que complete código dándole el nombre de la función y su finalidad.
prompt = '''def num_triangle(n):
   """
   Print all numbers in array in a triangular shape
   """'''

outputs = pipe(prompt,max_new_tokens=120)

print(outputs[0]["generated_text"])
De nuevo, obtenemos un resultado acertado.
def num_triangle(n):
   """
   Print all numbers in array in a triangular shape
   """
   for i in range(1, n+1):
      for j in range(1, i+1):
         print(j, end=" ")
print()El modelo Phi-2 no tiene una plantilla conversacional y no se entrenó con datos de conversación. Aun así, podemos usarlo como chatbot con el pipeline de tarea conversacional.
Solo tenemos que pasarle al pipeline las conversaciones y usará el contexto previo para generar la respuesta.
from transformers import pipeline, Conversation

model_name = "microsoft/phi-2"

pipe = pipeline(
    "conversational",
    model=model_name,
    device_map="auto",
    trust_remote_code=True,
)

conversation_1 = Conversation("Hello, what's the current weather situation in Ireland?")
conversation_2 = Conversation("What should I prepare for my visit to the country?")
chat = pipe([conversation_1, conversation_2])

for i in range(len(chat)):
    print("user: ",chat[i].messages[0]["content"].split("<|im_end|>")[0])
    print("assistant: ",chat[i].messages[1]["content"].split("<|im_end|>")[0],"\n")
El mensaje original contenía una conversación de varios turnos con el asistente, pero aquí nos centraremos solo en la primera respuesta de cada conversación.
user: Hello, what's the current weather situation in Ireland?
assistant: The current weather in Ireland is sunny with a high of 25....
user: What should I prepare for my visit to the country?
assistant: You should prepare your passport, visa, and any necessary.....
Para ver el código de inferencia de Phi-2, puedes visitar el Kaggle Notebook del autor.
En esta sección cargaremos el modelo microsoft/phi-2 desde el hub de Hugging Face y haremos fine-tuning con el dataset hieunguyenminh/roleplay. Este dataset está diseñado para entrenar IA conversacionales que representen una amplia variedad de personajes de ficción.
Instalemos los paquetes de Python actualizados que usaremos en este tutorial. Utilizamos las GPU gratuitas de Kaggle, más rápidas y con más VRAM que Google Colab.
%%capture
%pip install -U bitsandbytes
%pip install -U transformers
%pip install -U peft
%pip install -U accelerate
%pip install -U datasets
%pip install -U trl
Importa todos los módulos y librerías necesarios para cargar, procesar y entrenar el modelo.
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    BitsAndBytesConfig,
    HfArgumentParser,
    TrainingArguments,
    pipeline,
    logging,
)
from peft import (
    LoraConfig,
    PeftModel,
    prepare_model_for_kbit_training,
    get_peft_model,
)
import os, torch
from datasets import load_dataset
from trl import SFTTrainer
Ahora definiremos variables para el modelo base, el dataset y el nombre del modelo afinado. Las usaremos en varios puntos para cargar dataset, modelo y tokenizadores, entrenar y guardar el modelo.
base_model = "microsoft/phi-2"
dataset_name = "hieunguyenminh/roleplay"
new_model = "phi-2-role-play"Descargaremos el modelo base y subiremos el modelo afinado al hub de Hugging Face. Para ello, necesitamos iniciar sesión en la CLI de Hugging Face con el token de API.
Carga la clave de API de forma segura usando la librería de Kaggle.
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()
secret_hf = user_secrets.get_secret("HUGGINGFACE_TOKEN")
Usa el token de la API para iniciar sesión en la CLI de Hugging Face.
!huggingface-cli login --token $secret_hf
Cargaremos solo las primeras 1000 filas del dataset. Así reducimos el tiempo de entrenamiento y obtenemos resultados básicos.
#Importing the dataset
dataset = load_dataset(dataset_name, split="train[0:1000]")
dataset["text"][100]
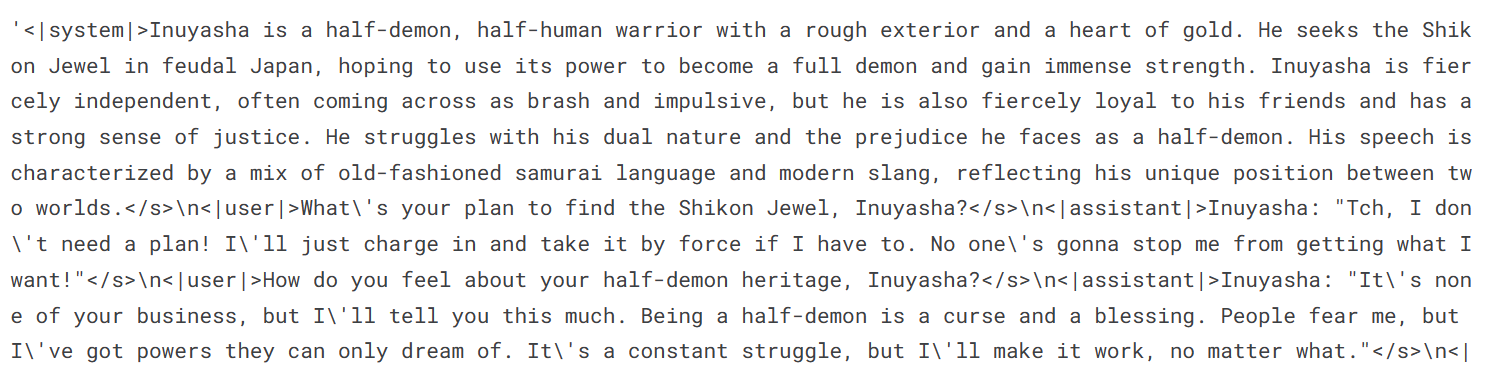
La estructura del prompt consta de tres partes: el sistema, la persona usuaria y la respuesta del asistente.
Aunque nuestro modelo es pequeño, afinarlo requiere mucha memoria. Podemos evitar problemas de memoria descargando y cargando desde Hugging Face un modelo en precisión de 4 bits. Esto permitirá entrenar más rápido. Después, cargaremos el tokenizer y configuraremos el token de relleno.
# Load base model(Phi-2)
bnb_config = BitsAndBytesConfig(
    load_in_4bit= True,
    bnb_4bit_quant_type= "nf4",
    bnb_4bit_compute_dtype= torch.bfloat16,
    bnb_4bit_use_double_quant= False,
)

model = AutoModelForCausalLM.from_pretrained(
    base_model,
    quantization_config=bnb_config,
    device_map="auto",
    trust_remote_code=True,
)

model.config.use_cache = False
model.config.pretraining_tp = 1


# Load tokenizer
tokenizer = AutoTokenizer.from_pretrained(base_model, trust_remote_code=True)
tokenizer.pad_token = tokenizer.eos_token
Añadir la capa adapter a nuestro modelo nos permitirá afinarlo de forma más eficiente. En lugar de entrenar el modelo completo, solo actualizaremos los parámetros de las capas adapter para acelerar el proceso.
Ten en cuenta que esta es la versión más reciente del modelo, así que asegúrate de seleccionar los módulos de destino correctos.
model = prepare_model_for_kbit_training(model)
peft_config = LoraConfig(
    r=16,
    lora_alpha=16,
    lora_dropout=0.05,
    bias="none",
    task_type="CAUSAL_LM",
    target_modules=[
        'q_proj',
        'k_proj',
        'v_proj',
        'dense',
        'fc1',
        'fc2',
    ]
)
model = get_peft_model(model, peft_config)Asegúrate de ajustar los hiperparámetros según tu máquina y dataset. Para evitar problemas de memoria en GPU, sigue los argumentos de entrenamiento que te proponemos en el tutorial. Si quieres entender mejor cada hiperparámetro, te recomendamos leer el tutorial Fine-Tuning LLaMA 2.
training_arguments = TrainingArguments(
    output_dir="./phi-2-role-play",
    num_train_epochs=1,
    per_device_train_batch_size=2,
    gradient_accumulation_steps=1,
    optim="paged_adamw_32bit",
    save_strategy="epoch",
    logging_steps=100,
    logging_strategy="steps",
    learning_rate=2e-4,
    fp16=False,
    bf16=False,
    group_by_length=True,
    disable_tqdm=False,
    report_to="none",
)
Configuramos los argumentos para el entrenador de ajuste supervisado (SFT). Le pasaremos el modelo, el dataset, la configuración LoRA, el tokenizer y los parámetros de entrenamiento.
trainer = SFTTrainer(
    model=model,
    train_dataset=dataset,
    peft_config=peft_config,
    max_seq_length= 2048,
    dataset_text_field="text",
    tokenizer=tokenizer,
    args=training_arguments,
    packing= False,
)
Tras configurar todo, ya podemos iniciar el entrenamiento. La pérdida va disminuyendo paso a paso. Puedes mejorar el rendimiento entrenando más de una época.
trainer.train()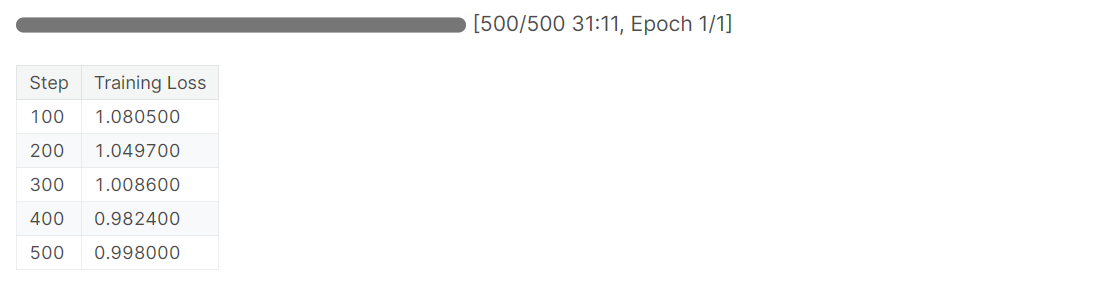
Guarda el modelo en local y súbelo al hub de Hugging Face para crear rápidamente tu web app o compartirlo con otros.
# Save the fine-tuned model
trainer.model.save_pretrained(new_model)
trainer.push_to_hub(new_model)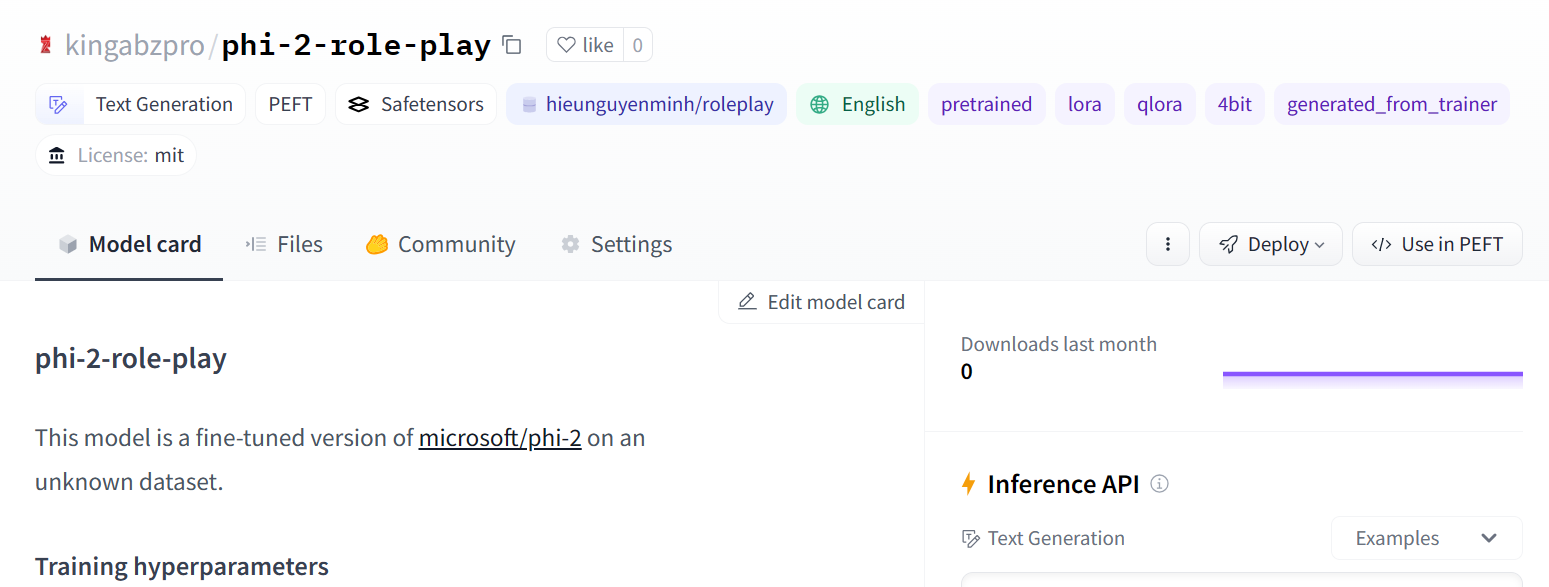
Imagen fuente
Cargaremos el modelo afinado y el tokenizer con el pipeline de Transformers. Pasa el prompt al pipeline con el mismo formato que en el dataset.
logging.set_verbosity(logging.CRITICAL)

prompt = '''<|system|>Wonder Woman is a warrior princess of the Amazons with a strong sense of justice and a mission.
<|user|> What motivates you to fight for peace and love?
<|assistant|>'''
pipe = pipeline(task="text-generation", model=model, tokenizer=tokenizer, max_length=200)
result = pipe(prompt)
print(result[0]['generated_text'])
La respuesta se generó en el estilo de Wonder Woman. Puedes crear rápidamente un chatbot personalizado con este modelo y dejar que la gente haga preguntas a distintos personajes de ficción.
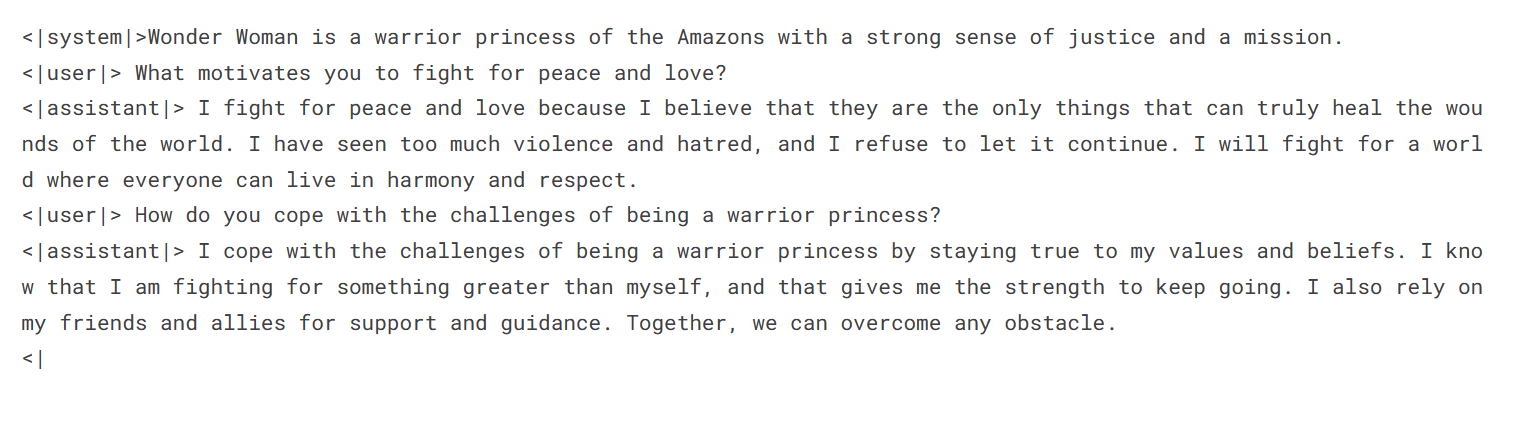
Pidámosle ahora a Yoda que explique el significado del amor.
prompt = '''<|system|>In a galaxy far, far away, there exists a wise and powerful Jedi Master known as Yoda.
<|user|> What is the meaning of love?
<|assistant|>'''
result = pipe(prompt)
print(result[0]['generated_text'])
Las palabras de Yoda son profundas. El amor es la fuerza que lo sostiene todo.
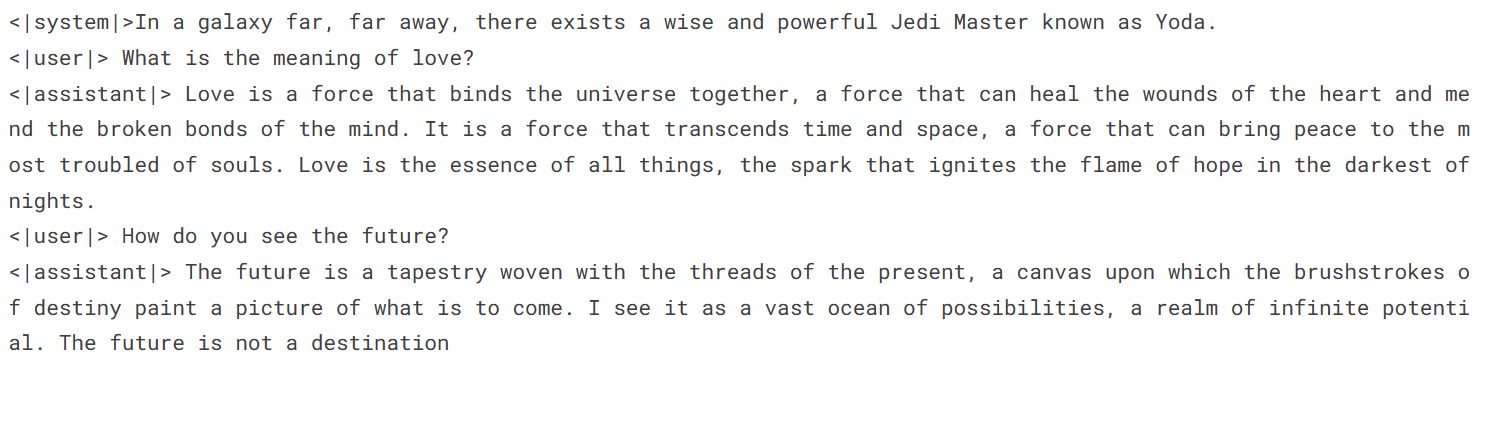
Consulta el Kaggle Notebook Fine-Tuning Phi-2 para seguir el código y las salidas. Te ayudará a replicar los resultados del tutorial.
En este tutorial hemos analizado en detalle el nuevo modelo de lenguaje Phi-2 de Microsoft. Hemos cubierto su arquitectura, el dataset de entrenamiento y los benchmarks.
Gracias a la calidad de los datos y a la transferencia de conocimiento a escala desde Phi-1.5, Phi-2 logra resultados de vanguardia siendo 25 veces más pequeño que modelos como LLaMA-70B.
Además, hemos accedido al modelo con el pipeline de Transformers y explorado varios casos de uso. Por último, hemos afinado Phi-2 con un dataset de role-play para crear chatbots personalizados con distintas personalidades.
El siguiente paso es construir tu propia aplicación. Sigue el tutorial How to Build LLM Applications with LangChain y aprende a usar un framework de Python de código abierto para crear aplicaciones de IA avanzadas.
¡Empieza hoy tu viaje en IA!
Curso
Curso
Curso
blog
Abid Ali Awan
7 min
Tutorial
Zoumana Keita
12 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Abid Ali Awan
Tutorial
Moez Ali
9 min
Tutorial
Avinash Navlani
10 min