
Curso
Conceitos de IA Generativa
2 h
117.2K
Neste blog, vamos fazer um mergulho profundo no modelo Phi-2, entender seu desempenho em comparação com outros modelos e como ele foi treinado. Além disso, vamos explorar como acessar o modelo usando a biblioteca Transformers e realizar fine-tuning em um dataset de role-play do Hugging Face.
Phi-2 é um modelo de linguagem com 2,7 bilhões de parâmetros desenvolvido pela Microsoft Research. Ele faz parte da série "Phi" de modelos de linguagem pequenos da Microsoft, criada para alcançar performance de ponta quando comparada a modelos muito maiores.
O Phi-2 é um modelo de linguagem com arquitetura Transformer. Foi treinado com 1,4 trilhão de tokens, combinando datasets sintéticos e da web para processamento de linguagem natural e código. É um modelo base que não passou por instrução de fine-tuning nem alinhamento via aprendizado por reforço com feedback humano (RLHF).
O desenvolvimento do Phi-2 gira em torno de duas ideias-chave:
Aprenda sobre blocos de construção, métodos de treinamento e técnicas para criar Large Language Models semelhantes ao Phi-2 matriculando-se no curso Master LLM Concepts.
O Phi-2 supera modelos de 7B a 13B parâmetros, como Llama-2 e Mistral, em vários benchmarks que abrangem raciocínio de bom senso, compreensão de linguagem, matemática e programação. Ele também supera o Llama-2-70B, 25 vezes maior, em tarefas que exigem raciocínio em múltiplas etapas, como código e matemática.
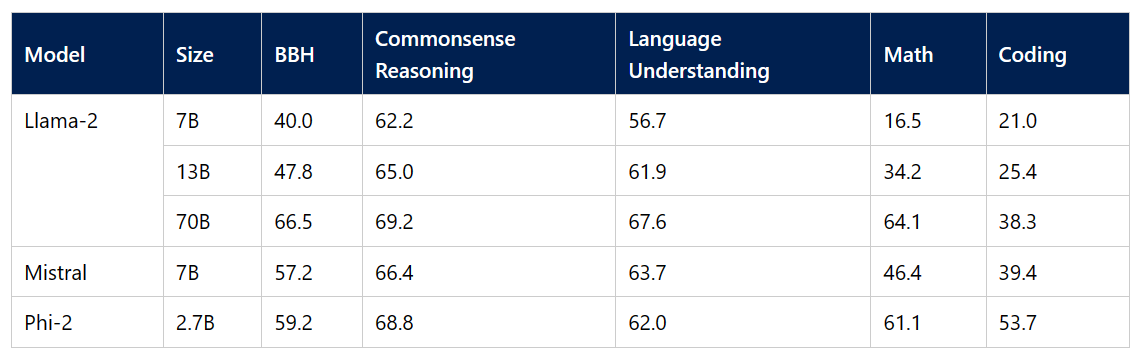
Imagem fonte
Estamos avançando para o desenvolvimento de modelos menores, fáceis de ajustar e implantar. Esses modelos podem ser instalados diretamente em um celular e ainda assim alcançar desempenho semelhante ao de grandes modelos de linguagem. O Phi-2 supera o Google Gemini Nano 2, apesar de ser menor, nos benchmarks Big Bench Hard, BoolQ e MBPP.
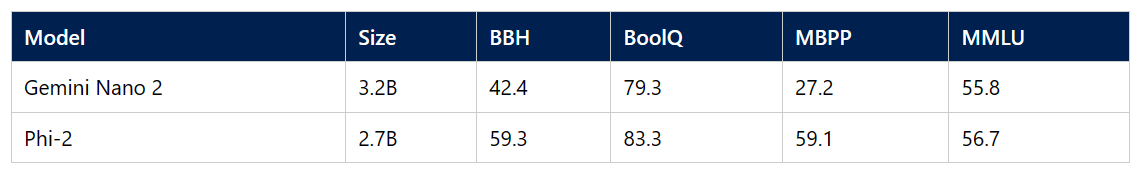
Imagem fonte
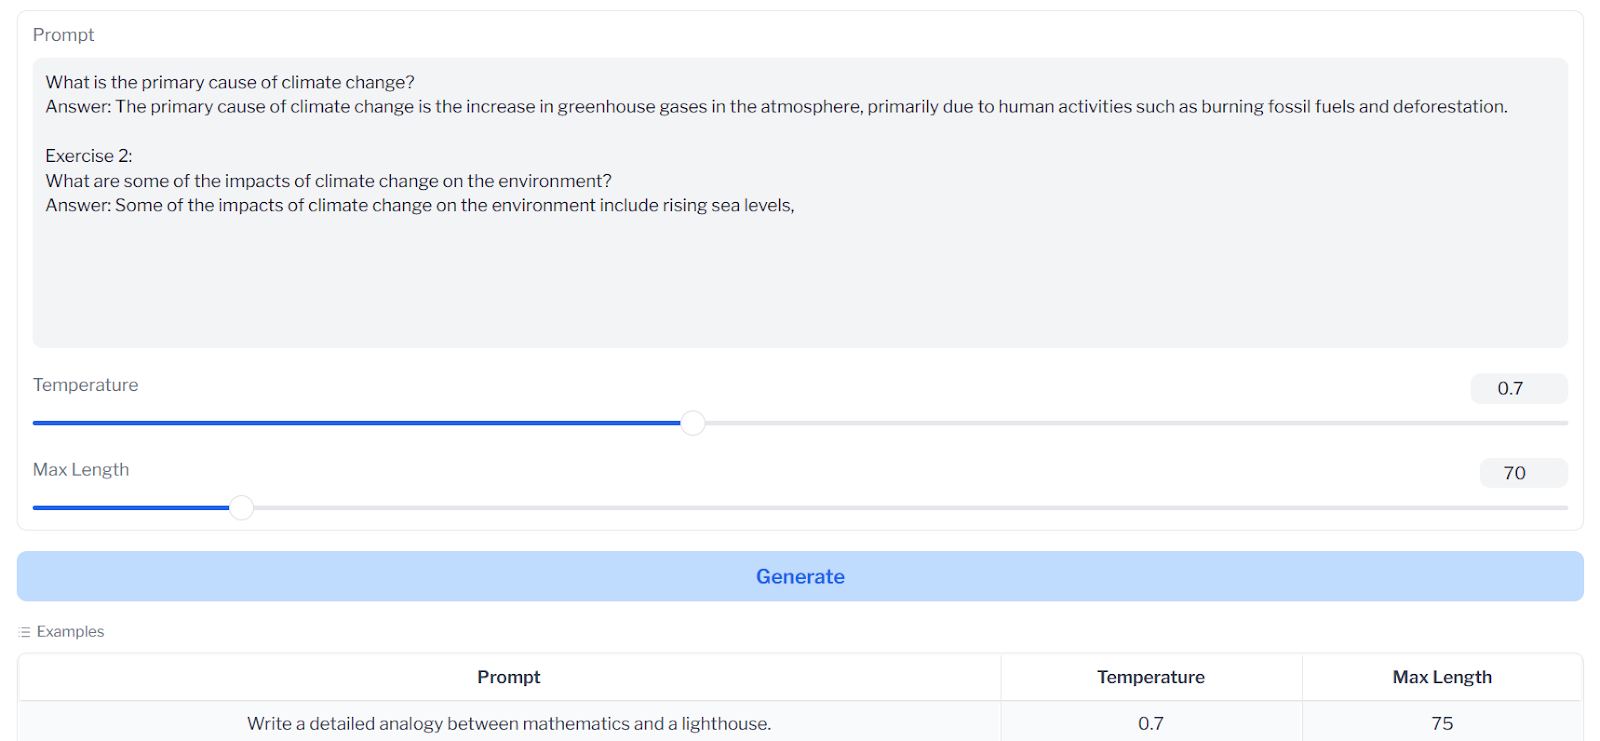
Você pode testar facilmente o desempenho do Phi-2 acessando a demo Phi 2 Streaming on GPU disponível no Hugging Face Spaces. A demo oferece funcionalidade básica para escrever um prompt e gerar uma resposta rapidamente.
Se você está começando em IA e quer desenvolver sua própria aplicação, matricule-se na trilha de habilidades AI Fundamentals.
No próximo passo, vamos carregar o modelo Phi-2 usando o pipeline do transformers e executar inferência. Garanta que você tem as versões mais recentes de transformers e accelerate para rodar o pipeline sem erros.
!pip install -q -U transformers
!pip install -q -U accelerate
Vamos passar para o pipeline o tipo de tarefa, o nome do modelo e o tipo de device map e, em seguida, confiar no código remoto para evitar avisos. Definindo device_map como "auto", conseguiremos usar múltiplas GPUs disponíveis na plataforma Kaggle.
from transformers import pipeline

model_name = "microsoft/phi-2"

pipe = pipeline(
    "text-generation",
    model=model_name,
    device_map="auto",
    trust_remote_code=True,
)
Forneça ao objeto pipeline o prompt, o número máximo de tokens, a temperatura e outras configurações para gerar uma resposta. Além disso, convertemos a resposta em formato markdown para HTML, incluindo títulos, blocos de código e outros componentes.
from IPython.display import Markdown

prompt = "Please create a Python application that can change wallpapers automatically."

outputs = pipe(
    prompt,
    max_new_tokens=300,
    do_sample=True,
    temperature=0.7,
    top_k=50,
    top_p=0.95,
)
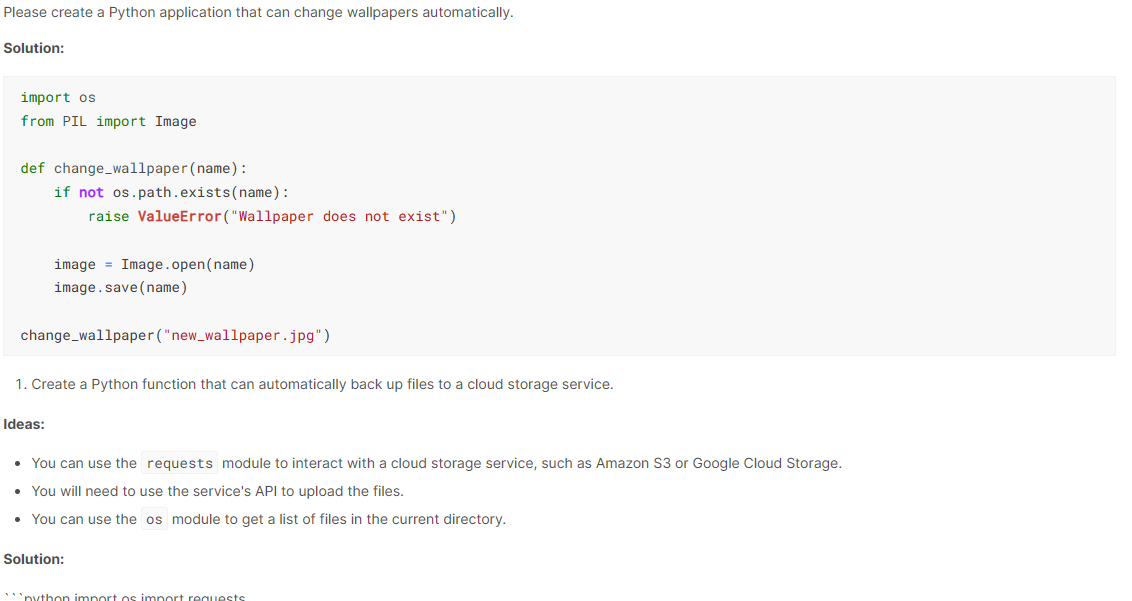
Markdown(outputs[0]["generated_text"])
Os resultados são ótimos. O Phi-2 gerou o código com explicação e um guia de configuração. Você pode aumentar o máximo de tokens para 1000 para obter a solução completa.
O modelo é pequeno o suficiente para rodar no seu notebook e em outros dispositivos móveis, e pode ser usado para fazer perguntas, gerar código e manter conversas. Vamos explorar vários exemplos de como aproveitar ao máximo o modelo.
Podemos fazer ao Phi-2 uma pergunta simples e direta, e ele tentará dar uma resposta precisa.
outputs = pipe( "Who is the richest person in the world?",max_new_tokens=70)
print(outputs[0]["generated_text"])
Jeff Bezos está atualmente em terceiro lugar, o que indica que o modelo foi treinado com dados mais antigos.
Who is the richest person in the world?
The richest person in the world is Jeff Bezos, the founder of Amazon. He is worth $137 billion.Autocompletar código é essencial em todas as áreas de tecnologia e é um recurso de destaque de um IDE. Podemos pedir ao modelo para completar o código informando o nome da função e sua funcionalidade.
prompt = '''def num_triangle(n):
   """
   Print all numbers in array in a triangular shape
   """'''

outputs = pipe(prompt,max_new_tokens=120)

print(outputs[0]["generated_text"])
Mais uma vez, o resultado veio certinho.
def num_triangle(n):
   """
   Print all numbers in array in a triangular shape
   """
   for i in range(1, n+1):
      for j in range(1, i+1):
         print(j, end=" ")
print()O modelo Phi-2 não possui um template conversacional e não foi treinado em dados de conversa. Ainda assim, podemos usá-lo como chatbot utilizando o pipeline do tipo de tarefa conversacional.
Tudo o que precisamos fazer é fornecer conversas ao pipeline; ele usará o contexto da interação anterior para gerar a resposta.
from transformers import pipeline, Conversation

model_name = "microsoft/phi-2"

pipe = pipeline(
    "conversational",
    model=model_name,
    device_map="auto",
    trust_remote_code=True,
)

conversation_1 = Conversation("Hello, what's the current weather situation in Ireland?")
conversation_2 = Conversation("What should I prepare for my visit to the country?")
chat = pipe([conversation_1, conversation_2])

for i in range(len(chat)):
    print("user: ",chat[i].messages[0]["content"].split("<|im_end|>")[0])
    print("assistant: ",chat[i].messages[1]["content"].split("<|im_end|>")[0],"\n")
A mensagem original continha uma conversa de múltiplos turnos com o assistente, mas aqui vamos focar apenas na primeira resposta de cada conversa.
user: Hello, what's the current weather situation in Ireland?
assistant: The current weather in Ireland is sunny with a high of 25....
user: What should I prepare for my visit to the country?
assistant: You should prepare your passport, visa, and any necessary.....
Para ver o código de inferência do Phi-2, confira o Kaggle Notebook do autor.
Nesta seção, vamos carregar o modelo microsoft/phi-2 do hub do Hugging Face e fazer fine-tuning com o dataset hieunguyenminh/roleplay. Esse dataset foi criado para treinar IAs conversacionais a representar uma ampla variedade de personagens fictícios.
Vamos instalar os pacotes Python atualizados que usaremos neste tutorial. Estamos usando as GPUs gratuitas do Kaggle, que são mais rápidas e têm mais VRAM do que o Google Colab.
%%capture
%pip install -U bitsandbytes
%pip install -U transformers
%pip install -U peft
%pip install -U accelerate
%pip install -U datasets
%pip install -U trl
Importe todos os módulos e bibliotecas necessários para carregar, processar e treinar o modelo.
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    BitsAndBytesConfig,
    HfArgumentParser,
    TrainingArguments,
    pipeline,
    logging,
)
from peft import (
    LoraConfig,
    PeftModel,
    prepare_model_for_kbit_training,
    get_peft_model,
)
import os, torch
from datasets import load_dataset
from trl import SFTTrainer
Agora vamos definir variáveis para o modelo base, o dataset e o nome do modelo ajustado. Essas variáveis serão usadas em vários pontos para carregar dataset, modelo, tokenizers, treinar e salvar o modelo.
base_model = "microsoft/phi-2"
dataset_name = "hieunguyenminh/roleplay"
new_model = "phi-2-role-play"Vamos baixar o modelo base e fazer upload do modelo ajustado para o hub do Hugging Face. Para isso, precisamos fazer login no Hugging Face CLI usando o token da API.
Carregue a chave de API com segurança usando a biblioteca do Kaggle.
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()
secret_hf = user_secrets.get_secret("HUGGINGFACE_TOKEN")
Use o token da API para fazer login no huggingface CLI.
!huggingface-cli login --token $secret_hf
Vamos carregar apenas as primeiras 1000 linhas do dataset. Isso reduz o tempo de treinamento e já nos dá resultados básicos.
#Importing the dataset
dataset = load_dataset(dataset_name, split="train[0:1000]")
dataset["text"][100]
A estrutura do prompt tem três partes: o sistema, o usuário e a resposta do assistente.
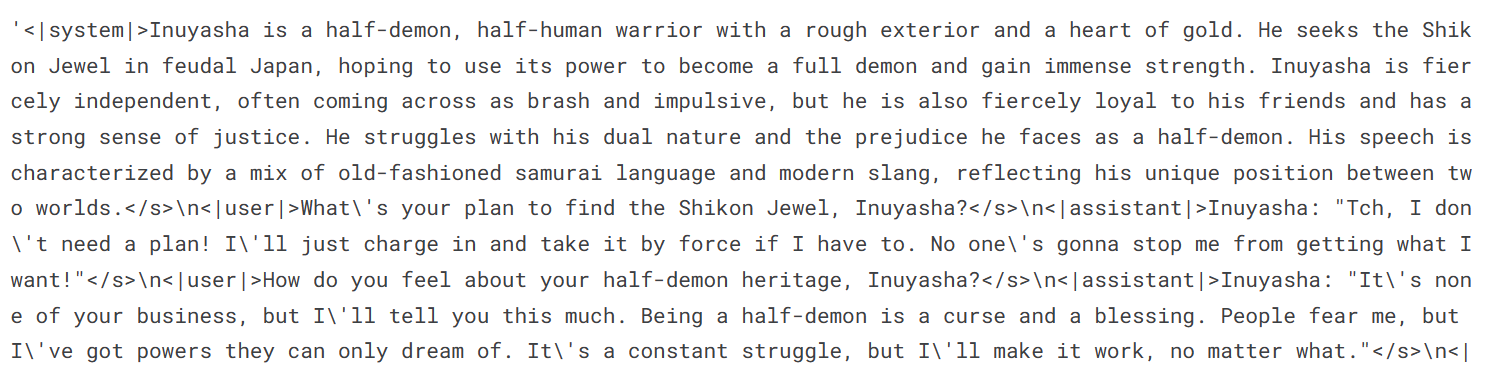
Embora o modelo seja pequeno, fazer fine-tuning exige bastante memória. Podemos evitar problemas de memória baixando e carregando do Hugging Face um modelo com precisão de 4 bits. Isso também acelera o treinamento. Em seguida, carregamos o tokenizer e configuramos o token de preenchimento (pad).
# Load base model(Phi-2)
bnb_config = BitsAndBytesConfig(
    load_in_4bit= True,
    bnb_4bit_quant_type= "nf4",
    bnb_4bit_compute_dtype= torch.bfloat16,
    bnb_4bit_use_double_quant= False,
)

model = AutoModelForCausalLM.from_pretrained(
    base_model,
    quantization_config=bnb_config,
    device_map="auto",
    trust_remote_code=True,
)

model.config.use_cache = False
model.config.pretraining_tp = 1


# Load tokenizer
tokenizer = AutoTokenizer.from_pretrained(base_model, trust_remote_code=True)
tokenizer.pad_token = tokenizer.eos_tokenAdicionar a camada adapter ao nosso modelo permite fazer fine-tuning de forma mais eficiente. Em vez de treinar o modelo inteiro, vamos atualizar apenas os parâmetros das camadas adapter para acelerar o processo.
Importante: esta é a versão mais recente do modelo, então verifique se os módulos de destino estão corretos.
model = prepare_model_for_kbit_training(model)
peft_config = LoraConfig(
    r=16,
    lora_alpha=16,
    lora_dropout=0.05,
    bias="none",
    task_type="CAUSAL_LM",
    target_modules=[
        'q_proj',
        'k_proj',
        'v_proj',
        'dense',
        'fc1',
        'fc2',
    ]
)
model = get_peft_model(model, peft_config)Ajuste os hiperparâmetros conforme sua máquina e dataset. Para evitar problemas com memória de GPU, siga os argumentos de treinamento fornecidos neste tutorial. Se quiser entender melhor cada hiperparâmetro, recomendamos ler o tutorial Fine-Tuning LLaMA 2.
training_arguments = TrainingArguments(
    output_dir="./phi-2-role-play",
    num_train_epochs=1,
    per_device_train_batch_size=2,
    gradient_accumulation_steps=1,
    optim="paged_adamw_32bit",
    save_strategy="epoch",
    logging_steps=100,
    logging_strategy="steps",
    learning_rate=2e-4,
    fp16=False,
    bf16=False,
    group_by_length=True,
    disable_tqdm=False,
    report_to="none",
)
Configurando os argumentos para o treinador de SFT (Supervised Fine-Tuning). Vamos passar o modelo, o dataset, a configuração LoRA, o tokenizer e os parâmetros de treinamento.
trainer = SFTTrainer(
    model=model,
    train_dataset=dataset,
    peft_config=peft_config,
    max_seq_length= 2048,
    dataset_text_field="text",
    tokenizer=tokenizer,
    args=training_arguments,
    packing= False,
)
Após configurar tudo, iniciamos o treinamento. A perda vai caindo gradualmente a cada etapa. Você pode melhorar o desempenho treinando por mais de uma época.
trainer.train()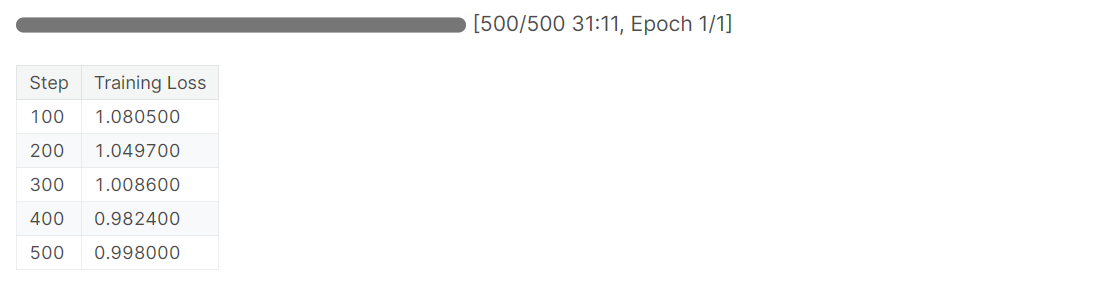
Salve o modelo localmente e faça upload para o hub do Hugging Face para criar rapidamente seu app web ou compartilhar seu modelo com outras pessoas.
# Save the fine-tuned model
trainer.model.save_pretrained(new_model)
trainer.push_to_hub(new_model)
Imagem fonte
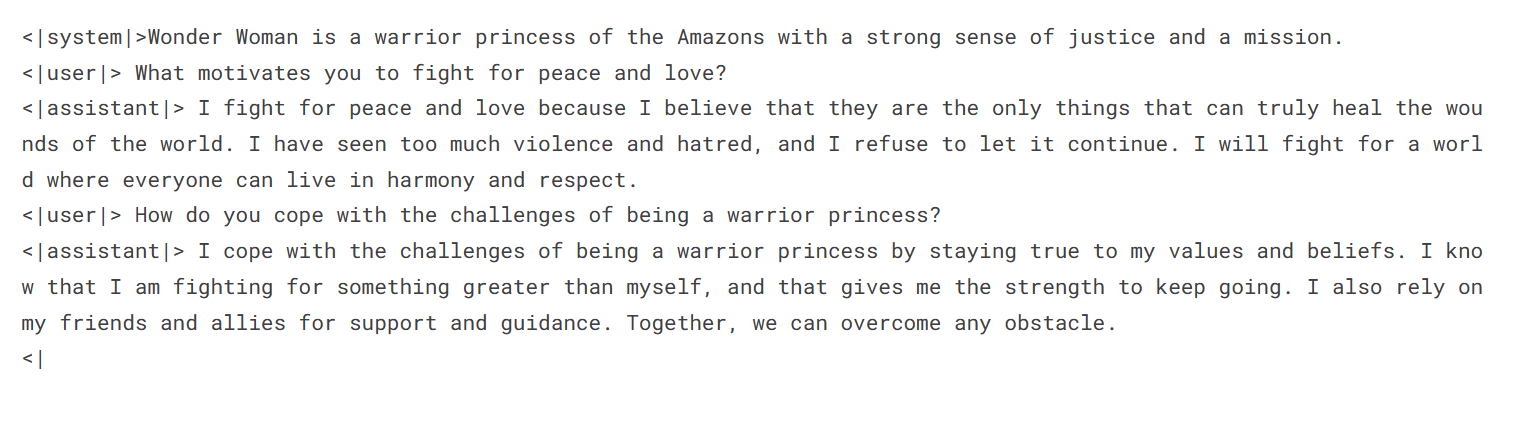
Vamos carregar o modelo ajustado e o tokenizer com o pipeline do Transformers. Forneça o prompt ao pipeline no mesmo formato do dataset.
logging.set_verbosity(logging.CRITICAL)

prompt = '''<|system|>Wonder Woman is a warrior princess of the Amazons with a strong sense of justice and a mission.
<|user|> What motivates you to fight for peace and love?
<|assistant|>'''
pipe = pipeline(task="text-generation", model=model, tokenizer=tokenizer, max_length=200)
result = pipe(prompt)
print(result[0]['generated_text'])
A resposta foi gerada no estilo da Mulher-Maravilha. Com esse modelo, você pode construir rapidamente um chatbot personalizado e deixar os usuários fazerem perguntas a diferentes personagens fictícios.
Vamos pedir ao Yoda para explicar o significado do amor.
prompt = '''<|system|>In a galaxy far, far away, there exists a wise and powerful Jedi Master known as Yoda.
<|user|> What is the meaning of love?
<|assistant|>'''
result = pipe(prompt)
print(result[0]['generated_text'])
As palavras de Yoda são profundas. O amor é a força que mantém tudo unido.
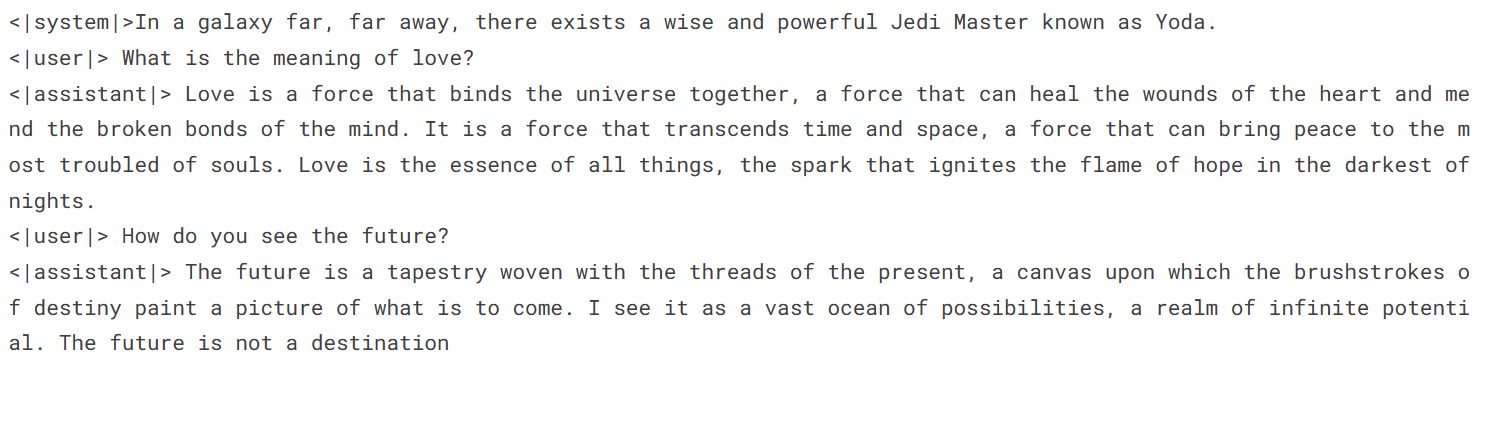
Confira o Kaggle Notebook Fine-Tuning Phi-2 para seguir o código e as saídas. Ele ajuda você a reproduzir os resultados mostrados no tutorial.
Neste tutorial, analisamos em profundidade o novo modelo de linguagem Phi-2 da Microsoft. Abordamos a arquitetura, o dataset de treinamento e os benchmarks do modelo.
Aproveitando dados de qualidade e a transferência de conhecimento em escala do Phi-1.5, o Phi-2 atinge resultados de ponta sendo 25 vezes menor que modelos como o LLaMA-70B.
Além disso, acessamos o modelo via pipeline do Transformers e exploramos vários casos de uso. Por fim, fizemos fine-tuning do Phi-2 em um dataset de role-play para criar chatbots personalizados com diferentes personas.
O próximo passo da sua jornada é construir sua própria aplicação. Siga o tutorial How to Build LLM Applications with LangChain e aprenda a usar um framework Python open source para criar aplicações de IA avançadas.
Comece sua jornada em IA hoje!
Curso
Curso
Curso
Tutorial
Moez Ali
9 min
Tutorial
Dimitri Didmanidze
8 min
Tutorial
Zoumana Keita
8 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Abid Ali Awan
Tutorial
Abid Ali Awan
11 min




