
Cours
Concepts d'IA générative
2 h
117.3K
Dans cet article, nous allons explorer en profondeur le modèle Phi-2, comprendre ses performances par rapport à d'autres modèles et la manière dont il a été entraîné. Nous verrons également comment y accéder avec la bibliothèque Transformers et comment le peaufiner sur un jeu de données de jeu de rôle depuis Hugging Face.
Phi-2 est un modèle de langage de 2,7 milliards de paramètres développé par Microsoft Research. Il fait partie de la série "Phi" de petits modèles de langage de Microsoft, conçus pour atteindre des performances de pointe face à des modèles bien plus volumineux.
Phi-2 est un modèle de langage basé sur une architecture Transformer. Il a été entraîné sur 1,4 billion de tokens, issus d'un mélange de jeux de données synthétiques et web pour le traitement du langage naturel et le code. C'est un modèle de base, qui n'a pas été affiné sur des consignes ni aligné par apprentissage par renforcement à partir de retours humains (RLHF).
Le développement de Phi-2 repose sur deux idées clés :
Découvrez les briques de base, méthodes d'entraînement et techniques pour créer des grands modèles de langage similaires à Phi-2 en vous inscrivant au cours Master LLM Concepts.
Phi-2 dépasse des modèles de 7B à 13B paramètres comme Llama-2 et Mistral sur de multiples benchmarks couvrant le bon sens, la compréhension du langage, les maths et le code. Il surpasse même Llama-2-70B, 25 fois plus grand, sur des tâches de raisonnement multi-étapes comme le codage et les mathématiques.
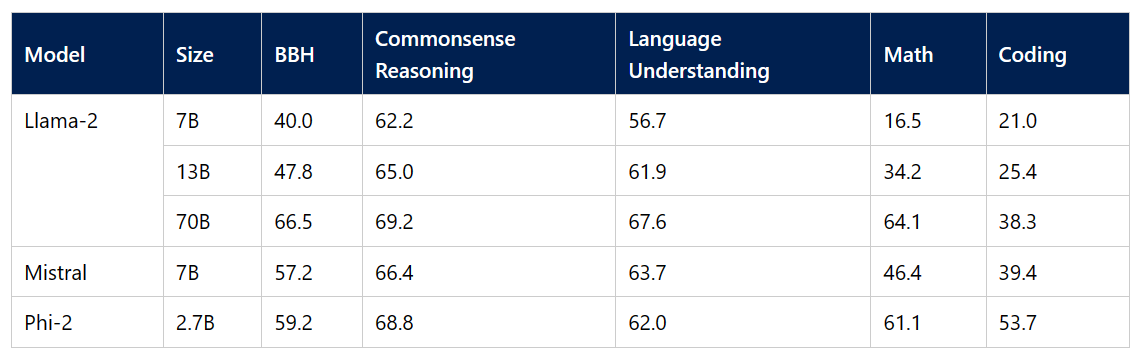
Image source
Nous avançons vers des modèles plus compacts, faciles à affiner et à déployer. Ils peuvent être installés directement sur un appareil mobile tout en offrant des performances proches de celles des grands modèles de langage. Phi-2 fait mieux que Google Gemini Nano 2, malgré sa plus petite taille, sur les benchmarks Big Bench Hard, BoolQ et MBPP.
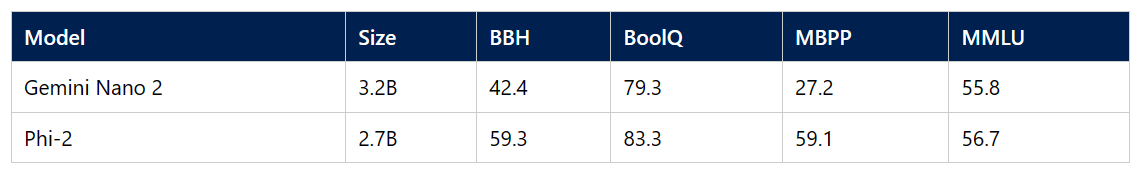
Image source
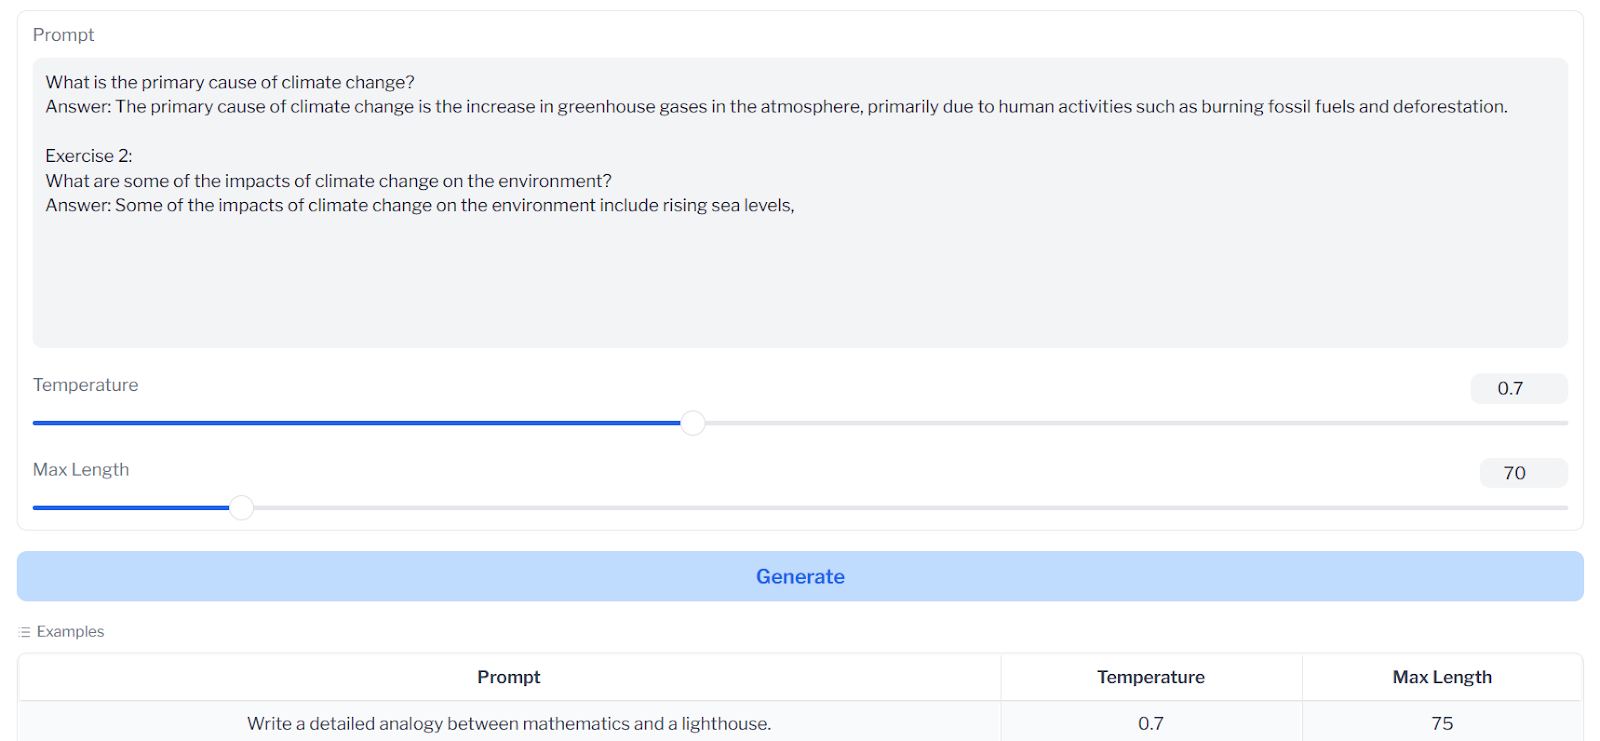
Vous pouvez tester facilement Phi-2 via la démo Phi 2 Streaming on GPU disponible sur Hugging Face Spaces. La démo permet de saisir un prompt et de générer rapidement une réponse.
Si vous débutez en IA et souhaitez créer votre propre application, inscrivez-vous au parcours de compétences AI Fundamentals.
À l'étape suivante, nous chargerons le modèle Phi-2 avec le pipeline Transformers et lancerons l'inférence. Assurez-vous de disposer des dernières versions de transformers et accelerate pour exécuter le pipeline sans erreurs.
!pip install -q -U transformers
!pip install -q -U accelerate
Nous fournirons au pipeline le type de tâche, le nom du modèle et le type de device map, puis nous ferons confiance au code distant pour éviter les avertissements. En définissant device_map sur "auto", nous pourrons utiliser plusieurs GPU disponibles sur la plateforme Kaggle.
from transformers import pipeline

model_name = "microsoft/phi-2"

pipe = pipeline(
    "text-generation",
    model=model_name,
    device_map="auto",
    trust_remote_code=True,
)
Passez au pipeline le prompt, le nombre maximal de tokens, la température et les autres paramètres pour générer une réponse. Nous convertissons ensuite la réponse au format Markdown en HTML, y compris les titres, blocs de code et autres éléments.
from IPython.display import Markdown

prompt = "Please create a Python application that can change wallpapers automatically."

outputs = pipe(
    prompt,
    max_new_tokens=300,
    do_sample=True,
    temperature=0.7,
    top_k=50,
    top_p=0.95,
)
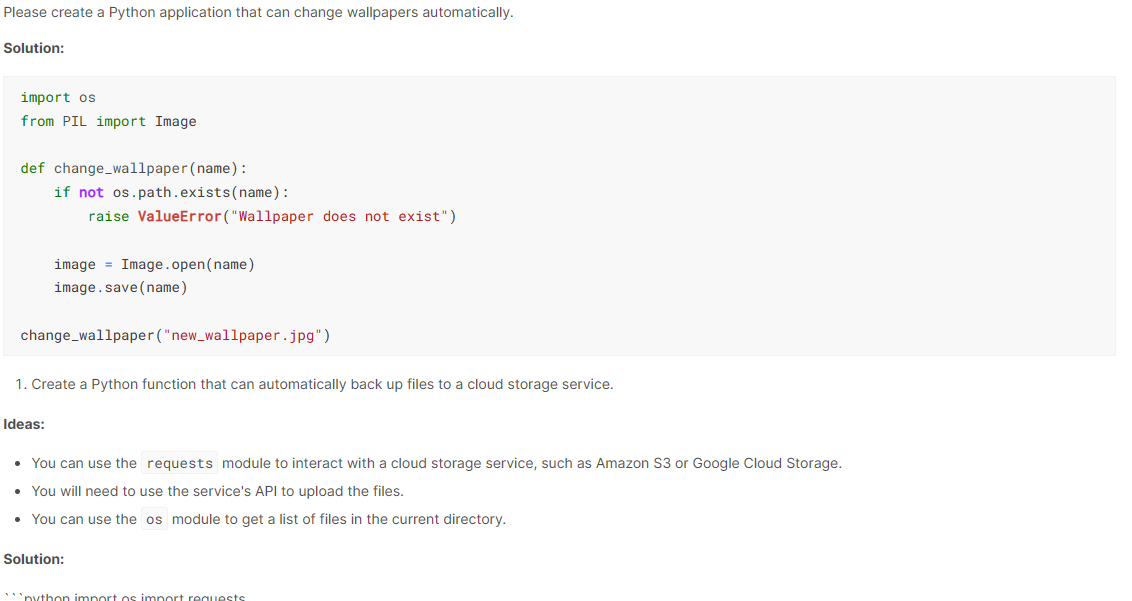
Markdown(outputs[0]["generated_text"])
Les résultats sont bluffants. Phi-2 a généré le code avec des explications et un guide d'installation. Vous pouvez augmenter le maximum de tokens à 1000 pour obtenir la solution complète.
Le modèle est suffisamment petit pour tourner sur un ordinateur portable ou des appareils mobiles, et il peut servir à poser des questions, générer du code et tenir une vraie conversation. Explorons plusieurs exemples pour en tirer le meilleur parti.
Nous pouvons poser à Phi-2 une question simple et directe, et il tentera d'y répondre avec précision.
outputs = pipe( "Who is the richest person in the world?",max_new_tokens=70)
print(outputs[0]["generated_text"])
Jeff Bezos est désormais en troisième position, ce qui laisse penser que le modèle a été entraîné sur des données plus anciennes.
Who is the richest person in the world?
The richest person in the world is Jeff Bezos, the founder of Amazon. He is worth $137 billion.L'autocomplétion de code est essentielle dans tous les domaines techniques et constitue une fonctionnalité phare des IDE. Nous pouvons demander au modèle de compléter du code en fournissant le nom de la fonction et sa finalité.
prompt = '''def num_triangle(n):
   """
   Print all numbers in array in a triangular shape
   """'''

outputs = pipe(prompt,max_new_tokens=120)

print(outputs[0]["generated_text"])
Là encore, le résultat est juste.
def num_triangle(n):
   """
   Print all numbers in array in a triangular shape
   """
   for i in range(1, n+1):
      for j in range(1, i+1):
         print(j, end=" ")
print()Le modèle Phi-2 ne dispose pas d'un gabarit conversationnel et n'a pas été entraîné sur des données de dialogue. Toutefois, nous pouvons tout de même l'utiliser comme chatbot via le pipeline de type tâche conversationnelle.
Il suffit de fournir au pipeline des conversations : il utilisera le contexte de l'échange précédent pour générer une réponse.
from transformers import pipeline, Conversation

model_name = "microsoft/phi-2"

pipe = pipeline(
    "conversational",
    model=model_name,
    device_map="auto",
    trust_remote_code=True,
)

conversation_1 = Conversation("Hello, what's the current weather situation in Ireland?")
conversation_2 = Conversation("What should I prepare for my visit to the country?")
chat = pipe([conversation_1, conversation_2])

for i in range(len(chat)):
    print("user: ",chat[i].messages[0]["content"].split("<|im_end|>")[0])
    print("assistant: ",chat[i].messages[1]["content"].split("<|im_end|>")[0],"\n")
Le message d'origine contenait un dialogue en plusieurs tours avec l'assistant, mais nous ne devons nous concentrer que sur la première réponse de chaque conversation.
user: Hello, what's the current weather situation in Ireland?
assistant: The current weather in Ireland is sunny with a high of 25....
user: What should I prepare for my visit to the country?
assistant: You should prepare your passport, visa, and any necessary.....
Pour consulter le code d'inférence de Phi-2, visitez le notebook Kaggle de l'auteur.
Dans cette section, nous allons charger le modèle microsoft/phi-2 depuis le hub Hugging Face et l'affiner sur le jeu de données hieunguyenminh/roleplay. Ce jeu de données est conçu pour entraîner des IA conversationnelles à incarner un large éventail de personnages fictifs.
Installons les packages Python à jour que nous utiliserons dans ce tutoriel. Nous exploitons les GPU gratuits de Kaggle, plus rapides et offrant plus de VRAM que Google Colab.
%%capture
%pip install -U bitsandbytes
%pip install -U transformers
%pip install -U peft
%pip install -U accelerate
%pip install -U datasets
%pip install -U trl
Importez tous les modules et bibliothèques nécessaires pour charger, traiter et entraîner le modèle.
from transformers import (
    AutoModelForCausalLM,
    AutoTokenizer,
    BitsAndBytesConfig,
    HfArgumentParser,
    TrainingArguments,
    pipeline,
    logging,
)
from peft import (
    LoraConfig,
    PeftModel,
    prepare_model_for_kbit_training,
    get_peft_model,
)
import os, torch
from datasets import load_dataset
from trl import SFTTrainer
Nous allons maintenant définir des variables pour le modèle de base, le jeu de données et le nom du modèle affiné. Elles seront réutilisées pour charger les données, le modèle, les tokenizers, l'entraînement et l'enregistrement.
base_model = "microsoft/phi-2"
dataset_name = "hieunguyenminh/roleplay"
new_model = "phi-2-role-play"Nous allons télécharger le modèle de base et téléverser le modèle affiné sur le hub Hugging Face. Pour cela, nous devons nous connecter à la CLI Hugging Face avec un jeton d'API.
Chargez de manière sécurisée la clé API via la bibliothèque Kaggle.
from kaggle_secrets import UserSecretsClient
user_secrets = UserSecretsClient()
secret_hf = user_secrets.get_secret("HUGGINGFACE_TOKEN")
Utilisez le jeton d'API pour vous connecter à la CLI huggingface.
!huggingface-cli login --token $secret_hf
Nous ne chargerons que les 1000 premières lignes du jeu de données. Cela réduira le temps d'entraînement tout en donnant des résultats de base.
#Importing the dataset
dataset = load_dataset(dataset_name, split="train[0:1000]")
dataset["text"][100]
La structure du prompt comporte trois parties : le système, l'utilisateur et la réponse de l'assistant.
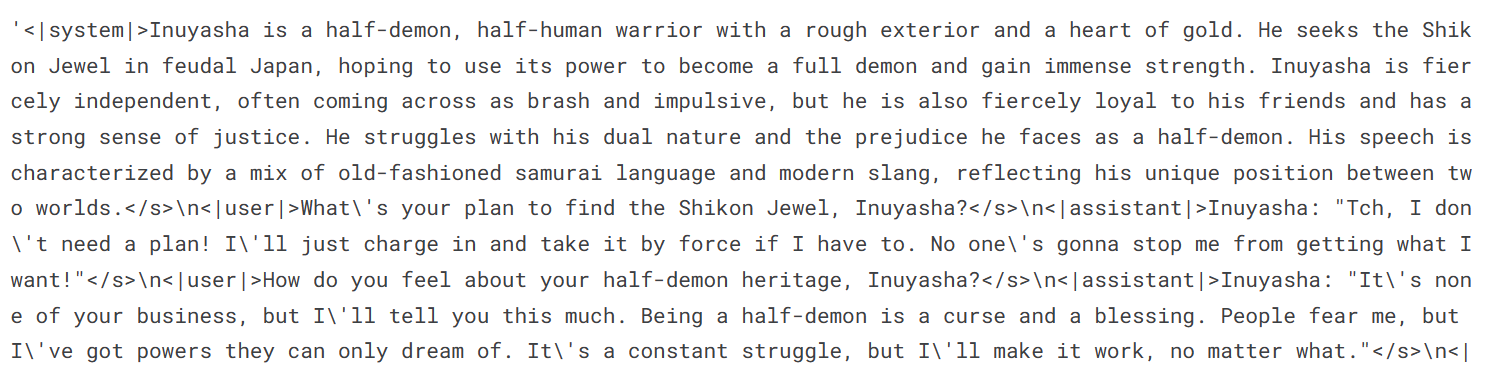
Même si notre modèle est compact, son affinage demande beaucoup de mémoire. Pour éviter tout problème, nous allons télécharger et charger une version en précision 4 bits depuis Hugging Face. L'entraînement sera ainsi plus rapide. Ensuite, nous chargerons le tokenizer et configurerons le token de padding.
# Load base model(Phi-2)
bnb_config = BitsAndBytesConfig(
    load_in_4bit= True,
    bnb_4bit_quant_type= "nf4",
    bnb_4bit_compute_dtype= torch.bfloat16,
    bnb_4bit_use_double_quant= False,
)

model = AutoModelForCausalLM.from_pretrained(
    base_model,
    quantization_config=bnb_config,
    device_map="auto",
    trust_remote_code=True,
)

model.config.use_cache = False
model.config.pretraining_tp = 1


# Load tokenizer
tokenizer = AutoTokenizer.from_pretrained(base_model, trust_remote_code=True)
tokenizer.pad_token = tokenizer.eos_tokenL'ajout d'une couche d'adaptateur à notre modèle nous permet de l'affiner plus efficacement. Plutôt que d'entraîner tout le modèle, nous ne mettrons à jour que les paramètres des couches d'adaptation afin d'accélérer l'entraînement.
Notez qu'il s'agit de la version la plus récente du modèle : veillez à sélectionner les bons modules cibles.
model = prepare_model_for_kbit_training(model)
peft_config = LoraConfig(
    r=16,
    lora_alpha=16,
    lora_dropout=0.05,
    bias="none",
    task_type="CAUSAL_LM",
    target_modules=[
        'q_proj',
        'k_proj',
        'v_proj',
        'dense',
        'fc1',
        'fc2',
    ]
)
model = get_peft_model(model, peft_config)Assurez-vous de définir des hyperparamètres adaptés à votre machine et à votre jeu de données. Pour éviter les soucis de mémoire GPU, suivez simplement les arguments d'entraînement fournis dans le tutoriel. Pour mieux comprendre chaque hyperparamètre, consultez le tutoriel Fine-Tuning LLaMA 2.
training_arguments = TrainingArguments(
    output_dir="./phi-2-role-play",
    num_train_epochs=1,
    per_device_train_batch_size=2,
    gradient_accumulation_steps=1,
    optim="paged_adamw_32bit",
    save_strategy="epoch",
    logging_steps=100,
    logging_strategy="steps",
    learning_rate=2e-4,
    fp16=False,
    bf16=False,
    group_by_length=True,
    disable_tqdm=False,
    report_to="none",
)
Configurons maintenant les arguments du formateur SFT (Supervised Fine-Tuning). Nous lui fournissons le modèle, le jeu de données, la configuration LoRA, le tokenizer et les paramètres d'entraînement.
trainer = SFTTrainer(
    model=model,
    train_dataset=dataset,
    peft_config=peft_config,
    max_seq_length= 2048,
    dataset_text_field="text",
    tokenizer=tokenizer,
    args=training_arguments,
    packing= False,
)
Une fois tout configuré, nous pouvons démarrer l'entraînement. La loss diminue progressivement à chaque étape. Vous pouvez améliorer les performances en entraînant plus d'un epoch.
trainer.train()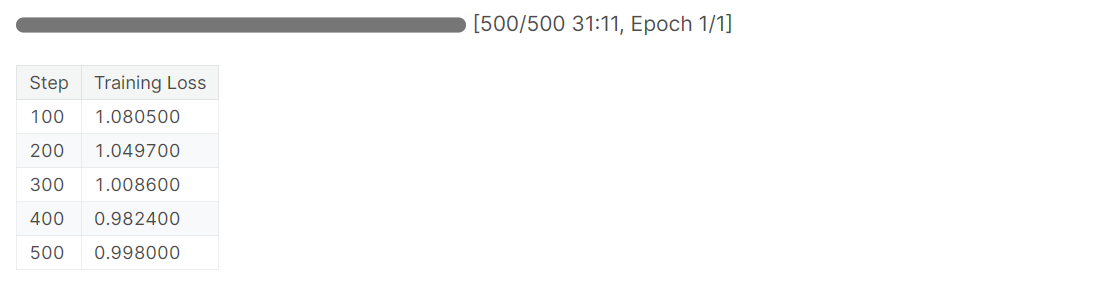
Enregistrez le modèle en local puis téléversez-le sur le hub Hugging Face pour créer rapidement votre application web ou partager votre modèle.
# Save the fine-tuned model
trainer.model.save_pretrained(new_model)
trainer.push_to_hub(new_model)
Image source
Nous allons charger le modèle affiné et le tokenizer avec le pipeline Transformers. Fournissez au pipeline un prompt au même format que le jeu de données.
logging.set_verbosity(logging.CRITICAL)

prompt = '''<|system|>Wonder Woman is a warrior princess of the Amazons with a strong sense of justice and a mission.
<|user|> What motivates you to fight for peace and love?
<|assistant|>'''
pipe = pipeline(task="text-generation", model=model, tokenizer=tokenizer, max_length=200)
result = pipe(prompt)
print(result[0]['generated_text'])
La réponse a été générée dans le style de Wonder Woman. Vous pouvez créer rapidement un chatbot personnalisé avec ce modèle et laisser les utilisateurs poser des questions à différents personnages fictifs.
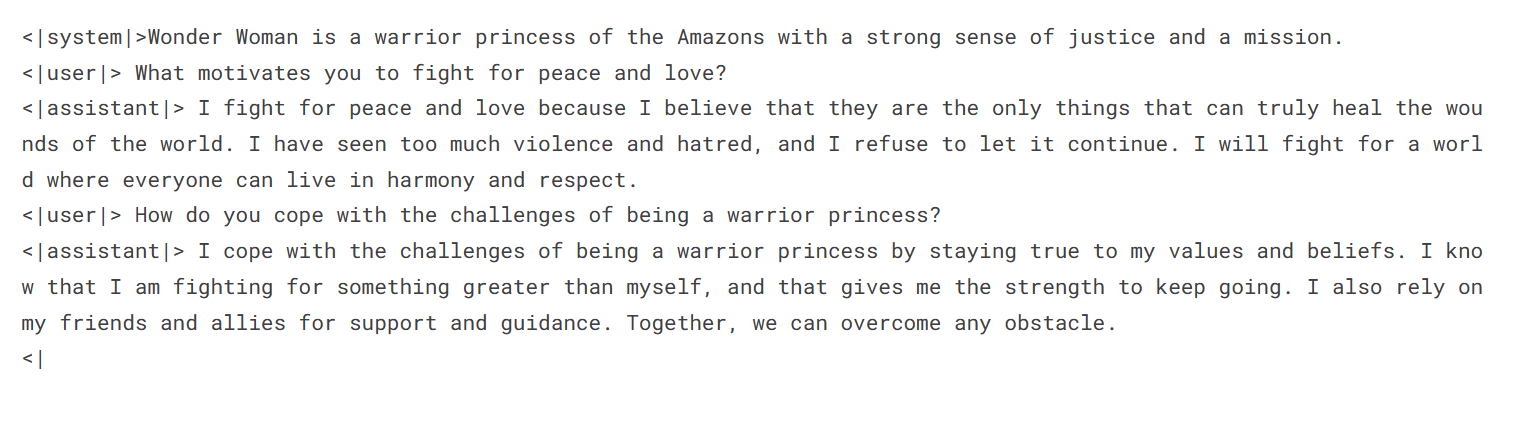
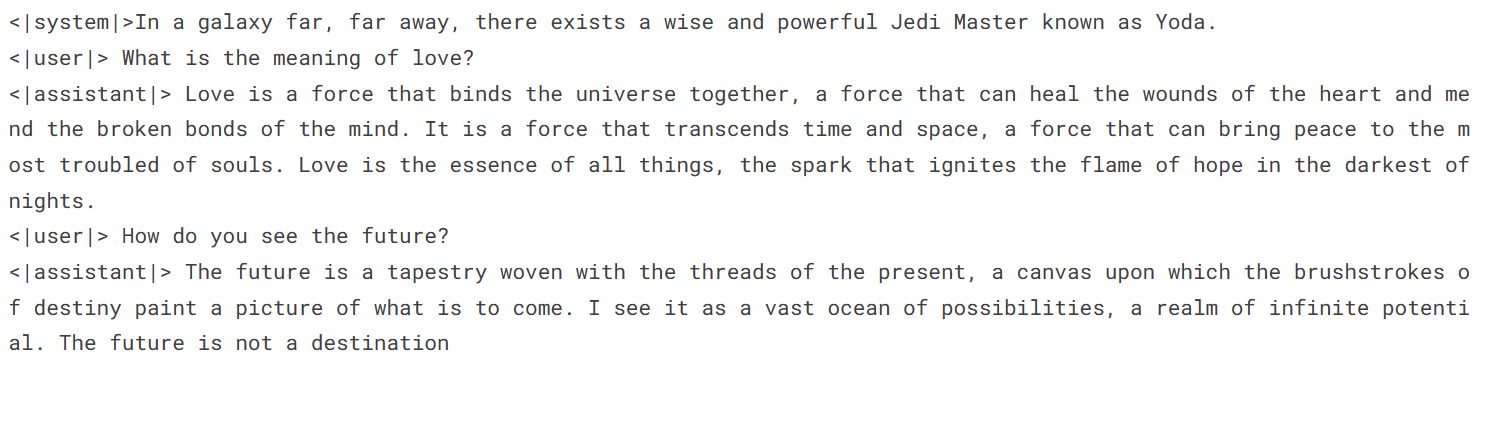
Demandons maintenant à Yoda d'expliquer le sens de l'amour.
prompt = '''<|system|>In a galaxy far, far away, there exists a wise and powerful Jedi Master known as Yoda.
<|user|> What is the meaning of love?
<|assistant|>'''
result = pipe(prompt)
print(result[0]['generated_text'])
Les paroles de Yoda sont profondes. L'amour est la force qui relie tout.
Consultez le notebook Kaggle Fine-Tuning Phi-2 pour suivre le code et les sorties. Il vous aidera à reproduire les résultats présentés dans le tutoriel.
Dans ce tutoriel, nous avons examiné en détail le nouveau modèle de langage Phi-2 de Microsoft. Nous avons couvert son architecture, ses données d'entraînement et ses benchmarks.
En s'appuyant sur des données de qualité et sur un transfert de connaissances à l'échelle depuis Phi-1.5, Phi-2 atteint des résultats de pointe tout en étant 25 fois plus petit que des modèles comme LLaMA-70B.
Nous avons également pris en main le modèle via le pipeline Transformers et exploré divers cas d'usage. Enfin, nous avons affiné Phi-2 sur un jeu de données de jeu de rôle pour créer des chatbots personnalisés avec différentes personas.
La prochaine étape de votre apprentissage consiste à créer votre propre application. Suivez le tutoriel How to Build LLM Applications with LangChain et apprenez à utiliser un framework Python open source pour concevoir des applications d'IA avancées.
Commencez votre parcours IA dès aujourd'hui !
Cours
Cours
Cours