Curso
Comprender el machine learning
2 h
308K
Imagina esta situación:
Estás trabajando con tu conjunto de datos. Creas un modelo de clasificación y consigues un 90% de precisión a la primera. Los resultados te parecen fantásticos. Profundizas un poco y descubres que casi todos los datos pertenecen a una sola clase. ¡Vaya! Los datos desbalanceados pueden ser una fuente de frustración.
La decepción llega cuando descubres que las clases están desbalanceadas y que esos "grandes" resultados no eran reales. Para colmo, muchos libros apenas tratan este tema de forma integral.
Este es un ejemplo de lo que puede ocurrir con un conjunto de datos desbalanceado y los resultados tan engañosos que puede provocar.
En este tutorial, descubrirás técnicas con las que podrás obtener muy buenos resultados en conjuntos con datos desbalanceados. En concreto, veremos:
Vamos primero a ver qué son los datos desbalanceados.
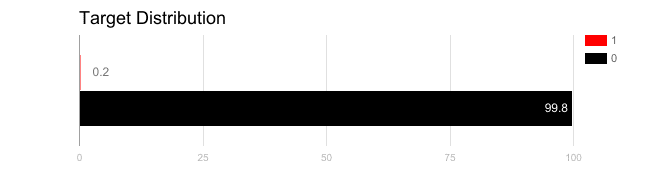 Source: KDNuggets
Normalmente hablamos de datos desbalanceados en tareas de clasificación donde las clases no están representadas por igual.
Por ejemplo, puedes tener un problema de clasificación binaria con 100 instancias, de las cuales 80 pertenecen a la Clase 1 y las 20 restantes a la Clase 2.
Este es un caso claro de conjunto desbalanceado, con una proporción Clase 1 : Clase 2 de 4:1.
Tanto en competiciones de Kaggle como en datos reales de producción, el desbalanceo de clases es de los problemas más habituales.
La mayoría de problemas reales de clasificación presentan algún grado de desbalanceo: faltan suficientes instancias de alguna de las clases. Por eso es clave elegir bien la métrica de evaluación del modelo. Si no lo haces, puedes acabar ajustando/optimizando un parámetro irrelevante. En un entorno empresarial, esto puede suponer un desperdicio total.
Hay problemas en los que el desbalanceo no solo es común; es inevitable. Por ejemplo, en conjuntos de transacciones fraudulentas y no fraudulentas, lo normal es que las fraudulentas sean muchas menos que las no fraudulentas. Y ahí surge el problema. Verás por qué.
Aunque muchos algoritmos de aprendizaje automático (tanto estadísticos como de deep learning) han demostrado un gran rendimiento en aplicaciones reales, aprender a partir de datos desbalanceados todavía no es estado del arte. A este campo se le suele llamar aprendizaje con clases desbalanceadas (Imbalanced learning).
Estos son algunos de sus problemas más relevantes:
Llegados a este punto, seguramente te preguntes: en plena era de GPUs y TPUs, ¿por qué los algoritmos no resuelven bien el desbalanceo? Es una buena pregunta, y la respuesta llega ahora.
La evaluación de los algoritmos tiene mucho que ver con por qué un modelo no rinde cuando se le alimenta con datos desbalanceados.
"Es el caso en el que tus medidas de precisión cuentan que tienes una exactitud excelente (por ejemplo, 90%), pero lo único que reflejan es la distribución subyacente de clases." - Machine Learning Mastery
Supón un conjunto de dos clases con proporción 9:1. Hay 1000 instancias en total, etiquetadas como Clase 1 y Clase 2. Con esa proporción, hay 900 instancias de Clase 1 y 100 de Clase 2. Aplicas un clasificador estándar (por ejemplo, Regresión Logística) y mides su rendimiento con la exactitud de clasificación, que es el número de instancias clasificadas correctamente. Ahora, piensa con calma.
Tu modelo de Regresión Logística no necesita ser muy complejo para clasificar las 1000 instancias como Clase 1. En ese caso, obtienes un 90% de exactitud, que no es un buen indicador de la calidad real del clasificador. Claramente, necesitas otras métricas para evaluar el sistema. Lo verás en un momento. A este fenómeno se le llama paradoja de la exactitud.
Empezaremos repasando métricas alternativas a la exactitud para juzgar de verdad un clasificador cuando hay desbalanceo.
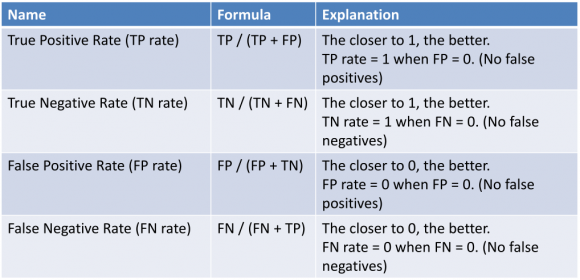
Primero, definamos cuatro conceptos básicos:
La siguiente imagen ilustra estos términos:
Ahora imagina que entrenas otro clasificador sobre el mismo conjunto sencillo y esta vez usas un Random Forest. Obtienes un 70% de exactitud. Ya que conoces las tasas de verdaderos y falsos positivos/negativos, compara con más detalle la Regresión Logística y el Random Forest.
Supón que para la Regresión Logística obtienes estas tasas de verdaderos/falsos positivos y negativos:

Y para Random Forest, las siguientes:

Fíjate en los negativos correctamente predichos (verdaderos negativos) por ambos clasificadores. Al tratar con un conjunto desbalanceado, este número es clave (porque la Clase 1 domina en el conjunto). Con ese criterio, Random Forest supera con claridad a la Regresión Logística.
Ahora ya estás en buena posición para estudiar los enfoques que combaten el problema de las clases desbalanceadas.
(Recuerda: a esta representación se la conoce como matriz de confusión).
Dos métricas muy utilizadas derivadas de la matriz de confusión son:
Precisión (precision): número de verdaderos positivos dividido por la suma de verdaderos positivos y falsos positivos. Dicho de otro modo, el número de predicciones positivas entre el total de predicciones positivas realizadas. También se conoce como valor predictivo positivo (PPV).
La precisión puede interpretarse como una medida de la exhaustividad del clasificador respecto a los positivos que predice correctamente frente a los falsos positivos. Una precisión baja indica muchos falsos positivos.
Exhaustividad (recall): número de verdaderos positivos dividido por la suma de verdaderos positivos y falsos negativos. Es decir, el número de positivos detectados entre el total de positivos reales en los datos de prueba. También se llama sensibilidad o tasa de verdaderos positivos.
El recall puede verse como una medida de la cobertura del clasificador. Un recall bajo indica muchos falsos negativos.
Otras métricas útiles en este contexto:
Antes de ver enfoques para abordar el desbalanceo, tomemos un ejemplo muy real donde elegir solo la exactitud como métrica de evaluación puede ser desastroso. (La idea es que no te quedes solo con la exactitud al entrenar tu próximo clasificador).
El conjunto de cáncer de mama es un dataset clásico. Contiene 9 atributos de 286 mujeres que padecieron y sobrevivieron a un cáncer de mama, e indica si hubo recurrencia en los 5 años siguientes.
Es un problema de clasificación binaria. De las 286 mujeres, 201 no sufrieron recurrencia y las 85 restantes sí.
Vamos a explorar el conjunto de forma visual.
import numpy as np
import pandas as pd

# Load the dataset into a pandas dataframe
data = pd.read_csv("breast-cancer.data",header=None)

# See the data
print(data.head(10))
                      0      1        2      3    4   5  6      7          8  \
0  no-recurrence-events  30-39  premeno  30-34  0-2  no  3   left   left_low
1  no-recurrence-events  40-49  premeno  20-24  0-2  no  2  right   right_up
2  no-recurrence-events  40-49  premeno  20-24  0-2  no  2   left   left_low
3  no-recurrence-events  60-69     ge40  15-19  0-2  no  2  right    left_up
4  no-recurrence-events  40-49  premeno    0-4  0-2  no  2  right  right_low
5  no-recurrence-events  60-69     ge40  15-19  0-2  no  2   left   left_low
6  no-recurrence-events  50-59  premeno  25-29  0-2  no  2   left   left_low
7  no-recurrence-events  60-69     ge40  20-24  0-2  no  1   left   left_low
8  no-recurrence-events  40-49  premeno  50-54  0-2  no  2   left   left_low
9  no-recurrence-events  40-49  premeno  20-24  0-2  no  2  right    left_up

    9
0  no
1  no
2  no
3  no
4  no
5  no
6  no
7  no
8  no
9  no
Los nombres de columna son numéricos porque usamos una versión parcialmente preprocesada. Si te interesa, consulta esta imagen:

Veamos un diagrama de barras con la distribución de clases.
import matplotlib.pyplot as plt

classes = data[9].values
unique, counts = np.unique(classes, return_counts=True)

plt.bar(unique,counts)
plt.title('Class Frequency')
plt.xlabel('Class')
plt.ylabel('Frequency')
plt.show()

La desproporción es clara. yes indica los casos con cáncer y, como era de esperar, su número es muy inferior al de la otra clase.
Definamos los eventos "No recurrences" y "Recurrences" del dataset para que quede aún más claro.
Todo no recurrencia: un modelo que solo predice no recurrencia lograría una exactitud de (201/286) * 100 = 70,28%. Es lo que llamamos All No Recurrence. Alta exactitud, pero modelo pésimo. Si se interpreta mal, mandaría a casa a 85 mujeres creyendo que su cáncer no reaparecerá (muchos falsos negativos).
Toda recurrencia: un modelo que solo predice recurrencia alcanzaría (85/286) * 100 = 29,72% de exactitud. Es el All Recurrence. Además de una exactitud pobre, enviaría a casa a 201 mujeres pensando que tienen una recurrencia cuando no es así (muchos falsos positivos).
Con esto debería haberse encendido una luz. Sigamos.
Ya tienes motivos de sobra para no usar solo la exactitud para evaluar tu modelo de clasificación.
Veamos ahora algunos enfoques.
Tratar con conjuntos desbalanceados incluye distintas estrategias: mejorar los algoritmos de clasificación o equilibrar las clases en los datos de entrenamiento (un paso de preprocesamiento) antes de alimentar al algoritmo. Esta última suele preferirse por su mayor aplicabilidad y rapidez; mejorar un algoritmo lleva más tiempo que generar muestras. Para investigación, ambas vías son válidas.
La idea del muestreo es aumentar las muestras de la clase minoritaria o reducir las de la clase mayoritaria para equilibrar el número de instancias.
Hay dos tipos principales de muestreo:
Implementarlo también es bastante sencillo, ¿verdad? Más adelante verás una librería pensada para esto.
Cuando eliminas aleatoriamente instancias de la clase mayoritaria sin rellenar el hueco que dejas, hablamos de submuestreo aleatorio. El vacío resultante es lo que hace que el proceso sea aleatorio.
Ventajas:
Desventajas:
De forma análoga, puedes aplicar sobre-muestreo. En este caso, sin tocar la clase mayoritaria, aumentas la minoritaria replicando sus instancias hasta un cierto grado. Por ejemplo, con 1000 instancias donde 980 son de la clase mayoritaria y 20 de la minoritaria, si replicas esas 20 instancias 20 veces, pasarás a tener 400 en la minoritaria.
Ventajas:
Desventajas:
Factores a considerar al elegir submuestreo o sobre-muestreo:
Si quieres implementar submuestreo y sobre-muestreo en Python, echa un vistazo a scikit-learn-contrib.
Veamos ahora el siguiente enfoque.
Una forma sencilla es muestrear aleatoriamente atributos de instancias de la clase minoritaria.
Existen algoritmos sistemáticos para generar muestras sintéticas. El más popular es SMOTE (Synthetic Minority Over-sampling Technique), propuesto en 2002. La siguiente infografía te da una idea:
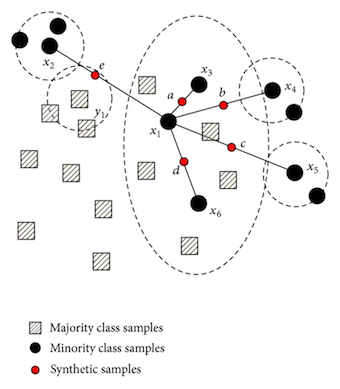
SMOTE es un método de sobre-muestreo que crea ejemplos "sintéticos" en lugar de replicar instancias. La clase minoritaria se sobre-muestrea tomando cada muestra minoritaria e introduciendo ejemplos sintéticos a lo largo de los segmentos que la unen con sus k vecinos más cercanos de la clase minoritaria. Según el grado de sobre-muestreo deseado, se eligen aleatoriamente vecinos de esos k más cercanos.
La clave de SMOTE es cómo construye la clase minoritaria. Ya viste que el sobre-muestreo por réplica puede causar sobreajuste y endurecer la frontera de decisión. ¿Y si en lugar de repetir, generas muestras similares? En el artículo original de SMOTE (enlazado arriba) se muestra que, para el algoritmo, estas instancias no son copias exactas, lo que suaviza la frontera de decisión y ayuda a aproximar mejor la hipótesis.
Ventajas y desventajas de SMOTE:
Ventajas:
Desventajas:
Hay variantes como safe-level SMOTE, borderline-SMOTE, OSSLDDD-SMOTE, etc. Para usar SMOTE y sus variantes, revisa el módulo scikit-learn-contrib mencionado. Para aprender más sobre SMOTE, consulta este y este artículos.
Pasemos al último enfoque de este tutorial.
Existen líneas de investigación específicas para tratar conjuntos desbalanceados, con sus propios algoritmos, métricas y terminología.
A menudo, la creatividad y un enfoque diferente aportan nuevas perspectivas. Aquí tienes una que puede darte ventaja:
Aprendizaje sensible al coste: normalmente usamos regularización (si quieres saber más, echa un vistazo a este artículo de DataCamp) para penalizar coeficientes grandes en modelos lineales generalizados (GLM). Si diseñas un mecanismo que penalice al clasificador cada vez que se equivoca, puedes ayudarle a aprender la hipótesis con más detalle.
Algunas ideas que deberías considerar:
Has visto qué son los datos desbalanceados y los problemas que generan al diseñar y desarrollar modelos de machine learning. También por qué es crucial abordarlos. Después, repasaste distintos enfoques para tratarlos con eficacia. El procesamiento de datos desbalanceados es un área de investigación activa que puede abrirte nuevas líneas de trabajo.
¡Muchos conceptos importantes de una vez! ¡Genial!
Y hasta aquí este tutorial.
A continuación tienes algunas referencias si quieres profundizar aún más en el tema:
Referencias:
Si quieres aprender más sobre visualización de datos, haz el curso de DataCamp "Interactive Data Visualization with Bokeh", impartido por Bryan Van de Ven, uno de los desarrolladores de Bokeh.
Aprende más sobre machine learning
Curso
Curso
Curso
Tutorial
Moez Ali
14 min
Tutorial
Zoumana Keita
15 min
Tutorial
Abid Ali Awan
15 min
Tutorial
Abid Ali Awan
6 min
Tutorial
DataCamp Team
10 min
Tutorial
Kurtis Pykes
7 min