Dernière chance ! -50 % sur DataCamp Premium
L'offre se termine dans
J'ai rencontré le concept de cardinalité pour la première fois lors d'un cours de mécanique quantique, pendant mes études de physique. Dans cette classe, la cardinalité faisait référence à la taille d'un ensemble, qu'il soit fini ou infini, et était liée à des concepts abstraits tels que la dénombrabilité et les infinis. En passant au génie logiciel, je me suis rendu compte que, pour un ingénieur en données ou un scientifique, la cardinalité a une signification beaucoup plus pratique : le caractère distinctif des valeurs dans un ensemble de données.
Dans l'un de mes premiers projets d'analyse de données réelles, j'ai découvert à quel point la cardinalité élevée pouvait être un défi. Il a ralenti les requêtes de ma base de données et a transformé ce qui aurait dû être une vision claire en un désordre confus. Depuis, j'ai acquis une certaine expérience pratique et j'ai rédigé ce guide dans l'espoir qu'il puisse aider d'autres personnes dans la même situation. Vous êtes au bon endroit si vous voulez apprendre ce qu'est la cardinalité élevée, quels sont les défis qu'elle pose et comment les maîtriser de manière pratique et efficace !
Les concepts de cardinalité et de cardinalité élevée peuvent sembler un peu abstraits.
La cardinalité fait référence au nombre de valeurs uniques dans une colonne d'un ensemble de données. Une colonne à forte cardinalité contient un grand nombre de valeurs uniques, tandis que les colonnes à faible cardinalité contiennent moins d'entrées uniques.
Une cardinalité élevée est particulièrement fréquente dans les ensembles de données comportant des identifiants uniques, comme par exemple :
Ces valeurs uniques sont importantes pour le cursus, l'agrégation ou la personnalisation des données. Cependant, leur nombre considérable peut poser des défis importants en matière de stockage, de performances et de visualisation, que nous examinerons prochainement.
La cardinalité élevée peut se manifester dans tous les domaines et toutes les industries. J'ai donné quelques exemples ci-dessous pour vous aider à comprendre ce que signifie une cardinalité élevée en termes plus pratiques.
Les plateformes de commerce électronique génèrent quotidiennement d'énormes quantités de données à haute cardinalité :
Ces ensembles de données sont essentiels pour comprendre le comportement des utilisateurs, suivre les stocks et optimiser les stratégies de vente, mais le nombre même d'entrées uniques rend souvent l'analyse complexe.
Dans le domaine des soins de santé, la nécessité d'un suivi et d'une identification précis se traduit naturellement par des données de haute cardinalité. Par exemple, nous pouvons trouver :
Ces données sont nécessaires pour conserver l'historique des patients et garantir le respect de la réglementation en matière de protection de la vie privée.
La prolifération des appareils IoT a créé une vague d'ensembles de données à haute cardinalité :
Dans l'IdO, la cardinalité élevée est due à la nécessité de traiter des données fines et en temps réel provenant de nombreux appareils. Ces données sont essentielles pour l'analyse et le suivi, mais il est difficile de les stocker et de les interroger efficacement - nous y reviendrons plus tard !
La cardinalité élevée présente plusieurs défis en matière de traitement des données, d'ingénierie, d'analyse et d'apprentissage automatique. Les ensembles de données à forte cardinalité fournissent une multitude d'informations utiles, mais ils peuvent souvent devenir un goulot d'étranglement et entraver les performances, l'interprétabilité et l'évolutivité.
L'un des plus grands défis de la cardinalité élevée est son impact sur le stockage des données et les performances du système.
Prenons l'exemple d'une base de données stockant des données de capteurs IoT avec des identifiants de capteurs uniques et des horodatages précis. Les requêtes filtrées par un capteur et une période spécifiques peuvent nécessiter le traitement par la base de données de millions d'entrées uniques, ce qui entraîne des temps de réponse extrêmement lents et des opérations gourmandes en ressources.
Le défi consiste à présenter un grand nombre de valeurs distinctes d'une manière qui soit à la fois compréhensible et significative. Sans une réflexion approfondie, les données à cardinalité élevée peuvent en fait cacher des informations au lieu de les révéler.
Le diagramme circulaire ci-dessous en est un bon exemple. La légende et les valeurs sont illisibles parce qu'il y a trop d'entrées uniques (états) pour le type de graphique utilisé. Il est parfois utile de changer le type de graphique utilisé, mais ce n'est pas toujours le cas.
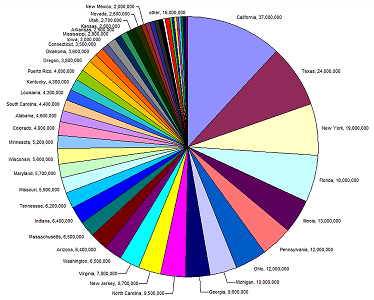
Source : Agence européenne pour l'environnement
Imaginez un diagramme à barres représentant l'activité des clients d'une plateforme de commerce électronique par identifiant de session. Avec des milliers ou des millions d'identifiants uniques, le graphique devient un fouillis de barres illisibles, et il est peu probable que le changement du type de graphique que nous utilisons pour représenter ces données fasse une différence.
D'accord, mais pourquoi ne pas simplement agréger les données pour en tirer des schémas et des relations ? Nous le pouvons, mais il faut le faire avec prudence. L'agrégation de données à forte cardinalité peut nous faire perdre la granularité dont nous avons besoin pour obtenir des informations. Par exemple, le regroupement des données IoT par emplacement peut masquer des variations subtiles mais critiques au niveau de chaque capteur. Les techniques pour résoudre ce problème peuvent être subtiles. Je vous recommande notre cours Intermediate Data Modeling in Power BI pour acquérir une expérience pratique des relations de type un à un et un à plusieurs.
Une cardinalité élevée peut poser des problèmes importants dans le domaine de l'apprentissage automatique, notamment en ce qui concerne l'ingénierie des caractéristiques, la complexité des modèles et l'interprétabilité. Les modèles d'apprentissage automatique s'appuient sur des données structurées et significatives, mais les caractéristiques à forte cardinalité perturbent souvent cet équilibre, ce qui entraîne des complications :
Par exemple, dans le domaine du commerce électronique, un modèle d'apprentissage automatique prédisant le désabonnement des clients peut inclure une caractéristique à forte cardinalité telle que l'"identifiant de l'utilisateur" ou l'"identifiant du produit". S'il n'est pas correctement géré, le modèle pourrait s'adapter de manière excessive à des clients ou des produits spécifiques dans les données d'apprentissage. Cela la rendrait moins efficace lorsqu'elle est appliquée à la prédiction du désabonnement de nouveaux utilisateurs, car elle apprend des schémas propres à l'ensemble de données d'apprentissage plutôt que des tendances généralisables.
La gestion efficace d'une cardinalité élevée nécessite un mélange de stratégies spécifiques au domaine et de techniques générales d'optimisation des données. Ces approches permettent non seulement d'améliorer les performances du système, mais aussi de rendre les données plus interprétables et exploitables.
Heureusement, les défis posés par les ensembles de données à cardinalité élevée sont suffisamment répandus pour que plusieurs techniques et outils aient été créés et affinés spécifiquement pour les traiter.
La gestion d'une cardinalité élevée dans les bases de données commence souvent par l'optimisation de la manière dont les données sont stockées et interrogées, au-delà de la simple suppression des doublons. Les techniques les plus courantes sont les suivantes :
Si vous avez affaire à une cardinalité extrêmement élevée, il existe des outils et des plateformes spécialisés qui peuvent vous aider :
Dans le domaine de la science des données et de l'apprentissage automatique, le prétraitement désigne les mesures prises pour nettoyer, transformer et organiser les données brutes dans un format adapté à l'analyse ou à la modélisation.
Il s'agit d'un sujet assez vaste et si vous n'avez que peu ou pas de connaissances en ingénierie des données ou en science des données, les informations contenues dans cette section peuvent être un peu difficiles à suivre. Cela dit, j'ai inclus des liens et des exemples pertinents pour vous aider à suivre le processus !
Le prétraitement des données est une étape essentielle pour gérer la cardinalité élevée, car il réduit la complexité, améliore les performances et garantit que la qualité des données est suffisante pour les tâches d'analyse ou d'apprentissage automatique. En transformant les données brutes en formes plus faciles à gérer, nous pouvons relever des défis tels que l'éparpillement, l'inefficacité du stockage et les goulets d'étranglement informatiques.
Les techniques de réduction de la dimensionnalité sont particulièrement utiles lorsque la cardinalité élevée se traduit par des ensembles de données comportant de nombreuses caractéristiques ou des matrices éparses. Ces méthodes compressent les données en moins de dimensions tout en conservant les informations essentielles.
Analyse en composantes principales (ACP)
Imaginez que vous disposiez d'un ensemble de données sur les comportements des clients du commerce électronique, avec de nombreuses caractéristiques telles que le nombre de fois qu'un client a consulté un produit, son interaction avec différentes catégories de produits, le temps qu'il a passé sur le site web, etc. Chacune de ces caractéristiques peut avoir une importance capitale, en particulier si vous assurez le cursus d'un grand nombre de produits. L'ACP peut être utilisée pour combiner ces caractéristiques en un nombre réduit de composantes qui capturent toujours les modèles les plus significatifs dans les données, tels que l'engagement global du client ou l'intérêt pour des types de produits particuliers. Pensez-y comme à la Marie Kondo des données : Il conserve les éléments qui suscitent la joie et rejette délicatement les autres !
t-SNE et UMAP
t-SNE et UMAP sont des techniques particulièrement utiles pour visualiser des données à haute dimension en les cartographiant en deux ou trois dimensions tout en préservant leur structure. Par exemple, dans les ensembles de données des dossiers médicaux, les UMAP peuvent aider à regrouper les patients présentant des conditions médicales ou des traitements similaires. Cela permettra de déceler des tendances telles que les maladies concomitantes ou les résultats des traitements.
Si vous construisez un modèle d'apprentissage automatique pour prédire les performances de vente d'une plateforme de commerce électronique et que votre ensemble de données comprend des caractéristiques telles que le nombre de fois qu'un client a cliqué sur une publicité, le nombre de produits qu'il a consultés et le nombre de jours écoulés depuis son dernier achat, vous constaterez que nombre de ces caractéristiques peuvent être corrélées les unes aux autres, ce qui crée une cardinalité et une redondance élevées.
En utilisant des techniques de sélection des caractéristiques telles que l'information mutuelle ou l'élimination récursive des caractéristiques, vous pouvez identifier les caractéristiques qui ont le pouvoir prédictif le plus important (par exemple, le "temps écoulé depuis le dernier achat" peut être plus important que les "clics sur la publicité") et exclure celles qui ne sont pas pertinentes, ce qui améliore en fin de compte les performances de votre modèle.
Si vous souhaitez en savoir plus sur ce sujet, essayez ce cours sur le prétraitement pour l'apprentissage automatique. Vous utiliserez Python pour nettoyer et préparer vos données avant de les introduire dans vos modèles.
Le codage est une étape de prétraitement essentielle pour le traitement des données catégorielles, en particulier lorsqu'il s'agit de caractéristiques à cardinalité élevée. Le choix de la méthode d'encodage dépend du cas d'utilisation spécifique et du niveau de cardinalité de l'ensemble de données.
Les ensembles de données à cardinalité élevée peuvent parfois sembler écrasants et l'extraction d'informations utiles à partir de ces ensembles de données peut s'avérer un véritable défi. La prochaine fois que vous rencontrerez un ensemble de données à cardinalité élevée, rappelez-vous que ce n'est pas la faute des données - elles sont simplement pleines de potentiel qui attend d'être débloqué. Qu'il s'agisse de réduction de la dimensionnalité, de techniques d'encodage intelligentes ou d'outils tels que les bases de données de séries chronologiques, vous pouvez gérer efficacement vos ensembles de données et les transformer en atouts très puissants.
Maintenant que vous savez comment travailler avec des données à cardinalité élevée en théorie, il est temps de passer à la pratique :
Et surtout, relevez le défi. La cardinalité élevée peut être délicate, mais c'est aussi l'occasion d'apprendre beaucoup sur l'ingénierie et l'analyse des données !
Apprenez avec DataCamp
Cours
Cours
Cours
blog
Kurtis Pykes
15 min
blog
Kurtis Pykes
9 min
blog
Tutoriel
Samuel Shaibu
9 min
Tutoriel
Josef Waples
8 min
Tutoriel
Neetika Khandelwal
5 min