
कोर्स
डेवलपर्स के लिए AI-असिस्टेड कोडिंग
1 घंटा 30 मिनट
10.5K
2026 में अधिकांश AI घोषणाएँ चैट और तर्क क्षमता में शीर्ष पर पहुँचने की दौड़ रही हैं, जैसा कि OpenAI के GPT-6 Astra, Anthropic के Fable 5.1 में देखा गया।
TypeSafe का एक नया दृष्टिकोण है। 15 सितंबर, 2026 को, कंपनी ने एक ऐसा मॉडल घोषित किया जो बिल्कुल भी टेक्स्ट जनरेट नहीं करता।
इस मॉडल का नाम Jev है, और यह AI मॉडलों की एक नई श्रेणी से संबंधित है जिसे TypeSafe System One मॉडल कह रहा है।
एक-एक टोकन कर स्ट्रिंग्स बनाने के बजाय, Jev असंरचित प्रोग्राम स्टेट को इनपुट के रूप में लेता है और एक ही समानांतर पास में टाइप किए हुए, प्रायिकतात्मक निर्णय लौटाता है।
TypeSafe के मुख्य दावे हैं कि Jev तुलनीय कार्यों पर फ्रंटियर LLMs से 40x–200x तेज़ चलता है, प्रति मिलियन इनपुट टोकन $0.042 की लागत है और आउटपुट मुफ़्त है, तथा गणितीय रूप से यह न तो भ्रम (हैलुसिनेशन) कर सकता है और न ही टाइप एरर उत्पन्न कर सकता है।
इस लेख में, मैं बताऊँगा कि वास्तव में System One मॉडल क्या है, Jev एक मानक LLM से कैसे भिन्न है, अन्य मॉडलों के मुकाबले वर्कफ़्लो बेंचमार्क क्या दिखाते हैं, और यह वास्तविक स्टैक में कहाँ फिट बैठता है।
जिन मॉडलों के विरुद्ध Jev को मापा गया है, उन पर गहन कवरेज के लिए हमारे Jev बनाम GPT-6 Astra, GPT-5.6 Terra बनाम Claude Sonnet 5 और Claude Opus 5 बनाम GPT-5.6 Sol की तुलना देखें। मैं हमारे Jev विकल्पों के गाइड और Jev API ट्यूटोरियल की भी सिफारिश करता हूँ।
System One मॉडल एक फ्रंटियर AI मॉडल है जो टेक्स्ट के बजाय टाइप किए हुए प्रायिकतात्मक निर्णय लौटाता है।
आप इसे स्टेट का एक ब्लॉक और टाइप किए हुए प्रश्नों का एक सेट देते हैं; यह सभी का समानांतर में आकलन करता है और कैलिब्रेटेड कॉन्फिडेंस स्कोर के साथ संरचित उत्तर लौटाता है—कोई स्ट्रिंग जनरेशन नहीं और कुछ भी पार्स करने की ज़रूरत नहीं। TypeSafe ने सितंबर 2026 में अपने पहले पब्लिक रिलीज़ Jev के साथ इस श्रेणी का नाम गढ़ा।
Jev एक फ्रंटियर मॉडल है जिसे तेज़, संरचित निर्णय लेने के लिए बनाया गया है—ऐसे निर्णय जिन्हें सॉफ़्टवेयर सीधे उपभोग कर सके, बिना पार्सिंग या वैलिडेशन स्टेप के।
यह TypeSafe के System One वर्ग में पहला सार्वजनिक रिलीज़ है, सितंबर 2026 से अर्ली एक्सेस में उपलब्ध, और अर्थशास्त्री William Stanley Jevons के नाम पर रखा गया है।
यह नाम Daniel Kahneman की Thinking, Fast and Slow से आता है।
Kahneman का System 1 तेज़ और सहज है; System 2 धीमा और सोचा-समझा।
मौजूदा LLMs, अपनी chain-of-thought और कई-सेकंड की reasoning ट्रेस के साथ, मज़बूती से System 2 क्षेत्र में आते हैं।
TypeSafe के संस्थापक Diogo Almeida, जो OpenAI में ChatGPT के सह-आविष्कारक थे, का तर्क है कि ऑटोमेशन गैप इसलिए है क्योंकि सभी System 2 मॉडल बना रहे हैं जबकि अधिकांश सॉफ़्टवेयर निर्णय तेज़ System 1 उत्तर चाहते हैं।
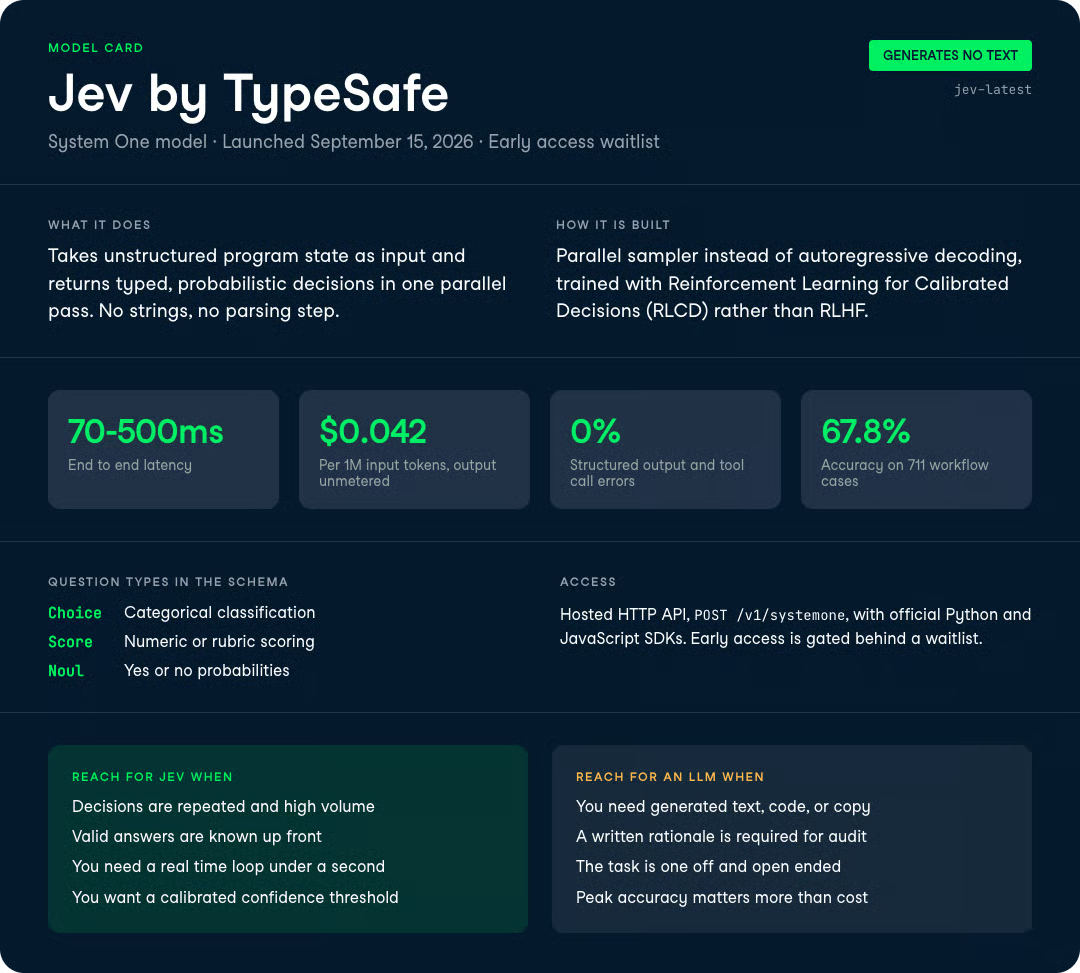
आर्किटेक्चर के स्तर पर, Jev एक ट्रांसफ़ॉर्मर LLM से वास्तविक विचलन है।
यह एक नए मॉडल आर्किटेक्चर का उपयोग करता है जिसमें एक पैरेलल सैंपलर है जो ऑटोरेग्रेसिव के बजाय एक ही क्वेरी में सभी आउटपुट जनरेट करता है, और एक प्रशिक्षण विधि जिसे TypeSafe Reinforcement Learning for Calibrated Decisions (RLCD) कहता है।
जहाँ GPT-5.6 और Opus 5 को RLHF और verifiable rewards के साथ ट्रेन किया जाता है ताकि वे ऐसा टेक्स्ट उत्पन्न करें जो मनुष्यों को पसंद आए, वहीं RLCD संरचित निर्णयों पर कैलिब्रेटेड प्रायिकताओं के लिए ऑप्टिमाइज़ करता है।
परिणाम, TypeSafe के अपने आंकड़ों के अनुसार, 0% संरचित आउटपुट एरर रेट और 70–500ms की एंड-टू-एंड लेटेंसी है।
RLCD प्रशिक्षण विधि पर एक तथ्य: TypeSafe इसे सीधे RLHF और RLVR के विरुद्ध रखता है। जहाँ RLHF मानव रेटर्स को पसंद आने वाली चैट प्रतिक्रियाओं के लिए और RLVR ऐसे आउटपुट के लिए ऑप्टिमाइज़ करता है जिन्हें कोई प्रोग्राम सत्यापित कर सके, वहीं RLCD निर्णय कार्यों पर एपिस्टेमिक रूप से ईमानदार प्रायिकताओं के लिए ऑप्टिमाइज़ करता है। इसी कारण कैलिब्रेशन Jev की प्रथम-श्रेणी विशेषता है, न कि प्रॉम्प्टिंग के जरिए बाद में जोड़ी गई कोई चीज़।
यहाँ एक तालिका में मूल आर्किटेक्चरल अंतर है, क्योंकि गद्य में यह भिन्नता आसानी से खो जाती है।
| विशेषता | फ्रंटियर LLM (GPT-5.6, Opus 5) | Jev (System One मॉडल) |
|---|---|---|
| आउटपुट | जनरेटेड स्ट्रिंग्स, पार्सिंग की ज़रूरत | टाइप्ड वैल्यूज़, स्कीमा-गारंटीड |
| सैंपलिंग | सीक्वेन्शियल, एक समय में एक टोकन | पैरेलल, सिंगल क्वेरी |
| इनपुट मूल्य / 1M टोकन | $0.20–$10 | $0.042 |
| आउटपुट मूल्य | ~5x इनपुट | मुफ़्त |
| लेटेंसी | 3–329s | 70–500ms |
| हैलुसिनेशन / टाइप एरर | संभव | डिज़ाइन के अनुसार असंभव |
| कॉन्फिडेंस | ओवरकॉन्फिडेंट, असंगत | प्रति आउटपुट कैलिब्रेटेड |
यहाँ दी गई सभी विशेषताएँ एक डिज़ाइन विकल्प से निकलती हैं: Jev पूरी तरह स्ट्रिंग जनरेशन छोड़ देता है।
यही कमी इसे गति, कीमत और टाइप गारंटी दिलाती है।
Jev ऐसे टाइप-सेफ़ संरचित मान लौटाता है जिनके संभावित आउटपुट आपके स्कीमा में कॉल से पहले परिभाषित होते हैं।
API कुछ सीमित प्रश्न-प्रकार उजागर करता है:
इसे एक फ्रंटियर-इंटेलिजेंस फ़ंक्शन कॉल की तरह समझें: असंरचित स्टेट अंदर जाता है, टाइप किए हुए प्रायिकतात्मक निर्णय बाहर आते हैं।
यदि आप एक सपोर्ट टिकट रूट कर रहे हैं, तो आप {billing, technical, sales, spam} पर एक Choice और 0 से 100 तक तात्कालिकता के लिए एक Score परिभाषित कर सकते हैं, और Jev एक ही पास में दोनों भर देता है। कोई JSON पार्स करना नहीं, और न ही यह जोखिम कि मॉडल भटककर कोई पैराग्राफ लिख दे।
स्पष्ट चेतावनी यह है कि यह तभी काम करता है जब मान्य उत्तरों का दायरा सीमित हो और पहले से ज्ञात हो। Jev ओपन-एंडेड जनरेशन के लिए बेकार है, और यह आपके लिए स्कीमा नहीं लिखता।
हर Jev आउटपुट एक कैलिब्रेटेड प्रायिकता के साथ आता है, जिसका अर्थ है कि अधिक कॉन्फिडेंस वस्तुतः अधिक सटीकता से मेल खाता है।
मुझे लगता है कि व्यवहार में यही फीचर सबसे उपयोगी होगा।
मानक LLMs कुख्यात रूप से ओवरकॉन्फिडेंट होते हैं, भले ही आप उनसे स्पष्ट रूप से कोई प्रायिकता माँगें।
यदि कोई मॉडल 95% मामलों को सही वर्गीकृत कर सकता है लेकिन यह नहीं बता सकता कि किन 5% में वह अनिश्चित है, तो आप उसके आस-पास सुरक्षित रूप से ऑटोमेट नहीं कर सकते।
Jev का कैलिब्रेशन आपको एक कॉन्फिडेंस थ्रेशहोल्ड सेट करने देता है और उसी से ऊपर स्वतः कार्य करने देता है, जबकि अनिश्चित मामलों को किसी मानव या धीमे LLM की ओर रूट किया जा सकता है।
ध्यान देने योग्य सीमा यह है कि Jev आपको एक संख्या देता है, तर्क नहीं।
यह प्राकृतिक-भाषा में यह नहीं बताता कि किसी मामले को उसने वैसा स्कोर क्यों दिया, जो डीबगिंग और नियंत्रित डोमेन्स में ऑडिट के लिए मायने रखता है।
क्योंकि Jev के आउटपुट स्कीमा तक सीमित हैं, इसके लिए कोई अमान्य मान या टाइप एरर उत्पन्न करना गणितीय रूप से असंभव है।
TypeSafe 0% संरचित आउटपुट एरर रेट और 0% टूल कॉल एरर रेट की रिपोर्ट करता है।
तुलना के लिए, TypeSafe के संरचित आउटपुट टेस्ट में, OpenAI के luna और terra 0.58% पर थे, Anthropic का Opus 5 5.73% पर, और Claude Haiku 4.5 45.5% पर।
टूल कॉल्स में, GPT-5.6 Sol सबसे खराब 17.0% पर था।
किसी इंटरैक्टिव एजेंट में हैलुसिनेटेड टूल कॉल एक असुविधा है, लेकिन जब यह लेटेंसी गारंटी वाले डिपेंडेंसी चेन में कई परतों के भीतर दबी हो, तो यह एक वास्तविक समस्या है।
Jev अपना पूरा आउटपुट एक ही पैरेलल क्वेरी में जनरेट करता है, एक-एक टोकन कर एमिट करने के बजाय।
यहीं से 70–500ms की लेटेंसी आती है।
यह गति ऐसे उपयोग मामलों के दरवाज़े खोलती है जहाँ टोकन-बाय-टोकन LLMs नहीं पहुँच सकते।
TypeSafe के अपने डेमो में Jev संरचित गेम स्टेट (टेक्स्ट के रूप में उपलब्ध) पर प्रतिक्रिया देकर Doom खेलता है, लगभग प्रति सेकंड 10 बार, लगभग $7/घंटा इन्फ़रेंस पर।
मुद्दा यह नहीं कि Jev Doom अच्छा खेलता है—एक स्क्रिप्टेड बॉट उसे हरा देगा—बल्कि यह कि वह रीयल-टाइम लूप के भीतर रिएक्टिव निर्णय ले सकता है जहाँ 3–30 सेकंड का LLM कॉल अस्वीकार्य है।
प्रति-केस लगभग $0.0004 की Jev की लागत बड़े डेटासेट की हर पंक्ति पर निर्णय चलाना व्यवहार्य बनाती है—जो एक फ्रंटियर LLM के साथ लागत-निषेधात्मक होता।
TypeSafe इसे पेटाबाइट्स के कच्चे डेटा को उस पर मैप-रिड्यूस तरीके से निर्णय चलाकर फीचर्स और इनसाइट्स में बदलने के रूप में पेश करता है।
एक ठोस उदाहरण है 5 करोड़-पंक्ति वाली तालिका में हर उत्पाद समीक्षा को सेंटिमेंट और नीति उल्लंघन के लिए स्कोर करना—Jev की रिपोर्टेड दर पर यह निर्णय कॉल्स में लगभग $20 पड़ेगा, जबकि टोकन-बिल्ड LLM के साथ यह हज़ारों में जाएगा।
संक्षेप में, सटीकता पर Jev मोटे तौर पर मिड-टियर फ्रंटियर LLMs के बराबर आता है, जबकि लागत और लेटेंसी पर सबको एक-दो ऑर्डर ऑफ़ मैग्निट्यूड से पछाड़ता है।
नीचे दिए गए सभी आँकड़े TypeSafe की अपनी इवैल्युएशन तालिकाओं से आते हैं, और अभी तक कोई बड़े पैमाने पर स्वतंत्र पुनरुत्पादन सामने नहीं आया है, इसलिए इन्हें वेंडर-रिपोर्टेड मानें।
TypeSafe ने 4 वर्कफ़्लोज़ (सिक्योरिटी इंसीडेंट रिस्पॉन्स, एजेंट-ट्रेस ऑब्ज़र्वेबिलिटी, इनवॉइस प्रोसेसिंग, और कस्टमर सर्विस) पर एक कस्टम इवैल्युएशन बनाया, प्रत्येक मॉडल को GPT-6 Astra और Anthropic के Fable की औसत भविष्यवाणियों के विरुद्ध स्कोर किया।
Jev औसतन संदर्भ उत्तरों से 67.8% सहमति दर्ज करता है।
उसी वर्कफ़्लोज़ पर फ्रंटियर LLMs के मुकाबले यह ऐसे दिखता है:
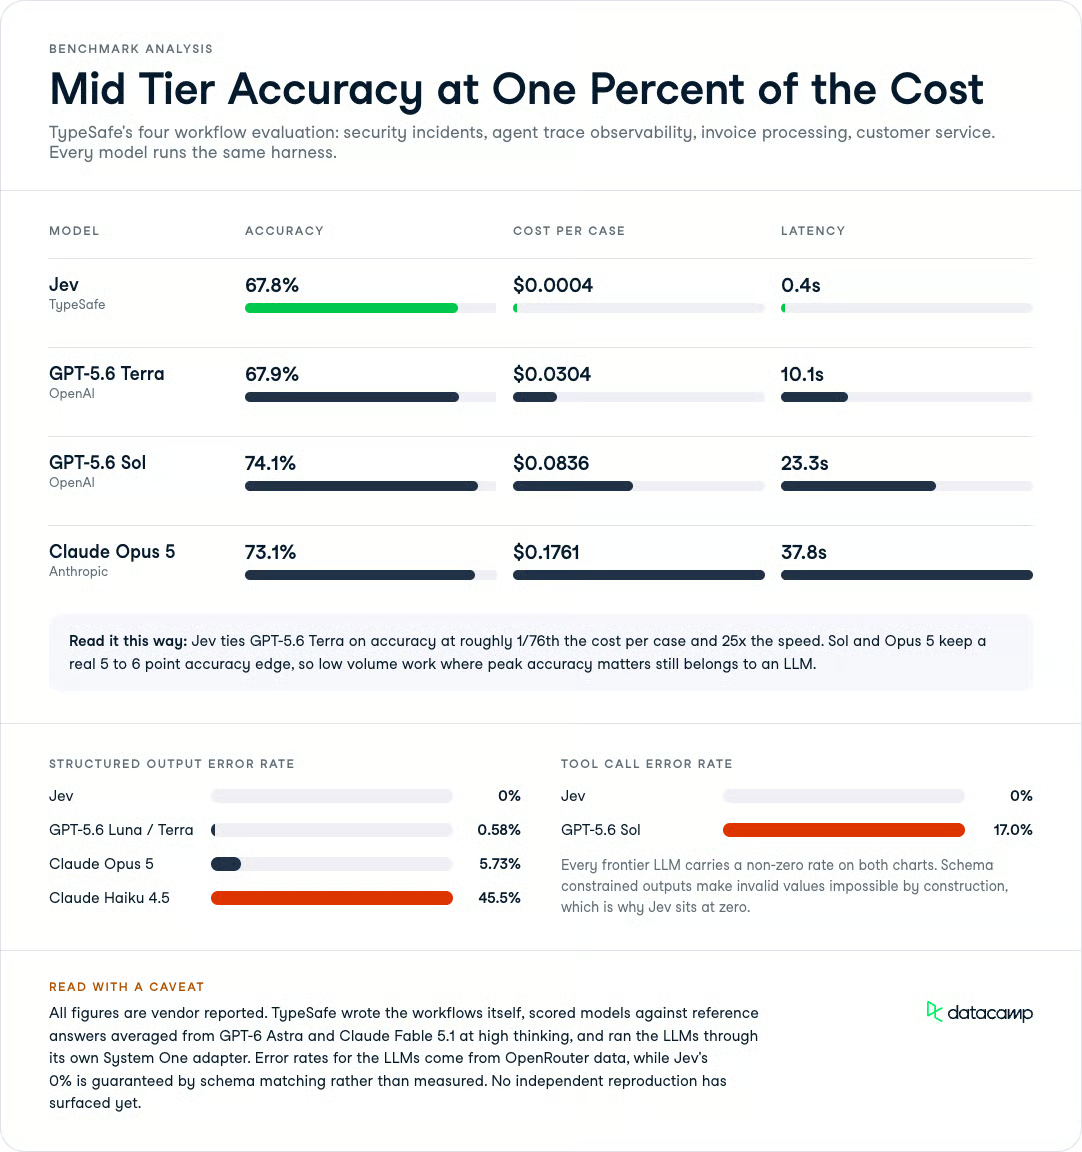
पैटर्न सुसंगत है: Jev सर्वोत्तम मॉडलों की तुलना में कुछ अंकों की सटीकता छोड़ता है और इसके बदले भारी लागत और लेटेंसी बचत देता है।
| मॉडल | सटीकता | प्रति केस लागत | लेटेंसी |
|---|---|---|---|
| Jev (TypeSafe) | 67.8% | $0.0004 | 0.4s |
| GPT-5.6 Terra | 67.9% | $0.0304 | 10.1s |
| GPT-5.6 Sol | 74.1% | $0.0836 | 23.3s |
| Claude Opus 5 | 73.1% | $0.1761 | 37.8s |
सटीकता पर Jev व्यावहारिक रूप से Terra के बराबर है, जबकि प्रति केस लगभग 1/76वीं लागत और 25x तेज़ चलन देता है।
शीर्ष-सटीकता वाले मॉडल—Sol 74.1% और Opus 5 73.1%—वास्तव में 5–6 अंकों की बढ़त बनाए रखते हैं, तो यदि कम-वॉल्यूम कार्य पर चरम सटीकता चाहिए, LLM अभी भी बेहतर है।
विश्वसनीयता चार्ट्स पर, संरचित आउटपुट और टूल कॉल दोनों में Jev 0% एरर पर बैठता है—जो स्कीमा-सीमित डिज़ाइन का मूल बिंदु है।
फ्रंटियर LLMs यहाँ सभी में कुछ-न-कुछ गैर-शून्य विफलता दर रखते हैं।
दो आँकड़े उभरकर आते हैं। Claude Haiku 4.5 45.5% संरचित आउटपुट एरर रेट दर्ज करता है, और GPT-5.6 Sol 17.0% टूल कॉल एरर रेट।
ये कोई दुर्लभ किनारे-के-केस नहीं हैं; ये ऐसे विफलताएँ हैं जो किसी अनअटेंडेड पाइपलाइन को वॉल्यूम पर चलते ही तोड़ देंगी।
Jev प्रायिकताएँ लौटाता है लेकिन कोई प्राकृतिक-भाषा तर्क नहीं, जिसे समीक्षक डीबगिंग और नियंत्रित डोमेन्स में ऑडिट के लिए एक वास्तविक बाधा के रूप में चिह्नित करते हैं।
यदि कोई कंप्लायंस टीम जानना चाहती है कि किसी लोन आवेदन को जैसा स्कोर मिला वैसा क्यों मिला, तो केवल कॉन्फिडेंस संख्या उन्हें संतुष्ट नहीं करेगी।
व्यावहारिक वर्कअराउंड यह है कि Jev को उच्च-वॉल्यूम रूटिंग लेयर के लिए आरक्षित रखें और फ़्लैग किए गए या कम-कॉन्फिडेंस मामलों को ऐसे मॉडल तक एस्केलेट करें जो लिखित व्याख्या दे सके।
इससे थ्रूपुट लाभ बने रहते हैं और जहाँ क़ानूनी रूप से आवश्यक हो वहाँ ऑडिट ट्रेल भी सुरक्षित रहता है।
TypeSafe अपनी खुद की इवैल्यूएशंस में पक्षपात के बारे में ताज़गीपूर्ण रूप से स्पष्ट है।
वर्कफ़्लोज़ इसके अपने मॉडल क्षमताएँ टीम ने लिखे, इसलिए कुछ पक्षपात हो सकता है, और संदर्भ उत्तर OpenAI और Anthropic मॉडलों से आते हैं, जो संभवतः Jev और DeepSeek के मॉडलों के सापेक्ष प्रदर्शन को कम आँकते हैं।
इन परीक्षणों में LLMs TypeSafe के ओपन-सोर्स System One एडेप्टर के माध्यम से चलते हैं, जो उन्हें API-संगत संरचित निर्णय देने के लिए बाध्य करता है।
TypeSafe का कहना है कि LLM से निर्णय निकालने का यह सबसे सटीक तरीका है, हालांकि यह प्रायिकताओं के बिना मॉडल को उत्तर देने देने की तुलना में धीमा और महँगा है।
जब तक कोई स्वतंत्र सूट इसे एक न्यूट्रल हार्नेस पर दोहराता नहीं, मैं सटीकता समानता को अंतिम नहीं बल्कि आशाजनक मानूँगा।
Jev GPT-5.6 या Opus 5 से उन्हीं नौकरियों के लिए प्रतिस्पर्धा नहीं कर रहा, इसलिए उपयोगी प्रश्न यह है कि किस वर्ग के मॉडल को चुनना है।
बँटवारा इस पर आता है कि आपका कार्य सीमित निर्णय चाहता है या ओपन-एंडेड उत्तर।
| उपयोग का मामला | किसे चुनें | क्यों |
|---|---|---|
| लाखों टिकट्स का वर्गीकरण या रूटिंग | Jev | सीमित आउटपुट, लागत और थ्रूपुट प्रमुख |
| स्केल पर LLM आउटपुट का स्कोरिंग या गार्डरेलिंग | Jev | तेज़ हाँ/ना प्रायिकताएँ, हैलुसिनेशन का जोखिम नहीं |
| किसी ऐप लूप के भीतर रीयल-टाइम निर्णय | Jev | LLM के 3–30s के मुकाबले 70–500ms लेटेंसी |
| कोड, ईमेल, या सारांश लिखना | फ्रंटियर LLM | Jev बिल्कुल भी टेक्स्ट जनरेट नहीं करता |
| लिखित व्याख्या के साथ एकबारगी बहु-चरणीय तर्क | फ्रंटियर LLM | तर्क और ओपन-एंडेड आउटपुट चाहिए |
व्यवहार में, दोनों अच्छी तरह साथ काम करते हैं: Jev को तेज़ निर्णय लेयर के रूप में उपयोग करें जो वर्गीकृत, स्कोर और रूट करे, और कठिन या ओपन-एंडेड मामलों के छोटे हिस्से को Terra या Opus 5 जैसे मॉडल को सौंप दें। Jev का कैलिब्रेशन उस हैंडऑफ़ को साफ़ बनाता है, क्योंकि आप कॉन्फिडेंस थ्रेशहोल्ड पर रूट कर सकते हैं।
कीमत के मोर्चे पर Jev का पिच आक्रामक है।
इनपुट टोकन प्रति मिलियन $0.042 (प्रति बिलियन $42) पड़ते हैं, और आउटपुट टोकन अनमीटर्ड और मुफ़्त हैं—TypeSafe के अनुसार इतने सस्ते कि मापना ही नहीं पड़ता, क्योंकि मॉडल लंबा टेक्स्ट लौटाने के बजाय संरचित निर्णय लौटाता है।
मापदंड के लिए, यह इनपुट दर GPT-5.6 Terra के प्रति मिलियन इनपुट टोकन $2.00 की दर की लगभग 1/48वीं है, और Terra इसके ऊपर प्रति मिलियन आउटपुट टोकन $12.00 भी बिल करता है।
वर्कफ़्लो स्तर पर, TypeSafe के आंतरिक इवैल्युएशंस Jev को प्रति केस लगभग $0.0004 पर रखते हैं, जबकि Terra के लिए $0.0304 और Sol के लिए $0.0836 है।
TypeSafe स्पष्ट है कि वह यह सिद्ध नहीं कर सकता कि कीमतें सब्सिडाइज़्ड नहीं हैं, और कहता है कि दीर्घकाल में स्थिरता स्वयं सिद्ध करनी होगी—हालाँकि उसे उम्मीद है कि कीमतें बढ़ेंगी नहीं बल्कि घटेंगी।
Jev 15 सितंबर, 2026 से अर्ली एक्सेस में है, एक वेटलिस्ट के पीछे, जहाँ डेवलपर्स को समय के साथ हटाकर अंदर लाया जा रहा है। मुझे लॉन्च सामग्रियों में कोई स्पष्ट फ्री-क्रेडिट या ट्रायल कार्यक्रम नहीं दिखा।
Jev एक स्वामित्व वाला, होस्टेड मॉडल है जो TypeSafe के HTTP API के माध्यम से उपलब्ध है। हालाँकि, एक्सेस पाने के लिए, आपको वेटलिस्ट में शामिल होना होगा और TypeSafe AI Blog पर समुदाय की जाँच करनी होगी।
एंडपॉइंट है POST https://api.typesafe.ai/v1/systemone, और अर्ली-एक्सेस मॉडल रूट jev-latest के रूप में संदर्भित है।
TypeSafe रॉ HTTP API के साथ Python और JavaScript के लिए आधिकारिक SDKs प्रदान करता है।
आप अपने प्रश्न-प्रकार (Choice, Score, Noul) स्कीमा में परिभाषित करते हैं और अपने प्रोग्राम स्टेट को इनपुट के रूप में पास करते हैं; प्रतिक्रिया टाइप किए हुए मानों के रूप में कैलिब्रेटेड प्रायिकताओं के साथ वापस आती है।
सर्वरलेस रूट के विरुद्ध अनुरोध का न्यूनतम आकार इस प्रकार है:
import requests

response = requests.post(
    "https://api.typesafe.ai/v1/systemone",
    headers={"Authorization": "Bearer YOUR_KEY"},
    json={
        "model": "jev-latest",
        "state": "Customer emailed twice this week about a failed refund...",
        "questions": {
            "category": {"type": "choice", "options": ["billing", "technical", "sales"]},
            "urgency": {"type": "score", "min": 0, "max": 100},
        },
    },
)
print(response.json())
पूर्ण स्कीमा संदर्भ और SDK सेटअप के लिए, TypeSafe के अपने दस्तावेज़ ही प्रामाणिक स्रोत हैं।
TypeSafe यह रणनीतिक दांव लगा रहा है कि लोग आज जो बहुत-सी चीज़ें LLMs से करवाते हैं, वे वास्तव में चैट की आड़ में संरचित निर्णय-निर्माण ही हैं।
यदि यह सही है, तो Jev का 40–400x लागत लाभ और 0% टाइप-एरर गारंटी उच्च-वॉल्यूम ऑटोमेशन के अर्थशास्त्र को ऐसे रीसेट करती है जैसा GPT-5.6 और Opus 5 कीमत पर मैच नहीं कर सकते।
मेरा ईमानदार आकलन है कि Jev तेज़ निर्णय और गार्डरेल लेयर के रूप में वास्तव में उपयोगी लगता है, और कैलिब्रेशन वह हिस्सा है जिसके इर्द-गिर्द मैं सच में निर्माण करूँगा।
खुले प्रश्न यह हैं कि क्या कोई स्वतंत्र बेंचमार्क सटीकता समानता की पुष्टि करता है और क्या सब्सिडी हटने के बाद भी कीमतें टिकाऊ रहती हैं।
यदि आप उन निर्णय समस्याओं को समझना चाहते हैं जिनके लिए Jev बनाया गया है, तो हमारा AI Fundamentals स्किल ट्रैक इसके अंतर्निहित वर्गीकरण और कैलिब्रेशन अवधारणाओं को कवर करता है।
शीर्ष DataCamp पाठ्यक्रम
कोर्स
कोर्स
कोर्स