
Last chance! 50% off DataCamp Premium
Sale ends in
मैं पहले ही बता चुका/चुकी हूँ कि अपेक्षाएँ मॉडल से मेल खानी चाहिए। Jev के मामले में यह खास तौर पर सही है, और यह मुख्यतः उसके मॉडल वर्ग—जिसे System One मॉडल कहा जाता है—से जुड़ा है।
एक System One मॉडल टेक्स्ट के बजाय टाइप्ड निर्णय लौटाता है। आप स्टेट का एक ब्लॉक और प्रश्नों का एक सेट भेजते हैं, जिनमें से प्रत्येक का उत्तर-स्थान आप परिभाषित करते हैं, और मॉडल प्रत्येक प्रश्न के लिए संभाव्यताओं के साथ एक उत्तर लौटाता है। कुछ भी टोकन-बाय-टोकन उत्पन्न नहीं होता, इसलिए कोई स्ट्रिंग पार्स करने या खराब JSON सुधारने की जरूरत नहीं। TypeSafe ने यह शब्द डैनियल काह्नमैन के प्रसिद्ध विभाजन के सन्दर्भ में गढ़ा है:
क्योंकि उत्तर-स्थान एक स्कीमा है जिसे आपका कोड डिक्लेयर करता है, System One मॉडल डिज़ाइन के मुताबिक कभी भी कोई ऐसा वर्ग नहीं लौटा सकते जो आपने परिभाषित न किया हो। इसका मतलब यह है कि वे स्कीमा से बाहर नहीं जा सकते। फिर भी, वे गलत हो सकते हैं—और हम आगे कुछ पेचीदा मामलों में जाएँगे।
TypeSafe ने 15 सितंबर, 2026 को Jev को अर्ली एक्सेस में रखते हुए स्टेल्थ से बाहर कदम रखा, 70 से 500 ms प्रतिक्रियाएँ और प्रति मिलियन इनपुट टोकन $0.042 की कीमत, आउटपुट फ्री होने की रिपोर्टिंग के साथ। अपने चार-वर्कफ़्लो बेंचमार्क पर, Jev लगभग 68% सटीकता पर आता है—मिड-टियर LLM क्षेत्र, लागत के एक छोटे से हिस्से पर।
फीचर्स और बेंचमार्क प्रदर्शन पर अधिक जानकारी के लिए, हमारा Jev गाइड पढ़ने की सलाह देता/देती हूँ।
कॉल करने से पहले मान्य उत्तर लिख लें। यदि आप उन्हें गिना सकते हैं, तो आपके पास Jev-आकार की समस्या है:
जब आउटपुट गद्य या कोड हो, जब उत्तर-स्थान खुला हो, या जब कार्य को कई चरणों की चेन की गई तर्क-वितर्क की ज़रूरत हो—तो LLM चुनें। संख्यात्मक किसी भी चीज़ के लिए भी Jev गलत टूल है—और मैं आगे बताऊँगा क्यों।
कोड लिखने से पहले, एक TypeSafe खाता बनाएँ और Playground खोलें। यहाँ, आप स्टेट के रूप में टेक्स्ट पेस्ट कर सकते हैं, प्रश्न जोड़ सकते हैं, और बिना कुछ इंस्टॉल किए पूरे उत्तर ऑब्जेक्ट देख सकते हैं। यह समझने का सबसे तेज़ तरीका है कि हर प्रश्न प्रकार क्या लौटाता है (और यह जानने का भी कि आपका प्रश्न खराब ढंग से लिखा गया है या नहीं)।
मैं तीनों उदाहरणों के लिए एक ही सपोर्ट टिकट को स्टेट के रूप में इस्तेमाल करूँगा:
Export to CSV has been broken since Friday.
It works in Chrome, but half our team is on Safari and they can't pull reports at all.
We have a board meeting Thursday.
हर प्रश्न प्रकार instructions लेता है—वह साधारण-भाषा का प्रश्न जिसका उत्तर आप चाहते हैं। इनके बीच जो बदलता है वह है criteria—और जो वापस आता है।
एक Choice आपके द्वारा परिभाषित सेट से एक विकल्प चुनता है।
आप criteria को एक डिक्शनरी ऑब्जेक्ट के रूप में पास करते हैं, जो प्रत्येक विकल्प को एक विवरण से मैप करता है—1 से 255 तक—और उत्तर में यह लौटता है:
{
  "department": {
    "type": "choice",
    "instructions": "Which queue should own this ticket?",
    "criteria": {
      "bug_triage": "A defect in a specific feature, reproducible, goes into the backlog",
      "incident_response": "A live breakage affecting multiple users right now, needs a responder today",
      "customer_success": "The account needs managing, not the code"
    }
  }
}
API के जरिए आपको मिलने वाले कोड आउटपुट को देखने के लिए, ऊपर दाईं ओर </> बटन पर क्लिक करें, और Run पर क्लिक कर Jev को प्रश्न का उत्तर देने दें।
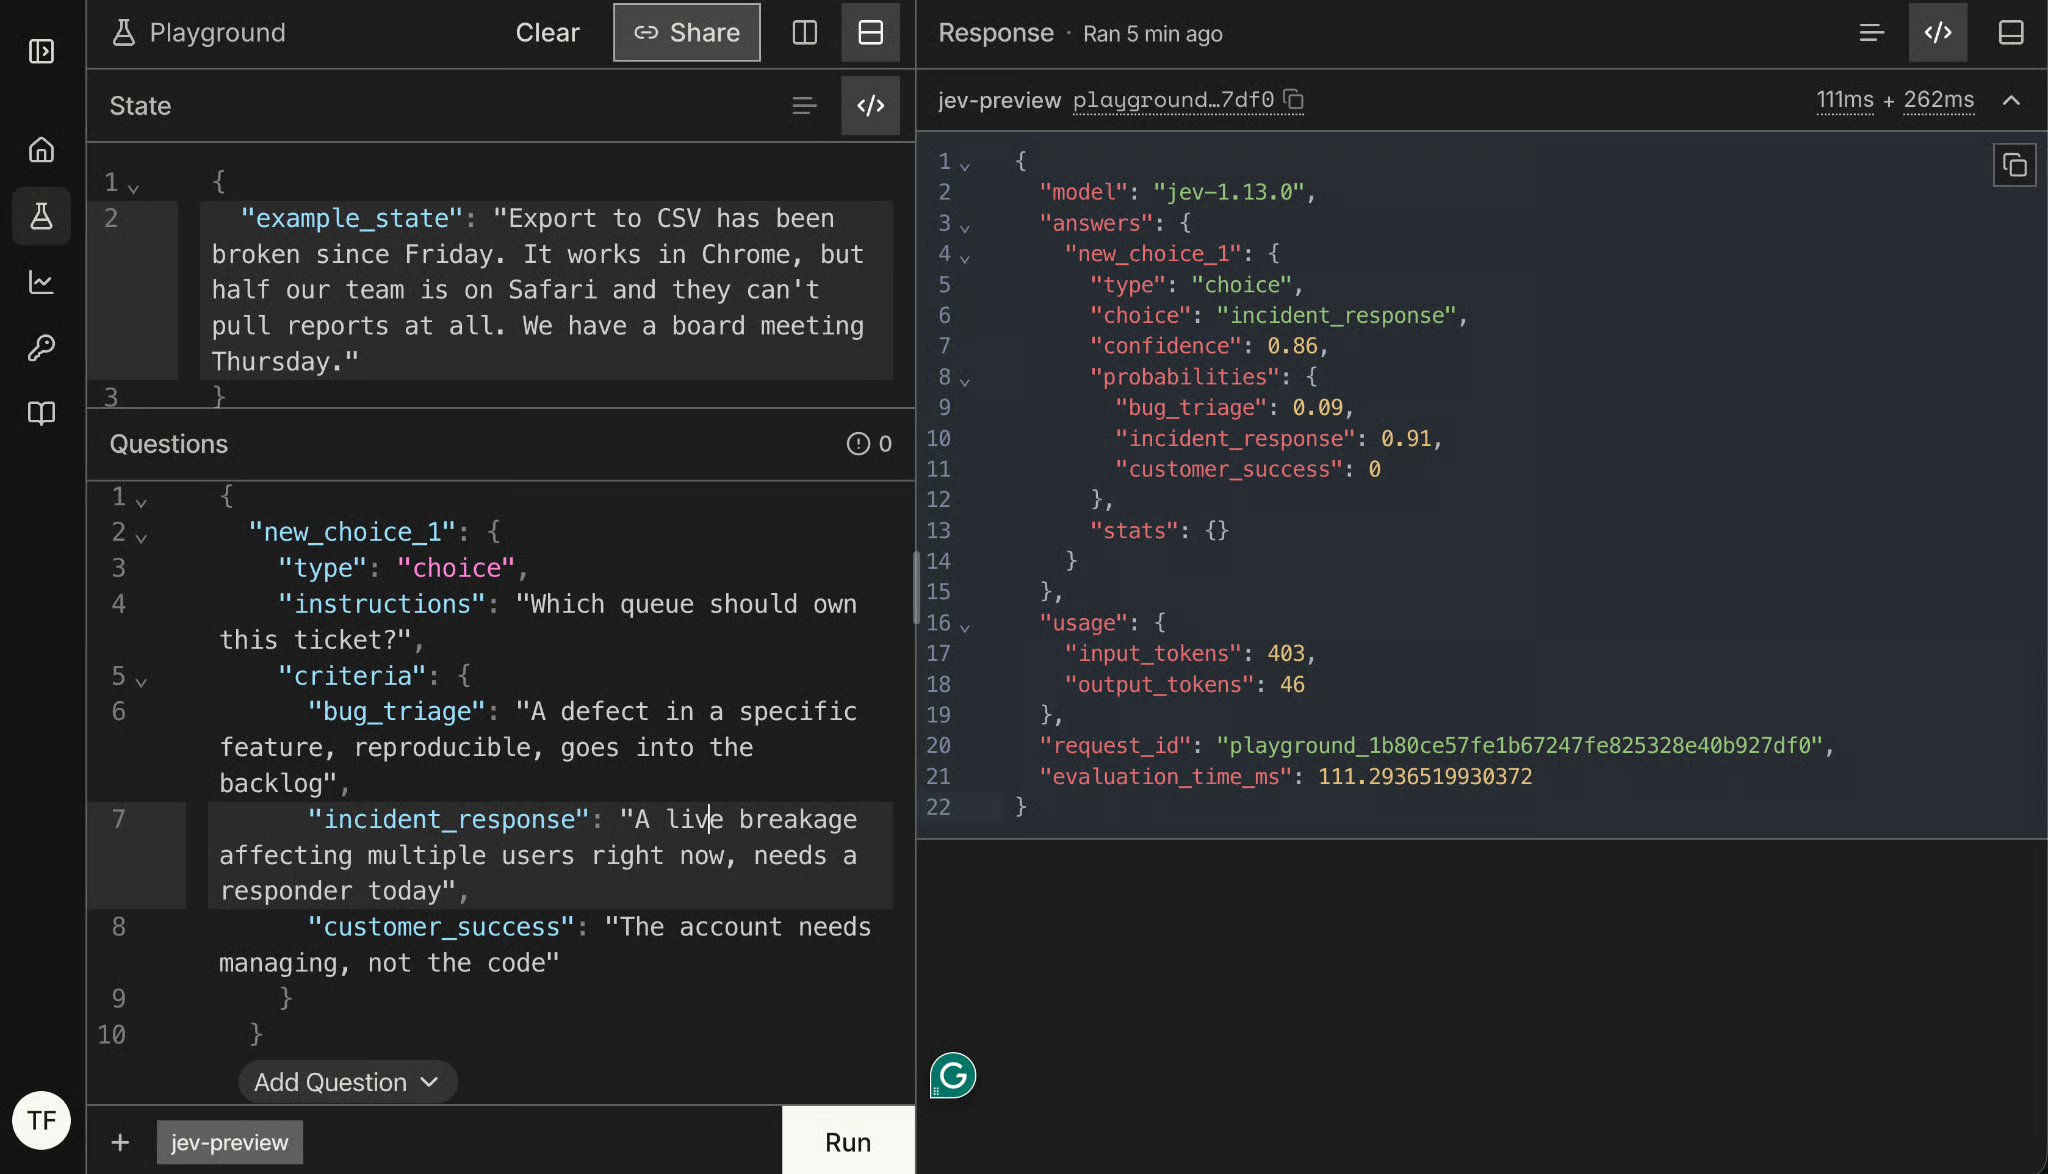
इस मामले में, incident_response 91% संभावना के साथ choice है। Jev का confidence इस चयन के लिए 86% है।
पूरी वितरण ही वह हिस्सा है जिस पर आपका ध्यान होना चाहिए।
choice केवल बताता है कि कौन-सा विकल्प जीता।
probabilities बताता है कि कितने अंतर से।
जब आप किसी टिकट को स्वतः रूट करने जा रहे हों, तो ये अलग जानकारियाँ होती हैं। 0.41/0.38/0.21 और हमारे मिले 0.91/0.09/0 जैसे स्प्लिट दोनों ही एक जैसा choice लौटा सकते हैं।
Score स्टेट को क्रमबद्ध स्तरों के विरुद्ध रेट करता है। आप criteria को array के रूप में पास करते हैं—2 से 10 स्तर-विवरण, सबसे कम पहले—और उत्तर में एक स्कोर, legend (जो प्रत्येक पोज़ीशन को आपके विवरण से मैप करता है), प्रति स्तर संभावना, और कॉन्फिडेंस शामिल होते हैं।
{
  "goodwill_risk": {
    "type": "score",
    "instructions": "How much patience does this customer have left?",
    "criteria": [
      "Reporting a problem, no sign of frustration",
      "Mildly annoyed, still collaborative",
      "Visibly out of patience, mentions the cost to their work",
      "At the point of escalating over our heads or leaving"
    ]
  }
}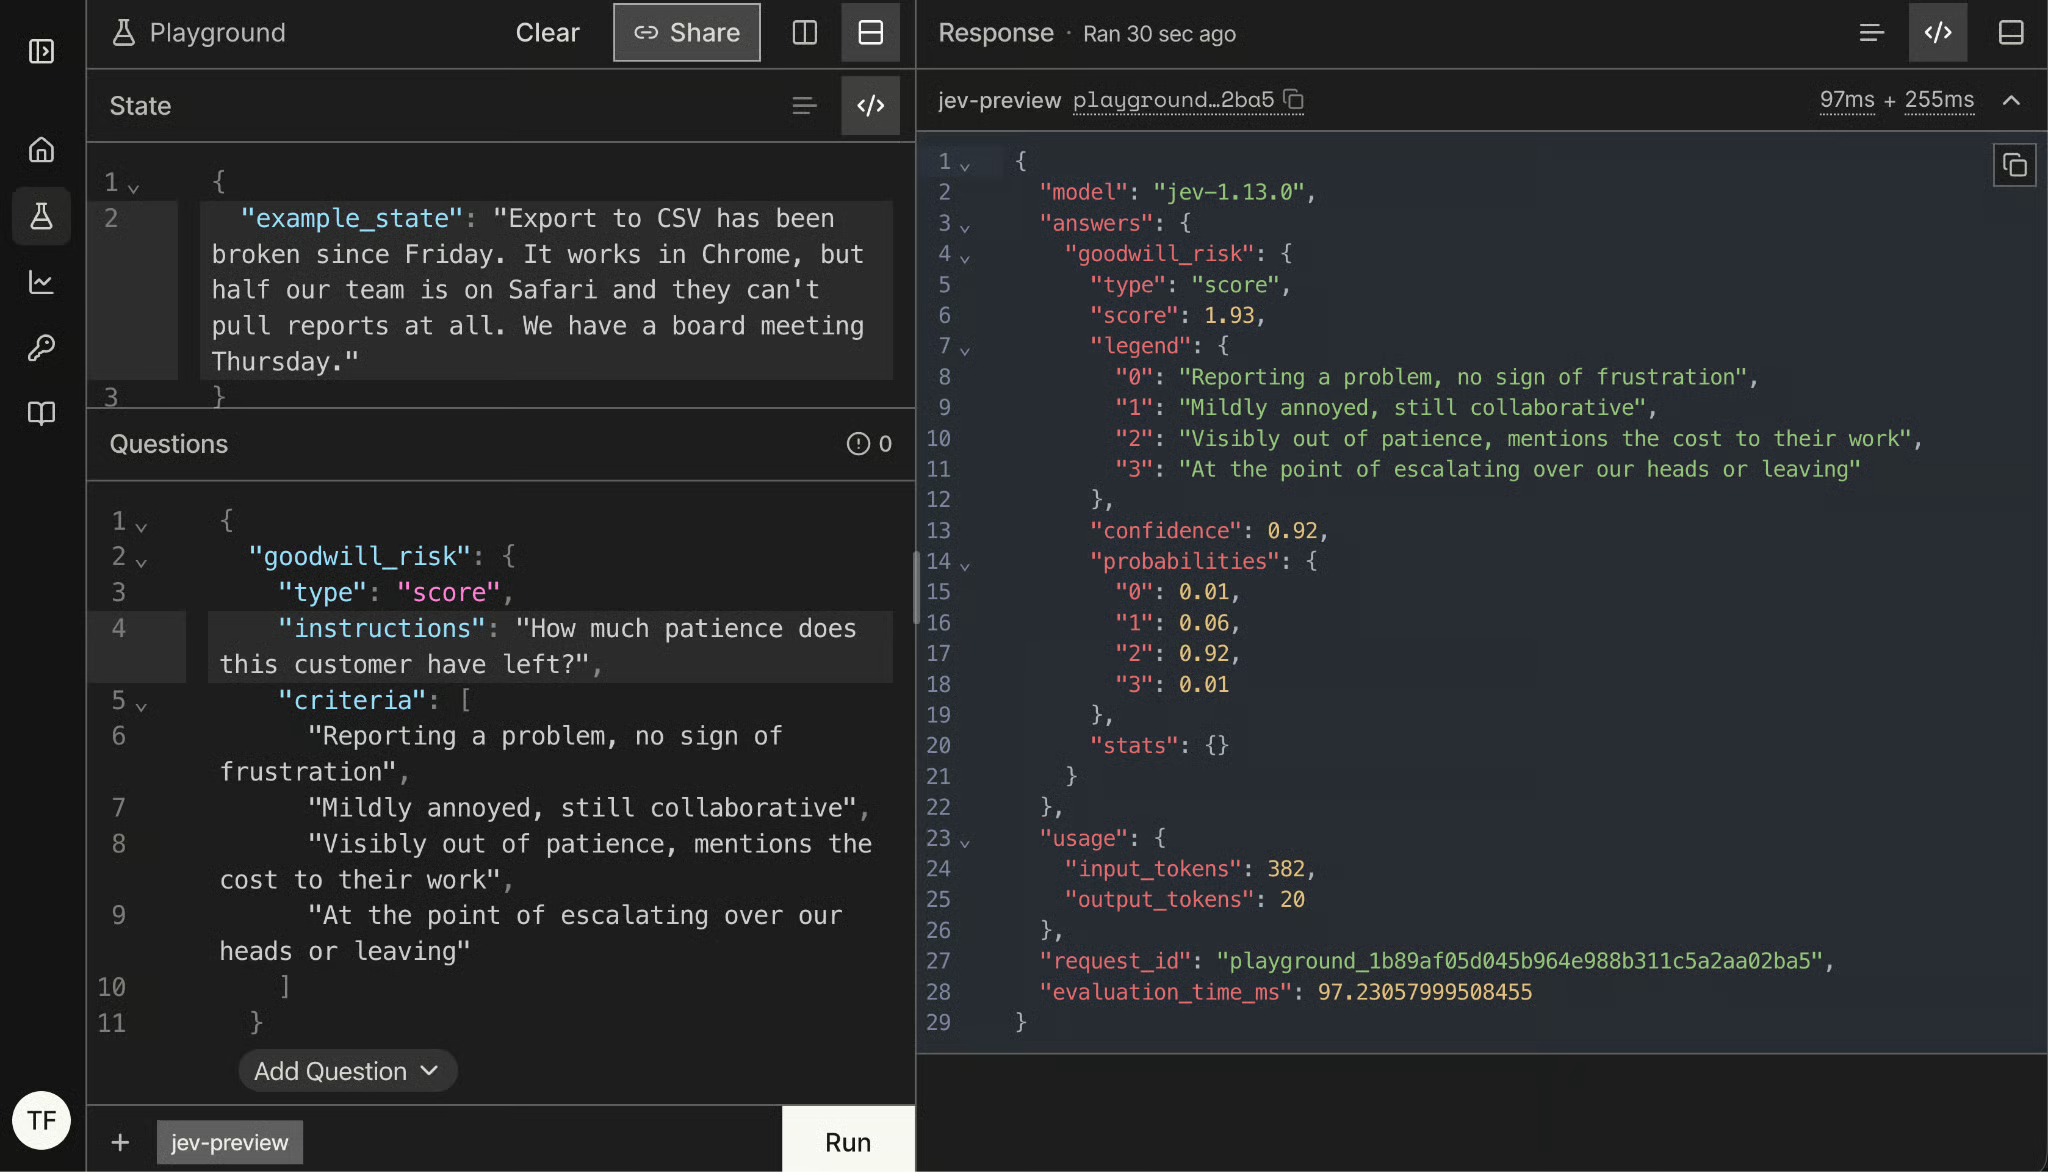
स्कोर आपके स्तरों के बीच भी आ सकता है, और यही legend का मकसद है। यहाँ 1.93 का score मतलब है कि मॉडल "हल्का झुंझलाया" और "स्पष्ट रूप से धैर्य खो चुका" के बीच बँटा हुआ है, और बाद वाले की ओर काफ़ी झुका है—जो ऐसे टिकट का उचित पाठ है जो विनम्र बना रहता है पर एक डेडलाइन बताता है जो छूटने वाली है।
फिर से, अकेले संख्या के बजाय probabilities का फैलाव पढ़ें: एक स्तर पर केंद्रित संभावना का मतलब निर्णायक उत्तर है; तीन स्तरों में फैली संभावना का मतलब है कि आपको फ़ैसले के बजाय औसत मिला।
Noul बाइनरी प्रश्नों के लिए प्रकार है, और यह नाम TypeSafe ने गढ़ा है। यहाँ criteria वैकल्पिक है, यद्यपि आप यह वर्णित कर सकते हैं कि true और false से आपका क्या तात्पर्य है—जब भी "हाँ" दो तरीकों से पढ़ा जा सकता हो, यह करना उपयोगी है।
प्रश्न को इस तरह लिखें कि उच्च मान का मतलब हाँ हो। TypeSafe के दस्तावेज़ इस बारे में साफ़ हैं, और ऐसा Noul जिसमें true "ना" से मैप होता है, मापनीय रूप से बदतर प्रदर्शन करता है।
{
  "is_time_sensitive": {
    "type": "noul",
    "instructions": "The customer names a specific deadline",
    "criteria": {
      "true": "A date, day, or event the work must be done before",
      "false": "Urgency is implied but no deadline is given"
    }
  }
}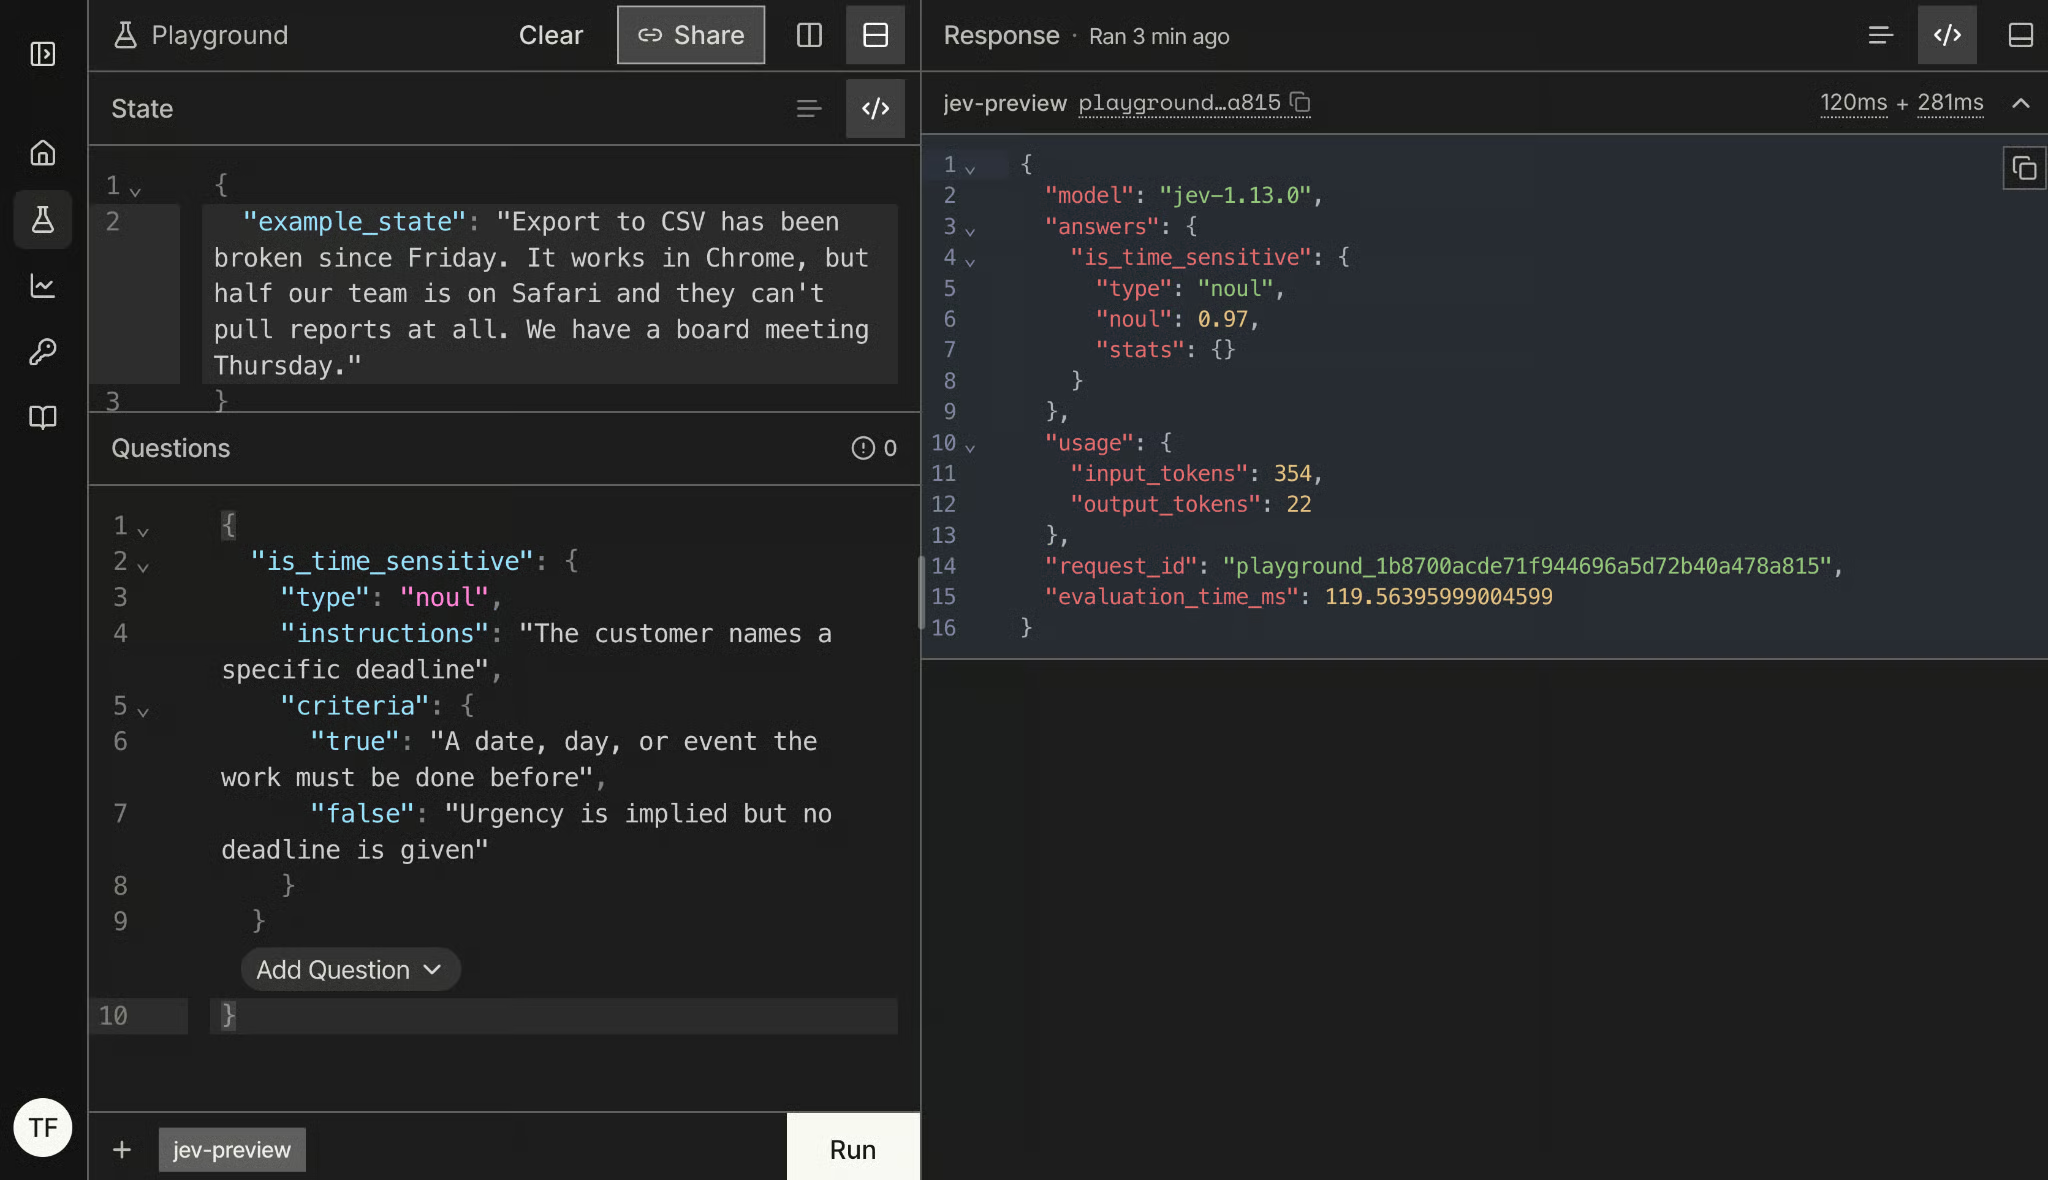
क्योंकि स्टेट में गुरुवार को बोर्ड मीटिंग का उल्लेख है, 0.97 का उच्च noul मान अपेक्षित था।
Choice और Score अपनी संभाव्यताओं के साथ confidence भी लौटाते हैं। Noul नहीं लौटाता, और यह लोगों को उलझाता है, इसलिए इसके कारण पर सटीक होना चाहिए।
Confidence और probability अलग अक्ष हैं। Choice के लिए, probabilities बताती हैं कि मॉडल आपके विकल्पों में विश्वास कैसे बांटता है, और confidence बताता है कि वह उत्तर कितना दृढ़ है—इसीलिए एक Choice 0.85 टॉप विकल्प के साथ 0.78 का confidence लौटा सकता है। Noul के केवल दो परिणाम होते हैं, इसलिए वह एकल संभावना पहले से ही दोनों वहन करती है: 0.97 एक पक्का हाँ है, 0.03 एक पक्का ना है, और 0.52 मॉडल का यह बताना है कि उसे कुछ पता नहीं।
इसका मतलब 0.5 से दूरी आपकी निर्णायकता का संकेत है, कोई अलग फ़ील्ड नहीं जिसे पढ़ना हो। इसका यह भी मतलब है कि आप Noul से निकला थ्रेशहोल्ड Choice पर पोर्ट नहीं कर सकते—और मैं इस पर आगे जग्डनेस खंड में लौटूँगा, क्योंकि यह सुनने में जितना लगता है उससे ज़्यादा चोट करता है।
साथ चलने के लिए आपको केवल Python 3.10+ और एक TypeSafe अर्ली-एक्सेस की चाहिए।
SDK इंस्टॉल करें:
pip install typesafe-sdkया uv के साथ:
uv add typesafe-sdkफिर TypeSafe कंसोल में एक की बनाएँ और उसे एक्सपोर्ट करें। क्लाइंट वातावरण से TYPESAFE_API_KEY पढ़ता है, इसलिए आप इसे कोड में कभी पास नहीं करते:
export TYPESAFE_API_KEY="your-key"निम्न आयात आपको playground की सारी चीज़ें दे देते हैं:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

client = TypeSafeClient()Choice, Noul, और Score वही प्रश्न प्रकार हैं जिन पर आपने अभी क्लिक किया, Python ऑब्जेक्ट्स के रूप में।
TypeSafeClient सिंक्रोनस क्लाइंट है, और यदि आप async सर्विस से Jev को कॉल कर रहे हैं तो उसी इंटरफ़ेस वाला AsyncTypeSafeClient भी है। दोनों कॉन्टेक्स्ट मैनेजर की तरह काम करते हैं, जो मैं स्क्रिप्ट से लंबे किसी भी काम में इस्तेमाल करूँगा/करूँगी:
with TypeSafeClient() as client:
...यूँ ही छोड़ देने पर, क्लाइंट jev-latest को कॉल करता है, जो तब बदलता रहता है जब भी TypeSafe नया संस्करण शिप करता है—यही हम इस ट्यूटोरियल में उपयोग करेंगे। जहाँ भी आपने कोई थ्रेशहोल्ड ट्यून कर लिया हो, वहाँ संस्करण को पिन करें:
client = TypeSafeClient(model="jev-1.13.0")रेस्पॉन्स आपको हर हाल में बताएगा कि वास्तव में किस मॉडल ने उत्तर दिया, और अंत के नज़दीक एक अनुभाग है कि आपको यह लॉग क्यों करना चाहिए।
Jev को API कॉल करने के लिए, आपको TypeSafeClient और system_one() फ़ंक्शन का उपयोग करके एक response आइटम परिभाषित करना होगा, जो आपके प्रश्नों का संदर्भ state पैरामीटर के रूप में लेता है, और स्वयं questions को playground जैसे ही फ़ॉर्मेट में।
हम एक ही कॉल बना सकते हैं जो हमारे सभी 3 playground प्रश्नों का उत्तर दे—क्योंकि वे एक ही state साझा करते हैं:
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient

ticket = (
    "Export to CSV has been broken since Friday. It works in Chrome, "
    "but half our team is on Safari and they can't pull reports at all. "
    "We have a board meeting Thursday."
)

with TypeSafeClient() as client:
    response = client.system_one(
        state=ticket,
        questions={
            "queue": Choice(
                instructions="Which queue should own this ticket",
                criteria={
                    "bug_triage": "A defect in a specific feature, reproducible, goes into the backlog",
                    "incident_response": "A live breakage affecting multiple users right now, needs a responder today",
                    "customer_success": "The account needs managing, not the code",
                },
            ),
            "goodwill_risk": Score(
                instructions="How much patience does this customer have left",
                criteria=[
                    "Reporting a problem, no sign of frustration",
                    "Mildly annoyed, still collaborative",
                    "Visibly out of patience, mentions the cost to their work",
                    "At the point of escalating over our heads or leaving",
                ],
            ),
            "is_time_sensitive": Noul(
                instructions="The customer names a specific deadline",
                criteria={
                    "true": "A date, day, or event the work must be done before",
                    "false": "Urgency is implied but no deadline is given",
                },
            ),
        },
    )
उत्तर उन्हीं नामों के तहत वापस आते हैं जो आपने प्रत्येक प्रश्न के लिए चुने थे—यही वह बारीकी है जो पूरे काम को सुखद बनाती है:
print(response.model)
print(response.answers["queue"].choice, response.answers["queue"].confidence)
print(response.answers["goodwill_risk"].score)
print(response.answers["is_time_sensitive"].noul)
jev-1.13.0
Incidence_response 0.95
1.95
0.97यदि आपकी पहली कॉल output_buffer_limit से जुड़े TypeError के साथ फेल होती है: यह SDK के कंप्रेशन बैकएंड में एक संस्करण मिसमैच है, आपका कोड नहीं। SDK अपना HTTP क्लाइंट httpx2 शिप करता है, जो zstandard और brotli के जरिए रेस्पॉन्स डिकंप्रेस करता है, और इनमें से किसी एक की पुरानी प्रति में वह आर्ग्युमेंट नहीं है जिसके साथ उसे कॉल किया जाता है। pip install -U typesafe-sdk httpx2 zstandard brotli ने मेरे लिए इसे साफ़ किया।
उस आउटपुट में दो बातें ठहरकर देखने लायक हैं।
पहली, response.model ने jev-latest नहीं, jev-1.13.0 लौटाया। आपने मूविंग उपनाम माँगा था और Jev ने आपको बताया कि वास्तव में किस संस्करण ने उत्तर दिया—यही वजह है कि उस फ़ील्ड को लॉग करना सस्ता और सार्थक है।
दूसरी, उत्तर ऑब्जेक्ट प्रश्न प्रकार के अनुसार टाइप्ड होते हैं, इसलिए .choice, .score, और .noul वास्तविक एट्रिब्यूट हैं और आपका एडिटर उनके बारे में जानता है। इस कोड में कहीं भी JSON स्ट्रिंग नहीं है, कुछ पार्स नहीं करना, और कोई ऐसी शाखा नहीं जहाँ कॉल खराब होकर लौटा हो। यदि आप ग्रुपिंग पसंद करते हैं, तो SDK response.choices, response.scores, और response.nouls भी देता है, वही कुंजियाँ रखते हुए।
response.usage भी देखें:
print(response.usage.input_tokens, response.usage.output_tokens)524
78आउटपुट टोकन एकल अंकों में होते हैं और फ्री हैं। आप स्टेट और प्रश्नों के लिए भुगतान करते हैं, इसलिए आप कितनी संदर्भ-सामग्री भेजते हैं यह तय करके लागत को पूरी तरह नियंत्रित कर सकते हैं। यह दिखने से ज़्यादा मायने रखता है, और यह फिर जग्डनेस खंड में आएगा: फूला हुआ स्टेट आपको एक साथ पैसे और सटीकता—दोनों—की लागत देता है।
यह उन उपयोग मामलों में से एक है जिनके लिए Jev बना है। एक सपोर्ट टिकट आता है, और किसी चीज़ को यह तय करना होता है कि यह किस कतार में जाएगा, क्या पहले किसी मानव को इसे देखना चाहिए, और कितनी जल्दी। इनमें से हर एक ऐसा निर्णय है जिसका उत्तर-स्थान आप टिकट के आने से पहले लिख सकते हैं।
शुरू में ही बताने लायक डिज़ाइन नियम: Jev तय करता है क्या है; आपका कोड तय करता है आगे क्या होगा। Jev कभी कुछ रूट नहीं करता। यह संख्याएँ लौटाता है, और रूटिंग एक सामान्य फ़ंक्शन में रहती है जिसे आप पढ़ सकते हैं, टेस्ट कर सकते हैं, और मॉडल को छुए बिना बदल सकते हैं।
एक ही अनुरोध में प्रश्न समानांतर आंके जाते हैं, इसलिए छठवाँ प्रश्न बस उसके टोकन की कीमत जोड़ता है और लगभग कोई अतिरिक्त लेटेंसी नहीं। यह पूछने का तरीका बदल देता है। LLM के साथ आप राउंड-ट्रिप समय बचाने के लिए सावधानी से बैच करते हैं, पर यहाँ आप किसी संदर्भ के बारे में वह सब कुछ पूछते हैं जो आप चाह सकते हैं—उन प्रश्नों सहित जिनके उत्तर आप शायद अनदेखा करेंगे।
आइए अपने पिछले प्रश्नों का विस्तार तीन और Noul से करें जो यह तय करने में महत्त्वपूर्ण सूचना देते हैं कि टिकट को कैसे संभालना है:
QUESTIONS = {
    "queue": Choice(
        instructions="Which queue should own this ticket",
        criteria={
            "bug_triage": "A defect in a specific feature, reproducible, goes into the backlog",
            "incident_response": "A live breakage affecting multiple users right now, needs a responder today",
            "customer_success": "The account needs managing, not the code",
        },
    ),
    "goodwill_risk": Score(
        instructions="How much patience does this customer have left",
        criteria=[
            "Reporting a problem, no sign of frustration",
            "Mildly annoyed, still collaborative",
            "Visibly out of patience, mentions the cost to their work",
            "At the point of escalating over our heads or leaving",
        ],
    ),
    "is_time_sensitive": Noul(
        instructions="The customer names a specific deadline",
        criteria={
            "true": "A date, day, or event the work must be done before",
            "false": "Urgency is implied but no deadline is given",
        },
    ),
    "has_reproduction": Noul(
        instructions="The ticket contains enough detail to reproduce the problem",
    ),
    "mentions_money": Noul(
        instructions="The customer mentions lost revenue, refunds, or cancelling",
    ),
    "is_automated": Noul(
        instructions="This ticket is a machine-generated notification, not a person writing in",
    ),
}

with TypeSafeClient() as client:
    response = client.system_one(state=ticket, questions=QUESTIONS)
छह प्रश्न—एक ही कॉल और एक ही बिल में सभी का उत्तर। is_automated अनुमान वाला है: यह लगभग हर वास्तविक टिकट पर false होता है, फिर भी यह पूछने लायक है क्योंकि जिस एक बार यह true होगा, वह किसी व्यक्ति को मेलर डेमन बाउंस खोलने से बचा देगा।
यहाँ मैं दो आदतें अपनाऊँगा/अपनाऊँगी।
प्रश्न सेट को इनलाइन बनाने के बजाय मॉड्यूल-लेवल कॉन्स्टेंट रखें, क्योंकि यही वह चीज़ है जिसे आप अपने थ्रेशहोल्ड्स के साथ वर्ज़न करेंगे।
और प्रश्नों का नाम इस आधार पर रखें कि वे क्या नापते हैं, न कि आप उत्तर के साथ क्या करेंगे—क्योंकि is_time_sensitive नीति बदलने पर भी बचा रहता है, जबकि route_to_incident नहीं।
प्रश्नों को सकारात्मक रूप में फ्रेम करें: हम is_automated को needs_no_reply जैसा भी कह सकते थे, लेकिन TypeSafe के अनुसार सकारात्मक रूप से बनाए गए प्रश्नों का प्रदर्शन बेहतर होता है।
अब वह हिस्सा जो Jev नहीं करता। हर उत्तर या तो confidence वैल्यू के साथ आता है या probability के साथ—और यही दूसरी संख्या आपको दो के बजाय तीन रास्ते बनाने देती है:
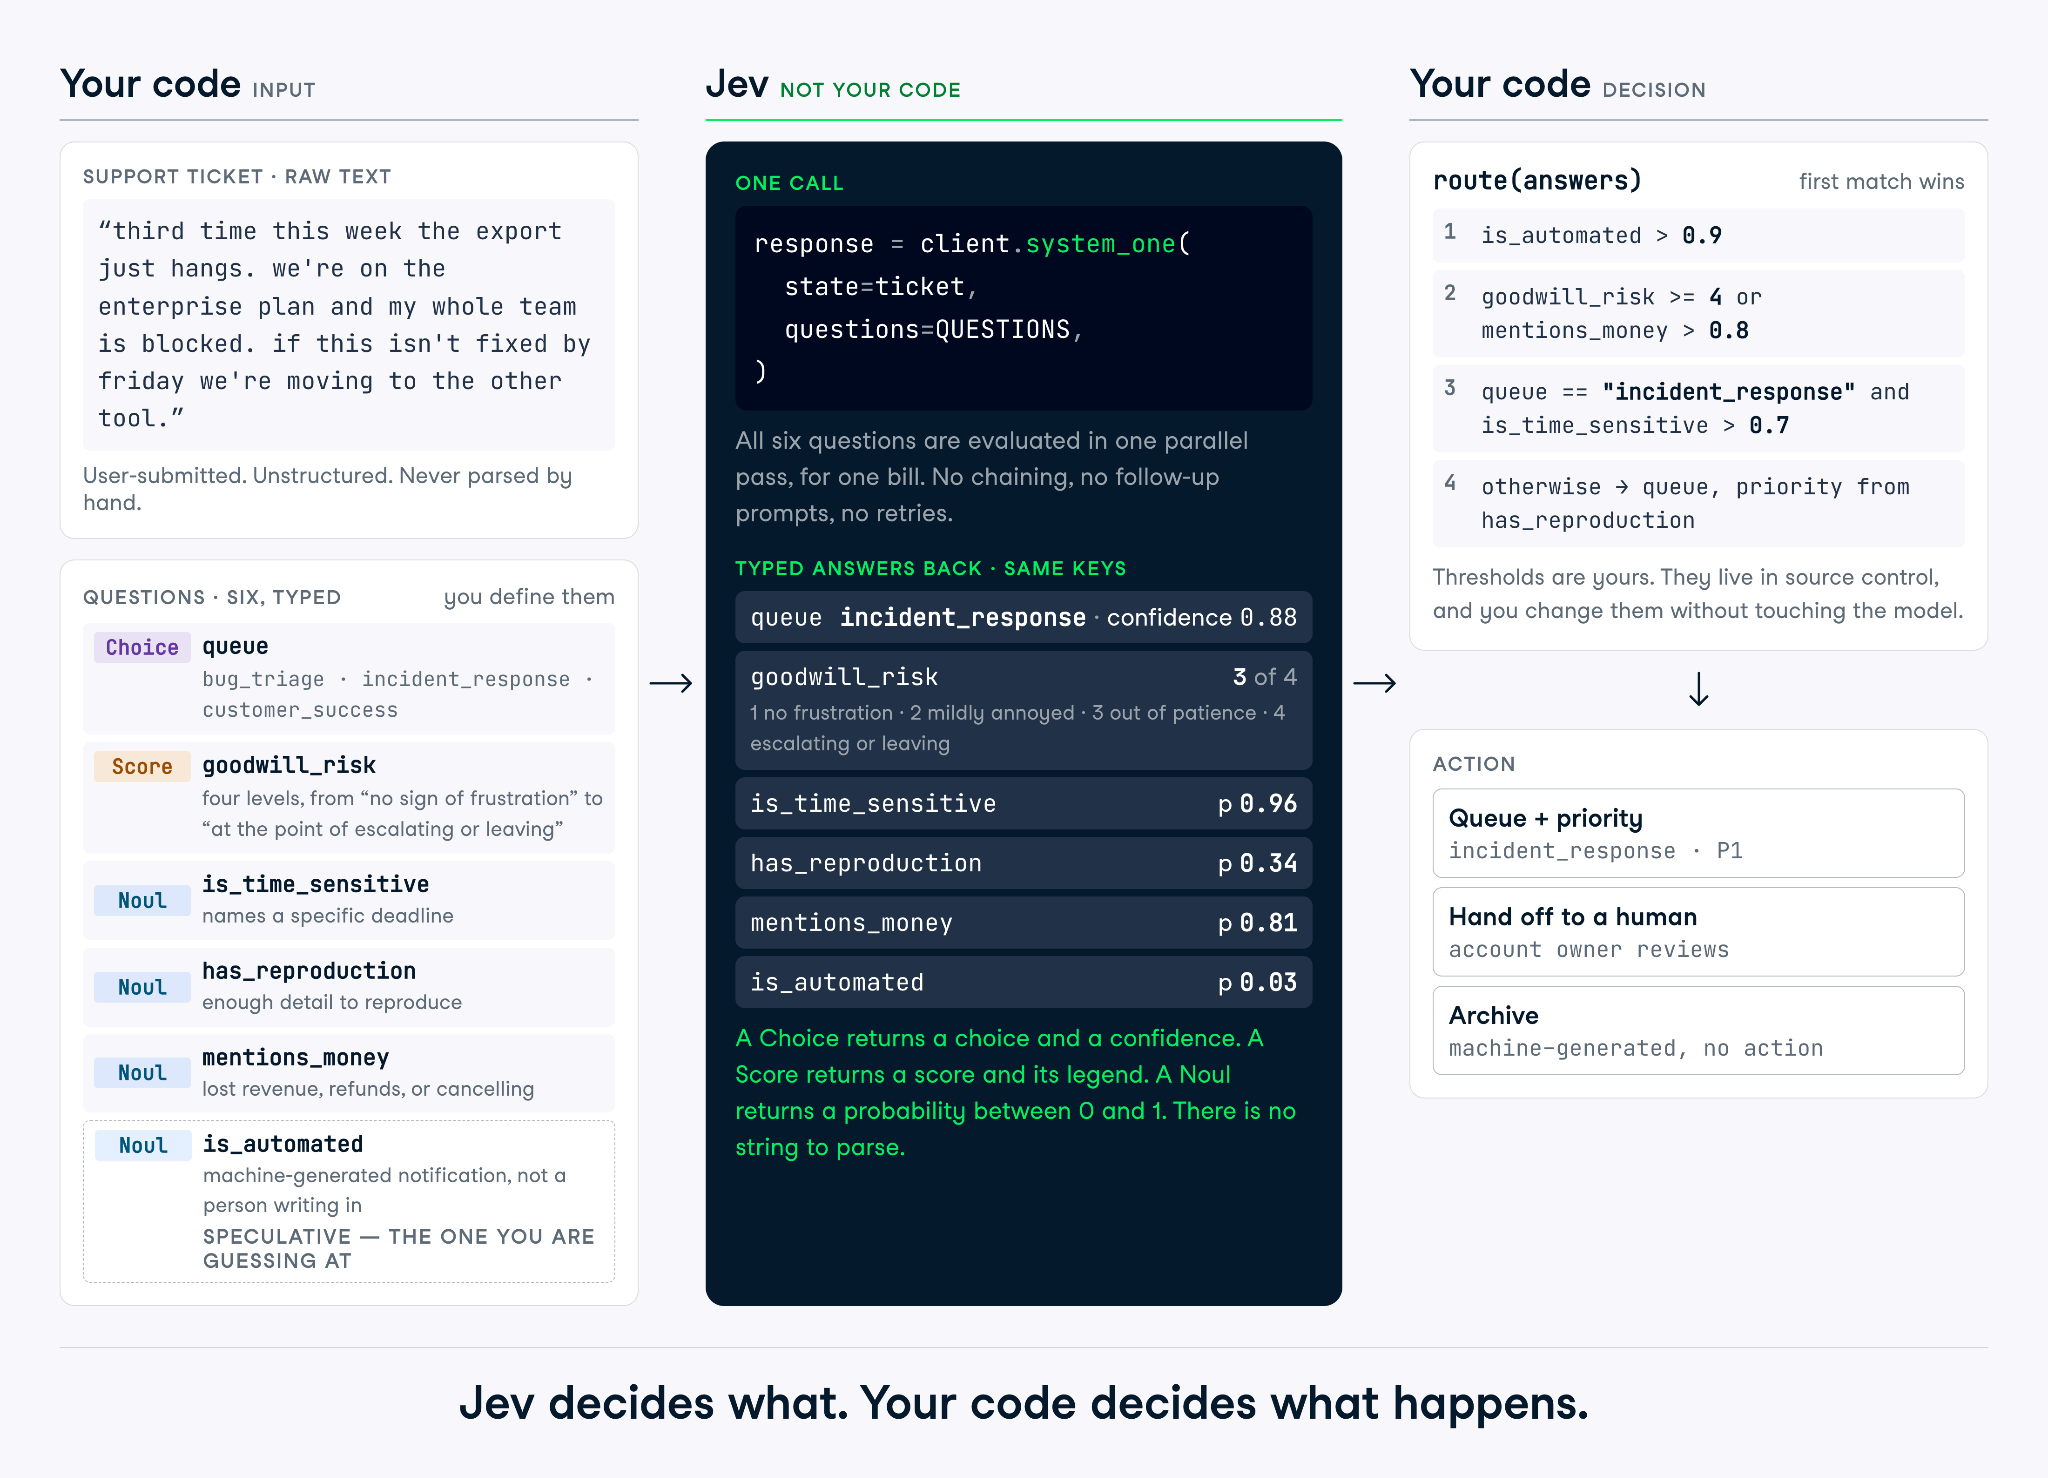
इसे टिकट रूटिंग के कुछ नियमों में बदलते हैं:
AUTO_ROUTE_CONFIDENCE = 0.75
YES = 0.8
FRUSTRATED = 2.0

def route(answers):
    if answers["is_automated"].noul > YES:
        return "archive", "auto"

    queue = answers["queue"]
    urgent = answers["is_time_sensitive"].noul > YES
    unhappy = answers["goodwill_risk"].score >= FRUSTRATED

    if unhappy and answers["mentions_money"].noul > YES:
        return "customer_success", "human_first"

    if queue.confidence < AUTO_ROUTE_CONFIDENCE:
        return queue.choice, "human_first"

    priority = "today" if urgent else "normal"
    return queue.choice, priority
पढ़ें कि यह फ़ंक्शन क्या कर रहा है। मॉडल ने छह निर्णय दिए, और नीति ने तय किया कि उनमें से एक—mentions_money—नाराज़ ग्राहक के साथ मिलकर, Jev द्वारा चुनी गई कतार पर भारी पड़ता है। यह ओवरराइड एक व्यावसायिक निर्णय है—यह कोड में होना चाहिए—और आप इसे शुक्रवार दोपहर बिना मॉडल को फिर से टेस्ट किए बदल सकते हैं।
has_reproduction कभी उपयोग में नहीं आता। मैंने इसे जानबूझकर छोड़ा है, क्योंकि व्यवहार में फैन-आउट पैटर्न ऐसा ही दिखता है: आप मौजूदा नीति से ज़्यादा चीज़ें पूछते हैं, सब लॉग करते हैं, और जब कोई पूछता है कि bug_triage टिकट बिना repro स्टेप्स के बंद होने में ज़्यादा समय लेते हैं या नहीं—तो आपके पास पहले से छह हफ्तों का उत्तर होता है।
ऊपर के थ्रेशहोल्ड सिर्फ उदाहरण हैं। सही थ्रेशहोल्ड निकालना कैलिब्रेशन का मामला है—और अंत में एक अनुभाग है कि उन्हें वाइब्स से नहीं, डेटा से कैसे सेट करें।
आप इस संबद्ध GitHub रिपो से पूरी स्क्रिप्ट एक्सेस कर सकते हैं। जब मैंने हमारे परिदृश्य के साथ Python स्क्रिप्ट चलाई, तो निर्णय था—टिकट को आज incident response टीम को रूट किया जाए।
python routing.py('incident_response', 'today')TypeSafe प्रत्येक मॉडल संस्करण के लिए एक जग्डनेस पेज प्रकाशित करता है, जिसमें ज्ञात विफलता तरीकों की सूची होती है। काश अधिक लैब ऐसा करतीं। कुछ भी बनाने से पहले इसे पढ़ें, और अपग्रेड करते समय फिर पढ़ें—क्योंकि सूची वर्ज़न्ड है और किनारे बदलते रहते हैं।
यहाँ वे पाँच हैं जिन्होंने मेरा सबसे ज़्यादा समय खाया होता।
आप प्रश्न प्रकारों के बीच थ्रेशहोल्ड पोर्ट नहीं कर सकते। TypeSafe का अपना उदाहरण उसी टिकट पर "क्या ग्राहक रिफंड माँग रहा है?" को दोनों तरीकों से पूछता है: Noul 0.22 लौटाता है, हाँ/ना Choice हाँ के लिए 0.01 लौटाता है, 0.97 confidence के साथ। वही प्रश्न, दो संख्याएँ, दो आर्डर ऑफ मैग्निट्यूड के फ़र्क के साथ।
निगेशन भी साथ नहीं देते। एक Noul और उसका विपरीत 0.72 और 0.47 पर वापस आए—जो 1.19 का योग है।
कारण यह है कि दोनों प्रकार अलग बातें पूछते हैं। Choice सापेक्ष है और तय करता है कि कौन-सा विकल्प जीतता है, जबकि प्रत्येक Noul निरपेक्ष है और सभी के लिए कम हो सकता है। उसी रूप में, जिसमें आप शिप करेंगे, प्रति प्रश्न थ्रेशहोल्ड ट्यून करें, और कभी यह न मानें कि P(yes) और 1 - P(no) एक ही संख्या हैं।
Score के स्तर क्रमबद्ध होते हैं, समान दूरी पर नहीं। 1.6 आपको बताता है कि मॉडल आपके दूसरे और तीसरे स्तर के बीच बैठा है, तीसरे की ओर झुका हुआ—और बस इतना ही बताता है।
जो आप नहीं कर सकते, वह है इससे वास्तविक मात्रा इंटरपोलेट करना। यदि आपके स्तर "एक घंटे से कम", "कुछ घंटे", और "एक दिन" हैं, तो 1.5 का मतलब पाँच घंटे नहीं होता। स्कोर का उपयोग किसी थ्रेशहोल्ड का परीक्षण करने के लिए करें, फिर हर वास्तविक संख्या को कोड में रखें।
Jev स्टेट को डेटा के रूप में लेता है, पर इसे स्टेट-लिखे निर्देशों से सख्त नहीं किया गया है जो इसे मोड़ दें।Injected इंस्ट्रक्शन, भ्रामक फ्रेमिंग, या ऐसा टेक्स्ट जो अपने ही वर्गीकरण के लिए तर्क दे—ये उत्तर को हिला सकते हैं, और TypeSafe कहता है कि वह यहाँ सुधार की अपेक्षा करता है। यदि यह अटैक सतह आपके लिए नई है, तो हम सामान्य स्थिति को अपने प्रॉम्प्ट इन्जेक्शन गाइड में कवर करते हैं।
यह सबसे ज़्यादा वहाँ मायने रखता है जहाँ स्टेट यूज़र-समर्पित हो—जो एक टिकट राउटर के लिए हमेशा होता है। Criteria इतनी सटीक लिखें कि टिकट के अपने दावे नतीजा तय न करें, और कुछ भी स्वतः रूट करने से पहले शत्रुतापूर्ण इनपुट के साथ टेस्ट करें।
गिनती अविश्वसनीय है और गिने जा रहे तत्व के बढ़ने के साथ और बदतर होती जाती है—क्योंकि मॉडल जोड़ने के बजाय उत्तर के आकार को पहचानता है। तिथियाँ टेक्स्ट की तरह पढ़ी जाती हैं, इसलिए क्रम, दूरी, और विंडोज़—सब असफल। संख्यात्मक एनकोडिंग्स अपने सेमांटिक समतुल्यों की तुलना में कमतर प्रदर्शन करती हैं—इसलिए #FF0000 की बजाय "लाल" के बारे में पूछें।
तीनों ही मामलों में समाधान एक जैसा है: काम बाँटें.
यदि आपको गिनती चाहिए, तो कोड में इटरेट करें और प्रति आइटम एक Noul पूछें:
count = sum(
    result.nouls[f"item_{i}"].noul > 0.5
    for i in range(len(items))
)तीन छोटे मुद्दे जो एक ही कारण साझा करते हैं। Jev वही प्रश्न उत्तर देता है जो आपने लिखा है, न कि जो आप कहना चाहते थे—इसलिए स्कोपिंग शब्द और नगेशन सतह पर ही पढ़े जाते हैं। दोहरे नकार और किसी गुण के गुण पर प्रश्न सटीकता घटाते हैं। और असंबंधित विवरणों से फूला बड़ा स्टेट सटीकता और पैसे—दोनों—की लागत देता है, क्योंकि असंबंधित सामग्री एक ध्यान-भंगकर्ता की तरह काम करती है।
पहले वाले की पहचान: जब आप गलत उत्तर देखते हैं और खुद को यह समझाते हुए पकड़ते हैं कि आप वास्तव में क्या कहना चाहते थे—वह व्याख्या आपकी निर्देशिका का गायब आधा भाग है।
जो हमने पहले ही सीखा है, उसके आधार पर, Jev का सबसे अच्छा उपयोग करने के लिए कुछ सर्वोत्तम अभ्यास यहाँ हैं।
इरादे के बजाय कंडीशन लिखें। यदि आप गलत उत्तर की समीक्षा करते समय यह समझा रहे हैं कि आपका तात्पर्य क्या था, तो वह व्याख्या निर्देशिका में होनी चाहिए। इसका मतलब:
jev-latest बदलता रहता है। एक बार जब कोई थ्रेशहोल्ड मॉडल व्यवहार पर निर्भर हो, तो संस्करण पिन करें:
client = TypeSafeClient(model="jev-1.13.0")हर कॉल पर पूरे उत्तरों के साथ response.model को लॉग करें—सिर्फ उस वैल्यू को नहीं जिस पर आपने कार्रवाई की। जब कोई थ्रेशहोल्ड गड़बड़ करना शुरू करता है, तो वही लॉग यह बताने का एकमात्र तरीका है कि यह मॉडल परिवर्तन है या आपके टिकटों में ड्रिफ्ट।
अंततः, थ्रेशहोल्ड दिए हुए नहीं होते—वे प्रयोग का नतीजा होते हैं।
Jev एक संकरा टूल है—और यही वास्तव में इसका उद्देश्य है। यह उन प्रश्नों के उत्तर देता है जिनके उत्तर आप गिना सकते हैं, इतनी सस्ती दर पर कि आप उन्हें राशन करना छोड़ दें, और फिर निर्णय आपके कोड को सौंप देता है।
जिस पर मैं आपत्ति करूँगा/करूँगी, वह है "हैलूसिनेट नहीं कर सकता" वाला फ़्रेमिंग। संकीर्ण अर्थ में यह सही है कि मॉडल स्कीमा से बाहर उत्तर नहीं दे सकता—पर यह इस बारे में कुछ नहीं कहता कि उत्तर सही है या नहीं। Choice हमेशा एक वैध कतार लौटाता है। वह 0.9 confidence के साथ भी गलत कतार हो सकता है—और टाइप्ड आउटपुट उस विफलता को और शांत बना देता है।
इसे अपने काम के लिए परखने के लिए, मैं सुझाव दूँगा/दूँगी कि अपने कोड में लिया जाने वाला एक ऐसा निर्णय खोजें जो भंगुर नियम पर टिका हो या धीमी LLM कॉल करता हो—और मान्य उत्तर लिखकर देखें। यदि आप लिख सकते हैं—यह Jev-आकार का है। यदि नहीं—तो कोई भी प्रश्न-इंजीनियरिंग इसे नहीं बदलेगी।
यदि आप AI का उपयोग करने वाली प्रणालियाँ बनाना शुरू करना चाहते हैं, तो मैं हमारे Associate AI Engineer for Developers करियर ट्रैक में नामांकन की कड़ी सिफारिश करता/करती हूँ। यह आपको OpenAI API, MCP, LangChain, और बहुत कुछ के साथ काम करना सिखाता है।
DataCamp के साथ AI इंजीनियरिंग सीखें!
लर्निंग पाथ
कोर्स
कोर्स