

कोर्स
Llama 3 के साथ फाइन-ट्यूनिंग
2 घंटा
4.1K
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखेंQwen3.5 Small हल्के फाइन-ट्यूनिंग के लिए एक व्यावहारिक मॉडल है क्योंकि इसे प्रोटोटाइपिंग, कार्य-विशिष्ट अनुकूलन और शोध वर्कफ़्लोज़ के लिए डिजाइन किया गया है। QLoRA के साथ मिलाकर, हम एक फ्रीज़ किए हुए 4-बिट क्वांटाइज़्ड बेस मॉडल के ऊपर इसे फाइन-ट्यून कर सकते हैं, जिससे प्रक्रिया काफी अधिक मेमोरी-कुशल हो जाती है और सीमित हार्डवेयर पर भी सुलभ हो जाती है।
इस ट्यूटोरियल में, हम वातावरण सेट करेंगे, मॉडल और AG News डेटासेट लोड करेंगे, बेस मॉडल का मूल्यांकन करेंगे, और फिर समाचार वर्गीकरण के लिए Qwen3.5 small को फाइन-ट्यून करेंगे। अंत में, हम प्रशिक्षण से पहले और बाद के परिणामों की तुलना करेंगे, फिर LoRA एडेप्टर को Hugging Face पर पुन: उपयोग के लिए सहेजेंगे और प्रकाशित करेंगे।
यदि आप पहले से इसकी कार्यप्रणाली से परिचित नहीं हैं, तो मैं Hugging Face Fundamentals स्किल ट्रैक लेने की सलाह देता/देती हूँ।
कोड में जाने से पहले, जिस मॉडल पर हम काम कर रहे हैं उसे समझना सहायक होता है। Qwen3.5 फाउंडेशन मॉडलों का एक परिवार है, और "Small" सीरीज़ उनके हल्के लाइनअप को संदर्भित करती है, विशेष रूप से 10 बिलियन पैरामीटर्स से कम वाले मॉडल। इस ट्यूटोरियल के लिए, हम 0.8B संस्करण का उपयोग करेंगे।
सिर्फ 800 मिलियन पैरामीटर्स होने के बावजूद, Qwen3.5-0.8B अत्यंत सक्षम और बेहद कुशल है। जब इसे 4-बिट प्रिसीजन में लोड किया जाता है, तो इसे 2GB से भी कम VRAM की आवश्यकता होती है। यह इसे कन्ज़्यूमर लैपटॉप, Kaggle जैसे फ्री क्लाउड वातावरण, और हल्के एज डिप्लॉयमेंट्स के लिए बेहतरीन बनाता है।
इसके अतिरिक्त, Qwen3.5 आर्किटेक्चर 262K के विशाल कॉन्टेक्स्ट विंडो और नैटिव मल्टीमॉडलिटी का समर्थन करता है। यद्यपि हम इस गाइड में केवल टेक्स्ट वर्गीकरण पर ध्यान दे रहे हैं, यहां कवर किए गए आधारभूत कॉन्सेप्ट्स को आगे चलकर विज़न कार्यों तक आसानी से बढ़ाया जा सकता है। मॉडल में एक हाइब्रिड रीजनिंग मोड भी है, हालांकि हम अपने सीधे-सरल लेबलिंग कार्य के लिए इनफ़्रेंस स्पीड अधिकतम रखने हेतु उसे डिसेबल रखेंगे।
कुल मिलाकर, Qwen3.5-0.8B प्रोटोटाइपिंग के लिए अत्यंत व्यावहारिक विकल्प है। यह हमें फाइन-ट्यूनिंग वर्कफ़्लोज़ को तेज़ी और कम लागत में परखने का तरीका देता है, जबकि डाउनस्ट्रीम परिणाम भी मजबूत रहते हैं।
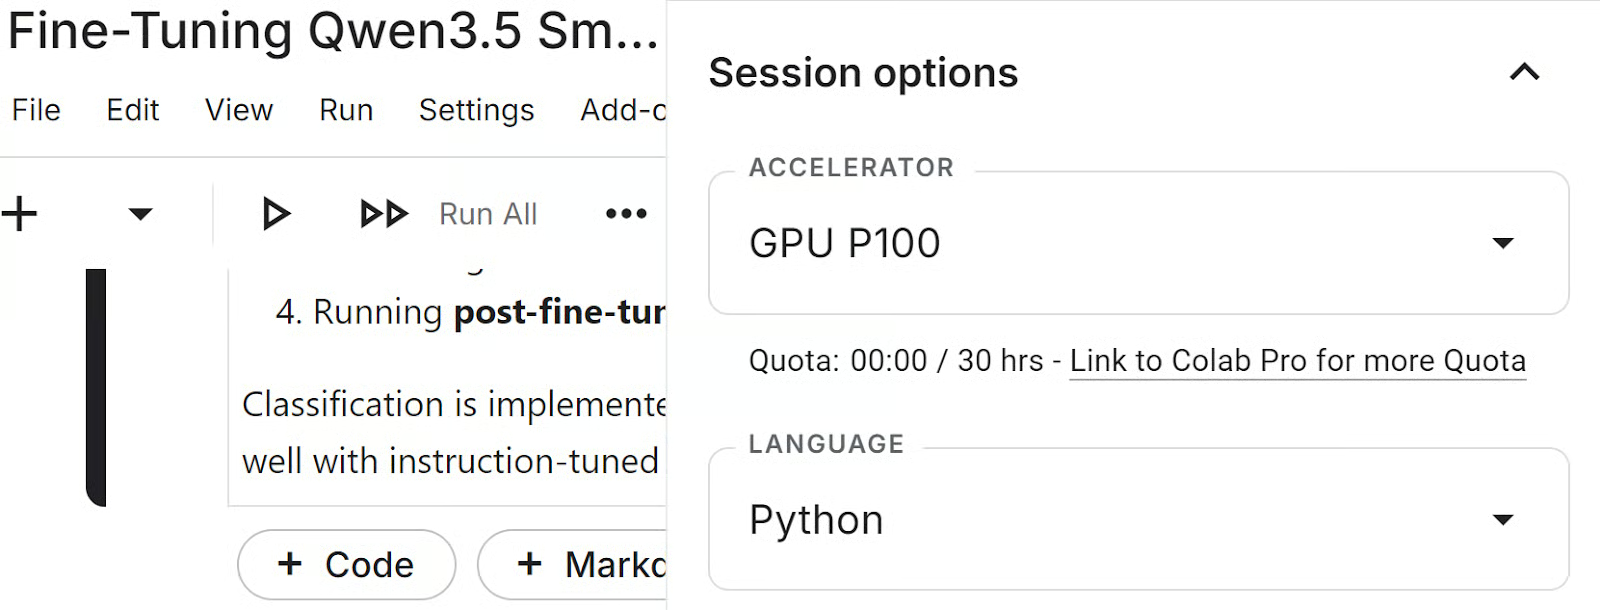
इस ट्यूटोरियल में, हम अपने प्रशिक्षण वातावरण के रूप में Kaggle नोटबुक का उपयोग करेंगे। Kaggle हमें GPUs की पहुँच देता है, जिससे प्रशिक्षण, फाइन-ट्यूनिंग और मॉडल का मूल्यांकन करने के लिए यह एक सुविधाजनक प्लेटफ़ॉर्म बन जाता है। नोटबुक चलाने से पहले, एक नया Kaggle नोटबुक लॉन्च करें, Session सेटिंग्स खोलें, और एक्सेलरेटर के रूप में GPU P100 चुनें।
इसके बाद, हम वातावरण सेट करेंगे, Kaggle में Hugging Face टोकन जोड़ेंगे, और पूरे ट्यूटोरियल में उपयोग होने वाली Python लाइब्रेरियाँ इम्पोर्ट करेंगे।
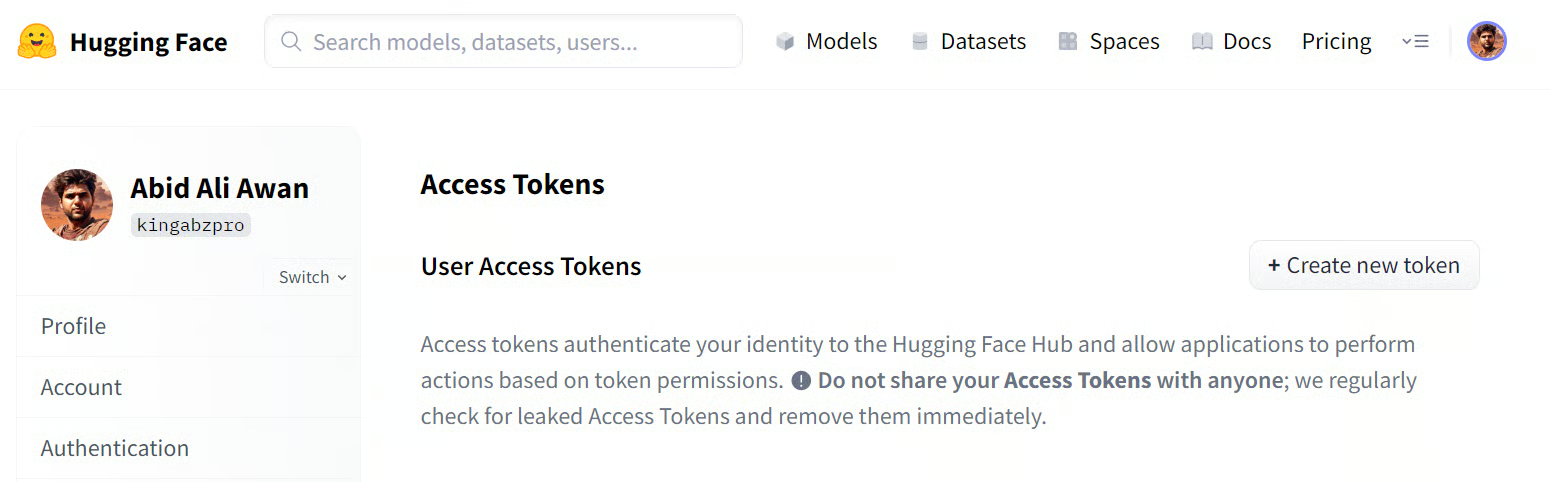
नोटबुक चलाने से पहले, अपने अकाउंट की सेटिंग्स से Hugging Face एक्सेस टोकन बनाएँ। Settings पर जाएँ, Access Tokens खोलें, और नया टोकन जेनरेट करें। यदि आप ट्यूटोरियल के अंत में फाइन-ट्यून किया गया LoRA एडेप्टर Hugging Face Hub पर प्रकाशित करना चाहते हैं, तो सुनिश्चित करें कि टोकन में लिखने (write) की अनुमति हो।
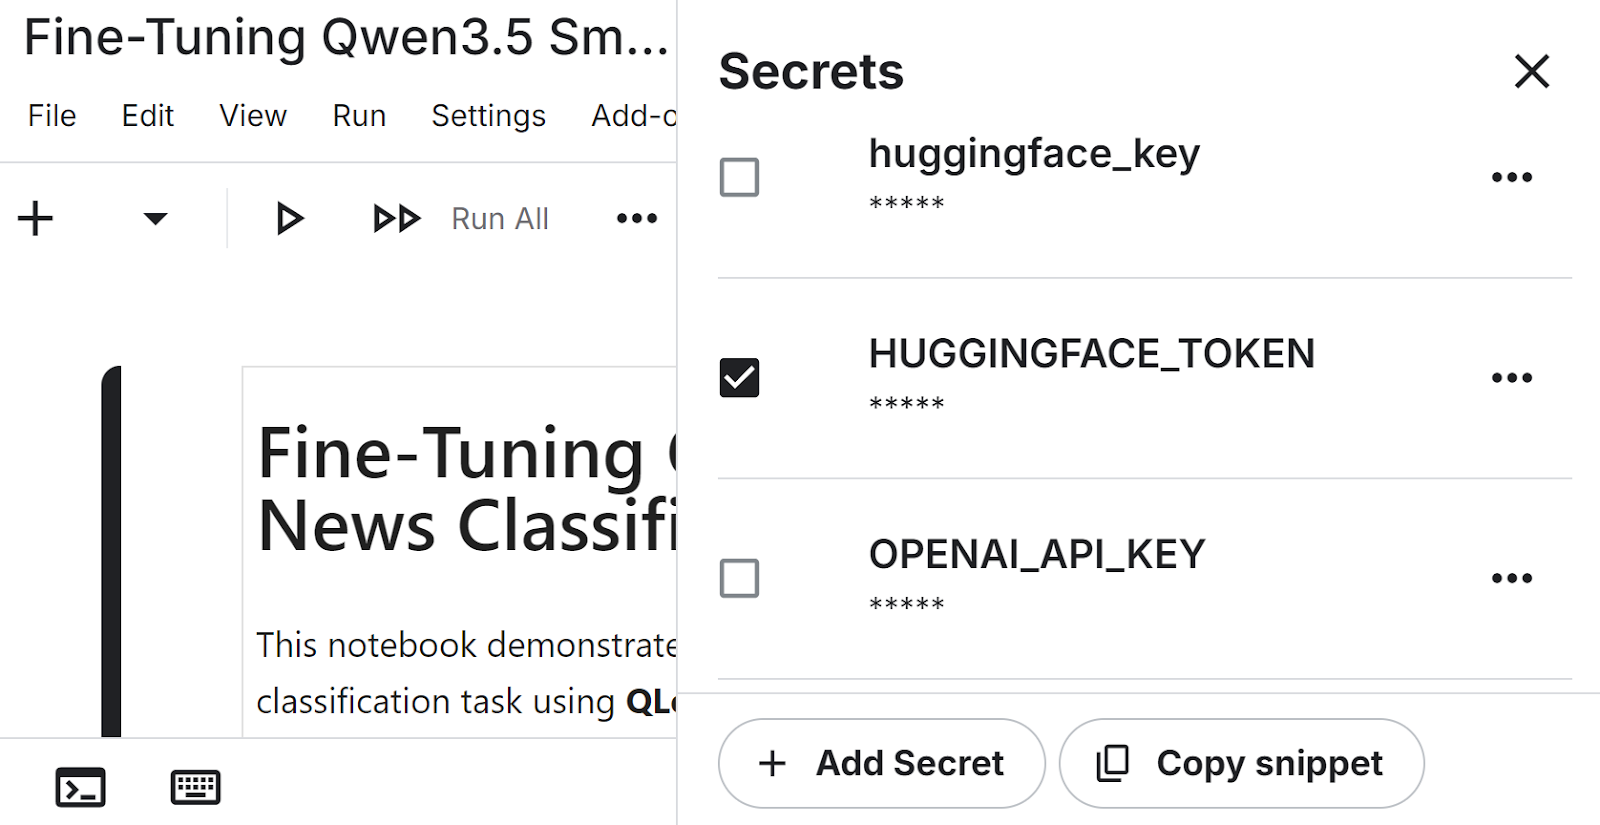
टोकन जेनरेट करने के बाद, अपना Kaggle नोटबुक खोलें और इसे एक सीक्रेट के रूप में जोड़ें। नोटबुक एडिटर में Add-ons पर जाएँ, फिर Secrets पर, और HUGGINGFACE_TOKEN नाम से नया सीक्रेट बनाएँ। अपना टोकन मान वहाँ पेस्ट करें ताकि नोटबुक उसे कोड में उजागर किए बिना सुरक्षित रूप से एक्सेस कर सके।
अब हम इस वर्कफ़्लो के लिए आवश्यक मुख्य लाइब्रेरियाँ इंस्टॉल कर सकते हैं। ये पैकेज मॉडल लोडिंग, क्वांटाइज़ेशन, पैरामीटर-कुशल फाइन-ट्यूनिंग, डेटासेट हैंडलिंग और मूल्यांकन को कवर करते हैं।
!pip install -q -U transformers accelerate
!pip install -q peft trl bitsandbytes datasets scikit-learnअगला कदम है Kaggle secrets से Hugging Face टोकन लोड करना और उससे लॉगिन करना। इससे नोटबुक को मॉडल तक पहुँच मिलती है और हमें बाद में प्रशिक्षित एडेप्टर पुश करने की अनुमति मिलती है।
from huggingface_hub import login
from kaggle_secrets import UserSecretsClient

user_secrets = UserSecretsClient()
login(token=user_secrets.get_secret("HUGGINGFACE_TOKEN"))अंत में, हम पूरे ट्यूटोरियल में उपयोग होने वाली Python लाइब्रेरियाँ इम्पोर्ट करते हैं, जिनका उपयोग मॉडल लोडिंग, प्रशिक्षण, डेटासेट प्रोसेसिंग और मूल्यांकन के लिए होगा।
import torch
from datasets import load_dataset
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig
from peft import LoraConfig, get_peft_model
from trl import SFTTrainer, SFTConfig
from transformers import TrainingArguments
from sklearn.metrics import accuracy_score, f1_score
from tqdm.notebook import tqdmअब जब वातावरण तैयार है, हम बेस मॉडल लोड कर सकते हैं और डेटासेट को फाइन-ट्यूनिंग के लिए तैयार कर सकते हैं।
इस सेक्शन में, हम Qwen3.5-0.8B को 4-बिट प्रिसीजन में लोड करेंगे ताकि प्रशिक्षण अधिक मेमोरी-कुशल हो, टोकनाइज़र सेट करेंगे, और प्रशिक्षण व मूल्यांकन के लिए AG News डेटासेट का एक छोटा सबसेट लोड करेंगे।
हम BitsAndBytes का उपयोग करके 4-बिट क्वांटाइज़ेशन के साथ Qwen3.5-0.8B लोड करना शुरू करते हैं। इससे मेमोरी उपयोग कम होता है और Kaggle नोटबुक वातावरण में मॉडल के साथ काम करना अधिक व्यावहारिक बनता है।
model_id = "Qwen/Qwen3.5-0.8B"

bnb_config = BitsAndBytesConfig(
  load_in_4bit=True,
  bnb_4bit_quant_type="nf4",
  bnb_4bit_compute_dtype=torch.bfloat16
)

model = AutoModelForCausalLM.from_pretrained(
  model_id,
  quantization_config=bnb_config,
  device_map="auto",
  dtype=torch.bfloat16
)इसके बाद, हम उसी मॉडल के लिए टोकनाइज़र लोड करते हैं। हम पैडिंग टोकन को एंड-ऑफ-सीक्वेंस टोकन पर सेट करते हैं ताकि मॉडल प्रशिक्षण और जेनरेशन के दौरान पैडेड इनपुट्स को सही तरीके से संभाल सके।
tokenizer = AutoTokenizer.from_pretrained(model_id)
tokenizer.pad_token = tokenizer.eos_token

model.config.pad_token_id = tokenizer.eos_token_id
model.generation_config.pad_token_id = tokenizer.eos_token_idअंत में, हम AG News डेटासेट लोड करते हैं और इस ट्यूटोरियल के लिए छोटे प्रशिक्षण और परीक्षण स्प्लिट बनाते हैं। एक सबसेट का उपयोग करने से वर्कफ़्लो तेज़ रहता है, जबकि फाइन-ट्यूनिंग के प्रभाव का मूल्यांकन करने के लिए पर्याप्त डेटा भी मिलता है।
dataset = load_dataset("ag_news")

train_dataset = dataset["train"].select(range(2500))
test_dataset = dataset["test"].select(range(200))फाइन-ट्यूनिंग से पहले, हमें परिभाषित करना होगा कि मॉडल कार्य को कैसे देखेगा और अपने मूल रूप में यह कितना अच्छा प्रदर्शन करता है इसे मापना होगा।
इस सेक्शन में, हम समाचार वर्गीकरण के लिए एक निर्देश-शैली का प्रॉम्प्ट बनाएँगे, मॉडल के आउटपुट से भविष्यवाणियाँ निकालेंगे, एक नमूना इनफ़्रेंस चलाएँगे, और प्रशिक्षण से पहले टेस्ट सेट पर बेस मॉडल का मूल्यांकन करेंगे।
हम लेबल नाम परिभाषित करके और एक प्रॉम्प्ट बनाकर शुरू करते हैं जो मॉडल से किसी समाचार लेख का वर्गीकरण करने को कहता है। प्रॉम्प्ट इस तरह लिखा गया है कि मॉडल केवल संख्यात्मक लेबल लौटाए, जिससे मूल्यांकन के दौरान आउटपुट को पार्स करना आसान हो जाता है।
labels = ['World','Sports','Business','Sci/Tech']

def build_prompt(text):

    return f"""
Classify the news article.

Article:
{text}

Return ONLY the number of the correct label.

0 = World
1 = Sports
2 = Business
3 = Sci/Tech

Answer:
"""इसके बाद, हम एक छोटा हेल्पर फ़ंक्शन बनाते हैं जो जेनरेटेड टेक्स्ट से अनुमानित लेबल निकालता है। यह फ़ंक्शन किसी भी अतिरिक्त रीजनिंग टोकन को हटा देता है और अंतिम क्लास लेबल को इन्टीजर के रूप में लौटाता है।
import re

def extract_label(text):

   text = re.sub(r"<think>.*?</think>", "", text, flags=re.DOTALL)
   matches = re.findall(r"[0-3]", text)

   if matches:
       return int(matches[-1])

return -1मॉडल को पूरे टेस्ट सेट पर मूल्यांकित करने से पहले, हम पहले इसे एक एकल उदाहरण पर आज़माते हैं। इससे हमें लेख की जाँच करने, सही लेबल देखने, और फाइन-ट्यूनिंग से पहले मॉडल क्या भविष्यवाणी करता है यह देखने में मदद मिलती है।
sample = train_dataset[10]

sample_text = sample["text"]
sample_label = sample["label"]

print("Ground truth label:", sample_label)
print("Sample text:")
print(sample_text[:300])
आउटपुट दिखाता है कि वास्तविक लेबल 2 है, जो Business से मेल खाता है।
Ground truth label: 2
Sample text:
Oil and Economy Cloud Stocks' Outlook  NEW YORK (Reuters) - Soaring crude prices plus worries  about the economy
and the outlook for earnings are expected to  hang over the stock market next week during the depth of the  summer doldrums.
अगला, हम प्रॉम्प्ट को फ़ॉर्मेट करते हैं, उसे मॉडल को पास करते हैं, और एक भविष्यवाणी जेनरेट करते हैं।
prompt = build_prompt(sample_text)

inputs = tokenizer(prompt, return_tensors="pt").to("cuda")

with torch.inference_mode():
    outputs = model.generate(
        **inputs,
        max_new_tokens=5,
        do_sample=False,
        pad_token_id=tokenizer.eos_token_id
    )

prediction = tokenizer.decode(outputs[0], skip_special_tokens=True)

print("Model prediction (before training):")
print(extract_label(prediction))
मॉडल भी 2 की भविष्यवाणी करता है, इसलिए यह उदाहरण सही वर्गीकृत होता है। इससे हमें त्वरित जाँच मिलती है कि प्रॉम्प्ट फ़ॉर्मेट और प्रेडिक्शन पाइपलाइन अपेक्षित रूप से काम कर रहे हैं।
Model prediction (before training):
2अब हम बेस मॉडल का टेस्ट सेट पर मूल्यांकन करते हैं ताकि एक बेसलाइन स्थापित हो सके। यह हमें फाइन-ट्यूनिंग से पहले और बाद के प्रदर्शन की तुलना करने के लिए संदर्भ बिंदु देता है।
def evaluate_model(dataset):

    preds = []
    refs = []

    model.eval()

    for example in tqdm(dataset):

        text = example["text"]
        label = example["label"]

        prompt = build_prompt(text)

        inputs = tokenizer(prompt, return_tensors="pt", truncation=True)
        inputs = {k: v.to("cuda") for k, v in inputs.items()}

        with torch.inference_mode():

            outputs = model.generate(
                **inputs,
                max_new_tokens=5,
                do_sample=False,
                pad_token_id=tokenizer.eos_token_id
            )

        prediction = tokenizer.decode(outputs[0], skip_special_tokens=True)

        pred_label = extract_label(prediction)

        preds.append(pred_label)
        refs.append(label)

    acc = accuracy_score(refs, preds)
    f1 = f1_score(refs, preds, average="weighted")

    print("Accuracy:", acc)
    print("F1:", f1)


print('Pre-fine-tuning evaluation')
evaluate_model(test_dataset)
आउटपुट में 0.52 की सटीकता और वेटेड F1 स्कोर 0.4589 रिपोर्ट होता है। ये बेसलाइन परिणाम दिखाते हैं कि मॉडल में पहले से कुछ क्षमता है, जबकि फाइन-ट्यूनिंग के माध्यम से सुधार की पर्याप्त गुंजाइश भी है।
Pre-fine-tuning evaluation
Accuracy: 0.52
F1: 0.45889163289429247अब जब हमने बेसलाइन स्थापित कर ली है, हम मॉडल को समाचार वर्गीकरण कार्य पर फाइन-ट्यून कर सकते हैं। इस सेक्शन में, हम प्रशिक्षण डेटा को फ़ॉर्मेट करेंगे, LoRA एडेप्टर्स को कॉन्फ़िगर करेंगे, प्रशिक्षण सेटिंग्स परिभाषित करेंगे, मॉडल को प्रशिक्षित करेंगे, और बाद में उपयोग के लिए अंतिम एडेप्टर सहेजेंगे।
सबसे पहले, हम प्रत्येक प्रशिक्षण उदाहरण को इस तरह फ़ॉर्मेट करते हैं कि वह इनफ़्रेंस के दौरान उपयोग किए गए उसी प्रॉम्प्ट स्ट्रक्चर से मेल खाए। हम प्रॉम्प्ट के अंत में सही लेबल जोड़ते हैं ताकि मॉडल फाइन-ट्यूनिंग के दौरान सही उत्तर जेनरेट करना सीख सके।
def format_train(example):
    prompt = build_prompt(example['text'])
    answer = str(example['label'])
    return {'text': prompt + ' ' + answer}

train_dataset = train_dataset.map(format_train)इसके बाद, हम LoRA कॉन्फ़िगरेशन परिभाषित करते हैं। यह मॉडल को बताता है कि फाइन-ट्यूनिंग के दौरान किन लेयर्स को अनुकूलित करना है, जिससे हम पूरे मॉडल को अपडेट करने के बजाय केवल थोड़े अतिरिक्त पैरामीटर्स ट्रेन कर सकें।
lora_config = LoraConfig(
    r=16,
    lora_alpha=16,
    lora_dropout=0,
    bias='none',
    task_type='CAUSAL_LM',
    target_modules=[
        'q_proj','k_proj','v_proj','o_proj',
        'gate_proj','up_proj','down_proj'
    ]
)इसके बाद, हम सुपरवाइज्ड फाइन-ट्यूनिंग के लिए प्रशिक्षण आर्ग्यूमेंट्स सेट करते हैं। ये सेटिंग्स नियंत्रित करती हैं कि एक बार में कितने उदाहरण प्रोसेस हों, ग्रेडिएंट्स कैसे एकत्रित हों, प्रशिक्षण कितने समय तक चले, और आउटपुट फाइलें कहाँ सहेजी जाएँ।
training_args = SFTConfig(
    output_dir="./qwen35-lora",
    per_device_train_batch_size=8,
    gradient_accumulation_steps=2,
    learning_rate=2e-4,
    num_train_epochs=1,
    logging_steps=10,
    bf16=True,
    dataset_text_field="text",
    packing=False,
)अब हम मॉडल, डेटासेट, LoRA कॉन्फ़िगरेशन, प्रशिक्षण सेटिंग्स और टोकनाइज़र के साथ ट्रेनर को इनिशियलाइज़ करते हैं। फिर हम फ़ॉर्मेट किए गए AG News प्रशिक्षण सेट पर मॉडल का फाइन-ट्यूनिंग शुरू करते हैं।
trainer = SFTTrainer(
    model=model,
    train_dataset=train_dataset,
    peft_config=lora_config,
    args=training_args,
    processing_class=tokenizer
)
trainer.train()
आउटपुट:
TrainOutput(global_step=157, training_loss=1.9094241804378047, metrics={'train_runtime': 616.477, 'train_samples_per_second': 4.055, 'train_steps_per_second': 0.255, 'total_flos': 1041693973114368.0, 'train_loss': 1.9094241804378047})प्रशिक्षण समाप्त होने के बाद, हम LoRA एडेप्टर और टोकनाइज़र सहेजते हैं। इससे हम बाद में मूल्यांकन, साझा करने या Hugging Face पर प्रकाशित करने के लिए फाइन-ट्यून किया गया एडेप्टर दोबारा लोड कर सकते हैं।
trainer.model.save_pretrained("qwen35-small-news-class")
tokenizer.save_pretrained("qwen35-small-news-class")प्रशिक्षण के बाद, हम बेस मॉडल को फिर से लोड करते हैं और सहेजे गए LoRA एडेप्टर को संलग्न करते हैं। इससे हम फाइन-ट्यून किए गए वेट्स का उपयोग करके मूल्यांकन चला सकते हैं और पहले की बेसलाइन से परिणामों की तुलना कर सकते हैं।
हम पहले बेस Qwen3.5 मॉडल को फिर से लोड करते हैं, फिर Kaggle वर्किंग डायरेक्टरी में सहेजे गए फाइन-ट्यून किए गए LoRA एडेप्टर को संलग्न करते हैं। उसके बाद, हम मॉडल को मूल्यांकन मोड में स्विच करते हैं और ट्रेन करने योग्य पैरामीटर्स का सारांश देखते हैं।
from transformers import AutoModelForCausalLM
base_model = AutoModelForCausalLM.from_pretrained(
    model_id,
    device_map="auto",
    dtype=torch.bfloat16
)


from peft import PeftModel

model = PeftModel.from_pretrained(
    base_model,
    "/kaggle/working/qwen35-small-news-class"
)

model.eval()
model.print_trainable_parameters()
आउटपुट दिखाता है कि इस चरण पर कोई भी पैरामीटर ट्रेन करने योग्य नहीं है क्योंकि प्रशिक्षण पूरा हो चुका है, और अब हम इनफ़्रेंस और मूल्यांकन के लिए सहेजे गए एडेप्टर का उपयोग कर रहे हैं।
trainable params: 0 || all params: 758,782,784 || trainable%: 0.0000इसके बाद, हम वही मूल्यांकन फ़ंक्शन फिर से टेस्ट सेट पर चलाते हैं। इससे हम माप सकते हैं कि फाइन-ट्यूनिंग के बाद मॉडल कितना सुधरा है।
print('Post-fine-tuning evaluation')
evaluate_model(test_dataset)
आउटपुट में 0.865 की सटीकता और 0.8661 का वेटेड F1 स्कोर रिपोर्ट होता है। बेसलाइन परिणामों की तुलना में, यह फाइन-ट्यूनिंग के बाद उत्कृष्ट सुधार दिखाता है।
Post-fine-tuning evaluation
Accuracy: 0.865
F1: 0.8660926258753361अब हम फाइन-ट्यूनिंग से पहले और बाद में मॉडल के प्रदर्शन की तुलना कर सकते हैं। सटीकता और F1 स्कोर दोनों में पर्याप्त सुधार होता है, जो दिखाता है कि QLoRA फाइन-ट्यूनिंग समाचार वर्गीकरण कार्य के लिए मॉडल को अच्छी तरह अनुकूलित करती है।
|
मेट्रिक |
प्रशिक्षण से पहले |
प्रशिक्षण के बाद |
|
Accuracy |
0.52 |
0.865 |
|
F1 Score |
0.4589 |
0.866 |
जैसा कि हम देख सकते हैं, QLoRA के साथ Qwen3.5 Small का फाइन-ट्यूनिंग वर्गीकरण प्रदर्शन में उल्लेखनीय सुधार करता है।
मूल्यांकन पूरा होने के बाद, हम फाइन-ट्यून किए गए एडेप्टर और टोकनाइज़र को Hugging Face पर अपलोड कर सकते हैं। इससे मॉडल को दोबारा प्रशिक्षण किए बिना भविष्य की परियोजनाओं में पुन: उपयोग, साझा और लोड करना आसान हो जाता है।
model.push_to_hub("kingabzpro/qwen35-small-news-class")
tokenizer.push_to_hub("kingabzpro/qwen35-small-news-class")
अपलोड खत्म होने के बाद, मॉडल यहाँ उपलब्ध होगा:
Model:
https://huggingface.co/kingabzpro/qwen35-small-news-class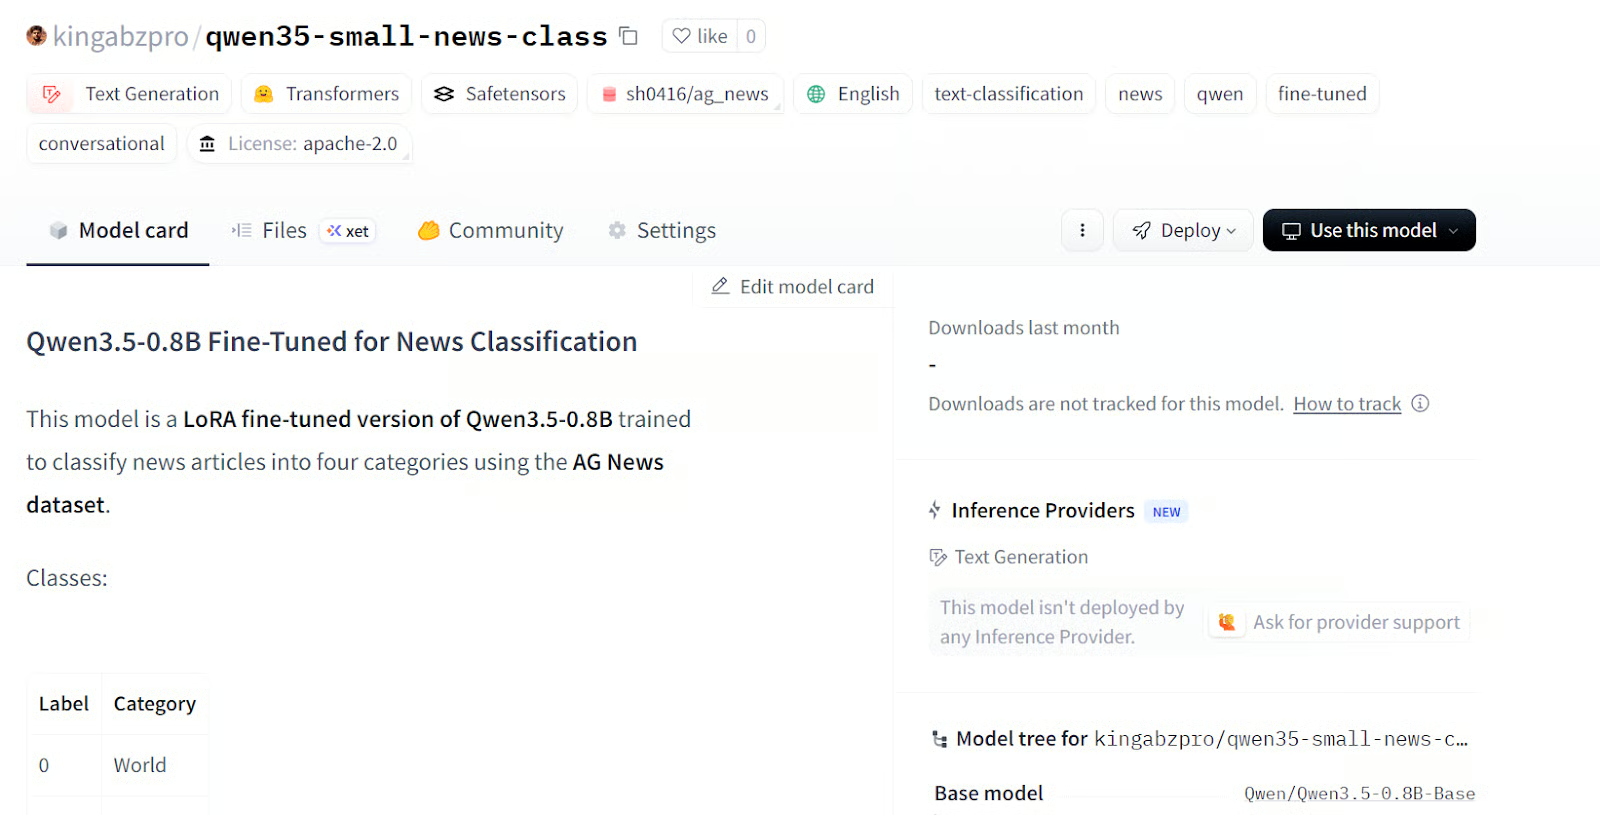
स्रोत: kingabzpro/qwen35-small-news-class
इस ट्यूटोरियल के लिए Kaggle नोटबुक भी उपलब्ध है। मैं इसे तभी उपयोग करने की सलाह देता/देती हूँ जब ऊपर दिए गए चरणों को दोहराते समय आपको समस्याएँ आएँ। आप नोटबुक को क्लोन करके अपने सिस्टम पर भी चला सकते हैं, लेकिन Hugging Face यूज़रनेम और टोकन को अपने अकाउंट के अनुसार अपडेट करना याद रखें।
इस ट्यूटोरियल में, हमने Qwen3.5-0.8B को QLoRA के साथ समाचार वर्गीकरण के लिए फाइन-ट्यून किया और बेहद हल्के सेटअप से मजबूत परिणाम प्राप्त किए। केवल एक एपॉक में छोटे सबसेट पर, सटीकता 0.52 से बढ़कर 0.865 हुई, और वेटेड F1 0.4589 से बढ़कर 0.8661 हो गया।
इतने छोटे मॉडल के लिए, ईमानदारी से कहें तो यही सबसे चौंकाने वाला हिस्सा है: मजबूत डाउनस्ट्रीम परिणाम पाने के लिए हमें न बहुत बड़ा मॉडल चाहिए, न बहुत बड़ा डेटासेट, न ही लंबा प्रशिक्षण।
इसे और भी उपयोगी बनाता है इसका व्यावहारिक सेटअप। Qwen 0.8B मॉडल को प्रोटोटाइपिंग और कार्य-विशिष्ट फाइन-ट्यूनिंग के लिए उपयुक्त बताता है, और QLoRA 4-बिट बेस मॉडल के ऊपर एडेप्टर्स को ट्रेन करके मेमोरी उपयोग कम रखता है। इसका मतलब यह सिर्फ क्लाउड नोटबुक वर्कफ़्लो नहीं है। यह छोटे कन्ज़्यूमर और लैपटॉप GPUs पर परीक्षण के लिए भी यथार्थवादी है।
इस मॉडल को लेकर मुझे उत्साहित करने का एक और कारण यह है कि Qwen3.5 परिवार टेक्स्ट और विज़न फाइन-ट्यूनिंग दोनों का समर्थन करता है। इसलिए भले ही हमने इसका उपयोग यहाँ टेक्स्ट वर्गीकरण के लिए किया, वही विचार इमेज क्लासिफिकेशन, इमेज-टू-टेक्स्ट और टेक्स्ट-टू-टेक्स्ट कार्यों तक भी बढ़ाया जा सकता है। जब आप विचारों को जल्दी परखना, सस्ते में फाइन-ट्यून करना, और डिप्लॉयमेंट को हल्का रखना चाहते हैं, तो ऐसा छोटा मॉडल वास्तव में बहुत व्यावहारिक विकल्प बन जाता है।
मैं आपको हमारे अन्य संसाधनों को भी देखने की सलाह देता/देती हूँ, जिनमें हमारा Qwen3.5 पर गाइड और हमारा ट्यूटोरियल कि एकल GPU पर Qwen3.5 को लोकली कैसे चलाएँ शामिल हैं।
टॉप DataCamp कोर्स
कोर्स
कोर्स
अभ्यास और ट्रैक अपनी प्रगति को।
Google के साथ जारी रखें