
Last chance! 50% off DataCamp Premium
Sale ends in
लॉजिस्टिक रिग्रेशन मॉडल ट्रेन करने के बाद, आप कैसे सुनिश्चित करें कि आप गुणांकों पर भरोसा कर सकते हैं?
लॉजिस्टिक रिग्रेशन अपनी सरलता के लिए जाना जाता है। scikit-learn के साथ आप .fit() कॉल करते हैं, ऑड्स रेशियो पढ़ लेते हैं, और बस। लेकिन ज्यादातर शुरुआती यह नहीं जानते कि इस मॉडल की अपनी मान्यताएँ होती हैं, और जब आप उन्हें न मानें, तो गुणांक भटका सकते हैं और भविष्यवाणियाँ ऐसे तरीकों से गलत हो सकती हैं जिनका कोई टेस्ट मैट्रिक इशारा नहीं करेगा।
सच कहा जाए तो लॉजिस्टिक रिग्रेशन की मान्यताएँ रैखिक रिग्रेशन से कम होती हैं, और जो होती भी हैं, उन्हें जाँचना आसान है। आउटपुट की व्याख्या करने से पहले सही डायग्नोस्टिक्स चलाने की जरूरत है ताकि आपको पता रहे कि मॉडल के किन भागों पर भरोसा करना है।
इस लेख में, मैं आपको लॉजिस्टिक रिग्रेशन की हर मान्यता के बारे में बताऊँगा, Python और R में उन्हें कैसे जाँचे, उल्लंघन होने पर क्या होता है, और जब मान्यताएँ पूरी न हों तो किन विकल्पों का सहारा लें।
यदि आप डेटा साइंस और मशीन लर्निंग में नए हैं, तो हमारी ब्लॉग पोस्ट Simple Linear Regression पढ़ें ताकि उसकी मान्यताओं और डायग्नोस्टिक्स को समझ सकें।
लॉजिस्टिक रिग्रेशन एक क्लासीफिकेशन मॉडल है जो श्रेणीगत परिणाम की प्रायिकता का अनुमान लगाता है। आप इसे प्रेडिक्टर्स देते हैं, और यह 0 और 1 के बीच एक संख्या लौटाता है जिसे किसी दी गई श्रेणी में आने की प्रायिकता के रूप में पढ़ा जा सकता है।
अधिकांश लोग इसे बाइनरी क्लासीफिकेशन जैसे चर्न या नो-चर्न, स्पैम या नॉन-स्पैम के लिए इस्तेमाल करते हैं। मल्टीनोमियल और ऑर्डिनल लॉजिस्टिक रिग्रेशन जैसे वेरिएंट दो से अधिक श्रेणियों को कवर करते हैं, लेकिन जब लोग "लॉजिस्टिक रिग्रेशन" कहते हैं तो अक्सर बाइनरी मामले का ही मतलब होता है।
अंदर ही अंदर, मॉडल आपके प्रेडिक्टर्स का एक रैखिक संयोजन फिट करता है और परिणाम को लॉजिस्टिक फ़ंक्शन से गुजारता है। आउटपुट एक प्रायिकता है, और गुणांक बताते हैं कि हर प्रेडिक्टर लॉग-ऑड्स को कैसे शिफ्ट करता है।
यह ध्यान देने योग्य है कि लॉजिस्टिक रिग्रेशन, रैखिक रिग्रेशन से अलग है। बाद वाले में अवशेषों की सामान्यता, होमोस्डेस्टीसिटी, प्रेडिक्टर्स और टार्गेट के बीच रैखिकता जैसी परिचित मान्यताएँ होती हैं। लॉजिस्टिक रिग्रेशन ये मान्यताएँ नहीं मानता। इसकी अपनी सूची है, और वे इतनी अलग हैं कि रैखिक रिग्रेशन की मान्यताओं का उपयोग करने से भ्रामक नतीजे मिलेंगे।
लॉजिस्टिक रिग्रेशन पर अधिक विवरण के लिए हमारी ब्लॉग पोस्ट देखें जिसमें Python में इम्प्लीमेंटेशन दिखाया गया है।
मान्यताएँ इसलिए मायने रखती हैं क्योंकि वे सीधे इस बात से जुड़ी हैं कि आप मॉडल के साथ क्या करते हैं।
यदि आप मान्यताओं का सम्मान करते हैं, तो गुणांक वही मतलब रखते हैं जो आप सोचते हैं। जो ऑड्स रेशियो आप पढ़ते हैं वे वैध हैं, और मॉडल की प्रायिकताएँ वास्तविक परिणामों से अच्छी तरह मैप होती हैं। जब मान्यताएँ नहीं मानी जातीं, तो यह सब डगमगा जाता है, ऐसे तरीकों से जिन्हें कन्फ्यूजन मैट्रिक्स या कोई और मैट्रिक नहीं दिखाएगा।
अच्छी बात यह है कि उल्लंघन बाइनरी नहीं होते। मान लें, लॉजिट की रैखिकता से हल्का विचलन आपके मॉडल को बेकार नहीं बना देगा। इसका मतलब सिर्फ इतना है कि आपके ऑड्स रेशियो थोड़े गलत हैं और आपकी भविष्यवाणियाँ जितनी अच्छी हो सकती थीं उससे कमतर होंगी। बहुत से प्रोडक्शन मॉडल अपूर्ण मान्यता-जाँच के साथ चलते हैं, और यह ठीक है।
जो आप नहीं करना चाहते, वह है इन जाँचों को छोड़ना। डायग्नोस्टिक्स के बिना, आप यह नहीं बता पाएँगे कि समस्या छोटी है या बड़ी—जब तक कि भविष्यवाणियाँ गलत न होने लगें।
हर मान्यता में जाने से पहले, यहाँ पूरी सूची है जिसे आपको जाँचना होगा।
| मान्यता | यह क्या अपेक्षा करती है | सामान्य डायग्नोस्टिक |
|---|---|---|
| स्वतंत्र प्रेक्षण | कोई रिकॉर्ड दूसरे रिकॉर्ड को प्रभावित न करे | अध्ययन डिज़ाइन, इंट्रा-क्लास कोरिलेशन |
| उपयुक्त आउटकम वेरिएबल | बाइनरी, या सही वेरिएंट से मॉडल किया गया | टार्गेट का निरीक्षण |
| लॉजिट की रैखिकता | प्रेडिक्टर्स का लॉग-ऑड्स में रैखिक होना | बॉक्स-टिडवेल टेस्ट, स्प्लाइन्स |
| कठोर मल्टिकॉलीनियरिटी न हो | प्रेडिक्टर्स में प्रबल सहसम्बंध न हो | VIF, कोरिलेशन मैट्रिक्स |
| पर्याप्त नमूना आकार | प्रति वेरिएबल पर्याप्त इवेंट्स | EPV thumb-rule |
| प्रभावशाली आउटलायर्स न हों | कोई एकल रिकॉर्ड फिट को न मोड़े | कुक्स डिस्टेंस, लीवरेज |
लॉजिस्टिक रिग्रेशन मान्यताओं की तालिका
यही पूरी चेकलिस्ट है। आगे, मैं हर मान्यता पर Python और R में डायग्नोस्टिक्स के साथ चलूँगा—उल्लंघन कैसा दिखता है, और कुछ गलत हो तो क्या करना है।
मानक लॉजिस्टिक रिग्रेशन बाइनरी आउटकम के लिए बना है। टार्गेट वेरिएबल में ठीक दो श्रेणियाँ होनी चाहिए, और मॉडल उसी केस के इर्द-गिर्द डिज़ाइन किया गया है।
क्लासिक उदाहरण हैं—चर्न या नो-चर्न, बीमारी या नहीं। कोई भी चीज़ जिसे आप हाँ/नहीं सवाल में बाँट सकें, अच्छा फिट है।
जब आपका आउटकम दो से अधिक श्रेणियों वाला हो, तो अलग वेरिएंट चाहिए। मल्टीनोमियल लॉजिस्टिक रिग्रेशन बिना क्रम वाली श्रेणियों (जैसे कस्टमर सेगमेंट, उत्पाद प्रकार) को संभालता है। ऑर्डिनल लॉजिस्टिक रिग्रेशन क्रम वाली श्रेणियों (जैसे 1 से 5 तक सैटिस्फैक्शन स्कोर) को संभालता है, जहाँ स्तरों का क्रम मायने रखता है।
मल्टी-क्लास आउटकम को बाइनरी मॉडल में ठूँसना सामान्यतः उन श्रेणियों को समेट देना होता है जिन्हें नहीं समेटना चाहिए। यदि आपके पास पाँच स्तरों वाला सैटिस्फैक्शन टार्गेट है और आप उसे "संतुष्ट बनाम असंतुष्ट" में काट देते हैं, तो आप जानकारी खो देते हैं जो आपके मॉडल की मदद कर सकती थी। अपने टार्गेट के स्वरूप से मेल खाने वाला वेरिएंट चुनें।
आपके डेटासेट की हर पंक्ति मॉडल को ऐसी जानकारी दे जो कोई और पंक्ति पहले से न देती हो। यदि दो रिकॉर्ड ऐसे जुड़े हैं कि यह शर्त टूटती है, तो आपके स्टैंडर्ड एरर और p-वैल्यूज वैसा अर्थ नहीं रखते जैसा उन्हें रखना चाहिए।
यह मान्यता तब टूटती है जब प्रेक्षण कोई साझा संरचना रखते हैं जिसे आपने मॉडल नहीं किया। एक अच्छा उदाहरण है—एक ही मरीज पर दोहराए गए माप, क्योंकि वे उस मरीज की बायोलॉजी साझा करते हैं। दूसरा उदाहरण है—एक ही कक्षा में समूहित छात्र, क्योंकि वे शिक्षक और कमरे को साझा करते हैं।
इसे अनदेखा कर के सादा लॉजिस्टिक रिग्रेशन फिट करने पर, मॉडल हर पंक्ति को नई जानकारी मानता है और स्टैंडर्ड एरर को जरूरत से ज्यादा घटा देता है। गुणांक सतह पर ठीक दिख सकते हैं, लेकिन p-वैल्यू और कॉन्फिडेंस इंटरवल अति-आत्मविश्वासी होंगे।
मानक विकल्प हैं—मिक्स्ड-इफेक्ट्स लॉजिस्टिक रिग्रेशन और GEE। मिक्स्ड-इफेक्ट्स मॉडल समूहों (मरीज, कक्षा) के लिए रैंडम इफेक्ट्स जोड़ते हैं ताकि मॉडल within-group कोरिलेशन को सम्हाले। GEE, यानी generalized estimating equations, बिना रैंडम-इफेक्ट्स तामझाम के करेक्टेड स्टैंडर्ड एरर के साथ पॉपुलेशन-एवरेज्ड इफेक्ट्स देता है।
जब आपको within-group भिन्नता मायने रखती है तो मिक्स्ड-इफेक्ट्स चुनें। जब पूरे पॉपुलेशन पर मार्जिनल इफेक्ट्स चाहिए हों तो GEE चुनें।
यह वह मान्यता है जिसे लोग लॉजिस्टिक रिग्रेशन के बारे में सबसे ज्यादा गलत समझते हैं।
मॉडल यह नहीं मानता कि आपके प्रेडिक्टर्स का आउटकम से रैखिक संबंध है। यह मानता है कि उनका संबंध आउटकम के लॉग-ऑड्स से रैखिक है। यह अलग कथन है, और यह बदल देता है कि आपको क्या जाँचना चाहिए।
लॉजिट, ऑड्स का नेचुरल लॉगरिद्म है। किसी प्रायिकता p के लिए ऑड्स हैं p / (1 - p), और लॉजिट उस अनुपात का लॉग है:
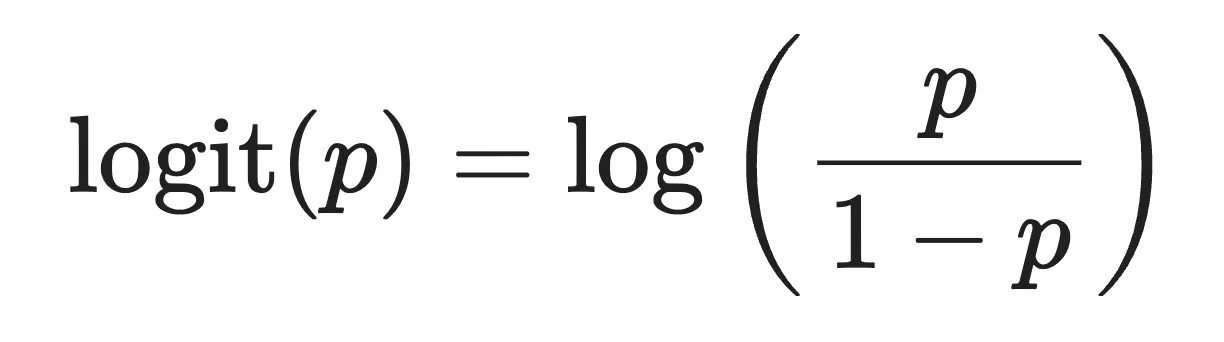
लॉजिट
इसके बाद लॉजिस्टिक रिग्रेशन इस स्केल पर एक रैखिक समीकरण फिट करता है:
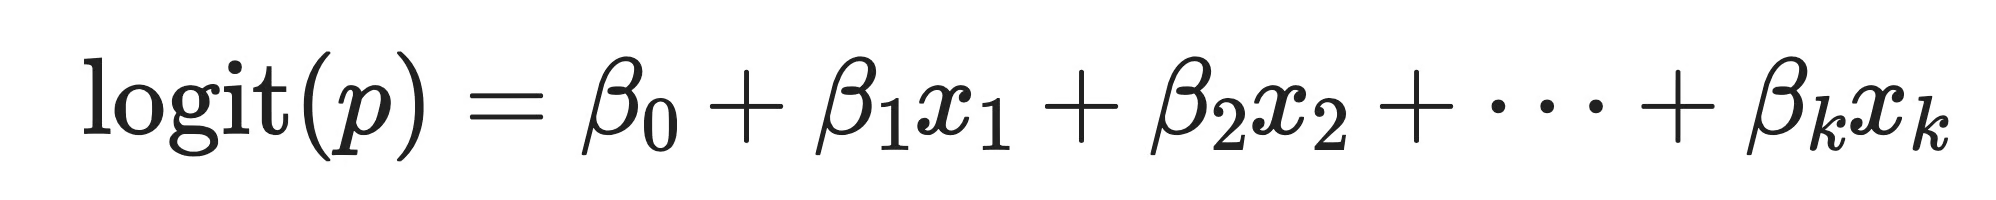
लॉजिस्टिक रिग्रेशन का सूत्र
दायाँ भाग प्रेडिक्टर्स में रैखिक है। बायाँ भाग लॉग-ऑड्स है, प्रायिकता नहीं। जो प्रायिकता आपको वास्तव में चाहिए, वह इस रैखिक संयोजन को लॉजिस्टिक फ़ंक्शन से गुजराकर मिलती है, जो नॉन-लिनियर है।
इसलिए किसी भी प्रेडिक्टर और प्रायिकता के बीच संबंध नॉन-लिनियर होता है। किसी भी प्रेडिक्टर और लॉग-ऑड्स के बीच संबंध रैखिक होना चाहिए।
जब किसी प्रेडिक्टर के लिए लॉजिट की रैखिकता नहीं टिकती, तो उस प्रेडिक्टर पर गुणांक एक वक्र को एक सीधी रेखा से समेट देता है। मॉडल तब भी एक संख्या देता है, और वह संख्या सांख्यिकीय रूप से महत्वपूर्ण भी हो सकती है, लेकिन वह आपके डेटा में वास्तविक संबंध का वर्णन नहीं करती।
age उदाहरण के लिए किसी बीमारी के लॉग-ऑड्स पर U-आकार का प्रभाव रख सकती है—दोनों छोरों पर जोखिम ज्यादा और बीच में कम। यदि आप age को एक ही रैखिक टर्म के रूप में डालते हैं, तो गुणांक शून्य के करीब आ सकता है और आप निष्कर्ष निकालेंगे कि उम्र मायने नहीं रखती। असल में रखती है। स्पेसिफिकेशन गलत है।
इस मान्यता की जाँच के कुछ तरीके हैं।
सबसे तेज़ जाँच है विजुअल इन्स्पेक्शन। हर सतत प्रेडिक्टर को डेसाइल्स में बाँटें, हर बिन में एम्पिरिकल लॉग-ऑड्स निकालें, और उसे प्रेडिक्टर के विरुद्ध प्लॉट करें। मोटे तौर पर सीधी रेखा का मतलब मान्यता टिकती है। साफ़ वक्र का मतलब यह नहीं टिकती। जाँच अनौपचारिक है लेकिन तब अच्छी काम करती है जब हर बिन में पर्याप्त डेटा हो।
बॉक्स-टिडवेल टेस्ट हर सतत प्रेडिक्टर और उसके अपने नेचुरल लॉग के बीच एक इंटरैक्शन टर्म जोड़ता है। यदि इंटरैक्शन सांख्यिकीय रूप से महत्वपूर्ण हो, तो उस प्रेडिक्टर के लिए लॉजिट की रैखिकता का उल्लंघन है। टेस्ट सिर्फ सख्ती से पॉजिटिव प्रेडिक्टर्स पर काम करता है (क्योंकि आप शून्य या ऋणात्मक का लॉग नहीं ले सकते), और किसी भी सिग्निफिकेंस टेस्ट की तरह यह सैम्पल साइज के प्रति संवेदनशील है।
स्प्लाइन्स एक और विकल्प हैं। रैखिकता टिकती है या नहीं यह जाँचने के बजाय, आप रैखिक टर्म की जगह एक लचीला बेसिस फ़ंक्शन (जैसे रेस्ट्रिक्टेड क्यूबिक स्प्लाइन) रखते हैं, और मॉडल को जरूरी आकार फिट करने देते हैं। यदि स्प्लाइन, रैखिक टर्म से काफी बेहतर फिट होती है (लाइकलीहुड रेशियो या AIC से आँका गया), तो आपके पास प्रमाण है कि रैखिक स्पेसिफिकेशन बहुत प्रतिबंधात्मक था। स्प्लाइन्स समाधान के रूप में भी काम करती हैं। जब रैखिकता फेल हो, उन्हें अंतिम मॉडल में रखना अक्सर सबसे अच्छा जवाब होता है।
यदि किसी प्रेडिक्टर के लिए मान्यता फेल हो, तो आपके पास कुछ विकल्प हैं:
दोनों ही आपको लॉजिस्टिक रिग्रेशन परिवार में रखते हैं, और दोनों किसी सूचनाप्रद प्रेडिक्टर को बाहर करने से बेहतर हैं।
लॉजिस्टिक रिग्रेशन एक सीमा तक सहसम्बद्ध प्रेडिक्टर्स को संभाल लेता है। उसके बाद मॉडल ऐसे तरीके से खराब बर्ताव करने लगता है जिन्हें किसी टेस्ट मैट्रिक से पकड़ना मुश्किल है।
मल्टिकॉलीनियरिटी तब होती है जब दो या अधिक प्रेडिक्टर्स में समान (या बहुत मिलती-जुलती) जानकारी हो। मसलन, आपने एक ही मॉडल में इंच और सेंटीमीटर में हाइट डाल दी। या टोटल रेवेन्यू और रेवेन्यू-पर-कस्टमर के साथ कस्टमर काउंट भी शामिल कर दिया।
मल्टिकॉलीनियरिटी होने पर दो बातें गलत होती हैं:
भविष्यवाणियाँ आम तौर पर ठीक रहती हैं। यदि आप सिर्फ प्रेडिक्टेड प्रायिकता की परवाह करते हैं, तो हल्की से मध्यम मल्टिकॉलीनियरिटी शायद ही समस्या बनती है। “नुकसान” मुख्यतः गुणांकों और उन पर आपकी इनफ़रेंस में केंद्रित रहता है।
दो जाँचें हैं—कोरिलेशन मैट्रिक्स और वेरिएंस इन्फ्लेशन फैक्टर (VIF)। कोरिलेशन मैट्रिक्स सबसे पहले देखें, खासकर वे जोड़े जिनका सहसम्बंध परिमाण में 0.8 या 0.9 से ऊपर हो। कमी यह है कि यह केवल पेयरवाइज़ कोलिनियरिटी पकड़ता है, न कि वह केस जहाँ तीन या अधिक प्रेडिक्टर्स सामूहिक रूप से अनावश्यक हों।
VIF मल्टी-वे केस के लिए है। हर प्रेडिक्टर के लिए, VIF मापता है कि बाकी प्रेडिक्टर्स के साथ कोलिनियरिटी के कारण उसके गुणांक के वेरिएंस में कितना इन्फ्लेशन है। VIF = 1 का मतलब कोई कोलिनियरिटी नहीं, 5 तक के मान आम तौर पर ठीक, और 10 से ऊपर के मान यह प्रबल संकेत देते हैं कि प्रेडिक्टर मॉडल के अन्य प्रेडिक्टर्स के साथ अनावश्यक है।
जब VIF कुछ फ़्लैग करे, तो सबसे आसान उपाय है किसी एक कोलिनियर प्रेडिक्टर को हटा देना या उन्हें जोड़-घटा कर एक ही फीचर (जैसे योग या अनुपात) बना देना। यदि आप सभी प्रेडिक्टर्स रखना चाहते हैं, तो रेग्युलराइज़ेशन (रिज या इलास्टिक नेट) गुणांकों को स्थिर करता है बिना आपको चयन करने पर मजबूर किए।
लॉजिस्टिक रिग्रेशन छोटे सैंपल पर भी काम करता है, लेकिन कुछ हद तक अविश्वसनीय हो सकता है। गुणांक जरूरत से ज्यादा झूलते हैं, और रेयर-क्लास इफेक्ट्स का आकलन लगभग असंभव हो जाता है।
लॉजिस्टिक रिग्रेशन के लिए जो नमूना आकार मायने रखता है वह कुल पंक्तियों की संख्या नहीं, बल्कि इवेंट्स (माइनॉरिटी क्लास की ऑब्जर्वेशन्स) की संख्या है। 100,000 पंक्तियों और 50 फ्रॉड केस वाला डेटासेट छोटे-सैंपल की समस्या है, क्योंकि मॉडल के पास वही 50 उदाहरण हैं जिससे उसे सीखना है।
यहीं इवेंट्स-पर-वेरिएबल (EPV) आता है। EPV = माइनॉरिटी क्लास ऑब्जर्वेशन्स की संख्या ÷ मॉडल के प्रेडिक्टर्स की संख्या। यदि आपके पास 50 फ्रॉड केस और 10 प्रेडिक्टर्स हैं, तो आपका EPV = 5 है।
पुराना thumb-rule था कि EPV कम-से-कम 10 हो। हाल की सिमुलेशन स्टडीज़ ने दिखाया कि सही संख्या आपके डेटा के इफेक्ट-साइज़ और आपके द्वारा उपयोग किए गए रेग्युलराइज़ेशन पर निर्भर करती है। कुछ सेटिंग्स में 5 तक का EPV भी ठीक हो सकता है, और कुछ में 20 या उससे अधिक चाहिए।
टेकअवे: EPV को चेतावनी-सूचना की तरह लें। 10 से नीचे, अस्थिर अनुमानों की अपेक्षा करें और Firth की लॉजिस्टिक रिग्रेशन या रिज जैसे पेनलाइज़्ड तरीकों पर विचार करें। 5 से नीचे, अधिक डेटा लें या मॉडल सरल करें, इससे पहले कि किसी व्यक्तिगत गुणांक पर भरोसा करें।
क्लास असंतुलन इससे संबंधित है, मगर अलग समस्या है।
ऐसा डेटासेट जहाँ 99% केस एक ही क्लास के हों, तब भी एब्सोल्यूट टर्म्स में पर्याप्त इवेंट्स-पर-वेरिएबल रख सकता है। जो बदलता है वह आउटकम का बेस रेट है, न कि EPV। इम्बैलेंस्ड डेटा आमतौर पर कंज़र्वेटिव प्रायिकता अनुमान देता है, और एक्युरेसी बेकार मैट्रिक बन जाती है। इससे निपटने के लिए, एक्युरेसी की जगह log-loss या Brier score से इवैल्युएट करें, और यदि बैलेंस्ड डिसीज़न चाहिए हों तो क्लास वेट्स या थ्रेशहोल्ड ट्यूनिंग पर विचार करें।
लॉजिस्टिक रिग्रेशन यह नहीं मानता कि आपके प्रेडिक्टर्स सामान्य-वितरित हैं। स्क्यूड प्रेडिक्टर्स और काउंट वेरिएबल्स अपने-आप में ठीक हैं। मॉडल को जिस चीज़ की परवाह है, वह है—क्या कोई एकल ऑब्जर्वेशन फिट किए गए गुणांकों पर अनुपातहीन प्रभाव डाल रहा है।
एक प्रभावशाली प्रेक्षण वह है जिसे हटाने पर मॉडल में अर्थपूर्ण बदलाव आ जाए। यह अवशेष आउटलायर जैसा नहीं है। किसी बिंदु का अवशेष बड़ा हो सकता है (मॉडल उसे खराब प्रेडिक्ट करता है) बिना प्रभावशाली हुए, और कोई बिंदु बहुत प्रभावशाली हो सकता है (मॉडल उस पर बहुत निर्भर है) बिना बड़े अवशेष के।
आपको प्रभाव के अलग-अलग पहलुओं को देखने वाले कुछ डायग्नोस्टिक्स चाहिए:
जब आप प्रभावशाली बिंदु पाएँ, सवाल यह है कि बिंदु वास्तविक है या गलत। डेटा-एंट्री त्रुटि को ठीक करें या हटा दें। वास्तविक पर असामान्य केस को रखें, और नोट करें कि आपके निष्कर्ष उस पर निर्भर हैं। केवल इसलिए बिंदुओं को न निकालें कि वे प्रभावशाली हैं—ऐसा करने से आप ऐसे मॉडल पर पहुँचते हैं जो सिर्फ ट्रेनिंग डेटा पर फिट होता है और कहीं नहीं।
लॉजिस्टिक रिग्रेशन की मान्यताओं के बारे में ज्यादातर भ्रम रैखिक रिग्रेशन की चेकलिस्ट के उपयोग से आता है। रैखिक रिग्रेशन की मान्यताएँ प्रसिद्ध हैं और हर जगह पढ़ाई जाती हैं, और वे लॉजिस्टिक रिग्रेशन में वहाँ भी घुस आती हैं जहाँ उनका स्थान नहीं। यहाँ चार सबसे सामान्य भ्रांतियाँ दूर कर रहे हैं।
यह गलत है। लॉजिस्टिक रिग्रेशन मॉडल में किसी भी वेरिएबल पर सामान्यता की कोई मान्यता नहीं है।
आउटकम सामान्य नहीं, बल्कि बाइनरी होना चाहिए—जिसे हमने मान्यता 1 में कवर किया है। प्रेडिक्टर्स पर भी सामान्यता की मान्यता नहीं है, वे डेटा के किसी भी आकार के हो सकते हैं। मायने यह रखता है कि प्रेडिक्टर्स और लॉग-ऑड्स के बीच संबंध कैसा है, न कि किसी एक वेरिएबल का मार्जिनल वितरण।
यह भी गलत है। होमोस्डेस्टीसिटी (प्रेडिक्टेड मानों की रेंज में अवशेषों का स्थिर वैरिएंस) रैखिक रिग्रेशन की मान्यता है, जो लॉजिस्टिक रिग्रेशन पर लागू नहीं होती।
लॉजिस्टिक रिग्रेशन में आउटकम का वैरिएंस स्वयं प्रेडिक्टेड प्रायिकता पर निर्भर करता है। बर्नौली आउटकम के लिए वैरिएंस p(1 - p) के बराबर होता है—जो p = 0.5 के पास सबसे ज्यादा और 0 व 1 के पास सबसे कम होता है। वैरिएंस स्थिर नहीं है, और मॉडल इसे अपने अधिकतम-सम्भाव्यता (likelihood) के जरिए सम्हालता है।
इसलिए लॉजिस्टिक रिग्रेशन फिट करते समय अलग-अलग वैरिएंस वाली प्रेडिक्टेड प्रायिकताएँ होना कोई उल्लंघन नहीं—यही मॉडल का स्वभाव है।
यह गलत है। लॉजिस्टिक रिग्रेशन प्रेडिक्टर्स पर कोई वितरणात्मक मान्यता नहीं रखता।
आप एक ही मॉडल में सतत, बाइनरी, काउंट और श्रेणीगत प्रेडिक्टर्स मिला सकते हैं। स्क्यूड प्रेडिक्टर्स ठीक हैं। हैवी-टेल्ड प्रेडिक्टर्स भी ठीक हैं। मॉडल को मार्जिनल शेप्स से फर्क नहीं पड़ता। इसे केवल लॉजिट की रैखिकता (मान्यता 3) की परवाह है, जो संबंध-आकार की मान्यता है, न कि वितरण-आकार की।
यदि किसी प्रेडिक्टर का स्क्यू समस्या बनता है, तो आमतौर पर वजह लॉजिट की रैखिकता या प्रभावशाली आउटलायर्स होती है।
यह गलत है। लॉजिस्टिक रिग्रेशन के अवशेषों पर सामान्यता की कोई मान्यता नहीं है।
रैखिक रिग्रेशन मानता है कि अवशेष शून्य के आसपास सामान्य-वितरित हैं—क्योंकि उसकी इनफ़रेंस का यह हिस्सा है। लॉजिस्टिक रिग्रेशन बाइनोमियल likelihood पर अधिकतम-सम्भाव्यता का उपयोग करता है, और उसके अवशेषों का वितरण आउटकम (जो 0 या 1 होता है) और फिटेड प्रायिकता से तय होता है। वे सामान्य-वितरित नहीं होते, न होने चाहिए।
इसलिए जब आप लॉजिस्टिक रिग्रेशन के लिए अवशेष डायग्नोस्टिक्स जाँचते हैं (मान्यता 6 में), तो आप घंटी-वक्र नहीं, बल्कि प्रभावशाली प्रेक्षण और ऐसे बिंदु ढूँढ रहे होते हैं जिन्हें मॉडल समझा नहीं पा रहा।
मैं डायग्नोस्टिक्स statsmodels से करूँगा। Scikit-learn लॉजिस्टिक रिग्रेशन फिट करता है, पर VIF, इन्फ्लुएंस स्टैटिस्टिक्स या अवशेष डायग्नोस्टिक्स आउट-ऑफ-द-बॉक्स नहीं देता।
मैं तीन प्रेडिक्टर्स (age, income, spending score) के साथ एक सिंथेटिक चर्न डेटासेट जनरेट करूँगा, जहाँ age और income को जानबूझकर सहसम्बद्ध रखा जाएगा ताकि मल्टिकॉलीनियरिटी दिखे।
import numpy as np
import pandas as pd
import statsmodels.api as sm
import statsmodels.formula.api as smf

np.random.seed(42)
n = 1000

age = np.random.normal(40, 12, n).clip(18, 80)
income = 30000 + 1500 * age + np.random.normal(0, 8000, n)
spending_score = np.random.uniform(1, 100, n)
logit_p = -3 + 0.04 * age + 0.02 * spending_score
p = 1 / (1 + np.exp(-logit_p))
y = np.random.binomial(1, p)

df = pd.DataFrame({
    "churned": y,
    "age": age,
    "income": income,
    "spending_score": spending_score,
})

model = smf.glm(
    "churned ~ age + income + spending_score",
    data=df, family=sm.families.Binomial()
).fit()
print(model.summary())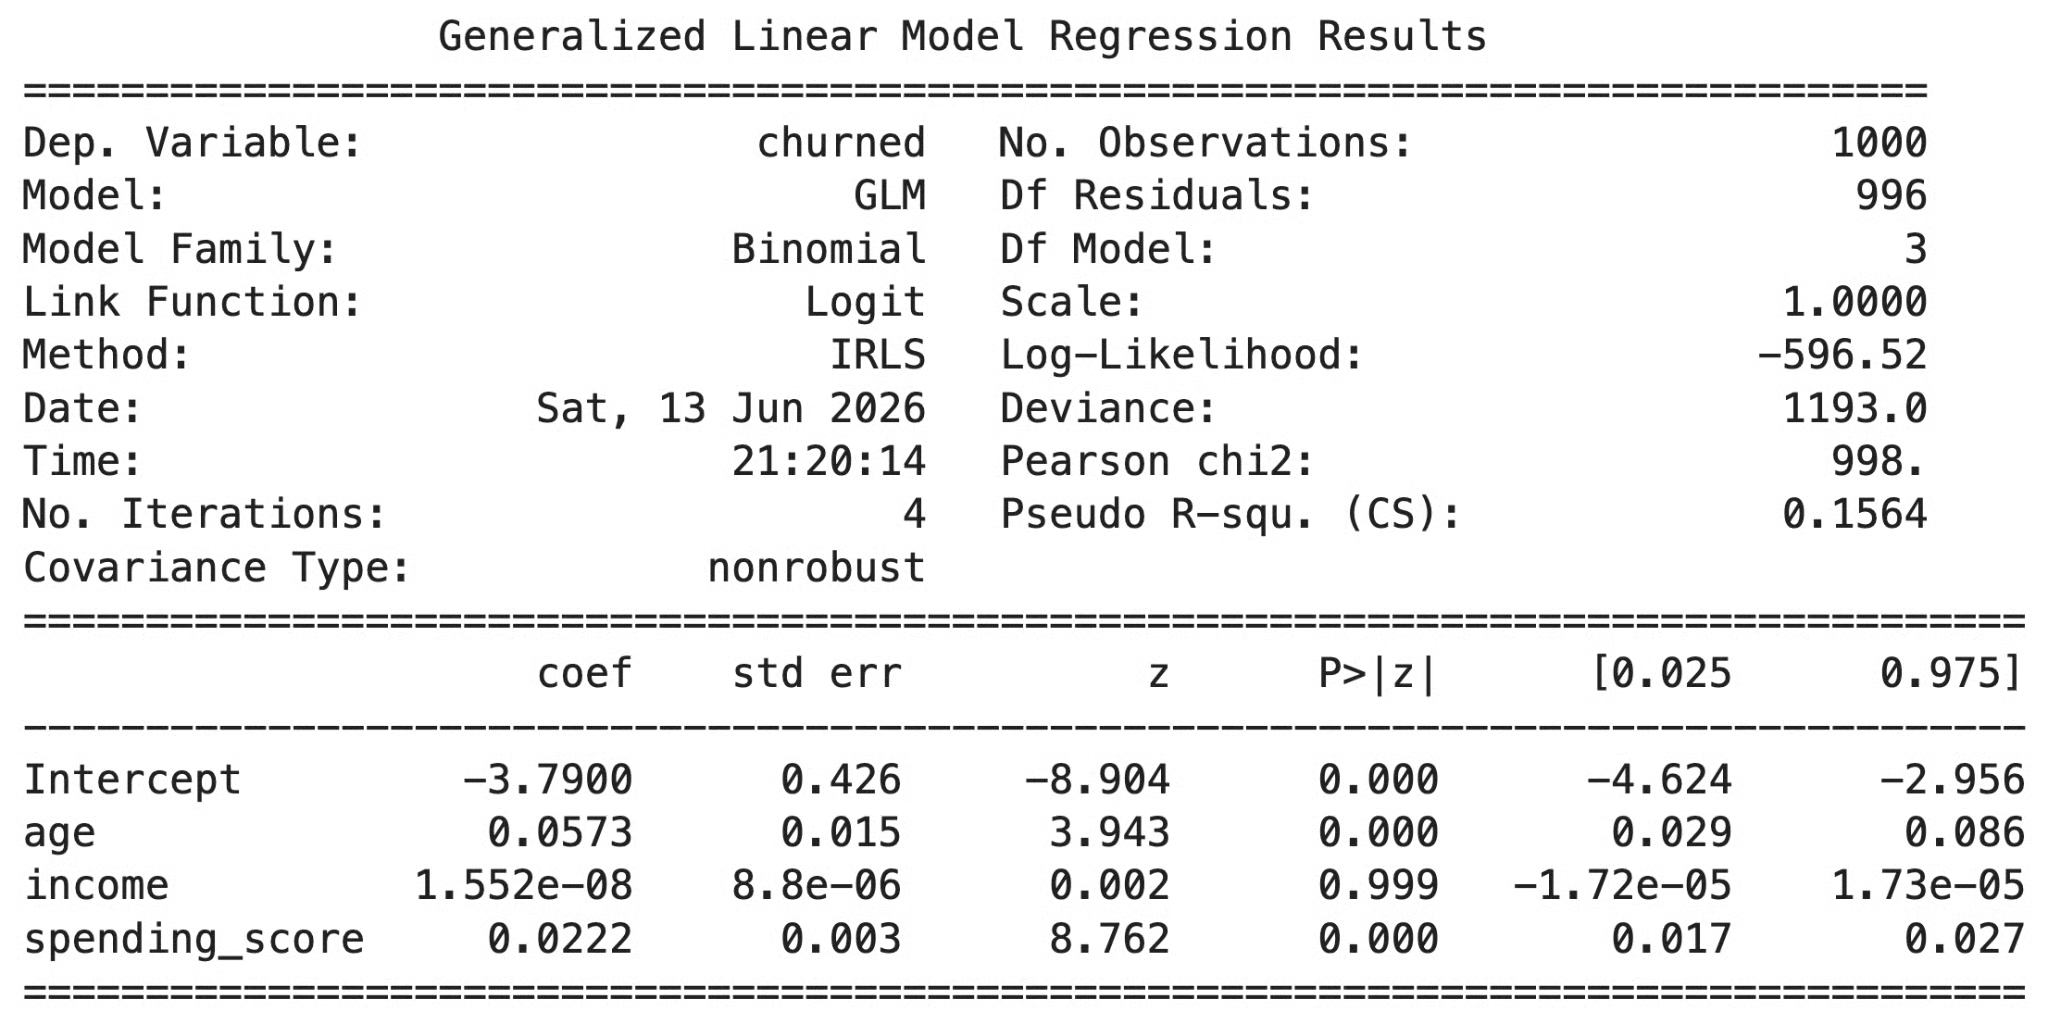
मॉडल सारांश
सारांश आपको गुणांक, स्टैंडर्ड एरर, z-स्टैटिस्टिक्स और p-वैल्यू देता है। age और spending_score अर्थपूर्ण प्रेडिक्टर्स के रूप में आते हैं। income का गुणांक छोटा है क्योंकि आउटकम सीधे income पर निर्भर नहीं करता—उसका प्रकट प्रभाव age सोख लेता है।
Statsmodels यह गणना बेहद आसान बना देता है:
from statsmodels.stats.outliers_influence import variance_inflation_factor

X = sm.add_constant(df[["age", "income", "spending_score"]])
vif = pd.DataFrame({
    "feature": X.columns,
    "VIF": [variance_inflation_factor(X.values, i) for i in range(X.shape[1])]
})
print(vif[vif["feature"] != "const"])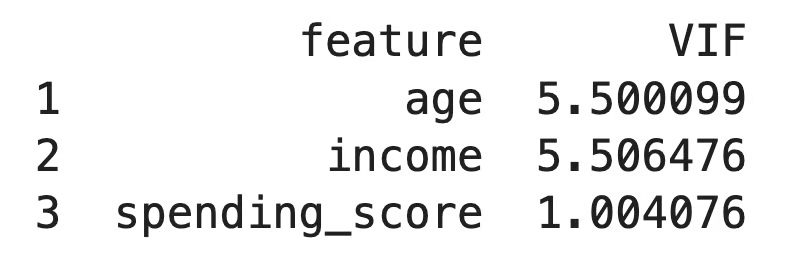
VIF आउटपुट
age और income के VIF लगभग 5.5 आते हैं, जो हल्की मल्टिकॉलीनियरिटी दिखाते हैं। spending_score लगभग 1 आता है—यही आप चाहते हैं। इसका वेरिएंस दूसरों के साथ कोलिनियरिटी से फूला नहीं है। 5 से ऊपर VIF हल्का फ़्लैग है; 10 से ऊपर गंभीर समस्या है जिसे तुरंत सुलझाना चाहिए। यहाँ कदम होगा age या income में से एक को हटाना या उन्हें एक फीचर में मिलाना।
बॉक्स-टिडवेल टेस्ट हर सतत प्रेडिक्टर और उसके नेचुरल लॉग के बीच इंटरैक्शन टर्म जोड़ता है। महत्वपूर्ण इंटरैक्शन उस प्रेडिक्टर के लिए नॉन-लिनियर लॉग-ऑड्स संबंध को फ़्लैग करते हैं।
df_bt = df.copy()
for col in ["age", "income", "spending_score"]:
    df_bt[f"{col}_logx"] = df_bt[col] * np.log(df_bt[col])

bt_formula = (
    "churned ~ age + income + spending_score + "
    "age_logx + income_logx + spending_score_logx"
)
bt_model = smf.glm(
    bt_formula, data=df_bt, family=sm.families.Binomial()
).fit()

interactions = ["age_logx", "income_logx", "spending_score_logx"]
print(bt_model.pvalues[interactions])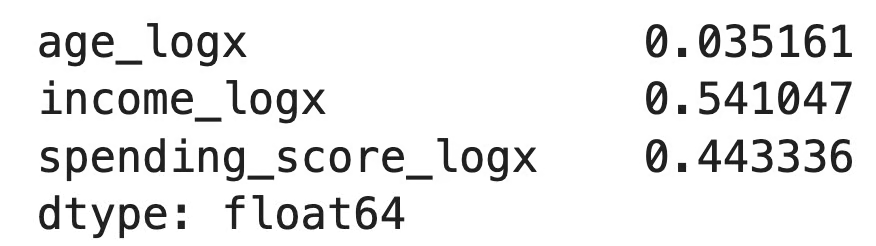
बॉक्स-टिडवेल आउटपुट
यदि इनमें से किसी p-वैल्यू का मान 0.05 से कम आता है, तो उस प्रेडिक्टर के लिए लॉजिट की रैखिकता संदिग्ध है। यहाँ लॉजिट रैखिक रूप से जनरेट किया गया था, अतः इंटरैक्शन महत्वपूर्ण नहीं आने चाहिए। वास्तविक डेटा पर, महत्वपूर्ण नतीजे को उस प्रेडिक्टर के विरुद्ध एम्पिरिकल लॉग-ऑड्स प्लॉट करने और यह तय करने के संकेत के रूप में लें कि ट्रांसफॉर्मेशन या स्प्लाइन उचित सुधार है।
Statsmodels get_influence() के जरिए कुक्स डिस्टेंस और लीवरेज तक पहुँच देता है।
influence = model.get_influence()
cooks_d = influence.cooks_distance[0]
leverage = influence.hat_matrix_diag

flagged = pd.DataFrame({
    "cooks_d": cooks_d,
    "leverage": leverage,
}).sort_values("cooks_d", ascending=False).head(10)
print(flagged)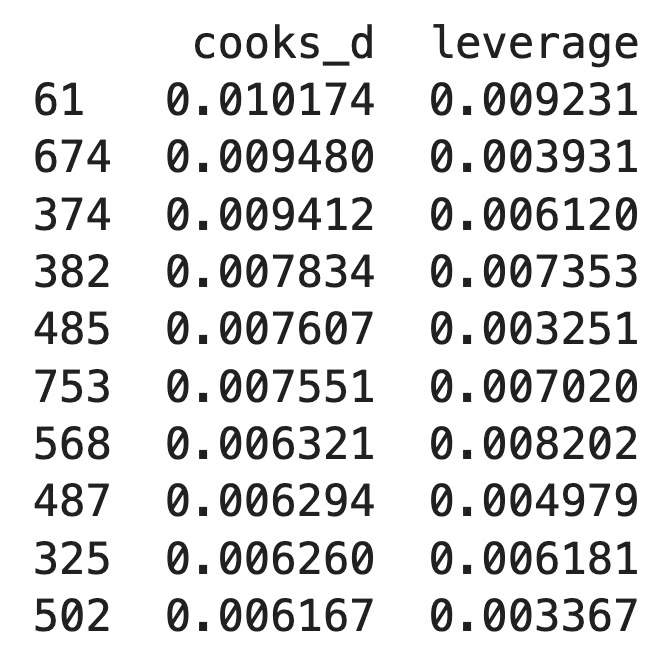
इन्फ्लुएंस डायग्नोस्टिक्स आउटपुट
कुक्स डिस्टेंस की जाँच-योग्य सीमा लगभग 4/n है। 1000 पंक्तियों के साथ, यह 0.004 है। इससे काफी ऊपर कुछ भी नज़दीकी जाँच चाहता है। इस डेटासेट में सबसे बड़े कुक्स डिस्टेंस भी एब्सोल्यूट टर्म्स में छोटे हैं—जो कि वह उबाऊ-पर-अच्छा नतीजा है जिसे आप आम तौर पर चाहते हैं।
अब मैं एक विज़ुअलाइज़ेशन बनाता हूँ ताकि वितरण पढ़ना आसान हो:
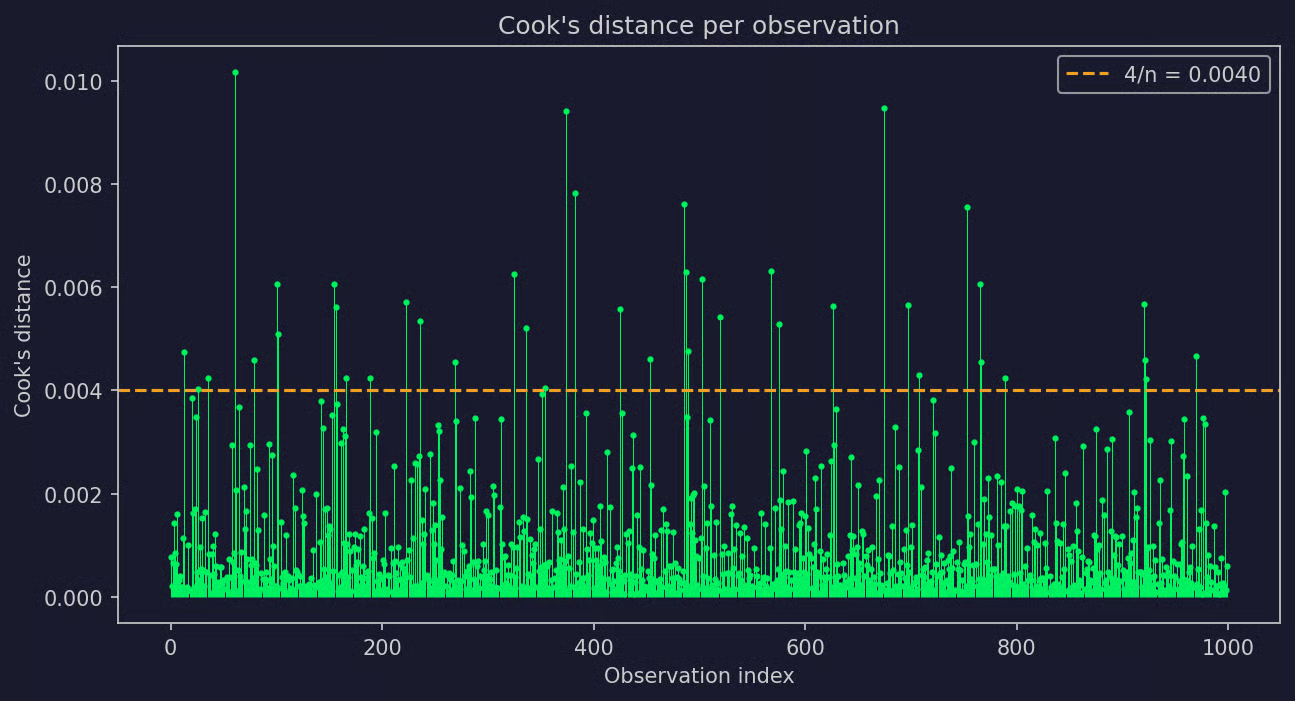
इन्फ्लुएंस डायग्नोस्टिक्स का दृश्य
डैश्ड थ्रेशहोल्ड से काफी ऊपर बैठे बिंदु जाँचने लायक हैं। कुछ हैं, पर बहुत ज्यादा नहीं।
डिविएंस रेजिडुअल्स बताते हैं कि किन प्रेक्षणों को मॉडल फिट करने में दिक्कत है।
deviance_resid = model.resid_deviance
fitted = model.fittedvalues

resid_df = pd.DataFrame({
    "fitted": fitted,
    "deviance": deviance_resid,
}).sort_values("deviance", key=abs, ascending=False).head(10)
print(resid_df)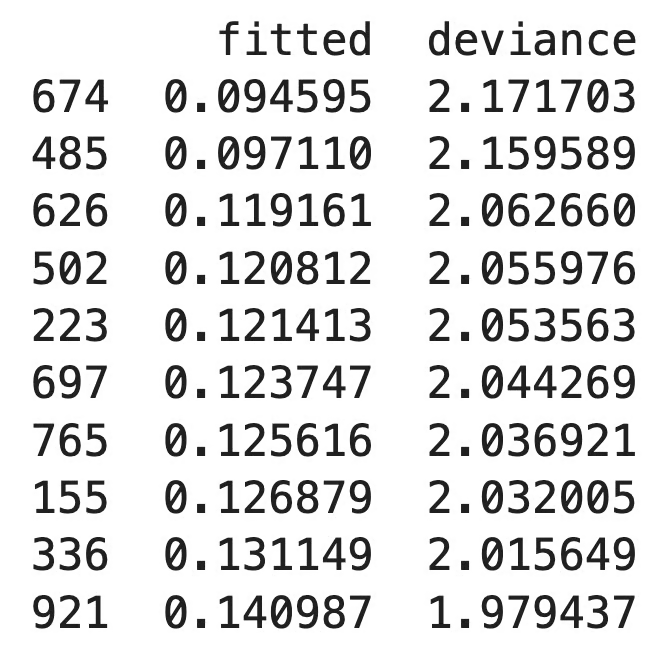
अवशेष डायग्नोस्टिक्स आउटपुट
बड़े पॉज़िटिव डिविएंस रेजिडुअल्स वे केस हैं जहाँ मॉडल ने कम प्रायिकता दी, पर वे वास्तव में पॉज़िटिव थे। बड़े नेगेटिव अवशेष इसका उलटा। ऊपर दिखाए इन्फ्लुएंस डायग्नोस्टिक्स के साथ उच्च-अवशेष प्रेक्षणों को क्रॉस-रेफरेंस करें। जो केस दोनों—खराब प्रेडिक्टेड और प्रभावशाली—है, वही सबसे ज्यादा जाँचने लायक है।
R में इन डायग्नोस्टिक्स के लिए बेहतर बिल्ट-इन सपोर्ट है। जो कुछ आपको चाहिए, उसका अधिकतर हिस्सा बेस R के glm() और car पैकेज से मिल जाता है।
मैं Python उदाहरण जैसा ही सिंथेटिक डेटासेट बनाऊँगा, जिसके में age और income जानबूझकर सहसम्बद्ध होंगे।
set.seed(42)
n <- 1000

age <- pmin(pmax(rnorm(n, mean = 40, sd = 12), 18), 80)
income <- 30000 + 1500 * age + rnorm(n, sd = 8000)
spending_score <- runif(n, min = 1, max = 100)
logit_p <- -3 + 0.04 * age + 0.02 * spending_score
p <- 1 / (1 + exp(-logit_p))
churned <- rbinom(n, size = 1, prob = p)

df <- data.frame(churned, age, income, spending_score)

model <- glm(churned ~ age + income + spending_score,
             data = df, family = binomial)
summary(model)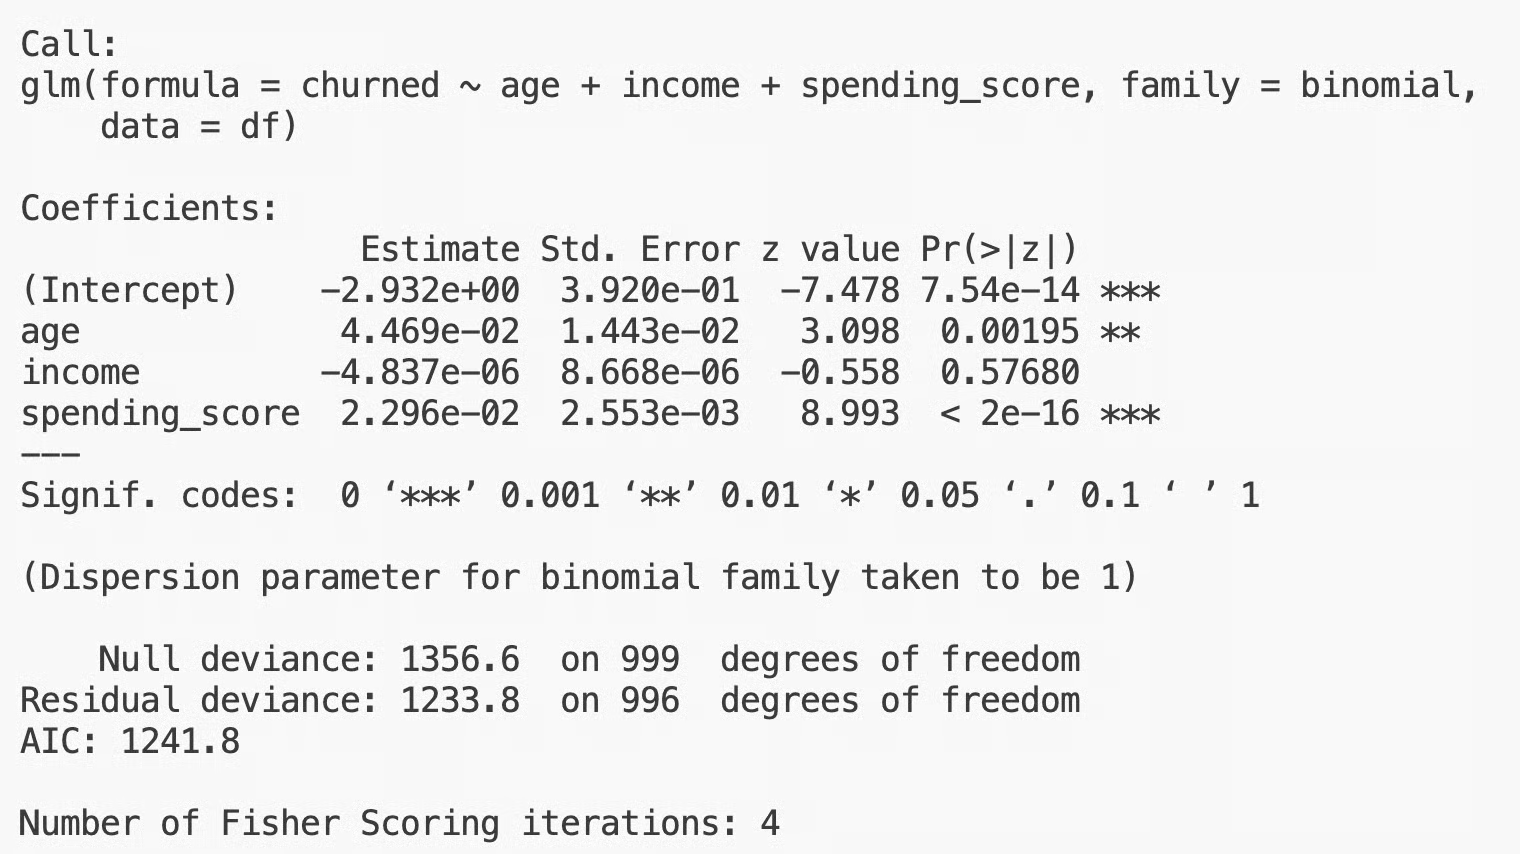
मॉडल सारांश आउटपुट
summary(model) आपको गुणांक, स्टैंडर्ड एरर, z-स्टैटिस्टिक्स और p-वैल्यू देता है। age और spending_score अर्थपूर्ण दिखने चाहिए, जबकि income का प्रभाव age सोख लेगा।
car पैकेज आपको किसी भी glm के लिए vif() देता है:
library(car)

vif(model)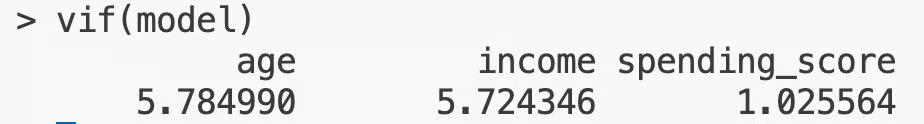
R में VIF आउटपुट
age और income दोनों के VIF लगभग 5.7 आएँगे, जो डेटा में गढ़ी मल्टिकॉलीनियरिटी दिखाते हैं। spending_score करीब 1 है। Python की तरह, 5 से ऊपर ध्यान देने योग्य और 10 से ऊपर स्पष्ट समस्या।
car::boxTidwell फ़ंक्शन रैखिक रिग्रेशन के लिए बना है, इसलिए लॉजिस्टिक रिग्रेशन में सबसे अच्छा तरीका है कि इंटरैक्शन टर्म्स मैन्युअली जोड़कर पुनः फिट करें:
df_bt <- df
df_bt$age_logx <- df_bt$age * log(df_bt$age)
df_bt$income_logx <- df_bt$income * log(df_bt$income)
df_bt$spending_score_logx <- df_bt$spending_score * log(df_bt$spending_score)

bt_model <- glm(
  churned ~ age + income + spending_score +
    age_logx + income_logx + spending_score_logx,
  data = df_bt, family = binomial
)

interactions <- c("age_logx", "income_logx", "spending_score_logx")
summary(bt_model)$coefficients[interactions, ]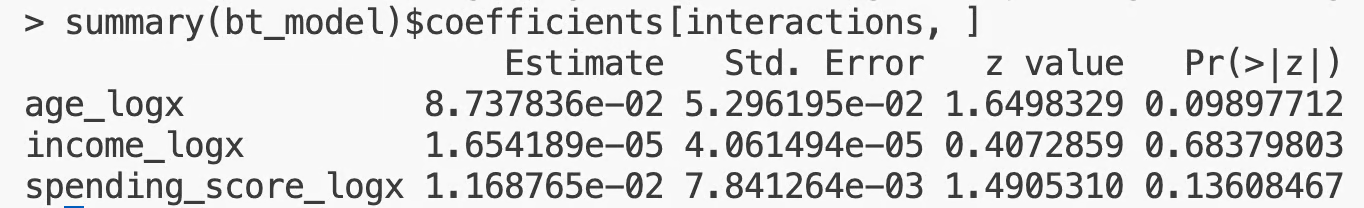
R में बॉक्स-टिडवेल आउटपुट
आउटपुट हर इंटरैक्शन टर्म का गुणांक और p-वैल्यू दिखाता है। महत्वपूर्ण p-वैल्यू उस प्रेडिक्टर के लिए लॉजिट की रैखिकता के उल्लंघन को फ़्लैग करते हैं। यहाँ सिंथेटिक डेटा में टेस्ट रैखिकता को खारिज नहीं करना चाहिए। वास्तविक डेटा पर, एम्पिरिकल लॉग-ऑड्स प्लॉट्स से फॉलो-अप करें या फ्लैग किए गए प्रेडिक्टर के लिए स्प्लाइन्स (splines पैकेज) के साथ मॉडल फिट करें।
R बेस में cooks.distance() और hatvalues() देता है, तो थर्ड-पार्टी पैकेज की ज़रूरत नहीं:
cooks_d <- cooks.distance(model)
leverage <- hatvalues(model)

influence_df <- data.frame(
  index = seq_along(cooks_d),
  cooks_d = cooks_d,
  leverage = leverage
)
head(influence_df[order(-influence_df$cooks_d), ], 10)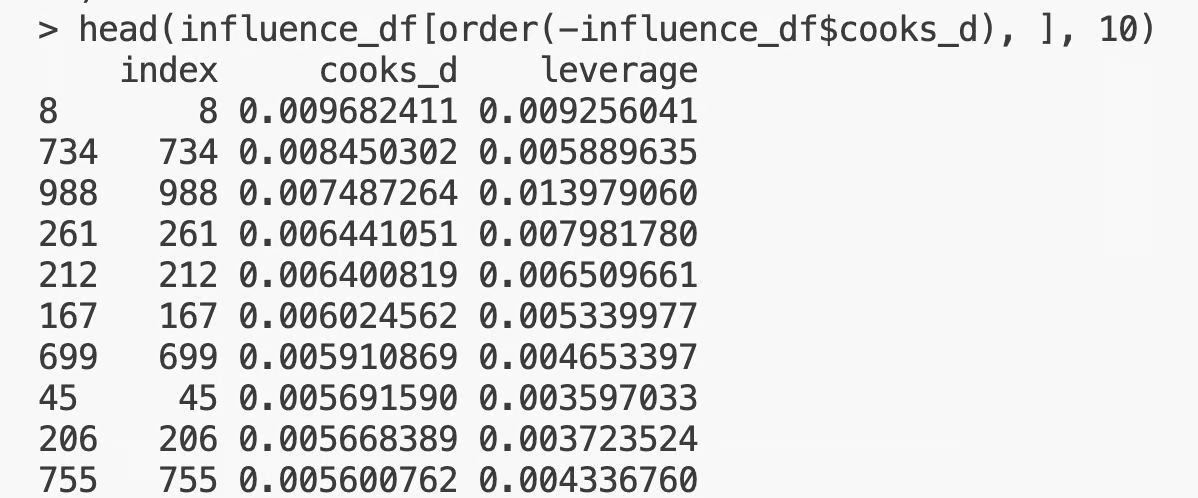
R में इन्फ्लुएंस डायग्नोस्टिक्स
कुक्स डिस्टेंस की सीमा Python जैसी ही है: 4/n, या 1000-पंक्ति डेटासेट के लिए 0.004। इससे काफी ऊपर कुछ भी जाँच योग्य है। त्वरित विज़ुअल जाँच के लिए, बेस R का plot(model, which = 4) एक लाइन में कुक्स डिस्टेंस प्लॉट देता है।
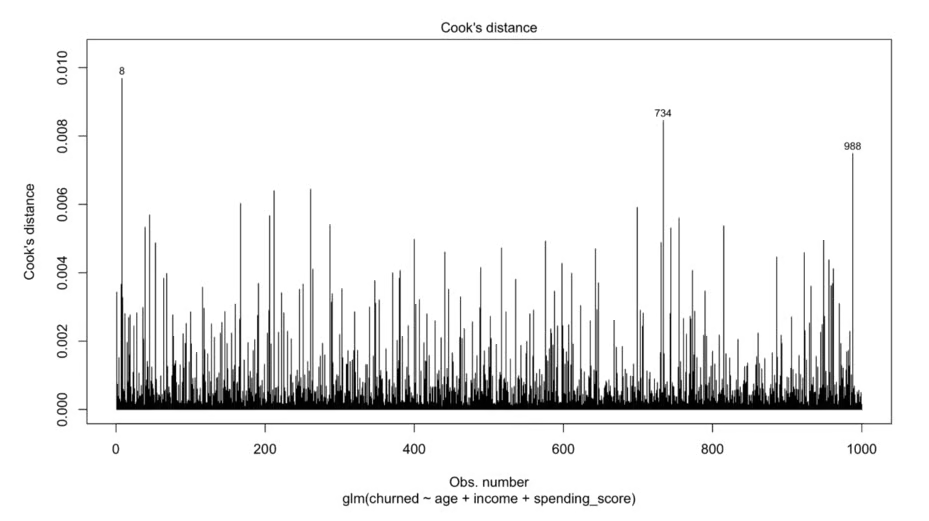
R में इन्फ्लुएंस डायग्नोस्टिक्स का दृश्य
R का residuals() किसी glm से डिविएंस रेजिडुअल्स देता है:
deviance_resid <- residuals(model, type = "deviance")
fitted_vals <- fitted(model)

resid_df <- data.frame(
  fitted = fitted_vals,
  deviance = deviance_resid
)
head(resid_df[order(-abs(resid_df$deviance)), ], 10)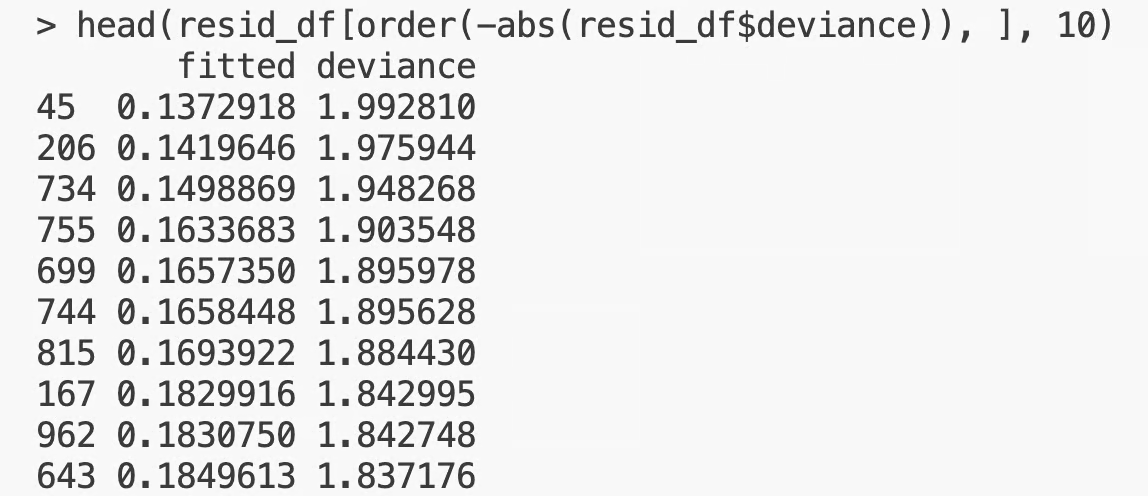
R में अवशेष डायग्नोस्टिक्स
बड़े परिमाण वाले डिविएंस रेजिडुअल्स वे केस हैं जहाँ मॉडल की भविष्यवाणी चूक गई। कुक्स डिस्टेंस फ़्लैग्स के साथ इन्हें क्रॉस-रेफरेंस करें ताकि वे प्रेक्षण ढूँढे जा सकें जो दोनों—खराब फिट और प्रभावशाली—हैं।
एक-ही-बार में सब कुछ देखने के लिए, influence.measures(model) एक तालिका लौटाता है जो कुक्स डिस्टेंस, लीवरेज, DFBETAs और अन्य कुछ इन्फ्लुएंस स्टैटिस्टिक्स को एक जगह जोड़ देता है। यह फिट किए गए glm पर सभी मानक डायग्नोस्टिक्स को तेज़ी से स्कैन करने का तरीका है।
ज्यादातर उल्लंघन आपके मॉडल को इस तरह नहीं तोड़ते कि वह चले ही नहीं। वे सूक्ष्म तरीकों से गड़बड़ी करते हैं जिन्हें आप तभी नोटिस करते हैं जब आपको पता हो कि क्या देखना है।
चार परिणाम सबसे आम हैं:
ईमानदारी से, उल्लंघन शायद ही किसी मॉडल को बेकार बनाते हैं। वे उसके कुछ हिस्सों को अविश्वसनीय बनाते हैं, और कौन-सा हिस्सा अविश्वसनीय होगा, यह इस पर निर्भर करता है कि कौन-सी मान्यता टूटी। इसलिए डायग्नोस्टिक्स मायने रखता है।
यदि आपके डायग्नोस्टिक्स ऐसी समस्याएँ दिखाएँ जिन्हें लॉजिस्टिक रिग्रेशन के भीतर ठीक न किया जा सके, तो अगला कदम ऐसा मॉडल लेना है जो वे मान्यताएँ न रखता हो।
Generalized additive models (GAMs) अगली चीज़ हैं। एक GAM लॉजिस्टिक लिंक और व्याख्यायोग्य एडिटिव संरचना रखता है, पर रैखिक टर्म्स की जगह हर प्रेडिक्टर के स्मूथ फ़ंक्शन्स लगा देता है। आपको एकल संख्याओं की जगह “शेप वाले गुणांक” मिलते हैं, जो लॉजिट की रैखिकता की समस्या सुलझाते हैं। GAMs अभी भी इतने पैरामीट्रिक हैं कि उन्हें देखा-समझा जा सके, जो उन्हें लॉजिस्टिक रिग्रेशन से एक अच्छा कदम ऊपर बनाता है जब रैखिकता की मान्यता टिक न सके।
ट्री-आधारित मॉडल अधिक लचीला विकल्प हैं। रैंडम फॉरेस्ट और ग्रेडिएंट बूस्टिंग प्रेडिक्टर वितरणों या संबंध-आकारों के बारे में कोई मान्यताएँ नहीं रखते। वे मल्टिकॉलीनियरिटी को संभालते हैं और नॉन-लिनियरिटी भी पकड़ सकते हैं। वे आपको लॉजिस्टिक रिग्रेशन जैसी आसान गुणांक-व्याख्या नहीं देते, पर जब डेटा में नॉन-लिनियर संरचना या वैसी इंटरैक्शन्स हों जिन्हें आपने मॉडल में नहीं डाला, तो वे प्रेडिक्टिव मैट्रिक्स पर अक्सर बेहतर प्रदर्शन करते हैं।
GAMs और ट्री-आधारित मॉडलों के बीच चुनाव इस पर आता है कि आपको मॉडल से क्या चाहिए।
यह याद रखने योग्य है कि लॉजिस्टिक रिग्रेशन की मान्यताएँ अनदेखा करने से कहीं आसान जाँची जा सकती हैं। यदि आप किसी ट्रांसफॉर्मेशन, स्प्लाइन, रेग्युलराइज़ेशन, या बेहतर सैंपल से समस्या ठीक कर सकते हैं, तो लॉजिस्टिक रिग्रेशन की व्याख्येयता और इनफ़रेंशियल आउटपुट आमतौर पर अधिक लचीले मॉडल में स्विच करने से बेहतर रहते हैं।
तो, GAMs या ट्रीज़ पर तब जाएँ जब डायग्नोस्टिक्स बताएँ कि मान्यताएँ सचमुच नहीं टिकतीं—सिर्फ इसलिए नहीं कि लॉजिस्टिक रिग्रेशन “स्टेट-ऑफ-द-आर्ट” एल्गोरिद्म नहीं है।
अंत में, इस छोटी सूची का पालन करें ताकि हर बार भरोसेमंद मॉडल मिले:
सच कहा जाए, लॉजिस्टिक रिग्रेशन उन मॉडलों में से है जो काफी क्षमाशील हैं।
यह स्क्यूड प्रेडिक्टर्स और इम्बैलेंस्ड आउटकम्स को सह लेता है, और इसे आपके अवशेष कैसे दिखते हैं इसकी परवाह नहीं। जो यह नहीं सह सकता, वह है—लॉग-ऑड्स के साथ गलत-स्पेसिफाइड संबंध या एक ही जानकारी वाले प्रेडिक्टर्स का समूह।
इसीलिए लॉजिट की रैखिकता और मल्टिकॉलीनियरिटी वे दो मान्यता-जाँचें हैं जिन्हें आवश्यक मानना चाहिए। ये मॉडल को ऐसे तरीकों से विकृत करती हैं जिन्हें कोई टेस्ट मैट्रिक पकड़ नहीं सकता। अन्य चार मान्यताएँ भी प्रासंगिक हैं, पर वास्तव में ध्यान इन्हीं दो पर होना चाहिए।
सुरक्षित रहने के लिए, इवैल्युएशन के साथ-साथ डायग्नोस्टिक्स भी चलाएँ, बाद में नहीं। जो मॉडल अच्छी भविष्यवाणी करता है और अपनी मान्यता-जाँचों से भी पास होता है, वही वह मॉडल है जिस पर आप डटे रह सकते हैं। इससे कम कुछ भी ऐसा मॉडल है जिसे आपने ट्रेन किया है पर वास्तव में सत्यापित नहीं किया।
यदि यह जटिल लगता है, तो इसलिए कि यह है। एक अच्छा मशीन लर्निंग इंजीनियर बनने में बहुत कुछ लगता है, इसलिए हम सलाह देते हैं कि आप हमारे Machine Learning Scientist in Python ट्रैक में दाखिला लें। 85 घंटे की सामग्री आपको 2026 के लिए जॉब-रेडी बना देगी।
DataCamp के साथ सीखें
कोर्स
कोर्स
कोर्स