
Program
Data Engineer dalam Python
40 jam
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan GoogleApache Spark dan Apache Flink adalah dua kerangka kerja pemrosesan data open-source yang banyak digunakan untuk big data dan analitik. Keduanya menonjol sebagai alat yang kuat dengan kapabilitas pemrosesan data yang andal, namun berbeda dalam arsitektur dan fungsi utamanya.
Kita akan menelusuri karakteristik utama Spark dan Flink, dengan fokus pada model pemrosesan, abstraksi data, manajemen state, dan performa. Kita juga akan melihat bagaimana masing-masing kerangka kerja menangani pemrosesan data batch dan real-time. Memahami perbedaan dan persamaan keduanya akan membantu Anda memilih kerangka kerja yang tepat sesuai kebutuhan.
Kita semua tahu volume data yang tersedia tumbuh secara eksponensial. Organisasi yang berupaya memanfaatkan big data dapat menghadapi tantangan dalam hal skalabilitas dan efisiensi.
Kerangka kerja pemrosesan data menjadi solusi yang sangat dibutuhkan karena dapat mendukung beragam operasi data termasuk ingestion, transformasi, dan penyimpanan, bahkan saat bekerja dengan data berukuran terabita. Mereka menyediakan spektrum luas alat dan API, memberi Anda fleksibilitas untuk melakukan tugas mulai dari operasi dasar hingga pemodelan machine learning. Selain itu, kerangka kerja pemrosesan data menawarkan abstraksi kompleksitas yang menyederhanakan proses pengembangan dan debugging aplikasi pemrosesan data.
Secara garis besar, kerangka kerja pemrosesan data bekerja dengan mendistribusikan beban kerja ke beberapa node dalam sebuah klaster. Beberapa kerangka kerja secara khusus ditujukan untuk memproses data real-time, memungkinkan Anda menganalisis data saat data tersebut tiba. Lainnya dioptimalkan untuk memproses data batch, yang berguna untuk analisis retrospektif Anda.
Apache Spark adalah kerangka kerja komputasi terdistribusi open-source yang dirancang untuk menangani volume data besar secara efisien dan cepat. Ia menggunakan model pemrograman in-memory, yang berarti dapat menyimpan data di memori utama node klaster, sehingga mempercepat pemrosesan secara signifikan dibandingkan alat lain yang lebih bergantung pada akses disk. Antarmuka yang mudah digunakan memungkinkan Anda melakukan operasi data yang kompleks melalui serangkaian API dalam beberapa bahasa, seperti Python dan R, dua bahasa utama untuk Data Science.
Apache Spark dapat menjalankan operasi secara tangguh, artinya ia dapat mentoleransi kegagalan pada node klaster dan pulih secara otomatis. Fitur kuat ini berkat komponennya, Resilient Distributed Dataset (RDD), yang merupakan kumpulan terdistribusi dari unit dasar yang menyimpan rekaman data.
Di sisi lain, model eksekusi Spark, Directed Acyclic Graph (DAG), memungkinkan Anda mengoptimalkan cara menjalankan tugas secara paralel. Komponen ini memungkinkan Spark mendistribusikan tugas ke berbagai node dalam klaster yang sama, memanfaatkan semua sumber daya yang tersedia.
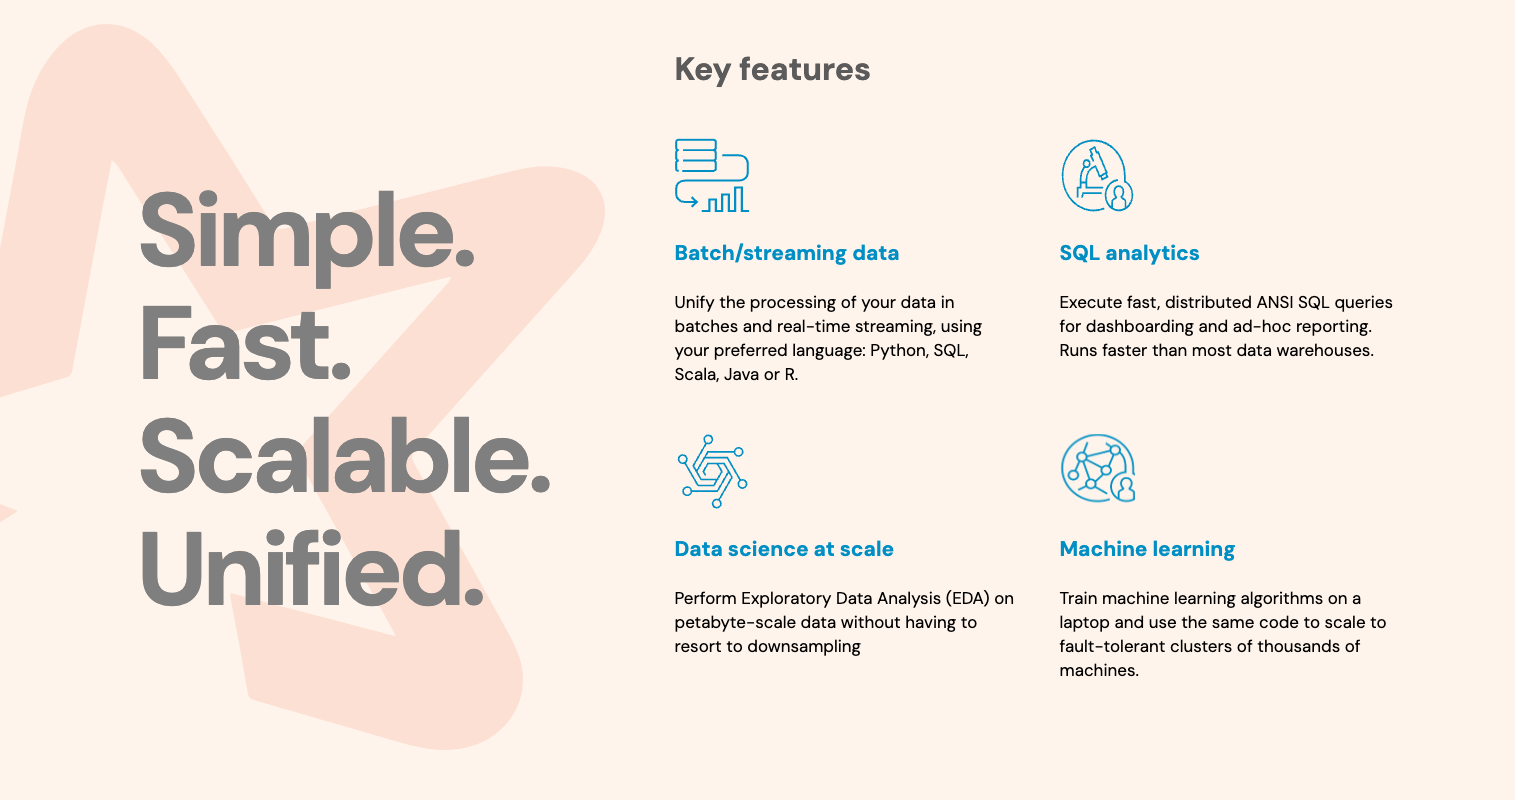 Fitur utama Apache Spark. Sumber
Apache Flink adalah sistem pemrosesan data open-source yang menonjol saat Anda perlu menganalisis data real-time dan memproses data besar dengan latensi rendah dan performa tinggi. Dengan infrastruktur yang sama, Apache Flink juga dapat memproses data batch, yang merupakan keunggulan besar ketika Anda perlu membangun dan menjalankan pipeline data kompleks yang memproses data real-time pada sistem terdistribusi. Ia menawarkan serangkaian API dalam beberapa bahasa termasuk Python dan R serta pustaka khusus yang membantu Anda membangun pipeline pemrosesan peristiwa untuk machine learning.
Apache Flink memperlakukan data Anda sebagai aliran peristiwa yang berkelanjutan, yang berguna pada aplikasi di mana data terus-menerus diterima dan diproses. Model pemrograman berbasis aliran ini adalah fitur kunci yang menghasilkan latensi rendah dalam merespons peristiwa. Selain itu, Anda dapat membangun pipeline pemrosesan data yang kompleks dan sangat disesuaikan menggunakan operasi Apache Flink.
Flink mengelola state secara efisien dalam aplikasi pemrosesan data real-time. Ini berarti Anda dapat mempertahankan dan memperbarui status aplikasi seiring data masuk dengan ketahanan terhadap kegagalan.
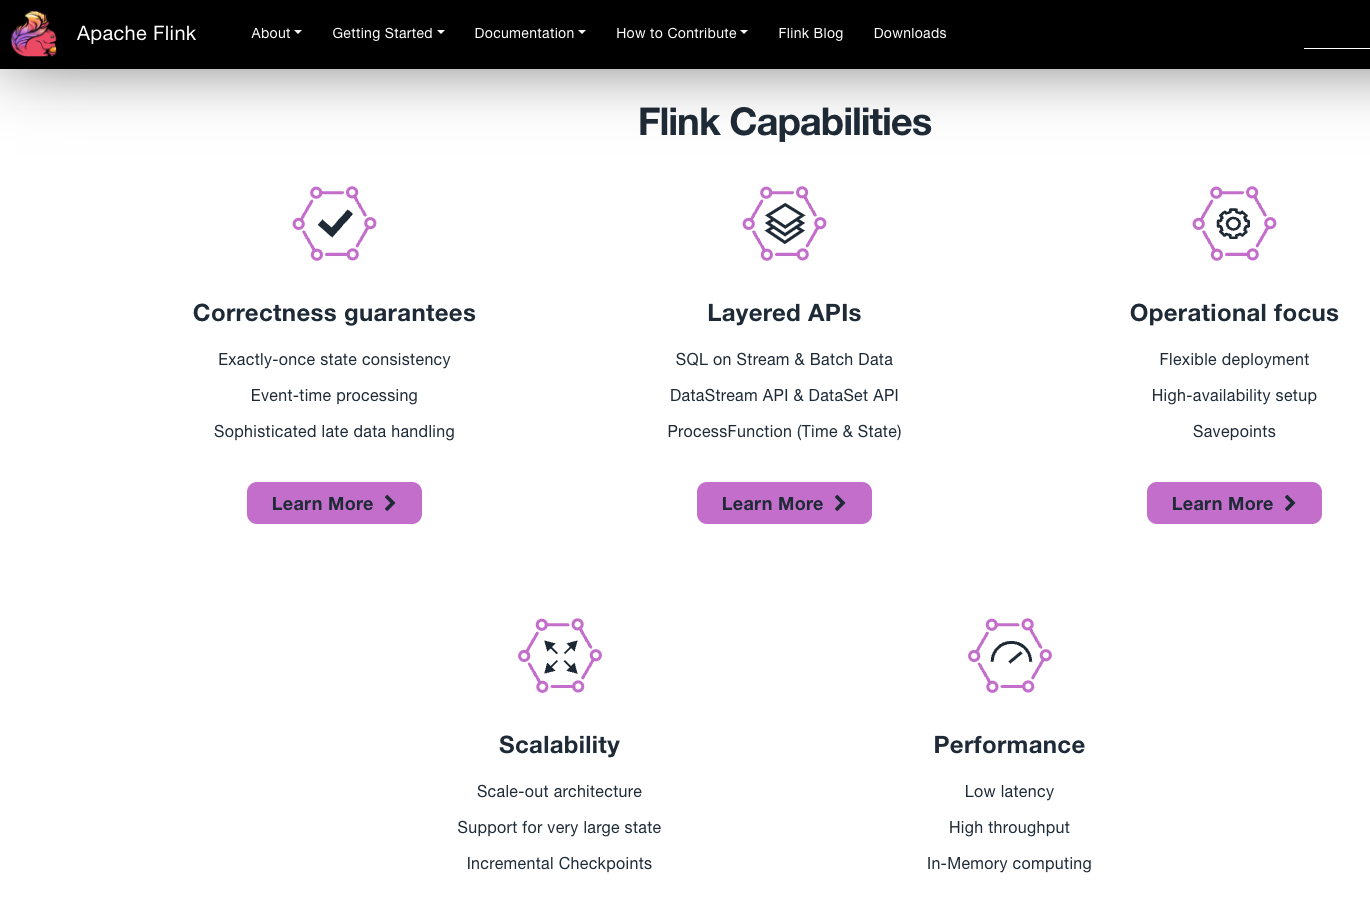 Fitur Utama Flink. Sumber
Memanfaatkan fitur kerangka kerja pemrosesan data yang tepat dapat membantu Anda meningkatkan performa dan efisiensi pipeline data. Di antara semua fitur yang ditawarkan Spark dan Flink, ada beberapa poin kunci yang perlu Anda evaluasi saat memilih di antara kedua alat ini:
Meskipun Spark dan Flink memiliki fitur pembeda utama, keduanya berbagi beberapa karakteristik penting. Keduanya dirancang untuk menangani tugas pemrosesan data skala besar dengan latensi rendah. Keduanya menawarkan serangkaian API dalam beberapa bahasa, termasuk Python, Scala, Java, dan R, serta terintegrasi dengan ekosistem alat big data yang lebih luas. Selain itu, Spark dan Flink menerapkan pengoptimalan performa.
Mari kita lihat masing-masing persamaan ini:
Apache Flink dan Apache Spark dirancang untuk memproses volume data besar dalam sebuah klaster komputer. Fitur ini memungkinkan Anda melakukan skala horizontal pada aplikasi untuk menangani dataset berukuran sangat besar dengan mengalokasikan dan membatalkan alokasi sumber daya secara dinamis ke beban kerja di berbagai node dengan latensi rendah. Kedua kerangka kerja dapat menangani pemrosesan data batch maupun streaming.
Baik Spark maupun Flink menyediakan API dan abstraksi tingkat tinggi yang diimplementasikan dalam beberapa bahasa, termasuk Scala, Python, dan Java, yang memungkinkan Anda menulis dan menjalankan pipeline dalam bahasa pilihan Anda. API ini membuat kedua kerangka kerja mudah digunakan saat mengembangkan aplikasi pemrosesan data. Selain itu, Flink menyertakan pustaka untuk machine learning (FlinkML), pemrosesan peristiwa kompleks (FlinkCEP), dan pemrosesan graf (Gelly). Spark juga menawarkan pustaka untuk machine learning (MLlib), pemrosesan graf (GraphX), dan pemrosesan data real-time (GraphX).
Apache Spark maupun Apache Flink terintegrasi dengan ekosistem alat big data yang luas, termasuk Hadoop Distributed File System, Apache Kafka, dan sistem penyimpanan cloud seperti Amazon S3.
Kedua kerangka kerja memiliki implementasi pengoptimalan performa yang memaksimalkan efisiensi dalam pemrosesan data. Fitur ini memungkinkan Anda melakukan tugas kompleks dengan memanfaatkan eksekusi paralel, perencanaan tugas, dan pengoptimalan kueri pada Spark dan Flink. Spark menggunakan pengoptimal Catalyst sementara Flink memiliki pengoptimal berbasis biaya untuk pemrosesan batch.
Apache Spark dan Apache Flink memiliki banyak kesamaan jika dilihat dari kapabilitas dasar dan pendekatan pemrosesan data. Namun, keduanya juga memiliki perbedaan signifikan terkait kekuatan dan fokus model pemrosesan, kematangan ekosistem dan dukungan bahasa, serta pendekatan terhadap pengoptimalan dan manajemen state.
Apache Flink terutama berfokus pada pemrosesan data real-time. Karena kerangka kerja ini dibangun di atas runtime streaming-nya dan juga dapat menangani pemrosesan batch. Di sisi lain, Apache Spark awalnya dirancang untuk pemrosesan batch, sehingga lebih cocok untuk analisis retrospektif terhadap dataset besar. Dengan menerapkan pendekatan micro-batch, Spark juga dapat memproses data streaming tetapi dengan latensi yang umumnya lebih tinggi daripada Flink.
Seperti disebutkan, kedua kerangka kerja menyediakan API dalam berbagai bahasa pemrograman. Namun, dukungan Python pada Flink kurang matang sehingga dapat menjadi keterbatasan jika Anda bekerja dengan tim yang berpusat pada data scientist.
Meskipun keduanya memiliki integrasi yang baik dengan alat big data, Apache Spark memiliki ekosistem yang lebih besar dan lebih matang, termasuk beragam konektor, pustaka, dan alat yang tersedia. Apache Flink terus memperluas kumpulan alat dan ekstensi yang tersedia, tetapi masih dapat dianggap sebagai ekosistem yang kurang matang.
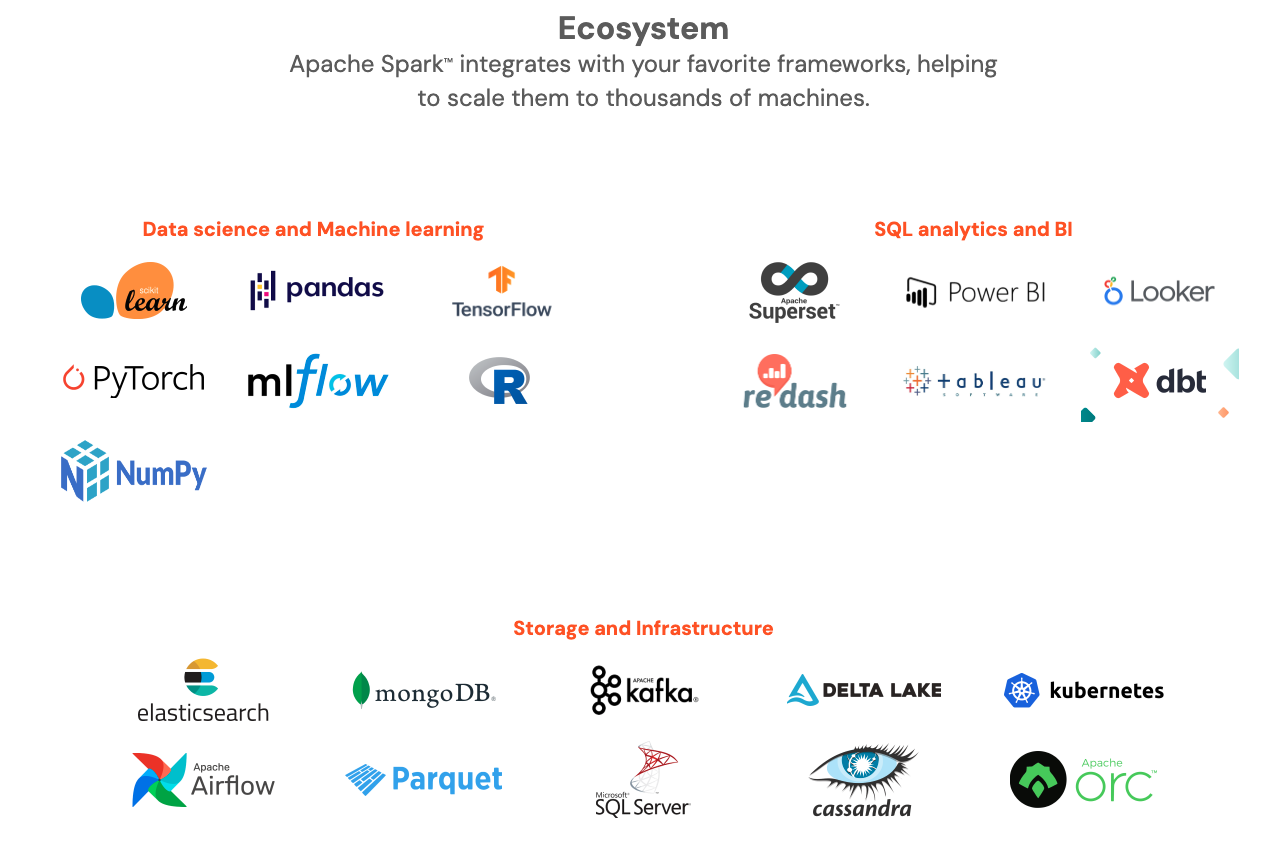
Ekosistem Apache Spark. Sumber
Apache Flink memungkinkan Anda bekerja dengan manajemen state yang lebih maju dan fleksibel, yang dapat menjadi keunggulan jika Anda bekerja dengan pipeline yang perlu mempertahankan dan memperbarui state secara real-time, seperti pemrosesan jendela berdasarkan event-time dan processing-time, atau jendela untuk menangani pola peristiwa yang kompleks. Spark memungkinkan Anda melakukan fungsionalitas windowing dasar yang bekerja baik saat pemrosesan batch dan micro-batching diperlukan.
Apache Flink dan Apache Spark menunjukkan banyak kesamaan namun juga berbeda secara substansial dalam pendekatan pemrosesan serta latensi, performa, dan manajemen state yang terkait. Selain itu, keduanya memiliki kematangan ekosistem dan dukungan bahasa yang agak berbeda. Kerangka kerja yang Anda pilih akan sangat bergantung pada kebutuhan spesifik proyek Anda. Namun, ada beberapa aspek di mana Spark atau Flink unggul dibandingkan satu sama lain:
Spark awalnya dirancang untuk pemrosesan batch, tetapi kini mendukung data streaming melalui modul Spark Streaming. Flink, di sisi lain, secara khusus dikembangkan untuk data streaming, namun sekarang juga mendukung pemrosesan batch.
Spark menggunakan Resilient Distributed Datasets dan teknik partisi data untuk meningkatkan pemrosesan paralel dan mengoptimalkan penggunaan sumber daya. Flink memanfaatkan operator chaining dan eksekusi pipeline, meningkatkan pemrosesan paralel dan efisiensi manajemen sumber dayanya. Secara umum, Flink dianggap lebih cepat dan menawarkan performa yang lebih baik dalam aplikasi pemrosesan real-time.
Spark menyediakan fitur windowing dasar yang terutama cocok untuk implementasi berbasis waktu, serasi dengan jendela waktu tetap atau meluncur untuk pemrosesan data batch dan streaming. Flink memiliki kapabilitas windowing yang lebih canggih, termasuk jendela berbasis event-time dan processing-time, jendela sesi, dan fungsi jendela kustom. Kapabilitas windowing Flink jauh lebih fleksibel dan efisien, menjadikannya pilihan utama untuk kebutuhan yang kompleks.
Spark memanfaatkan pengoptimal Catalyst, yang unggul dalam mengoptimalkan transformasi data dan kueri pemrosesan serta mengintegrasikan mesin eksekusi Tungsten untuk meningkatkan performa kerangka kerja. Flink memiliki pengoptimal berbasis biaya yang dirancang khusus untuk tugas pemrosesan batch, mengevaluasi sumber daya yang tersedia dan karakteristik data untuk memilih pendekatan paling efisien. Selain itu, eksekusi berbasis pipeline dan penjadwalan berlatensi rendah pada Flink secara signifikan meningkatkan kecepatan pemrosesan data. Pilihan antara Spark dan Flink untuk optimasi bergantung pada kasus penggunaan spesifik, karena keduanya menawarkan keunggulan yang berbeda.
Spark mencapai toleransi kesalahan melalui penggunaan Resilient Distributed Datasets (RDD), yaitu struktur data terpartisi yang tidak dapat diubah yang memungkinkan rekonstruksi cepat jika terjadi kegagalan. Flink, di sisi lain, menggunakan pendekatan snapshot terdistribusi, menangkap state aplikasi pada checkpoint tertentu, yang memfasilitasi pemulihan cepat dari kegagalan dengan dampak minimal terhadap performa. Meskipun kedua kerangka kerja menyediakan toleransi kesalahan yang efektif, metode Flink umumnya menghasilkan waktu pemulihan yang lebih cepat dan gangguan yang lebih kecil terhadap proses yang sedang berjalan, sehingga lebih disukai pada skenario di mana meminimalkan downtime sangat penting.
Spark mendukung beragam bahasa pemrograman termasuk Scala, Java, Python, dan R, menjadikannya sangat menarik bagi pengembang dan data scientist karena potensi kolaborasi yang luas dan serangkaian API yang komprehensif untuk bahasa-bahasa tersebut. Flink, meski mendukung Java, Scala, dan Python dengan API yang intuitif dan mudah digunakan, menawarkan kapabilitas Python yang lebih terbatas, yang dapat menghambat adopsinya di kalangan tim data science. Dukungan Python Spark yang unggul membuatnya lebih menarik bagi tim yang berfokus pada data di mana Python banyak digunakan.
Spark memiliki ekosistem yang lengkap dan matang, terintegrasi mulus dengan berbagai alat big data seperti Hadoop, Hive, dan Pig, di antaranya. Kompatibilitas yang luas ini menjadikan Spark pilihan yang tangguh untuk lingkungan data kompleks yang memerlukan beragam perangkat. Flink memiliki jangkauan integrasi yang lebih terbatas dengan alat big data lain, meski unggul dalam integrasinya dengan Apache Kafka. Karena integrasinya yang lebih komprehensif dan matang, Spark umumnya menghadirkan ekosistem yang lebih kuat.
Di bawah ini, Anda dapat menemukan tabel yang merangkum perbedaan utama antara Spark dan Flink:
| Kategori | Spark | Flink | Pemenang |
|---|---|---|---|
| Pemrosesan Data | Model berorientasi batch | Model berorientasi real-time | Tergantung |
| Performa | RDD dan partisi data | Operator chaining dan eksekusi pipeline | Flink |
| Windowing | Fungsionalitas berbasis waktu | Event-time, sesi, dan fungsi kustom | Flink |
| Optimasi | Pengoptimal Catalyst | Pengoptimal berbasis biaya | Tergantung |
| Toleransi Kesalahan | Dicapai oleh RDD | Snapshot terdistribusi | Flink |
| Dukungan Bahasa dan API | Dukungan komprehensif | Beberapa bahasa, Python tidak maju | Spark |
| Ekosistem | Integrasi penuh dengan alat big data | Integrasi dengan beberapa alat, unggul dengan Kafka | Spark |
Memilih kerangka kerja pemrosesan data yang paling sesuai dapat meningkatkan performa pipeline data Anda. Di antara semua kerangka kerja, Apache Spark dan Apache Flink menonjol sebagai dua alat yang kuat dan serbaguna dengan kekuatan dan kapabilitasnya masing-masing.
Spark sangat cocok untuk pemrosesan batch, menawarkan beragam alat, API, dan integrasi penuh dengan teknologi big data lainnya. Jika Anda tertarik mempelajari cara menggunakan Spark dari Python, lihat kursus Introduction to PySpark kami dan tutorial Getting Started with Pyspark kami. Flink menonjol untuk pemrosesan data real-time dan streaming karena menawarkan manajemen state yang efisien, fungsionalitas windowing, dan performa berlatensi rendah.
Pada akhirnya, pilihan antara kedua kerangka kerja ini akan bergantung pada kebutuhan dan persyaratan spesifik proyek Anda. Untuk memahami alat-alat ini dengan baik, sebaiknya lanjutkan membaca dan berlatih menggunakan sumber daya berikut.
Belajar bersama DataCamp
Program
Kursus
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan Googleblogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt



