
Program
Veri Mühendisi Python'da
40 sa
Alıştırma and program your progress.
Google Ile Devam EdinApache Spark ve Apache Flink, büyük veri ve analitik için yaygın olarak kullanılan iki açık kaynaklı veri işleme çerçevesidir. Her ikisi de güçlü veri işleme yetenekleriyle öne çıkan araçlar olsa da mimarileri ve temel işlevleri açısından farklılaşırlar.
Bu yazıda Spark ve Flink’in temel özelliklerini; işleme modelleri, veri soyutlamaları, durum yönetimi ve performansa odaklanarak inceleyeceğiz. Ayrıca her bir çerçevenin toplu ve gerçek zamanlı veri işlemeyi nasıl ele aldığını da keşfedeceğiz. Farklılıklarını ve benzerliklerini anlamak, ihtiyaçlarınıza en uygun çerçeveyi seçmenize yardımcı olacaktır.
Hepimiz mevcut veri hacminin katlanarak arttığını biliyoruz. Büyük veriden yararlanmak isteyen kuruluşlar, ölçeklenebilirlik ve verimlilikle ilgili zorluklarla karşılaşabiliyor.
Veri işleme çerçeveleri, terabaytlarca verilerle çalışırken bile veri alımı, dönüştürme ve depolama gibi çok çeşitli işlemleri destekleyebildikleri için çok ihtiyaç duyulan bir çözümdür. Temel işlemlerden makine öğrenimi modellemeye kadar uzanan görevler için size esneklik sağlayan geniş bir araç ve API yelpazesi sunarlar. Ayrıca veri işleme uygulamalarının geliştirme ve hata ayıklama süreçlerini basitleştiren karmaşıklık soyutlaması da sağlarlar.
Genel olarak veri işleme çerçeveleri, iş yükünü bir kümedeki birden fazla düğüm arasında dağıtarak çalışır. Bazı çerçeveler, veriler gelir gelmez analiz etmenizi sağlayan gerçek zamanlı veri işlemeye özel olarak tasarlanmıştır. Diğerleri ise geriye dönük analizleriniz için yararlı olan toplu veri işlemeye optimize edilmiştir.
Apache Spark, büyük veri hacimlerini verimli ve hızlı bir şekilde işlemek üzere tasarlanmış, açık kaynaklı, dağıtık bir hesaplama çerçevesidir. Bellek içi bir programlama modeli kullanır; bu da veriyi küme düğümlerinin ana belleğinde tutabildiği anlamına gelir ve disk erişimine daha çok bağımlı araçlara kıyasla işlemleri önemli ölçüde hızlandırır. Kolay kullanımlı arayüzü, Python ve R gibi Veri Bilimi için başlıca dillerde sunulan bir API seti aracılığıyla karmaşık veri işlemlerini gerçekleştirmenize olanak tanır.
Apache Spark, işlemleri dayanıklı biçimde yürütebilir; yani küme düğümlerindeki hatalara tolerans gösterir ve otomatik olarak toparlanabilir. Bu güçlü özellik, veri kayıtlarını tutan temel birimlerden oluşan dağıtık bir koleksiyon olan Dayanıklı Dağıtık Veri Kümesi (RDD) bileşeni sayesinde mümkündür.
Öte yandan Spark’ın Yönlendirilmiş Çevrimsiz Grafik (DAG) yürütme modeli, görevlerinizi paralel olarak nasıl yürüteceğinizi optimize etmenizi sağlar. Bu bileşen, Spark’ın görevleri aynı kümenin farklı düğümlerine dağıtmasına ve mevcut tüm kaynaklardan yararlanmasına olanak tanır.
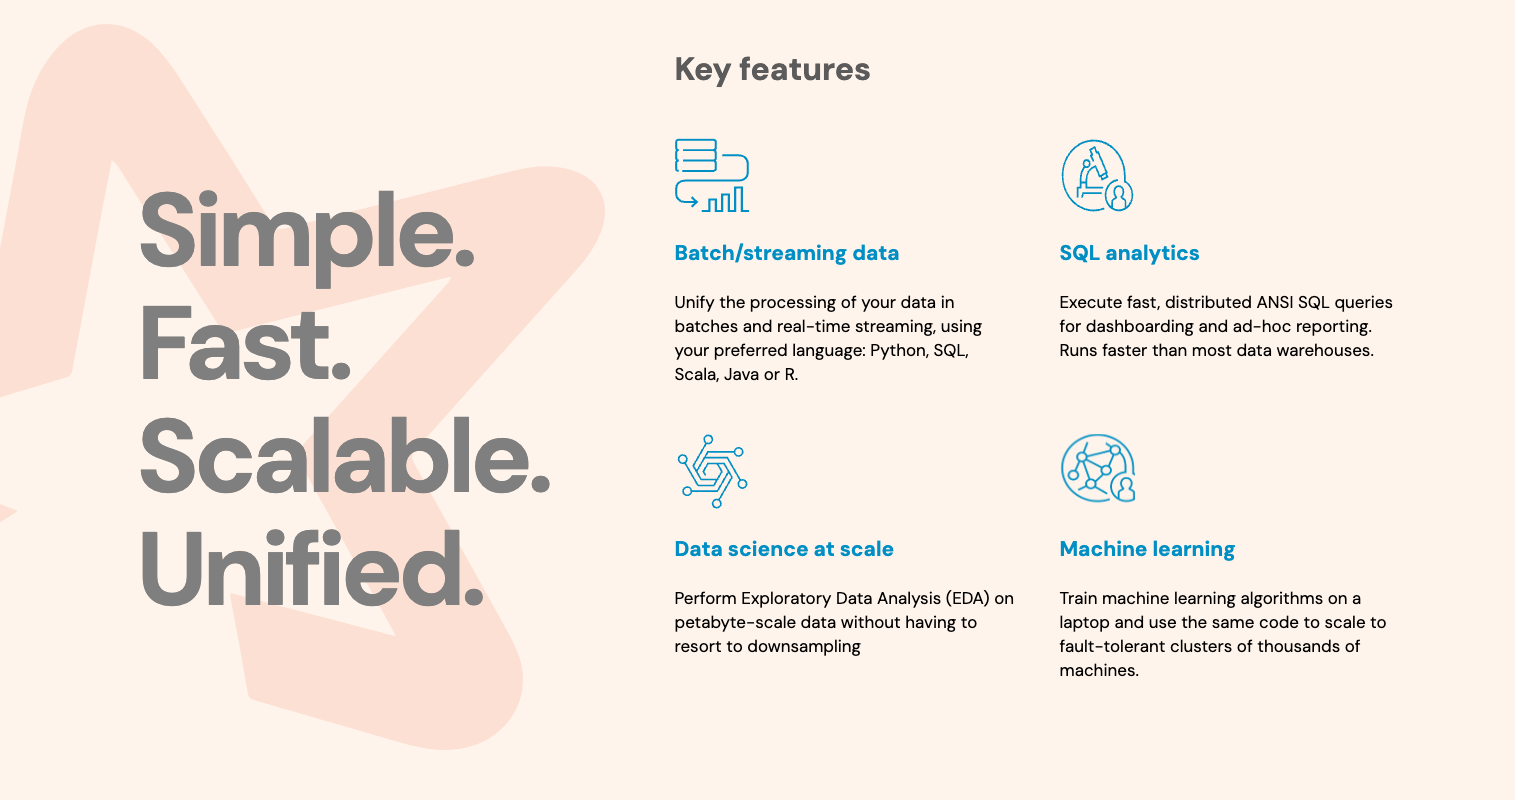 Apache Spark’ın başlıca özellikleri. Kaynak
Apache Flink, gerçek zamanlı verileri analiz etmeniz ve büyük veriyi düşük gecikme ve yüksek performansla işlemeniz gerektiğinde öne çıkan, açık kaynaklı bir veri işleme sistemidir. Aynı altyapıyı kullanarak toplu verileri de işleyebilir; bu da dağıtık sistemlerde gerçek zamanlı veri işleyen karmaşık veri boru hatları kurup çalıştırmanız gerektiğinde büyük bir avantaj sağlar. Python ve R dahil çeşitli dillerde API seti ve makine öğrenimi olay işleme boru hatları oluşturmanıza yardımcı olan uzmanlaşmış kütüphaneler sunar.
Apache Flink, verilerinizi kesintisiz olay akışları olarak ele alır; bu, verinin sürekli alındığı ve işlendiği uygulamalarda faydalıdır. Bu akış temelli programlama modeli, olaylara düşük gecikmeyle yanıt vermeyi sağlayan kilit bir özelliktir. Ayrıca Apache Flink işlemlerini kullanarak karmaşık ve yüksek derecede özelleştirilmiş veri işleme boru hatları oluşturabilirsiniz.
Flink, gerçek zamanlı veri işleme uygulamalarında durumu verimli bir şekilde yönetir. Bu, veriler geldikçe uygulamalarınızın durumunu hataya dayanıklı olarak koruyup güncelleyebileceğiniz anlamına gelir.
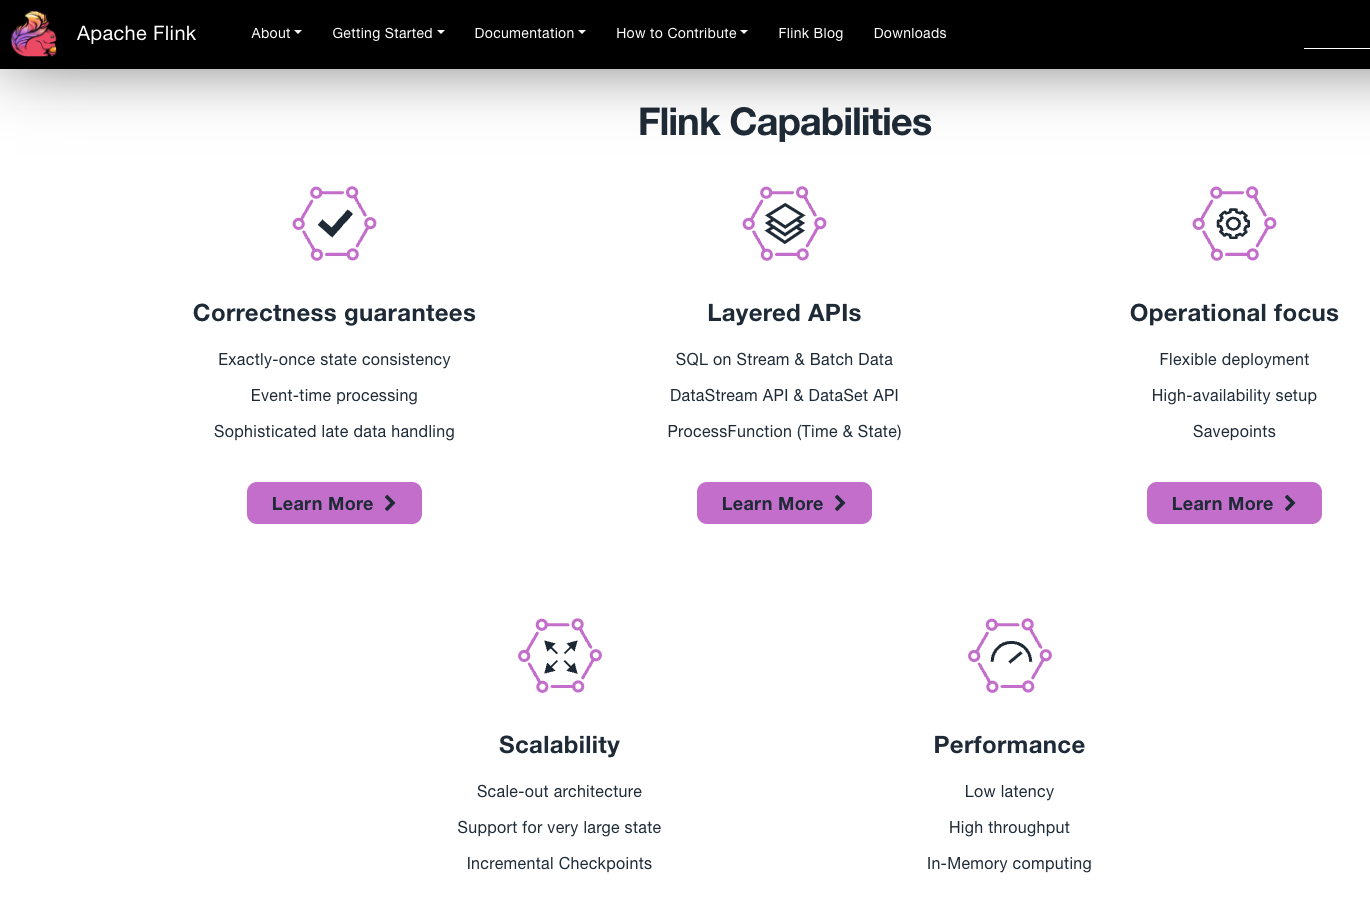 Flink’in Başlıca Özellikleri. Kaynak
Uygun bir veri işleme çerçevesinin özelliklerinden yararlanmak, veri boru hattınızın performansını ve verimliliğini artırmanıza yardımcı olabilir. Spark ve Flink’in sunduğu tüm özellikler arasında, bu araçlar arasında seçim yaparken değerlendirmeniz gereken bazı kilit noktalar vardır:
Spark ve Flink ayırt edici özelliklere sahip olsalar da birkaç önemli özelliği paylaşırlar. Her ikisi de düşük gecikmeyle geniş ölçekli veri işleme görevlerini ele almak üzere tasarlanmıştır. Python, Scala, Java ve R dahil çeşitli dillerde API seti sunarlar ve daha büyük bir büyük veri araç ekosistemiyle entegredirler. Ayrıca Spark ve Flink performans optimizasyonları uygular.
Bu benzerliklerin her birine bakalım:
Apache Flink ve Apache Spark, verileri bir bilgisayar kümesinde büyük hacimlerde işlemek üzere tasarlanmıştır. Bu özellik, uygulamanızı yatay olarak ölçeklendirerek, iş yükünü düşük gecikmeyle birden fazla düğüm arasında dinamik olarak kaynak tahsis edip geri alarak devasa veri kümelerini işlemenize olanak tanır. Her iki çerçeve de hem toplu hem akış veri işlemeyi destekleyebilir.
Spark ve Flink, tercih ettiğiniz dilde boru hatları yazıp çalıştırmanıza olanak tanıyan Scala, Python ve Java dahil çeşitli dillerde uygulanmış yüksek seviyeli API’ler ve soyutlamalar sağlar. Bu API’ler, veri işleme uygulamaları geliştirirken bu çerçeveleri kullanımı kolay hâle getirir. Ayrıca Flink; makine öğrenimi (FlinkML), karmaşık olay işleme (FlinkCEP) ve grafik işleme (Gelly) için kütüphaneler içerir. Spark da makine öğrenimi (MLlib), grafik işleme (GraphX) ve gerçek zamanlı veri işleme (GraphX) için kütüphaneler sunar.
Hem Apache Spark hem de Apache Flink, Hadoop Dağıtık Dosya Sistemi, Apache Kafka ve Amazon S3 gibi bulut depolama sistemlerini de içeren kapsamlı bir büyük veri araç ekosistemiyle entegredir.
Her iki çerçevenin de veri işlemeyi en verimli hâle getiren performans optimizasyonu uygulamaları vardır. Bu özellik, Spark ve Flink’in paralel yürütme, görev planlama ve sorgu optimizasyonundan yararlanarak karmaşık görevleri gerçekleştirmenize olanak tanır. Spark, Catalyst optimize edicisini kullanırken Flink, toplu işlem için maliyet tabanlı bir optimize ediciye sahiptir.
Apache Spark ve Apache Flink, temel yetenekleri ve veri işleme yaklaşımları düşünüldüğünde birçok benzerlik paylaşır. Ancak, işleme modellerinin güçlü yönleri ve odak alanları, ekosistemlerinin ve dil desteğinin olgunluğu ile optimizasyon ve durum yönetimine yaklaşımları açısından önemli farklılıklar da gösterirler.
Apache Flink esas olarak gerçek zamanlı veri işlemeye odaklanmıştır. Bu çerçeve akış yürütüm ortamı üzerine inşa edildiğinden toplu işlemeyi de ele alabilir. Öte yandan Apache Spark, başlangıçta toplu işlem için tasarlanmıştır; bu da onu büyük veri kümelerinin geriye dönük analizi için daha uygun kılar. Mikro-toplu yaklaşımı uygulayarak Spark, akış verilerini de işleyebilir ancak genellikle Flink’ten daha yüksek gecikmelerle.
Belirtildiği gibi her iki çerçeve de birden çok programlama dilinde API’ler sağlar. Ancak Flink’in Python desteği daha az olgundur; bu da veri bilimci ağırlıklı bir ekiple çalışıyorsanız kısıt oluşturabilir.
Her iki çerçeve de büyük veri araçlarıyla iyi entegrasyona sahip olsa da Apache Spark; çok çeşitli bağlayıcılar, kütüphaneler ve araçlar içeren daha geniş ve daha olgun bir ekosisteme sahiptir. Apache Flink, mevcut araç ve uzantı setini büyütmektedir ancak hâlen daha az olgun bir ekosistem olarak kabul edilebilir.
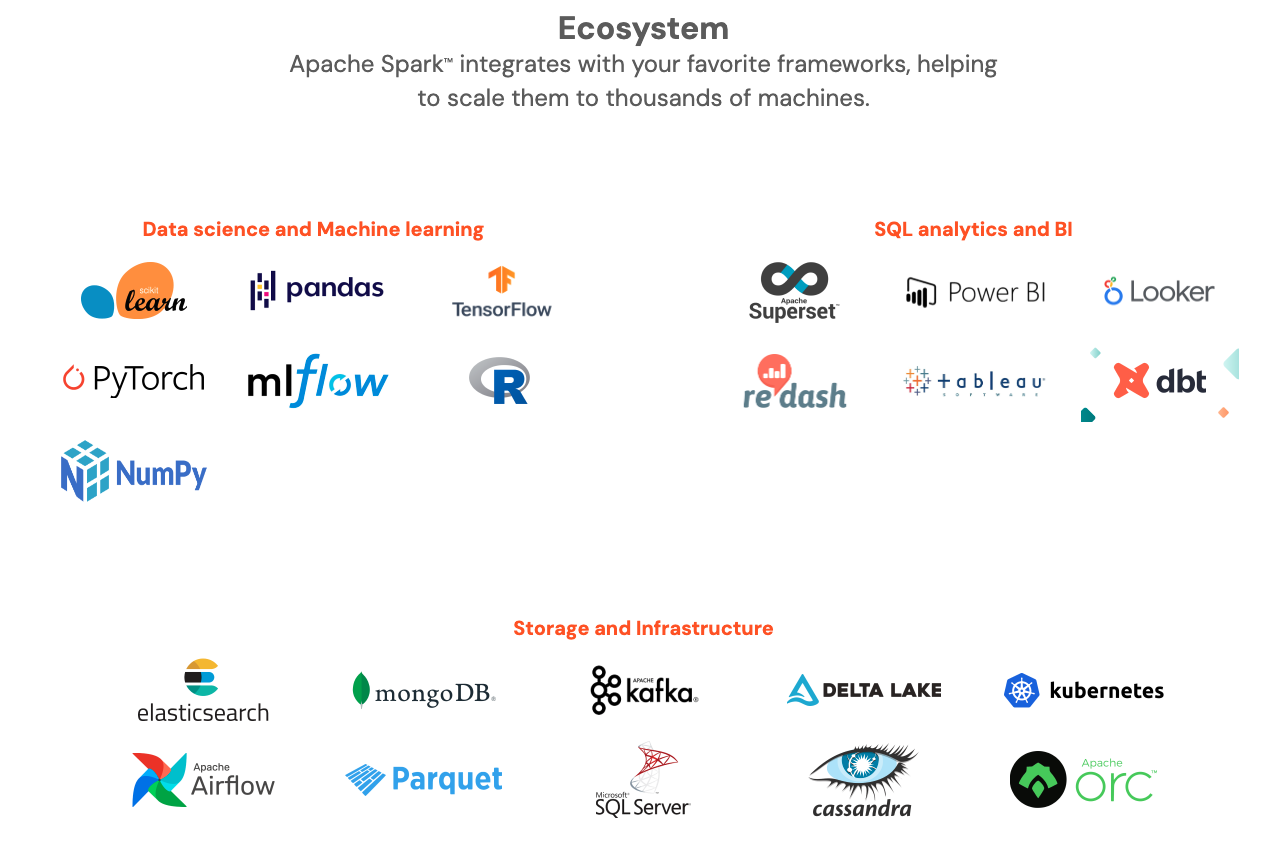
Apache Spark Ekosistemi. Kaynak
Apache Flink, daha gelişmiş ve esnek durum yönetimiyle çalışmanıza imkân tanır; bu da olay zamanı ve işleme zamanı pencereleri veya karmaşık olay desenlerini ele almaya yönelik pencereler gibi, durumu gerçek zamanlı olarak koruyup güncellemesi gereken boru hatlarıyla çalışıyorsanız avantaj sağlayabilir. Spark, toplu ve mikro-toplu işlem gerektiğinde iyi çalışan temel pencereleme işlevlerini sunar.
Apache Flink ve Apache Spark birçok benzerlik gösterse de işleme yaklaşımları ve buna bağlı gecikme, performans ve durum yönetimi açısından önemli ölçüde farklılaşır. Ayrıca ekosistem olgunluğu ve dil desteği bakımından da kısmen ayrışırlar. Hangi çerçeveyi seçeceğiniz büyük ölçüde projenizin özel gereksinimlerine bağlı olacaktır. Yine de Spark veya Flink’in birbirine kıyasla öne çıktığı bazı özellikler vardır:
Spark başlangıçta toplu işlem için tasarlanmıştır ancak artık Spark Streaming modülü aracılığıyla akış verilerini de desteklemektedir. Flink ise özellikle akış verileri için geliştirilmiş olup artık toplu işlemeyi de destekler.
Spark, paralel işlemeyi artırmak ve kaynak kullanımını optimize etmek için Dayanıklı Dağıtık Veri Kümeleri ve veri bölümleme tekniklerinden yararlanır. Flink ise operatör zincirleme ve boru hattı yürütmesinden faydalanarak paralel işleme ve kaynak yönetimi verimliliğini artırır. Genel olarak Flink daha hızlı kabul edilir ve gerçek zamanlı işleme uygulamalarında daha iyi performans sunar.
Spark, öncelikle zamana dayalı uygulamalar için uygun temel pencereleme özellikleri sağlar; hem toplu hem akış veri işlemelerinde sabit veya kayan zaman pencerelerine iyi oturur. Flink, olay zamanı ve işleme zamanı tabanlı pencereler, oturum pencereleri ve özel pencere fonksiyonları dahil daha gelişmiş pencereleme yeteneklerine sahiptir. Flink’in pencereleme yetenekleri belirgin biçimde daha esnek ve verimlidir; bu da onu karmaşık ihtiyaçlar için tercih edilen seçenek yapar.
Spark, veri dönüştürme ve işleme sorgularını optimize etmede üstün olan Catalyst optimize edicisini kullanır ve çerçevenin performansını artırmak için Tungsten yürütme motorunu entegre eder. Flink ise özellikle toplu işleme görevleri için tasarlanmış maliyet tabanlı bir optimize ediciye sahiptir; mevcut kaynakları ve veri özelliklerini değerlendirerek en verimli yaklaşımı seçer. Ayrıca Flink’in boru hattı tabanlı yürütmesi ve düşük gecikmeli zamanlayıcısı veri işleme hızlarını önemli ölçüde iyileştirir. Optimizasyon açısından Spark ile Flink arasında seçim, her ikisinin de farklı avantajlar sunması nedeniyle kullanım durumuna bağlıdır.
Spark, hatalar durumunda hızlı yeniden oluşturmayı sağlayan, değişmez ve bölümlendirilmiş veri yapıları olan Dayanıklı Dağıtık Veri Kümeleri (RDD) sayesinde hata toleransı sağlar. Flink ise dağıtık anlık görüntü tabanlı bir yaklaşım kullanır; uygulamanın durumunu belirli kontrol noktalarında yakalayarak, performansa minimum etkiyle hatalardan hızlı kurtulmayı kolaylaştırır. Her iki çerçeve de etkili hata toleransı sunsa da Flink’in yöntemi genellikle daha hızlı kurtarma süreleri ve devam eden süreçlerde daha az kesintiyle sonuç verir; bu da kesinti süresinin en aza indirilmesinin kritik olduğu senaryolarda onu daha tercih edilir kılar.
Spark; Scala, Java, Python ve R dahil çok sayıda programlama dilini destekler; bu da kapsamlı işbirliği potansiyeli ve bu diller için geniş API seti sayesinde hem geliştiriciler hem veri bilimciler için oldukça çekici kılar. Flink ise Java, Scala ve Python’u sezgisel ve kullanıcı dostu API’lerle desteklese de Python yetenekleri daha sınırlıdır; bu durum veri bilimi ekipleri arasında benimsenmesini zorlaştırabilir. Spark’ın üstün Python desteği, Python’un ağırlıklı olarak kullanıldığı veri odaklı ekipler için onu daha cazip kılar.
Spark, Hadoop, Hive ve Pig gibi çok çeşitli büyük veri araçlarıyla sorunsuz entegre olan eksiksiz ve olgun bir ekosisteme sahiptir. Bu geniş uyumluluk, çeşitli araç setlerinin gerektiği karmaşık veri ortamları için Spark’ı sağlam bir seçenek yapar. Flink, diğer büyük veri araçlarıyla daha sınırlı entegrasyon yelpazesine sahip olsa da Apache Kafka ile entegrasyonda öne çıkar. Daha kapsamlı ve olgun entegrasyonları sayesinde Spark genellikle daha güçlü bir ekosistem sunar.
Aşağıda, Spark ve Flink arasındaki temel farklılıkları özetleyen bir tablo bulabilirsiniz:
| Kategoriler | Spark | Flink | Kazanan |
|---|---|---|---|
| Veri İşleme | Toplu işleme odaklı model | Gerçek zaman odaklı model | Duruma bağlı |
| Performans | RDD’ler ve veri bölümleme | Operatör zincirleme ve boru hattı yürütme | Flink |
| Pencereleme | Zamana dayalı işlevler | Olay zamanı, oturum ve özel fonksiyonlar | Flink |
| Optimizasyon | Catalyst optimize edici | Maliyet tabanlı optimize edici | Duruma bağlı |
| Hata Toleransı | RDD’lerle sağlanır | Dağıtık anlık görüntüler | Flink |
| Dil ve API Desteği | Kapsamlı destek | Birkaç dil, Python gelişmiş değil | Spark |
| Ekosistem | Büyük veri araçlarıyla tam entegrasyon | Bazı araçlarla entegrasyon, Kafka ile üstün | Spark |
En uygun veri işleme çerçevesini seçmek, veri boru hattınızın performansını iyileştirebilir. Tüm çerçeveler arasında Apache Spark ve Apache Flink, kendilerine özgü güçlü yönleri ve yetenekleriyle iki güçlü ve çok yönlü araç olarak öne çıkar.
Spark, toplu işlem için son derece uygundur; çok çeşitli araçlar, API’ler ve diğer büyük veri teknolojileriyle tam entegrasyon sunar. Spark’ı Python ile nasıl kullanacağınızı öğrenmekle ilgileniyorsanız, Introduction to PySpark kursumuza ve Getting Started with Pyspark eğitimimize göz atın. Flink ise verimli durum yönetimi, pencereleme işlevleri ve düşük gecikmeli performans sunduğu için gerçek zamanlı ve akış veri işlemeyle öne çıkar.
Nihayetinde bu iki çerçeve arasındaki seçim, projenize özgü gereksinim ve ihtiyaçlara bağlı olacaktır. Bu araçları iyi anlamak için okumaya devam etmek ve aşağıdaki kaynakları kullanarak pratik yapmak en iyisidir.
DataCamp ile öğrenin
Program
Kurs
Alıştırma and program your progress.
Google Ile Devam Edinblog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




