
Lộ trình
Kỹ sư dữ liệu trong Python
40 giờ
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với GoogleApache Spark và Apache Flink là hai framework xử lý dữ liệu mã nguồn mở được sử dụng rộng rãi cho big data và phân tích. Cả hai đều là công cụ mạnh mẽ với khả năng xử lý dữ liệu vững chắc, song khác nhau về kiến trúc và các chức năng cốt lõi.
Chúng ta sẽ khám phá các đặc điểm chính của Spark và Flink, tập trung vào mô hình xử lý, trừu tượng dữ liệu, quản lý trạng thái và hiệu năng. Chúng ta cũng sẽ xem mỗi framework xử lý dữ liệu theo lô và theo thời gian thực như thế nào. Hiểu được điểm khác và giống sẽ giúp bạn chọn đúng framework cho nhu cầu của mình.
Ai cũng biết khối lượng dữ liệu sẵn có đang tăng theo cấp số nhân. Các tổ chức muốn tận dụng big data có thể gặp thách thức về khả năng mở rộng và hiệu quả.
Các framework xử lý dữ liệu là giải pháp cần thiết vì chúng hỗ trợ nhiều thao tác dữ liệu như thu nạp, chuyển đổi và lưu trữ, ngay cả khi làm việc với dữ liệu hàng terabyte. Chúng cung cấp một phổ công cụ và API rộng, cho phép bạn linh hoạt thực hiện các nhiệm vụ từ thao tác cơ bản đến mô hình hóa máy học. Ngoài ra, các framework xử lý dữ liệu còn trừu tượng hóa độ phức tạp, đơn giản hóa quá trình phát triển và gỡ lỗi ứng dụng xử lý dữ liệu.
Nói chung, các framework xử lý dữ liệu hoạt động bằng cách phân phối khối lượng công việc trên nhiều nút trong một cụm. Một số framework được thiết kế chuyên để xử lý dữ liệu thời gian thực, cho phép bạn phân tích dữ liệu ngay khi dữ liệu đến. Số khác được tối ưu để xử lý theo lô, hữu ích cho phân tích hồi cứu của bạn.
Apache Spark là một framework tính toán phân tán mã nguồn mở, được thiết kế để xử lý khối lượng dữ liệu lớn một cách hiệu quả và nhanh chóng. Nó sử dụng mô hình lập trình trong bộ nhớ, tức có thể lưu dữ liệu trong bộ nhớ chính của các nút trong cụm, nhờ đó tăng tốc xử lý đáng kể so với các công cụ dựa nhiều vào truy cập đĩa. Giao diện dễ dùng cho phép bạn thực hiện các thao tác dữ liệu phức tạp thông qua bộ API bằng nhiều ngôn ngữ như Python và R, hai ngôn ngữ chủ đạo trong Khoa học Dữ liệu.
Apache Spark có thể thực thi các thao tác một cách bền bỉ, nghĩa là chịu lỗi ở các nút trong cụm và tự động khôi phục. Tính năng mạnh mẽ này đến từ thành phần Resilient Distributed Dataset (RDD), một tập hợp phân tán các đơn vị cơ bản chứa bản ghi dữ liệu.
Mặt khác, mô hình thực thi Directed Acyclic Graph (DAG) của Spark cho phép bạn tối ưu cách thực hiện các tác vụ song song. Thành phần này giúp Spark phân phối tác vụ qua nhiều nút trong cùng cụm, tận dụng toàn bộ tài nguyên sẵn có.
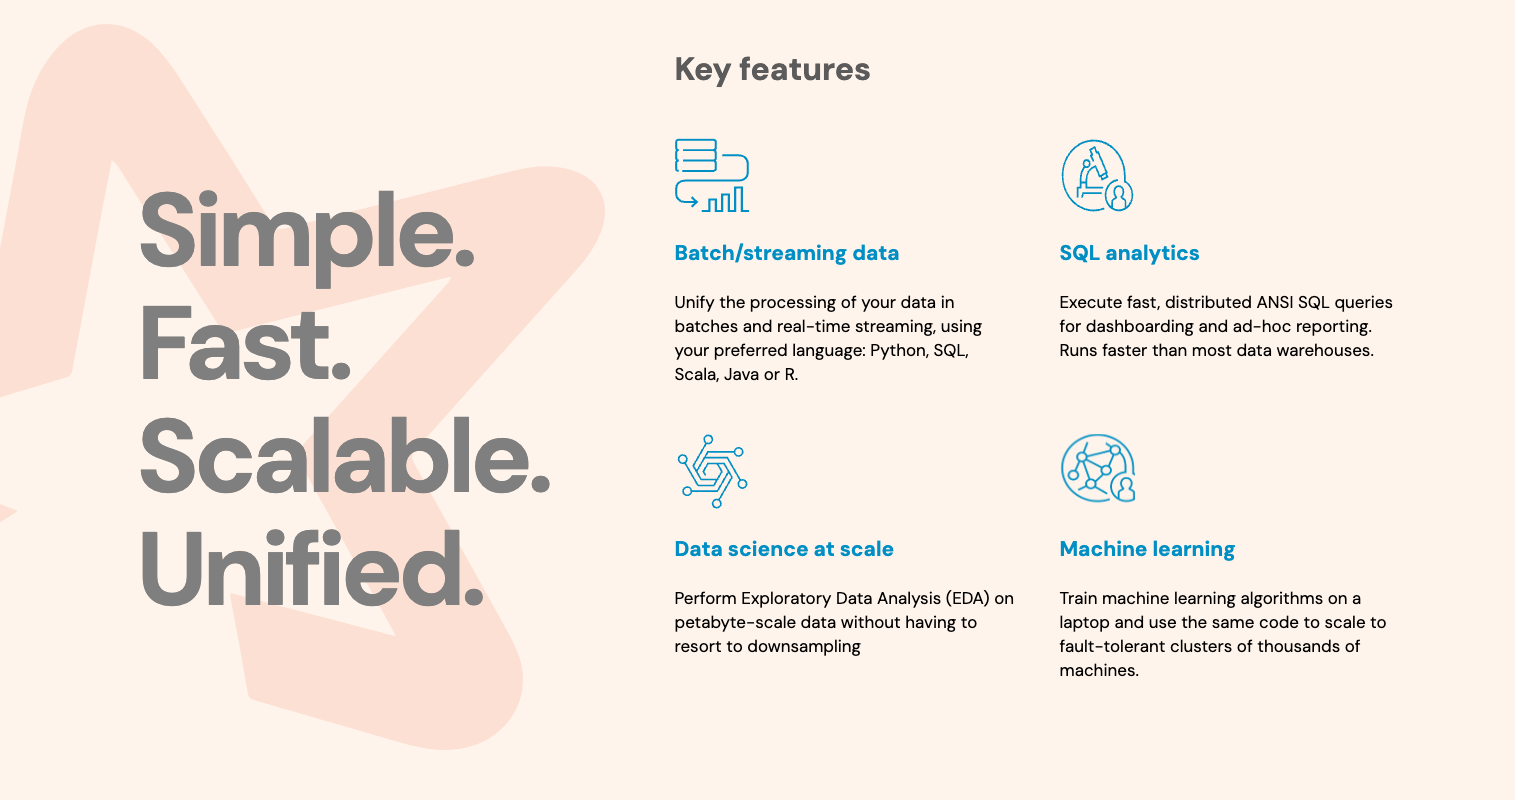 Các tính năng chính của Apache Spark. Nguồn
Apache Flink là một hệ thống xử lý dữ liệu mã nguồn mở nổi bật khi bạn cần phân tích dữ liệu thời gian thực và xử lý dữ liệu lớn với độ trễ thấp và hiệu năng cao. Trên cùng một hạ tầng, Apache Flink cũng có thể xử lý dữ liệu theo lô, đây là lợi thế lớn khi bạn cần xây dựng và vận hành các pipeline dữ liệu phức tạp xử lý dữ liệu thời gian thực trên hệ thống phân tán. Nó cung cấp bộ API bằng nhiều ngôn ngữ, bao gồm Python và R, cùng các thư viện chuyên biệt giúp bạn xây dựng pipeline xử lý sự kiện cho máy học.
Apache Flink coi dữ liệu của bạn như những dòng sự kiện liên tục, hữu ích trong các ứng dụng mà dữ liệu được nhận và xử lý liên tục. Mô hình lập trình dựa trên luồng là tính năng then chốt giúp phản hồi sự kiện với độ trễ thấp. Bên cạnh đó, bạn có thể xây dựng các pipeline xử lý dữ liệu phức tạp và tùy biến cao bằng các phép toán của Apache Flink.
Flink quản lý trạng thái hiệu quả trong các ứng dụng xử lý dữ liệu thời gian thực. Điều này có nghĩa bạn có thể duy trì và cập nhật trạng thái của ứng dụng khi dữ liệu đến, với khả năng chịu lỗi.
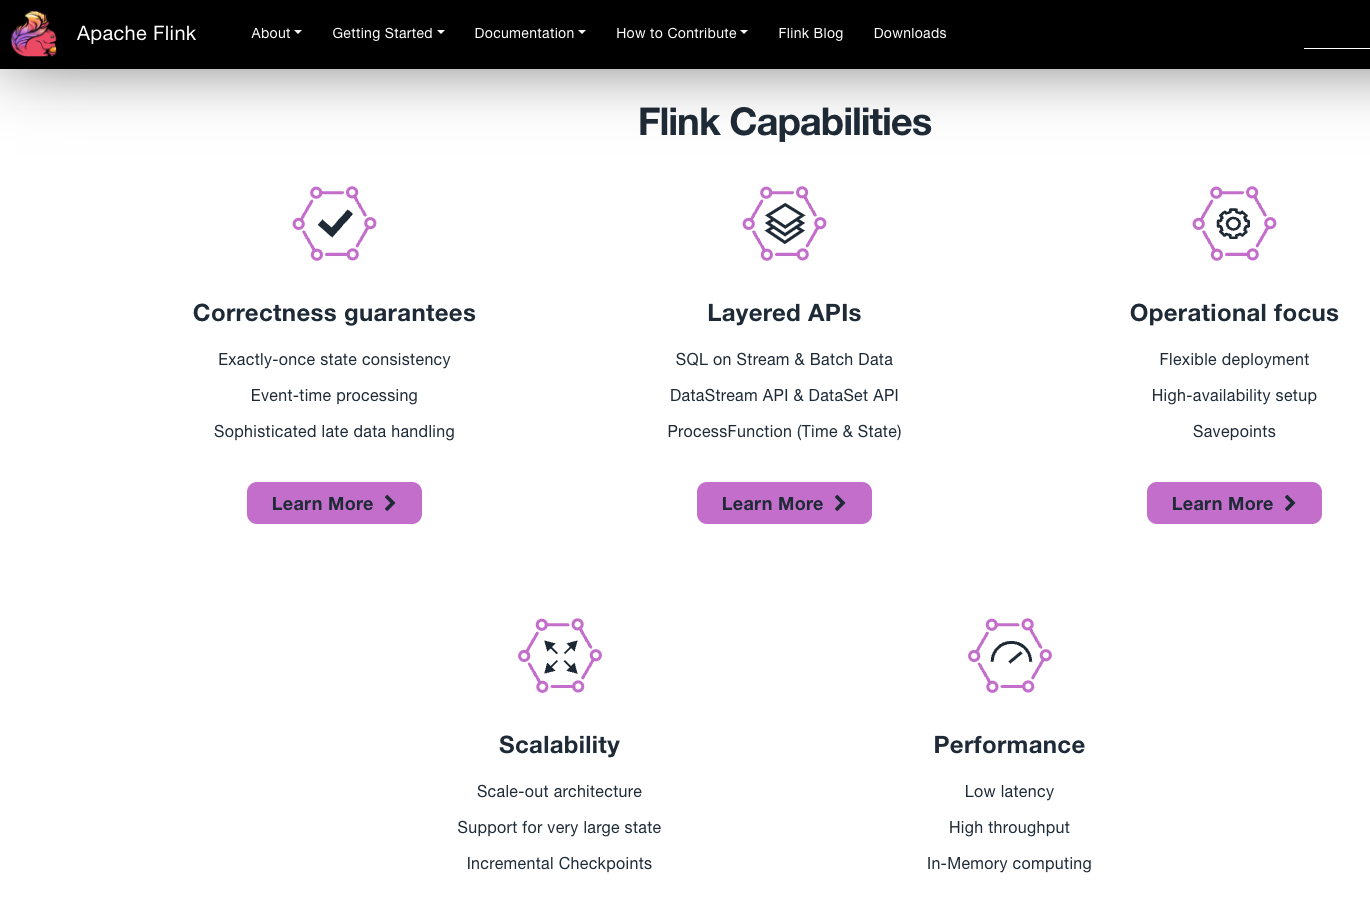 Các tính năng chính của Flink. Nguồn
Tận dụng đúng tính năng của framework xử lý dữ liệu phù hợp có thể giúp bạn cải thiện hiệu năng và hiệu quả của pipeline dữ liệu. Trong số các tính năng mà Spark và Flink cung cấp, có một vài điểm mấu chốt bạn cần đánh giá khi lựa chọn giữa hai công cụ này:
Dù Spark và Flink có các tính năng khác biệt, chúng cũng chia sẻ nhiều đặc điểm quan trọng. Cả hai đều được thiết kế để xử lý tác vụ dữ liệu quy mô lớn với độ trễ thấp. Cả hai cung cấp bộ API bằng nhiều ngôn ngữ, bao gồm Python, Scala, Java và R, và tích hợp trong hệ sinh thái công cụ big data lớn hơn. Hơn nữa, Spark và Flink đều triển khai các tối ưu hiệu năng.
Hãy cùng xem từng điểm tương đồng này:
Apache Flink và Apache Spark được thiết kế để xử lý khối lượng dữ liệu lớn trong một cụm máy tính. Tính năng này cho phép bạn mở rộng ngang ứng dụng để xử lý tập dữ liệu khổng lồ bằng cách cấp và thu hồi tài nguyên động cho khối lượng công việc trên nhiều nút với độ trễ thấp. Cả hai framework đều có thể xử lý dữ liệu theo lô và theo dòng.
Cả Spark và Flink đều cung cấp API cấp cao và các trừu tượng được triển khai bằng nhiều ngôn ngữ, bao gồm Scala, Python và Java, cho phép bạn viết và chạy pipeline bằng ngôn ngữ ưa thích. Những API này giúp các framework dễ dùng khi phát triển ứng dụng xử lý dữ liệu. Ngoài ra, Flink có các thư viện cho máy học (FlinkML), xử lý sự kiện phức tạp (FlinkCEP) và xử lý đồ thị (Gelly). Spark cũng cung cấp thư viện cho máy học (MLlib), xử lý đồ thị (GraphX) và xử lý dữ liệu thời gian thực (GraphX).
Apache Spark cũng như Apache Flink đều được tích hợp với hệ sinh thái công cụ big data toàn diện, bao gồm Hadoop Distributed File System, Apache Kafka và các hệ thống lưu trữ đám mây như Amazon S3.
Cả hai framework đều có triển khai tối ưu hiệu năng nhằm tối đa hóa hiệu quả xử lý dữ liệu. Tính năng này cho phép bạn thực hiện các tác vụ phức tạp bằng cách tận dụng thực thi song song, lập kế hoạch tác vụ và tối ưu truy vấn của Spark và Flink. Spark sử dụng bộ tối ưu Catalyst trong khi Flink có bộ tối ưu dựa trên chi phí cho xử lý theo lô.
Apache Spark và Apache Flink có nhiều điểm tương đồng khi xét về năng lực cơ bản và cách tiếp cận xử lý dữ liệu. Tuy nhiên, chúng cũng có khác biệt đáng kể về thế mạnh và trọng tâm của mô hình xử lý, độ trưởng thành của hệ sinh thái và hỗ trợ ngôn ngữ, cũng như cách tiếp cận tối ưu hóa và quản lý trạng thái.
Apache Flink tập trung chủ yếu vào xử lý dữ liệu thời gian thực. Vì framework này được xây dựng trên runtime streaming nên cũng có thể xử lý theo lô. Ngược lại, Apache Spark ban đầu được thiết kế cho xử lý theo lô, phù hợp hơn với phân tích hồi cứu trên các tập dữ liệu lớn. Bằng cách triển khai phương pháp vi-lô (micro-batch), Spark cũng có thể xử lý dữ liệu streaming nhưng với độ trễ thường cao hơn Flink.
Như đã đề cập, cả hai framework đều cung cấp API bằng nhiều ngôn ngữ lập trình. Tuy nhiên, hỗ trợ Python của Flink kém trưởng thành hơn, có thể là hạn chế nếu bạn làm việc với đội ngũ thiên về khoa học dữ liệu.
Dù cả hai framework đều tích hợp tốt với công cụ big data, Apache Spark có hệ sinh thái lớn hơn và trưởng thành hơn, bao gồm nhiều connector, thư viện và công cụ sẵn có. Apache Flink đang mở rộng bộ công cụ và tiện ích, nhưng vẫn có thể xem là hệ sinh thái kém trưởng thành hơn.
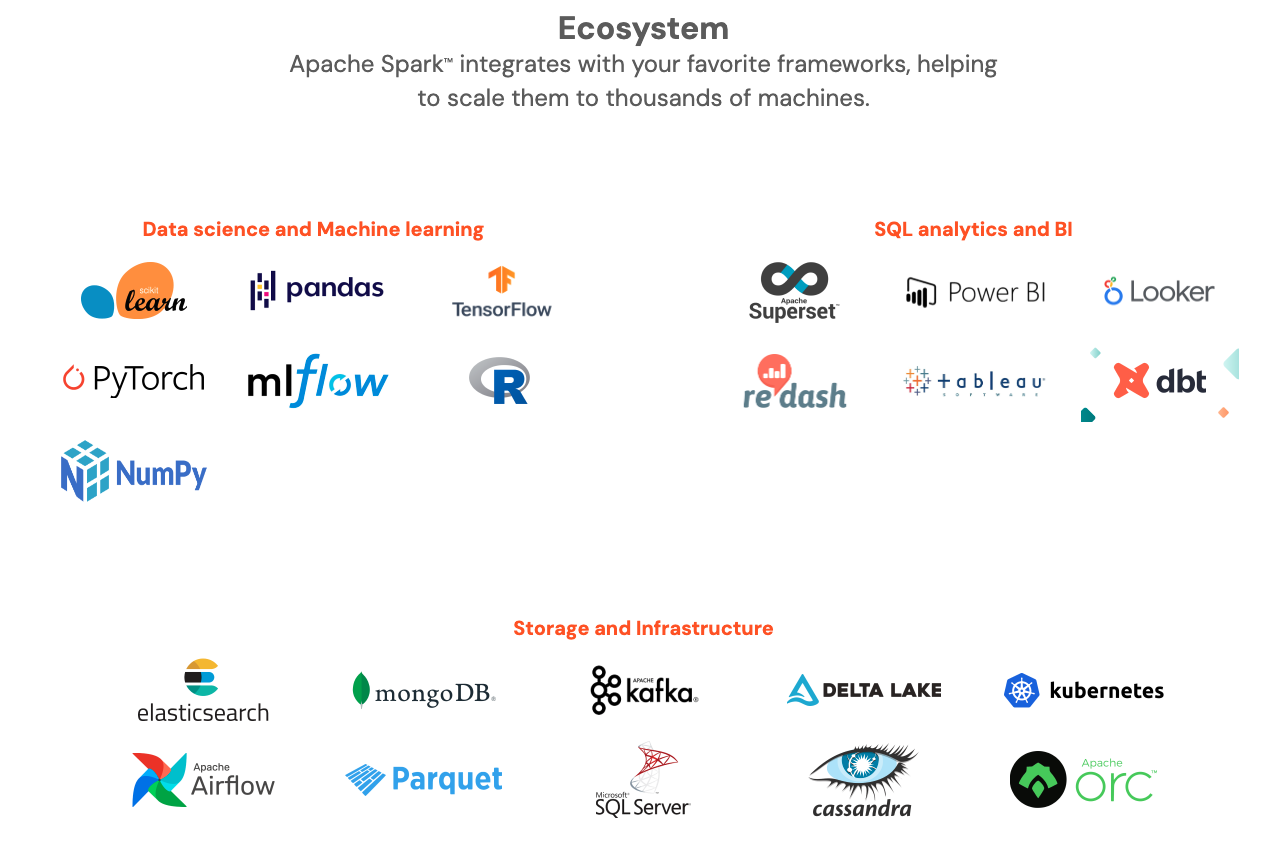
Hệ sinh thái Apache Spark. Nguồn
Apache Flink cho phép bạn làm việc với quản lý trạng thái linh hoạt và nâng cao hơn, là lợi thế nếu bạn xây dựng các pipeline cần duy trì và cập nhật trạng thái theo thời gian thực, như xử lý cửa sổ theo thời gian sự kiện và thời gian xử lý, hoặc các cửa sổ để xử lý mẫu sự kiện phức tạp. Spark cung cấp chức năng tạo cửa sổ cơ bản, hoạt động tốt khi cần xử lý theo lô và vi-lô.
Apache Flink và Apache Spark có nhiều điểm giống nhau nhưng cũng khác biệt đáng kể về cách tiếp cận xử lý và độ trễ liên quan, hiệu năng và quản lý trạng thái. Đồng thời, chúng có mức độ trưởng thành hệ sinh thái và hỗ trợ ngôn ngữ hơi khác nhau. Việc chọn framework nào chủ yếu phụ thuộc vào yêu cầu cụ thể của dự án. Tuy nhiên, có một số khía cạnh mà Spark hoặc Flink vượt trội hơn so với đối phương:
Spark ban đầu được thiết kế cho xử lý theo lô, nhưng hiện hỗ trợ dữ liệu streaming qua module Spark Streaming. Flink, ngược lại, được phát triển chuyên cho dữ liệu streaming, nhưng hiện cũng hỗ trợ xử lý theo lô.
Spark sử dụng Resilient Distributed Datasets và kỹ thuật phân vùng dữ liệu để tăng cường xử lý song song và tối ưu sử dụng tài nguyên. Flink tận dụng xâu chuỗi toán tử (operator chaining) và thực thi theo đường ống, nâng cao hiệu quả xử lý song song và quản lý tài nguyên. Nói chung, Flink được xem là nhanh hơn và mang lại hiệu năng tốt hơn trong các ứng dụng xử lý thời gian thực.
Spark cung cấp các tính năng windowing cơ bản chủ yếu phù hợp với triển khai dựa trên thời gian, thích hợp với cửa sổ thời gian cố định hoặc trượt cho cả xử lý theo lô và streaming. Flink có khả năng windowing nâng cao hơn, bao gồm cửa sổ theo thời gian sự kiện và thời gian xử lý, cửa sổ phiên, và các hàm cửa sổ tùy chỉnh. Khả năng windowing của Flink linh hoạt và hiệu quả hơn đáng kể, khiến nó là lựa chọn ưa thích cho nhu cầu phức tạp.
Spark sử dụng bộ tối ưu Catalyst, vượt trội trong tối ưu hóa các phép biến đổi dữ liệu và truy vấn xử lý, đồng thời tích hợp engine thực thi Tungsten để tăng hiệu năng framework. Flink có bộ tối ưu dựa trên chi phí được thiết kế riêng cho tác vụ xử lý theo lô, đánh giá tài nguyên sẵn có và đặc tính dữ liệu để chọn cách tiếp cận hiệu quả nhất. Ngoài ra, thực thi dựa trên pipeline và lập lịch độ trễ thấp của Flink cải thiện đáng kể tốc độ xử lý dữ liệu. Việc chọn Spark hay Flink cho tối ưu hóa phụ thuộc vào trường hợp sử dụng cụ thể, vì cả hai đều có lợi thế riêng.
Spark đạt khả năng chịu lỗi thông qua RDD, là cấu trúc dữ liệu bất biến được phân vùng, cho phép tái tạo nhanh khi xảy ra lỗi. Flink, mặt khác, sử dụng phương pháp snapshot phân tán, chụp lại trạng thái ứng dụng tại các điểm checkpoint cụ thể, giúp khôi phục nhanh sau lỗi với tác động tối thiểu đến hiệu năng. Dù cả hai cung cấp khả năng chịu lỗi hiệu quả, phương pháp của Flink thường dẫn đến thời gian khôi phục nhanh hơn và ít gián đoạn hơn cho các tiến trình đang chạy, khiến nó là lựa chọn phù hợp hơn trong bối cảnh cần giảm thiểu thời gian chết.
Spark hỗ trợ nhiều ngôn ngữ lập trình bao gồm Scala, Java, Python và R, rất hấp dẫn với cả nhà phát triển và nhà khoa học dữ liệu nhờ tiềm năng cộng tác cao và bộ API toàn diện cho các ngôn ngữ này. Flink, dù hỗ trợ Java, Scala và Python với API trực quan, thân thiện, lại có khả năng Python hạn chế hơn, có thể cản trở việc tiếp nhận trong các nhóm khoa học dữ liệu. Hỗ trợ Python vượt trội của Spark khiến nó hấp dẫn hơn với các đội ngũ thiên về dữ liệu nơi Python được dùng chủ yếu.
Spark sở hữu một hệ sinh thái đầy đủ và trưởng thành, tích hợp mượt mà với nhiều công cụ big data như Hadoop, Hive và Pig, v.v. Khả năng tương thích rộng này khiến Spark là lựa chọn vững chắc cho môi trường dữ liệu phức tạp cần bộ công cụ đa dạng. Flink có phạm vi tích hợp hạn chế hơn với các công cụ big data khác, dù nổi bật ở tích hợp với Apache Kafka. Nhờ tích hợp rộng và trưởng thành hơn, Spark thường có hệ sinh thái mạnh hơn.
Bên dưới là bảng tóm tắt những khác biệt chính giữa Spark và Flink:
| Danh mục | Spark | Flink | Người thắng |
|---|---|---|---|
| Xử lý dữ liệu | Mô hình thiên về theo lô | Mô hình thiên về thời gian thực | Phụ thuộc |
| Hiệu năng | RDD và phân vùng dữ liệu | Xâu chuỗi toán tử và thực thi theo pipeline | Flink |
| Cửa sổ | Chức năng dựa trên thời gian | Thời gian sự kiện, phiên và hàm tùy chỉnh | Flink |
| Tối ưu hóa | Bộ tối ưu Catalyst | Bộ tối ưu dựa trên chi phí | Phụ thuộc |
| Chịu lỗi | Đạt được nhờ RDD | Ảnh chụp nhanh phân tán | Flink |
| Hỗ trợ ngôn ngữ và API | Hỗ trợ toàn diện | Nhiều ngôn ngữ, Python chưa nâng cao | Spark |
| Hệ sinh thái | Tích hợp đầy đủ với công cụ big data | Tích hợp với một số công cụ, nổi bật với Kafka | Spark |
Chọn framework xử lý dữ liệu phù hợp nhất có thể cải thiện hiệu năng pipeline dữ liệu của bạn. Trong số các framework, Apache Spark và Apache Flink nổi bật như hai công cụ mạnh và linh hoạt với những điểm mạnh và năng lực riêng.
Spark rất phù hợp cho xử lý theo lô, cung cấp nhiều công cụ, API và tích hợp đầy đủ với các công nghệ big data khác. Nếu bạn quan tâm học cách dùng Spark từ Python, hãy xem khóa học Introduction to PySpark và bài hướng dẫn Getting Started with Pyspark của chúng tôi. Flink nổi trội ở xử lý dữ liệu thời gian thực và dữ liệu streaming nhờ quản lý trạng thái hiệu quả, chức năng windowing và hiệu năng độ trễ thấp.
Cuối cùng, lựa chọn giữa hai framework sẽ phụ thuộc vào yêu cầu và nhu cầu cụ thể của dự án. Để hiểu rõ các công cụ này, tốt nhất bạn nên tiếp tục đọc và thực hành với các tài nguyên sau.
Học cùng DataCamp
Lộ trình
Khóa học
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Googleblog
Matt Crabtree
10 phút
